
Datenklassifizierungsmarkt Größe und Marktanteil
Marktübersicht
| Studienzeitraum | 2020 - 2031 |
|---|---|
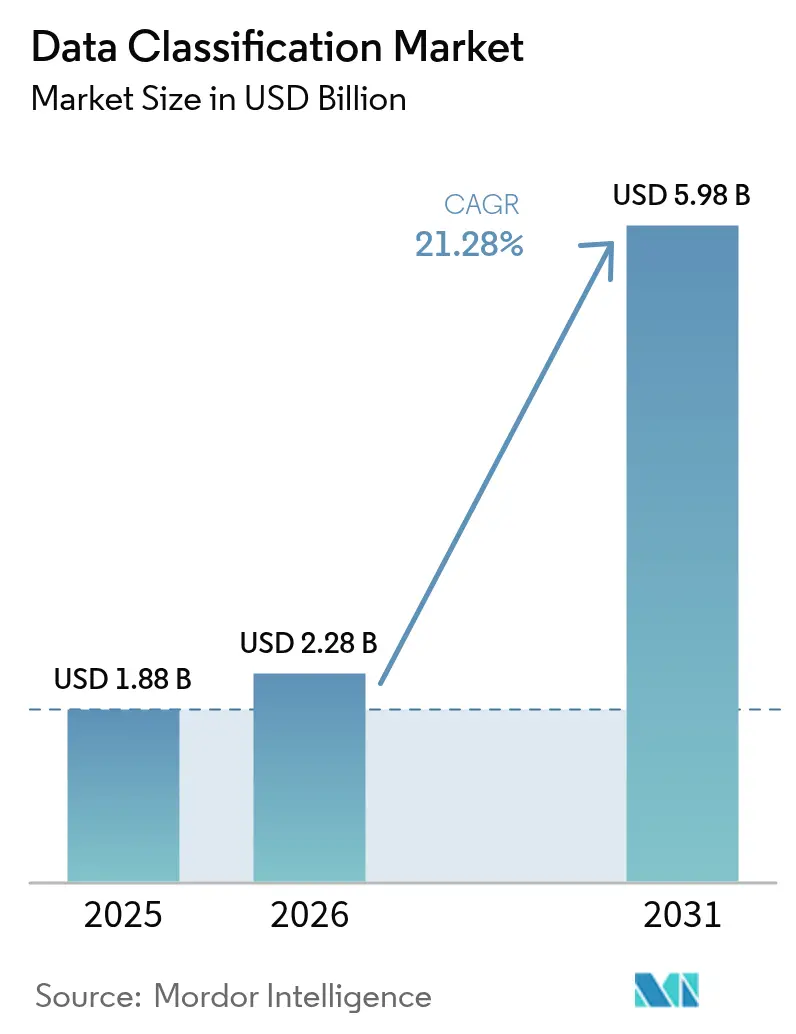
| Marktgröße (2026) | 2.28 Milliarden US-Dollar |
| Marktgröße (2031) | 5.98 Milliarden US-Dollar |
| Growth Rate (2026 - 2031) | 21.28 % |
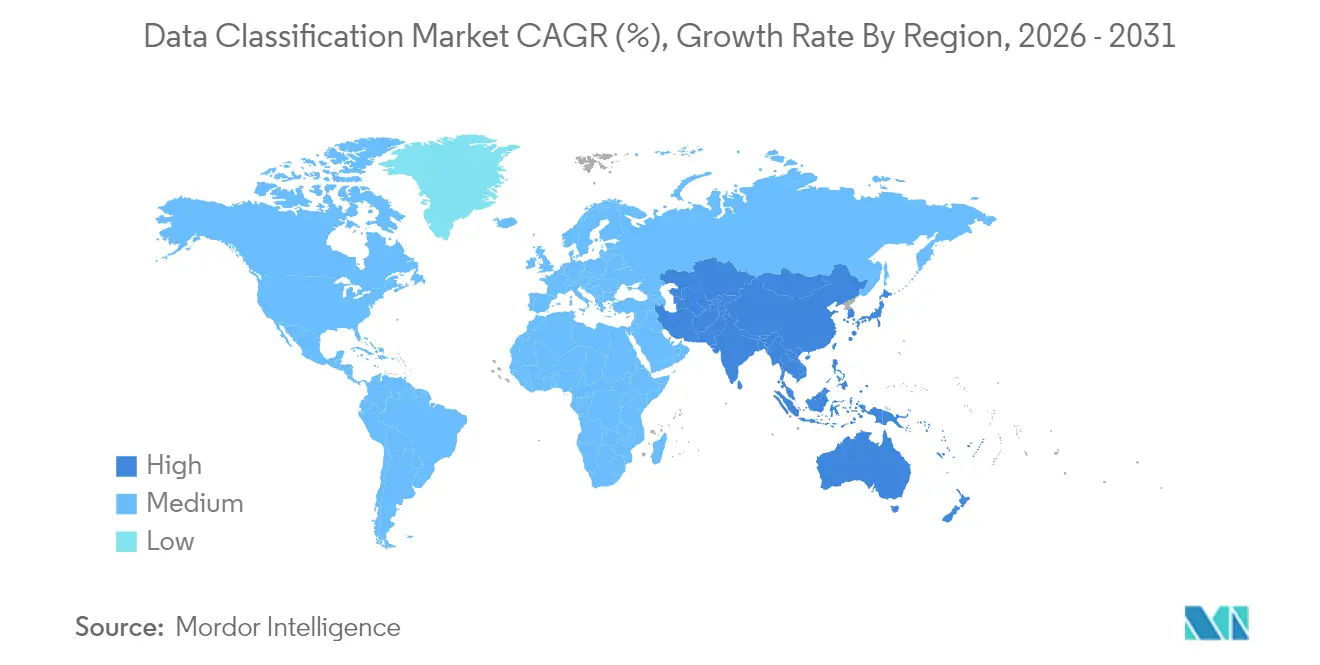
| Schnellstwachsender Markt | Asien-Pazifik |
| Größter Markt | Nordamerika |
| Marktkonzentration | Mittel |
Hauptakteure *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert Bild © Mordor Intelligence. Wiederverwendung erfordert Namensnennung gemäß CC BY 4.0. | |
Datenklassifizierungsmarkt Analyse von Mordor Intelligence
Die Größe des Datenklassifizierungsmarkts wird im Jahr 2026 auf USD 2,28 Milliarden geschätzt, ausgehend vom Wert des Jahres 2025 von USD 1,88 Milliarden, mit Prognosen für 2031 von USD 5,98 Milliarden, was einem Wachstum von 21,28 % CAGR über den Zeitraum 2026–2031 entspricht. Das rasante Datenwachstum, das auf täglich 328,77 Millionen TB neu erstellter Daten geschätzt wird, sowie strengere globale Datenschutzvorschriften veranlassen Unternehmen, KI-gestützte Echtzeit-Datenkennzeichnung einzuführen, die über hybride Cloud-Umgebungen skaliert. In Cloud-nativen Architekturen eingebettete KI-gestützte Klassifizierungsmaschinen erkennen nun sensible Informationen in unstrukturierten Repositories, während Initiativen zur souveränen Cloud im asiatisch-pazifischen Raum die regionale Nachfrage ankurbeln. Die zunehmende Bedrohungslage, bei der die durchschnittlichen Kosten eines Datenschutzvorfalls im Energiesektor im Jahr 2024 USD 4,78 Millionen erreichten, unterstreicht die Dringlichkeit automatisierter Governance zusätzlich. Investitionen von Hyperscalern wie AWS und Microsoft in regionale Rechenzentren verleihen dem Markt weiteren Schwung, indem sie die Latenz senken und Anforderungen an den Datenstandort erfüllen.
Wichtigste Erkenntnisse des Berichts
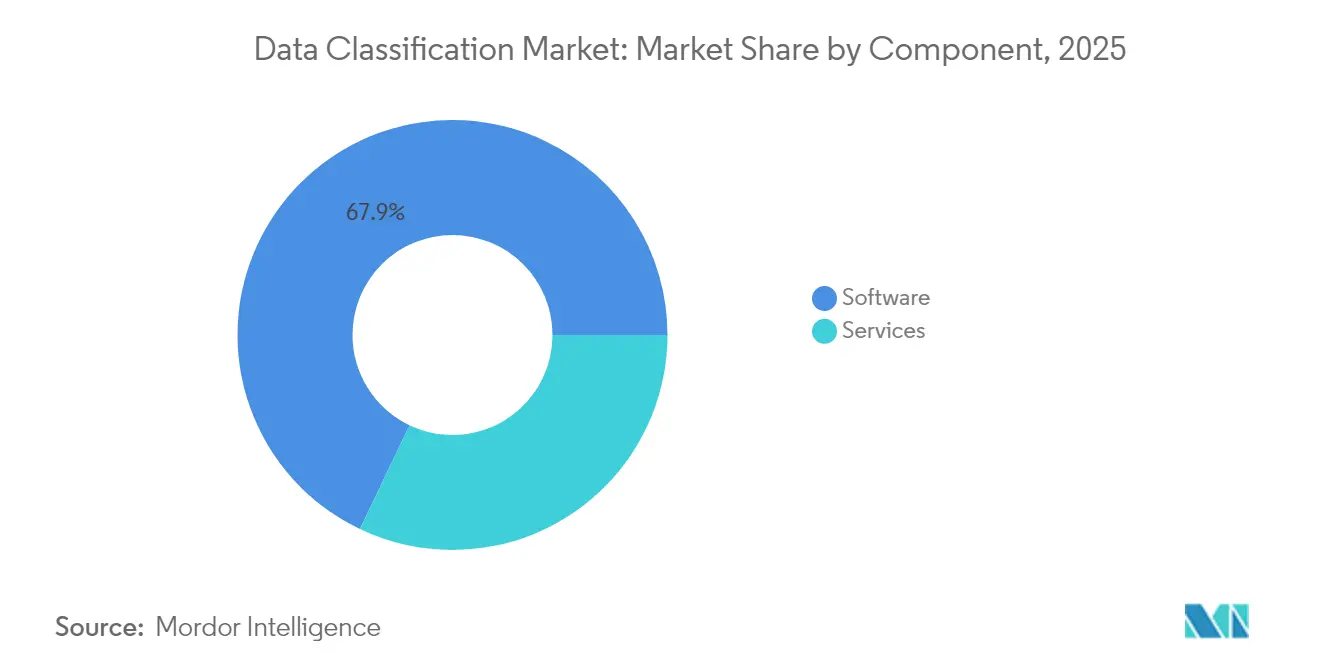
- Nach Komponente führte Software im Jahr 2025 mit einem Umsatzanteil von 67,92 %, während Dienstleistungen bis 2031 voraussichtlich mit einer CAGR von 23,62 % wachsen werden.
- Nach Klassifizierungsmethode entfielen im Jahr 2025 42,76 % des Marktanteils auf inhaltsbasierte Modelle; ML-gestützte Ansätze werden bis 2031 voraussichtlich mit einer CAGR von 22,44 % wachsen.
- Nach Unternehmensgröße hielten Großunternehmen im Jahr 2025 70,55 % des Marktanteils am Datenklassifizierungsmarkt, während das KMU-Segment mit einer CAGR von 23,29 % wachsen soll.
- Nach Anwendung entfielen im Jahr 2025 56,12 % des Marktanteils am Datenklassifizierungsmarkt auf Zugangskontrolle und IAM; Governance und Compliance verzeichnen eine CAGR von 22,91 %.
- Nach Branchenvertikale trug BFSI im Jahr 2025 einen Umsatzanteil von 35,12 % bei; Regierung und Verteidigung ist auf ein CAGR-Wachstum von 21,78 % ausgerichtet.
- Nach Geografie dominierte Nordamerika im Jahr 2025 mit einem Anteil von 40,62 %, doch der asiatisch-pazifische Raum wird bis 2031 voraussichtlich eine CAGR von 22,07 % verzeichnen.
Hinweis: Die Marktgrößen- und Prognosezahlen in diesem Bericht werden mithilfe des proprietären Schätzrahmens von Mordor Intelligence erstellt und mit den neuesten verfügbaren Daten und Erkenntnissen bis 2026 aktualisiert.
Markttrends und Einblicke
Analyse der Auswirkungen von Treibern*
| Treiber | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Ausweitung globaler Datenschutzvorschriften | +4.2% | Global, mit konzentrierter Auswirkung in der EU, Nordamerika und dem asiatisch-pazifischen Raum | Mittelfristig (2–4 Jahre) |
| Explosives Wachstum unstrukturierter Daten und Datenschutzverletzungsrisiko | +3.8% | Global, besonders ausgeprägt in Nordamerika und Europa | Kurzfristig (≤ 2 Jahre) |
| Nachfrage nach Cloud-nativer Datenklassifizierung | +3.5% | Asiatisch-pazifischer Raum als Kern, Ausstrahlungseffekte auf den Nahen Osten und Afrika sowie Lateinamerika | Mittelfristig (2–4 Jahre) |
| KI/ML-gestützte automatische Klassifizierung im Produktionseinsatz in großem Maßstab | +3.1% | Nordamerika und EU führend, rasante Übernahme im asiatisch-pazifischen Raum | Kurzfristig (≤ 2 Jahre) |
| Vertrauliche Datenverarbeitung durch Chipsets, die Inline-Kennzeichnung ermöglichen | +2.4% | Nordamerika und ausgewählte EU-Märkte | Langfristig (≥ 4 Jahre) |
| GenAI-Sicherheit erfordert feinkörnige Datenkennzeichnung | +2.7% | Global, mit früher Übernahme in regulierten Branchen | Mittelfristig (2–4 Jahre) |
| Quelle: Mordor Intelligence | |||
Ausweitung globaler Datenschutzvorschriften
Die europäischen DORA-Vorschriften und aktualisierte HIPAA-Standards verlagern die Compliance von geplanten Prüfungen hin zur kontinuierlichen Überprüfung und verpflichten Unternehmen, Klassifizierungslogik direkt in Datenverarbeitungsworkflows einzubetten[1]US-Bundesregister, "Sicherheits- und Datenschutzkontrollen für föderale Informationssysteme," federalregister.gov. Multinationale Unternehmen, die in mehreren Rechtsordnungen tätig sind, wenden häufig die strengste globale Anforderung als Ausgangspunkt an, was die Einführung einheitlicher Klassifizierungsarchitekturen beschleunigt. Finanzinstitute müssen Berichte zur Geldwäschebekämpfung innerhalb von Minuten vorlegen, was die Nachfrage nach richtliniengesteuerter Erkennung erhöht. Ähnlicher Druck entsteht durch lateinamerikanische Datensouveränitätsgesetze, die sich an der DSGVO orientieren. Zusammen verkürzen diese Vorschriften die Beschaffungszyklen und drängen selbst mittelgroße Unternehmen zu SaaS-basierten Tools, die Richtlinien automatisch aktualisieren.
Explosives Wachstum unstrukturierter Daten und Datenschutzverletzungsrisiko
Unstrukturierte Repositories wachsen jährlich um 62 %, was Sicherheitsteams blind gegenüber dem Inhaber sensibler Datensätze macht. Unternehmen berichten von übermäßigen Berechtigungen bei 82 % der Dateifreigaben, wodurch wertvolle Entwürfe und Kundendaten gefährdet werden. Energieversorger verzeichnen mittlerweile 1.100 wöchentliche Cyberangriffe, und Untersuchungen von Datenschutzverletzungen zeigen falsch klassifizierte Dokumente als Grundursache. Anwaltskanzleien sind ähnlichen Risiken ausgesetzt, da Mandantendateien ohne Kennzeichnung in gemeinsam genutzten Laufwerken liegen. KI-gestützte Mustererkennung wird zunehmend bevorzugt, da statische Regelwerke mit dynamischen Kollaborationsplattformen nicht Schritt halten können.
Nachfrage nach Cloud-nativer Datenklassifizierung
Vierundsechzig Prozent der australischen Organisationen testen Souveränitätsstrategien, und fast die Hälfte der Behörden im öffentlichen Sektor des asiatisch-pazifischen Raums plant, solche Kontrollen innerhalb eines Jahres einzuführen. Klassifizierungsmaschinen müssen über Multi-Cloud-Umgebungen hinweg betrieben werden und dabei lokale Anforderungen an den Datenstandort einhalten. Microsofts Partnerschaft im Wert von USD 1,5 Milliarden mit dem in den Vereinigten Arabischen Emiraten ansässigen Unternehmen G42 unterstreicht die regionale Rechenkapazitätserweiterung, die auf integrierte Kennzeichnung zur Trennung regulierter Workloads angewiesen ist. Die Einführung souveräner Cloud zwingt Unternehmen, duale Richtlinienebenen aufrechtzuerhalten: globale Standards und jurisdiktionsspezifische Tags. Anbieter, die diese Zuordnung automatisieren, erzielen eine klare Differenzierung.
KI/ML-gestützte automatische Klassifizierung im Produktionseinsatz in großem Maßstab
Unternehmen berichten nun von 96-prozentigen Verbesserungen der Datenqualität, nachdem sie maschinelles Lernen auf bestehende Erkennungspipelines aufgesetzt haben. Forcepoint integrierte das selbstlernende Modell von Getvisibility, um langwierige Regelerstellung zu eliminieren und die Genauigkeit durch Live-Feedback zu verbessern. Microsoft Purview bietet mehr als 200 integrierte Informationstypen, die Inhalte in Exchange, SharePoint und SQL-Assets automatisch kennzeichnen. Steigende Modellpräzision reduziert Fehlalarme, was wiederum den Helpdesk-Aufwand senkt und die Benutzerakzeptanz beschleunigt. KMU profitieren am meisten, da ihnen zuvor die Ressourcen für manuelle Anpassungen fehlten.
Analyse der Auswirkungen von Hemmnissen*
| Hemmnis | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Fehlende branchenübergreifende Taxonomiestandards | -2.1% | Global, mit besonderen Herausforderungen in Schwellenmärkten | Langfristig (≥ 4 Jahre) |
| Hohe Integrationskosten in veralteten IT-Umgebungen | -1.8% | Nordamerika und Europa mit etablierter IT-Infrastruktur | Mittelfristig (2–4 Jahre) |
| "Klassifizierungsrückstand" durch die Verbreitung synthetischer Daten | -1.5% | Global, konzentriert in KI-intensiven Branchen und Regionen | Mittelfristig (2–4 Jahre) |
| Homomorphe Verschlüsselung verzögert die Klartextprüfung | -1.2% | Nordamerika und EU führend bei der Einführung, selektiver Unternehmenseinsatz | Langfristig (≥ 4 Jahre) |
| Quelle: Mordor Intelligence | |||
Fehlende branchenübergreifende Taxonomiestandards
Finanzaufsichtsbehörden klassifizieren Risikodaten anders als Gesundheitsbehörden, was Anbieter zwingt, branchenspezifische Regelbibliotheken zu pflegen. Multinationale Unternehmen müssen die DSGVO-Terminologie mit Chinas Definition von „wichtigen Daten” in Einklang bringen, wenn sie Dateien übertragen. Diese Fragmentierung treibt den Aufwand für individuelle Programmierung in die Höhe, verstärkt Bedenken hinsichtlich der Anbieterabhängigkeit und verlangsamt Kaufentscheidungen. Branchenverbände erarbeiten offene Schema-Vorschläge, doch die Übernahme bleibt uneinheitlich. Infolgedessen erzielen Systemintegratoren erhebliche Einnahmen aus Zuordnungsworkshops und nicht aus reinen Softwarelizenzen.
Hohe Integrationskosten in veralteten IT-Umgebungen
Betreiber kritischer Infrastrukturen betreiben noch immer Systeme, die vor mehr als 20 Jahren in Betrieb genommen wurden und häufig keine modernen APIs besitzen[2]Thales Group, "Bericht zur Cybersicherheit kritischer Infrastrukturen," thalesgroup.com. Die Nachrüstung von Klassifizierung in solchen Umgebungen überschreitet häufig 18 Monate, während derer Compliance-Risiken ungelöst bleiben. KMU erleben ähnliche Reibungsverluste, da knappes Sicherheitspersonal den Tagesbetrieb mit Transformationsprojekten in Einklang bringen muss. Budgetverantwortliche verschieben Klassifizierungseinführungen manchmal bis zu geplanten umfassenderen ERP-Upgrades. Anbieter fördern nun agentenlose Konnektoren und vorgefertigte Pipelines, um diese Kosten zu senken, doch die Komplexität bleibt ein wesentliches Hemmnis.
*Unsere Prognosen behandeln die Auswirkungen von Treibern und Einschränkungen als richtungsweisend und nicht additiv. Die Wirkungsprognosen berücksichtigen Basiswachstum, Mischungseffekte und Wechselwirkungen zwischen Variablen.
Segmentanalyse
Nach Komponente:
Dienstleistungen treiben das Wachstum über Softwarelizenzen hinausSoftware erzielte weiterhin den höchsten Umsatz und machte im Jahr 2025 67,92 % des Datenklassifizierungsmarkts aus. Der Lizenzverkauf konzentrierte sich auf Richtlinienmaschinen, Erkennungs-Crawler und SaaS-Dashboards. Dennoch skalieren professionelle und verwaltete Dienstleistungen mit einer CAGR von 23,62 %, da Unternehmen Orientierung benötigen, um langjährige Klassifizierungsrückstände abzubauen. Aufträge beginnen häufig mit Multi-Petabyte-Scans, die Rückstände bei der Behebung speisen und interne Ressourcen belasten. Anbieter verwalteter Dienste gleichen Qualifikationsmängel aus, indem sie Modell-Retraining, regulatorische Aktualisierungen und Ticket-Triage auf Abonnementbasis übernehmen. Diese Verträge können sich über mehrere Jahre erstrecken, was die Ausgaben von einmaligen Investitionsausgaben auf wiederkehrende Betriebsausgaben verlagert. Der Ansatz findet bei Vorständen Anklang, die vorhersehbare Budgets und prüfungsreife Nachweise anstreben. In monetären Begriffen könnten Dienstleistungen bis 2031 USD 2,16 Milliarden der Marktgröße des Datenklassifizierungsmarkts ausmachen, was ihre strategische Bedeutung widerspiegelt. Softwareanbieter bündeln daher Beratungskapazitäten in Premium-Tarifen, um Margen zu schützen.
Implementierungen der zweiten Generation setzen auf kontinuierliche Anpassung statt auf jährliche Gesundheitschecks. Servicepartner bauen DevSecOps-Pipelines auf, die eine Klassifizierung auslösen, sobald neue Daten in den Objektspeicher gelangen. Sie kodifizieren auch gemeinsame Taxonomien über Geschäftsbereiche hinweg, was die Onboarding-Zeiträume für Akquisitionen verkürzt. Der Trend erweitert den Datenklassifizierungsmarkt, da mittelgroße Unternehmen Expertise mieten können, anstatt knappe Spezialisten einzustellen. Anbieter-Marktplätze listen nun kuratierte Servicepakete auf, die auf ISO 27001, HIPAA oder PCI-Vorlagen abgestimmt sind, was die Einführung weiter demokratisiert. Da die Dienstleistungserlöse zunehmen, übernehmen Systemintegratoren Boutique-Beratungsunternehmen, um Domänenwissen zu stärken und Marktanteile zu sichern.
Notiz: Segmentanteile aller einzelnen Segmente sind nach dem Berichtskauf verfügbar


Nach Klassifizierungsmethode:
Maschinelles Lernen definiert Genauigkeitsmaßstäbe neuDie inhaltsbasierte Prüfung hielt im Jahr 2025 42,76 % der Ausgaben, indem sie reguläre Ausdrücke und Fingerprinting nutzte, um geistiges Eigentum zu kennzeichnen. Dennoch wachsen ML-gestützte und semantische Modelle mit einer CAGR von 22,44 %, indem sie Kontext aus Millionen gekennzeichneter Dokumente erlernen. Musterblindfähigkeiten, wie Transformer-Netzwerke, die Satzstrukturen analysieren, erhöhen die Trefferquoten und reduzieren Fehlalarme. Microsoft Purview trainiert auf globaler Telemetrie, was regelmäßige Modellaktualisierungen ohne Kundeneingriff ermöglicht. Digital Guardian schichtet kontextuelle Signale wie Standort und Gerätestatus über inhaltliche Hinweise, was eine risikogewichtete Kennzeichnung ermöglicht. Kombinierte Ansätze werden nun als vorkonfigurierte Pakete geliefert, sodass Administratoren neue Maschinen ohne Betriebsunterbrechung einführen können.
Frühe Anwender berichten, dass maschinelles Lernen die Produktivität der Prüfer um 35 % steigert, da weniger Elemente menschlicher Beurteilung bedürfen. Organisationen mit mehrsprachigen Archiven profitieren messbar, da semantische Modelle Sprachvarianz besser handhaben als manuelle Schlüsselwortlisten. Anbieter öffnen APIs zur Integration kundenspezifischer Ontologien und ermöglichen so maßgeschneiderte Genauigkeit ohne Neuentwicklung. Der Wandel stärkt den Datenklassifizierungsmarkt, da er eine ehemals elitäre Fähigkeit in ein SaaS-Standardmerkmal verwandelt. Trainingsdaten bleiben jedoch ein Engpass für Nischenbereiche, was einige Unternehmen dazu veranlasst, anonymisierte Korpora im Rahmen von Gegenseitigkeitsvereinbarungen zu teilen. Im Prognosezeitraum wird erwartet, dass die ML-Einführung die Zeit bis zur Wertschöpfung von Quartalen auf Wochen reduziert und ihre Rolle als Standardmethodik festigt.
Nach Unternehmensgröße:
Cloud-native Plattformen demokratisieren Kennzeichnung auf UnternehmensebeneGroßunternehmen trugen 2025 70,55 % des Umsatzes bei, bedingt durch regulatorische Exposition und Budgettiefe. Sie waren frühe Befürworter integrierter Governance-Suiten, die lokale Dateiserver und Multi-Cloud-Umgebungen umspannen. Dennoch stellen KMU nun das am schnellsten wachsende Segment mit einer CAGR von 23,29 % dar und profitieren von SaaS-Angeboten ohne Infrastrukturaufwand. Die meisten Plattformen werden innerhalb von Stunden bereitgestellt und erfordern nur leichtgewichtige Konnektoren für E-Mail, Zusammenarbeit und Objektspeicher. Abonnementtarife richten die Kosten am Verbrauch aus, was Einstiegspunkte für Unternehmen mit weniger als 500 Mitarbeitern erschwinglich macht. Auf Gesundheits-, Finanz- und Rechtsinhalte abgestimmte Vorlagen beschleunigen die Einführung, da KMU keine Vollzeit-Compliance-Beauftragten haben.
Bildungsressourcen, wie die von der Community geleiteten Workshops von Microsoft, senken die Hürden weiter, indem sie IT-Generalisten in der Verwaltung von Klassifizierungsrichtlinien schulen. Das PUZZLE-Framework bietet praktische Checklisten, mit denen KMU minimale tragfähige Sicherheit in Cloud-Workloads einbetten können. Branchenverbände verbreiten auch Open-Source-Regelpakete, damit Mitglieder ohne Ausgangspunkt starten können. Mit zunehmender Einführung sammeln Plattformanbieter Telemetrie, die die ML-Genauigkeit für alle Mandanten verbessert und ein Schwungrad schafft, das kleinere Unternehmen überproportional begünstigt. Das Muster motiviert Marktplätze, Nischenkonnektoren für Buchhaltungs-, Personal- und Kundenbeziehungssysteme aufzulisten, die im mittleren Marktsegment beliebt sind, und erweitert so die Abdeckung ohne individuelle Skripterstellung.
Nach Anwendung:
Governance und Compliance rücken in den MittelpunktZugangskontrolle und IAM machten 2025 56,12 % der Ausgaben aus, da kennzeichnungsgesteuerte Berechtigungen das Rückgrat von Zero-Trust-Richtlinien bilden. E-Mail- und Mobilschutz folgten, da verteilte Belegschaften sensible Dokumente über Chat- und BYOD-Kanäle teilen. Das schnellste Wachstum mit einer CAGR von 22,91 % liegt in Governance- und Compliance-Dashboards, die Kennzahlen für Regulierungsbehörden und Vorstände aufbereiten. Diese Tools beziehen Daten aus der Klassifizierungstelemetrie, um Datenspeicherort, Aufbewahrung und Herkunft zu visualisieren. Sie exportieren maschinenlesbare Berichte für automatisierte Sicherungsportale und reduzieren die Prüfungsvorbereitung von Wochen auf Stunden. Die Fähigkeit wird unter nahezu in Echtzeit geltenden Offenlegungspflichten wie der Cybersicherheits-Vorfallsregel der SEC kritisch.
Integrationen mit Risikobewertungsmaschinen ermöglichen es Compliance-Teams, die Behebung nach Datenkritikalität statt nach Dateianzahl zu priorisieren. Erweiterte Dashboards betten prädiktive Analysen ein, die potenzielle Bußgelder schätzen, wenn falsch gekennzeichnete Datensätze eine Region verlassen. Daher verlagern sich Ausgabenmuster von punktuellen DLP-Plugins hin zu einheitlichen Plattformen mit integrierten Analysen. Anbieter positionieren Compliance-Module als produktgesteuerte Wachstumshebel und bieten Freemium-Lizenztarife an, die Risikobefunde aufzeigen und Upselling zu vollständig ausgestatteten Suiten fördern. Die daraus resultierende Transparenz fördert die Unterstützung durch Führungskräfte und erweitert den Datenklassifizierungsmarkt über die Sicherheitsabteilung hinaus.

Notiz: Segmentanteile aller einzelnen Segmente sind nach dem Berichtskauf verfügbar
Nach Branchenvertikale:
Regierung und Verteidigung beschleunigen die AusgabenentwicklungBFSI erzielte 2025 35,12 % des Umsatzes, angetrieben durch Basel-III-Kapitalvorschriften und Verpflichtungen zur Geldwäschebekämpfung. Das Gesundheitswesen folgte, angetrieben durch die HIPAA-Modernisierung und den Vorstoß für elektronische Gesundheitsakten. Die schnellste Expansion mit einer CAGR von 21,78 % verzeichnen Regierung und Verteidigung, wo Zero-Trust-Anforderungen und Workflows für klassifizierte Informationen eine präzise Kennzeichnung erfordern. Das aktualisierte Informationssicherheitsprogramm des US-Verteidigungsministeriums verpflichtet Auftragnehmer, einheitliche Kennzeichnungsregeln für E-Mail, Kollaborationsplattformen und Cloud-Speicher anzuwenden. Validierungsfenster für Beschränkungen technischer Daten erstrecken sich nun auf 6 Jahre, was nachhaltige Dienstleistungserlöse sichert. Verteidigungsbehörden investieren auch in Inline-Kennzeichnung an Netzwerk-Gateways zur Unterstützung sicherer domänenübergreifender Lösungen.
Betreiber kritischer Infrastrukturen, wie Versorgungsunternehmen, die mit Smart-Grid-Analysen experimentieren, übernehmen zunehmend verteidigungsähnliche Praktiken, um staatlich geförderte Bedrohungen abzuwehren. Nationale Datenstrategien fordern souveräne Cloud-Einrichtungen, die wiederum eine durch Klassifizierungs-Tags durchgesetzte Mandantentrennung erfordern. Große Systemintegratoren bilden Joint Ventures mit Einrichtungen des öffentlichen Sektors, um Produkt-Roadmaps an Missionsbedürfnissen auszurichten. Da diese Verträge häufig inländisches Hosting vorschreiben, stärkt die Lokalisierung regionale SaaS-Präsenzen. Vertikale Spezialisierung wird daher zu einem Wettbewerbsvorteil und sichert stetige Zuflüsse in den Datenklassifizierungsmarkt.
Geografische Analyse
Markt für Datenklassifizierung in Nordamerika
Nordamerika behauptete seine Führungsposition mit einem Anteil von 40,62 % am Umsatz des Jahres 2025, da strenge Vorschriften und eine frühe KI-Einführung Unternehmen dazu veranlassten, ihre Datenerkennungsprogramme zu modernisieren. BigIDs Finanzierungsrunde in Höhe von 60 Millionen USD im Jahr 2025 verdeutlicht das Risikokapitalinteresse an Lösungen, die die Datenhygiene im Vorfeld neuer SEC-Offenlegungsvorschriften automatisieren. Finanzinstitute setzen Kennzeichnungen ein, um die Anforderungen an die Intraday-Berichterstattung zu erfüllen, während Gesundheitsdienstleister Tags in elektronische Patientenakten integrieren, um den sich weiterentwickelnden HIPAA-Erweiterungen zu entsprechen. Die Datenschutzgesetze der kanadischen Provinzen spiegeln die bundesstaatlichen Anforderungen wider und stärken eine gleichbleibend hohe Nachfrage. Mexikos Technologiezentren übernehmen cloudbasierte Plattformen, um die Datentransferklauseln des USMCA zu erfüllen, wobei die Nutzung jedoch auf multinationale Tochtergesellschaften konzentriert ist.
Markt für Datenklassifizierung im asiatisch-pazifischen Raum
Der asiatisch-pazifische Raum ist die am schnellsten wachsende Region mit einem CAGR von 22,07 %, was auf Sovereign-Cloud-Mandate und hohe Infrastrukturausgaben durch Hyperscaler zurückzuführen ist. AWS verpflichtete sich zu Investitionen in Höhe von 6 Milliarden USD in Malaysia, und NTT sagte 90 Millionen USD für Rechenzentren in Bangkok zu, wodurch lokale Rechenkapazitäten entstehen, die die Latenz für Richtlinien-Engines reduzieren. China schlägt eine Lockerung der Genehmigungen für ausgehende Daten vor, stuft jedoch viele Datensätze weiterhin als „wichtig” ein, was doppelte Kontrollen erzwingt. Japan und Südkorea setzen Klassifizierung in der 5G-Fertigung ein, um Geschäftsgeheimnisse zu schützen. Indiens IT-Dienstleistungsexporteure fordern mandantenfähige Kennzeichnung zur Trennung von Kundendaten, was den adressierbaren Pool an Cloud-Abonnenten erweitert.
Markt für Datenklassifizierung in Europa
Europa belegt einen soliden zweiten Platz nach Wert, angetrieben durch den Digital Operational Resilience Act, der bis 2025 kontinuierliche Kontrolltests vorschreibt. Deutschlands Industrie-4.0-Werke kennzeichnen operative Daten, um geistiges Eigentum zu schützen und Sicherheitsaudits der Lieferkette zu erfüllen. Das Vereinigte Königreich balanciert die Post-Brexit-Angemessenheit mit inländischen Innovationsregeln, sodass Unternehmen grenzüberschreitende Datenflüsse unter dualen Richtlinien überwachen. Frankreich fördert souveräne Cloud-Zonen für öffentliche Arbeitslasten, während Italien den Schutz kritischer Infrastrukturen verschärft. Die nordischen Länder, frühe DSGVO-Anwender, pilotieren nun Chips für vertrauliches Computing, die eine inline-Kennzeichnung ohne Offenlegung von Klartext ermöglichen, und positionieren die Region für Innovationen der nächsten Generation.

Regulatorisches Umfeld
Die Einführung der Datenklassifizierung wird direkt durch Sicherheits- und Datenschutzregelungen geprägt, die formalisieren, wie sensible Informationen gekennzeichnet, kontrolliert und teilweise im Inland gehalten werden müssen. In China bietet GB/T 43697-2024 (herausgegeben von der Staatlichen Verwaltung für Marktregulierung, in Kraft seit 1. Oktober 2024) einen strukturierten Ansatz zur Datenklassifizierung und -einstufung. Die Vorschriften der Volksrepublik China zur Netzwerkdatensicherheitsverwaltung (verabschiedet im August 2024, in Kraft seit 1. Januar 2025) verlangen einen kategorisierten und klassifizierten Schutz von Netzwerkdaten basierend auf ihrer Sicherheitsrelevanz, was die Compliance-Anforderungen für Unternehmen mit grenzüberschreitenden Datenflüssen erhöht.
In den Vereinigten Staaten bilden die NIST-Richtlinien weiterhin die Grundlage für operative Kontrollen und die Terminologie, die von vielen globalen Programmen verwendet wird, einschließlich NIST SP 800-53 Rev. 5 und NIST IR 8496 (2023) für die grundlegende Klassifizierungssprache, die Zero-Trust-Implementierungen unterstützt. Neuere Anforderungen an Souveränität und Datenresidenz entstehen ebenfalls: Die Executive Order Nr. 119 der Philippinen (unterzeichnet am 13. Juli 2026) etabliert einen verbindlichen staatlichen Rahmen zur Datenklassifizierung und Datenresidenz, der zwischen Daten mit eingeschränktem Zugang und Daten mit offenem Zugang unterscheidet. Dies verstärkt die jurisdiktionsbewusste Kennzeichnung und die Durchsetzung von Residenzanforderungen als Beschaffungsvoraussetzungen für betroffene Tools und Dienstleistungen.
Wertschöpfungskettenanalyse
Die Wertschöpfungskette beginnt mit der Definition von Richtlinien und Taxonomien, gefolgt von der Datenermittlung und Inventarisierung in strukturierten und unstrukturierten Repositorien. Sie geht weiter zur Ausführung der Klassifizierungs-Engine (Inhalt, Kontext, Rolle sowie ML-/semantische Modelle), gefolgt von der Richtliniendurchsetzung (IAM/ABAC, DLP, Verschlüsselung, Aufbewahrung), und endet mit Berichterstattung und Nachweisen für Audits und kontinuierliche Kontrollen. Hyperscaler und Governance-Plattformen (zum Beispiel Microsoft Purview und cloud-native Stacks von AWS und anderen) bieten integrierte Kontrollen und Konnektoren, während spezialisierte Anbieter tiefgehende Inhaltsanalysen und Datenschutz-Dashboards ergänzen. Die Bereitstellung erfolgt über Systemintegratoren, Managed Security Service Provider und Beratungsunternehmen, die Multi-Petabyte-Scans durchführen, Modelle optimieren, Sektortaxonomien abbilden und Richtlinienaktualisierungen pflegen, was die Marktverschiebung hin zu wiederkehrenden Dienstleistungen neben Software unterstützt.
Die wichtigsten Engpässe liegen bei der Taxonomieharmonisierung und den Integrationsebenen. Fragmentierte Definitionen über Branchen und Rechtsräume hinweg erhöhen den Anpassungsbedarf, während Altsysteme ohne moderne APIs die Bereitstellungszyklen verlängern und die Abhängigkeit von Dienstleistungen erhöhen. Souveräne Cloud- und regulierte Branchenarchitekturen bringen zusätzliche Anforderungen an kryptografische Kontrolle und Segmentierung mit sich, wie das Beispiel der Deutschen Telekom zeigt, die eine souveräne Datenplattform auf Google Cloud mit externem Schlüsselmanagement und formaterhaltender Verschlüsselung aufbaut, um die DSGVO und die deutschen Telekommunikationsdatenschutzanforderungen zu erfüllen. Standards und praktische Leitfäden wie der Entwurf des NIST NCCoE zur Erkennung und Kennzeichnung unstrukturierter Daten (SP 1800-39 IPD, Februar 2026) versorgen das Ökosystem mit umsetzbaren Referenzmustern, die Anbieter und Integratoren in gebündelte Beschleuniger umsetzen.
Wettbewerbslandschaft
Der Datenklassifizierungsmarkt weist eine moderate Fragmentierung auf, da Hyperscale-Cloud-Anbieter und spezialisierte Sicherheitsunternehmen um Plattformanteile konkurrieren. Microsoft Purview integriert Kennzeichnung über Azure, Microsoft 365 und SQL-Dienste und bietet eine zentrale Governance, die Großunternehmen anzieht. AWS, Google Cloud und IBM betten ähnliche Kontrollen in Speicher-APIs ein, was die Einführungshürden für Entwickler senkt. Spezialisierte Anbieter wie Varonis und BigID differenzieren sich durch tiefgehende Inhaltsanalysen und Datenschutz-Dashboards, die die Datenherkunft visualisieren. Aufstrebende Akteure wie Cyera konzentrieren sich auf Cloud-natives Datensicherheits-Positionsmanagement und ziehen rasche Finanzierungen an, was die Innovation beschleunigt.
Akquisitionsaktivitäten gestalten die Wettbewerbsdynamik um. Forcepoint erwarb Getvisibility, um selbstlernende Modelle mit seiner DLP-Maschine zu kombinieren und die Präzision über hybride Clouds zu verbessern. Capgemini kaufte Syniti, um Datenqualitätsdienste mit Governance-Beratung zu verbinden und das Mehrwertangebot zu erweitern. Snowflakes Übernahme von Reka AI und Databricks' Kauf von MosaicML verdeutlichen die Konvergenz von Analyse-, KI- und Kennzeichnungsfähigkeiten. Diese Schritte reagieren auf die Käuferpräferenz für konsolidierte Plattformen, die die Lizenzkomplexität reduzieren und Compliance-Nachweise integrieren.
Preismodelle entwickeln sich hin zu verbrauchsbasierten Tarifen, die an gescannte Terabytes und geschützte Nutzer geknüpft sind. Anbieter bündeln Starter-Kits mit vorgefertigten Taxonomien, um die Zeit bis zur Wertschöpfung zu beschleunigen. Kanalpartner entwickeln vertikale Beschleuniger, die Branchenvorschriften kodifizieren und so gebundene Ökosysteme schaffen. Wettbewerbsvorteile konzentrieren sich zunehmend auf nachweisbaren ROI, wobei Lieferanten Einsparungen bei Datenschutzverletzungskosten und Prüfungsressourcen vorweisen. Marktteilnehmer mit engen Punktlösungen stehen unter Druck, da Kunden sich um integrierte Suiten mit globalen Support-Netzwerken konsolidieren.
Marktführer im Bereich Datenklassifizierung
Amazon Web Services, Inc.
Boldon James Ltd (QinetiQ)
IBM Corporation
Microsoft Corporation
Broadcom Inc. (Symantec Corporation)
- *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert
Markt für Datenklassifizierung
- Amazon Web Services
- Microsoft Corporation
- IBM Corporation
- Broadcom (Symantec)
- Google LLC
- OpenText (TITUS)
- Thales Group
- Fortra (Boldon James)
- SECLORE
- Digital Guardian
- Forcepoint
- Varonis Systems
- BigID Inc.
- Concentric AI
- Netwrix Corporation
- Spirion LLC
- Immuta Inc.
- OneTrust LLC
- PKWARE Inc.
- Palo Alto Networks

Marktchancen und Zukunftsaussichten
Die Produktisierung der automatisierten Klassifizierung in zentralen Datenplattformen erweitert den adressierbaren Käuferkreis über eigenständige Tools hinaus, insbesondere für semistrukturierte und unstrukturierte Daten, die den Großteil der Compliance- und Sicherheitsverletzungsrisiken ausmachen. Im Jahr 2026 machte Snowflake die Klassifizierung sensibler Daten für semistrukturierte JSON-Datentypen (VARIANT, ARRAY, OBJECT) allgemein verfügbar. Databricks stellte die automatisierte Datenklassifizierung in Unity Catalog neben der attributbasierten Zugriffskontrolle allgemein bereit und ordnete sie explizit Compliance-Kontexten wie DSGVO und HIPAA zu. Die Einbettung auf Plattformebene schafft Freiräume für Anbieter und Dienstleister, um Konnektoren, Taxonomiepakete und Governance-Workflows zu liefern, die hybride Umgebungen abdecken und Kennzeichnungen direkt mit der Durchsetzung (Zeilen-/Spaltenkontrollen, DLP und Zugriffsrichtlinien) verknüpfen.
Es eröffnen sich auch Chancen im Zusammenhang mit Betriebsmodellen des KI-Zeitalters, in denen die Klassifizierung zur Voraussetzung für die sichere Nutzung von GenAI und für die Skalierung von Kontrollen über Kollaborations- und Cloud-Dienste wird. Cloudflare fügte die Datenklassifizierung in DLP-Profile ein (April 2026), und AWS führte einen KI-Agenten-Ansatz für die automatisierte Klassifizierung in Amazon SageMaker Catalog ein (März 2026), was einen Wandel hin zu agentengestützter Ermittlung und schnellerem Onboarding neuer Datensätze widerspiegelt. Das Käuferinteresse an prüffähigen, wiederholbaren Verfahren wird durch Leitfäden des öffentlichen Sektors wie den Entwurf SP 1800-39 des NIST NCCoE (Kommentierungsfrist bis 30. März 2026) verstärkt, der die Nachfrage nach Implementierungsdienstleistungen unterstützt, die Referenzarchitekturen in produktive Richtlinien, Testnachweise und Betriebsverfahren über regulierte Branchen und souveräne Cloud-Bereitstellungen hinweg umsetzen.
Recent Industry Developments in Markt für Datenklassifizierung
- Juli 2026: Microsoft begann mit einer öffentlichen Vorschau-Roadmap zur Integration von Microsoft Purview Data Loss Prevention mit Entra Internet Access, um klassifizierungsgesteuerte Kontrollen auf die Netzwerkebene auszuweiten. Die Roadmap zielt darauf ab, das Hochladen sensibler Daten an nicht autorisierte KI-Dienste und nicht verwaltete Ziele zu verhindern. Sie erweitert außerdem die Durchsetzung über Endpunkte und Dateien hinaus und verschärft die Governance in hybriden Arbeits- und SaaS-intensiven Umgebungen.
- Juni 2025: IBM stellte neue Software vor, um Governance und Sicherheit für agentenbasierte KI zu vereinheitlichen und Richtlinienkontrollen darauf abzustimmen, wie automatisierte Agenten auf Unternehmensdaten zugreifen und diese nutzen. Die Ankündigung verstärkt die Konvergenz von Datenklassifizierung, Governance-Nachweisen und KI-Sicherheitskontrollen innerhalb einheitlicher Plattformen. Für Käufer unterstützt dies Strategien zur Anbieterkonsolidierung, bei denen Klassifizierungs- und Durchsetzungstelemetrie in dieselbe Governance-Ebene einfließen.
- Dezember 2024: Microsoft kündigte neue Microsoft Purview-Funktionen an, die den Schutz und die Governance von Daten im KI-Zeitalter zum Ziel haben und erweitern, wie Sensitivitätskennzeichnungen und zugehörige Kontrollen in Microsoft-Umgebungen angewendet werden. Das Update erhöhte die praktische Abdeckung von Klassifizierung und Richtliniendurchsetzung über Kollaborations- und Datendienste hinweg. Es verstärkte außerdem den Sogeffekt integrierter Suiten, bei denen die Kennzeichnung direkt mit Zugriffskontrollen und Compliance-Berichterstattung verbunden ist.


Markt für Datenklassifizierung Berichtsumfang und Forschungsmethodik
Marktdefinition und Abdeckung
Dieser Markt umfasst Software und zugehörige Dienstleistungen, die zur Identifizierung, Kennzeichnung und Beschriftung von Unternehmensdaten verwendet werden, damit diese für Sicherheit, Governance und Compliance über Cloud-, On-Premises- und hybride Umgebungen hinweg korrekt behandelt werden können.
Ausschlüsse: Wir schließen allgemeine Datenkatalog-, Datenermittlungs- und Datenkennzeichnungstools aus, die hauptsächlich für das Training von KI-Modellen verwendet werden, wenn sie nicht als Datenklassifizierungsangebote verkauft oder positioniert werden.
Übersicht der Segmentierung
- Nach Komponente
- Software
- Dienstleistungen
- Nach Klassifizierungsmethode
- Inhaltsbasiert
- Kontextbasiert
- Nutzer-/Rollenbasiert
- ML-gestützt und semantisch
- Nach Unternehmensgröße
- Großunternehmen
- Kleine und mittlere Unternehmen (KMU)
- Nach Anwendung
- Zugangskontrolle und IAM
- Governance und Compliance
- E-Mail- und Mobilschutz
- Nach Branchenvertikale
- BFSI
- Gesundheitswesen und Biowissenschaften
- Regierung und Verteidigung
- IT und Telekommunikation
- Energie und Versorgungsunternehmen
- Sonstige Branchenvertikalen
- Nach Geografie
- Nordamerika
- Vereinigte Staaten
- Kanada
- Mexiko
- Europa
- Deutschland
- Vereinigtes Königreich
- Frankreich
- Italien
- Spanien
- Übriges Europa
- Asiatisch-pazifischer Raum
- China
- Japan
- Indien
- Südkorea
- Australien
- Übriger asiatisch-pazifischer Raum
- Südamerika
- Brasilien
- Argentinien
- Übriges Südamerika
- Naher Osten und Afrika
- Naher Osten
- Saudi-Arabien
- Vereinigte Arabische Emirate
- Türkei
- Übriger Naher Osten
- Afrika
- Südafrika
- Ägypten
- Nigeria
- Übriges Afrika
- Naher Osten
- Nordamerika
Datenquellen, Marktdimensionierung und Validierung
Sekundärforschung
Die Sekundärforschung beginnt mit dem Aufbau des Nachfragekontexts und des regulatorischen Hintergrunds für die Datenklassifizierung und ordnet dies dann dem typischen Ausgabeverhalten von Unternehmen für diese Tools und Dienstleistungen zu. Wir stützen uns hauptsächlich auf öffentliche, regulatorbezogene Quellen wie NIST-Richtlinien, CISA-Hinweise und die Cybersicherheits-Offenlegungsvorschriften der SEC, da diese Anforderungen die Einführungsprioritäten und Kaufzeitpläne beeinflussen.
Für Markteingaben prüfen wir auch Quellen wie US-Census- und Eurostat-Indikatoren zur digitalen Wirtschaft, OECD-Publikationen zur digitalen Sicherheit und ENISA-Berichte zu Cloud- und Datenschutzpraktiken. Diese werden ergänzt durch Jahresberichte von Unternehmen, Transkripte von Ergebnistelefonkonferenzen, Produktdokumentationen und renommierte Presseberichterstattung, damit wir Verpackung, Bereitstellungsmuster und die typische Käuferreise erfassen können. In einigen Fällen nutzen wir kostenpflichtige Abonnements für Unternehmensfinanzdaten und Patentdatenbanken, um die Richtung bei Umsatz und Innovationsintensität zu überprüfen, während die Liste der Sekundärquellen NIST, CISA und SEC weiterhin als Ankerpunkt für die Abdeckung dient. Die Liste der Sekundärquellen ist nicht erschöpfend, und zusätzliche Quellen wurden zur Gegenprüfung und Klärung verwendet.
Primärinterviews und Umfragen
Primärgespräche werden verwendet, um zu bestätigen, was als Ausgaben für Datenklassifizierung gilt, und um die wichtigsten Adoptionstreiber wie regulatorische Dringlichkeit, Cloud-Migration und die Reife der Sicherheitslage zu überprüfen. Wir sprachen mit einer Mischung aus Lösungsanbietern, Vertriebspartnern und Endnutzern in IT-, Sicherheits- und Risikoteams, wobei die Interviews APAC, EMEA und Amerika abdeckten, sodass regionale Kaufunterschiede im endgültigen Modell berücksichtigt werden.
Verteilung der Befragten der primären Feldforschung
| Unternehmenstyp | Position des Befragten | Region |
|---|---|---|
| Top-Tier: 38% | CXOs: 12% | APAC: 43% |
| Mid-Tier: 47% | Funktions-/Bereichsleiter: 29% | EMEA: 34% |
| Kleinere Anbieter: 15% | Manager: 59% | Amerika: 23% |
Marktdimensionierung & Prognose
Die Dimensionierung erfolgt nach Top-down- und Bottom-up-Logik. Wir beginnen mit einem Top-down-Nachfragepool, der aus den Ausgabemustern für Unternehmenssicherheit und Compliance rekonstruiert wird, und grenzen ihn dann auf den Anteil ein, der auf Anwendungsfälle der Datenklassifizierung zurückzuführen ist. Um das Modell fundiert zu halten, verankern wir es an Marktvariablen wie dem Wachstum der Unternehmensdatenmengen, dem Grad der Cloud- und Hybrid-Einführung, regulatorischer und Prüfaktivität, Trends bei Datenschutzverletzungen und Insider-Risiken sowie dem Anteil der Workloads, die Zugriffskontroll- und Governance-Kontrollen erfordern.
Nach der Festlegung des Nachfragepools bestätigen wir die Gesamtwerte anhand selektiver Bottom-up-Näherungen, einschließlich gestichprobter Umsatzsignale von Anbietern, Kanalprüfungen zu typischen Deal-Größen und einer ASP-Betrachtung nach Bereitstellungsart (Cloud-Abonnement versus On-Premises-Lizenzierung plus Dienstleistungen). Wo Produktbündel Messlücken erzeugen, werden Ausgaben nur zugeordnet, wenn die Klassifizierungsfunktionalität eindeutig bepreist, vertraglich vereinbart oder aktiv im Einsatz ist. Diese Zuordnungen werden anschließend anhand von Interview-Rückmeldungen erneut überprüft.
Die Prognose verwendet Szenarioanalysen mit kurzfristiger Trendglättung bei den wichtigsten Eingaben, da politische Änderungen und Sicherheitsvorfälle Budgets schnell verschieben können. Das Basisszenario wird anhand von Expertenmeinungen zum Tempo der Automatisierung in Klassifizierungs-Workflows, den erwarteten Serviceanbindungsraten und der Geschwindigkeit, mit der regulierte Branchen die Abdeckung über Datentypen hinweg ausweiten, angepasst.
Datenvalidierung & Aktualisierungszyklus
Die Validierung erfolgt durch wiederholte Gegenprüfungen im gesamten Modell. Wir vergleichen die Ergebnisse mit unabhängigen Indikatoren wie dem Wachstum von Sicherheitssoftware, der Expansion von Cloud-Workloads und berichteten Trends bei Compliance-Investitionen. Wenn ein Segment oder eine Region einen ungewöhnlichen Anstieg zeigt, überprüfen wir die zugrunde liegenden Treiberannahmen, und die Befragten werden erneut kontaktiert, wenn die Abweichung nicht durch öffentliche Indikatoren erklärt werden kann.
Vor der endgültigen Freigabe führen wir eine mehrstufige Überprüfung durch, damit Berechnungslogik, Währungsbehandlung und Jahresabgleich über Tabellen und Erläuterungen hinweg konsistent bleiben. Berichte werden jährlich aktualisiert, und Zwischenaktualisierungen erfolgen bei wesentlichen Ereignissen, wie größeren regulatorischen Durchsetzungsmaßnahmen oder starken Veränderungen der IT-Ausgaben von Unternehmen. Unmittelbar vor der Auslieferung führen wir einen erneuten Aktualisierungsdurchlauf durch, damit Kunden die aktuellste verfügbare Sicht erhalten.
Vergleich der Marktgröße für Datenklassifizierung von Mordor Intelligence mit anderen veröffentlichten Schätzungen
Veröffentlichte Marktwerte für Datenklassifizierung können stark voneinander abweichen, da der Markt unterschiedlich definiert wird, das Basisjahr nicht dasselbe ist und Dienstleistungen nicht immer konsistent behandelt werden. Wir stellen auch Lücken fest, bei denen Studien unterschiedliche Währungszeitpunkte verwenden, schnelleres Wachstum als beobachtet annehmen oder Annahmen nicht mit Praktikerfeedback überprüfen.
Ein häufiger Unterschied besteht darin, ob angrenzende Bereiche wie Datenermittlung, Katalogisierung oder breitere Data-Governance-Plattformen im selben Umsatzpool erfasst und dann als ein einziger Markt fortgeschrieben werden. Einige Schätzungen verwenden auch längere Prognosehorizonte, die sich naturgemäß zu größeren Endwerten aufaddieren, und sie wenden möglicherweise eine einzelne hohe CAGR an, ohne diese gegen kurzfristige Indikatoren wie regulierungsgetriebene Projekte oder das Tempo der Cloud-Migration zu testen. Mordor Intelligence begrenzt die Gesamtsumme auf Datenklassifizierungssoftware und zugehörige professionelle oder verwaltete Dienstleistungen und schließt breitere Plattformen aus, sofern die Klassifizierungsausgaben nicht getrennt und validiert werden können.
Vergleichsbenchmark
| Quelle | Marktgröße | Lücken in der Forschungsmethodik |
|---|---|---|
| Mordor Intelligence | 2,28 Mrd. USD (2026) | |
| Globale Unternehmensberatung A | 1,85 Mrd. USD (2024) | Verwendet ein früheres Basisjahr mit einem kürzeren Betrachtungszeitraum und wendet einen schnelleren Wachstumspfad bis 2030 an, was die Vorwärtskurve anheben kann, selbst wenn die kurzfristige Serviceanbindung geringer ausfällt. |
| Branchenverlag B | 1,94 Mrd. USD (2024) | Verwendet eine breite Segmentierungssicht und einen anderen Prognosezeitraum bis 2035, und der längere Zinseszinseffekt kann den Endmarktwert im Vergleich zu einer engeren mittelfristigen Prognose aufblähen. |
Die Tabelle zeigt, dass zeitliche und umfangbezogene Entscheidungen einen Großteil der Streuung erklären, noch bevor die Prognosetechnik berücksichtigt wird. Unser Ansatz bleibt auf spezifische Ausgabetreiber rückführbar, trennt Software von Dienstleistungen, wo möglich, und verwendet anschließend interviewbasierte Prüfungen, um die Gesamtsummen an dem auszurichten, was Käufer tatsächlich implementieren.


Im Bericht beantwortete Schlüsselfragen
Wie groß ist der Datenklassifizierungsmarkt derzeit?
Der Markt wird im Jahr 2026 auf USD 2,28 Milliarden geschätzt und soll bis 2031 USD 5,98 Milliarden erreichen, was einer CAGR von 21,28 % entspricht.
Welche Region wächst am schnellsten?
Der asiatisch-pazifische Raum verzeichnet das höchste Wachstum, wobei der Datenklassifizierungsmarkt bis 2031 voraussichtlich eine CAGR von 22,07 % aufweisen wird, bedingt durch souveräne Cloud-Mandate und Infrastrukturinvestitionen.
Welches Komponentensegment wächst am schnellsten?
Dienstleistungen wachsen mit einer CAGR von 23,62 %, da Organisationen professionelle Beratung benötigen, um KI-gestützte Kennzeichnung in hybriden Umgebungen einzuführen und zu pflegen.
Wie wirken sich Methoden des maschinellen Lernens auf die Einführung aus?
ML-gestützte Klassifizierung verbessert die Genauigkeit, reduziert Fehlalarme und verringert den manuellen Anpassungsaufwand, was kleineren Unternehmen den Zugang zu Schutz auf Unternehmensebene ermöglicht.
Welche Branchen investieren am stärksten?
BFSI führt bei den aktuellen Ausgaben dank strenger Vorschriften, während Regierung und Verteidigung mit einer CAGR von 21,78 % das schnellste Wachstum aufgrund nationaler Sicherheitsanforderungen verzeichnen.
Was ist ein wesentliches Hemmnis für eine breitere Einführung?
Die Integration von Klassifizierung in veraltete IT-Umgebungen bleibt kostspielig und zeitaufwendig, insbesondere für Betreiber kritischer Infrastrukturen, die noch immer veraltete Systeme betreiben.
Seite zuletzt aktualisiert am:



