
Marktgröße und Marktanteil im Bereich Datenvorbereitung
Marktübersicht
| Studienzeitraum | 2020 - 2031 |
|---|---|
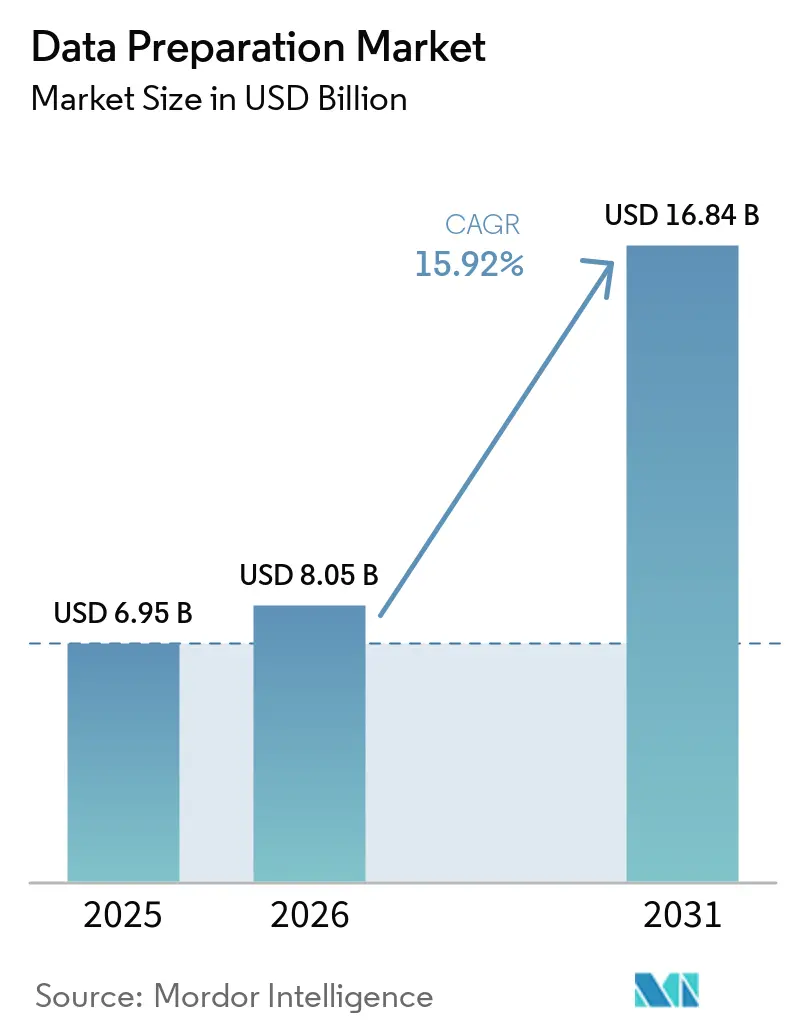
| Marktgröße (2026) | 8.05 Milliarden US-Dollar |
| Marktgröße (2031) | 16.84 Milliarden US-Dollar |
| Wachstumsrate (2026 - 2031) | 15.92 % |
| Schnellstwachsender Markt | Asien-Pazifik |
| Größter Markt | Nordamerika |
| Marktkonzentration | Mittel |
Hauptakteure *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert Bild © Mordor Intelligence. Wiederverwendung erfordert Namensnennung gemäß CC BY 4.0. | |
Analyse des Marktes für Datenvorbereitung von Mordor Intelligence
Die Marktgröße für Datenvorbereitung wird voraussichtlich von 6,95 Milliarden USD im Jahr 2025 auf 8,05 Milliarden USD im Jahr 2026 wachsen und soll bis 2031 bei einer CAGR von 15,92 % über den Zeitraum 2026–2031 einen Wert von 16,84 Milliarden USD erreichen. Diese Expansion spiegelt den Anstieg der KI-fähigen Infrastruktur wider, da Unternehmen generative KI in alltägliche Arbeitsabläufe integrieren; die Einführungsrate hat 83 % der Organisationen in China und vollständige Produktionseinführungen bei 24 % der Unternehmen in den Vereinigten Staaten erreicht[1]. Die zunehmende Verbreitung von Daten-Governance-Programmen, die mittlerweile in 71 % der Organisationen vorhanden sind, verglichen mit 60 % im Jahr 2023, stärkt die Ausgaben für systematische Datenvorbereitungstools.
Wichtigste Erkenntnisse des Berichts
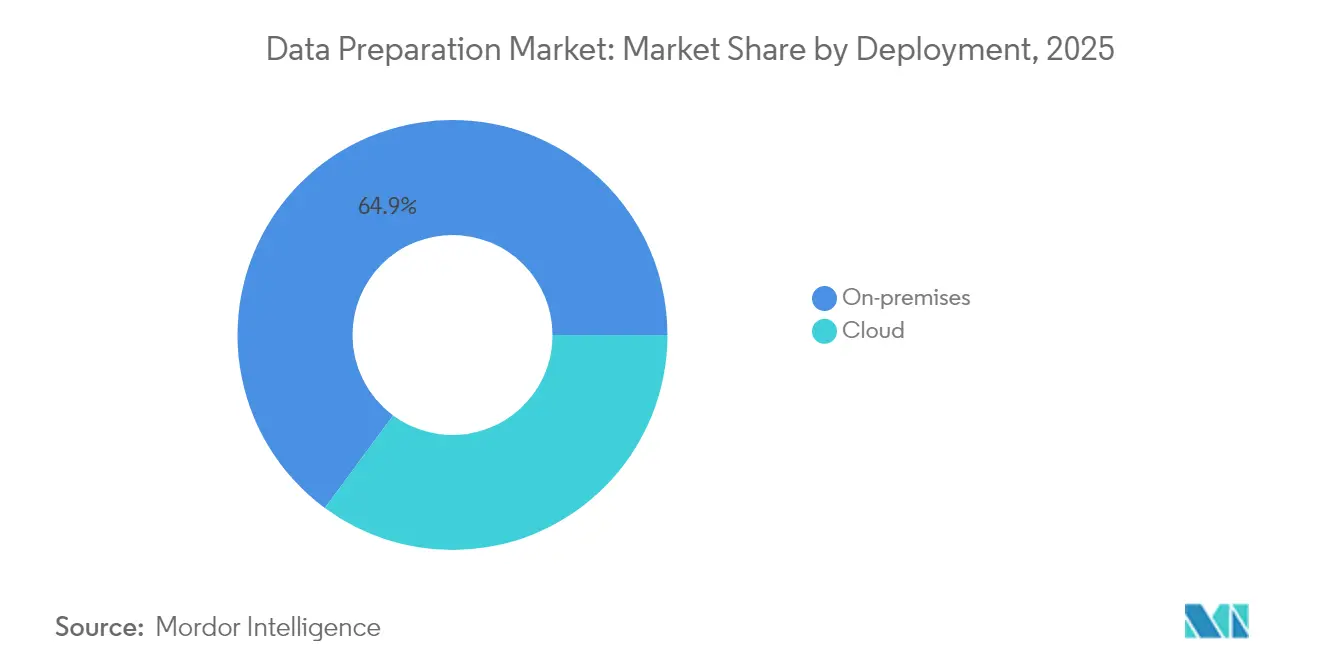
- Nach Bereitstellung hielten On-Premises-Plattformen im Jahr 2025 einen Marktanteil von 64,88 % am Markt für Datenvorbereitung; Cloud-Modelle werden voraussichtlich bis 2031 mit einer CAGR von 17,12 % wachsen.
- Nach Unternehmensgröße führten Großunternehmen mit einem Umsatzanteil von 68,05 % im Jahr 2025, während KMU mit einer CAGR von 17,62 % bis 2031 zulegen.
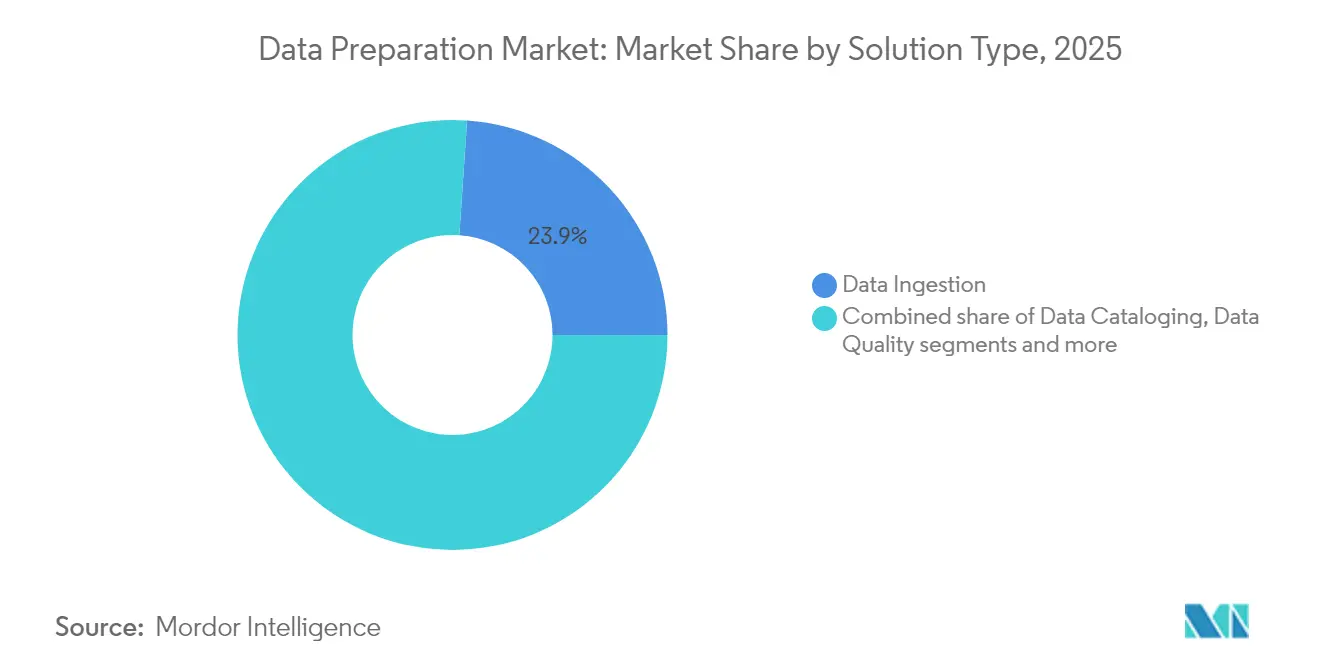
- Nach Lösungstyp entfiel auf Datenerfassung ein Anteil von 23,92 % am Umsatz 2025; Datenverwaltungslösungen werden bis 2031 mit einer CAGR von 16,74 % wachsen.
- Nach Endnutzerbranche entfielen auf IT und Telekommunikation 22,35 % des Umsatzes 2025; Gesundheitswesen und Biowissenschaften verzeichnen die schnellste CAGR von 16,31 % bis 2031.
- Nach Geografie hielt Nordamerika im Jahr 2025 einen Umsatzanteil von 36,62 %; Asien-Pazifik weist mit einer CAGR von 16,98 % die stärkste Wachstumsprognose bis 2031 auf.
Hinweis: Die Marktgrößen- und Prognosezahlen in diesem Bericht werden mithilfe des proprietären Schätzrahmens von Mordor Intelligence erstellt und mit den neuesten verfügbaren Daten und Erkenntnissen bis 2026 aktualisiert.
Markttrends und Einblicke
Analyse der Auswirkungen von Wachstumstreibern*
| Treiber | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Low-Code-/No-Code-Self-Service-Analysetools | +3.2% | Weltweit, angeführt von Nordamerika und Europa | Mittelfristig (2–4 Jahre) |
| Cloud-Einführung durch KMU-Analyseteams | +2.8% | Weltweit, mit höchstem Wachstum in Asien-Pazifik | Kurzfristig (≤ 2 Jahre) |
| Generative-KI-Copiloten in Datenvorbereitungs-Workflows | +3.5% | Kernregionen Nordamerika und Asien-Pazifik, Ausweitung auf Europa | Mittelfristig (2–4 Jahre) |
| Bündelung von Anbietern in Datenfabrik-Suiten | +2.1% | Weltweit, Unternehmensfokus in entwickelten Märkten | Langfristig (≥ 4 Jahre) |
| Branchenspezifische KI-Datenvorbereitungs-Pipelines | +2.4% | Nordamerika und Europa, Ausweitung auf Asien-Pazifik | Mittelfristig (2–4 Jahre) |
| Regulierung zur Datensouveränität und Repatriierung | +1.8% | Asien-Pazifik und Europa, regulatorischer Fokus | Langfristig (≥ 4 Jahre) |
| Quelle: Mordor Intelligence | |||
Beschleunigter Wandel hin zu Low-Code-/No-Code-Self-Service-Analysetools
Low-Code-Oberflächen definieren den Markt für Datenvorbereitung neu, indem sie Fachspezialisten ermöglichen, Pipelines per Drag-and-Drop-Design statt durch Skripte zu erstellen. Googles BigQuery-Datenvorbereitung in der Cloud veranschaulicht diesen Trend und bietet KI-gestützte Anleitungen, die Daten mit natürlichsprachlichen Eingaben bereinigen, profilieren und transformieren[2]. Dieser Ansatz verringert die Abhängigkeit von knappen Dateningenieuren, verkürzt Entwicklungszyklen und stimmt die Bereitstellung von Analysen mit Domänenkenntnissen ab. Die Erweiterung durch generative KI verbreitet sich schnell; Branchenprognosen deuten darauf hin, dass bis 2026 nahezu alle BI-Plattformen generative KI integrieren werden. Die Einführung erfordert jedoch eine sorgfältige Verwaltung, um sicherzustellen, dass die zunehmend von Fachanwendern erstellten Abläufe mit den Qualitäts- und Sicherheitsstandards des Unternehmens übereinstimmen.
Starke Cloud-Einführung bei KMU-Analyseteams
KMU skalieren Cloud-native Pipelines, um Fähigkeitslücken gegenüber größeren Wettbewerbern zu schließen, und treiben die inkrementelle Nachfrage in Asien-Pazifik voran, wo 60 % der Unternehmen bis 2025 die Implementierung von KI-Sprachmodellen planen. Cloud-Elastizität und verbrauchsbasierte Preisgestaltung ermöglichen es kleineren Unternehmen, Kapitalausgaben zu vermeiden und gleichzeitig auf erweiterte Datenvorbereitungsfunktionen zuzugreifen. Britische Forschungsergebnisse zeigen, dass heute weniger als 1 % der KMU Big-Data-Analysen nutzen, was das Wachstumspotenzial unterstreicht, wenn Kosten- und Komplexitätshürden sinken. Dennoch bestehen weiterhin Fachkräftemangel; Managed-Service-Anbieter übernehmen die Konfiguration von Pipelines und die Durchsetzung von Compliance-Anforderungen, insbesondere im Hinblick auf neue Datenlokalisierungsvorschriften.
Integration von generativen KI-Copiloten in Datenvorbereitungs-Workflows
Fünfundsiebzig Prozent der Organisationen beabsichtigen, generative KI innerhalb von zwölf Monaten zu finanzieren, was KI-Copiloten zu einem zentralen Element von Transformationsstrategien macht. Copiloten automatisieren aufwändiges Profiling, schlagen optimale Verknüpfungen vor und markieren Anomalien, wodurch die 94 % der Projektzeit, die traditionell für die Bereinigung aufgewendet werden, komprimiert werden. Die Interaktion in natürlicher Sprache senkt die Anforderungen an Fachkenntnisse, obwohl automatisierte Ergebnisse weiterhin Governance-Prüfpunkte durchlaufen müssen, die die Herkunft verfolgen und die Genauigkeit validieren. Die Investitionsdynamik ist in datenintensiven Branchen wie Telekommunikation und Finanzwesen am höchsten, wo selbst marginale Zeiteinsparungen einen erheblichen ROI erzielen.
Bündelung von Datenvorbereitungsmodulen durch Anbieter in umfassendere Datenfabrik-Suiten
Übernahmen wie die von Salesforce und Informatica veranschaulichen die Konsolidierung hin zu einheitlichen Datenfabriken, die Katalog, Qualität, Herkunft und Orchestrierung vereinen. Die Strategie vereinfacht den Integrationsaufwand durch die Bereitstellung eines durchgängigen Arbeitsbereichs von der Erfassung bis zur BI und verbessert die Konsistenz über Multi-Cloud-Umgebungen hinweg. Der Trend zur Komplettlösung birgt jedoch Risiken der Anbieterabhängigkeit und schränkt die Plug-and-Play-Flexibilität ein. Unternehmen evaluieren Standards wie OpenLineage und Apache Arrow, um Wahlmöglichkeiten zu erhalten.
Analyse der Auswirkungen von Hemmnissen*
| Hemmnis | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Fachkräftemangel für die Konfiguration der Datenverwaltung | -2.3% | Weltweit, besonders ausgeprägt in Schwellenmärkten | Mittelfristig (2–4 Jahre) |
| Hohe Gesamtbetriebskosten für Multi-Cloud-Datenpipelines | -1.9% | Nordamerika und Europa | Kurzfristig (≤ 2 Jahre) |
| Zunehmende Strafen für Datensouveränitätsverstöße | -1.4% | Asien-Pazifik und Lateinamerika | Mittelfristig (2–4 Jahre) |
| Rechenintensive Aufgaben unterliegen CO₂-Quoten | -1.1% | Europa und Nordamerika | Langfristig (≥ 4 Jahre) |
| Quelle: Mordor Intelligence | |||
Fachkräftemangel für die komplexe Konfiguration der Datenverwaltung
Fast ein Drittel der CIOs nennt die Komplexität des Datenmanagements als kritisches Hindernis, und der Mangel an Governance-Spezialisten verzögert die Einführung skalierbarer Pipelines[3]. Die Herausforderung verschärft sich, wo Gesetze wie Kaliforniens Klimaoffenlegungsregel die automatisierte Erfassung von Scope-1-3-Emissionen vorschreiben. Schwellenmärkte sind von tieferem Fachkräftemangel betroffen, da akademische Programme hinterherhinken, was Unternehmen dazu zwingt, auf externe Berater und Managed-Service-Verträge zurückzugreifen, die die Bereitstellungsbudgets erhöhen.
Hohe Gesamtbetriebskosten für Multi-Cloud-Datenpipelines
Die Mehrheit der Multi-Cloud-Programme verfehlt die ROI-Ziele, da Integrations-, Replikations- und Überwachungskosten schneller steigen als prognostiziert. Regionsspezifische Speicheranforderungen, die durch Lokalisierungsgesetze vorgeschrieben werden, erhöhen die Ausgaben weiter, da Unternehmen die Infrastruktur über Zonen hinweg duplizieren. Der Betriebsaufwand kann 25 % der gesamten Cloud-Budgets übersteigen, sobald Sicherheits- und Herkunftstools hinzugefügt werden, was mittelständische Käufer unter Druck setzt, zwischen architektonischer Eleganz und Erschwinglichkeit abzuwägen.
*Unsere Prognosen behandeln die Auswirkungen von Treibern und Einschränkungen als richtungsweisend und nicht additiv. Die Wirkungsprognosen berücksichtigen Basiswachstum, Mischungseffekte und Wechselwirkungen zwischen Variablen.
Segmentanalyse
Nach Bereitstellung:
Cloud-Beschleunigung gleicht On-Premises-Dominanz ausDie Marktgröße für Datenvorbereitung bei On-Premises-Plattformen belief sich 2025 auf USD 4,51 Milliarden, was einem Marktanteil von 64,88 % entspricht – ein Ausdruck der Unternehmensnachfrage nach direkter Kontrolle angesichts strengerer Lokalisierungsvorschriften. Vietnams Datengesetz und Indiens Regeln zum Schutz digitaler personenbezogener Daten stärken On-Premises- und Datensouveränitäts-Cloud-Modelle, die sensible Daten innerhalb nationaler Grenzen halten. Cloud-Dienste sind zwar kleiner, werden aber bis 2031 voraussichtlich mit 17,12 % wachsen, da KMU und digital native Einheiten Agilität priorisieren. In Nordamerika dominieren hybride Konzepte, die lokale Cluster für regulierte Daten mit Hyperscale-Reservoirs für risikoärmere Workloads verbinden. Cloud-Anbieter reagieren mit dedizierten regionalen Instanzen und verschlüsselter Schlüsselkontrolle, um Compliance-Bedenken zu zerstreuen, und weiten die Einführung über traditionelle Technologiezentren hinaus aus, da kleinere Städte direkten Glasfaseranschluss erhalten.
Die wirtschaftliche Kalkulation hängt von der Workload-Variabilität ab: Gleichmäßige ETL-Batches und vorhersehbare Anreicherungsaufgaben verbleiben aufgrund der Lizenzamortisierung On-Premises, während burstige KI-Inferenz und Sandboxes für Fachanwender zu nutzungsbasierten Clouds migrieren. Mehr als die Hälfte der multinationalen Unternehmen wird bis 2029 voraussichtlich Datensouveränitäts-Cloud-Instanzen betreiben, was die Nachfrage nach nahtloser Richtliniendurchsetzung über private, öffentliche und Edge-Knoten hinweg schafft. Anbieter betonen nun einheitliche Steuerungsebenen, die Datenqualitätsregeln und Herkunftsgraphen unabhängig vom Substrat propagieren.



Nach Unternehmensgröße:
KMU treiben künftiges Wachstumspotenzial trotz Führung durch Großunternehmen voranGroßunternehmen erwirtschafteten 2025 einen Umsatz von USD 4,73 Milliarden, was 68,05 % des Marktes für Datenvorbereitung entspricht, unterstützt durch dedizierte Governance-Teams und globale Präsenz. Ihre Ausgaben bevorzugen Plattformbündel, die Katalog, Herkunft und Beobachtbarkeit in bestehende Datenfabriken integrieren. Demgegenüber trugen KMU USD 2,22 Milliarden bei, werden aber andere Kohorten mit einer CAGR von 17,62 % übertreffen und die Marktgröße für KMU-Lösungen bis 2031 auf prognostizierte USD 5,02 Milliarden heben. Verbrauchsbasierte Abrechnung und automatisierte Schema-Erkennung reduzieren Kapitalhürden und ermöglichen es regionalen Einzelhändlern, Fintechs und SaaS-Start-ups, mit etablierten Unternehmen gleichzuziehen.
Eine Umfrage des Small Business Institute Journal zeigt, dass 70 % der US-amerikanischen KMU den Wert von Analysen anerkennen, aber nur eine Minderheit über internes Talent verfügt, um durchgängige Pipelines umzusetzen. Low-Code-Cloud-Workbenches und Managed-Service-Ökosysteme schließen Lücken, während Branchenverbände modulare Schulungen anbieten, um die Nutzung durch Fachanwender zu beschleunigen. Herausforderungen bestehen weiterhin bei der Entwicklung von Richtlinienrahmen, die auf neue KI-Gesetzesverpflichtungen abgestimmt sind, was Chancen für Kanalpartner schafft, die auf Compliance-Overlays spezialisiert sind.
Nach Lösungstyp:
Datenverwaltung gewinnt an Fahrt, während Datenerfassung die Führung behältDie Datenerfassung behielt mit 23,92 % einen dominierenden Anteil am Umsatz 2025 und unterstreicht den grundlegenden Bedarf, strukturierte, halbstrukturierte und unstrukturierte Datenströme für die nachgelagerte Verarbeitung zu erfassen. Governance-Module werden jedoch mit der schnellsten CAGR von 16,74 % wachsen, was den regulatorischen Wandel hin zu prüfungsfähigen ESG- und KI-Ethik-Offenlegungen widerspiegelt. Die Marktgröße für Datenverwaltungstools wird bis 2031 voraussichtlich USD 3,74 Milliarden erreichen. Integrierte metadatengesteuerte Kataloge fügen nun automatisierte Richtlinienprüfungen hinzu und machen Herkunftsvisualisierungen zum zentralen Element des Risikomanagements. Synthetische Datengeneratoren integrieren Datenschutzmechanismen und erweitern gleichzeitig KI-Trainingsdatensätze, was Unternehmen hilft, Minimierungsanforderungen zu erfüllen, ohne die Modellgenauigkeit zu beeinträchtigen.
Angrenzende Kategorien – Qualität, Datenaufbereitung, Anreicherung – konsolidieren sich zu einzelnen UI-Schichten. Produkt-Roadmaps priorisieren kontextbewusste Vorschläge, die bevorzugte Geschäftsregeln erlernen und Standardisierungsmuster vorschlagen. Anbieter umwerben Partner-Ökosysteme, um branchenspezifische Vorlagen zu bündeln, wie z. B. HL7-FHIR-Normalisierer für das Gesundheitswesen oder FIX-Protokoll-Mapper für das Finanzwesen, was die Wertschöpfungszeit verkürzt und Wechselkosten erhöht.

Nach Endnutzerbranche:
Gesundheitswesen wächst stark, während IT und Telekommunikation an der Spitze bleibtIT und Telekommunikation buchten 2025 USD 1,55 Milliarden, was 22,35 % des Marktes für Datenvorbereitung entspricht, angetrieben durch 5G-Rollouts, die Telemetriedaten erzeugen, die eine schnelle Bereinigung und Anreicherung erfordern. Betreiber setzen auf KI zur Optimierung der Netzwerkauslastung und zur Vorhersage von Kundenabwanderung, was die Ausgaben für hochdurchsatzfähige Pipeline-Automatisierung antreibt. Gesundheitswesen und Biowissenschaften werden mit USD 1.018 Millionen im Jahr 2025 mit der schnellsten CAGR von 16,31 % wachsen, da Krankenhäuser Patientenpfade digitalisieren und Pharmaunternehmen Multi-Omics-Datensätze für die Arzneimittelentwicklung orchestrieren. Die Branche für Datenvorbereitung sieht sich strengen HIPAA-, DSGVO- und bevorstehenden EU-KI-Gesetz-Anforderungen gegenüber, die Governance-Module zum unverzichtbaren Standard erheben.
Banken, Finanzdienstleistungen und Versicherungen (BFSI) setzen generative KI für die Betrugserkennung und hyperpersonalisierte Beratung ein – China verzeichnet bereits eine organisatorische Nutzung von 83 % – und legen großen Wert auf Erklärbarkeit und Herkunft, um Aufsichtsgremien zu befriedigen. Einzelhändler setzen Kundengraphen-Anreicherung ein, um Empfehlungs-APIs zu speisen und Scope-3-Emissionen zu messen, indem sie Transaktionsdaten mit Lieferantenprüfungen verknüpfen, um aufkommenden Nachhaltigkeitsverpflichtungen gerecht zu werden. Regierungsprogramme nutzen Open-Data-Portale und interne Dashboards für evidenzbasierte Politik, obwohl Budgetobergrenzen und Beschaffungszyklen die Projektzeitpläne verlängern.
Geografische Analyse
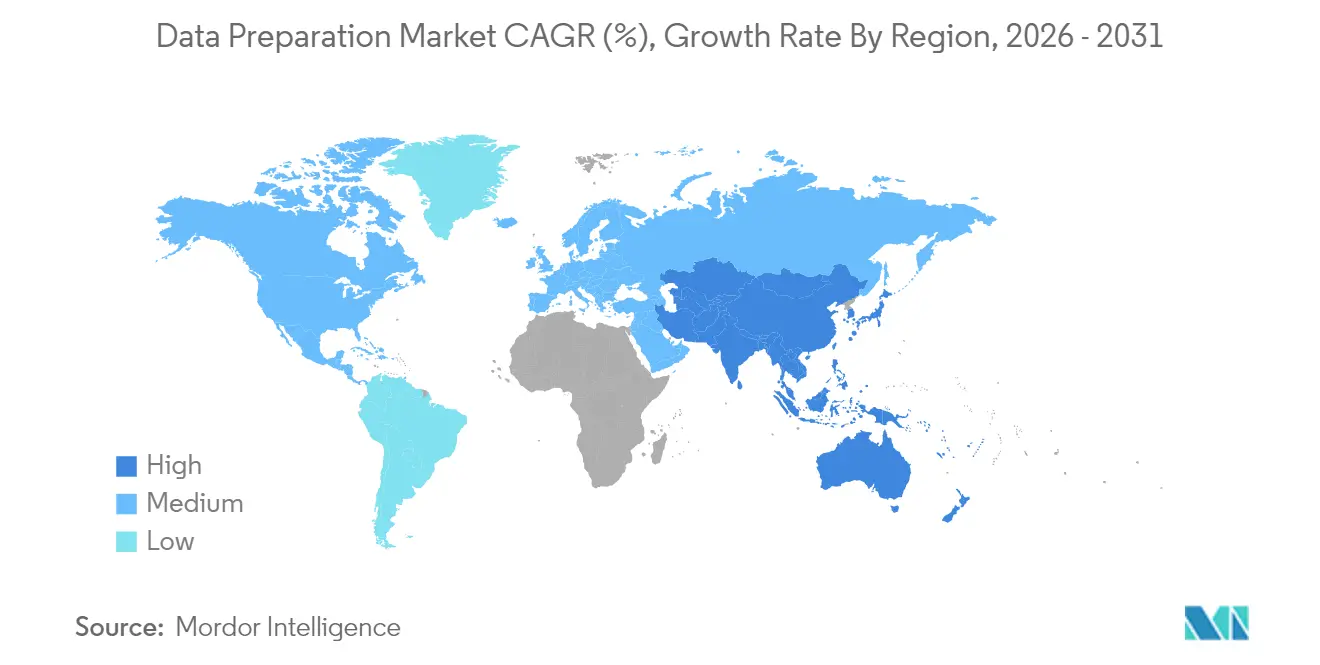
Markt für Datenvorbereitung in Nordamerika
Nordamerikas Ausgaben von 2,54 Milliarden USD im Jahr 2025 spiegelten einen Marktanteil von 36,62 % im Bereich Datenvorbereitung wider – ein Ergebnis früher KI-Experimente und dichter Anbieter-Ökosysteme. Kaliforniens Klimaoffenlegungsgesetz verpflichtet Unternehmen mit einem Umsatz von über 1 Milliarde USD zur Veröffentlichung von Scope-1-3-Emissionen und stärkt damit die Nachfrage nach Governance-Tools auf dem gesamten Kontinent. Multinationale Unternehmen mit Hauptsitz außerhalb der USA, die jedoch in den Vereinigten Staaten tätig sind, müssen ebenfalls berichten, was den Einfluss über die Landesgrenzen hinaus ausdehnt. Kanada treibt parallele Rahmenbedingungen durch das Verbraucherdatenschutzgesetz des Gesetzentwurfs C-27 voran, während Mexikos Vorschläge zur Datenlokalisierung hybride Cloud-Konzepte für grenzüberschreitende Maquiladora-Lieferketten anstoßen. Der Investitionsschwerpunkt der Region hat sich von anfänglichen Erfassungsfähigkeiten hin zu erweiterter Beobachtbarkeit und automatisierter Fehlerbehebung verlagert, die den operativen Aufwand reduzieren.
Markt für Datenvorbereitung im asiatisch-pazifischen Raum
Der asiatisch-pazifische Raum ist der am schnellsten wachsende Markt mit einer jährlichen Expansion von 16,98 %, da das Wachstum der öffentlichen Cloud andere Regionen übertrifft. Chinas GenKI-Adoptionsrate von 83 % manifestiert sich in einer aggressiven Modernisierung der Datenpipelines, während Südkorea und Japan nationale KI-Mittel für die Digitalisierung von Gesundheitsakten und Programme für intelligente Fabriken bereitstellen. Vietnams Datenschutzgesetz und Indiens Datenschutzregeln für digitale personenbezogene Daten lösen Datenhaltungsschichten innerhalb multinationaler Infrastrukturen aus, was lokale Edge-Deployments vor Ort verstärkt und die Nachfrage nach integrierten Richtlinien-Engines ankurbelt. Australische Unternehmen sehen sich neuen Verpflichtungen zur Sicherheit kritischer Infrastrukturen gegenüber, die eine Echtzeit-Anomalieerkennung in vorgelagerten Datenvorbereitungsstufen erfordern. Unterdessen treiben Singapurs IMDA-Förderprogramme kleine und mittlere Unternehmen zu Cloud-Diensten und stärken den Massenmarkt-Schwung der Region.
Markt für Datenvorbereitung in Europa
Europa verzeichnet ein stetiges Wachstum im mittleren zweistelligen Bereich, da ESG-Vorgaben Investitionen in berichtsbereite Datenpipelines antreiben. Die EU-Richtlinie zur Nachhaltigkeitsberichterstattung von Unternehmen verpflichtet rund 50.000 Unternehmen zur Erfassung von Treibhausgasmetriken anhand einheitlicher Taxonomien, was Datenkatalog- und Qualitätswerkzeuge auf die Agenda der Unternehmensführung hebt. Deutschland und Frankreich führen die Ausgaben an, obwohl der Schwung in Italien und Spanien zunimmt, da Fördermittel aus der Aufbau- und Resilienzfazilität digitale Transformationsprojekte finanzieren. Das EU-KI-Gesetz erfordert Transparenz, Bias-Überwachung und Protokolle zur menschlichen Aufsicht, was den Bedarf an sicheren Herkunftsarchiven vertieft, die Edge-Knoten und Hyperscaler-Zonen umspannen. Osteuropäische Staaten bauen lokale Cloud-Kapazitäten aus, um Bürgerdaten im Inland zu halten, und fördern damit Partnerschaften zwischen regionalen Telekommunikationsunternehmen und globalen Hyperscalern.
Wertschöpfungskettenanalyse
Die Wertschöpfungskette der Datenaufbereitung beginnt mit vorgelagerten Datenquellen, einschließlich Unternehmensanwendungen wie ERP/CRM, operativen Datenbanken, IoT/Telemetrie, Protokollen, Dokumenten und Datensätzen von Drittanbietern, sowie der Infrastruktur, die diese speichert und verarbeitet, wie On-Premise-Datenplattformen und Cloud-Data-Warehouses und Lakehouse-Speicher. Datenaufnahme und Konnektivität bilden den ersten Engpass in der Ausführung, an dem verwaltete Konnektoren, API-Governance und Change-Data-Capture-Muster bestimmen, wie schnell Teams neue Quellen einbinden und Pipelines stabil halten können. Jüngste Plattform-Schritte hin zu größeren Konnektor-Bibliotheken, beispielsweise die Erweiterung von Databricks Lakeflow Connect auf über 100 native, verwaltete Konnektoren im Juni 2026, deuten auf eine anhaltende Nachfrage hin, brüchige Drittanbieter-Integrationen und den laufenden Wartungsaufwand zu reduzieren.
Die mittleren Phasen umfassen Profiling, Bereinigung, Transformation, Anreicherung und Metadatenerfassung, einschließlich Katalog, Lineage und Richtlinien, die Rohdaten in analysebereite Assets für nachgelagerte BI-, ML- und GenAI-Workloads umwandeln. KI-gestützte Aufbereitung wird zunehmend als horizontale Fähigkeit über Suiten hinweg eingebettet, so veröffentlichte Microsoft Research im Mai 2026 Data Formulator 0.7 als Open-Source-, KI-gestützten Ansatz zur Vereinfachung von Transformationen und Reduzierung sich wiederholender manueller Datenverarbeitung, während Governance- und Qualitätskontrollen als Torfunktionen für regulierte Anwendungsfälle dienen. Nachgelagerte Beteiligte umfassen Analyse- und Visualisierungstools, ML-Plattformen, Datenprodukt-Marktplätze und Managed-Service-Partner, die DataOps-Praktiken (Versionierung, CI/CD, Observability) und Compliance-Kontrollen über hybride und souveräne Cloud-Umgebungen hinweg operationalisieren, mit Vertrieb hauptsächlich über SaaS-Abonnements, Hyperscaler-Marktplätze und Enterprise-Lizenzpakete, die an breitere Data-Fabric-Stacks gebunden sind.
Wettbewerbslandschaft
Marktkonzentration
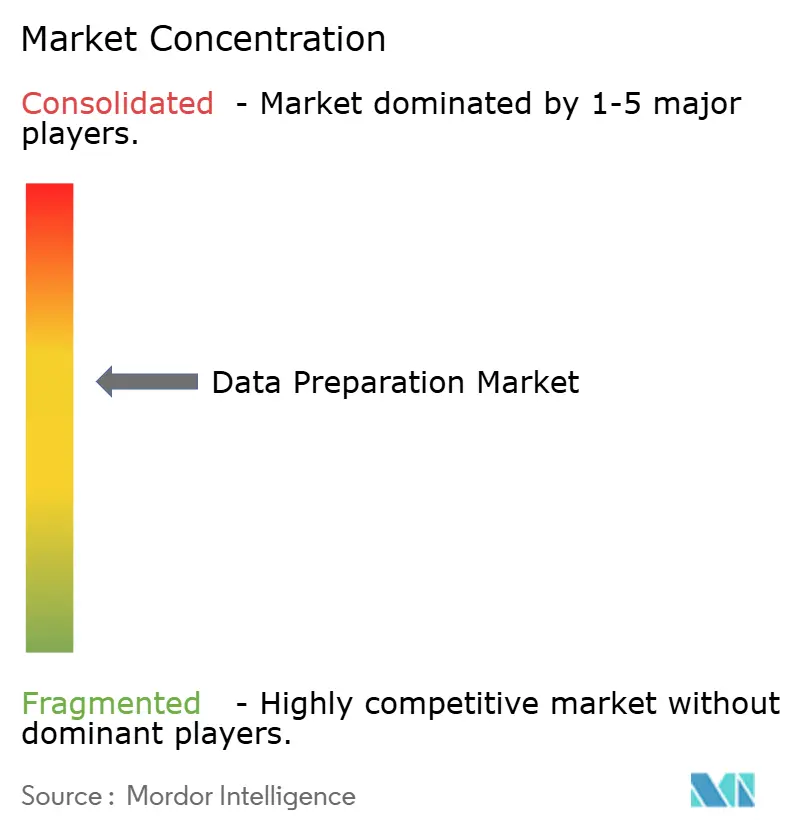
Die Konsolidierung verändert die Anbieterlandschaft. Salesforces Vereinbarung über USD 8 Milliarden zum Kauf von Informatica unterstreicht den Wandel hin zu Komplettsuiten, die Erfassung, Governance, Katalog und KI-gestützte Analysen unter einer kommerziellen Lizenz vereinen. Der Schritt beantwortet die Bündel von Microsoft und Oracle und bindet eine breite Kundenbasis an Salesforces Agentforce-Plattform. Das Interesse von Private-Equity bleibt hoch: Clearlake Capital und Insight Partners nahmen Alteryx für USD 4,4 Milliarden von der Börse, um den Übergang zu Cloud-nativem SaaS und generativen KI-Copiloten zu beschleunigen. IBM, Microsoft und Oracle erweitern ihre Präsenz mit horizontalen Releases, die Herkunftsbeobachtbarkeit und automatisierte Behebung in umfassendere KI-Studios integrieren, während Google Cloud verstärkt auf die BigQuery-Datenvorbereitung setzt.
Disruptoren konzentrieren sich auf KI-first-Architekturen. Scale AI sammelte USD 1 Milliarde in einer Series-F-Finanzierungsrunde, während Meta USD 14,3 Milliarden investierte und CEO Alexandr Wang damit beauftragte, ein neues Labor für Superintelligenz zu leiten. Cloud-native Start-ups wie Prophecy betonen visuelle Pipelines und einen Migrations-Copiloten, der Legacy-ETL-Code in Spark und Snowpark portiert, was Unternehmen anspricht, die Mainframe-Workloads modernisieren. Branchenspezialisten entstehen: Tamr für die Entitätsauflösung in den Biowissenschaften, Precisely für die Ausrichtung von ESG-Metriken und One Data für Datenprodukt-Marktplätze.
Die Wettbewerbsintensität nimmt rund um Differenzierungshebel zu: automatisierte Datenqualitätsbehebung, eingebettete datenschutzverbessernde Berechnungen und Branchenvorlagen, die Regulierungsbehörden überzeugen. Der Preiswettbewerb bleibt moderat, da Käufer reduziertes Risiko und Compliance-Bereitschaft über den niedrigsten Preis stellen, obwohl Freemium-Angebote von Open-Source-Anbietern am unteren Ende des KMU-Marktes Druck ausüben.
Marktführer im Bereich Datenvorbereitung
-
Informatica LLC
-
IBM Corporation
-
SAS Institute Inc.
-
Microstrategy Inc.
-
Tableau Software, LLC (Salesforce.com Inc.)
- *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert
Markt für Datenvorbereitung Unternehmen in diesem Bericht
- Alteryx Inc.
- Informatica LLC
- IBM Corporation
- Microsoft Corporation
- Tableau Software LLC (Salesforce)
- SAP SE
- SAS Institute Inc.
- QlikTech International AB
- TIBCO Software Inc.
- Talend SA
- Oracle Corporation
- Trifacta Inc. (Google)
- Databricks Inc.
- Snowflake Inc.
- Dataiku SAS
- MicroStrategy Inc.
- RapidMiner Inc.
- Paxata Inc. (DataRobot)
- Unifi Software Inc.
- Denodo Technologies Inc.
Marktchancen und Zukunftsaussichten
Chancen verdichten sich rund um Produkte, die die Datenaufbereitung direkt innerhalb von KI-Agenten- und RAG-Workflows nutzbar machen, insbesondere wenn unstrukturierte Inhalte wie Dokumente, PDFs, Tickets, E-Mails und Anruftranskripte in gesteuerten, abfragbaren Kontext umgewandelt werden müssen. IBM formulierte diesen Workflow im März 2026 explizit mit OpenRAG für watsonx.data, gefolgt von Erweiterungen, die im Juni 2026 Funktionen zur Risikobewertung und Datenschutzverwaltung über StoredIQ InstaScan innerhalb von Cloud Pak for Data hinzufügten. Zusammen deuten diese Veröffentlichungen auf eine Käufernachfrage nach paketierten, konformen Aufbereitungsschritten hin, statt nach individuellen Skripten.
Ein zweiter Bereich mit Whitespace ist die kopflose, In-situ-Datenaufbereitung und -Governance, die sich in Enterprise-KI-Tools einfügt, ohne eine Datenbewegung oder eine einzelne Frontend-Benutzeroberfläche zu erzwingen. Informatica hob dies im Mai 2026 mit kopflosem Datenmanagement für AWS hervor und vertiefte zudem die Zusammenarbeit mit Microsoft, um Model Context Protocol-Server innerhalb von Microsoft Foundry verfügbar zu machen. Da Organisationen sich über hybride Umgebungen hinweg auf Lakehouse-Muster und offene Tabellenformate wie Apache Iceberg und Delta Lake standardisieren, haben Anbieter, die portable Metadaten-, Lineage- und Richtlinienkontrollen über diese Laufzeitumgebungen hinweg bereitstellen, Raum zur Expansion, insbesondere dort, wo Lokalisierungs- und Prüfanforderungen Käufer dazu drängen, sensible Datensätze im Land zu halten und dabei gleichzeitig Self-Service-Aufbereitung und gesteuertes Teilen zu ermöglichen.
Neueste Industrielle Entwicklungen in Markt für Datenvorbereitung
- Juni 2026: IBM kündigte Erweiterungen für Cloud Pak for Data an, die StoredIQ InstaScan-Funktionen für schnelle Risikobewertung und Datenschutzmanagement einbeziehen. Das Update verbessert, wie Unternehmen sensible Datensätze scannen, klassifizieren und vor der gemeinsamen Nutzung oder KI-Anwendung aufbereiten, und stärkt die Verbindung zwischen Datenaufbereitung und Compliance-Workflows.
- Mai 2026: Informatica führte kopfloses Datenmanagement für AWS ein und erweiterte seine agentenorientierten Fähigkeiten, indem es Model Context Protocol-Server und CLAIRE Agent-Fähigkeiten über AWS-KI-Oberflächen wie das AWS Agent Registry verfügbar machte. Dieser Schritt verbindet Datenaufbereitungs-, Governance- und Qualitätsfunktionen mit aufkommenden KI-Agentenarchitekturen, bei denen Daten über Cloud-Dienste hinweg an Ort und Stelle bleiben.
- Mai 2024: Clearlake Capital und Insight Partners schlossen die Übernahme von Alteryx im Wert von 4,4 Milliarden USD zur Privatisierung ab. Die Transaktion unterstützte einen schnelleren Wandel hin zu Cloud-native-Bereitstellung und beschleunigte die Produktweiterentwicklung rund um Automatisierung und KI-gestützte Datenaufbereitungsfunktionen.
Markt für Datenvorbereitung Berichtsumfang und Forschungsmethodik
Marktdefinition und Abdeckung
Der Markt für Datenvorbereitung umfasst die Einnahmen aus Software und zugehörigen Abonnements, die zur Aufnahme, Profilierung, Bereinigung, Transformation und Veröffentlichung von Daten verwendet werden, damit diese für Analysen, Dashboards und maschinelles Lernen genutzt werden können.
Ausschlüsse aus dem Umfang: Wir schließen reine Datenintegrations-Laufzeitumgebungen, ETL-Appliances und einmalige professionelle Dienstleistungen aus, die als benutzerdefinierte Skripterstellung enden.
Segmentierungsübersicht
- Nach Bereitstellung
- On-Premises
- Cloud
- Nach Unternehmensgröße
- Kleine und mittlere Unternehmen (KMU)
- Großunternehmen
- Nach Lösungstyp
- Datenerfassung
- Datenkatalogisierung
- Datenqualität
- Datenverwaltung
- Datenaufbereitung
- Datenanreicherung
- Nach Endnutzerbranche
- BFSI
- Gesundheitswesen und Biowissenschaften
- Einzelhandel und E-Commerce
- Fertigung und Industrie
- IT und Telekommunikation
- Regierung und öffentlicher Sektor
- Sonstige (Energie, Bildung, Medien)
- Nach Geografie
- Nordamerika
- Vereinigte Staaten
- Kanada
- Mexiko
- Europa
- Deutschland
- Vereinigtes Königreich
- Frankreich
- Italien
- Spanien
- Russland
- Übriges Europa
- Asien-Pazifik
- China
- Japan
- Indien
- Südkorea
- Australien und Neuseeland
- Übriges Asien-Pazifik
- Südamerika
- Brasilien
- Argentinien
- Übriges Südamerika
- Naher Osten und Afrika
- Naher Osten
- Saudi-Arabien
- Vereinigte Arabische Emirate
- Türkei
- Übriger Naher Osten
- Afrika
- Südafrika
- Nigeria
- Übriges Afrika
- Naher Osten
- Nordamerika
Datenquellen, Marktgrößenbestimmung und Validierung
Sekundärforschung
Sekundärforschung wurde eingesetzt, um die Marktgrenzen festzulegen und den ersten Satz von Angebots- und Nachfragesignalen zu erstellen, bevor das Modell aufgebaut wurde. Wir stützten uns auf öffentliche Quellen wie das US Bureau of Labor Statistics, das US Census Bureau, Eurostat, OECD-Datensätze zur digitalen Wirtschaft und Weltbank-IKT-Indikatoren, um die Richtung der Digitalausgaben und die Einstellungsintensität im Bereich Datenfunktionen zu verstehen.
Um diese Makroindikatoren mit diesem Markt zu verknüpfen, haben wir SEC-Einreichungen und Jahresberichte, Investorenpräsentationen, Produktdokumentation auf Unternehmenswebsites sowie seriöse Presseberichte über Plattformaktualisierungen und Akquisitionen ausgewertet. Bei Bedarf nutzten wir kostenpflichtige Abonnements für Unternehmensfinanzdaten und -informationen, Nachrichten und Finanzdaten sowie Patentdatenbanken, um Produktpositionierungen und Umsatzberichtsmuster zu überprüfen. Diese Beispiele sind nicht abschließend; wir haben auch weitere öffentliche und kostenpflichtige Quellen für die Datenerhebung, Validierung und Klärung herangezogen.
Primärinterviews und Umfragen
Primärgespräche wurden mit Softwareanbietern, Cloud- und Kanalpartnern, Systemintegratoren sowie datenseitigen Entscheidungsträgern auf Käuferseite geführt, die Analyse- und Governance-Programme verwalten. Wir nutzten diese Erkenntnisse, um zu bestätigen, welche Angebote als Datenvorbereitung im Gegensatz zu angrenzenden Tools erworben werden, typische Preisbewegungen zu validieren und die Einführung nach Branche und Region zu überprüfen, bevor die Nachfragegesamtwerte finalisiert wurden.
Verteilung der Befragten in der Primärforschung
| Unternehmenstyp | Position des Befragten | Region |
|---|---|---|
| Obere Ebene: 31 % | CXOs: 13 % | APAC: 46 % |
| Mittlere Ebene: 54 % | Funktions-/Bereichsleiter: 34 % | EMEA: 30 % |
| Kleinere Marktteilnehmer: 15 % | Manager: 53 % | Amerika: 24 % |
Marktgrößenbestimmung und Prognose
Die Größenbestimmung beginnt mit einem Top-down-Ansatz, bei dem Ausgaben für Unternehmenssoftware und Datenmanagement mithilfe von Einführungssignalen und Nutzungsintensität in einen Nachfragepool für Datenvorbereitung gefiltert werden. Sobald diese Struktur vorhanden ist, verwenden wir selektive Bottom-up-Näherungen, wie z. B. Stichproben von Anbieterumsätzen, Kanalprüfungen bei Abonnementpaketen und eine Logik im Stil von Durchschnittspreis mal aktive Nutzer. Anschließend passen wir die Gesamtwerte nur dort an, wo die Abweichung erklärbar ist.
Zu den wichtigsten Modelleingaben gehören das Tempo der Cloud-Migration für Analyse-Stacks, das Wachstum der Datenvolumen und der Anteil halbstrukturierter Daten, die Einführung von Governance- und Compliance-Programmen, der Wandel von IT-geführten zu Self-Service-Datenworkflows sowie das typische Preisverhalten bei Abonnements (einschließlich Paketierungsänderungen bei Lizenzen, Kapazitäten und Funktionsstufen). Prognosen stützen sich auf Szenarioanalysen, die durch Expertenmeinungen zu KI-gestützten Vorbereitungsfunktionen, Budgetzyklen und dem Tempo der Konsolidierungsaktivitäten unterstützt werden. Wo Bottom-up-Belege unvollständig sind, verwenden wir konservative Durchdringungsannahmen und überprüfen diese anhand von Einstellungs-, Softwarebudgetindikatoren und Angaben zur Umsatzmischung der Anbieter.
Datenvalidierung und Aktualisierungszyklus
Prüfungen werden an mehreren Punkten durchgeführt, damit die endgültige Zahl mit realen Signalen übereinstimmt. Wir vergleichen Ergebnisse mit unabhängigen Indikatoren wie der Richtung der Softwareausgaben, Kommentaren zur Umsatzmischung der Anbieter und regionalen Cloud-Einführungsmustern und untersuchen dann große Abweichungen vor der Freigabe.
Wird ein Ausreißer gefunden, überprüfen wir die Annahmen, und bei Bedarf lösen wir Interview-Nachfassaktionen aus, um zu bestätigen, ob ein Umfangselement falsch klassifiziert wurde oder eine Preisänderung vorübergehend war. Berichte werden jährlich aktualisiert, mit Zwischenaktualisierungen, wenn wichtige Ereignisse die Nachfrage oder das Angebot wesentlich verschieben. Vor der Lieferung führen wir einen abschließenden Analystencheck durch, damit die Einschätzung die neuesten öffentlichen Informationen und die zuletzt validierten Annahmen widerspiegelt.
Marktgrößenbestimmung für Datenvorbereitung von Mordor Intelligence im Vergleich mit anderen veröffentlichten Schätzungen
Es ist üblich, dass für Datenvorbereitung unterschiedliche Marktwerte veröffentlicht werden, selbst wenn der Themenname gleich klingt. Die Unterschiede entstehen in der Regel dadurch, wie jede Studie die Grenze zwischen Datenvorbereitung und angrenzenden Softwarekategorien zieht, zuzüglich Unterschieden beim verwendeten Jahr, dem Währungszeitpunkt und der Behandlung von Abonnements.
Einige Herausgeber kombinieren Datenvorbereitung mit breiteren ETL-, Datenintegrations- oder professionellen Dienstleistungsumsätzen, während andere sich nur auf Tools und wiederkehrende Abonnements konzentrieren. Die Spanne kann auch dadurch bedingt sein, wie Pakete behandelt werden, ob Cloud- und On-Premises-Preise normalisiert werden und ob Prognosen eine aggressive Einführung KI-gestützter Funktionen oder eine schrittweisere Käuferrampe annehmen. Indem professionelle Dienstleistungen ausgeschlossen und Plattformumsätze nur dann gezählt werden, wenn die primäre Aufgabe die Profilierung, Bereinigung und Transformation von Daten für nachgelagerte Analysen ist, beläuft sich der Gesamtwert für 2025 auf 6,95 Milliarden USD gemäß dem von Mordor Intelligence verwendeten Umfang.
Im Vergleich für 2025 sind die Unterschiede größtenteils durch Umfangsregeln und Zeitpunkte erklärbar, nicht durch eine Veränderung der zugrunde liegenden Nachfragesignale.
Benchmark-Vergleich
| Quelle | Marktgröße | Lücken in der Forschungsmethodik |
|---|---|---|
| Mordor Intelligence | 6,95 Milliarden USD (2025) | |
| Global Consultancy A | 7,01 Milliarden USD (2024) | Verwendet eine reine Tool-Perspektive mit dem Basisjahr 2024, und die Umfangsbeschreibung klärt keine Ausschlüsse für Integrations-Laufzeitumgebungen oder gebündelte angrenzende Module, was die Gesamtwerte je nach Anbieterpaketierung verschieben kann. |
| Industry Publisher B | 6,50 Milliarden USD (2024) | Verwendet das Basisjahr 2024 und liefert nur begrenzte Details darüber, was über breite Bereitstellungs- und Unternehmenssegmente hinaus enthalten ist, was Abonnementausweitungen im Zusammenhang mit Governance-zentrierten und KI-gestützten Vorbereitungsfunktionen untererfassen kann. |
Zusammengenommen zeigt der Vergleich hauptsächlich, dass die Wahl des Jahres und die Umfangsregeln den größten Teil der Varianz erzeugen, nicht eine Meinungsverschiedenheit über die Nachfragerichtung. Unser Ansatz bleibt nachvollziehbar, da jede Annahme auf Einführungssignale, Preislogik und Interview-Validierung zurückgeführt wird, was den endgültigen Marktwert leichter reproduzierbar und aktualisierbar macht.
Im Bericht beantwortete Schlüsselfragen
Wie groß ist der aktuelle Markt für Datenvorbereitung?
Der Markt für Datenvorbereitung wird im Jahr 2026 auf USD 8,05 Milliarden geschätzt.
Wie schnell wird der Markt für Datenvorbereitung voraussichtlich wachsen?
Der Umsatz wird voraussichtlich mit einer CAGR von 15,92 % wachsen und bis 2031 USD 16,84 Milliarden erreichen.
Welches Bereitstellungsmodell wächst am schnellsten?
Cloud-basierte Bereitstellungen skalieren mit einer CAGR von 17,12 %, angetrieben durch die KMU-Einführung und die Elastizität von KI-Workloads.
Warum gewinnen Datenverwaltungstools an Bedeutung?
Globale Nachhaltigkeits- und KI-Vorschriften erfordern transparente Herkunft, Qualität und ESG-Berichterstattung, was Governance-Module auf eine CAGR von 16,74 % treibt.
Welche Region wird das stärkste Wachstum verzeichnen?
Asien-Pazifik wird voraussichtlich mit einer CAGR von 16,98 % führen, unterstützt durch Programme zur digitalen Transformation und Investitionen in Datensouveränitäts-Clouds.
Wie prägen Fusionen und Übernahmen den Wettbewerb?
Große Suiten entstehen durch Deals wie Salesforce-Informatica und die Übernahme von Alteryx, die Erfassung, Katalog und Governance unter einheitlichen Plattformen konsolidieren.