
Datenerkundungsmarkt Größe und Anteil
Marktübersicht
| Studienzeitraum | 2020 - 2031 |
|---|---|
| Marktgröße (2026) | 18.82 Milliarden US-Dollar |
| Marktgröße (2031) | 41.07 Milliarden US-Dollar |
| Wachstumsrate (2026 - 2031) | 16.92 % |
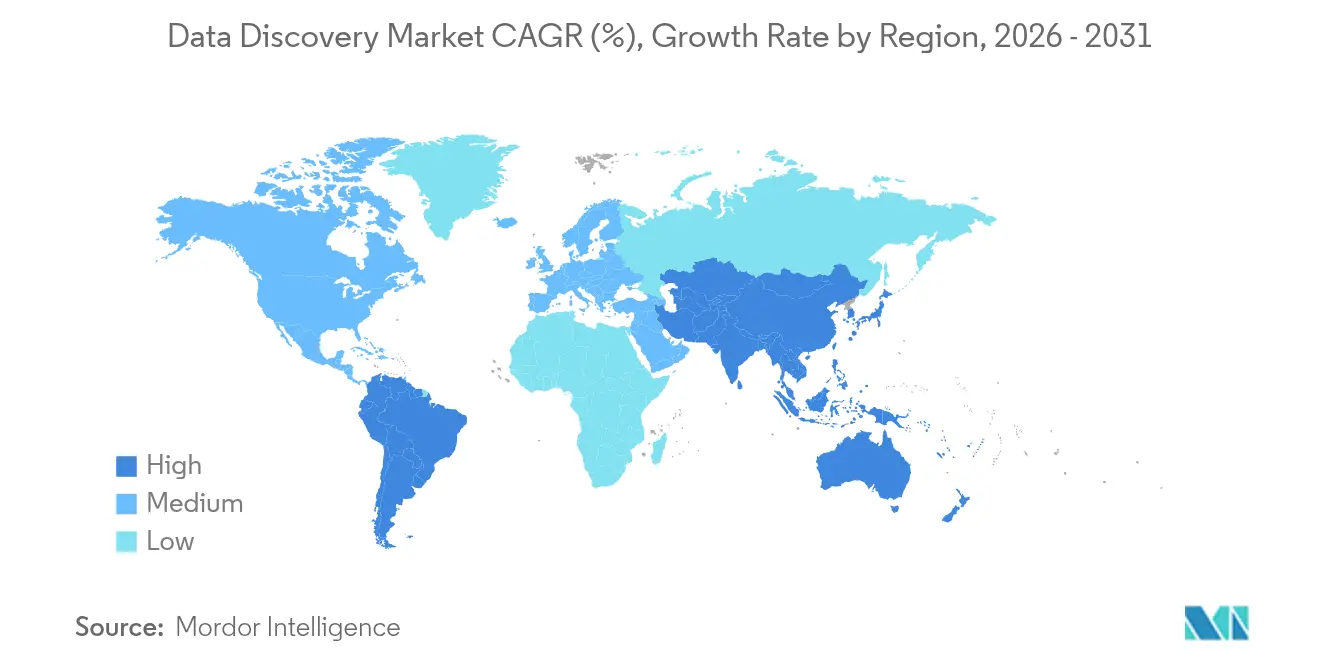
| Schnellstwachsender Markt | Asien-Pazifik |
| Größter Markt | Nordamerika |
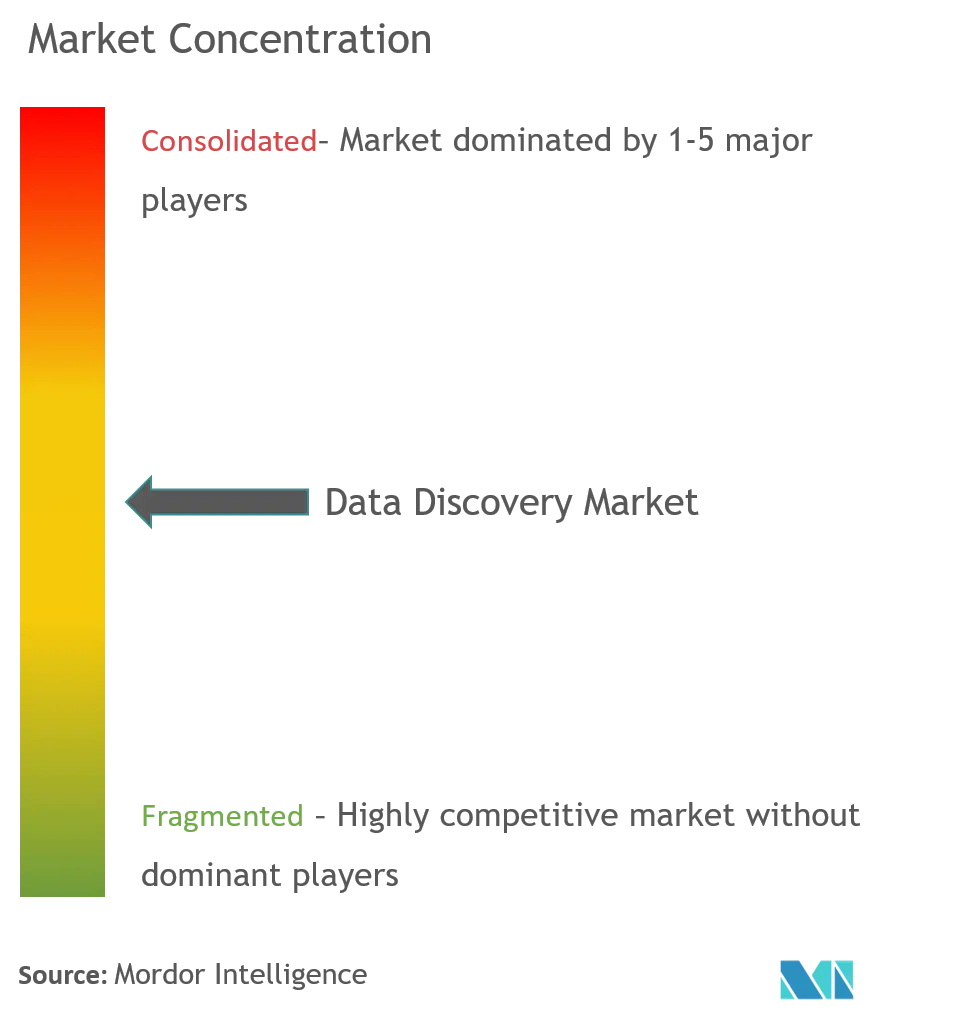
| Marktkonzentration | Mittel |
Hauptakteure *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert Bild © Mordor Intelligence. Wiederverwendung erfordert Namensnennung gemäß CC BY 4.0. | |
Datenerkundungsmarktanalyse von Mordor Intelligence
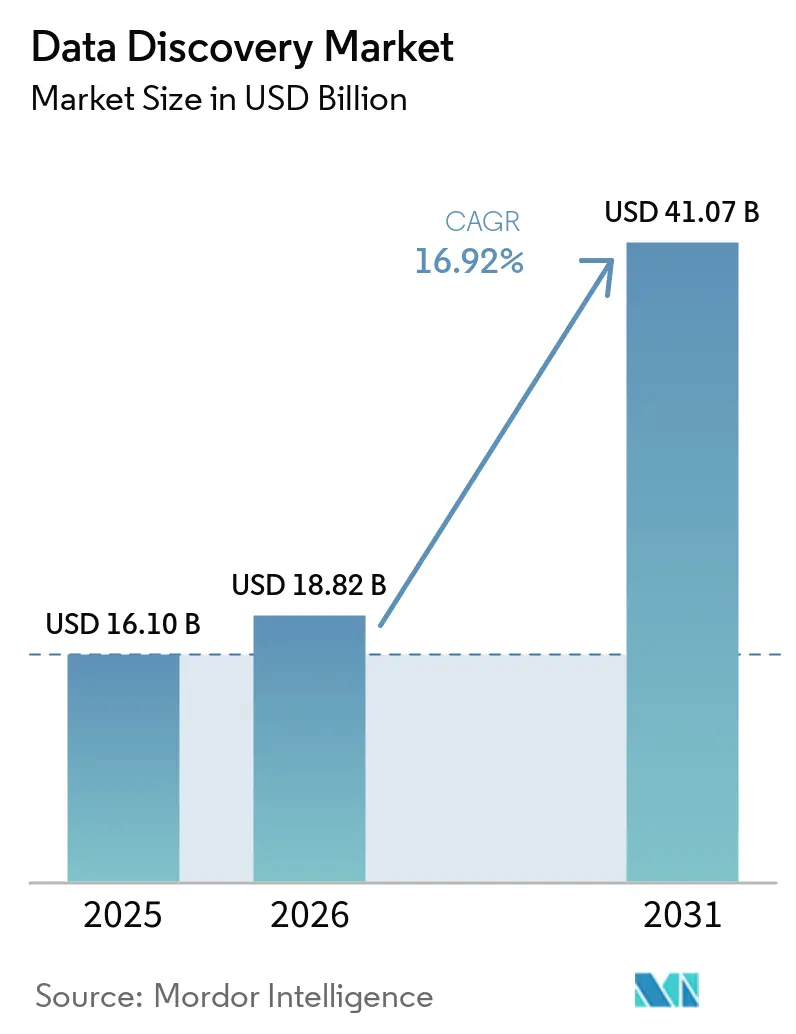
Die Größe des Datenerkundungsmarkts wird voraussichtlich von 16,1 Milliarden USD im Jahr 2025 auf 18,82 Milliarden USD im Jahr 2026 wachsen und soll bis 2031 bei einer CAGR von 16,92 % über den Zeitraum 2026–2031 41,07 Milliarden USD erreichen. Dieses Wachstum festigt den Datenerkundungsmarkt als eines der am schnellsten wachsenden Segmente der Unternehmensanalytik, angetrieben durch den steigenden Bedarf, multistrukturierte Daten in zeitnahe Geschäftsentscheidungen umzuwandeln. Verstärkte Cloud-Akzeptanz, rasante Fortschritte bei generativer KI und zunehmende Führungsmandate für datengetriebene Kulturen beschleunigen die Plattformnachfrage. Gleichzeitig wechseln Kunden von traditionellen Business-Intelligence-Stacks zu intuitiven Self-Service-Tools, die die Erkenntnisgewinnung abteilungsübergreifend demokratisieren, wodurch die Plattformbindung und wiederkehrende Umsatzströme gestärkt werden. Wettbewerbsstrategien werden zunehmend durch regionsspezifische Vorschriften geprägt – insbesondere durch Souveräne-Cloud-Mandate im asiatisch-pazifischen Raum und Datenverwaltungsregeln in Europa –, die Bereitstellungsentscheidungen und Anbieterpartnerschaften bestimmen.
Wichtigste Erkenntnisse des Berichts
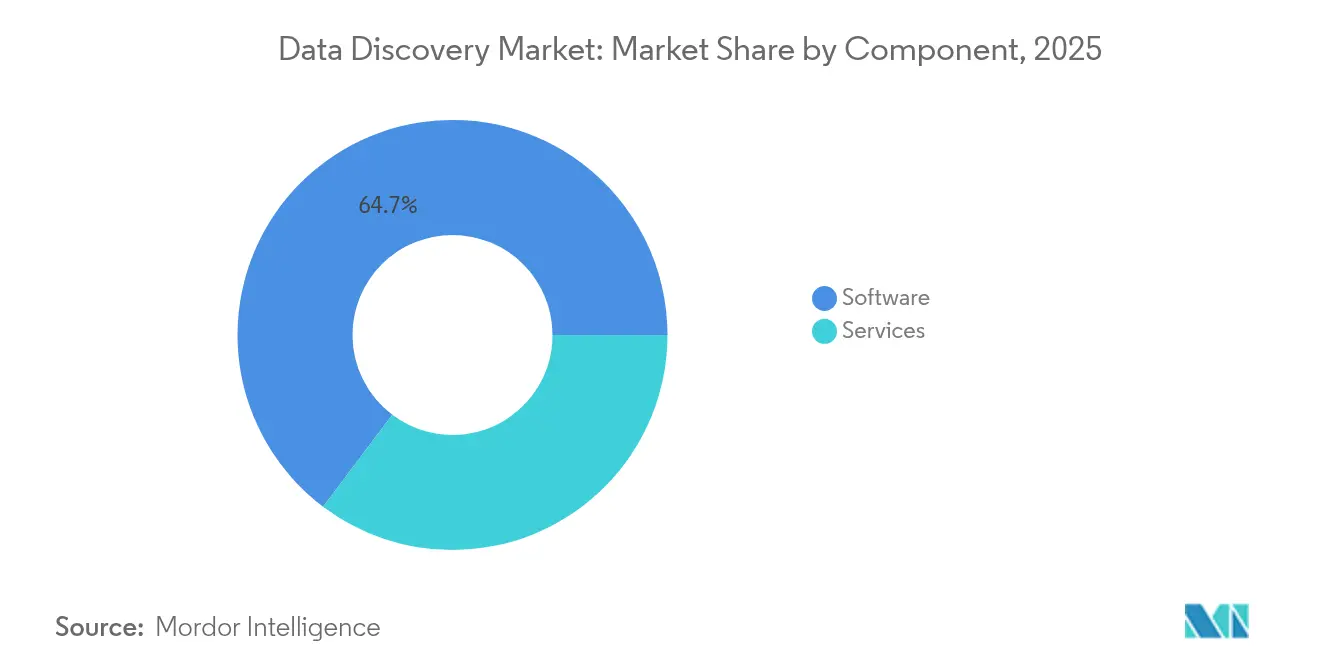
- Nach Komponente entfielen im Jahr 2025 64,72 % des Datenerkundungsmarktanteils auf Softwarelösungen, während Dienstleistungen bis 2031 mit einer CAGR von 23,12 % wachsen.
- Nach Bereitstellungsmodell hielten On-Premise-Installationen im Jahr 2025 54,30 % der Datenerkundungsmarktgröße; Cloud-Bereitstellungen sollen bis 2031 eine CAGR von 24,62 % verzeichnen.
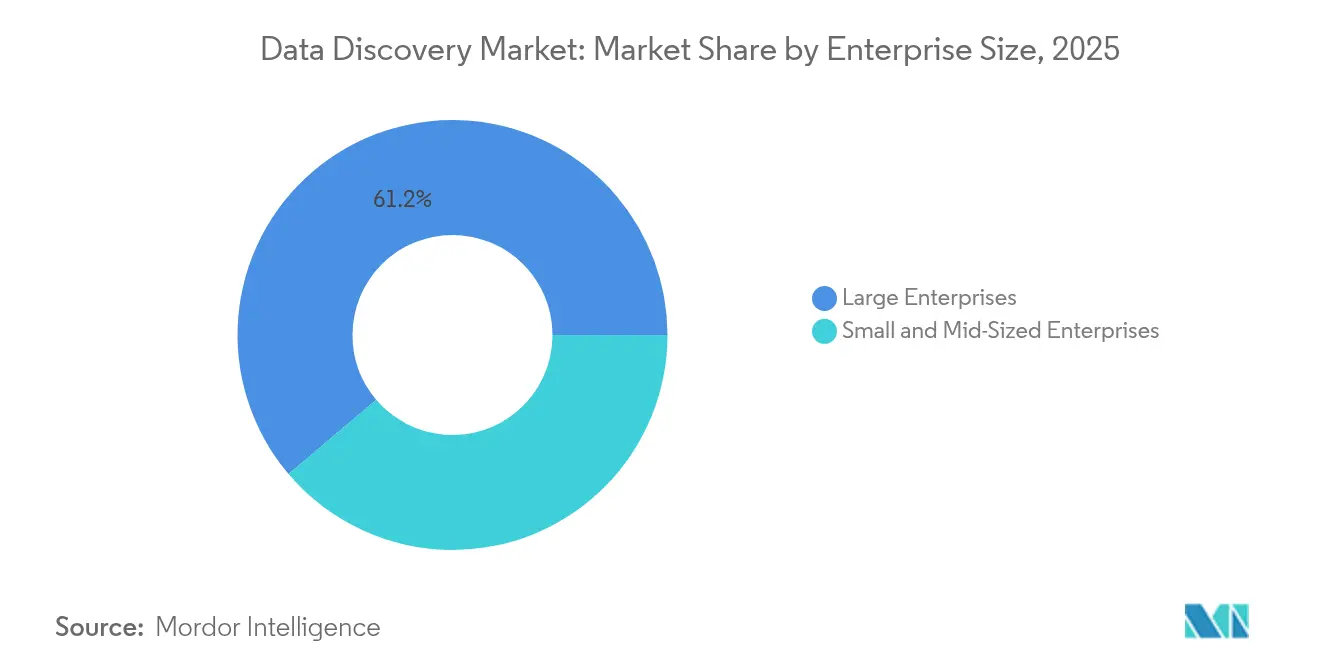
- Nach Unternehmensgröße entfielen auf Großunternehmen im Jahr 2025 61,20 % der Datenerkundungsmarktgröße; kleine und mittlere Unternehmen werden mit einer CAGR von 24,14 % wachsen.
- Nach Branche führte BFSI mit einem Datenerkundungsmarktanteil von 23,78 % im Jahr 2025, während Gesundheitswesen und Biowissenschaften voraussichtlich mit einer CAGR von 18,92 % wachsen werden.
- Nach Anwendung entfielen im Jahr 2025 27,95 % der Datenerkundungsmarktgröße auf Risiko- und Compliance-Management, während Kundenerlebnis- und Personalisierungsanwendungen voraussichtlich mit einer CAGR von 20,12 % wachsen werden.
- Nach Geografie kontrollierte Nordamerika im Jahr 2025 39,60 % des Datenerkundungsmarkts; der asiatisch-pazifische Raum ist mit einer CAGR von 18,27 % auf die schnellste Expansion ausgerichtet.
Hinweis: Die Marktgrößen- und Prognosezahlen in diesem Bericht werden mithilfe des proprietären Schätzrahmens von Mordor Intelligence erstellt und mit den neuesten verfügbaren Daten und Erkenntnissen bis 2026 aktualisiert.
Markttrends und Einblicke
Analyse der Treiber-Auswirkungen auf den Markt für Datenerkennung*
| Treiber | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Wirkung |
|---|---|---|---|
| Verbreitung multistrukturierter Daten | +4.2% | Global | Mittelfristig (2–4 Jahre) |
| Druck zur datengetriebenen Entscheidungsfindung | +3.8% | Nordamerika, EU-Kernländer, Expansion im asiatisch-pazifischen Raum | Kurzfristig (≤2 Jahre) |
| Schnelle Übernahme von Self-Service-Analysen | +3.5% | Global, KMU-Konzentration | Mittelfristig (2–4 Jahre) |
| Governance- und Compliance-Mandate | +2.9% | EU, Nordamerika, aufstrebender asiatisch-pazifischer Raum | Langfristig (≥4 Jahre) |
| Generative-KI-Copiloten in Workflows | +2.7% | Nordamerika, EU, entwickelter asiatisch-pazifischer Raum | Kurzfristig (≤2 Jahre) |
| Sinkende Kosten für spaltenorientierte Cloud-Datenlager | +1.9% | Globale Cloud-First-Märkte | Mittelfristig (2–4 Jahre) |
| Quelle: Mordor Intelligence | |||
Verbreitung multistrukturierter Datenquellen
Unternehmen erfassen heute Datenströme von IoT-Sensoren, sozialen Medien, Dokumenten und Edge-Geräten und zwingen Plattformen dazu, unterschiedliche Formate ohne Vorverarbeitung zu vereinheitlichen. Anbieter integrieren Verarbeitung natürlicher Sprache, um Ressourcen automatisch zu katalogisieren und den Zeitaufwand der Analysten für die Datenpflege zu reduzieren.[1] Edge-Rollouts verstärken diesen Bedarf, und der Mangel an Halbleitern hat die Cloud-Elastizität für die Skalierung von Erkundungs-Workloads attraktiver gemacht. Unternehmen kommen zu dem Schluss, dass herkömmliche Datenlager allein die heutige Datengeschwindigkeit nicht bewältigen können, was Migrationen zu Cloud-nativen Erkundungslösungen beschleunigt.
Unternehmerischer Druck zur datengetriebenen Entscheidungsfindung
Führungsmandate haben Erkundungsplattformen als strategische Vermögenswerte neu definiert. HPs Einführung einer konversationellen BI-Schicht auf Databricks ermöglicht es Supply-Chain-Teams, Anomalien durch einfache Abfragen anstatt durch aufwändige Engineering-Aufwände zu erkennen.[2] Transparente Herkunftsfunktionen erfüllen zudem Anforderungen der Prüfer, insbesondere im Finanzdienstleistungsbereich, und erfolgreiche Implementierungen verbinden technologische Einführungen mit kulturellen Veränderungen, die Datenerkenntnisse in den Mittelpunkt täglicher Entscheidungen stellen.
Schnelle Übernahme von Self-Service-Analyseplattformen
Organisationen mit ausgereiften Self-Service-Programmen berichten von 42 % Effizienzsteigerungen und einem 64%igen Anstieg der Datenzugänglichkeit.[3] Microsofts verwaltete Self-Service-Architektur zeigt, wie gemeinsame semantische Modelle die Governance wahren und gleichzeitig Geschäftsanwender befähigen. KMU, die zuvor durch IT-Budgets eingeschränkt waren, setzen nun auf Cloud-native Bereitstellung, die unvorhersehbare Nutzungsspitzen ohne Vorabinvestitionen in Infrastruktur unterstützt.
Governance- und Compliance-Mandate
Europas Datengesetz verpflichtet Unternehmen, Datenressourcen auf Abruf zu katalogisieren und zu teilen, wodurch integrierte Governance zu einer Beschaffungsvoraussetzung wird.[4] Der Fokus der Europäischen Zentralbank auf Risikodatenaggregation treibt Banken ebenfalls zu Plattformen mit robusten Prüfpfaden. In den Vereinigten Staaten stärkt der OCC-Plan 2025 die Datenklassifizierungsanforderungen in Drittpartei-Ökosystemen, während mehrere Regierungen im asiatisch-pazifischen Raum eine souveräne Datenspeicherung vorschreiben, was Bereitstellungen weiter lokalisiert.
Analyse der Hemmnisse-Auswirkungen auf den Markt für Datenerkennung*
| Hemmnis | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Wirkung |
|---|---|---|---|
| Steigende Datensicherheits- und Datenschutzrisiken | –2.8% | Global, mit stärkerem Druck in der EU und stark regulierten Sektoren | Langfristig (≥4 Jahre) |
| Begrenzte Verfügbarkeit von Daten-Engineering- und Stewardship-Fachkräften | –2.1% | Nordamerika, EU, entwickelter asiatisch-pazifischer Raum | Mittelfristig (2–4 Jahre) |
| Komplexe Integration mit Legacy-Systemen | –1.7% | Global, am stärksten ausgeprägt bei Großunternehmen | Mittelfristig (2–4 Jahre) |
| Strenge souveräne Cloud-Datenlokalisierungsmandate | –1.4% | Asiatisch-pazifischer Kernraum, Ausdehnung auf EU und andere aufstrebende Märkte | Langfristig (≥4 Jahre) |
| Quelle: Mordor Intelligence | |||
Datensicherheits- und Datenschutzbedenken
Fast die Hälfte der globalen Cyberangriffe im Jahr 2024 beinhaltete Daten- oder Anmeldedatendiebstahl, wobei der asiatisch-pazifische Raum ein Drittel der Vorfälle verzeichnete. Hersteller sind bevorzugte Ransomware-Ziele, und ein breiterer Datenzugang erhöht die Aufmerksamkeit der Regulierungsbehörden. Datenschutzverbessernde Technologien existieren, jedoch wird ihre Einführung durch Leistungskompromisse und Kosten behindert. Unternehmen verlangen nun granulare Zugriffskontrollen und unveränderliche Prüfprotokolle, die Implementierungszyklen verlängern und Budgets erhöhen.
Mangel an Fachkräften für Daten-Engineering und Daten-Stewardship
Die globale Nachfrage nach Datenspezialistinnen und -spezialisten übersteigt das Angebot, verlängert Bereitstellungszeiträume und erhöht die Kosten von Servicepartnern. Unternehmen, die gleichzeitig tarifbedingte Lieferkettenstörungen und Plattformmodernisierung bewältigen, nennen Talentknappheit als größtes Hindernis. Der Wettbewerb um qualifiziertes Personal treibt die Gehälter in die Höhe und bewegt einige Unternehmen dazu, auf Managed-Services-Modelle umzusteigen, um Kompetenzlücken zu schließen.
*Unsere Prognosen behandeln die Auswirkungen von Treibern und Einschränkungen als richtungsweisend und nicht additiv. Die Wirkungsprognosen berücksichtigen Basiswachstum, Mischungseffekte und Wechselwirkungen zwischen Variablen.
Segmentanalyse des Marktes für Datenerkennung
Nach Komponente:
Dienstleistungen treiben den Implementierungserfolg voranSoftware dominierte die Datenerkundungsmarktgröße im Jahr 2025 nach wie vor mit einem Umsatzanteil von 64,72 %. Dienstleistungen wachsen jedoch am schnellsten mit einer CAGR von 23,12 %, da Unternehmen erkennen, dass erfolgreiche Einführungen Integrations-, Governance- und Change-Management-Expertise erfordern. Beratungsaufträge befassen sich mit der Architekturmodernisierung, während Managed Services für KMU ohne interne Ressourcen attraktiv sind. Im Prognosezeitraum werden Dienstleistungen voraussichtlich einen größeren Anteil der inkrementellen Ausgaben erfassen, da die Plattformkomplexität steigt und Talentengpässe bestehen bleiben. Der Wandel unterstreicht den Übergang von toolzentrierten Käufen zu ergebnisorientierten Verträgen, die Software mit messbarem Geschäftsnutzen bündeln.
Softwareanbieter verfeinern weiterhin Abonnementmodelle und integrieren Low-Code-Konfigurationen, um umfangreiche Anpassungen einzudämmen. Dennoch ergänzen Unternehmenskunden Lizenzen häufig durch spezialisierte Partner für das Daten-Onboarding, das Taxonomiedesign und die Herkunftsvalidierung. Dieses hybride Kaufverhalten entspricht breiteren Marktreifungstrends, bei denen der Wert an Verbesserungen der Entscheidungsgeschwindigkeit statt an Funktionslisten gemessen wird.
Notiz: Segmentanteile aller einzelnen Segmente sind nach dem Berichtskauf verfügbar
Nach Bereitstellungsmodell:
Cloud-Wirtschaftlichkeit überwiegt SicherheitsbedenkenOn-Premise-Installationen behielten im Jahr 2025 einen Datenerkundungsmarktanteil von 54,30 %, hauptsächlich aufgrund von Datenlokalisierungsmandaten im Bank- und öffentlichen Sektor. Cloud-Bereitstellungen hingegen sollen mit einer CAGR von 24,62 % wachsen, da kostenoptimierte Datenlager und souveräne Cloud-Rahmenwerke Risikowahrnehmungen abbauen. Unternehmen kombinieren nun lokale Speicherung für sensible Datensätze mit Cloud-Computing für Analysebursts und schaffen damit Nachfrage nach einheitlichen Steuerungsebenen, die die zugrunde liegende Komplexität verbergen.
Fujitsus Einführung einer souveränen Cloud, die auf Oracle Alloy basiert, ist ein typisches Beispiel für regionale Reaktionen auf Lokalisierungsregeln bei gleichzeitiger Bereitstellung elastischer Cloud-Skalierung. Da immer mehr Regulierungsbehörden Cloud-Sicherheitsstandards veröffentlichen, wächst das branchenübergreifende Vertrauen, und Unternehmen verlagern Investitionsausgaben hin zu betriebsausgabenbasierten Verbrauchsmodellen, die Upgrade-Zyklen verkürzen.
Nach Unternehmensgröße:
KMU-Demokratisierung beschleunigt die MarktexpansionGroßunternehmen machten im Jahr 2025 61,20 % des Umsatzes aus, aber die KMU-Akzeptanz steigt mit einer CAGR von 24,14 % dank Pay-as-you-go-Modellen und intuitiven Self-Service-Oberflächen. Kleinere Unternehmen, die früher durch Infrastrukturkosten ausgeschlossen waren, nutzen nun kuratierte Datenprodukte über browserbasierte Portale und verkürzen die Zeit bis zur Erkenntnis. Anbieter-Roadmaps umfassen zunehmend sofort einsatzbereite Konnektoren und automatische Governance-Vorlagen, um KMU-Bereitstellungen schnell zu starten.
Gleichzeitig bleiben Großunternehmen für Anbieter-Roadmaps entscheidend, da ihre komplexen Multi-Cloud-Umgebungen erweiterte Herkunfts- und Sicherheitsfunktionen demonstrieren. Doch selbst diese Käufer erwarten verbrauchergerechte Erlebnisse für Geschäftsanwender, was eine universelle Benutzerfreundlichkeitsanforderung über alle Kundenstufen hinweg verstärkt.
Notiz: Segmentanteile aller einzelnen Segmente sind nach dem Berichtskauf verfügbar
Nach Branchenvertikale:
Innovationen im Gesundheitswesen überholen die finanzielle ReifeBFSI führte die Ausgaben 2025 mit einem Datenerkundungsmarktanteil von 23,78 % an, angetrieben durch strenge Berichts- und Prüfpflichten. Gesundheitswesen und Biowissenschaften werden jedoch mit der schnellsten CAGR von 18,92 % bis 2031 prognostiziert, da Präzisionsmedizinforschung, klinische Studie-Analytik und Programme für reale Evidenz das Datenvolumen und die Datenkomplexität vervielfachen. Telekommunikation, Einzelhandel und Fertigung halten ihre Investitionen stabil aufrecht, um das Kundenengagement und die Effizienz in der Fabrikhalle zu optimieren, während Versorgungsunternehmen ein zunehmendes Interesse an vorausschauender Wartung inmitten von Dekarbonisierungsbestrebungen melden.
Branchenspezifische Lösungen, die Domänenontologien und Compliance-Artefakte vorkonfigurieren, gewinnen an Bedeutung, verkürzen Bereitstellungszyklen und differenzieren Anbieter in stark umkämpften Ausschreibungen.
Nach Anwendung:
Transformation des Kundenerlebnisses treibt das Wachstum anRisiko- und Compliance-Management hielt im Jahr 2025 den größten Anteil von 27,95 % am Datenerkundungsmarkt, was eine regulatorische Grundlage widerspiegelt, die jedes Unternehmen erfüllen muss. Vorausblickend sind Kundenerlebnis- und Personalisierungs-Workloads auf eine CAGR von 20,12 % ausgerichtet, da Unternehmen granulare Einblicke in das Omni-Channel-Verhalten suchen. Die Vereinheitlichung von Marketing, Support und Produkttelemetrie ermöglicht Mikrosegmentierung und Echtzeit-Angebote, die den Lebenszeitwert steigern.
Vertriebs- und Marketingoptimierung profitiert ebenfalls von konsolidierten Profilen, während Betriebs- und Lieferketten-Analytik Organisationen dabei hilft, Störungen zu mindern und die Widerstandsfähigkeit zu verbessern. Asset-Performance-Management findet frühe Akzeptanz in Energie- und Industriebereichen, wo Betriebszeit geschäftskritisch ist.
Geografische Analyse
Markt für Datenerkennung in Nordamerika
Nordamerika hielt 2025 einen Umsatzanteil von 39,60 %, gestützt durch ausgereifte Governance-Rahmenbedingungen, eine hohe Cloud-Durchdringung und robuste Partnerökosysteme. Regulierungsanforderungen im Finanzdienstleistungssektor treiben weiterhin die Erneuerung von Erkennungsplattformen voran, und die Datenstrategie der US-amerikanischen Nachrichtendienstgemeinschaft für 2023–2025 unterstreicht das föderale Bekenntnis zu interoperablen Architekturen. Forschungs- und Entwicklungslabore des Technologiesektors erweitern zudem die Plattform-Footprints, um die Entwicklung von KI-Produkten voranzutreiben.
Markt für Datenerkennung im asiatisch-pazifischen Raum
Der APAC-Raum wird voraussichtlich die am schnellsten wachsende Region mit einem CAGR von 18,27 % sein. Nationale Programme zur digitalen Verwaltung und Roadmaps für souveräne KI beschleunigen die Nachfrage nach lokalisierten, aber skalierbaren Discovery-Umgebungen. Japan veranschaulicht diesen Trend durch die Verlagerung des öffentlichen Sektors hin zur Oracle Cloud Infrastructure, während steigende Investitionen in Rechenzentrumskapazitäten in Südostasien die physischen Grundlagen für eine breitere Akzeptanz schaffen.
Markt für Datenerkennung in EMEA und Südamerika
Europa verzeichnet stetige Zuwächse, gestützt durch die strengen Anforderungen der DSGVO und des Datengesetzes hinsichtlich Datenweitergabe und Datenherkunft. Banken müssen sich an den Risikodaten-Leitlinien der Europäischen Zentralbank ausrichten, was neue Plattform-Upgrades stimuliert. In Südamerika sowie im Nahen Osten und Afrika vollzieht sich der Übergang von Pilotphasen hin zu unternehmensweiten Implementierungen, wenngleich Infrastrukturlücken und Fachkräftemangel die kurzfristige Expansion dämpfen.
Regulatorisches Umfeld
Das regulatorische Umfeld für die Datenermittlung wird in Bezug auf Prüfbarkeit, Datenverwaltung und Kontrollen für KI-gestützte Analysen strenger. In der Europäischen Union legt die Verordnung (EU) 2024/1689 (KI-Verordnung) im Rahmen von Artikel 10 ausdrückliche Datenverwaltungspflichten für Hochrisiko-KI-Systeme fest, einschließlich Anforderungen an Datenerfassung, -vorbereitung, -dokumentation sowie Bias-Erkennung und -minderung. Die Verordnung tritt am 2. August 2026 vollständig in Kraft, was die Compliance-Prüfung für Ermittlungsfunktionen erhöht, die KI-Workflows unterstützen, insbesondere in Bezug auf Datenherkunft, Vollständigkeit der Metadaten und Reproduzierbarkeit analytischer Ergebnisse.
In den Vereinigten Staaten schaffen Maßnahmen auf Bundesebene und im Finanzsektor zunehmend spezifischere Compliance-Auslöser, die das Design und die Bereitstellung von Plattformen prägen. Im Juni 2026 erließ die U.S. General Services Administration eine GSAR-Klausel (552.239-7001), die Anforderungen zum Datenschutz für Systeme mit großen Sprachmodellen (Large Language Models) festlegt, die Regierungsdaten verarbeiten. Dies unterstreicht die Notwendigkeit von Ermittlungswerkzeugen mit durchsetzbaren Zugriffskontrollen und prüfbarer Handhabung sensibler Datensätze. Getrennt davon veröffentlichten die US-Finanzaufsichtsbehörden im Juni 2026 eine endgültige gemeinsame Regelung, die am 1. Oktober 2026 in Kraft tritt und Datenstandards für die Interoperabilität von Finanzaufsichtsdaten festlegt. Dies erhöht die Nachfrage nach interoperabilitätsfähigen Katalogen, standardisierten Metadaten und nachvollziehbaren Datentransformationen in regulierten Meldeprozessen.
Wettbewerbslandschaft
Der Datenerkundungsmarkt ist mäßig fragmentiert. Globale Cloud-Anbieter nutzen bestehende IaaS-Präsenzen, um Erkundungsmodule anzubieten, während Spezialanbieter sich in der Katalogisierung, Herkunftsverfolgung oder branchenspezifischer Compliance-Tiefe differenzieren. Strategische Allianzen – wie jüngste gemeinsame Datenbankdienste zwischen führenden Hyperscalern und Datenbankspezialisten – demonstrieren die Nachfrage nach Cross-Cloud-Interoperabilität unter einheitlicher Governance.
Patenttrends verdeutlichen intensivierte Forschungs- und Entwicklungsaktivitäten rund um natürlichsprachliche Oberflächen und automatisierte Metadatengenerierung, was auf einen Wettlauf hindeutet, die Qualifikationsanforderungen für komplexe Erkundungsaufgaben zu senken. Anbieter, die Beratungsdienstleistungen neben Software bündeln, gewinnen an Bedeutung, insbesondere dort, wo Kunden mit Datenschutz-, Souveränitäts- und Talentbeschränkungen zu kämpfen haben. Nischenanbieter, die Workloads gegen regionale Souveränitätscodes zertifizieren können, sichern sich verteidigungsfähige Marktpositionen in Regierungs- und regulierten Branchen.
Preisgestaltungsinnovationen sind erkennbar, da Abonnementebenen Speicher-, Rechen- und Governance-Messgrößen kombinieren, um Ausgaben an realisierten Geschäftsvorteilen auszurichten. Insgesamt bleibt der Wettbewerbsdruck hoch, aber kein einzelner Anbieter dominiert die Wahrnehmung über alle Regionen und Branchen hinweg.
Marktführer im Datenerkundungsbereich
-
Tableau Software, LLC
-
Datameer, Inc.
-
SAP SE.
-
Tibco Software Inc.
-
Cloudera, Inc.
- *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert
Data-Discovery-Markt Unternehmen in diesem Bericht
- Microsoft Corp.
- Tableau Software LLC (Salesforce)
- SAP SE
- QlikTech International AB
- IBM Corp.
- Oracle Corp.
- Amazon Web Services Inc.
- Google LLC (Looker)
- Altair Engineering Inc.
- SAS Institute Inc.
- MicroStrategy Inc.
- Alteryx Inc.
- Datameer Inc.
- Cloudera Inc.
- Talend SA
- Informatica Inc.
- Collibra NV
- Alation Inc.
- Snowflake Inc.
- Tibco Software Inc.
Marktchancen und Zukunftsaussichten
Agentenbasierte und konversationelle Analysen verschieben die Datenermittlung von einer Katalog- und Suchfunktion zu einer aktiven Kontextebene, die steuern kann, wie KI-Agenten Unternehmensdaten finden, interpretieren und darauf handeln. Die Roadmaps der Anbieter spiegeln diese Richtung bereits wider. Im Juli 2026 machte Google Cloud Conversational Analytics in BigQuery allgemein verfügbar, wobei Gemini-Modelle für die Interaktion in natürlicher Sprache verwendet werden, und AWS erreichte die allgemeine Verfügbarkeit für Amazon Bedrock Managed Knowledge Base mit integrierter Dokumentenzugriffskontrolle für agentenbasierte Abfragen. Diese Produktifizierung schafft Freiraum für Ermittlungsplattformen, die Kennzahlendefinitionen standardisieren, vertrauenswürdige semantische Schichten bereitstellen und richtlinienbewussten Zugriff in Workflows erzwingen können, in denen Geschäftsanwender (und Agenten) Daten ohne manuell erstellte Dashboards abfragen.
Eine zweite Chance liegt in der Vereinheitlichung verteilter Datenbestände, insbesondere dort, wo souveräne und regulierte Bereitstellungen hybride Architekturen erfordern. Im Juli 2026 kündigte Denodo die Denodo Platform 9.5 mit semantischen Elementen (Metric Views) in einem Wissensgraphen an, um Kontext für agentenbasierte KI bereitzustellen, und unterstrich damit die Nachfrage nach aktiven Metadaten und quellenübergreifendem Kontext anstelle passiver Dokumentation. Da On-Premise 2025 noch 54,30 % des Marktanteils der Datenermittlung ausmacht, haben Anbieter und Serviceanbieter Spielraum, sich durch Governance-by-Design-Implementierungen, vorgefertigte Compliance-Vorlagen (Risiko- und Compliance-Management machte 27,95 % der Anwendungsumsätze 2025 aus) und Konnektoren zu differenzieren, die eine konsistente hybride Ermittlung über Cloud-, souveräne Cloud- und Legacy-Umgebungen hinweg gewährleisten, ohne die Prüfpfade zu schwächen.
Aktuelle Branchenentwicklungen im Markt für Datenerkennung
- Juli 2026: Tableau (Salesforce) erweiterte die Tableau-Agent-Funktionen um neue Verbesserungen bei konversationellen Analysen und KI-Integrationen, einschließlich Claude, ChatGPT und Codex. Die Updates stärken die durch natürliche Sprache gesteuerte Analyse und beschleunigen die Self-Service-Ermittlung für Geschäftsanwender. Die breitere Modellkonnektivität erhöht zudem den Wettbewerbsdruck auf Anbieter, multi-modellfähige Governance, Datenherkunft und konsistente semantische Definitionen zu unterstützen.
- Mai 2025: Salesforce stellte Tableau Next vor und positionierte es als KI-agentengetriebenen Ansatz für Business Intelligence, der Erkenntnisse mit Aktionen innerhalb von Unternehmensworkflows verknüpft. Die Einführung verstärkte den Marktwandel von dashboard-zentrierter BI zu agentengestützter Exploration und Entscheidungsautomatisierung. Sie erhöhte zudem die Bedeutung von kontrollierten semantischen Schichten und vertrauenswürdigen Datenprodukten, um inkonsistente Kennzahlen im großen Maßstab zu vermeiden.
- Juni 2024: Die Europäische Union verabschiedete die Verordnung (EU) 2024/1689 (KI-Verordnung) und schuf damit einen risikobasierten Rahmen für KI-Systeme, einschließlich strenger Anforderungen an die Datenverwaltung für Hochrisiko-Anwendungsfälle. Die Gesetzgebung erhöhte die Nachfrage nach Ermittlungsfunktionen, die Datenquellen, Vorbereitungsschritte und Bias-Kontrollen dokumentieren können. Diese regulatorische Ausrichtung erhöhte die Bedeutung von Metadatenmanagement, Datenherkunft und prüfungsbereiter Berichterstattung im Beschaffungsprozess über KI-gestützte Analysestacks hinweg.
Data-Discovery-Markt Berichtsumfang und Forschungsmethodik
Marktdefinition und Abdeckung
Dieser Markt umfasst Umsätze aus Data-Discovery-Software und zugehörigen Dienstleistungen, die Organisationen dabei helfen, Daten in On-Premises-, Cloud- und hybriden Umgebungen zu finden, zu profilieren, zu klassifizieren und zu verstehen.
Ausschlüsse aus dem Umfang: Wir schließen reine ETL-Tools, Hardware für Data Warehousing und eigenständige Visualisierungspakete aus, die nicht als Data Discovery positioniert sind.
Segmentierungsübersicht
- Nach Komponente
- Software
- Dienstleistungen
- Nach Bereitstellungsmodell
- On-Premise
- Cloud
- Hybrid
- Nach Unternehmensgröße
- Kleine und mittlere Unternehmen
- Großunternehmen
- Nach Branchenvertikale
- Bankwesen, Finanzdienstleistungen und Versicherungen (BFSI)
- Telekommunikation und IT
- Einzelhandel und E-Commerce
- Fertigung
- Energie und Versorgungsunternehmen
- Gesundheitswesen und Biowissenschaften
- Regierung und öffentlicher Sektor
- Sonstige Branchen
- Nach Anwendung
- Risiko- und Compliance-Management
- Vertriebs- und Marketingoptimierung
- Kundenerlebnis und Personalisierung
- Betriebs- und Lieferketten-Analytik
- Asset- und Performance-Management
- Sonstige Anwendungen
- Nach Geografie
- Nordamerika
- Vereinigte Staaten
- Kanada
- Mexiko
- Südamerika
- Brasilien
- Argentinien
- Übriges Südamerika
- Europa
- Vereinigtes Königreich
- Deutschland
- Frankreich
- Spanien
- Italien
- Übriges Europa
- Asien-Pazifik
- China
- Japan
- Indien
- Südkorea
- Australien und Neuseeland
- Übriger asiatisch-pazifischer Raum
- Naher Osten
- Israel
- Saudi-Arabien
- Vereinigte Arabische Emirate
- Türkei
- Übriger Naher Osten
- Afrika
- Südafrika
- Ägypten
- Nigeria
- Übriges Afrika
- Nordamerika
Datenquellen, Marktgröße und Validierung
Desk Research
Der Desk Research beginnt mit öffentlich zugänglichen Signalen, die überprüft und erneut geprüft werden können, bevor Annahmen hinzugefügt werden. Wir verwenden Quellen wie die Datenreihen des US Census Bureau und des Bureau of Economic Analysis zur Ausrichtung der IT-Ausgaben von Unternehmen, SEC-Einreichungen und Jahresberichte in den USA, um die Sprache der Umsatzmischung zu verstehen, sowie begutachtete Fachzeitschriften für Akzeptanzmuster und Datenverwaltungspraktiken.
Um das Modell geografisch und regulatorisch zu verankern, beziehen wir uns auch auf Quellen wie NIST-Publikationen, OECD-Statistiken zur digitalen Wirtschaft und Materialien der Europäischen Kommission zu Datenverwaltung und grenzüberschreitenden Datenregeln. Patentdatenbanken werden genutzt, um zu verfolgen, wie schnell sich discovery-bezogene Fähigkeiten weiterentwickeln und welche Funktionen produktisiert werden. Wir prüfen außerdem Investorenpräsentationen und seriöse Technologiepresse, um wichtige Fähigkeitsverschiebungen und Bereitstellungstrends zeitlich einzuordnen. Diese Beispiele sind nicht abschließend, und viele weitere Quellen wurden für die Datenerhebung, Validierung und Klärung herangezogen.
Primärinterviews und Umfragen
Primärforschung wird eingesetzt, um zu testen, was die Desk-Research-Ergebnisse nicht vollständig erklären, insbesondere hinsichtlich dessen, was Käufer als Data Discovery im Vergleich zu angrenzenden Analyse-Tools betrachten. Wir sprechen mit einer Mischung aus Plattformanbietern, Servicepartnern, Systemintegratoren und Unternehmensanwendern und decken Nachfragesignale aus dem APAC-Raum, EMEA und Amerika ab, sodass regionale Einführungsrealitäten berücksichtigt werden.
Erkenntnisse aus Interviews helfen dabei, Verschiebungen im Bereitstellungsmix, typische Bündelung mit Governance-Funktionen sowie die Veränderung der Preisgestaltung in Abhängigkeit von Datenvolumen, Benutzerlizenzen und Workload-Umfang zu bestätigen, die dann in das endgültige Modell einfließen.
Verteilung der Befragten in der Primärforschung
| Unternehmenstyp | Position des Befragten | Region |
|---|---|---|
| Oberste Ebene: 30 % | CXOs: 19 % | APAC: 45 % |
| Mittlere Ebene: 49 % | Funktions-/Bereichsleiter: 27 % | EMEA: 29 % |
| Kleinere Akteure: 21 % | Manager: 54 % | Amerika: 26 % |
Marktgröße und Prognose
Für die Größenbestimmung verwenden wir einen Top-down- und Bottom-up-Ansatz. Ausgangspunkt ist ein Nachfragepool, der aus den Ausgabenmustern für Unternehmenssoftware aufgebaut und dann auf discovery-spezifische Anwendungsfälle abgebildet wird. Um dies nicht zu abstrakt werden zu lassen, werden die Gesamtwerte mit selektiven Bottom-up-Näherungen abgeglichen, wie z. B. stichprobenartige Umsatzhinweise von Anbietern, Überprüfungen durch Kanalpartner sowie eine Berechnung aus Durchschnittsverkaufspreis multipliziert mit dem Adoptionsvolumen unter Verwendung typischer Lizenzbänder.
Zu den wichtigsten Eingangsgrößen, die das Modell steuern, gehören der Bereitstellungsmix aus Cloud und On-Premises, die Einführung von Self-Service-Discovery-Workflows, das Wachstum gesteuerter Dateninitiativen, das Tempo des Wachstums unstrukturierter Daten sowie die durchschnittliche Preislogik, die an Benutzerlizenzen und Datenconnectors geknüpft ist. Wo Bottom-up-Signale dünn sind, schließen wir Lücken mithilfe von Proxy-Verhältnissen aus ähnlichen Käuferkohorten und passen diese an, nachdem das Primärfeedback bestätigt, ob die Verhältnisse realistisch erscheinen.
Prognosen werden mithilfe einer Szenarioanalyse erstellt, die durch eine leichte multivariate Regression unterstützt wird. Treiber wie das Tempo der Cloud-Migration, der regulatorische Druck zur Datenverwaltung und die Einführung von Unternehmensanalysen werden innerhalb realistischer Bandbreiten variiert. Die endgültige Entwicklung wird erst akzeptiert, wenn die Ergebnisse mit den primären Erwartungen hinsichtlich Budgetzyklen und Verlängerungszeitpunkten übereinstimmen.
Datenvalidierung und Aktualisierungszyklus
Die Validierung erfolgt durch eine Reihe von Prüfungen, die die Zahl aus mehr als einem Blickwinkel erklärbar machen. Wir vergleichen die Ergebnisse mit unabhängigen Signalen wie der Ausrichtung der Ausgaben für Unternehmenssoftware, der Ausweitung von Cloud-Workloads und offengelegten Segmentnarrativen und untersuchen dann alle starken Sprünge, die nicht mit den Adoptionsrealitäten übereinstimmen.
Vor der Freigabe wird das Modell in mehreren Schritten überprüft. Ausreißer werden besprochen und mit klaren Anmerkungen zu den vorgenommenen Änderungen und deren Gründen korrigiert. Berichte werden jährlich aktualisiert, und Zwischenaktualisierungen werden ausgelöst, wenn wesentliche Ereignisse eintreten, wie z. B. größere Verschiebungen im Preismodell oder Änderungen der Datenverwaltungsregeln. Unmittelbar vor der Auslieferung führt ein Analyst einen abschließenden Durchgang durch, damit die Kunden die aktuellste Ansicht erhalten.
Vergleich der Data-Discovery-Marktgröße von Mordor Intelligence mit anderen veröffentlichten Schätzungen
Veröffentlichte Zahlen für Data Discovery können weit auseinanderliegen, weil das Marktlabel uneinheitlich verwendet wird und weil angrenzende Tools manchmal in die Gesamtsumme einbezogen werden. Unterschiede treten auch auf, wenn eine Quelle eine reine Software-Sicht ausweist, während eine andere Dienstleistungen hinzufügt, oder wenn Basisjahr und Währungszeitpunkt nicht aufeinander abgestimmt sind.
Die Hauptlücke ergibt sich daraus, ob eigenständige BI- und generische Visualisierungsumsätze als Data Discovery gezählt werden. Bei Mordor Intelligence wird die Gesamtsumme auf Discovery-Plattformen zuzüglich zugehöriger Dienstleistungen beschränkt, die explizit das Auffinden, Profilieren und Katalogisieren von Daten in verschiedenen Umgebungen unterstützen. Ein weiterer Treiber ist die Modellierung der Preisgestaltung im Zeitverlauf. Einige Schätzungen gehen von einer aggressiven Ausweitung des Durchschnittsverkaufspreises durch KI-Erweiterungen aus, ohne das Verlängerungsverhalten zu prüfen, während andere eine konservative Logik mit konstanten Preisen verwenden. Auch der Aktualisierungsrhythmus spielt eine Rolle, da sich schnell verändernde Produktbündelungen von einem Jahr zum nächsten verändern können, was einbezogen wird.
Benchmark-Vergleich
| Quelle | Marktgröße | Lücken in der Forschungsmethodik |
|---|---|---|
| Mordor Intelligence | 16,10 Milliarden USD (2025) | |
| Globales Beratungsunternehmen A | 12,70 Milliarden USD (2024) | Verwendet ein früheres Basisjahr und scheint eine breitere Auswahl an Software- und Servicekomponenten einzubeziehen, was Governance- und Analyse-Elemente einschließen kann, die nicht immer als Discovery verkauft werden. |
| Branchenpublikation B | 8,90 Milliarden USD (2023) | Verankert den Markt an gemeldeten Umsatzerlösen in einem früheren Jahr und könnte gebündelte Discovery-Funktionen, die innerhalb breiterer Datenplattformen verkauft werden, unterbewerten, was die Gesamtsumme im Vergleich zu einem fähigkeitsorientierten Umfang komprimieren kann. |
Zusammengenommen lässt sich die Streuung größtenteils durch Umfangsgrenzen und Jahresabgleich erklären und nicht durch eine einzelne mathematische Entscheidung. Indem die Gesamtsumme an klare Käufer-Anwendungsfälle geknüpft, die Preisgestaltung anhand realer Bereitstellungsmuster überprüft und Annahmen durch Interviews validiert werden, bleibt die Schätzung auf Eingaben zurückführbar, die ein Leser nachvollziehen und wiederholen kann.
Im Bericht beantwortete Schlüsselfragen
Wie groß ist der Datenerkundungsmarkt derzeit und wie schnell wächst er?
Der Datenerkundungsmarkt wird im Jahr 2026 auf 18,82 Milliarden USD geschätzt und soll bis 2031 41,07 Milliarden USD erreichen, was einer CAGR von 16,92 % entspricht.
Welche Region führt den Markt heute an, und welche Region expandiert am schnellsten?
Für den APAC-Raum wird bis 2031 der schnellste CAGR von 18,27 % prognostiziert.
Welche Branchenvertikalen sind die größten Beitragenden und die am schnellsten wachsenden?
Bankwesen, Finanzdienstleistungen und Versicherungen repräsentieren den größten Anteil von 23,78 %, während Gesundheitswesen und Biowissenschaften mit einer CAGR von 18,92 % wachsen.
Welches Bereitstellungsmodell gewinnt gegenüber On-Premise-Systemen an Bedeutung?
Cloud-Bereitstellungen sollen mit einer CAGR von 24,62 % wachsen und damit On-Premise-Installationen übertreffen, die im Jahr 2025 noch 54,30 % des Umsatzes ausmachen.
Was sind die wichtigsten Hemmnisse, die das Marktwachstum verlangsamen könnten?
Die bedeutendsten Hindernisse umfassen Datensicherheits- und Datenschutzrisiken (–2,8 % Auswirkung auf die CAGR), Talentmangel in der Daten-Stewardship (–2,1 %), Komplexität der Legacy-System-Integration (–1,7 %) und strenge souveräne Cloud-Datenlokalisierungsmandate (–1,4 %).