
自然言語処理市場規模とシェア
市場概要
| 調査期間 | 2020 - 2031 |
|---|---|
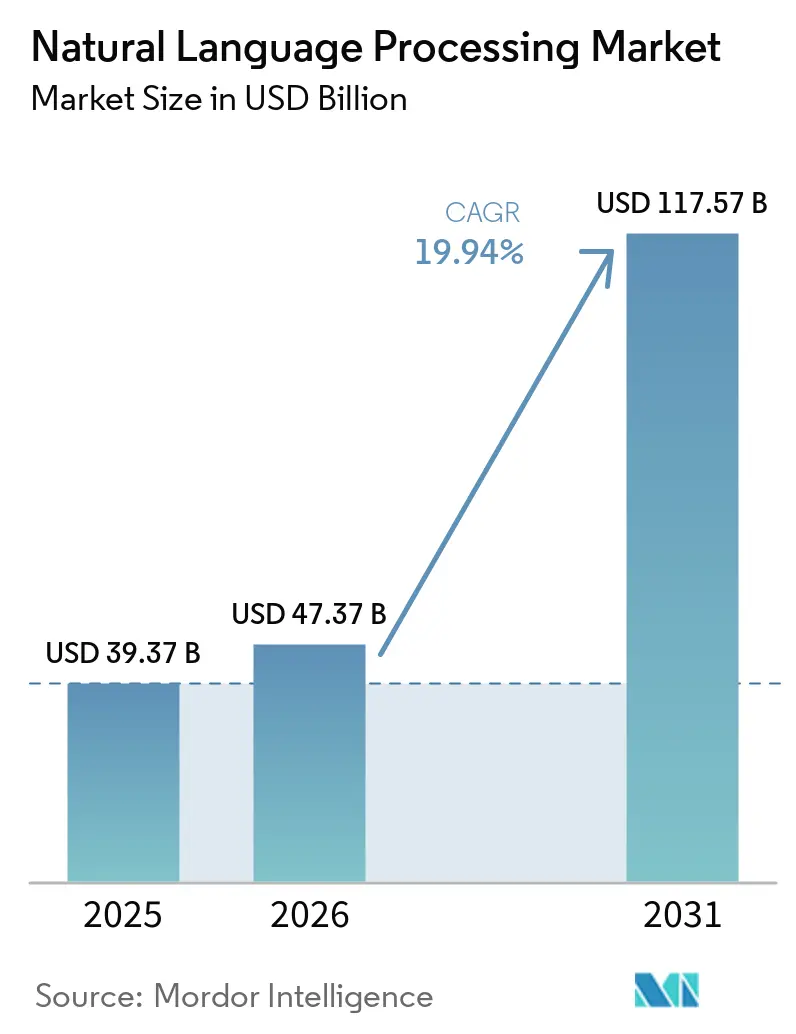
| 市場規模 (2026) | 47.37 十億米ドル |
| 市場規模 (2031) | 117.57 十億米ドル |
| 成長率 (2026 - 2031) | 19.94 % |
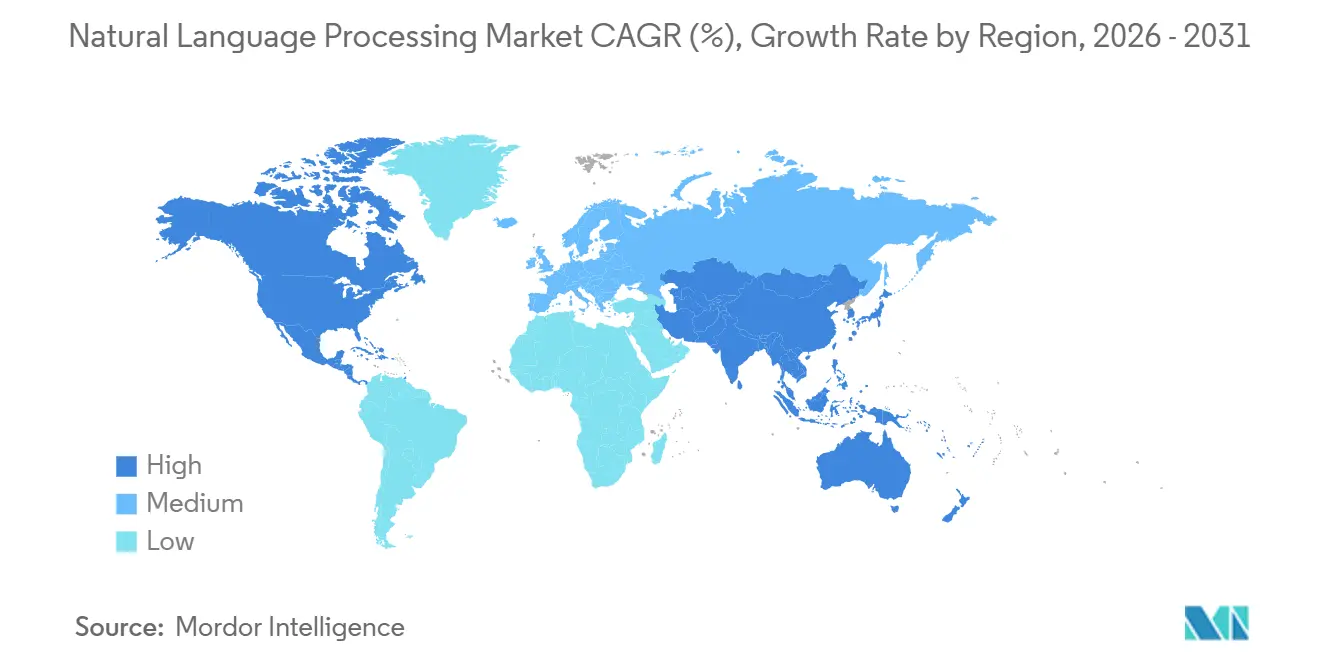
| 最も急速に成長している市場 | アジア太平洋 |
| 最大市場 | 北米 |
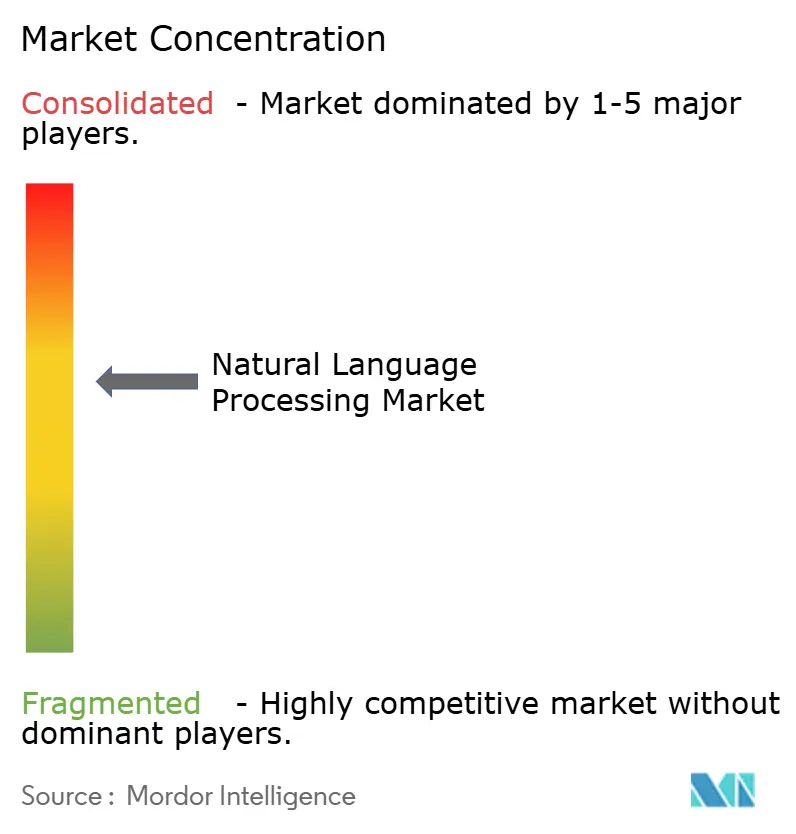
| 市場集中度 | 中 |
主要プレーヤー 注:主要企業の掲載順は順位を示すものではありません。 画像 © Mordor Intelligence。再利用にはCC BY 4.0の表示が必要です。 | |
Mordor Intelligenceによる自然言語処理市場分析
自然言語処理市場規模は、2025年の393億7,000万米ドル、2026年の473億7,000万米ドルから、2031年までに1,175億7,000万米ドルへと拡大する見込みであり、2026年から2031年にかけて年平均成長率19.94%を記録すると予測されています。この急成長は、ドメイン固有の精度を二桁台のポイントで向上させるトランスフォーマーの改良、推論レイテンシを100ミリ秒未満に短縮するクラウドとエッジの相乗効果、そして概念実証から本番稼働へと予算を振り向ける規制の明確化に支えられています。企業の購買担当者は現在、基盤モデルを実験的な付加機能ではなくコアインフラとして位置づけ、分析予算を統合ツール、バイアス監査、カーボンニュートラルなコンピューティングオプションへと再配分しています。ベンダー間の競争は、トークンあたりのコスト削減、EUのAI法に向けた高リスクモジュールの事前認証、そして英語中心のシステムでは十分に対応されていない低リソース言語セグメントの獲得に集中しています。資本の流れもこれらの優先事項を反映しており、ハイパースケーラーはGPU供給をマネージドプラットフォームに注ぎ込む一方、自動車および医療のリーダー企業は確定的なレイテンシを確保するためにエッジ推論プロジェクトに資金を投じています。
主要レポートのポイント
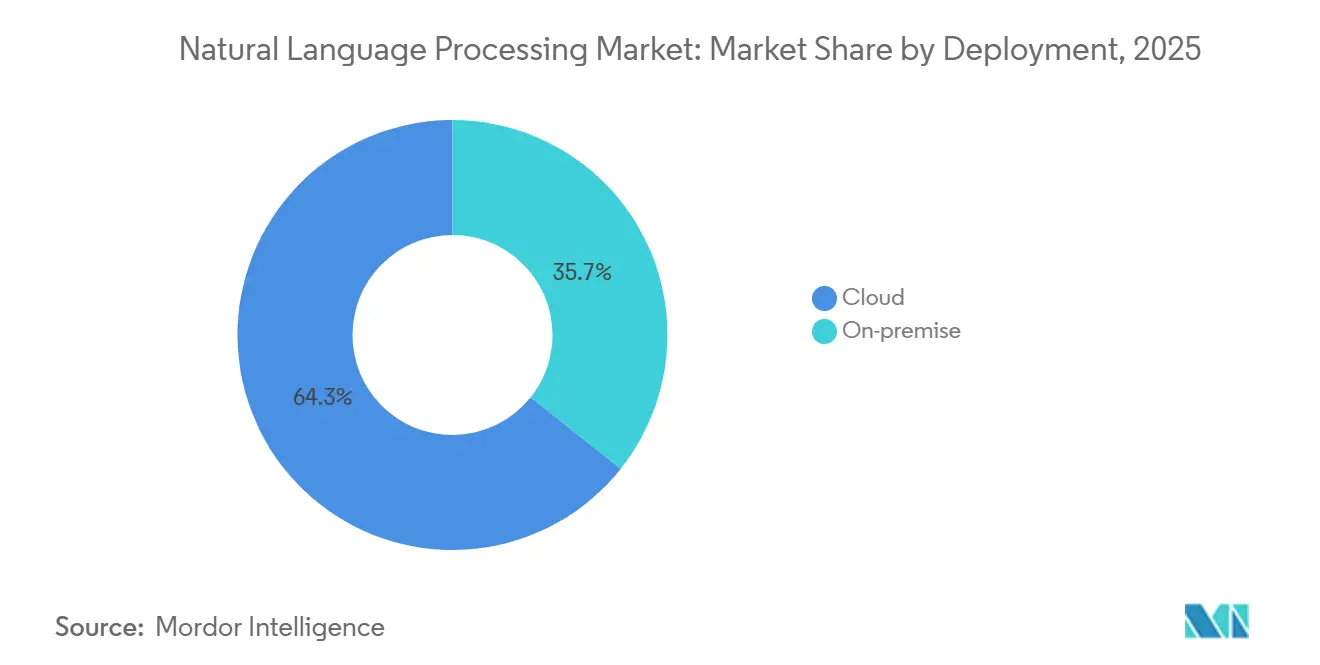
- 展開形態別では、クラウドが2025年の自然言語処理市場シェアの64.31%を占め、サービスは2031年にかけて最も高い年平均成長率22.62%を記録する見込みです。
- 組織規模別では、大企業が2025年の自然言語処理市場の73.13%を占め、中小企業は2031年にかけて年平均成長率19.98%で拡大すると予測されています。
- コンポーネント別では、ソフトウェアが2025年の自然言語処理市場規模の46.14%のシェアを占めましたが、サービスは2031年にかけて年平均成長率22.62%で拡大しています。
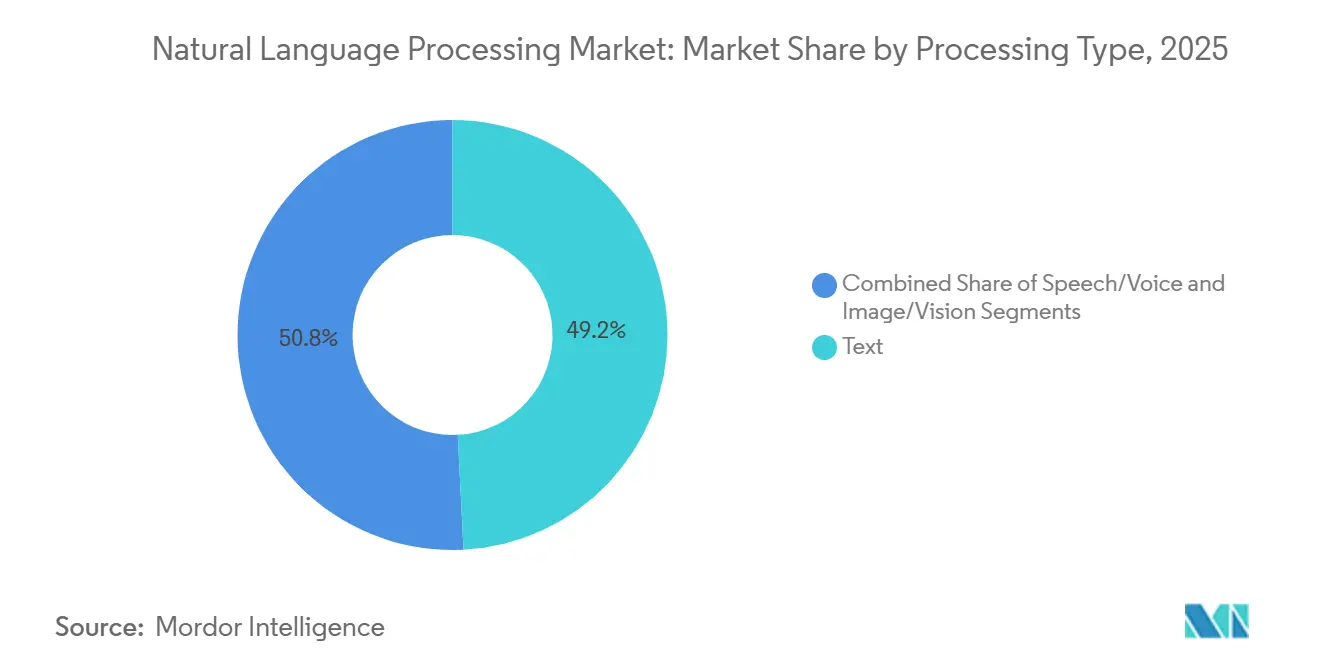
- 処理タイプ別では、テキスト処理が2025年に49.18%のシェアでトップとなり、音声認識は2026年〜2031年にかけて年平均成長率22.41%を記録すると予測されています。
- エンドユーザー産業別では、BFSIが2025年の自然言語処理市場規模の20.13%を占め、ヘルスケアおよびライフサイエンスは2031年にかけて年平均成長率24.84%という最も高い成長軌道を示しています。
- 地域別では、北米が2025年に37.92%のシェアを維持し、アジア太平洋地域は2031年にかけて年平均成長率22.13%という最も急速な成長が見込まれています。
注:本レポートの市場規模および予測数値は、Mordor Intelligence 独自の推定フレームワークを使用して作成されており、2026年1月時点の最新の利用可能なデータとインサイトで更新されています。
グローバル自然言語処理市場のトレンドとインサイト
ドライバーの影響分析*
| ドライバー | 年平均成長率予測への影響(〜%) | 地理的関連性 | 影響のタイムライン |
|---|---|---|---|
| 生成AIを活用したモデル精度の向上 | +4.5% | グローバル、北米およびアジア太平洋地域に集中 | 中期(2〜4年) |
| カスタマーサポートにおける会話型AIの採用急増 | +3.8% | グローバル、北米およびヨーロッパが主導し、アジア太平洋地域へ拡大 | 短期(2年以内) |
| 組み込みまたはエッジデバイスへの自然言語処理の統合 | +3.2% | アジア太平洋地域が中核、北米およびヨーロッパへの波及 | 中期(2〜4年) |
| 規制産業向けドメイン固有大規模言語モデルの普及 | +2.9% | 北米およびヨーロッパ、アジア太平洋地域での段階的な採用 | 長期(4年以上) |
| 自動車およびスマートデバイスにおけるリアルタイム音声認識の需要増加 | +2.4% | グローバル、北米・ヨーロッパ・中国が早期リーダーシップ | 中期(2〜4年) |
| 新たな垂直市場を開拓するマルチモーダル基盤モデル | +2.1% | グローバル、北米およびアジア太平洋地域のテクノロジーハブに集中 | 長期(4年以上) |
| 情報源: Mordor Intelligence | |||
生成AIを活用したモデル精度の向上
2025年の基盤モデルのリリースでは、10,000件未満のラベルでファインチューニングした際に専門ベンチマークで18〜23パーセントポイントの向上を記録し、アノテーションコストを大幅に削減するとともに、法的条項の抽出やICD-10コーディングなど高い責任が伴うワークフローへの適用を可能にしました。[1] GoogleのGemini 2.0 Flashは推論レイテンシを40%削減し、かつてバッチ処理を必要としていた会話および要約タスクを可能にしました。混合エキスパートルーティングは、クエリごとに1兆パラメータのうち10〜15%のみをアクティブに保ち、精度を損なうことなくエネルギー消費を削減します。OpenAIのo3モデルはARC-AGIで87.5%を記録し、多段階推論が自動化の範囲に入りつつあることを示しています。これらの進歩が相まって、自然言語処理市場がミッションクリティカルな業務を支えられるという経営幹部レベルの確信を高めました。
カスタマーサポートにおける会話型AIの採用急増
ティア1エージェントの賃金インフレが12〜18%に達したことでコンタクトセンターは自動化へと向かい、検索拡張生成(RAG)により2025年半ばまでに初回解決率が75〜85%に向上しました。[2]SalesforceのAgentforce 2.0は、CRM、請求、在庫フローを引き継ぎなしでオーケストレーションし、平均処理時間を最大40%削減します。クラウドプラットフォームはチャットAPIを既存のエンタープライズ契約にバンドルし、パイロット期間を四半期単位から数週間に短縮しました。EUのAI法はほとんどのカスタマーサービスボットを限定リスクに分類し、適合性審査を免除することで、EU域内での採用を加速させました。[3]
組み込みまたはエッジデバイスへの自然言語処理の統合
ニューラルユニットを搭載したスマートフォンチップセットは現在、70億パラメータのモデルをローカルで実行し、クラウド呼び出しに伴う200〜500ミリ秒の往復レイテンシを解消するとともに、プライバシーへの懸念を払拭しています。AppleのIntelligenceはSiriリクエストの80%をデバイス上で処理しており、この転換は中国およびインドの厳格なデータローカライゼーション規制と整合しています。Mercedes-BenzはMBUXコックピットに精度95%のドメインモデルを統合し、エッジ推論が接続性なしでリアルタイムの自動車ニーズを満たせることを示しました。その結果、自然言語処理市場は、確定的な応答時間と居住地要件への準拠を保証するオンデバイスツールキットへと傾いています。
規制産業向けドメイン固有大規模言語モデルの普及
厳選されたコーパスでファインチューニングされた垂直モデルは汎用モデルを12〜18ポイント上回り、誤分類が罰則を招くセクターでは3〜5倍の高いトレーニングコストを正当化しました。NuanceのDAX Copilotは100万件以上の臨床受診を処理し、文書作成の負担を半減させ、燃え尽き症候群を緩和しました。銀行は財務申告でトレーニングされたモデルを採用し、マネーロンダリング対策における誤検知率を95%から70%未満に削減しました。EUのAI法は信用スコアリングに対して説明可能性を求めており、ベンダーは透明性の高いアーキテクチャと認定済みツールチェーンへと誘導されています。
制約要因の影響分析*
| 制約要因 | 年平均成長率予測への影響(〜%) | 地理的関連性 | 影響のタイムライン |
|---|---|---|---|
| 高品質でバイアスのないトレーニングデータの不足 | -1.8% | グローバル、非英語および低リソース言語で深刻 | 短期(2年以内) |
| 大規模モデルの推論コストの増大 | -1.5% | グローバル、北米およびヨーロッパで最も顕著 | 中期(2〜4年) |
| 国境を越えたデータ居住コンプライアンスの障壁 | -1.2% | グローバル、ヨーロッパ・中国・インドに集中 | 長期(4年以上) |
| 大規模トレーニングコンピューティングの環境負荷 | -0.9% | グローバル、ヨーロッパで規制圧力が最も強い | 長期(4年以上) |
| 情報源: Mordor Intelligence | |||
高品質でバイアスのないトレーニングデータの不足
監査によると、コーパスの70〜80%が依然として英語であり、他の言語では15〜25ポイントの低下をもたらし、多言語地域でのコンプライアンスリスクに企業をさらしています。合成生成ツールはギャップを埋めますが、繰り返しのファインチューニング後にモード崩壊のリスクがあります。医療記録はHIPAAの背後に孤立しており、PCI-DSSはトランザクションログをロックダウンし、トレーニングプールを断片化しています。標準化されたバイアステストがなければ、企業は独自の監査を考案することになり、調達が遅延します。この制約は、主権AIの自律性を求める国内市場に重くのしかかっています。
大規模モデルの推論コストの増大
1,000億パラメータのシステムをサブ秒レイテンシで提供するには、インスタンスあたり8〜16台のGPUが必要であり、1日100万ユーザーの場合、コンピューティングコストは月額最大10万米ドルに達します。量子化とプルーニングはパラメータを半減させますが、精度を数ポイント低下させ、多くのリスクマネージャーはこれを受け入れません。NVIDIA TensorRT-LLMなどのツールチェーンはスループットを3倍にしますが、急峻な学習曲線が展開を遅らせます。階層型クラウド価格設定はトラフィックの急増時にボラティリティを加えます。このコストの逆風は、製品チームに品質と利益率のトレードオフを迫り、価格に敏感なアプリケーションにおける自然言語処理市場を抑制しています。
*当社の予測では、推進要因および抑制要因の影響を加算的ではなく方向性のあるものとして扱います。影響予測は、ベースライン成長、構成効果、および変数間の相互作用を反映しています。
セグメント分析
展開形態別:クラウドの優位性がエッジの勢いを覆い隠す
クラウドは2025年の自然言語処理市場において64.31%のシェアを維持しており、企業は弾力的なスケーリングとバンドルされたAIサービスを好んでいます。2031年にかけてこのセグメントは20.01%で成長し、ハイパースケーラーは独自モデルをより広範な契約に組み込むことでワークロードを囲い込んでいます。オンプレミスクラスターは、すべてのデータフローを監査しなければならない銀行や病院内で存続しており、このような選択はコストを最大50%引き上げる場合でも同様です。AWS BedrockとAzureの機密エンクレーブは現在、境界線を曖昧にしており、クライアントは管理されたオーケストレーションに依存しながらも、機密性の高いペイロードを仮想プライベートクラウド内に保持できます。
アジア太平洋地域でスマートフォン普及率が70%を超え、自動車メーカーが確定的な音声制御を求めるにつれ、エッジの採用が急増しています。GoogleのAI Edge SDKはGemini Nanoを2GB未満に圧縮し、高品質な自然言語処理が中位クラスのハンドセットで動作できることを証明しました。Mercedes-BenzとBMWは、推論をローカライズした後に音声インテント精度が20ポイント向上したことを示しています。デバイス内でデータを処理することで、アーキテクチャの変更なしに中国の個人情報保護法を満たすことができ、インドのデジタル個人データ保護法の下でも同様のダイナミクスが展開されています。この二軌道の進化は、自然言語処理市場が単一拠点の優位性ではなく、クラウドとエッジの同等性を重視するようになったことを意味しています。
組織規模別:中小企業がギャップを縮める
大企業は2025年の自然言語処理市場シェアの73.13%を占め、ペタバイト規模のデータと専任のMLOpsチームを活用しています。しかし、中小企業はノーコードエージェントとトークン従量課金モデルが資本障壁を排除するため、年平均成長率19.98%で大企業を上回るペースで成長すると予測されています。Hugging Faceのハブと消費量ベースのクラウド価格設定により、実験コストは2万米ドル未満に抑えられ、シードステージのスタートアップにも手が届くようになっています。迅速な意思決定サイクルにより、中小企業は数週間で音声コマースボットや契約分析ツールのパイロットを実施でき、動きの遅い既存企業よりも先にニッチな機会を掴むことが多いです。
大企業は、ERP、CRM、サプライチェーンフィードを同時に活用するマルチシステム統合において優位性を保っています。また、展開を最大1年延長する可能性のある重いEU AI法監査も負担しており、これは最小規模の企業がユースケースが限定リスク分類に該当する場合に回避できるオーバーヘッドです。予測期間にわたって収束が見込まれており、成熟したツールが技術的なギャップを解消し、両コホートが生のコンピューティング規模ではなくワークフローの親密さで差別化を図ることを余儀なくされます。
コンポーネント別:統合の複雑さが増すにつれてサービスが急増
ソフトウェアは2025年の自然言語処理市場支出の46.14%を占め、基盤モデルとファインチューニングプラットフォームのライセンス供与を通じて獲得しました。しかし、年間22.62%の成長が予測されるサービスは、企業がモデルドリフト、バイアス監視、EU適合性監査に直面するにつれて、最も急速に増加する費目となっています。アクセンチュア、デロイト、PwCは現在、ベンダー選定、データパイプライン構築、24ヶ月のMLOpsサポートをFortune 500のロールアウト向けに500万米ドルを超える固定料金バンドルにパッケージ化しています。
ハードウェアは依然として不可欠であり、NVIDIA GPUは出荷されたトレーニングチップの80%以上を占めていますが、ハイパースケーラーのカスタムASICが推論ワークロードで存在感を増すにつれて、そのシェアは徐々に低下しています。サービスの自然言語処理市場規模は2028年までにハードウェアを上回る可能性が高く、複雑さが生のシリコン不足を超えるにつれて、設備投資から運用費用へのシフトを示しています。
処理タイプ別:音声認識が存在感を増す
テキスト処理は、成熟したドキュメントマイニングおよびセンチメント分析ツールにより、2025年に49.18%のシェアを維持しました。一方、音声認識はリアルタイム文字起こがアンビエントヘルスケアドキュメンテーションおよび車載音声アシスタントを可能にすることから、22.41%のCAGRで成長軌道にあります。クリニックにおけるアンビエントインテリジェンスは、1回の診察あたりの書類作業時間を40〜50%削減し、医師不足の中での負担軽減に貢献しています。自動車OEMは完全オフライン型アシスタントを導入し、通信圏外の問題やプライバシーへの懸念を解消しています。
GPT-4Vのようなマルチモーダルモデルは画像とテキストを相互に連携させ、小売商品検索、X線画像解析、自然言語生成へと適用範囲を拡大しています。ビジョンモジュールが成熟するにつれ、自然言語処理市場はマルチモーダルの領域へと進化し、データ入力においてキーボードがカメラやマイクと競合する時代へと移行しています。

エンドユーザー産業別:ヘルスケアが採用曲線をリード
ヘルスケアおよびライフサイエンスは、アンビエントノートテイキング、コーディング自動化、創薬文献マイニングに牽引され、2031年にかけて年平均成長率24.84%で成長しています。NuanceのDAX Copilotは100万件以上の受診を処理し、医療提供者が時間延長なしに1日2人の追加患者を診察できる能力を付与しています。2025年に20.13%のシェアを保有する金融サービスは、誤検知を4分の1削減し、不審取引のブロックを2秒未満に高速化する不正検知に注力しています。
小売チャネルは写真を商品リストに変換するビジュアル検索を活用し、パイロットでコンバージョンを二桁台で向上させています。製造業は予知保全のためのログ解析を活用し、計画外のダウンタイムを最大30%削減しています。各セクターにわたって、成功はバニラテキスト分析よりもワークフロー統合の深さとバイアスガバナンスにますます依存しています。
地域分析
北米は2025年に37.92%のシェアを維持しており、ハイパースケーラーのインフラとリスク許容度の高いアーリーアダプターに支えられています。企業は潤沢なベンチャー資金を活用し、規制サンドボックスにより銀行は監督指導のもとで生成モデルを試験できます。しかし、飽和と増大するコンプライアンスオーバーヘッドが成長を10%台後半に抑制しています。
アジア太平洋地域は、中国の500億米ドル規模の主権AI推進、インドの公共デジタルスタック、日本の高齢化社会の課題が収束し、年平均成長率22.13%という最も急速な成長を記録しています。中国の国有企業は国内モデルの展開を義務付け、BaiduとAlibabaの採用を促進しています。インドの統一決済インターフェース(UPI)は数十億件の多言語記録を不正検知および信用モデルに供給しています。日本の病院はアンビエント文書化システムの導入時に税制優遇を享受し、臨床自然言語処理のロールアウトを促進しています。
ヨーロッパはEU AI法の明確性から恩恵を受けていますが、適合性審査により高リスクな製品の発売に6〜12ヶ月が追加されます。ドイツの自動車メーカーはGDPRを満たすためにローカル音声アシスタントを組み込んでいます。英国はコンプライアンスコスト削減のためにKYC自動化を奨励しています。南米は地域の方言に合わせたカスタマーサービスボットを採用し、中東は経済多様化の柱として主権AIに資金を投じています。アフリカの普及はナイジェリアとケニアに集中しており、モバイルファーストの自然言語処理がフィンテックと農業普及メッセージングを支援しています。出発点は異なりますが、すべての地域が10年末までに自然言語処理市場をコアデジタルインフラとして位置づけています。
規制環境
NLPの規制環境は、規制対象のワークフローにおける汎用および高リスク言語システムの両方に適用される横断的なAIガバナンス制度によって形成されている。EUでは、AI法(規則(EU)2024/1689)が2026年8月2日から適用される義務を創設し、コンプライアンス上の期待は、文書化された技術情報(附属書IV)と、整合規格に関連する適合性評価の経路(第40条)に結び付けられている。EU AI Officeは公式ベータ版のコンプライアンスチェッカーも運用しており、事業者はこれを用いて、顧客対応型の会話型AIから、信用や雇用関連の意思決定支援などの高リスクなアプリケーションに至るまでの要件を整理している。
米国では、連邦政策は依然として比較的規範性の低いアプローチを通じたイノベーション重視の姿勢を継続しており、NIST AIリスクマネジメントフレームワークのような自主的なリスク管理手法に依拠している。2025年12月の大統領令14365は、商業化の障壁削減を軸にAIガバナンスを枠組み化しており、2026年3月のホワイトハウスの国家政策フレームワークは、分断化した州のAI法を先取りし統一的な国家基準を推進するための議会の行動を提言しており、これはクラウドNLP APIの複数州展開に影響を与える。日本では、2026年6月の生成AIに関する政府調達・利用ガイドラインにより、各省庁にChief AI Officer(CAIO)の設置が求められており、公共部門向けプログラムに販売されるNLP対応システムにとって、ガバナンスとリスク管理が調達の前提条件となっている。
競合環境
Microsoft、Google、Amazon、OpenAI、NVIDIAの上位5社のベンダーが企業支出の約60%を占めており、自然言語処理市場において中程度の集中度を示しています。ハイパースケーラーはバンドルクレジットと統合されたMLOpsを通じて流通力を活用しています。一方、MetaのLlama 3やMistralなどのオープンソース競合他社は精度のギャップを縮めています。この変化により、既存プレーヤーはパラメータ数よりもレイテンシ、コンプライアンス、ドメインエコシステムを優先することを余儀なくされています。注目すべき戦略的動向としては、GoogleのGemini Flashによるレイテンシ削減、Microsoftによるシームレスなモデル移行のためのAzure AI Foundryの導入、そして推論スループットを2倍に向上させたNVIDIAのH200 GPUのデビューが挙げられます。
スタートアップは検索拡張生成(RAG)、合成データ、オンデバイス圧縮などの分野で足場を固めています。Cohereはエンタープライズ向けRAGで目覚ましい進歩を遂げており、印象的に低いハルシネーション率を誇っています。Hugging Faceは50万人の開発者を擁するプラットフォームを強力なコミュニティ資産へと変革し、独自カタログにも匹敵する存在となっています。特許出願件数が前年比35%増加したことは、特に少数ショット学習やバイアス軽減などの分野での知的財産争いの激化を示しています。規制が戦略的ツールとして活用されており、高リスクモジュールを事前認証したベンダーはEUでファーストムーバーの恩恵を享受しており、この傾向は同様の規制フレームワークを採用する他の地域にも波及する可能性があります。
さらに、パートナーシップとコラボレーションが競合環境を形成しています。例えば、OpenAIとエンタープライズソフトウェアプロバイダーとのコラボレーションは特定の産業向けにカスタマイズされたソリューションを可能にしており、AmazonはAWSサービスに自然言語処理機能を統合して開発者のアクセシビリティを向上させています。これらの提携は、予測期間中に多様なセクターにわたる自然言語処理技術のイノベーションと採用拡大を促進すると期待されています。
自然言語処理産業リーダー
-
Microsoft Corporation
-
SAS Institute Inc.
-
IBM Corporation
-
Google LLC (Alphabet)
-
NVIDIA Corp.
- 注:主要企業の掲載順は順位を示すものではありません。
市場機会と将来展望
企業の購買層は、単一モデルの試験導入から、NLPをビジネスシステムに接続する統制されたエージェント型展開へと移行している。この変化は、規制対象の用途における文書化・説明可能性要件を満たす統合サービス、モニタリングツールチェーン、監査可能なRAGスタックにとっての新たな余地を生み出している。この動きは、Microsoft Azure AI Foundryのようなプラットフォームレベルの取り組みによっても支えられており、これは書き換え不要のモデル切替を可能にする位置付けであり、また、SAS Viyaなどのスイートにおけるエンドツーエンドのエージェントフレームワークのベンダーによるパッケージ化にも支えられており、そこではガバナンスを念頭に置いたエージェント型アシスタントやアクセラレータが導入されている。
近い将来の機会は、決定論的なレイテンシとデータ常駐要件が純粋なクラウドワークフローだけでは満たしにくい音声・エッジ展開に集中しており、これは自動車分野やアンビエント臨床記録における リアルタイム音声認識需要の高まりと合致している。第二の機会領域は、購入基準としてのモデル効率であり、ベンダーはベンチマーク性能だけでなく、トークン当たりコスト、レイテンシ、ハードウェア対応の最適化で競争している。2026年7月のリリースはこの方向性を示しており、OpenAIは企業タスク向けにコストパフォーマンスとトークン効率に注力した階層型オプションを備えたGPT-5.6ファミリーを発表し、Anthropicはツール利用とコーディング機能を改善した自律型エージェントワークフロー向けのClaude Sonnet 5をリリースし、Thinking Machines Labは非常に長いコンテキストウィンドウを備え、NVIDIA Blackwellシステムに明示的に最適化されたオープンウェイトのInkling MoEモデルをリリースした。これらの更新は、独自モデルとオープンウェイトの両アプローチにわたって購買者の選択肢を広げ、コンプライアンスと予算の制約下でマルチモデルポートフォリオを運用可能にする評価、ルーティング、展開ツールへの需要を高めている。
最近の業界動向
- 2026年7月:OpenAIは、コーディングおよび企業向けワークロードにおけるコストパフォーマンスとトークン効率の改善を目指したGPT-5.6モデルファミリー(Sol、Terra、Lunaの各ティア)をリリースした。この階層型ラインアップは、チームが単一プラットフォームに標準化しつつ、タスクの重要性やレイテンシ・コストの制約に応じて異なるモデルティアを選択する調達パターンを支えている。
- 2026年6月:Microsoftは、43言語に対応する多言語音声テキスト変換モデルMAI-Transcribe-1.5を発表し、Copilot、Teams、GitHub、Dynamics 365 Contact Centerへの統合を含む本番展開を想定した位置付けとした。このリリースは、広く展開されている企業向けアプリケーション内のエンドツーエンドの音声NLPスタックを強化し、カスタマーサポートやナレッジワークのフローにおける音声対応自動化を加速させる。
- 2025年2月:IBMは、企業利用向けに構築された新たなマルチモーダルおよび推論重視モデルにより、Graniteモデルファミリーを拡張した。これにより、NLP負荷の高いワークロード向けに商業的にサポートされる基盤モデルの選択肢が広がり、ハイパースケーラーへの競争圧力が高まり、購買者に統制された展開のための追加の選択肢が提供された。
研究方法のフレームワークとレポートの範囲
市場の定義と対象範囲
本調査において、自然言語処理市場は、システムが実際の使用環境において人間の言語を理解・解釈・生成することを可能にするNLPソフトウェア、サービス、および関連ハードウェアから生み出される収益として定義されます。
調査対象外:汎用コンピューティングおよびストレージへの支出は、NLPワークロードの実行を目的として購入された場合を除き、対象外とします。
セグメンテーション概要
- 展開形態別
- オンプレミス
- クラウド
- 組織規模別
- 大企業
- 中小企業(SME)
- コンポーネント別
- ハードウェア
- ソフトウェア
- サービス
- 処理タイプ別
- テキスト
- 音声またはボイス
- 画像またはビジョン
- エンドユーザー産業別
- BFSI
- ヘルスケアおよびライフサイエンス
- ITおよびテレコム
- 小売および電子商取引
- 製造
- メディアおよびエンターテインメント
- 教育
- その他のエンドユーザー産業
- 地域別
- 北米
- 米国
- カナダ
- メキシコ
- 南米
- ブラジル
- アルゼンチン
- その他の南米
- ヨーロッパ
- ドイツ
- 英国
- フランス
- イタリア
- スペイン
- その他のヨーロッパ
- アジア太平洋
- 中国
- 日本
- 韓国
- インド
- オーストラリア
- ニュージーランド
- その他のアジア太平洋
- 中東・アフリカ
- 中東
- アラブ首長国連邦
- サウジアラビア
- トルコ
- その他の中東
- アフリカ
- 南アフリカ
- ナイジェリア
- ケニア
- その他のアフリカ
- 中東
- 北米
データソース、市場規模算定、および検証
デスクリサーチ
デスクリサーチは、明確な調査境界を設定し、信頼性の高い公開指標によってモデルを裏付けるために活用されました。需要環境をリアルに把握するため、主に米国労働統計局(関連職種の賃・雇用データ)、米国国勢調査局およびUN Comtrade(特定ハードウェアカテゴリーの貿易シグナル)、世界銀行(マクロ経済およびIT支出の文脈)などのソースを参照しました。
これらのシグナルを市場関連インプットに変換するため、arXivやIEEEなどのソースから査読済み論文、NISTや欧州委員会などの規制・標準アップデート、さらに主要サプライヤーおよび採用企業の年次報告書、決算資料、製品ドキュメントも参照しました。一部では、公開情報が限られている企業財務データ、特許調査、輸出入の出荷レベルの確認に限り、有料サブスクリプションを使用しました。これらは例示であり、データ収集、数値検証、前提条件の明確化のために多数の公開ソースが参照されています。
一次インタビューおよびサーベイ
一次調査は、デプロイメント形態、顧客規模、エンドユーザー産業にわたってNLPがどのように購入・収益化されているかを確認することに重点を置きました。APAC、EMEA、アメリカ大陸にわたるソリューションプロバイダー、システムインテグレーター、エンタープライズバイヤーと話し、採用ペース、価格設定、サービスアタッチメントに関する前提条件を、実際の取引や導入事例に即した形で調整しました。
一次調査フィールドワーク回答者の分布
| 企業タイプ | 回答者の役職 | 地域 |
|---|---|---|
| 上位層:39% | CXO:14% | APAC:45% |
| 中位層:44% | 部門・ユニットリーダー:28% | EMEA:29% |
| 中小規模プレイヤー:17% | マネージャー:58% | アメリカ大陸:26% |
市場規模算定と予測
規模算定はトップダウンアプローチから始まり、総アドレス可能なテクノロジー支出を、地域および主要エンドユーザー産業別の採用率とワークロード浸透率を用いてNLP需要プールへと再構築します。この需要プールが形成された後、企業がNLPを長期的にどのように導入・維持するかに関するシグナルを用いて、コンポーネントタイプ(ソフトウェア、サービス、ハードウェア)およびデプロイメントモード別に分割されます。
合計値を現実に即したものとするため、クラウド対オンプレミスのデプロイメント比率、会話型AIおよびテキスト分析のエンタープライズ採用率、統合・モデルチューニグにおける典型的なサービスアタッチメント、使用量ベース価格設定からバンドル型またはプラットフォームベースの購買への平均価格シフトなど、複数の市場フィンガープリントをインプットとして活用しています。また、言語カバレッジ拡大のペース、規制対応コスト(例:監査・文書化作業)、パイロットプログラムから本格的な本番運用への移行(支出強度に影響)も追跡しています。結果は、サプライヤー収益のサンプルロールアップや平均契約金額のチャネルチェックを含む選択的なボトムアップ推計によって裏付けられ、開示情報が限られている箇所には保守的なベンチマークを適用してギャップを処理しています。
予測においては、シナリオ分析を採用しており、企業がNLPを運用化するスピード、モデル効率化に伴う価格変動、コンプライアンスコストの推移に関する一次調査フィードバックによって導かれています。シナリオはIT支出、AI投資サイクル、クラウド採用、産業レベルの導入成熟度などの測定可能なドライバーに紐付けられ、地域別または垂直市場別のパターンがグローバルトンドから乖離する場合に調整されます。
データ検証と更新サイクル
検証は、モデルアウトプットを独立したシグナルと比較し、数値確定前に外れ値を調査する複数のチェックを通じて実施されます。地域間の不一致、価格前提条件の急激な変化、産業別の非現実的な採用急増を確認し、フォローアップコールや追加デスクチェックを通じてそれらの領域を再検討します。
最終承認前に、定義・計算・前提条件の整合性を保つため段階的にレビューが行われ、公開されているサプライヤーの方向性に対する大きな乖離については説明が付されます。レポートは年次で更新され、需要や価格に影響を与える重要なイベントが発生した場合には中間更新が行われます。また、クライアントが最新の情報を受け取れるよう、納品前に最終的な鮮度確認が実施されます。
Mordor Intelligenceの自然言語処理市場規模算定と他の公表推計との比較
公表されているNLP市場の数値がしばしば異なるのは、調査機関によって計上する収益ストリームが異なり、基準年や成長前提も異なるためです。一つの推計隣接するAIカテゴリーをNLPに組み込んでいたり、採用の実態に見合わない形で価格拡大を速く想定している場合、差異はさらに大きくなります。
下表は2025年の出発点となる数値の幅を示しており、Mordor Intelligenceのモデルは合計をソフトウェア、サービス、関連ハードウェアにわたるNLP固有の収益に限定しています。内訳はデプロイメント、組織規模、処理タイプ、エンドユーザー産業別に整理されており、より広範なAIプラットフォーム支出を一括計上するものではありません。差異はまた、使用量ベース価格の上昇速度の想定、スケーリング時のサービスアタッチメントの扱い、通貨換算に年間平均レートを使用するか時点レートを使用するかによっても生じ、USDの合計値に影響を与える可能性があります。
ベンチマーク比較
| 出典 | 市場規模 | 調査方法論上のギャップ |
|---|---|---|
| Mordor Intelligence | 392.37 ビリオン 米ドル(2025年) | |
| 業界専門誌A | 368.00 ビリオン 米ドル(2025年) | 記述の一部でより狭いソリューションの視点を採用しており、ハードウェアおよび導入サービスが完全に計上されているかどうかの明確が限られているため、記載合計値が低くなる可能性があります。 |
| グローバルコンサルタンシーB | 424.70 ビリオン 米ドル(2025年) | より積極的な成長前提と広範なセグメントマップを適用しており、隣接するAI収益ラインを取り込む可能性があり、純粋なNLP支出をより広範な自動化・分析バンドルから分離することについての明示が少ない。 |
調査範囲を一貫して保ち、支出を実際の採用状況と価格インプットに紐付けることで、公表数値間のギャップは説明しやすくなります。当社のアプローチは、2025年の数値を明確な需要ドライバーと再現可能な前提条件に紐付けることを目指しており、これにより年次更新および地域比較の信頼性が高まります。
レポートで回答される主要な質問
自然言語処理ソリューションへのグローバル支出はどのくらいの速さで拡大していますか?
2026年〜2031年にかけて、自然言語処理市場は年平均成長率19.94%で成長し、473億7,000万米ドルから1,175億7,000万米ドルへと拡大します。
最も強い成長勢いを示している地域はどこですか?
アジア太平洋地域は、中国の主権AI義務付け、インドの公共デジタルスタック、日本の医療デジタル化が採用加速を牽引し、年平均成長率22.13%を記録しています。
なぜサービスが将来の予算においてソフトウェアを上回るペースで成長しているのですか?
企業は統合、バイアス監視、コンプライアンス監査を必要としており、サービスを年平均成長率22.62%に押し上げ、2028年までにハードウェア支出を上回る位置に置いています。
ヘルスケアが最も急速に成長するエンドユーザーセグメントである理由は何ですか?
アンビエント臨床インテリジェンス、コーディング自動化、創薬テキストマイニングが書類作成を最大50%削減し、能力を解放することで、年平均成長率24.84%の成長を牽引しています。