
データラベリング市場規模とシェア
市場概要
| 調査期間 | 2020 - 2031 |
|---|---|
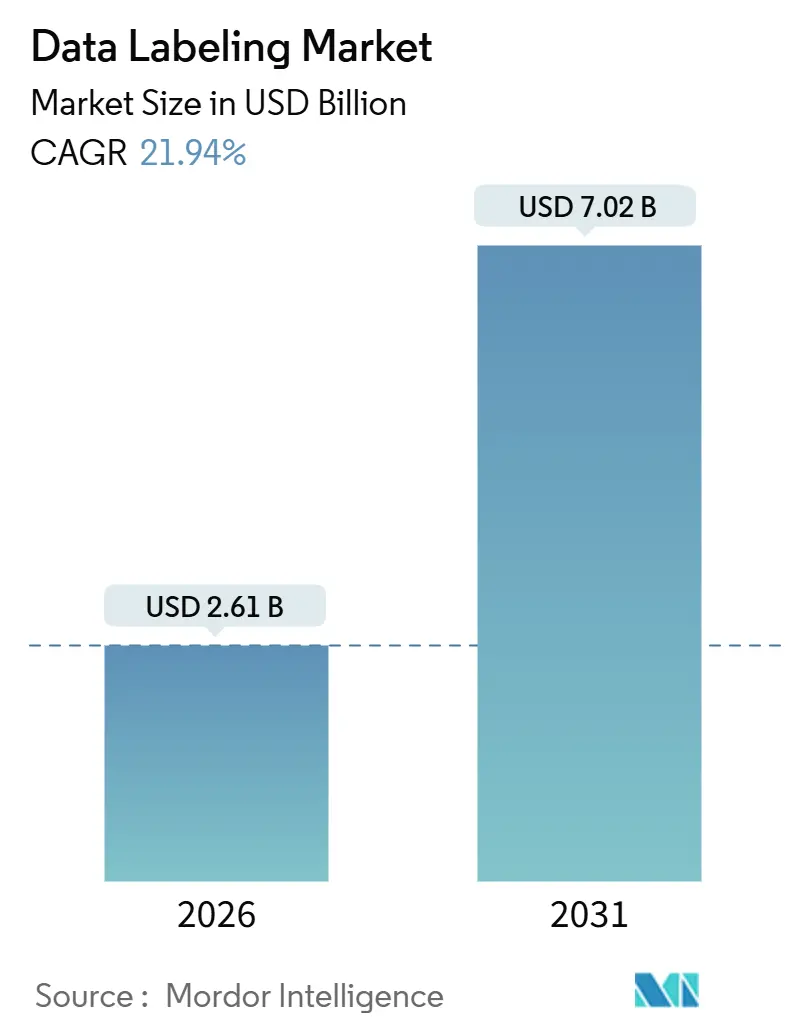
| 市場規模 (2026) | 2.61 十億米ドル |
| 市場規模 (2031) | 7.02 十億米ドル |
| 成長率 (2026 - 2031) | 21.94 % |
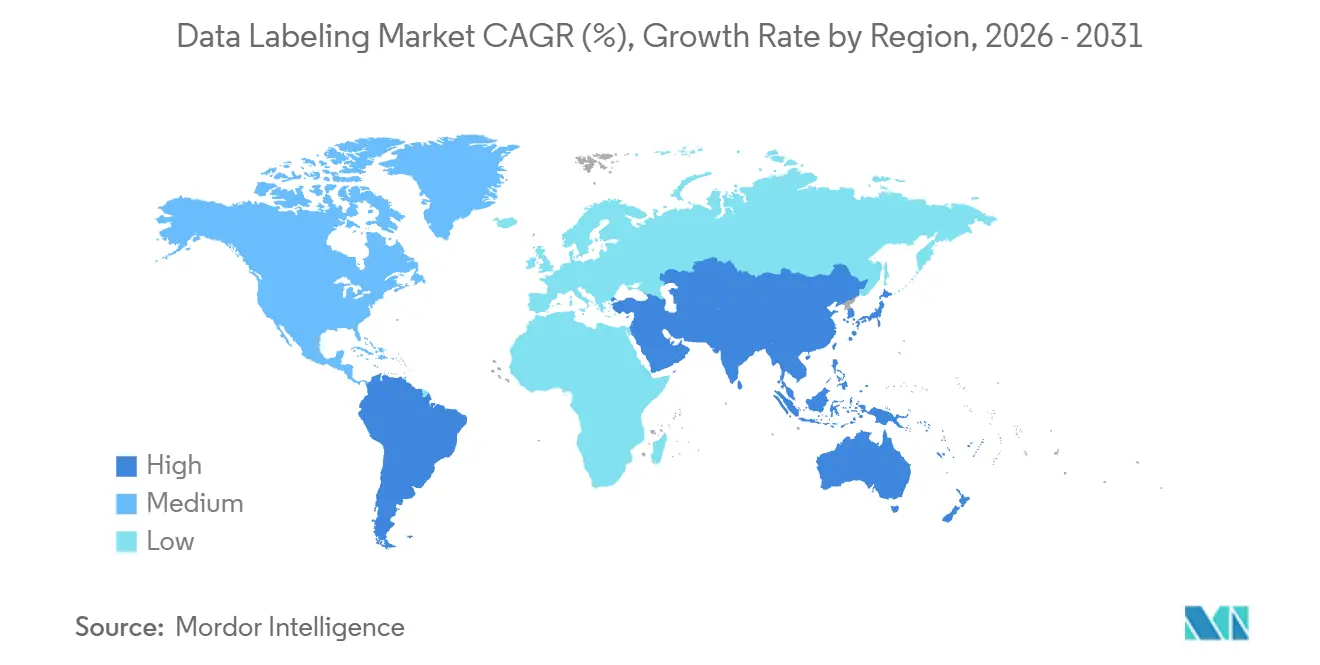
| 最も急速に成長している市場 | アジア太平洋 |
| 最大市場 | 北米 |
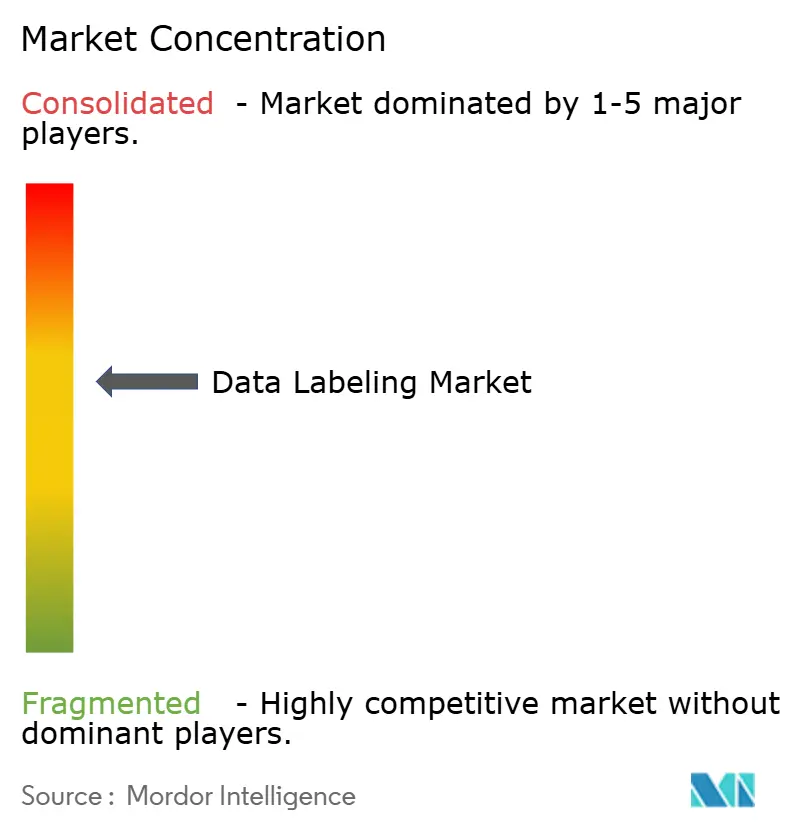
| 市場集中度 | 中 |
主要プレーヤー 注:主要企業の掲載順は順位を示すものではありません。 画像 © Mordor Intelligence。再利用にはCC BY 4.0の表示が必要です。 | |
Mordor Intelligenceによるデータラベリング市場分析
データラベリング市場規模は2026年に26億1,000万米ドルに達しており、2031年までに70億2,000万米ドルに拡大する見込みで、堅調な21.94%のCAGRを反映しています。この成長は、相互に絡み合う3つの触媒によって促進されています。幻覚を抑制する専門家監修コーパスを求めるファウンデーションモデル開発者、フレームレベルの3Dタグを必要とするセンサーフュージョンスタックを検証する自動車メーカー、そしてラベル付きの時系列障害データに依存する予知保全AIを拡張する産業企業です。2025年6月にMetaがScale AIに対して行った150億米ドルの出資は、ラベリングインフラを商品化されたサービスではなく戦略的な競争優位の源泉として位置づけることを明確にし、OpenAIとGoogleがアノテーションベンダーの多様化を進めるきっかけとなりました。自律システム向けの動画アノテーション、社内専門知識とアウトソーシング労働を融合したハイブリッド調達モデル、そしてラベル単価を引き下げる自己教師あり学習ラベリングパイプラインは、いずれもデータラベリング市場全体よりも速いペースで拡大しており、人間の専門家とモデル支援タグ付けを同期させるプラットフォームに成長の余地をもたらしています。北米は引き続き収益の中核を担っていますが、アジア太平洋地域の政策主導による産業AIへの取り組みが地域のダイナミクスを再形成しています。
レポートの主要ポイント
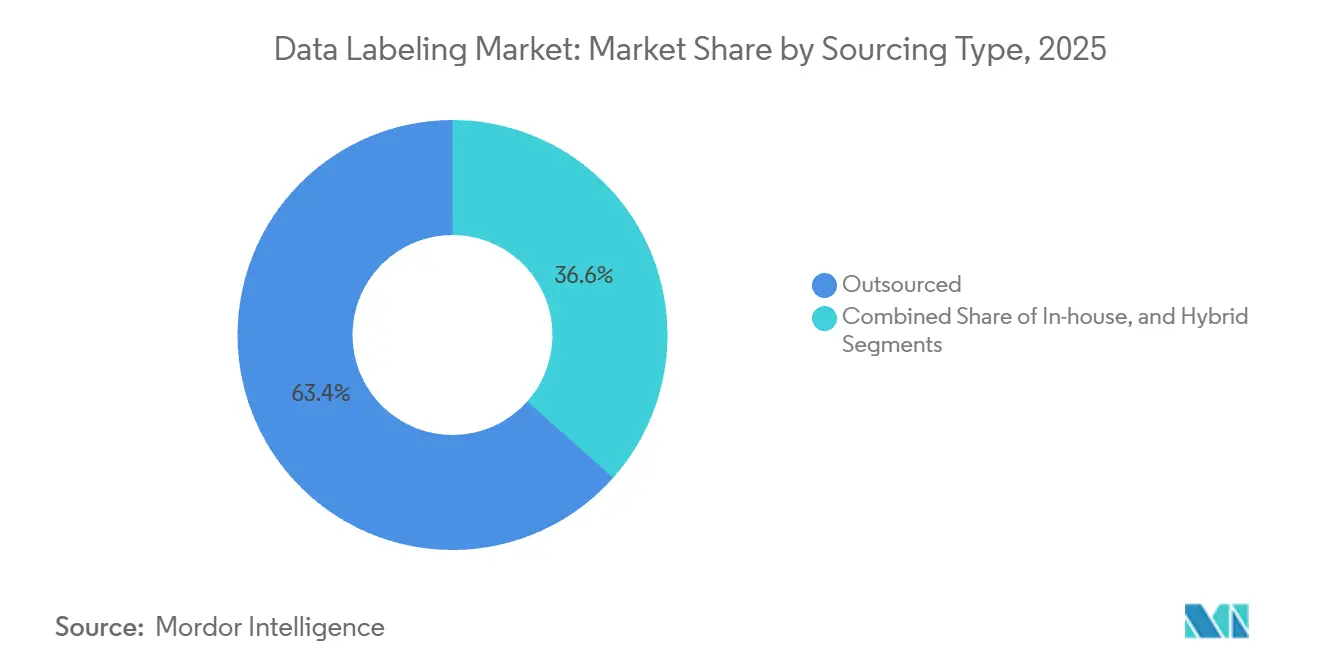
- 調達タイプ別では、アウトソーシングラベリングが2025年のデータラベリング市場シェアの63.43%をリードし、ハイブリッド調達は2031年にかけて22.48%のCAGRで拡大しています。
- データタイプ別では、画像データセットが2025年に36.26%のシェアを獲得し、動画アノテーションは2031年に向けて23.17%のCAGRで推移する見込みです。
- ラベリングアプローチ別では、手動ラベリングが2025年のデータラベリング市場規模の42.31%を占めていますが、自己教師あり学習およびプログラマティック手法は22.16%のCAGRで成長しています。
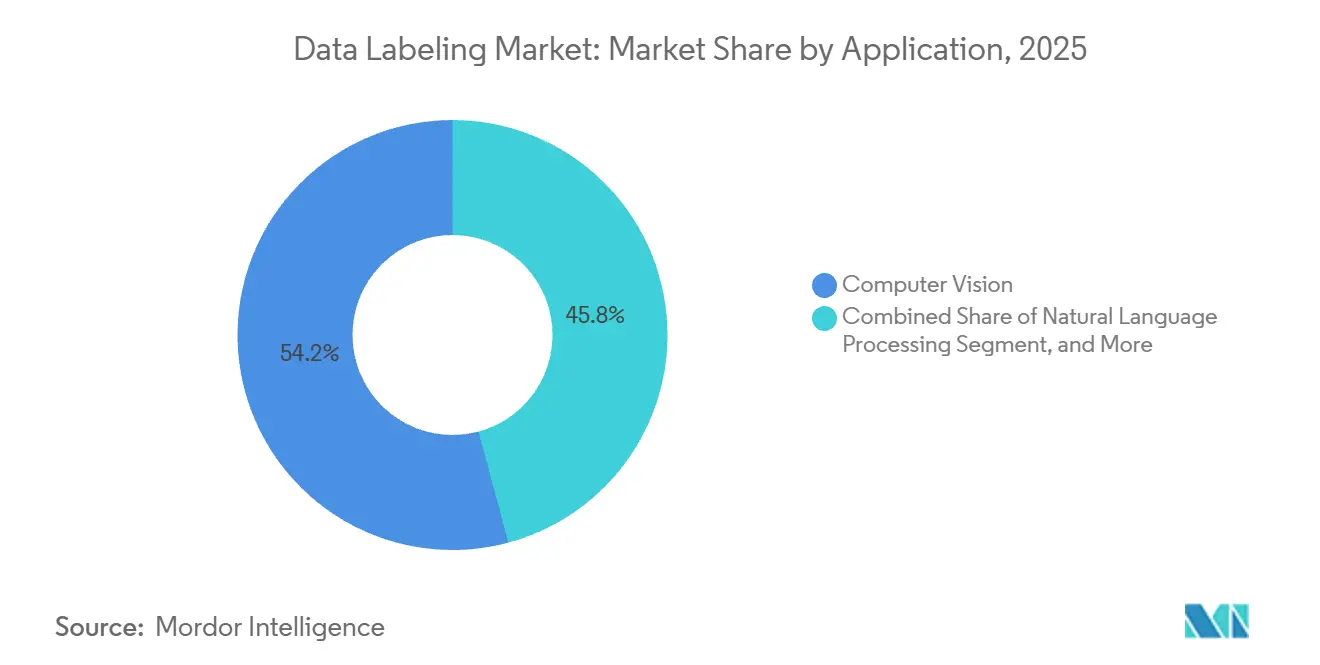
- アプリケーション別では、コンピュータビジョンアプリケーションが2025年に54.19%のシェアを占め、予知保全と品質保証は2031年にかけて最速の22.61%のCAGRを示しています。
- エンドユーザー産業別では、自動車・輸送が2025年に28.26%のシェアを保持し、産業・製造が22.84%のCAGRで最も速く成長しています。
- 地域別では、北米が2025年の収益の31.13%を占めていますが、アジア太平洋地域が21.16%のCAGRで最も速く成長している地域です。
注:本レポートの市場規模および予測数値は、Mordor Intelligence 独自の推定フレームワークを使用して作成されており、2026年1月時点の最新の利用可能なデータとインサイトで更新されています。
市場動向とインサイト
促進要因の影響分析*
| 促進要因 | CAGR予測への影響(概算%) | 地理的関連性 | 影響の時間軸 |
|---|---|---|---|
| ADASおよび自動運転ビジョンデータの急速な普及 | +5.2% | 北米、欧州、中国に集中したグローバル | 中期(2〜4年) |
| 生成AIブームによるマルチモーダルデータセット需要の拡大 | +6.8% | 北米とアジア太平洋地域が主導するグローバル | 短期(2年以内) |
| ビッグデータ機械学習パイプラインの進歩 | +3.1% | グローバル | 中期(2〜4年) |
| 医療画像AIの普及 | +2.9% | 北米、欧州、アジア太平洋 | 中期(2〜4年) |
| 合成データ検証のためのエッジマイクロラベリング | +1.7% | 北米と欧州で早期普及が進むグローバル | 長期(4年以上) |
| 規制主導の説明可能なAI出所メタデータ | +2.3% | 欧州、北米、中国 | 中期(2〜4年) |
| 情報源: Mordor Intelligence | |||
ADASおよび自動運転ビジョンデータの急速な普及
自動車センタースイートは現在、毎日テラバイト規模のマルチモーダルデータをストリーミングしており、データラベリング市場はレベル3およびレベル4の自律走行を実現するために精密なタグに依存しています。Waymoの公開データによると、車両の平均精度はトレーニングデータの10%使用時の29.7%から、全データ使用時の49.4%に向上しており、ラベルのスケールと地理的多様性が知覚精度に直接影響することが証明されています。日本のRoAD to L4イニシアチブと電気自動車充電インフラの整備は、地域固有のタグを必要とする新たなセンサーログを生み出すことになります。自動車メーカーは生データの量から1フレームあたりの品質へとシフトしており、同期されたLiDARカメララベリングツールと自動車グレードの検証ワークフローへの需要が高まっています。
生成AIブームによるマルチモーダルデータセット需要の拡大
基盤モデルの開発者は現在、幻覚を抑制しドメイン固有のチューニングを可能にする、より小規模で専門的にラベリングされたコーパスを好む傾向にある。AIデタラベリング市場では、業界固有のテンプレートにより、社内の機械学習スタッフが限られている中小規模の小売業者、保険会社、製造業者がモデルを構築できるようになり、標準化されたアノテーションパイプラインに対する需要基盤が拡大している。Scale AI は2024年の収益の90%が生成AIプロジェクトから生じたことを公表しており、MetaによるMetaの150 ビリオン 米ドルの出資は、出所管理されたデータセットへの高いプレミアムを裏付けている。中国が2026年1月に策定した、AIを20の産業に統合するための作業計画は、厳選された会話・対話・指示追従コーパスへの需要をさらに高めている。弁護士、医師、言語学者に対する賃金が現在1時間あたり60 米ドルに達しており、供給は専門的ティアとコモディティティアに二極化しつつあり、透明性の高い監査証跡によって両方のスキル層を管理できるプラットフォームが優位に立っている。
ビッグデータ機械学習パイプラインの進歩
企業は継続的インテグレーションワークフロー内でラベル付きデータセットのバージョン管理を行うケースが増えています。日本のAIブリッジングクラウドインフラは、ドメイン専門家のタグと不変の出所記録に依存する60日間の言語モデルプロジェクトに40〜80ノードを割り当てています。インドの2025年ロードマップは標準化された機械データプロトコルと国家デジタルバックボーンを求めており、品質指標をDevOpsダッシュボードに送り込むラベリングAPIへの需要を加速させています。[1]NITI Aayog、「製造業の再構想:先進製造業におけるインドのグローバルリーダーシップへのロードマップ」、niti.gov.in プログラマティックインジェスト、弱教師あり学習フック、ドリフト監視を提供するベンダーが従来のアノテーションショップを凌駕しつつあります。
医療画像AIの普及
世界中の放射線科および病理科は、規制当局がAIデバイスを承認する前に臨床医によって確認されたHIPAA準拠のデータセットを必要としています。米国食品医薬品局(FDA)は2024年以降、それぞれラベル付きグラウンドトゥルーススキャンを必要とする数十の画像アルゴリズムを承認しています。日本の研究機関である理化学研究所(RIKEN)は、透明な監査証跡を必要とする厳選された臨床データを用いてライフサイエンスのファウンデーションモデルをトレーニングしています。そのため、病院はループ内の放射線科医とISO認定品質システムを組み合わせたニッチなベンダーに目を向けています。
抑制要因の影響分析*
| 抑制要因 | CAGR予測への影響(概算%) | 地理的関連性 | 影響の時間軸 |
|---|---|---|---|
| 熟練アノテーターの不足と人件費の上昇 | -3.4% | 北米と欧州で深刻なグローバル | 短期(2年以内) |
| データプライバシーおよびデータ主権規制の強化 | -2.8% | 欧州、中国、北米でも台頭 | 中期(2〜4年) |
| ハイパースケールアノテーションのエネルギー使用に対するサステナビリティ圧力 | -0.9% | 欧州が主導するグローバル | 長期(4年以上) |
| 自己教師あり学習および弱教師あり学習による手動ラベリング支出の侵食 | -4.1% | 北米とアジア太平洋で早期採用が進むグローバル | 中期(2〜4年) |
| 情報源: Mordor Intelligence | |||
熟練アノテーターの不足と人件費の上昇
ドメイン専門家によるタグ付けへの転換は、人材のボトルネックを露呈させています。Scale AIは、クラウドソーシングの賃金水準への批判を受け、博士号レベルのアノテーターに1時間あたり30〜60米ドルを支払うようになり、ベンダー全体のコスト基準を引き上げています。インドのロードマップは、モジュール式の見習い制度とアノテーション認定のためのフロンティアテクノロジーインスティテュートを通じてスキルギャップに取り組んでいます。自動化は事前ラベリングを支援しますが、規制対象のユースケースでは人間による検証が依然として必須であり、賃金インフレが短期的にマージンの重荷となっています。
データプライバシーおよびデータ主権規制の強化
データローカライゼーション規則はデータラベリング市場を地域的なサイロに分断しています。EU AI法は出所メタデータとデータセットドキュメントを要求し、コンプライアンスのオーバーヘッドを増大させています。[2]欧州委員会、「人工知能に関する調和されたルールを定める規則の提案」、europa.eu 中国のガバナンスフレームワークは国境を越えたデータ転送を制限し、外国ベンダーに国内クラウドの設立を迫っています。これらの断片化した規制体制により、アノテーション企業はインフラを重複させ、地域の労働力を確保せざるを得なくなり、グローバルな規模の経済を抑制しています。
*当社の予測では、推進要因および抑制要因の影響を加算的ではなく方向性のあるものとして扱います。影響予測は、ベースライン成長、構成効果、および変数間の相互作用を反映しています。
セグメント分析
調達タイプ別:
ハイブリッドモデルが管理とスケールのバランスを実現ハイブリッド調達は2026年に22.48%のCAGRで大きな勢いを生み出しており、機密データを社内に保持しながら大量業務をベンダーに依存する企業によって牽引されています。アウトソーシングのシェアは2025年のデータラベリング市場シェアの63.43%を依然として占めていますが、知的財産への懸念の高まりとドメイン専門家の不足が予算を混合モデルへとシフトさせています。タスクを複雑さに応じてルーティングし、ロールベースのアクセスを適用し、リアルタイムの品質指標を表示するハイブリッドオーケストレーションツールがこの転換を支えています。アジア太平洋地域では、中国が2028年までに50,000の工場をデジタル化する計画により、企業が地域の工場レベルのチームと集中型プラットフォームを切り替えるにつれて、ハイブリッド調達がデフォルトとなるでしょう。北米全体では、防衛契約が機密データの国内処理を規定する一方で、商業用画像のオフショアタグ付けを許可しており、ハイブリッドワークフローを強化しています。
ハイブリッド戦略を採用する企業は、キューを分割することでターンアラウンドタイムを短縮しています。高感度ラベルはセキュアな内部クラスターに留まり、汎用のバウンディングボックスはオフショアベンダーに流れます。自動化されたポリシーエンジンがデータセットの系譜を追跡し、クリアランスレベルによってアノテーターを割り当て、スループットを制限することなくコンプライアンスを強化しています。ハイブリッドモデルを収益化するベンダーは、厳選された「マイクロデータセット」を複数の購入者に販売可能な繰り返し可能な資産として位置づけ、かつて不透明だったサービス収益をソフトウェアのようなマージンに転換し、データラベリング市場のアドレス可能な規模を拡大しています。
注記: 全セグメントの個別シェアはレポート購入後にご確認いただけます


データタイプ別:
動画アノテーションが自律性を加速動画アノテーションは、自律走行車、ロボティクス、スマートシティ監視によって推進され、2031年にかけて23.17%のCAGRが見込まれています。一方、静止画像は2025年の収益の36.26%を依然として占めており、フレームベースのコンピュータビジョンの定着した役割を示しています。連続ストリームは時間的に一貫したオブジェクトトラッキング、行動認識、シーンセグメンテーションを必要とし、ラベル単価と平均販売価格を引き上げています。LiDARおよび深度センサーのタグ付けに関するデータラベリング市場規模は比較的小さいものの、3Dポイントクラウドのバウンディングには専門的なツールと自動車グレードの精度が求められるため、プレミアム価格が設定されています。
具現化AIとスマートロボットを重視する中国の政策は、工場の組立ライン、倉庫物流、サービスロボットのインタラクションを捉えるマルチモーダルな動画LiDARデータセットへの需要を拡大するでしょう。北米のロボティクス新興企業も同様に、ビジョンベースの操作モデルを再トレーニングするためにアノテーション済みシーケンスをライセンス供与しています。補間支援バウンディングやモデル提案ポリゴンなどのワークフロー革新により手動作業は圧縮されますが、精度を保証するために検証段階は依然として人間中心のままです。
ラベリングアプローチ別:
自己教師あり学習手法が効率的にスケール手動ワークフローは2025年の収益の42.31%を依然として占めていますが、企業がコスト削減を追求する中で、自己教師あり学習およびプログラマティックアプローチが22.16%のCAGRで台頭しています。開発者はファウンデーションモデルを使用してフレームを事前ラベリングし、曖昧なスライスに人間をループさせることで、データセットあたりのエッジケースの総数を大幅に削減しています。小規模なゴールドラベルプールが自動化された疑似ラベルに情報を提供する半教師あり学習の拡張は、会話AIパイプラインを支配しています。弱教師あり学習ライブラリが成熟し、ダッシュボードがエンドツーエンドの出所を報告するにつれて、自動事前ラベリングに関連するデータラベリング市場規模は拡大すると予想されます。
しかし規制当局は監査可能性を義務付けています。日本のAI安全研究所は、説明可能なラベル生成ログを要求するガイダンスの草案を作成しており、ベンダーに高リスクの垂直市場での人間による監視の維持を求めています。その結果、最も強靭なプラットフォームは信頼度スコアリング、能動学習の優先順位付け、および可逆的なラベル履歴を統合し、純粋に手動のショップに対するマージン優位性を確保しながらコンプライアンスを確保しています。
アプリケーション別:
予知保全が継続的な収益を牽引コンピュータビジョンは2025年の支出の54.19%を維持していますが、工場がダウンタイムを防ぐためにセンサーデータを活用するにつれて、予知保全と品質保証は現在22.61%のCAGRを記録しています。振動、温度、音響信号の時系列タグ付けは、設備や運用体制が変化するたびにモデルを再トレーニングする必要があるため、安定したサブスクリプション型の需要を生み出しています。インドの国家ロードマップは、自律的なバッチリリースを引き起こすエージェンティックAIを重点項目として挙げており、ラベル付きセンサー障害タクソノミーと動画ベースの欠陥ライブラリを必要としています。これらの産業データセットに起因するデータラベリング市場規模は、OEMがラベリングコストを複数年のサービス契約に組み込むにつれて増加しています。
小売業者とコールセンターは引き続き自然言語処理と音声分析に投資していますが、産業用IoTパイプラインが成長をリードしています。ドメインオントロジー、エッジキャプチャSDK、クラウドサイドラベリングフックをバンドルするベンダーが工場展開を勝ち取っており、汎用プラットフォームよりも速く生の運用技術データをAI対応コーパスに変換しています。
注記: 全セグメントの個別シェアはレポート購入後にご確認いただけます
エンドユーザー産業別:
産業製造が急成長自動車企業はADASとフリートテレマティクスに牽引され、2025年の収益の28.26%を依然として生み出していますが、産業・製造顧客は2031年にかけて最速の22.84%のCAGRを示しています。中国の20のセクター別データセットと50,000の工場アップグレード計画は、金属、化学、消費者向け電子機器の垂直市場に大規模な需要を注入しています。[3]王晶晶、「中国、産業インターネットとAIの統合深化計画を発表」、国務院、english. 日本の半導体ルネサンスも同様に、ラベル付きフォトマスク画像、インライン検査スキャン、欠陥タクソノミーを必要としています。データラベリング市場は現在、生産デジタルツイン予算に直接組み込まれており、一度限りのパイロットから継続的な運用費用へと転換しています。
ヘルスケアとライフサイエンスは厳格なコンプライアンス要件を維持しており、専門ベンダーを育成しています。金融サービス企業は不正検知タグを優先し、農業ユーザーはドローンベースの作物ストレスラベルを要求しています。各垂直市場固有のオントロジーがプラットフォームのカスタマイズを促進しており、ドメインアドオンで補完された幅広いラベルオペレーションソフトウェアが社内の専用ツールを置き換えている理由を裏付けています。
地域分析
北米および欧州のデータラベリング市場
北米は2025年のデータラベリング市場収益の31.13%を占め、ハイパースケーラーへの投資、防衛契約、および基盤モデルの研究開発がその基盤となっている。2024年5月におけるScale AIの10億米ドルのシリーズFラウンドは投資家の信頼を強化し、2025年のMetaによる出資は出所情報が豊富なデータセットの戦略的重要性を浮き彫りにした。情報・国家安全保障データセットに関する連邦調達は複数年契約をもたらし、テクノロジー支出の景気循環的な変動を緩和している。欧州のAI法はコンプライアンス上のハードルを引き上げる一方で、監査対応可能なラベルファイルを提供しEUデータレジデンシーを維持できるベンダーを差別化する要因ともなっている。
アジア太平洋地域のデータラベリング市場
ジア太平洋地域は最も急速に成長しており、CAGRは21.16%に達している。中国の産業インターネットロードマップ、インドの先進製造業ブループリント、および日本のロボティクス拡大がその成長を後押ししている。これらの政策的支援は、ローカライズされたアノテーション、多言語コーパス、および業種別タクソノミーに対する地域需要を促進している。中国における国内クラウド義務化は国内プラットフォームに優位性をもたらしているが、合弁事業を設立するか現地データセンターを構築する外資系ベンダーも成長セグメントへのアクセスが可能である。東南アジア諸国は低コストの労働力を提供し、グローバルなハイブリッドワークフローを支えている。
中東・アフリカおよびラテンアメリカのデータラベリング市場
中東およびアフリカは依然として黎明期にあり、アラブ首長国連邦およびサウジアラビアがスマートシティおよび自律移動モビリティのパイロットプロジェクトに資金を投じており、規模は小さいながらも戦略的なデータラベリング案件を生み出している。南アフリカおよびケニアは英語圏のアウトソーシング業務を引き付けているが、国内AI需要の限定性が地域全体の成長を抑制している。ラテンアメリカではブラジルが牽引役となっており、eコマースおよびアグリテック企業がタギング業務をアウトソーシングしているが、通貨の変動性が国境を越えた取引を複雑にしている。

競合ランドスケープ
データラベリング市場は中程度に断片化しています。Scale AIはMetaによる150億米ドルの資金注入後に主導的な地位を確立し、厳選された専門家ラベル付きデータセットと2024年末までに14億米ドルに達すると予想される収益で注目を集めています。AppenとTELUS Internationalは、グローバルなクラウドプラットフォームとLionbridge AIなどの買収を通じてシェアを守っています。Labelbox、SuperAnnotate、V7 Labsを含む中立的なプラットフォームベンダーは、開発者エクスペリエンスと統合品質分析で競争しています。NVIDIAとDatabricks Venturesが支援するSuperAnnotateの3,600万米ドルのシリーズBは、企業がソフトウェアのみのモードとマネージドサービスモードを切り替えられるプラットフォーム中心のアプローチへの投資家の関心を示しています。
技術的差別化は現在、ファウンデーションモデルによる事前ラベリング、能動学習の優先順位付け、アノテーター間の一致度をリアルタイムで可視化する品質ダッシュボードに焦点が当たっています。データ主権のサポートを急ぐベンダーは欧州と中国に地域インスタンスを立ち上げており、小規模なブティックはISO 13485またはSOC 2認証を掲げることで規制対象セクターを獲得しています。汎用画像タグ付けでは価格圧力が続いていますが、医療画像、3D LiDAR、法的文書アノテーションなどの高付加価値セグメントはマージンを支えるプレミアム価格を維持しています。
Snorkel AIのようなスタートアップはプログラマティックラベリングを普及させ、ユーザーがヒューリスティックルールをエンコードしたり弱教師あり学習を活用したりできるようにしており、一方でDataloopのようなエッジ重視の参入者は合成データ検証のためのデバイス上マイクロラベリングを提供しています。企業がパイロットプロジェクトから本番規模のパイプラインへと移行するにつれて、勝者はハイブリッドクラウドとオンプレミスクラスター全体にわたって、インジェストからドリフト監視まで、フルスタックのラベルオペレーションを提供できる企業となるでしょう。
データラベリング産業リーダー
Appen Limited
TELUS International AI Inc.
Scale AI, Inc.
Amazon Mechanical Turk, Inc.
CloudFactory Limited
- 注:主要企業の掲載順は順位を示すものではありません。
データラベリング市場
- Appen Limited
- TELUS International AI Inc.
- Scale AI, Inc.
- Amazon Mechanical Turk, Inc.
- CloudFactory Limited
- SuperAnnotate AI, Inc.
- Labelbox, Inc.
- Toloka AI B.V.
- Cogito Tech LLC
- clickworker GmbH
- Alegion, Inc.
- Deep Systems, LLC
- Explosion AI GmbH
- HEEX Technologies SAS
- Dataloop AI Ltd.
- Hive AI, Inc.
- Kili Technology SAS
- V7 Labs Ltd.
- Snorkel AI, Inc.
- Edgecase AI, Inc.
- Surge AI, Inc.
- iMerit, Inc.
- Mercor, Inc.

Recent Industry Developments in データラベリング市場
- 2026年1月:中国の工業情報化部が、2028年までに50,000件の産業インターネットアップグレードと標準化されたドメインデータセットを目標として、20のセクターにわたるAI統合を深化させる作業計画を発表しました。
- 2025年11月:中国が、大規模言語モデルを先進製造設備とAIエージェントと連携させる6点戦略を概説した産業AI ロードマップを公表しました。
- 2025年10月:インドのNITI Aayogが、AI搭載設計コパイロット、予知保全エージェント、認定ラベリングプロセスを優先する10年間の製造業ブループリントを発表しました。
- 2025年6月:MetaがScale AIに約150億米ドルを投資し、同社を290億米ドルと評価するとともに、28歳の最高経営責任者を新たな超知能研究所の責任者として招聘しました。


データラベリング市場 レポートの範囲と調査方法論
市場の定義と主要カバレッジ
本調査では、データラベリング市場を、機械学習モデルが学習・検証・ファインチューニングを行えるよう、テキスト、画像、動画、音声、およびポイントクラウドファイルにタグ付けを行うプラットフォーム、マネージドサービス、およびヒューマン・イン・ザ・ループのブレンドワークフローから得られるすべての収益と定義する。バリュープールには、企業、研究機関、および公的機関が支払う費用が含まれ、2025年の米ドル実質価で表示される。
スコープ除外:合成データジェネレーター、純粋なデータ分類ソフトウェア、および単独のモデルテストツールはこの範囲外とする。
セグメンテーション概要
- 調達タイプ別
- 社内
- アウトソーシング
- ハイブリッド
- データタイプ別
- テキスト
- 画像
- 動画
- 音声
- LiDAR・センサー
- ラベリングアプローチ別
- 手動
- 自動
- 半教師あり学習
- 自己教師あり学習・プログラマティック
- アプリケーション別
- コンピュータビジョン
- 自然言語処理
- 音声・オーディオ分析
- 予知保全・品質保証
- エンドユーザー産業別
- 自動車・輸送
- ヘルスケア・ライフサイエンス
- ITおよび通信
- 銀行・金融サービス・保険(BFSI)
- 小売・電子商取引
- 産業・製造
- 農業
- 政府・公共部門
- 地域別
- 北米
- 米国
- カナダ
- メキシコ
- 南米
- ブラジル
- アルゼンチン
- その他の南米
- 欧州
- 英国
- ドイツ
- フランス
- スペイン
- イタリア
- その他の欧州
- アジア太平洋
- 中国
- インド
- 日本
- オーストラリア
- 韓国
- その他のアジア太平洋
- 中東
- サウジアラビア
- アラブ首長国連邦
- トルコ
- その他の中東
- アフリカ
- 南アフリカ
- ケニア
- その他のアフリカ
- 北米
詳細な調査方法論とデータ検証
一次調査
Mordor のアナリストは、北米、欧州、アジア太平洋地域のプラットフォームプロダクトヘッド、アウトソーシング担当エグゼクティブ、およびAIエンジニアリングリードと対話を行った。これらの議論により、ワークフローの組み合わせ、自動化比率、および1,000ラベルあたりの実勢価格が明確になり、デスクリサーチで残った空白を埋め、地域別の採用曲線を整合させることができた。
デスクリサーチ
需要シグナルは、米国労働統計局、EurostatのICT調査、OECDのAI政策オブザーバトリー、および自動運転、医療画像診断、会話型AIに関するセクター団体などの無償公開情報源を通じてマッピングした。特許クラスターはQuestelを用いてトレースし、企業収益の手がかりはD&B Hoovers、SECの10-K、および決算説明会から収集し、活動タイプ別の初期分類を行った。学術誌、NISTのAIリスクフレームワーへのコメント、およびアノテーション労働契約を詳述した税関台帳がさらなる文脈を加えた。記載された情報源は例示であり、データ収集と検証には多数の追加出版物が活用されている。
市場規模推計と予測
企業のAIトレーニング予算、パブリッククラウドのGPU時間、およびユースケースの普及率から再構築されたトップダウンのプールがベースラインを形成し、サンプリングされたベンダーの請求書と平均販売価格にジョブ量を乗じたターゲットを絞ったボトムアップの積み上げによってクロスチェックされた。モデルを固定する5つの主要変数は、自律走行1マイルあたりのアノテーション済みオブジェクト数、病院ベッドあたりのデジタル化された放射線スキャン数、合成データと実データの拡張比率、ラベラーの時間給、およびプラットフォームの自動化普及率である。多変量回帰によりこれらのドライバーを2030年まで予測し、専門家との対話で検証されたシナリオオーバーレイを適用している。
データ検証と更新サイクル
アウトプットは、承認前に分散スクリーニング、ピアレビー、および異常値チェックを経る。レポートは年次で更新され、新たなAI安全規制などの重要なイベントが発生した場合は中間更新が行われ、クライアントが常に最新の見解を受け取れるよう保証している。
Mordorのデータラベリングベースラインが信頼性を持つ理由
各調査会社の推計値は、それぞれが独自のスコープ、通貨処理、および上方修正要因を選択するため乖離が生じる。
社内および外部委託の支出をプラットフォームライセンスを含めて捕捉し、インプットを12ヶ月ごとに見直すことで、Mordor Intelligence は計画立案のためのより安定した基準を提供している。
ベンチマーク比較
| 市場規模 | 匿名化された情報源 | 主要なギャップの要因 |
|---|---|---|
| 6.5 ビリオン 米ドル | Mordor Intelligence | - |
| 4.89 ビリオン 米ドル | グローバルコンサルタンシーA | 社内プラットフォームおよびハイブリッド自動化収益ストリームを除外している |
| 4.87 ビリオン 米ドル | 地域コンサルタンシーB | ラベルあたりの保守的な価格を適用し、LiDARデータフローを除外している |
この比較は、他社がユニバースを狭めるか静的コスト要因を固定しているのに対し、Mordor の厳格なスコープ、ライブ一次調査、および年次更新サイクルが、意思決定者が信頼できる透明性と再現性の高いベースラインをもたらすことを示している。


レポートで回答される主要な質問
2031年のデータラベリング市場の予測値はいくらですか?
2026年から2031年にかけて21.94%のCAGRを反映し、70億2,000万米ドルに達すると予測されています。
データアノテーション需要が最も速く成長している地域はどこですか?
アジア太平洋地域が中国、インド、日本に牽引された21.16%のCAGRで最も高い勢いを示しています。
他よりも速く拡大しているデータタイプはどれですか?
動画アノテーションが自律走行車とロボティクスにより23.17%のCAGRで成長をリードしています。
ハイブリッド調達モデルが支持を集めている理由は何ですか?
企業は機密データに社内専門家を活用しながら、スケールのために外部ベンダーを組み合わせ、22.48%のCAGRで成長しながらコストと管理のバランスを実現しています。
継続的な繰り返しラベリング収益を生み出すと期待されているアプリケーション領域はどれですか?
産業環境における予知保全は、設備の進化に伴い継続的なセンサーの再タグ付けを必要とし、22.61%のCAGRで成長しています。
プライバシー規制はグローバルなラベリング戦略にどのような影響を与えていますか?
EU AI法や中国のデータガバナンス規則などの義務により、ベンダーは地域インフラを構築し、ローカライゼーション法に準拠するために個別のアノテーターのプールを維持することを余儀なくされています。
最終更新日:


