
ウェブスクレイピング市場規模とシェア
Mordor Intelligenceによるウェブスクレイピング市場分析
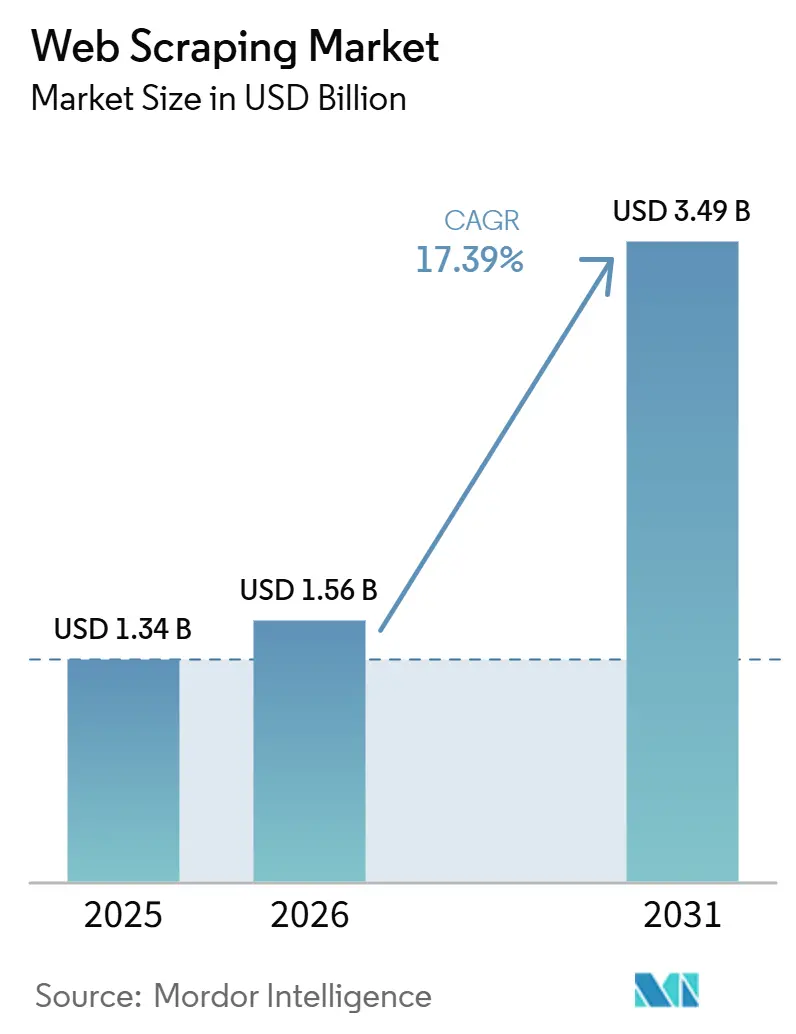
ウェブスクレイピング市場規模は2026年に1.56 ビリオン 米ドルと評価され、2027年の1.83 ビリオン 米ドルから2032年には4.03 ビリオン 米ドルに達すると推定され、予測期間(2027年〜2032年)においてCAGR 17.08%で成長する見込みです。
米国におけるオンライン小売の成長および投資会社によるウェブ由来データの活用が、収集への継続的な需要を支えています。AI支援による抽出は、スキーマ制約付きレコードを生成し、分析前にチームが確認できる定義済みの出力フィールドを提供します。プラットフォームへのアクセス制限も、各収集経路で取得される内容を検証する価値を高めています。サプライヤーは、再利用可能なソフトウェアの販売と完成データセットの提供のどちらかを選択し、収集の異なる部分に責任を負います。保護サイトのコストや法的制限は、これらのサービスが収集・提供できる範囲を制約しています。
レポートの主要ポイント
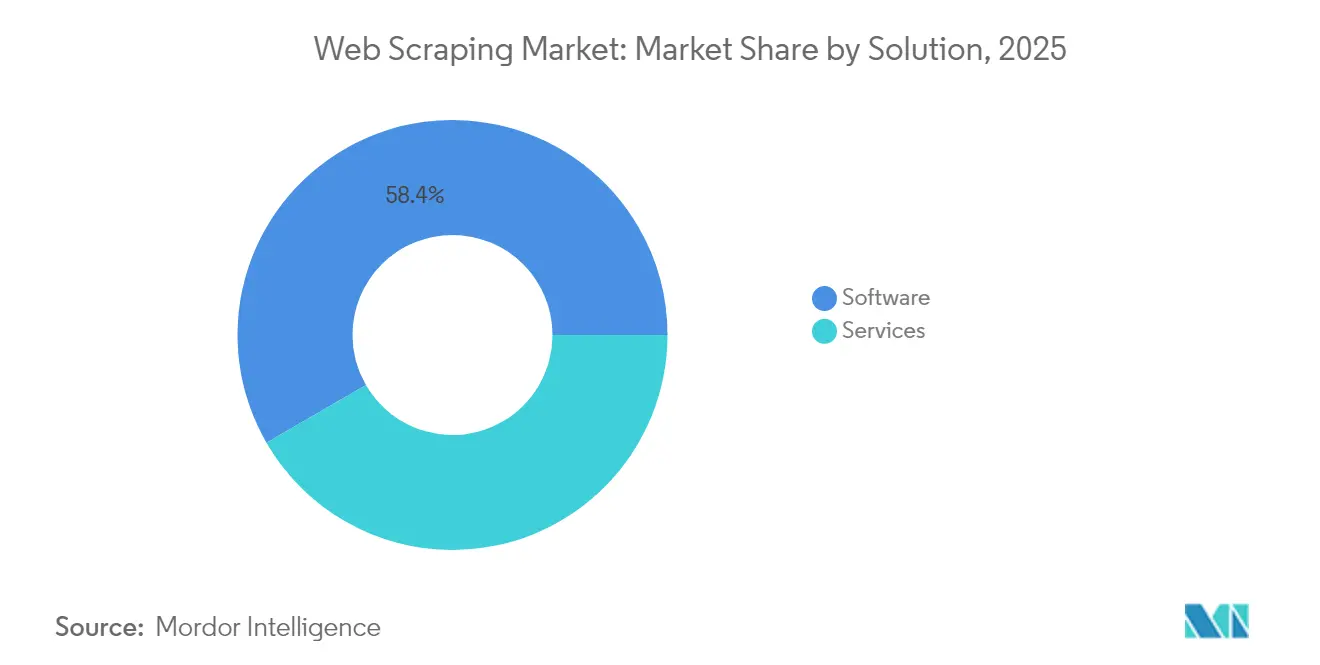
- ソリューション別では、ソフトウェアが2026年のウェブスクレイピング市場シェアの57.93%を占め、サービスは2027年〜2032年においてCAGR 18.35%で最も速く成長すると予測されています。
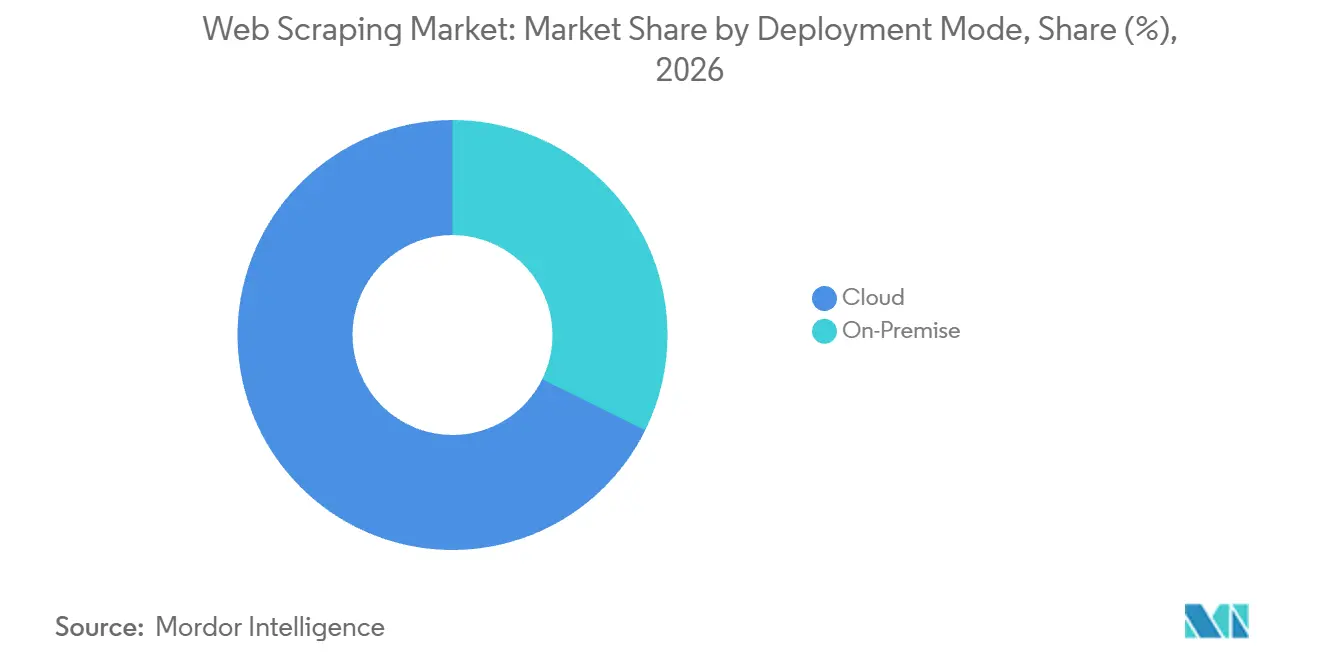
- クラウド展開は2026年のウェブスクレイピング市場規模の67.7%を占め、2027年〜2032年においてCAGR 17.52%で最も速く成長すると予測されています。
- エンドユーザー産業別では、BFSIが2026年の収益の29.39%でトップを占め、広告・メディアセグメントが2027年〜2032年においてCAGR 18.5%で最も速く成長すると予測されています。
- ユースケース別では、データスクレイピング/ETLが2026年の収益の35.89%でトップを占め、価格・競合モニタリングが2027年〜2032年においてCAGR 18.05%で最も速く成長すると予測されています。
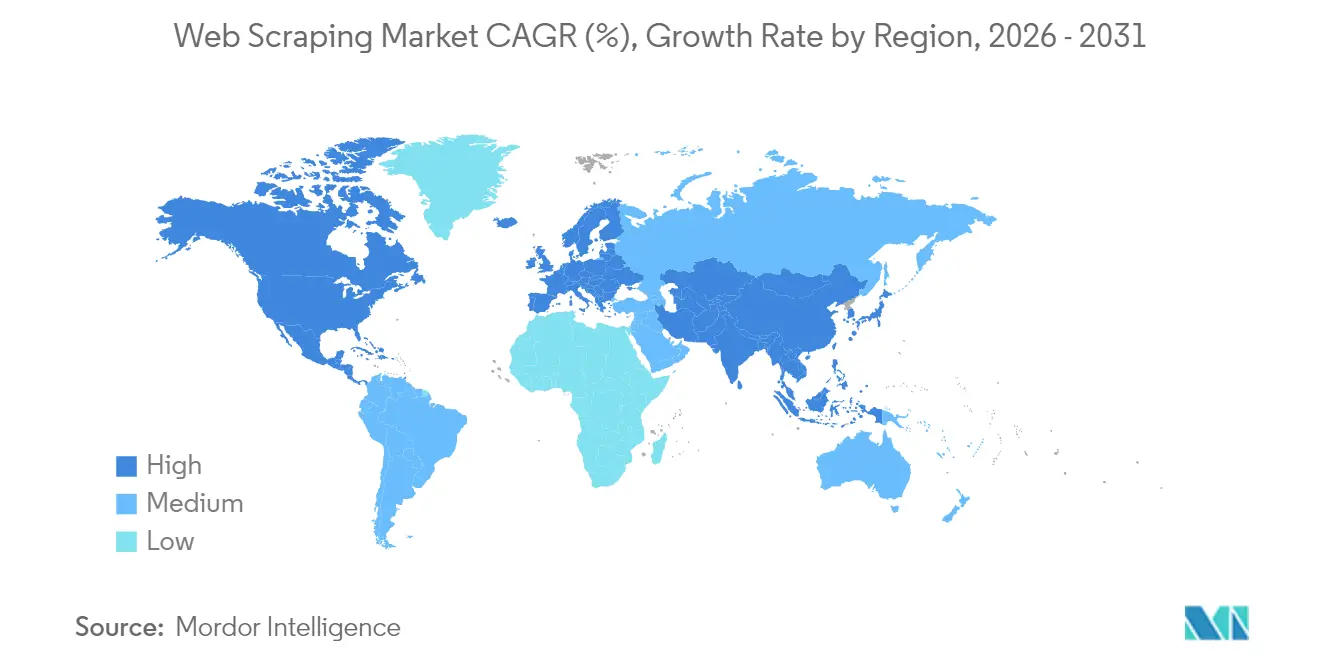
- 地域別では、北米が2026年の収益の33.94%を占め、アジア太平洋が2027年〜2032年においてCAGR 18.35%で最も速く成長すると予測されています。
注:本レポートの市場数値は、基準年2026年における9か月間の実績データと第4四半期の予測を組み合わせたMordor Intelligence独自の推定フレームワークに基づいています。
市場動向とインサイト
推進要因の影響分析*
| 推進要因 | CAGRへの影響(〜%)予測 | 地理的関連性 | 影響タイムライン |
|---|---|---|---|
| 電子商取引およびオンラインマーケットプレイスの成長 | +5.1% | 北米およびアジア太平洋 | 短期(2年以内) |
| データ抽出におけるAI/MLの進歩 | +4.6% | 北米、欧州およびアジア太平洋 | 短期(2年以内) |
| 金融における代替データへの需要増大 | +4.1% | 北米および欧州 | 中期(2〜4年) |
| 主要プラットフォームにおけるAPI廃止がスクレイピングを促進 | +3.6% | 米国および欧州 | 短期(2年以内) |
| 生成AI学習データ要件 | +3.2% | 北米およびアジア太平洋 | 長期(4年以上) |
| オープンデータ義務により明らかになるデータギャップ | +1.8% | ドイツ、フランスおよびスペイン | 中期(2〜4年) |
| 情報源: Mordor Intelligence | |||
電子商取引およびオンラインマーケットプレイスの成長
オンライン販売の流量増大により、デジタル店頭全体の価格および在庫状況を観察することの商業的価値が高まっています。季節調整済みの米国小売電子商取引売上高は2026年第2四半期に340.2 ビリオン 米ドルに達し、価格変動を調整しない場合、2025年第2四半期から12.2%(±0.9%)増加しました。同期間の米国小売売上高全体は6.7%(±0.5%)増加したため、オンライン価格の観察は売上比重が高まっているチャネルに関わります。定期的な商品セットを追う小売業者にとって、収集作業は価格変動と品揃えの変化を分離することです。収集実行をまたいで一致した商品を比較することで、異なる商品構成による見かけ上の価格変動ではなく、競合他社の値付け変更に基づいた次の価格提案を行うことができます。
データ抽出におけるAI/MLの進歩
AI支援によるスパイダー開発は、収集チームが維持できる対象サイトの範囲を広げることができます。2025年第2四半期〜第3四半期にかけて、ScrapeGraphAIはオープンソースのウェブ抽出ライブラリの本番利用からオプトイン方式で約900万件のテレメトリーイベントを収集しました。研究者たちはこれらの生データをスキーマ別に重複排除・バランス調整し、93,695件の抽出イベントからなる公開データセットを作成しました。2026年3月、ZyteはWeb Scraping Copilot 1.0を一般公開しました。これはAIを使用してScrapyスパイダーの生成、テスト、デプロイを行うVisual Studio Codeの拡張機能です。これらの作業を開発者のエディター内に取り込むことで、対象サイトごとのエンジニアリング工数を削減し、チームのScrapyベースのプログラムが経済的に実現可能な範囲を拡大することができます。
金融における代替データへの需要増大
2025年9〜10月に実施された米国、英国および欧州の56社のバイサイド企業を対象とした調査において、Crisil Coalition Greenwichは投資家の63%が代替データへの支出を増やす予定であると報告しました。2026年3月の開示において、AQRはそのアドバイザーが消費者行動、ソーシャルメディアのセンチメント、インターネット検索・トラフィックデータを含む代替データを特定のファンドの運用に使用していると述べました。この開示では、プロバイダーの情報技術インフラが脆弱であることが多く、データセットが停止、遅延、または利用不能になる可能性があることについても警告しています。支出意向は代替データサプライヤーにとって潜在的な機会を広げる一方、AQRによる中断リスクの警告はサプライチェーンの継続性の重要性を浮き彫りにしています。投資チームにとって、プロバイダーの中断は次の更新時にモデルの入力値を失うことを意味します。供給の継続性は、それ以外の条件が同等であデータプロバイダーを差別化する要素となり得ます。
主要プラットフォームにおけるAPI廃止がスクレイピングを促進
2024年10月〜2025年2月に実施されたインタビューにおいて、ソーシャルメディア研究者はウェブスクレイピングをプラットフォームAPIの代替手段として挙げ、法的、倫理的、信頼性に関する懸念を提起しました。Redditは2026年8月5日、新規の公開APIリクエストを段階的に制限すると発表しました。[1] Redditはまた、2027年1月12日より未登録またはエンゲージメントのないアプリおよびユーザーに対するData APIアクセスの廃止を開始し、2027年3月に残りの公開APIアクセスを終了する計画です。2026年のTikTok研究では、APIおよびフロントエンドのスクレイピングツールが異なる期間および人気レベルのコンテンツを取得することが判明しました。アクセス制限に直面する購入者にとってこれらの違いは代替収集経路が意図した分析に適合する場合にのみ商業的に有用となります。Redditが2027年3月に残りの公開APIアクセスを終了する計画は、現在APIプルに依存しているチームに対し、代替経路のカバレッジ確認が必要な確定期日を与えています。
抑制要因の影響分析*
| 抑制要因 | CAGRへの影響(〜%)予測 | 地理的関連性 | 影響タイムライン |
|---|---|---|---|
| 法的・倫理的不確実性 | -2.2% | 米国および中国 | 中期(2〜4年) |
| 高コストおよび技術的複雑性 | -1.6% | 米国および英国 | 短期(2年以内) |
| 高度なボット対策ツールによる失敗率の増加 | -1% | 米国および英国 | 短期(2年以内) |
| 公式APIによる一部スクレイピングユースケースの代替 | -0.5% | 北米および欧州 | 中期(2〜4年) |
| 情報源: Mordor Intelligence | |||
法的・倫理的不確実性
データセットは、その取得方法が削除義務を生じさせる場合、商業的有用性を失う可能性があります。2025年7月、LinkedInはその解決策としてProxycurlが不正な手段で取得したLinkedInデータを永久に削除し、LinkedInへの不正アクセスを停止することを要求したと述べました。LinkedInはこの件が偽アカウントやその他の不正行為を使用した不正スクレイピングを含むものと説明しました。購入者にとって、同様の制限は影響を受けたレコードに依存するワークフローを混乱させる可能性があります。同解決策はProxycurlによるLinkedInへのさらなる不正アクセスを禁止したため、削除されたレコードを生み出した経路を使用して再構築することはできませんでした。
高コストおよび技術的複雑性
保護されたウェブサイトは、スクレイピングプログラムの経済的範囲を制限するコストの閾値を生み出します。2025年12月の調査では、回答者の88.7%がボット対策措置で保護されたウェブサイトを対象とする場合にコストが増加したと報告しました。[2] スクレイピング実務者にとって、収集コストの増大はプログラムに保護された対象を追加するために必要なリソースを増やします。この負担は保護された各対象をログラムに追加する費用を引き上げ、チームが引き受ける対象の数を制限する可能性があります。より広いカバレッジまたはより高頻度の収集は、報告されたコスト圧力を吸収しなければなりません。
*当社の予測では、推進要因および抑制要因の影響を加算的ではなく方向性のあるものとして扱います。影響予測は、ベースライン成長、構成効果、および変数間の相互作用を反映しています。
セグメント分析
ソリューション別:
再利用可能なソフトウェアがリードし、データサービスが拡大ソフトウェアは2026年のウェブスクレイピング市場規模の57.93%のシェアを占めました。Apifyは、そのウェブスクレイピングおよびブラウザ自動化プラットフォームの世界的な顧客基盤として91,000社を報告しています。ソフトウェアプラットフォームを利用することで、購入者は設定した抽出ロジックを保持し、継続的な収集実行に適用することができます。繰り返しの収集は、既存の実装を活用することで再利用可能なコードとワークフロー設定から経済的価値を引き出します。プラットフォームは、顧客固有のルーティンを維持しながら、共有実行インフラを通じてスケールできます。
サービスは最も成長の速いセグメントであり、2027年〜2032年においてCAGR 18.35%が見込まれています。2025年12月1日、カナダ統計局はMobius365 Knowledge Services, Inc.にカナダのウェブサイトからウェブスクレイピングされたデータの契約を付与しました。[3] この契約は2026年4月1日から2027年3月31日までの統計・研究目的を対象とし、1年間の延長オプションが4回設定されています。同機関はデータの取得を指定しており、ソフトウェアやSaaSライセンスではなく、提供される情報に焦点を当てた契約となっています。潜在的な更新価値は、継続的なデータ供給義務のもとで要求されたデータセットのパフォーマンスに依存します。
注記: 各セグメントのシェアはレポート購入後に入手可能
展開モード別:
クラウドスケールとオペレーターコントロールの融合クラウドは2026年のウェブスクレイピング市場シェアの67.7%を占め、2027年〜2032年においてCAGR 17.52%で最も速く成長するセグメントです。Apifyはクラウド上でウェブスクレイピング、データ抽出、自動化プラットフォームをActorsと呼ばれるサーバーレスプログラムとして運営しています。同社は月間1ペタバイト以上のデータをそのプラットフォームで処理していると報告しています。サプライヤーが運営する実行環境は、収集需要が実行ごとに変動する購入者に適しています。なぜなら、容量は要求されるレコードの定義とは別に検討できるからです。クラウドはプラットフォームサプライヤーに容量の義務を集中させるため、購入者は各環境を個別にプロビジョニングすることなく大量の収集を実行できます。
オンプレミス展開は収集環境を運営者の直接管理下に置き、設定とメンテナンスを同じ組織の境界内に収めます。収集されたレコードと抽出ログを自社ネットワーク内に保持する必要がある組織にとって、ローカル実はそのクローラーを内部要件に合わせます。組織は収集プログラムの一部として、クローラーの運用、プロキシの設定、パース修正のための人員を配置しなければなりません。必要なデータフィールドが同じであっても、ページレイアウトの変更がそのチームの時間を消費する可能性があります。ローカル実行を維持する理由はその内部データ処理要件にあり、パーサーのメンテナンスはその要件を満たすための継続的なコストとして扱われます。
注記: 各セグメントのシェアはレポート購入後に入手可能
エンドユーザー産業別:
投資ワークフローおよび広告インテリジェンスが需要を形成BFSIは最大のセグメントであり、2026年の市場収益の29.39%を占めました。Lowenstein Sandlerの2025年調査は、プライベートエクイティ会社、ヘッジファンドマネージャー、ベンチャーキャピタ会社の回答者を対象としました。調査では、投資調査、ポートフォリオ最適化、またはトレーディング向けのカスタムAIシステムで使用されるデータソースの中にウェブスクレイピングが挙げられていました。そのような購入者にとって、抽出は潜在的なモデル入力を提供し、投資調査、ポートフォリオ最適化、トレーディングはそれらの入力をどのように使用すべきかについて異なる判断を伴います。抽出サプライヤーが1つの投資タスクに合わせた提供変数を調整することで、それらのレコードを使用するモデル内での統合作業の明確な根拠が得られます。
広告・メディアセグメントは最も成長の速いセグメントであり、2027年〜2032年においてCAGR 18.5%が見込まれています。Adbeatは日次で130万ページをクロールし、380万件の広告を検出、分析、処理しています。その規模での日次処理は、広告インテリジェンスが繰り返しのページ取得および広告処理ワークロードを生み出すことを示しています。競合キャンペーンを比較する広告主にとって、連続した日に同じパブリッシャーセットを収集することで、新掲載と以前の観察を区別できます。商業的機会はそのキャンペーン履歴を維持することにあるため、カバーするページ数と並んで収集頻度も重要です。
ユースケース別:
繰り返し可能なパイプラインが競合の可視性を支援データスクレイピング/ETLは最大のセグメントであり、2026年の市場収益の35.89%を占めました。このユースケースはウェブページを構造化されたレコードに変換し、抽出、変換、ロードのステップを経由できるようにします。その経済的役割は水的であり、同じ収集インフラが単一の判断を規定することなく複数のダウンストリーム分析にデータを供給できます。複数のウェブソースを組み合わせる購入者にとって、重要な設計上の選択は他のシステムに渡す前にどこでレコードを標準化するかです。そのハンドオフの時点で、抽出プロバイダーはダウンストリームの分析ソフトウェアとは独立して信頼性の高い入力を販売できます。
価格・競合モニタリングは最も成長の速いセグメントであり、2027年〜2032年においてCAGR 18.05%が見込まれています。2026年10月7日、RateGain Travel Technologiesはベトナム航空がその航空運賃インテリジェンスプラットフォームであるAirGainを選択したと発表しました。発表されたカバレッジには300以上の航空会社、170以上のオンライン旅行代理店、50以上のメタサーチプラットフォームが含まれていました。この広範な範囲は、直接サプライヤーと仲介業者の両方を含む観察フレームが競合モニタリングに必要な理由を示しています。チャネルの選択がデータセットが表すものを定義するためです。関連するカバレッジの決は、どの航空会社と仲介業者のチャネルを一緒にモニタリングするかです。なぜなら、航空会社のみのフィードは狭い価格設定の問題しか解決しないからです。
地域分析
北米ウェブスクレイピング市場
北米は2026年のウェブスクレイピング市場規模の33.94%のシェアを占めました。カナダ統計局の2025年10月のCPIプログラムの詳細は、非伝統的な価格ソースとして自動ウェブスクレイピング、小売業者のトランザクションファイル、手動オンライン収集を挙げています。混合ソースプログラムは既存の測定システム内にウェブ抽出を組み込み、価格比較は収集チャネルに一部依存します。統計オペレーターにとって、自動化された価格系列はトランザクションファイルや手動収集の観察値と同じ月次生産サイクルに適合しなければなりません。
アジア太平洋ウェブスクレイピング市場
アジア太平洋は最も成長の速い地域であり、2027年〜2032年においてCAGR 18.35%が見込まれています。インドネシアの国家統計庁は、その流通・サービス統計部門を通じて、2025年にマーケットプレイスサイトからいくつかの商品の価格を収集するためにウェブスクレイピングを使用しました。2026年6月時点で、オーストラリア統計局は統計目的のために特定のウェブサイトから価格、製品、その他の情報を抽出するためにウェブスクレイピングを使用しています。オーストラリアのCPIについて、オーストラリア統計局はウェブスクレイピングされたデータが手動収集と比較して収集価格を500倍増加させると述べています。手動訪問から自動ルーティンへの価格収集の移行は、プログラムが更新できる観察数を拡大し、これらの統計的用途内での抽出ワークロードを増加させます。
南米では、チリの調達機関ChileCompraの2026年1月の入札が、政府枠組み契約における製品のウェブスクレイピングを含む大規模な価格取得と定期的なモニタリングを求めました。欧州では、アイスランド統計局が2025年の消費者物価の調和指数のために、月次収集週の金曜日に企業のウェブサイトからガソリンおよびディーゼルの価格を約490件スクレイピングしました。中東・アフリカでは、2026年8月のIMFレポートが、ケニア国家統計局がナイロビ以外でのデータ品質およびモデルの堅牢性に関する課題にもかかわらず、初の住宅価格指数に向けたウェブスクレイピング収集の安定化において著しい進展を遂げたと説明しました。中東では、UAEオープンファイナンス規制の第15条が、適用法令の下で許可される場合を除き、同規制の対象となる活動に対するスクレイピングを制限しています。ローカルの製品範囲とデータ品質の条件がこれらの価格プログラムを定義する一方、対象となるUAEの金融活動は追加の法的境界に直面しています。
規制の枠組みと展望
この比較は、パーソナルデータを含むウェブデータを収集する商業サプライヤーの観点から選定された管轄区域を対象としています。政策の魅力度は、そのサプライヤーに対する比較されたアクセスおよびパーナルデータ規則の明確さと運用上の負担を反映しています。義務はサプライヤーの実際の活動に依存します。なぜなら、各フレームワークはアクセス方法、自動収集、個人情報の取り扱いに対して異なる条件を設定しているからです。
規制テーブル
| 判断要素 | 米国 | ブラジル | ドイツ | 中国 |
|---|---|---|---|---|
| 主要機関 | 認可された捜査機関の中で米国シークレットサービス | 国家データ保護局(ANPD) | 管轄する州(ラント)データ保護当局 | 調整を担う中国サイバースペース管理局、その他管轄当局 |
| 主要な法令または方向性 | コンピュータ不正行為法、18 U.S.C. § 1030 | LGPD、第3条および第7条;内部起草中のアグリゲーターガイダンス | GDPR第14条;連邦データ保護法第40条;デジタルオムニバス提案 | ネットワークデータセキュリティ管理規則、第18条、2025年1月1日施行 |
| 商業的影響 | 対象情報を取得する許可なしまたは許可を超えた意図的なアクセスは刑事上のリスクを招く可能性がある | 地域的にカバーされる個人データ処理には第7条の法的根拠が必要 | 間接的に個人データを取得したデータ管理者は、第14条の例外に従い、データ主体に所定の情報を提供しなければならない | 自動アクセスを使用する対象のネットワークデータ処理者はサービスへの影響を評価しなければならない;不法侵入および妨害は禁止される |
| 現在の政策魅力度 | 中 | 中 | 中 | 低 |
| 政策魅力度の今後の方向性 | 変化なし | 強化 | 緩和 | 変化なし |
| 情報源: Mordor Intelligence | ||||
米国の行動ベースのアクセステストにおいて、収集経路の認可条件は継続的な商業上の考慮事項です。ブラジルでは、地域的にカバーされる個人データ処理には第7条の法的根拠が必要であり、ANPDのアグリゲーターガイダンスは2026年10月20日時点でパブリックコンサルテーションなしに内部起草中でした。ドイツのデータ管理者が間接的に個人データを取得した場合、例外を除いて第14条の情報提供義務を負い、2025年11月のデジタルオムニバス簡素化提案は2026年10月時点で共同立法プロセスにありました。中国の自動アクセス評価義務は、ネットワークサービスへの影響を対象処理者の運用上の責任とすることで、2025年1月1日施行の規則にづく継続性を支援します。
バリューチェーンの各段階
バリューチェーンは、使用可能なデータセットを提供するために必要なクローラーのセットアップ、構造化抽出、品質管理を比較します。中心的な商業上の区別は、抽出ツールの提供と結果として得られるレコードへの責任の引き受けの間にあります。複数の段階にまたがるサプライヤーは、実装収益を継続的な提供作業と結びつけることができますが、これらの段階をまたぐ障害に対しても責任を負います。ツールプロバイダーはソフトウェア収益を得る一方、チェック済みのデータセットを提供するサプライヤーはサービス収益を得るとともに品質管理段階への責任を負います。
バリューチェーン分析テーブル
| 主要活動 | 主要参加者 | 価値の獲得 | ボトルネック | レジリエンス対応 |
|---|---|---|---|---|
| クローラーのセットアップ | PromptCloud Technologies Pvt Ltdなどのマネージドクローラーオペレーター | マネージド抽出サービス収益 | 対象フィールドと収集範囲の定義 | スケール前にサンプルレコードと収集境界について合意する |
| ページ抽出と構造化 | Bright Data Ltd.、Zyte Group Ltd.、Apify Technologies s.r.o.などの抽出ソフトウェアプロバイダー | ソフトウェアおよび抽出API収益 | ページのバリエーションをまたいで一貫したフィールドを維持すること | 代表的なページタイプに対して抽出をテストし、必要なフィールドを検証する |
| 品質管理とデータセット提供 | PromptCloud Technologies Pvt Ltdなどの品質管理・提供プロバイダー;Zyte Group Ltd.などのマネージド提供プロバイダー | マネージドデータ提供サービス収益 | 提供前に誤ったレコードを検出すること | レコードの検証と対象を絞った例外レビューを組み合わせる |
| 情報源: Mordor Intelligence | ||||
PromptCloudの機械学習と人的品質チェックの組み合わせは、ページコンテンツの収集を超えた提供責任を示しています。この責任は、マネージドプロバイダーが提供データセットの信頼性から価値を獲得する根拠を提供します。さらなる自動化は商業的なテストを経済的に例外を特定することへと移行させます。なぜなら、使用不能なレコードが未検出のまま通過すると、より大きな収集物の価値が制限されるからです。
競合ランドスケープ
競争は統合プラットフォームと特化型プロバイダーにわたって断片化されており、Bright Data Ltd.がスクレイピングツール、データセット、マネージドサービスを提供しています。Zyte Group Ltd.はAPIおよびデベロッパーツールを提供し、Apify Technologies s.r.o.はクラウドプラットフォームおよびプロフェッショナルサービスを提供しています。Octopus Data, Inc.はOctoparseを提供し、NeuralogicsグループのImport.io Ltd.はセルフサービス抽出とマネージドウェブデータ提供を組み合わせています。Bright Data は2025年に大規模言語モデル(LLM)ラボのトップ20のうち14社にサービスを提供したと報告しています。LLMラボの購入者へのアクセスは、重複するソフトウェアおよびサービス形式での競争とともに、この多様なサプライヤーベースの中で独自の商業的足場を作り出します。
Import.ioは2025年10月にNeuralogicsグループに参加し、独自の名称、プラットフォーム、顧客、チームを維持しています。同社は既存の抽出エンジンの上にAIネイティブ製品への投資を行っており、確立された抽出提供とんで製品開発を推進しています。Zyteは2025年にそのWeb Scraping Copilotを開発者のワークフローに直接組み込まれたコードファーストAIアシスタントとして説明しており、このアプローチはエンジニアが自身のパイプラインをコントロールし続けることを可能にします。一方、Import.ioは既存顧客がすでに使用している抽出エンジンにAIネイティブ製品を追加しており、両サプライヤーは既存のルーティンを置き換えるのではなく、拡張しています。
競合の方向性は、AIエージェントが自身のワークフロー内でリクエストできる抽出へと向かっています。2026年9月30日、ZyteはZyte APIとScrapy Cloudを互換性のあるAIおよびコーディングエージェントが利用できるホスト型モデルコンテキストプロトコル(MCP)サーバーを導入しました。OctoparseのAgentTools APIは、エージェントがテンプレートの検出、パラメータの検証、クラウド抽出、データエクスポートを行うことをガイドしており、実行にはサポートされているクラウド実行可能テンプレートが必要です。ブラジルのLGPDの地域的テストが適用される場合、個人データ処理に第7条の法的根拠が必要であり、ドイツのデータ管理者が間接的に個人データを取得した場合、例外を除いてGDPR第14条の所定の情報を提供しなければなりません。スペシャリストは、購入者が使用するエージェントインターフェースを通じて狭い抽出タスクを実行可能にすることで競争できます。
ウェブスクレイピング産業のリーダー
-
Bright Data Ltd.
-
Zyte Group Ltd.
-
Apify Technologies s.r.o.
-
Octopus Data, Inc.
-
Import.io Ltd.
- 注:主要企業の掲載順は順位を示すものではありません。
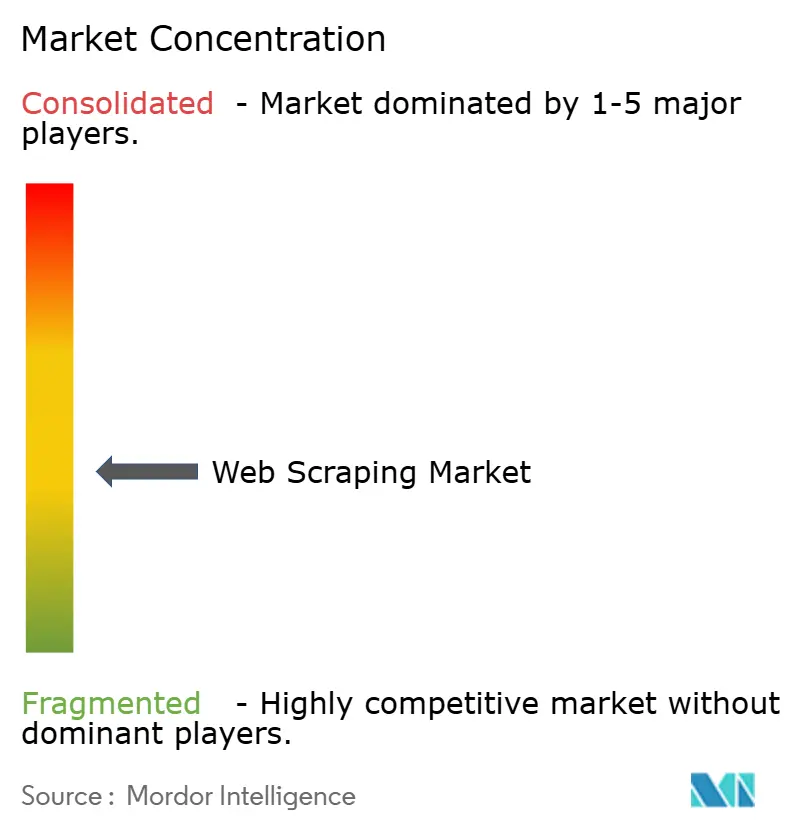
ウェブスクレイピング市場 このレポートでカバーされる企業
- Bright Data Ltd.
- Zyte Group Ltd.
- Apify Technologies s.r.o.
- Octopus Data, Inc.
- Import.io Ltd.
- The Phantom Company SAS (PhantomBuster)
- Diffbot Technologies Corp.
- Mozenda, Inc.
- Sequentum Inc.
- ScrapeHero LLC
- ParseHub Inc.
- UAB Oxylabs
- DataWeave Pvt Ltd
- PromptCloud Technologies Pvt Ltd
- DATAANT Sp. z o.o. (ScrapingAnt)
- DataHen Inc.
- Actowiz Solutions LLC
- SysNucleus Software Pvt Ltd (product: WebHarvy)
- PilotFish Technology LLC
- Datopian Ltd.
- Newprosoft LLC
- UAB Data troops (Decodo)
- Datafiniti LLC
- Crawlbase LLC
- Bright Data Labs Ltd.
市場参加者にとっての主要な機会
機会の比較は、制限されたアクセス下でカバレッジとコントロールを向上させる学習データ収集に焦点を当てています。Inriaは2025年12月に新しいオンライン公開学習データがますます希少になっていると述べ、OECD.AIは2025年までに世界で50件以上の著作権およびデータ保護訴訟を報告しました。OECD.AIはまた、ウェブサイトがスクレイピングを防ぐために技術的・契約的障壁をますます使用していると報告しました。希少性とアクセス制限が組み合わさることで、コーパス拡大する前に使用可能なカバレッジとレコードのソース条件を定義する収集サービスが有利になります。
市場機会テーブル
| 機会 | 今なぜか | 購入者/リードセグメント | 推奨するプレー | 主な障壁 | 有力な受益者 |
|---|---|---|---|---|---|
| 垂直特化型学習コーパス | 新しい公開学習データの希少性 | AIおよびLLM学習チーム | 狭い垂直分野を定義し、そのソースカバレッジをキュレートする | 選定した垂直分野へのデータセットの適合性を確立すること | Bright Data Ltd.などの特化型データサプライヤー |
| 増分コーパス収集 | 新しい公開学習素材の必要性 | 既存コーパスを拡張しているモデルチーム | ソースの日付を文書化した増分バッチを提供する | 真に新しい使用可能な素材を取得すること | Bright Data Ltd.などのカスタムデータパイプラインプロバイダー |
| ソースレコード付き学習フィード | 法的紛争と収集制限 | コーパスの起源を評価するモデル開発者 | 各バッチにソース、収集時刻、使用条件を付加する | 技術的・契約的アクセス障壁 | Bright Data Ltd.などのウェブデータサプイヤー |
| 情報源: Mordor Intelligence | |||||
Bright Dataの垂直特化型ソーシングおよびカスタムパイプラインの役割は、学習データ作業の商業的出発点を提供します。その役割を増分フィードやソースレコード付きフィードへと拡張するには、明示的な提供要件と各ソースを収集するための確認済みの根拠が必要になります。最も強力な切り口は、狭く定義された収集を、コーパスが変化してもスコープと起源が明確な繰り返し可能な供給取り決めに変えることです。
最近の産業開発事情 ウェブスクレイピング市場
- 2026年10月:UAB OxylabsがWeb APIを導入し、ウェブ検索とスクレイピングをAI駆動のパーシングと組み合わせて構造化されたウェブデータを提供。
- 2026年10月:RateGain Travel Technologies Limitedがベトナム航空が航空料金インテリジェンスプラットフォームのAirGainを選択し、レートショッピングと競合価格設定の強化を発表。
- 2026年9月:Zyte Group Ltd.がZyte MCPを導入し、コーディングエージェントにリアルタイムウェブアクセス、構造化抽出、Scrapy Cloud操作を提供。
ウェブスクレイピング市場 レポートの範囲と調査方法論
市場の定義とカバレッジ
グローバルウェブスクレイピング市場は、産業全体およびユースケースにわたって有償組織向けに公開ウェブページコンテンツをプログラム的に抽出する商業ソフトウェアおよびマネージドサービスからの年間収益を測定します。世界中のクラウドおよびオンプレミス製品からのソフトウェアライセンス、サブスクリプション販売、およびサビス料金を対象としています。
スコープの除外:企業内のみで運用される社内DIYスクリプト、スタンドアロンのプロキシまたはIP回転サービス、公開ウェブページコンテンツをプログラム的に抽出しない一般的なウェブ分析またはSEOツールは除外されています。
セグメンテーションの概要
- ソリューション別
- ソフトウェア
- サービス
- 展開モード別
- クラウド
- オンプレミス
- エンドユーザー産業別
- BFSI
- 小売おび電子商取引
- 不動産
- 製造業
- 政府
- ヘルスケア
- 広告・メディア
- その他
- ユースケース別
- データスクレイピング/ETL
- 価格・競合モニタリング
- リード生成と営業インテリジェンス
- 代替金融データ
- センチメントおよびソーシャル分析
- 地域別
- 北米
- 米国
- カナダ
- メキシコ
- 南米
- ブラジル
- アルゼンチン
- その他の南米
- 欧州
- ドイツ
- 英国
- フランス
- イタリア
- スペイン
- ロシア
- その他の欧州
- アジア太平洋
- 中国
- 日本
- インド
- 韓国
- オーストラリアおよびニュージーランド
- その他のアジア太平洋
- 中東・アフリカ
- 中東
- サウジアラビア
- UAE
- トルコ
- その他の中東
- アフリカ
- 南アフリカ
- ナイジェリア
- ケニア
- その他のアフリカ
- 中東
- 北米
データソース、市場規模、検証
デスクリサーチ
デスクリサーチは、オンライン小売のコンテキストのための米国国勢調査局の四半期小売電子商取引売上高、変化する公開アクセス条件のためのRedditのデベロッパープラットフォーム通知、技術的パフォーマンスの質問のためのスキーマ制約付きウェブ抽出に関するarXiv研究、および実務者が報告する運用条件のためのApifyのウェブスクレイピング現状レポートなどのソースを活用しています。これらのソースは、隣接する指標を市場収益として扱うことなく、需要のユースケース、アクセス条件、データ品質のニーズ、抽出コストを枠組み化するのに役立ちます。
企業の申告書と投資家向け資料は、ベンダーの収益モデルと製品境界を特定するのに役立ち、公的な契約落札と信できるテクノロジー・ビジネス報道は、取引がソフトウェア、提供データ、またはその両方をカバーするかを明確にするのに役立ちます。市場合計は記載された収益根拠、地域、期間、対象範囲と照合されます。これらの指定ソースは例示であり、網羅的なものではなく、さらなるソースが収集、検証、および明確化に関与しています。
一次インタビューおよびサーベイ
調査設計は、APAC、EMEA、米州のファイナンス、小売、メディア、製造業、公共セクターのユースケースにわたるウェブスクレイピングソフトウェアベンダー、マネージド抽出プロバイダー、および組織購入者との構造化インタビューまたはサーベイを使用します。製品、商業、提供、調達、データ運用の責任を持つ回答者は、収益の境界、クラウド対オンプレミスの購入、顧客の使用状況、抽出ワークロードの変化を明確にすることができます。アナリストの質問はセカンダリソースの解釈をテストし、ベンダー収益、サービスバンドル、地理的配分、採用状況のギャップを調査し、前提が保持される前にサプライヤー、購入者、公開証拠にわたって情報を三角検証します。
一次調査フィールドワーク回答者の分布
| 企業タイプ | 回答者の役職 | 地域 |
|---|---|---|
| 上位層:35% | CXO:20% | APAC:38% |
| 中間層:45% | 機能/部門リーダー:35% | EMEA:32% |
| 小規模プレーヤー:20% | マネージャー:45% | 米州:30% |
市場規模と予測
このモデルは商業的なウェブスクレイピングソフトウェアおよびマネージド抽出サービスのグローバルな年間ベンダー収益を推計し、その合計をソリューション、展開、エンドユーザー産業、ユースケース、顧客の地域に配分します。トップダウン推計は収益開示と市場レベルの推計から始まり、ライセンス、サブスクリプション、抽出サービスの定義された販売に調整されます。選択的なボトムアップ確認はサプライヤーの収益合計と、推計された顧客数を掛けた抽出サービスのサンプル契約またはサービス価格を比較し、ギャップは完全な調査として扱うのではなく記録して調整します。主要指標には、ベンダーの収益と製品構成、顧客と契約の開示、クラウド対オンプレミスの採用、オンライ小売とマーケットプレイスの活動、および金融やメディアの代替データへの需要が含まれます。各指標は全体的な収益範囲、セグメントシェア、または予測ドライバーに情報を与えます。一貫した履歴が存在する場合、多変量回帰は年次収益系列をこれらの指標に関連付けることができ、シナリオ分析はアクセス制限、法的変更、または新しい自動抽出機能などの不連続性を処理します。欠損観測値には文書化された補間または境界付き前提を使用します。セグメントシェアは報告された分割、顧客使用証拠、製品説明、および産業と用途にわたる購入者配分から構築され、残差はサポートされたカテゴリが評価された後にのみ割り当てられます。一次専門家は変数レベルの成長経路とソリューション構成の変化の妥当性を確認できます。また、サプライヤー確認とトップダウン合計の間で未解決の差異があれば、ソースと境界の確認を通じて再検討されます。
データ検証と更新サイクル
アナリストはサプライヤーの開示、バイヤーサイドの証拠、公的契約、独立した市場シグナルを三角検証し、合、シェア、成長率、過去の修正について異常や重大な差異を確認します。多段階レビューにより、ソースの日付と定義を確認し、外れ値が実際の変化を反映しているのか、それとも一貫性のない境界を反映しているのかをテストし、サインオフ前に問題を解決します。重大な回答が公開された証拠と矛盾する場合、または収益の所有権、バンドル、地理が不明確な場合に再コンタクトが行われます。データセットは年次で更新され、重大な市場イベントに対してはサイクル間で更新され、納品前にソース、計算、および叙述の一貫性の新鮮なレビューが行われます。
Mordor Intelligenceのウェブスクレイピング市場規模と他の公表推計値との比較
公表された推計値は、カウントする取引と製品、および需要モデル化に使用するインプットにおいて異なる場合があります。グローバルウェブスクレイピング市場は、産業全体およびユースケースにわたって有償組織向けに公開ウェブページコンテンツをプログラム的に抽出する商業ソフトウェアおよびマネージドサービスからの年間収益を測定します。
要なギャップの要因には、研究の定義されたカバレッジと市場固有のモデリングの選択が含まれます。主要指標には、ベンダーの収益と製品構成、顧客と契約の開示、クラウド対オンプレミスの採用、オンライン小売とマーケットプレイスの活動、および金融やメディアの代替データへの需要が含まれます。
ベンチマーク比較
| ソース | 市場規模 | 調査方法のギャップ |
|---|---|---|
| Mordor Intelligence | 1.83 ビリオン 米ドル(2027年) | |
| グローバルコンサルタンシーA | 0.99 ビリオン 米ドル(2025年) | 2025年のベースでは、この推計は2年後の本レポートの2027年値である1.83 ビリオン 米ドルを45.9%下回っています。ベース年が早いため、その後の市場成長の前に推計が置かれています。 |
| グローバルコンサルタンシーB | 909.9 ミリオン 米ドル(2024年) | 2024年のベースでは、この推計は3年後の本レポートの2027年値である1.83 ビリオン 米ドルを50.3%下回っています。ソフトウェアのみのカバレッジはマネージド抽出サービスを除外しており、そのベース年はその後の市場成長の前にあります。 |
Mordor Intelligenceのアナリストはサプライヤーの開示、バイヤーサイドの証拠、公的契約、独立した市場シグナルを三角検証し、合計、シェア、成長率、過去の修正について異常や重大な差異を確認します。
レポートで回答される主要な質問
ウェブスクレイピング市場の規模と予測成長率は?
規模は2027年に1.83 ビリオン 米ドルと推定され、2027年〜2032年においてCAGR 17.08%で2032年には4.03 ビリオン 米ドルに達すると予測されています。
ウェブスクレイピングのソフトウェアおよびサービスへの需要を促進するものは何か?
米国のオンライン小売の拡大とAI支援によるスパイダー開発が需要を支えています。米国、英国および欧州の56社のバイサイド企業を対象した2025年の調査では、63%が代替データへの支出を増やす予定と回答しました。
商業的なウェブスクレイピングからの収益をリードするソリューションはどれか?
ソフトウェアが2026年の収益の57.93%を占め、サービスは2027年〜2032年においてCAGR 18.35%で成長すると予測されています。
ウェブスクレイピングのソフトウェアおよびサービスの主要プロバイダーはどこか?
主要プロバイダーには、Bright Data Ltd.、Zyte Group Ltd.、Apify Technologies s.r.o.、Octopus Data, Inc.、およびNeuralogics内で事業を行うImport.io Ltd.が含まれます。
商業的なウェブスクレイピングの展望を形成する課題は何か?
2025年12月の調査では、回答者の88.7%がボット対策で保護されたウェブサイトを対象とした際にコストが上昇したと報告しました。スクレイピング実務者にとって、そのコスト圧力は保護サイトのカバレッジと更新頻度を制約する可能性があります。
商業的なウェブスクレイピング産業でどの地域がリードし、どこで成長が最も速いか?
北米が2026年の収益の33.94%を占め、アジア太平洋が2027年〜2032年においてCAGR 18.35%で最も速く成長すると予測されています。