
Markt für Datenintegration Größe und Anteil
Marktübersicht
| Studienzeitraum | 2020 - 2031 |
|---|---|
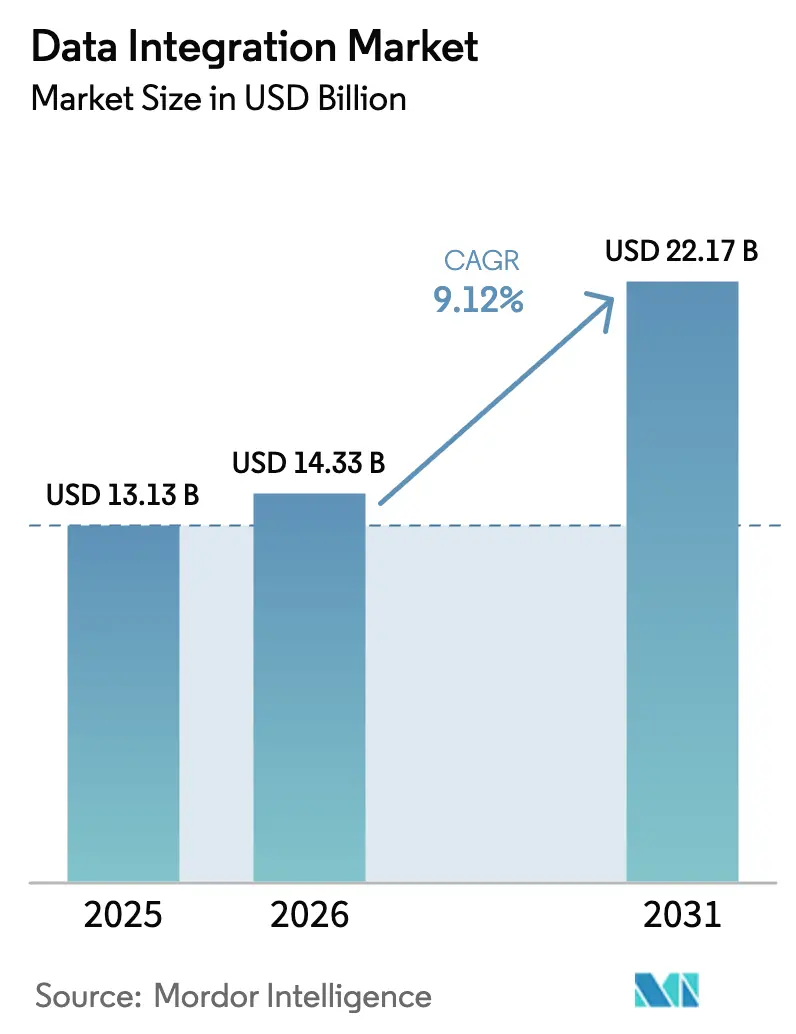
| Marktgröße (2026) | 14.33 Milliarden US-Dollar |
| Marktgröße (2031) | 22.17 Milliarden US-Dollar |
| Growth Rate (2026 - 2031) | 9.12 % |
| Schnellstwachsender Markt | Asien-Pazifik |
| Größter Markt | Nordamerika |
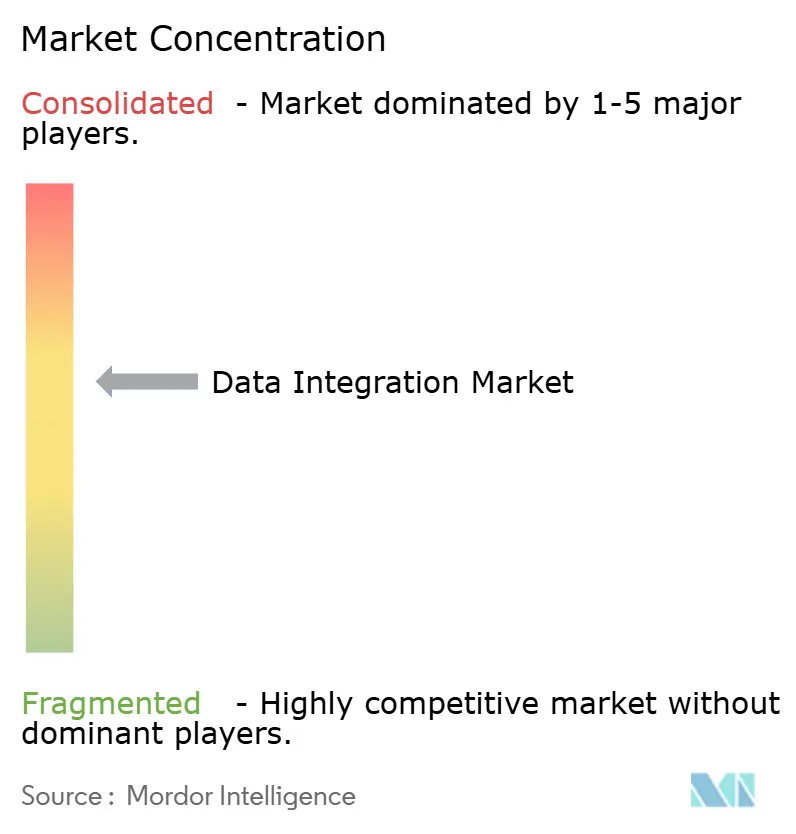
| Marktkonzentration | Mittel |
Hauptakteure *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert Bild © Mordor Intelligence. Wiederverwendung erfordert Namensnennung gemäß CC BY 4.0. | |
Analyse des Marktes für Datenintegration von Mordor Intelligence
Die Größe des Marktes für Datenintegration wird voraussichtlich von 13,13 Milliarden USD im Jahr 2025 auf 14,33 Milliarden USD im Jahr 2026 wachsen und soll bis 2031 bei einer CAGR von 9,12 % über den Zeitraum 2026–2031 einen Wert von 22,17 Milliarden USD erreichen. Der Schwung kam von Unternehmen, die batch-orientierte Workflows durch Echtzeit-Pipelines ersetzten, um künstliche Intelligenz zu operationalisieren, Transparenzvorschriften zu erfüllen und weitläufige Datenbestände zu vereinheitlichen. Cloud-first-Modernisierung blieb das dominante Bereitstellungsmuster, doch hybride Architekturen gewannen an Bedeutung, da Unternehmen Souveränitätsregeln mit elastischer Skalierung in Einklang brachten. Generative-KI-Initiativen steigerten die Nachfrage nach verwalteten semantischen Schichten, die die Halluzinationsraten von Modellen reduzierten, während eine stetige Welle von Fusionen Erfassung, Transformation, Aktivierung und Governance in einzelne Plattformen bündelte. Gleichzeitig dämpften Fachkräftemangel und steigende Egress-Gebühren die Adoptionsgeschwindigkeit und zwangen viele Organisationen, Integrationsoperationen auszulagern.
Wichtigste Erkenntnisse des Berichts
- Nach Bereitstellung führten Cloud-Modelle mit einem Umsatzanteil von 58,74 % im Jahr 2025; Hybrid-Cloud-Bereitstellungen werden voraussichtlich bis 2031 mit einer CAGR von 16,62 % wachsen.
- Nach Unternehmensgröße hielten Großunternehmen im Jahr 2025 einen Anteil von 55,62 % am Markt für Datenintegration, während Kleinunternehmen bis 2031 voraussichtlich mit einer CAGR von 15,36 % wachsen werden.
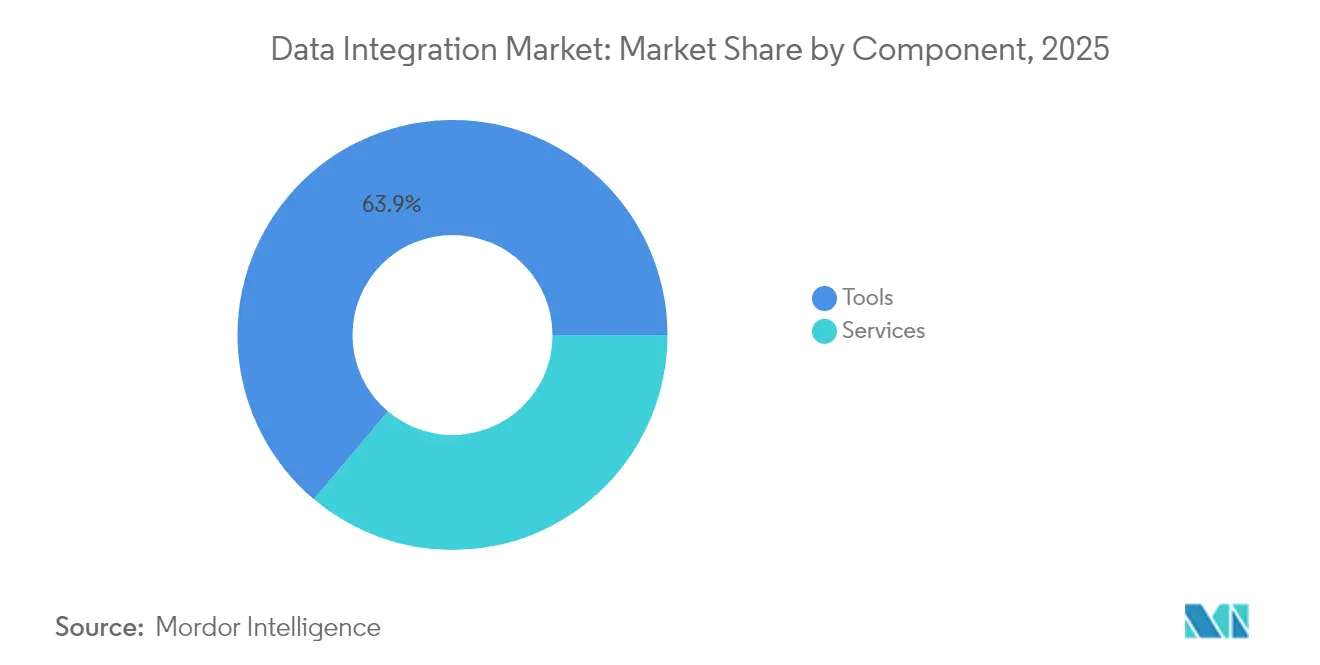
- Nach Komponente erfassten Tools im Jahr 2025 63,85 % der Marktgröße für Datenintegration; Services sind auf dem Weg, zwischen 2026–2031 mit einer CAGR von 14,08 % zu wachsen.
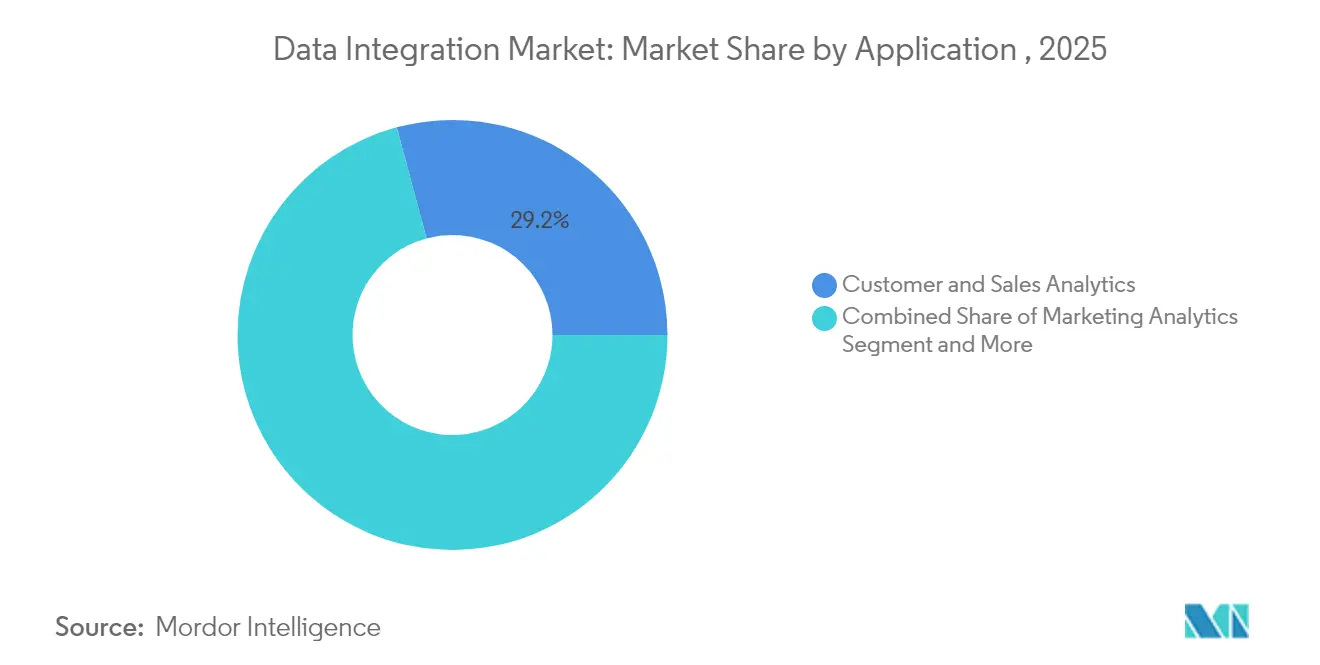
- Nach Anwendung entfielen auf Kunden- und Vertriebsanalyse 29,18 % des Umsatzes im Jahr 2025, während Betriebs- und Lieferkettenoptimierung mit einer CAGR von 15,74 % das am schnellsten wachsende Segment ist.
- Nach Endnutzerbranche dominierte der Sektor Banken, Finanzdienstleistungen und Versicherungen mit 24,12 % des Umsatzes im Jahr 2025; Gesundheitswesen und Biowissenschaften sollen bis 2031 mit einer CAGR von 18,91 % wachsen.
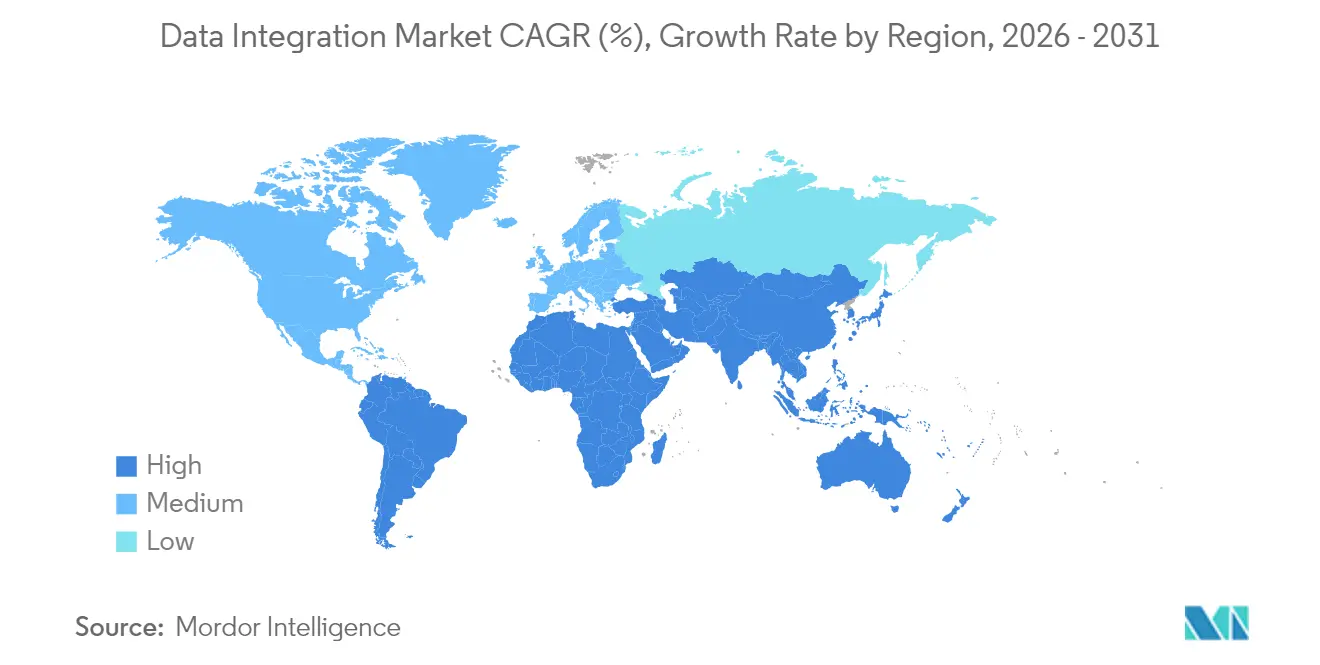
- Nach Geografie entfielen auf Nordamerika 38,35 % des Umsatzes im Jahr 2025, während Asien-Pazifik mit einer CAGR von 17,78 % die am schnellsten wachsende Region ist.
Hinweis: Die Marktgrößen- und Prognosezahlen in diesem Bericht werden mithilfe des proprietären Schätzrahmens von Mordor Intelligence erstellt und mit den neuesten verfügbaren Daten und Erkenntnissen bis 2026 aktualisiert.
Markttrends und Einblicke
Analyse der Auswirkungen von Treibern*
| Treiber | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Cloud-first-Modernisierung von Unternehmens-Stacks | +2.8% | Global, angeführt von Nordamerika und Europa | Mittelfristig (2–4 Jahre) |
| Wechsel von Batch-ETL zu Echtzeit-Streaming und CDC | +2.1% | Global, am stärksten in den APAC-Fertigungszentren | Kurzfristig (≤ 2 Jahre) |
| Self-Service-Datenpipelines mit Low-Code für Citizen Developer | +1.4% | Nordamerika und Europa, Ausweitung auf APAC | Mittelfristig (2–4 Jahre) |
| Regulatorischer Druck für Datenherkunft und Prüfbarkeit | +1.9% | Europa und Nordamerika, globale Ausbreitung | Kurzfristig (≤ 2 Jahre) |
| Entstehung von generativer-KI-fähigen semantischen Schichten | +1.8% | Global technologieorientierte Unternehmen | Langfristig (≥ 4 Jahre) |
| Edge- und In-Sensor-Analytik | +1.2% | APAC-Fertigung, Nordamerika IoT | Langfristig (≥ 4 Jahre) |
| Quelle: Mordor Intelligence | |||
Cloud-first-Modernisierung von Unternehmens-Stacks
Bis 2025 hatten die meisten Fortune-100-Unternehmen Integrationsworkloads in abonnementbasierte Cloud-Dienste verlagert, wodurch Infrastrukturkosten gesenkt und Upgrades vereinfacht wurden. [1]Informatica Corp., "Einführung in Informatica," informatica.com Cloud-F&E-Investitionen von über 1 Milliarde USD förderten Zero-ETL-Muster, die Schemata bei Bedarf lesen und Teams von starren vordefinierten Transformationen befreien. Fallstudien wie das Engagement von HCLTech mit Unilever zeigten 30 % Infrastruktureinsparungen nach der Einführung cloud-nativer Integration. Anbieter konvergierten auf Lakehouse-Designs, die Warehouses und Data Lakes vereinen, wobei Iceberg- und Delta-Formate offene Dateispeicherung über Plattformen hinweg ermöglichen. Verwaltete Lake-Dienste beschleunigten die Einführung weiter, indem sie die Tabellenwartung und Formatkonvertierung für mehr als 500 Quellen automatisierten. [2]Fivetran Inc., "Fivetran erweitert Snowflake-Partnerschaft," fivetran.com
Wechsel von Batch-ETL zu Echtzeit-Streaming und CDC
Streaming-Reverse-ETL-Tools, die 2024 eingeführt wurden, synchronisierten Data-Warehouse-Tabellen innerhalb von Sekunden mit operativen Systemen und unterstützten so die Live-Kundenbindung. Finanzinstitute integrierten CDC-Pipelines, die Betrugserkennungsfenster von Stunden auf Sekunden reduzierten. Fertigungsunternehmen wendeten IoT-Streams an, um Maschinenausfälle vorherzusagen und ungeplante Ausfallzeiten um 40 % zu reduzieren. [3]IBM, "Echtzeit-Analytik auf IoT-Daten," ibm.comZero-ETL-Konzepte entstanden, die Rohdaten direkt zwischen Speichern verschieben und Transformationen zur Abfragezeit anwenden, wodurch Latenz und Betriebskosten drastisch gesenkt werden. Cloud-Plattformen vereinfachten die Orchestrierung über deklarative Streaming-Dienste wie Dynamic Tables und Delta Live Tables.
Regulatorischer Druck für Datenherkunft und Prüfbarkeit
Der Digital Operational Resilience Act, der im Januar 2025 in Kraft trat, verpflichtete rund 22.000 EU-Finanzunternehmen zur Führung von Echtzeit-Datenherkunft und Vorfallsberichterstattung oder riskierte Strafen von bis zu 2 % des Umsatzes. In den Vereinigten Staaten verbot der 21st Century Cures Act die Informationsblockierung und schrieb Fast Healthcare Interoperability Resources-APIs für den Patientendatenzugang vor. Krankenhäuser sahen sich mit Kürzungen der Medicare-Anreize konfrontiert, wenn sie die Vorschriften nicht einhielten, was beschleunigte Investitionen in verwaltete Integrationsschichten auslöste. Anbieter reagierten mit automatisierten Datenkatalogen, die die Herkunft von Ende zu Ende abbilden und Prüfpfade in Pipeline-Metadaten einbetten. Da sich überlappende Vorschriften häuften, übernahmen Unternehmen semantische Schichten zur Zentralisierung von Definitionen und zur Vereinfachung der Compliance-Berichterstattung.
Entstehung von generativer-KI-fähigen semantischen Datenschichten
Semantische Schichten entwickelten sich zu KI-Ausrichtungsmaschinen, die die Ausgaben großer Sprachmodelle auf verwalteten Tabellen verankerten und die Halluzinationsraten um zwei Drittel reduzierten. Modellgesteuerte Definitionen in LookML ermöglichten deterministische KPI-Berechnungen, die über Dashboards und Chat-Schnittstellen hinweg wiederverwendet werden konnten. Progress Software integrierte generative KI, um Ontologien automatisch aufzubauen und in unstrukturierten Daten verborgene Beziehungen aufzudecken. Context-Layer-Innovationen verarbeiteten Billionen von Zeilen und passten Abfragen gleichzeitig an die Benutzerabsicht an, wodurch der Umfang der konversationellen Analytik erweitert wurde. Zusammen machten diese Fortschritte semantische Governance zu einer Voraussetzung für skalierbare Unternehmens-KI.
Analyse der Auswirkungen von Hemmnissen*
| Hemmnis | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Fachkräftemangel in fortgeschrittenen Integrationsarchitekturen | −1.8% | Global, akut in Nordamerika und Europa | Kurzfristig (≤ 2 Jahre) |
| Steigende Cloud-Egress- und Datenbewegungskosten | −1.2% | Global, am höchsten in Multi-Cloud-Setups | Mittelfristig (2–4 Jahre) |
| Datensouveränitätsbeschränkungen, die Pipelines fragmentieren | −1.5% | APAC, Europa, anderswo entstehend | Langfristig (≥ 4 Jahre) |
| Risiko der Anbieterabhängigkeit durch proprietäre iPaaS-Lösungen | −0.9% | Globale Unternehmen | Mittelfristig (2–4 Jahre) |
| Quelle: Mordor Intelligence | |||
Fachkräftemangel in fortgeschrittenen Integrationsarchitekturen
Im Jahr 2025 berichteten 76 % der Unternehmen von erheblichem Mangel an KI- und Datentechnik-Fachkräften, was Bereitstellungen verzögerte und Beratungsausgaben in die Höhe trieb. Sicherheits-, Netzwerk- und Datenkenntnisse wiesen jeweils Lücken von mehr als 35 % auf, was CIOs dazu zwang, Weiterbildungsprogramme und Managed-Services-Partnerschaften zu finanzieren. Umfragen prognostizierten, dass das Talentdefizit bis 2026 5,5 Billionen USD aus der globalen Wirtschaftsleistung abziehen könnte. Europäische Hersteller hoben Automatisierungs- und Grüntechnologie-Kenntnisse als besonders knapp hervor, was zu Projektrückständen in mittelgroßen Betrieben führte. Diese Einschränkungen verlangsamten den Rollout von Echtzeit-Streaming, semantischen Schichten und Edge-Pipelines trotz klarem ROI-Potenzial.
Datensouveränitätsbeschränkungen, die Multi-Regionen-Pipelines fragmentieren
Chinas Gesetz zum Schutz personenbezogener Informationen verpflichtete Betreiber kritischer Infrastrukturen, Daten lokal zu speichern und grenzüberschreitende Übertragungen durch Sicherheitsüberprüfungen zu genehmigen, was regionalisierte Integrationsarchitekturen vorantrieb. Im gesamten Asien-Pazifik-Raum wuchsen die Datenschutzvorschriften um 25 %, wobei Thailand, Indonesien und Sri Lanka umfassende Gesetze erließen. Europas DSGVO beeinflusste weiterhin die globale Politik und verlangte Privacy-by-Design-Kontrollen und strenge Rechtsgrundlagen für Übertragungen. Unternehmen reagierten mit der Einrichtung lokalisierter Verarbeitungsknoten und der Einführung hybrider Speichermodelle, um Souveränität mit Analytikskalierung in Einklang zu bringen. Multi-Cloud-Egress-Gebühren erhöhten den Kostendruck, da Daten zwischen konformen Zonen hin- und hertransportiert wurden, was den Bedarf an intelligentem Workload-Placement verstärkte.
*Unsere Prognosen behandeln die Auswirkungen von Treibern und Einschränkungen als richtungsweisend und nicht additiv. Die Wirkungsprognosen berücksichtigen Basiswachstum, Mischungseffekte und Wechselwirkungen zwischen Variablen.
Segmentanalyse
Nach Komponente:
Services wachsen schneller als ToolsDer Services-Umsatz wuchs bis 2031 mit einer CAGR von 14,08 %, da Organisationen fachkundige Beratung zu Cloud-Migrationen, Streaming-Architekturen und Compliance-Frameworks suchten. Die Tools-Kategorie hielt im Jahr 2025 noch immer 63,85 % des Marktes für Datenintegration, was etablierte ETL-, CDC- und Virtualisierungsplattformen widerspiegelt. Professional Services stiegen rund um semantische Schicht-Rollouts und generative KI-Integration stark an, wo maßgeschneiderte Governance und ethisches Design entscheidend waren. Managed Services gewannen an Beliebtheit für die 24/7-Überwachung und automatisierte Optimierung von Multi-Cloud-Pipelines.
Innerhalb der Tools blieben ETL/ELT-Suiten Standardinvestitionen für Batch-Workloads, während CDC-Engines für sofortige Analytik an Dynamik gewannen. Streaming-Plattformen wurden in IoT-Szenarien kritisch, und Datenvirtualisierung stieg neben Mesh-Architekturen, die den Zugriff vom Speicher entkoppeln. Datenqualitäts- und Master-Data-Management-Tools fanden neue Relevanz, da KI-Modelle vertrauenswürdige Eingaben verlangten. Die wachsende Qualifikationslücke verstärkte die Nachfrage nach Dienstleistern, die diese vielfältigen Produkte zu kohärenten Lösungen orchestrieren können.
Notiz: Segmentanteile aller einzelnen Segmente sind nach dem Berichtskauf verfügbar


Nach Bereitstellung:
Hybrid-Cloud steigt aufHybride Konfigurationen verzeichneten eine CAGR von 16,62 %, was den Kompromiss zwischen Souveränität und Flexibilität widerspiegelt, der Datenstrategie-Entscheidungen dominiert. Die Public Cloud behielt den größten Gesamtanteil, da Hyperscaler elastische Skalierung und ein reiches Ökosystem nativer Dienste boten. Private Clouds blieben in stark regulierten Umgebungen wie Finanzen und Gesundheitswesen bestehen, wo die Kontrolle über Hardware- und Netzwerkkonfigurationen wesentlich blieb.
On-Premise-Bestände schrumpften, verschwanden aber nicht und unterstützten Legacy-Mainframes und latenzempfindliche Workloads. Edge-Knoten entstanden als Mikro-Integrationspunkte, die Sensordaten lokal verarbeiten, bevor Zusammenfassungen an zentrale Speicher weitergeleitet werden. Die Marktgröße für Datenintegration bei Hybrid-Cloud-Bereitstellungen soll stetig wachsen, da mehr Unternehmen Mesh-Muster einführen, die Domänenteams föderieren und gleichzeitig eine zentralisierte Governance aufrechterhalten. Die Einführung beschleunigte sich, als Plattformen einzelne Steuerungsebenen einführten, die Warehouses, Lakes und Edge-Cluster umspannen.
Nach Unternehmensgröße:
Demokratisierung setzt sich durchKleinunternehmen verzeichneten eine CAGR von 15,36 %, da Low-Code-Schnittstellen und nutzungsbasierte Preisgestaltung historische Einstiegshürden beseitigten. Citizen Developer bauten Pipelines ohne tiefe Scripting-Kenntnisse auf und ermöglichten Echtzeit-Einblicke, die zuvor großen Unternehmen vorbehalten waren. Mittelständische Unternehmen nutzten dieselben Tools, um Analyseprogramme zu skalieren und beim Kundenerlebnis zu konkurrieren.
Großunternehmen, die im Jahr 2025 55,62 % des Umsatzes hielten, verlagerten ihren Fokus auf die Optimierung komplexer Bestände statt auf schnelle Expansion. Sie übernahmen KI-gesteuerte Beobachtbarkeit, um Pipeline-Ausfallzeiten zu reduzieren, und implementierten strenge Datenverträge über Tausende von Quellen hinweg. Die Datenintegrations-Branche sah, wie Kleinstunternehmen Versuche mit gehosteten Erfassungsdiensten begannen, die mit SaaS-Anwendungen gebündelt waren, was zukünftiges Volumenwachsen am langen Ende des Marktes signalisiert.
Nach Anwendung:
Lieferkettenoptimierung steigt stark anBetriebs- und Lieferkettenoptimierung erzielte mit einer CAGR von 15,74 % die höchste Wachstumsrate, da Hersteller und Einzelhändler End-to-End-Transparenz benötigten. IoT-Sensoren streamten Maschinenkennzahlen und ermöglichten vorausschauende Wartung und Bestandsausgleich nahezu in Echtzeit. Kunden- und Vertriebsanalyse blieb mit einem Anteil von 29,18 % dominant, da personalisiertes Engagement und Umsatzbeschleunigung oberste Prioritäten blieben.
Marketing-Analytik entwickelte sich auf der Grundlage kanalübergreifender Attributionsmodelle weiter, während Finanzteams Echtzeit-Feeds integrierten, um strenge Berichtsfristen zu erfüllen. HR-Funktionen übernahmen People Analytics, um Fluktuation und DEI-Ziele anzugehen, und F&E-Gruppen vereinheitlichten Datensätze, um Produktzyklen zu verkürzen. Die Marktgröße für Datenintegration bei betriebsorientierten Workloads soll sich ausweiten, da autonome Lieferketten reifen und Fabrik-, Logistik- und Ladendaten in kontinuierlichen Schleifen verknüpfen.
Notiz: Segmentanteile aller einzelnen Segmente sind nach dem Berichtskauf verfügbar
Nach Endnutzerbranche:
Gesundheitswesen beschleunigt sichGesundheitswesen und Biowissenschaften übertrafen alle Sektoren mit einer CAGR von 18,91 %, angetrieben durch Fast Healthcare Interoperability Resources-Mandate, die den Echtzeit-Austausch von Patientenakten erzwangen. Anbieter integrierten disparate elektronische Krankenaktensysteme, Labore und Wearable-Feeds, um koordinierte Versorgung zu liefern und Informationsblockierungsregeln zu erfüllen.
Banken, Finanzdienstleistungen und Versicherungen behielten einen Anteil von 24,12 %, da Betrugsbekämpfung, regulatorische Berichterstattung und Kundenpersonalisierung ausgereifte Pipelines verlangten. Die Fertigung schritt durch Industrie-4.0-Programme voran, während der Einzelhandel in Omnichannel-Plattformen investierte, die Online- und Point-of-Sale-Daten verbinden. Regierung, Energie und Medien verstärkten alle die Einführung, um Dienste zu modernisieren, kritische Infrastrukturen zu überwachen bzw. Inhalte zu personalisieren.
Geografische Analyse
Markt für Datenintegration in Nordamerika
Nordamerika hielt im Jahr 2025 einen Anteil von 38,35 % am globalen Umsatz, begünstigt durch eine frühe Cloud-Einführung, eine robuste Risikokapitalfinanzierung und ein dichtes Ökosystem aus Systemintegratoren. Bundesinfrastrukturprogramme, darunter ein Paket zur Netzmodernisierung im Wert von 65 Milliarden USD, trieben die zusätzliche Nachfrage nach Echtzeit-Energiedatenintegration an. Kanada spiegelte diese Muster wider und investierte in die Modernisierung des Gesundheitswesens und der Finanzdienstleistungen, während es gleichzeitig grenzüberschreitende Compliance-Anforderungen bewältigte.
Markt für Datenintegration im asiatisch-pazifischen Raum
Der asiatisch-pazifische Raum verzeichnete mit einem CAGR von 17,78 % das stärkste Wachstum, angetrieben durch den Ausbau von Hyperscale-Rechenzentren und umfangreiche Digitalisierungsprojekte im öffentlichen Sektor. China stellte 442 Milliarden USD für Smart-Grid-Upgrades bereit, die Streaming-Datenplattformen erfordern, während Indien INR 3,03 Billionen (0,012 Billionen USD) für Infrastruktur bereitstellte, die Analysen in ihrem Kern verankert. Japans digitale Infrastrukturbudgets in Höhe von 155 Milliarden USD erweiterten die adressierbare Basis für den Markt für Datenintegration zusätzlich. Lokale Datenlokalisierungsgesetze förderten jedoch hybride Architekturen, die Daten im Inland verarbeiten, bevor sie selektiv aggregiert werden.
Markt für Datenintegration in Europa
Europa zeigte trotz Datenschutzvorschriften eine solide Dynamik. Die Europäische Kommission plante bis 2030 Smart-Grid-Investitionen in Höhe von 584 Milliarden EUR (669,87 Milliarden USD), was Integrationsprojekte ankurbelte, die Daten aus erneuerbarer Energieerzeugung mit der Nachfragereaktion der Verbraucher kombinieren. Die DORA-Compliance-Ausgaben stiegen im Bankensektor an, während DSGVO-konforme Edge-Lösungen es Unternehmen ermöglichten, Daten lokal zu analysieren. Insgesamt wird erwartet, dass die Größe des Marktes für Datenintegration in der Region stetig ansteigen wird, da souveräne Clouds und offene Standards regulatorische Gegenwinds abmildern.

Regulatorisches Umfeld
Käufer von Datenintegrationslösungen richten die Plattformauswahl zunehmend an Anforderungen an Interoperabilität und Prüfbarkeit im Finanzdienstleistungs- und Gesundheitssektor aus. In der EU gilt seit Januar 2025 der Digital Operational Resilience Act (DORA), der die Erwartungen an nachvollziehbare Datenflüsse und Vorfallmeldungen verstärkt und die Nachfrage nach kontrollierter Datenherkunftsverfolgung, Überwachung und robusten Pipeline-Abläufen in regulierten Institutionen erhöht.
In den Vereinigten Staaten haben Regulierungsbehörden und Normungsgremien 2026 neue Interoperabilitätsanforderungen eingeführt. Die U.S. Securities and Exchange Commission (SEC) hat im Rahmen des Financial Data Transparency Act von 2022 gemeinsame Datenstandards festgelegt, die zum 1. Oktober 2026 in Kraft treten, um regulatorische Daten über mehrere Finanzaufsichtsbehörden hinweg zu harmonisieren. Im Gesundheitswesen veröffentlichte ASTP/ONC die 2026 Interoperability Standards Advisory (ISA) Reference Edition und stellte im Januar 2026 einen Entwurf der USCDI Version 7 zur öffentlichen Kommentierung vor, was den anhaltenden Bedarf an FHIR-basiertem Datenaustausch und Datenstandardisierung unterstreicht, die auf robuste Integration, Governance und Metadatenverwaltung angewiesen sind.
Wertschöpfungskettenanalyse
Die Wertschöpfungskette umfasst (1) Datenproduzenten (Unternehmensanwendungen, IoT und operative Systeme), (2) Erfassung und Konnektivität (Konnektoren, CDC/Streaming, API-Management), (3) Transformation und Orchestrierung (ETL/ELT, Workflow-Engines, Datenqualität), (4) Governance-Ebenen (Katalog, Datenherkunft, Richtlinien, MDM, semantische Ebenen) und (5) Nutzung und Aktivierung (BI, KI/ML, Reverse-ETL, operative Anwendungen). Hyperscaler und Anbieter von Datenplattformen konzentrieren zunehmend ihren Einfluss über mehrere Stufen hinweg, indem sie Integrationsfunktionen in Marktplätze und plattforminterne Erlebnisse einbetten, wodurch sich die Beschaffung hin zu Abonnements und nutzungsbasierten Modellen verschiebt und Interoperabilität wichtiger wird, um Anbieterbindung zu verringern.
Jüngste Entwicklungen im Ökosystem deuten auf eine engere Einbindung von Integrationssoftware in große Cloud- und ERP-Stacks hin. Informatica hat seine Zusammenarbeit mit Microsoft rund um Microsoft Fabric ausgebaut, einschließlich der Unterstützung von Fabric Open Mirroring und Azure-basierten Bereitstellungspunkten (einschließlich der Schweiz), was lokale Verarbeitungs- und Governance-Muster im Zusammenhang mit Souveränitätsanforderungen stärkt. IBM erweiterte ebenfalls das integrationsorientierte Ökosystem durch Partnerschaften, darunter die Zusammenarbeit mit Oracle bei der Modernisierung von Hybrid-Cloud- und KI-Umgebungen sowie mit SAP für SAP Cloud ERP Private-Implementierungen auf IBM Power Virtual Server. Diese Entwicklungen spiegeln einen Wandel in der Wertschöpfungskette wider, bei dem Beratungsunternehmen und Plattformpartner umfassende Modernisierungsprogramme zusammen mit den entsprechenden Tools bereitstellen.
Wettbewerbslandschaft
Der Markt blieb mäßig fragmentiert. Informatica führte mit einem Anteil von 14,1 % und nutzte seine Intelligent Data Management Cloud, um mehr als 80 % der Fortune-100-Unternehmen zu bedienen. Die Konsolidierung beschleunigte sich; Fivetran kaufte Census, um Erfassung und Aktivierung zusammenzuführen, und Snowflake fügte Crunchy Data für PostgreSQL-Unterstützung hinzu, was den Wunsch der Anbieter nach End-to-End-Stacks signalisiert.
Technologische Konvergenz verwischte die Grenzen zwischen Warehouse-, Lake- und Mesh-Lösungen. Cloud-Datenspeicher übernahmen vektorisierte Engines und offene Tabellenformate, während Integrationsspezialisten generative KI einbetteten, um Mapping und Fehlerbehebung zu automatisieren. Nischenanbieter erkämpften sich Positionen in Reverse ETL, Edge-Analytik und semantischer Governance und sprachen Käufer mit gezielten Schmerzpunkten an.
Strategische Allianzen gewannen an Bedeutung. Teradata kooperierte mit Fivetran an einem nativen Connector, der Daten aus mehr als 700 Quellen in VantageCloud für KI-Workloads überträgt. Anbieter umwarben auch die Marktplätze der Hyperscaler, um die Beschaffung zu vereinfachen und mittelständische Käufer zu erreichen. Der Wettbewerbsdruck blieb hoch, da Preisdruck, Open-Source-Tools und Fachkräftemangel Anbieter zwangen, sich durch Servicequalität, Sicherheitszertifizierungen und Ökosystembreite zu differenzieren.
Marktführer in der Datenintegrations-Branche
IBM Corporation
Microsoft Corporation
Informatica Inc.
SAP SE
Oracle Corporation
- *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert
Markt für Datenintegration
- Informatica Inc.
- IBM Corporation
- Microsoft Corporation
- SAP SE
- Oracle Corporation
- SAS Institute Inc.
- Denodo Technologies
- TIBCO Software Inc.
- QlikTech International AB
- Precisely
- Talend S.A.
- Fivetran Inc.
- Boomi LP
- SnapLogic Inc.
- MuleSoft LLC (Salesforce)
- Matillion Ltd
- Amazon Web Services, Inc.
- Google LLC
- HVR Software BV
- Airbyte Inc.
- Celigo Inc.
- Tray.io Inc.
- Alteryx Inc.
- SyncMatters Ltd.
- Hitachi Vantara LLC

Marktchancen und Zukunftsaussichten
Compliance-getriebene Interoperabilität und domänenübergreifende Datenstandardisierung stellen für Integrationsanbieter, die Datenherkunft, Prüfpfade und gemeinsame Semantik für Regulierungsbehörden und Prüfer produktisieren können, konkrete Chancen dar. Das Inkrafttreten der gemeinsamen Datenstandards der SEC im Rahmen des Financial Data Transparency Act von 2022 zum 1. Oktober 2026 schafft ein kurzfristiges Zeitfenster für regulierte Unternehmen und deren Technologieanbieter, um Berichtspipelines und Metadatenkontrollen zu modernisieren. Gleichzeitig halten die Aktualisierungen von ASTP/ONC (ISA 2026 und Entwurf der USCDI Version 7 im Januar 2026) die Interoperabilität und Datennormalisierung im Gesundheitswesen auf den aktiven Fahrplänen. Zusammen begünstigen diese politischen und normativen Signale Plattformen, die Datenverträge, Datenherkunft und kontrollierten Datenaustausch über Multisystemumgebungen hinweg operationalisieren können.
Agentische KI und kontrollierte KI-zu-Daten-Konnektivität heben sich ebenfalls als eigenständiger Chancenbereich innerhalb von Datenintegrationsstacks hervor, insbesondere wenn Unternehmen möchten, dass KI-Agenten mit Richtliniendurchsetzung auf vertrauenswürdige Unternehmensdaten zugreifen können. Informatica und Microsoft haben die Integration von Informatica IDMC mit Microsoft Fabric (einschließlich der Unterstützung von Fabric Open Mirroring) ausgebaut und MCP-basierte Zugriffsmuster für agentische KI-Workflows positioniert, was aktuelle Marktbelege für den Fokus der Anbieter in diesem Bereich liefert. Parallel dazu bindet SAPs Vereinbarung zur Übernahme von Reltio MDM enger an SAP Business Data Cloud, während der Ausbau lokaler Bereitstellungspunkte, einschließlich der Azure-basierten Implementierung von Informatica in der Schweiz, die Nachfrage nach Integrationsfähigkeiten unterstreicht, die Cloud-Elastizität mit landesinterner Verarbeitung und Governance-Kontrollen verbinden.
Recent Industry Developments in Markt für Datenintegration
- Juli 2026: Die Einführung von SnapCode und MCP Server ermöglicht KI-gesteuerte Unternehmensintegration direkt aus Coding-Umgebungen heraus. Die Einführung erweitert die direkten Daten- und Integrationswerkzeuge, beschleunigt die kontrollierte, KI-unterstützte Integration in Unternehmen und stärkt KI-native Datenworkflows innerhalb von Data-Fabric-Stacks.
- Mai 2026: Informatica und Microsoft vertiefen ihre Zusammenarbeit, um über die Integration von IDMC und Microsoft Foundry vertrauenswürdige Daten für agentische KI und Analytik in großem Maßstab bereitzustellen. Die Partnerschaft verbessert die Datengovernance und -zugänglichkeit für Unternehmens-KI und stärkt die positionierte Datenschicht von Informatica in Multicloud-Umgebungen.
- März 2026: SAP hat eine Vereinbarung zur Übernahme von Reltio getroffen, um MDM-Funktionen für agentische KI in SAP Business Data Cloud zu integrieren. Die Kapazitätserweiterung stärkt SAPs Data Fabric durch integriertes MDM für KI-gesteuerte Transformationen im gesamten SAP-Ökosystem.


Markt für Datenintegration Berichtsumfang und Forschungsmethodik
Marktdefinition und Abdeckung
Dieser Markt ist definiert als der Umsatz, der mit Software und Dienstleistungen erzielt wird, die Daten über verschiedene Systeme hinweg verbinden, verschieben, transformieren und synchronisieren, damit sie zuverlässig für Berichterstattung, Analytik und Betrieb genutzt werden können.
Umfangsausschlüsse: Wir schließen allgemeines IT-Outsourcing aus, das nicht an eine Integrationsaufgabe gebunden ist, sowie reine Datenbankspeicher-, Rechen- und Netzwerkdienste, die ohne Integrationsfunktionen verkauft werden.
Übersicht der Segmentierung
- Nach Komponente
- Tools
- ETL- und ELT-Plattformen
- Datenreplikation und CDC
- Datenvirtualisierung
- Streaming-Integration
- Datenqualitäts- und MDM-Tools
- Services
- Professional Services
- Managed Services
- Tools
- Nach Bereitstellung
- Cloud
- Public Cloud
- Private Cloud
- Hybrid Cloud
- On-Premise
- Cloud
- Nach Unternehmensgröße
- Kleinstunternehmen (1–49)
- Kleinunternehmen (50–249)
- Mittlere Unternehmen (250–999)
- Großunternehmen (1.000+)
- Nach Anwendung
- Kunden- und Vertriebsanalyse
- Betriebs- und Lieferkettenoptimierung
- Marketing-Analytik
- Finanz- und Risikomanagement
- Personalanalyse
- Produkt- und F&E-Datenintegration
- Sonstige
- Nach Endnutzerbranche
- IT und Telekommunikation
- BFSI
- Gesundheitswesen und Biowissenschaften
- Fertigung
- Einzel- und E-Commerce
- Regierung und Verteidigung
- Energie und Versorgungsunternehmen
- Medien und Unterhaltung
- Sonstige
- Nach Geografie
- Nordamerika
- Vereinigte Staaten
- Kanada
- Mexiko
- Südamerika
- Brasilien
- Argentinien
- Rest von Südamerika
- Europa
- Deutschland
- Vereinigtes Königreich
- Frankreich
- Italien
- Spanien
- Nordische Länder
- Benelux
- Russland
- Rest von Europa
- Asien-Pazifik
- China
- Indien
- Japan
- Südkorea
- ASEAN
- Rest von Asien-Pazifik
- Naher Osten und Afrika
- Naher Osten
- GCC
- Türkei
- Rest des Nahen Ostens
- Afrika
- Südafrika
- Nigeria
- Ägypten
- Rest von Afrika
- Naher Osten
- Nordamerika
Datenquellen, Marktgrößenbestimmung und Validierung
Schreibtischrecherche
Die Schreibtischrecherche wurde verwendet, um den Marktumfang festzulegen, die Nachfragetreiber zu verstehen und Annahmen zu verankern, die anhand öffentlicher Daten überprüft werden können. Wir stützen uns auf seriöse öffentliche Quellen wie das US Bureau of Labor Statistics für IT-Arbeitsmarkttrends, das US Census Bureau und Eurostat für Indikatoren der Unternehmensaktivität, NIST und ähnliche Normungsgremien für Leitlinien zu Datenmanagement und Interoperabilität sowie Veröffentlichungen von Regulierungsbehörden, die Governance und Datenbewegungen beeinflussen.
Wir prüfen zudem Unternehmensberichte und Investorenpräsentationen, Produktdokumentationen, Verbandswebsites und glaubwürdige Presseberichterstattung, um zu erfassen, wie Käufer Integrationsarbeiten beschreiben (Cloud-Migration, Anwendungsmodernisierung und Analytik-Ermöglichung). Zur Modellhygiene werden kostenpflichtige Datenbankabonnements gezielt für Unternehmensfinanzdaten und -informationen, Nachrichten- und Finanzscreening, Patentdatenbanken sowie Import- und Exportsignale auf Sendungsebene genutzt, wenn Hardware-Appliances in offengelegten Stücklisten auftauchen. Diese Beispiele sind nicht erschöpfend, und viele weitere Quellen werden zur Datenerhebung, Validierung und Klärung herangezogen.
Primärinterviews und Umfragen
Primärarbeit wird verwendet, um die Erkenntnisse aus der Schreibtischrecherche zu überprüfen und allgemeine Nachfragesignale in messbare Größenbestimmungsparameter umzuwandeln. Wir sprechen mit Lösungsverantwortlichen, Implementierungspartnern und Unternehmensanwendern in wichtigen Regionen, um Annahmen zu Einführungstempo, typischen Vertragsgrößen und Bereitstellungsmix mit den tatsächlichen Kaufentscheidungen abzustimmen. Wenn Lücken auftreten, werden Folgegespräche genutzt, um zu klären, ob das Problem im Umfang, der Preisgestaltung oder dem Zeitpunkt liegt, und das Modell wird anschließend vor der endgültigen Freigabe angepasst.
Verteilung der Befragten der Primärforschung im Feld
| Unternehmenstyp | Position der Befragten | Region |
|---|---|---|
| Top-Tier: 35% | CXOs: 15% | APAC: 47% |
| Mid-Tier: 46% | Funktions-/Abteilungsleiter: 27% | EMEA: 34% |
| Kleinere Akteure: 19% | Manager: 58% | Amerika: 19% |
Marktgrößenbestimmung & Prognose
Die Größenbestimmung beginnt mit einem Top-down-Ansatz, bei dem IT-Ausgaben und Cloud-Adoptionsindikatoren in einen adressierbaren Pool für Integrationsarbeiten übersetzt werden, der dann anhand von Adoptionsraten nach Branche und Unternehmensgröße eingegrenzt wird. Um die Gesamtwerte realistisch zu halten, wird das Ergebnis mittels selektiver Bottom-up-Näherungen abgeglichen, wie beispielsweise stichprobenartig erhobene Anbieterumsatzsignale, Kanalprüfungen zu typischen Dealgrößen und einer Volumen-mal-ASP-Logik für gängige Abonnementpakete.
Einige praktische Eingabegrößen, die das Modell beeinflussen, sind das Tempo von Cloud- und Hybrid-Implementierungen, der Anteil der Integration, der als Tools versus Dienstleistungen erbracht wird, die Rate neuer Anwendungseinführungen, die Konnektornachfrage erzeugen, und die Intensität der Governance-Anforderungen, die den Projektumfang erhöhen. Für die Prognose verwenden wir Szenarioanalysen, die durch Expertenkonsens zu Variablen wie dem Zeitpunkt der Cloud-Migration, der Komplexität der Datenlandschaft und der Verschiebung von Batch- zu Nahezu-Echtzeit-Pipelines gestützt werden. Wenn Bottom-up-Signale unvollständig sind, gehen wir mit Lücken um, indem wir konservative Bandbreiten verwenden und diese dann anhand regionaler Unternehmenszahlen und gemeldeter Softwareumsatztrends erneut überprüfen.
Datenvalidierung & Aktualisierungszyklus
Die Modellergebnisse werden mit unabhängigen Signalen trianguliert und anschließend auf Anomalien überprüft, etwa plötzliche Mixverschiebungen, unrealistische regionale Anteile oder Preissprünge, die nicht mit den Angaben der Käufer übereinstimmen. Wird eine Abweichung festgestellt, wird der zugrunde liegende Treiber isoliert, mit Interviewnotizen erneut überprüft und mithilfe einer weiteren Schreibtischquelle validiert, bevor die Zahl beibehalten wird.
Vor der Veröffentlichung wird eine mehrstufige interne Überprüfung durchgeführt, damit Annahmen, Einheiten und Währungsumrechnungen über die gesamte Zeitreihe hinweg konsistent bleiben. Berichte werden jährlich aktualisiert, und Zwischenaktualisierungen erfolgen, wenn wesentliche Ereignisse die Nachfragemuster oder Preisgestaltung verändern. Vor der Auslieferung führt der Analyst einen neuen Durchgang durch, damit Kunden die neueste aktualisierte Sichtweise erhalten.
Vergleich der Marktgrößenbestimmung von Mordor Intelligence für den Datenintegrationsmarkt mit anderen veröffentlichten Schätzungen
Veröffentlichte Marktgrößen für Datenintegration unterscheiden sich häufig, da Teams Tools, Dienstleistungen und angrenzende Kategorien unterschiedlich behandeln und außerdem unterschiedliche Basisjahre und Währungszeitpunkte wählen. Die größten Unterschiede zeigen sich, wenn sich eine Schätzung auf die Kennzeichnung des Anbieterumsatzes stützt und eine andere Schätzung die Nachfrage aus Signalen der Unternehmensadoption rekonstruiert.
Einige veröffentlichte Zahlen erweitern den Umfang auf Datenqualität, Governance oder breitere Plattformumsätze und können zudem ein schnelleres Wachstum unterstellen, indem sie eine einheitliche Cloud-Migration über alle Branchen hinweg annehmen. In der Größenbestimmung von Mordor Intelligence wird Umsatz nur dann berücksichtigt, wenn er direkt mit Integrationstools und Integrationsdienstleistungen verbunden ist, und angrenzende Datenmanagement-Suiten werden ausgeschlossen, sofern sie nicht als Teil einer Integrationsaufgabe bepreist und verkauft werden.
Benchmark-Vergleich
| Quelle | Marktgröße | Lücken in der Forschungsmethodik |
|---|---|---|
| Mordor Intelligence | 14,33 Mrd. USD (2026) | |
| Branchenverlag A | 14,32 Mrd. USD (2024) | Verwendet ein früheres Basisjahr und eine breitere Definition, die ausdrücklich Plattformen sowie ein breites Spektrum an Dienstleistungen einschließt, was Ausgaben einbeziehen kann, die nicht integrationsspezifisch sind. |
| Branchenverlag B | 14,29 Mrd. USD (2024) | Berichtet einen anderen Zeitrahmen und vermischt mehrere Dienstleistungskategorien (einschließlich Professional Services und Managed Services), was die Gesamtwerte je nach Zuordnung der Implementierungsarbeiten verändern kann. |
Die Tabelle zeigt, dass selbst ähnlich erscheinende Werte aus unterschiedlichen Jahren und unterschiedlichen einbezogenen Umsatzlinien stammen können. Indem der Umfang auf integrationsspezifische Ausgaben beschränkt bleibt und Adoption, Mix und Preisgestaltung durch wiederholte Prüfungen validiert werden, bleibt die Endzahl auf klare, überprüfbare und aktualisierbare Eingaben zurückführbar.


Im Bericht beantwortete Schlüsselfragen
Wie groß war der globale Markt für Datenintegration im Jahr 2026?
Der Markt erreichte im Jahr 2026 einen Wert von 14,33 Milliarden USD.
Welches Bereitstellungsmodell wächst am schnellsten?
Hybrid-Cloud-Bereitstellungen sollen zwischen 2026–2031 mit einer CAGR von 16,62 % wachsen.
Welcher Anwendungsbereich wird bis 2031 das stärkste Wachstum verzeichnen?
Betriebs- und Lieferkettenoptimierung soll mit einer CAGR von 15,74 % führen.
Warum führt das Gesundheitswesen Datenintegration so schnell ein?
Der 21st Century Cures Act schreibt Echtzeit-Interoperabilität vor und treibt Gesundheitswesen und Biowissenschaften zu einer CAGR von 18,91 %.
Wie beeinflussen Vorschriften wie DORA Kaufentscheidungen?
Finanzunternehmen sehen sich unter DORA mit Anforderungen an Echtzeit-Datenherkunft und Vorfallsberichterstattung konfrontiert, was Investitionen in verwaltete Integrationsplattformen beschleunigt.
Was treibt die Konsolidierung unter Integrationsanbietern an?
Anbieter erwerben komplementäre Fähigkeiten wie Reverse ETL und Datenbankunterstützung, um End-to-End-Datenbewegungsökosysteme bereitzustellen und wettbewerbsfähig zu bleiben.
Seite zuletzt aktualisiert am:



