
Data-Lake-Marktgröße und Marktanteil
Marktübersicht
| Studienzeitraum | 2020 - 2031 |
|---|---|
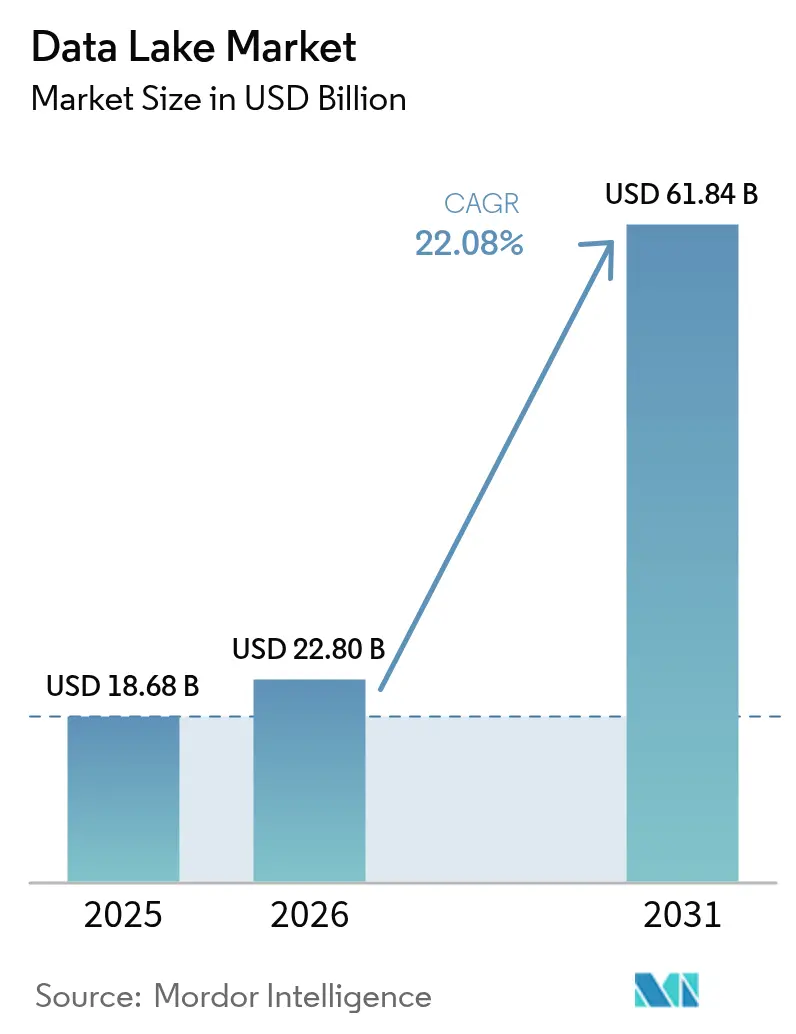
| Marktgröße (2026) | 22.8 Milliarden US-Dollar |
| Marktgröße (2031) | 61.84 Milliarden US-Dollar |
| Growth Rate (2026 - 2031) | 22.08 % |
| Schnellstwachsender Markt | Asien |
| Größter Markt | Nordamerika |
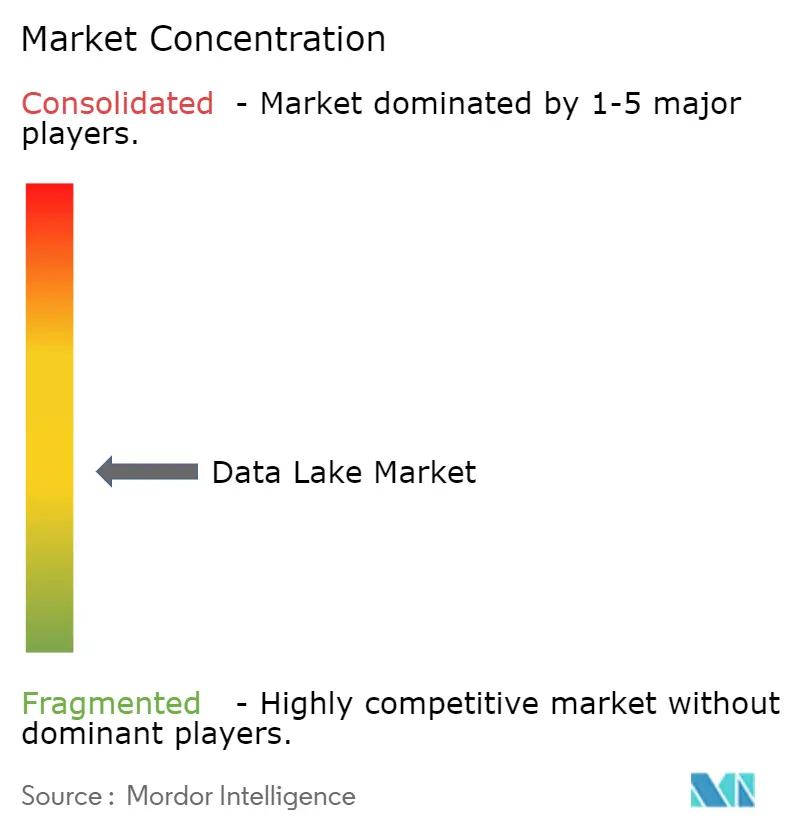
| Marktkonzentration | Mittel |
Hauptakteure *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert Bild © Mordor Intelligence. Wiederverwendung erfordert Namensnennung gemäß CC BY 4.0. | |
Data-Lake-Marktanalyse von Mordor Intelligence
Die Größe des Data-Lake-Marktes wird voraussichtlich von 18,68 Milliarden USD im Jahr 2025 auf 22,8 Milliarden USD im Jahr 2026 wachsen und bis 2031 bei einem CAGR von 22,08 % über den Zeitraum 2026–2031 voraussichtlich 61,84 Milliarden USD erreichen. Das Wachstum resultiert aus dem rasant steigenden Volumen unstrukturierter Daten, die durch generative KI-Pipelines erzeugt werden, aus erweiterten regulatorischen Anforderungen zur Aufzeichnungsführung sowie aus dem Wandel hin zu Lakehouse-Architekturen, die See- und Warehouse-Strukturen in einer einzigen Ebene zusammenführen. Fortune-500-Unternehmen berichten von Gesamtkosteneinsparungen von 35–40 % nach der Einführung von Lakehouses, während Echtzeit-ESG- und Risikostresstestarbeitslasten die Anwendungsfälle auf industrielle und finanzielle Bereiche ausweiten. Serverlose offene Tabellenformate bilden nun den Kern von Multi-Cloud-Portabilitätsstrategien, und automatisierte Governance-Schichten entstehen, um „Sumpf”-Fallstricke zu verhindern, ohne die Innovation zu bremsen.
Wichtigste Erkenntnisse des Berichts
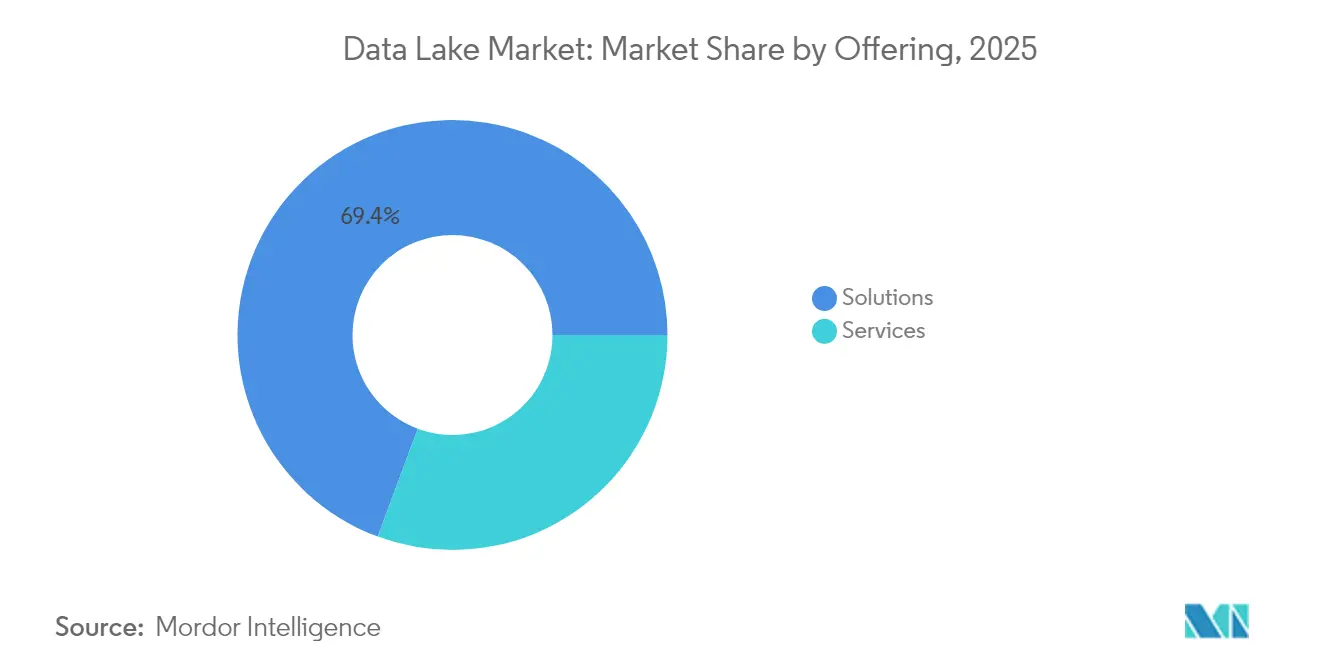
- Nach Angebot führten Lösungen im Jahr 2025 mit einem Umsatzanteil von 69,35 %; Dienstleistungen werden bis 2031 voraussichtlich mit einem CAGR von 24,77 % wachsen.
- Nach Bereitstellung entfiel im Jahr 2025 ein Marktanteil von 64,20 % auf Cloud-Lösungen, während Hybrid/Multi-Cloud zwischen 2026 und 2031 voraussichtlich mit einem CAGR von 23,1 % wachsen wird.
- Nach Unternehmensgröße entfielen im Jahr 2025 71,10 % der Data-Lake-Marktgröße auf Großunternehmen; KMU sind mit einem CAGR von 26,1 % bis 2031 die am schnellsten wachsende Gruppe.
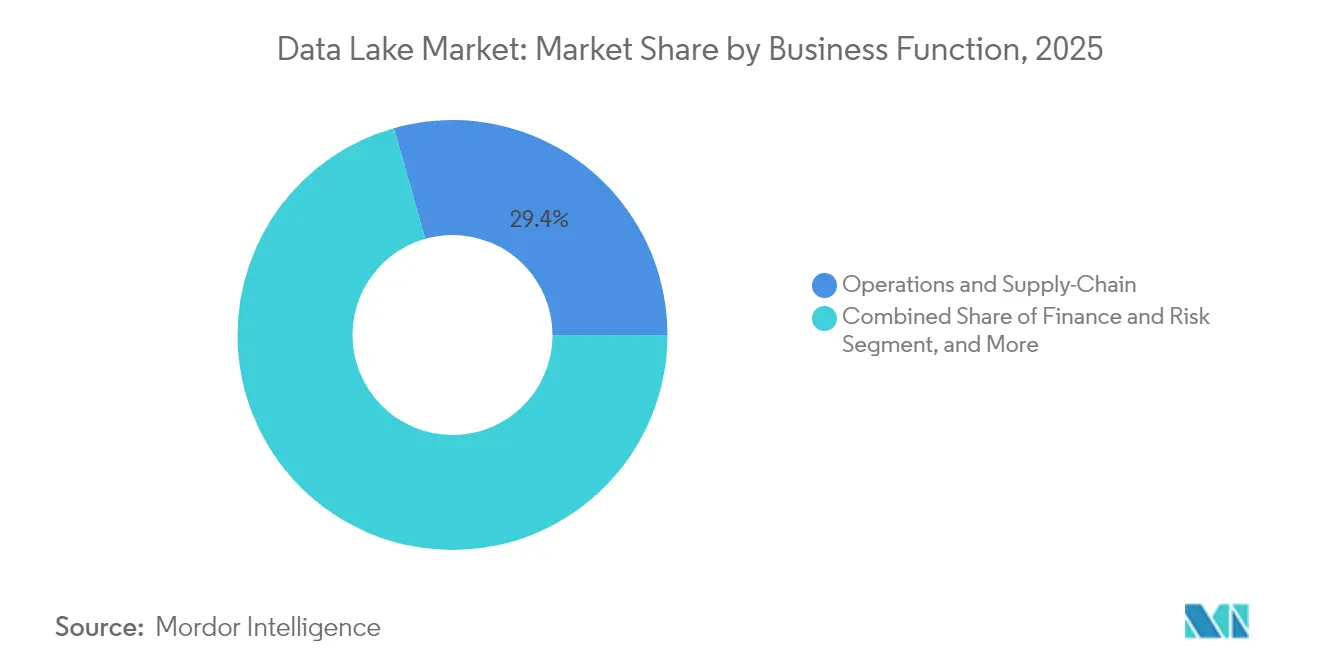
- Nach Geschäftsfunktion hielt Betrieb und Lieferkette im Jahr 2025 einen Anteil von 29,40 % am Data-Lake-Markt, während Finanzen und Risiko bis 2031 mit einem CAGR von 25,2 % wächst.
- Nach Endnutzerbranche führte IT und Telekommunikation im Jahr 2025 mit einem Umsatzanteil von 21,60 %; Gesundheitswesen und Biowissenschaften wird bis 2031 voraussichtlich mit einem CAGR von 25,6 % wachsen.
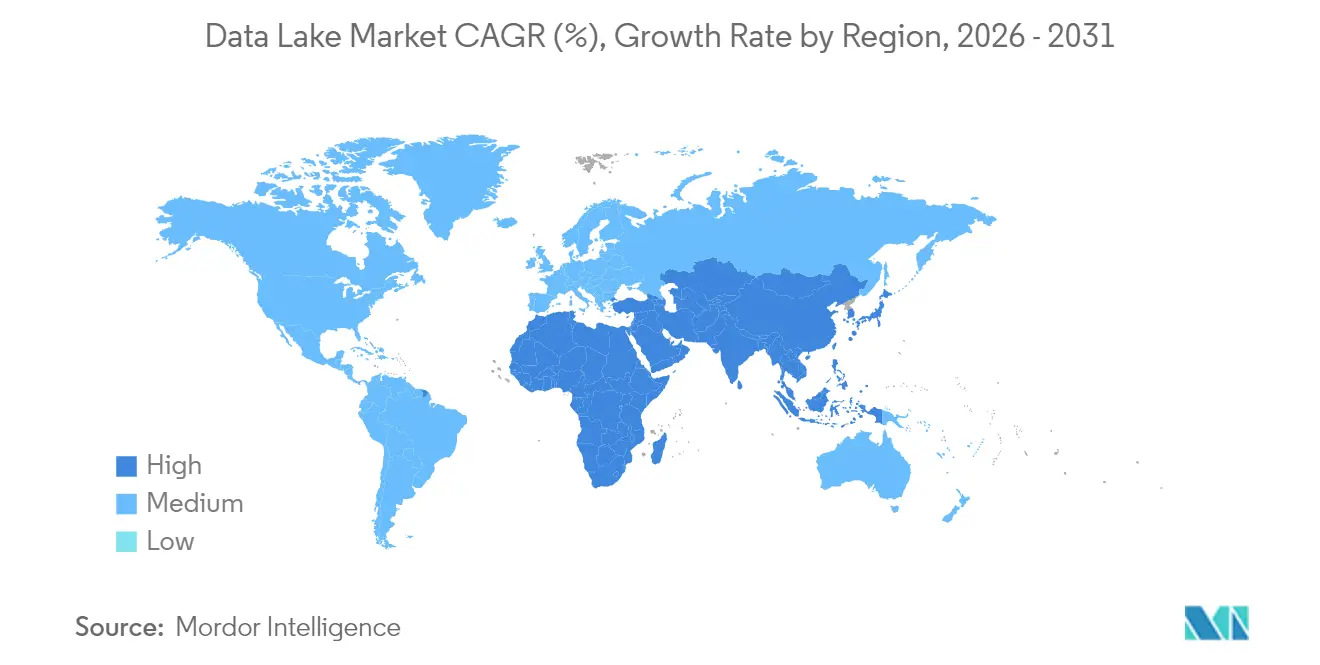
- Nach Geografie dominierte Nordamerika im Jahr 2025 mit einem Anteil von 37,40 %, während Asien bis 2031 voraussichtlich mit einem CAGR von 23,5 % wachsen wird.
Hinweis: Die Marktgrößen- und Prognosezahlen in diesem Bericht werden mithilfe des proprietären Schätzrahmens von Mordor Intelligence erstellt und mit den neuesten verfügbaren Daten und Erkenntnissen bis 2026 aktualisiert.
Markttrends und Einblicke
Analyse der Auswirkungen von Treibern*
| Treiber | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Auswirkungszeitraum |
|---|---|---|---|
| Explosion unstrukturierter und multimodaler Daten aus generativen KI-Arbeitslasten | +7.5% | Global mit Schwerpunkt in Nordamerika und Westeuropa | Mittelfristig (2–4 Jahre) |
| Datenspeicherungsvorschriften in Europa beschleunigen die Einführung cloudbasierter Data Lakes | +5.2% | Europäische Union, Vereinigtes Königreich, Schweiz und APAC | Kurzfristig (≤ 2 Jahre) |
| Lakehouse-Konvergenz treibt 35–40 % TCO-Einsparungen für Fortune-500-Unternehmen | +6.3% | Global mit früher Einführung in Nordamerika | Mittelfristig (2–4 Jahre) |
| Serverlose Tabellenformate (Iceberg/Delta) ermöglichen Multi-Cloud-Portabilität | +4.8% | Global, am stärksten dort, wo Multi-Cloud-Strategien aktiv sind | Mittelfristig (2–4 Jahre) |
| Echtzeit-ESG-Scope-3-Datenerfassungsanforderungen im Industriesektor | +3.2% | Europa, Nordamerika, fortgeschrittene APAC-Volkswirtschaften | Langfristig (≥ 4 Jahre) |
| Regulatorische Stresstests im Finanzdienstleistungsbereich erfordern jahrzehntelange Tick-Daten-Aufbewahrung | +2.9% | Globale Finanzzentren (New York, London, Singapur, Hongkong) | Mittelfristig (2–4 Jahre) |
| Quelle: Mordor Intelligence | |||
Explosion unstrukturierter und multimodaler Daten aus generativen KI-Arbeitslasten
Generative KI-Anwendungen erzeugen umfangreiche Bild-, Audio- und Textdaten, die eine Schema-on-Read-Speicherung erfordern. Unternehmen erwarten, dass bis 2025 30 % der globalen 175-Zettabyte-Datensphäre eine Echtzeitverarbeitung erfordern werden – ein Profil, das für starre Warehouses ungeeignet ist. Data Lakes werden daher zur Standard-Landezone für multimodale Korpora, die in Prompt-Engineering-Schleifen verwendet werden.[1]Acceldata, "Enterprise Data Lakes: Revolutionizing Business Data," acceldata.ioDer Lakehouse-Entwurf von Google Cloud zeigt, wie die Speicherung im nativen Format in Kombination mit Vektorindizierung die Feinabstimmung von Foundation-Modellen beschleunigt und gleichzeitig die Speicherkosten senkt. Unternehmen, die die Einführung verzögern, riskieren langsamere Innovationszyklen und höhere Stückkosten bei KI-Arbeitslasten.
Datenspeicherungsvorschriften in Europa beschleunigen die Einführung cloudbasierter Data Lakes
Das EU-Datenverwaltungsgesetz und das Datengesetz verpflichten Organisationen zur Lokalisierung sensibler Arbeitslasten. Hyperscaler reagieren darauf: AWS investiert 7,8 Milliarden EUR in eine souveräne Cloud-Region, die mit integrierten Datenspeicherungskontrollen ausgeliefert wird.[2]Databricks, "Databricks Agrees to Acquire Tabular," databricks.com Unternehmen setzen nun regionssegmentierte Data Lakes ein, die Speicherungsvorschriften erfüllen und dennoch über föderierte Engines abfragbar bleiben, was die Nachfrage nach metadatenreichen Katalogen ankurbelt, die in der Lage sind, grenzüberschreitende Datennutzung in Prüfberichten aufzuzeigen.
Lakehouse-Konvergenz liefert 35–40 % TCO-Einsparungen
Ein einstufiges Lakehouse beseitigt die Duplizierung, die früher separate Seen und Warehouses belastete. Befragte Unternehmen, die Analyseaufgaben auf Lakehouse-Engines verlagern, berichten von halbierten Datenübertragungskosten und komprimierungsbedingten Speichereinsparungen. Leistungsgewinne durch vektorbewusste Abfrageplaner reduzieren die Rechenzeiten weiter und setzen Budget für KI-Experimente frei. Einundachtzig Prozent der Unternehmen trainieren ML-Modelle nun direkt auf Lakehouse-Tabellen, was darauf hindeutet, dass die Konvergenz keine Randerscheinung mehr ist, sondern ein Mainstream-Muster.
Serverlose Tabellenformate ermöglichen Multi-Cloud-Portabilität
Apache Iceberg, Delta Lake und Hudi führen ACID-Transaktionen, Schema-Evolution und Zeitreisen in Objektspeicher ein. Die Formate entkoppeln Compute von Storage und ermöglichen es Analyse-Engines in konkurrierenden Clouds, dieselben Datensätze ohne Replikation abzufragen. Die Übernahme von Tabular durch Databricks im Jahr 2024 unterstreicht den strategischen Wert offener Tabellenmetadaten, während die Omni-Funktion von Google BigLake Iceberg-Partitionen in konkurrierenden Clouds abfragt und damit die These des neutralen Formats bestätigt.[3]Europäische Kommission, "Eine europäische Datenstrategie," digital-strategy.ec.europa.eu
Analyse der Auswirkungen von Hemmnissen*
| Hemmnis | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Auswirkungszeitraum |
|---|---|---|---|
| Metadatendrift führt zu „Datensümpfen” | -3.8% | Global, stärker ausgeprägt bei Legacy-Implementierungen | Kurzfristig (≤ 2 Jahre) |
| Mangel an qualifizierten Data-Lake-Ingenieuren | -2.9% | APAC, Lateinamerika, Naher Osten und Afrika | Mittelfristig (2–4 Jahre) |
| Latenzempfindliche Anwendungsfälle bevorzugen weiterhin Warehouses | -2.1% | Finanz- und Telekommunikationszentren weltweit | Kurzfristig (≤ 2 Jahre) |
| Intransparente verbrauchsbasierte Cloud-Preisgestaltung | -1.7% | Mittelständische Unternehmen weltweit | Mittelfristig (2–4 Jahre) |
| Quelle: Mordor Intelligence | |||
Metadatendrift führt zu „Datensümpfen”
Wenn die Datenaufnahme die Katalogaktualisierungen überholt, werden Data Lakes zu nicht durchsuchbaren Repositories. Bis 2025 wird das globale Datenvolumen 163 Zettabyte erreichen, was das Risiko isolierter Dateien ohne Kontext erhöht. Unternehmen reagieren darauf, indem sie automatisierte Herkunfts-Tracker wie Unity Catalog einsetzen, der jeden Lese-/Schreibvorgang protokolliert und verwaiste Assets kennzeichnet. Ohne ähnliche Kontrollen kann der Governance-Aufwand die prognostizierten Einsparungen aus der Lakehouse-Konsolidierung zunichtemachen.
Mangel an qualifizierten Lake-Ingenieuren in aufstrebenden Regionen
Unternehmen in APAC und Lateinamerika beklagen einen Mangel an Ingenieuren, die verteilte Dateisysteme, offene Tabellenformate und Cloud-Kostenoptimierung beherrschen. POPsights-Daten zeigen, dass die KI-getriebene Schaffung neuer Stellen das lokale Ausbildungsangebot übersteigt. OECD-Forschungen heben eine wachsende Stadt-Land-Kluft beim Zugang zu fortgeschrittenen Datenkenntnissen hervor.[4]OECD, "Schaffung von Arbeitsplätzen und lokale Wirtschaftsentwicklung 2024," oecd.org Verwaltete Dienste und Low-Code-Pipelines mildern den Mangel, doch der Talentmangel verlängert weiterhin die Implementierungszyklen und verlangsamt die Marktdurchdringung von Data Lakes.
*Unsere Prognosen behandeln die Auswirkungen von Treibern und Einschränkungen als richtungsweisend und nicht additiv. Die Wirkungsprognosen berücksichtigen Basiswachstum, Mischungseffekte und Wechselwirkungen zwischen Variablen.
Segmentanalyse
Nach Angebot:
Lösungen führen, Dienstleistungen wachsen starkLösungen generierten im Jahr 2025 69,35 % des Data-Lake-Marktumsatzes, was einer Data-Lake-Marktgröße von 12,95 Milliarden USD entspricht. Die Dominanz resultiert daraus, dass Unternehmen Speicher-Engines, Abfragebeschleuniger und Governance-Suiten standardisieren, die das Rückgrat KI-fähiger Umgebungen bilden. Anbieter bündeln Kostenoptimierungs-Dashboards, automatisiertes Tiering und native Unterstützung offener Tabellenformate und bleiben damit relevant, wenn sich Arbeitslasten weiterentwickeln.
Das Dienstleistungssegment wächst mit einem CAGR von 24,77 % bis 2031 rasant, was die Nachfrage nach Migrationsplänen, Leistungsoptimierung und 24×7-Managed-Operations widerspiegelt. Vielen Unternehmen fehlt Personal, das Legacy-Hadoop-Umgebungen neu aufsetzen kann, weshalb sie Spezialisten beauftragen, die vorhersehbare SLA-Ergebnisse versprechen. Der angespannte Talentmarkt stellt sicher, dass die Buchungen für professionelle Dienstleistungen schneller wachsen werden als der gesamte Data-Lake-Markt.


Nach Bereitstellung:
Cloud dominiert, Hybrid beschleunigtCloud-Bereitstellungen entfielen im Jahr 2025 auf 64,20 % des Data-Lake-Marktanteils, da Organisationen sofortige Skalierbarkeit und integrierte Sicherheit anstrebten. Elastische Objektspeicher wie Amazon S3 eliminieren Investitionsausgaben und bieten gleichzeitig Lifecycle-Automatisierung, die kalte Daten automatisch in kostengünstige Klassen verschiebt. Analyse-Engines werden dann bei Bedarf hochgefahren, wodurch die Rechenausgaben mit dem Projekttempo in Einklang gebracht werden.
Hybrid- und Multi-Cloud-Konfigurationen wachsen bis 2031 mit einem CAGR von 23,1 %. Offene Tabellenformate ermöglichen es, eine Metadatendefinition über lokale und öffentliche Cloud-Buckets hinweg zu verwenden, was den Replikationsbedarf drastisch reduziert. Regionale Compliance-Vorschriften treiben Hybrid-Strategien weiter voran, da Unternehmen regulierte Arbeitslasten in souveränen Regionen verankern und dennoch über Cloud-übergreifende Fabrics abfragen. Infolgedessen steigt die Data-Lake-Marktgröße für Hybrid-Umgebungen im Gleichschritt mit souveränen Cloud-Einführungen.
Nach Unternehmensgröße:
Großunternehmen dominieren, KMU gewinnen an TempoGroßunternehmen machten im Jahr 2025 71,10 % der Data-Lake-Marktgröße aus, was ungefähr 13,28 Milliarden USD entspricht. Ihre komplexen, Petabyte-großen Umgebungen erfordern erweitertes RBAC, automatisierte Herkunftsverfolgung und FinOps-Governance. Banken, Hersteller und Telekommunikationsunternehmen verlassen sich auf Lakehouses, um Silos zu konsolidieren und Echtzeit-KI-Anwendungen zu unterstützen.
Kleine und mittlere Unternehmen verzeichnen mit einem CAGR von 26,1 % das schnellste Wachstum, da von Anbietern verwaltete Pläne nun eine „Pay-as-processed”-Abrechnung anbieten. Low-Code-Orchestrierung und vorlagengesteuerte Schemata verkürzen die Implementierungszyklen. Community-Editionen von Iceberg und Delta bieten unternehmensgerechte Funktionen ohne Lizenzgebühren und ermöglichen es ressourcenbeschränkten Unternehmen, in den Data-Lake-Markt-Mainstream einzusteigen.
Nach Geschäftsfunktion:
Betrieb stabil, Finanzen und Risiko wachsen starkBetriebs- und Lieferkettenarbeitslasten generierten im Jahr 2025 29,40 % der Ausgaben, wobei Hersteller IoT-Telemetrie, Lieferanten-EDI und Logistikdaten für die vorausschauende Wartung zusammenführen. Die Schema-on-Read-Flexibilität macht Data Lakes ideal für die Zusammenführung halbstrukturierter Sensordateien mit ERP-Tabellen und unterstützt Control-Tower-Dashboards, die Ausfallzeitrisiken aufzeigen.
Finanz- und Risikoanwendungen wachsen mit einem CAGR von 25,2 %. Regulatoren erwarten nun jahrzehntelange Tick-Historien, und Lakehouses speichern diese Volumina effizient. Der Vorschlag der US-Notenbank vom April 2025 zur Überarbeitung der Stresspufferberechnungen unterstreicht die Notwendigkeit, Kapitalauswirkungen unter Stressbedingungen zu modellieren. Banken, die Risiko-, Treasury- und ESG-Daten in einem verwalteten Data Lake zentralisieren, eliminieren Abstimmungsverzögerungen und gewinnen Berichtsflexibilität.
Nach Endnutzerbranche:
IT und Telekommunikation führen, Gesundheitswesen wächstIT- und Telekommunikationsbetreiber hielten im Jahr 2025 21,60 % des Umsatzes. Netzbetreiber nehmen Anrufdetailaufzeichnungen, Netz-KPIs und Support-Transkripte in Data Lakes auf und führen dann Betrugserkennung und Abwanderungsanalysen durch, die den Lifetime Value verbessern. Softteco weist darauf hin, dass Vodafone und AT&T KI-gesteuerte Lake-Architekturen nutzen, um Sendemasten zu optimieren und Angebote zu personalisieren.
Gesundheitswesen und Biowissenschaften werden voraussichtlich mit einem CAGR von 25,6 % wachsen. Krankenhäuser verbinden elektronische Gesundheitsakten, Bildgebung und Genomik in einheitlichen Repositories, die Präzisionsmedizinstudien ermöglichen. Microsoft-Fabric-Implementierungen veranschaulichen, wie einheitliche Aufnahmepipelines die Datenvorbereitung verkürzen und Echtzeit-klinische Warnmeldungen ermöglichen. Pharmaunternehmen nutzen wiederholbare Lake-Workflows, um Entdeckungszyklen zu verkürzen, was nachhaltige Investitionen in den Data-Lake-Markt antreibt.
Geografische Analyse
Data-Lake-Markt Nordamerika
Nordamerika erwirtschaftete 37,40 % des Umsatzes im Jahr 2025 und setzt weiterhin Maßstäbe in der Architekturreife. Finanzinstitute verlängern die Zeitreihen-Aufbewahrung, um sich an weiterentwickelte Stresstestvorlagen anzupassen, während Krankenhausnetzwerke multimodale Patientengraphen aufbauen, die KI-gestützte Diagnostik unterstützen. Risikokapital fördert zudem die Gründung von Governance-Start-ups und sorgt für ein lebendiges Ökosystem.
Data-Lake-Markt Asien-Pazifik
Asien-Pazifik ist die am schnellsten wachsende Region mit einer CAGR von 23,5 % bis 2031. Regierungen in Japan, Indien und Singapur fördern Sovereign-Cloud-Projekte und treiben die Nachfrage nach regionenkonformen Lake-Zonen an. Telekommunikationsunternehmen in China analysieren umfangreiche 5G-Protokolle für die Kapazitätsplanung, während indonesische Fintech-Unternehmen Betrugserkennungs-Lakes gemeinsam nutzen, um Cyberkriminalität einzudämmen. Anbieter, die APAC-Hauptsitze errichten, wie etwa Wasabi in Japan, zielen darauf ab, den prognostizierten IaaS-Anstieg von 36 % zu nutzen.
Data-Lake-Markt Europa
Europa beschleunigt die Einführung unter strengen Datensouveränitätsvorgaben. Die Europäische Datenstrategie treibt Investitionen in lokales Hosting voran, und AWS wird bis Ende 2025 eine Region in Brandenburg eröffnen, um Anforderungen an den Datenstandort zu erfüllen. Hersteller speichern Scope-3-Emissionen in Echtzeit für die CSRD-Berichterstattung, und Banken verfeinern Basel-III-Berechnungen in prüfungssicheren Lakes. Die Stresstestvorlagen der Europäischen Bankenaufsichtsbehörde für 2025 verstärken die technischen Anforderungen, die Lakehouse-Architekturen erfüllen.

Regulatorisches Umfeld
Die regulatorischen Anforderungen an Datenzugriff, Datenstandort und Governance werden zunehmend verschärft und beeinflussen damit, wie Unternehmen Data Lakes gestalten und betreiben. In der Europäischen Union tritt der Data Act (Verordnung (EU) 2023/2854) stufenweise in Kraft, mit Wirksamkeit ab dem 12. September 2025 und wesentlichen Anwendungsterminen ab dem 12. September 2026. Dies verschärft die Pflichten rund um Datenzugriff und Datenportabilität, was die Nachfrage nach standardisierten Metadaten, prüfbaren Freigabekontrollen und Multi-Umgebungs-Architekturen erhöht. Getrennt davon führt das EU-KI-Gesetz explizite Anforderungen an die Datengovernance für Hochrisiko-KI ein. Artikel 10 legt Anforderungen an Qualität und Governance von Trainings-, Validierungs- und Testdaten fest, und die vollständigen Pflichten für Hochrisikosysteme (einschließlich der Artikel 10 bis 12) gelten ab dem 2. August 2026, wodurch Herkunftsnachweis, Provenienz und Dataset-Dokumentation innerhalb der Governance-Ebenen von Lakehouse und Data Lake an Priorität gewinnen.
Auch Compliance-Treiber im öffentlichen Sektor und im grenzüberschreitenden Bereich erhöhen die grundlegenden Erwartungen an Sicherheit und Informationsmanagement bei groß angelegten Datenplattformen. In den Vereinigten Staaten verstärken die OMB-Memoranden M-25-04 (Leitlinien für das Geschäftsjahr 2025 zu Anforderungen an Informationssicherheit und Datenschutzmanagement des Bundes gemäß FISMA) und M-25-05 (Umsetzungsleitlinien für Phase 2 des Foundations for Evidence-Based Policymaking Act von 2018 zu offenem Datenzugang und -management) die Erwartungen an einen disziplinierten Umgang mit Daten, Zugriffskontrollen und Governance-Nachweise. Diese entsprechen weitgehend den Mustern zur Katalogisierung, Richtliniendurchsetzung und prüfbereiten Speicherung, die in Unternehmens-Data-Lakes verwendet werden. Im Vereinigten Königreich verlangt die im Mai 2026 veröffentlichte Richtlinie zum Management von Datenbeständen der Regierung von den Ministerien, Datenbestände zu identifizieren, zu erfassen und zentral an den Government Digital Service zu melden, was die Bedeutung von Auffindbarkeit und standardisierten Dateninventaren erhöht und Betriebsmodelle mit Unternehmenskatalog und Data Lake begünstigt.
Wettbewerbslandschaft
Der Data-Lake-Markt ist mäßig fragmentiert. Hyperscaler – AWS, Microsoft Azure, Google Cloud – dominieren die Infrastruktur und nutzen globale Regionen und integrierte Governance. Spezialisierte Plattformen wie Databricks und Snowflake heben sich durch Leistung, Notebook-Integration und Lakehouse-Vollständigkeit ab. Open-Source-Gemeinschaften steuern Iceberg, Delta und Hudi und geben Käufern Formatoptionen, die die Anbieterabhängigkeit lockern.
Strategische Übernahmen gestalten Wertschöpfungsketten um. Databricks erwarb Tabular im Jahr 2024, um die Iceberg-Herkunft in Delta-Workflows zu integrieren, was auf eine Wette auf universelle Metadaten hindeutet. Fivetran kaufte Census im Jahr 2025 und vereinte Datenaufnahme und Reverse-ETL, um den Aktivierungskreislauf zu schließen. Das Clumio-Geschäft von Commvault im Jahr 2024 fügt Ransomware-Wiederherstellungs-Snapshots für S3-Data-Lakes hinzu. Diese Schritte deuten auf eine Zukunft hin, in der integrierte Suiten Aufnahme, Governance, Schutz und Aktivierung umfassen.
Trotz der Stärke der Hyperscaler erfassen die fünf größten Anbieter etwa 55 % der Gesamtausgaben, was Raum für Innovatoren lässt, die sich auf Kostenoptimierung, Cloud-übergreifende Abfragebeschleunigung und branchenspezifische Governance-Pläne spezialisieren. KI-gestützte Datenqualitätsbeobachtung und souveräne Cloud-Governance sind zwei aufkommende Lücken, die wahrscheinlich neue Marktteilnehmer anziehen werden.
Marktführer der Data-Lake-Branche
Microsoft Corporation
Amazon.com Inc.
Capgemini SE
Oracle Corporation
Teradata Corporation
- *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert
Data-Lake-Markt
- Amazon Web Services (AWS)
- Microsoft Corporation
- Google LLC
- IBM Corporation
- Oracle Corporation
- Snowflake Inc.
- SAP SE
- Cloudera Inc.
- Teradata Corporation
- Informatica Inc.
- Databricks Inc.
- Hitachi Vantara LLC
- Dell Technologies Inc.
- Atos SE
- SAS Institute Inc.
- Zaloni Inc.
- Dremio Corporation
- Qubole Inc.
- Talend SA
- HPE (Ezmeral)

Marktchancen und Zukunftsaussichten
Compliance-getriebene Governance und plattformübergreifende Interoperabilität erweitern den kommerziellen Spielraum rund um Data Lakes über Speicherung und Abfrage hinaus, insbesondere in regulierten KI- und Datensouveränitätsumgebungen. Das EU-KI-Gesetz führt ab dem 2. August 2026 durchsetzbare Datengovernance-Pflichten für Hochrisiko-KI ein (einschließlich Artikel 10). Dies schafft Nachfrage nach Lösungen, die Dataset-Provenienz, Bias-Bewertungsabläufe, Herkunftsnachweise sowie Kontrollen über Datenaufbereitung und Dokumentation operationalisieren. Infolgedessen tendieren Käufer zu Lakehouse- und Open-Table-Implementierungen, bei denen Governance-Richtlinien, Kataloge und feingranulare Berechtigungen geprüft werden können, und Anbieter sowie Dienstleister können KI-Governance-fertige Referenzarchitekturen, kontrollierte Veröffentlichung von Datenprodukten und verwaltete Compliance-Operationen bündeln.
Die Umsetzung im Telekommunikationssektor weist zudem auf aktive Investitionspfade hin, die mit einheitlichen Datenfundamenten für KI-gesteuerte Betriebsabläufe verbunden sind. Im April 2026 implementierte IBM für Tata Play Fiber ein KI-fähiges Data Lakehouse mit IBM watsonx, um fragmentierte Daten aus Kundenservice, Marketing, Finanzen und Netzbetrieb zusammenzuführen. Im Juni 2026 schlossen Nokia und Databricks einen gemeinsamen Proof of Concept für eine einheitliche, substratunabhängige Datenplattform zur Unterstützung KI-gesteuerter autonomer Netzwerke ab. Zusammen unterstreichen diese Programme Chancen rund um die automatisierte Erstellung von Datenprodukten, Data-Fabric- und Mesh-Overlays sowie Compute-to-Data-Muster, die die Bewegung sensibler Daten reduzieren und gleichzeitig die Wiederverwendung verbessern. Da offene Tabellenformate wie Apache Iceberg und Delta Lake zum Beschaffungsstandard für Portabilität werden, können sich Anbieter durch Interoperabilitätsfunktionen, Governance-Automatisierung, die Datensumpf-Ergebnisse verhindert, und dienstleistungsgetriebene Modernisierung für Hybrid- und Multi-Cloud-Umgebungen differenzieren, in denen Datenresidenz und Kostenkontrolle die Architekturentscheidungen prägen.
Recent Industry Developments in Data-Lake-Markt
- Juni 2026: AWS aktualisierte Lake Formation, um das Lesen und Schreiben zugrunde liegender Amazon-S3-Datendateien für im AWS Glue Data Catalog registrierte Tabellen zu ermöglichen und die Berechtigungen über SQL- und dateibasierte Zugriffsmuster hinweg anzugleichen. Die Änderung unterstützt gemischte Betriebsmodelle mit mehreren Engines, bei denen unterschiedliche Tools mit denselben Data-Lake-Tabellen interagieren, was die Anforderungen an eine einheitliche Governance erhöht und Reibungsverluste bei Multi-Tool-Data-Lake-Implementierungen verringert.
- Februar 2026: Microsoft kündigte die allgemeine Verfügbarkeit der Interoperabilität zwischen OneLake und Snowflake an, die die native Speicherung von durch Snowflake verwalteten Apache-Iceberg-Tabellen in OneLake ermöglicht. Dies stärkt Iceberg als neutrale Tabellenschicht und hilft Unternehmen, Duplikate zu reduzieren, indem Daten in einer gemeinsamen Lake-Speicherbasis gehalten werden, während mehrere Analyseplattformen darauf arbeiten können.
- Mai 2025: Fivetran übernahm Census und erweiterte damit die Reverse-ETL-Funktionen, die Daten in operativen Systemen aktivieren. Die Übernahme verbindet Ingestion und Aktivierung zu einem vollständigeren Datenlebenszyklus und erhöht die strategische Rolle von Data-Lake- und Lakehouse-Umgebungen als geregelte Quelle für nachgelagerte Geschäftsanwendungen.


Data-Lake-Markt Berichtsumfang und Forschungsmethodik
Marktdefinition und Abdeckung
Dieser Markt umfasst Umsätze aus Data-Lake-Software und zugehörigen Dienstleistungen, die dabei helfen, große Mengen strukturierter und unstrukturierter Daten in Cloud-, On-Premise- und Hybridumgebungen zu speichern, zu organisieren und zu analysieren.
Ausschlüsse vom Anwendungsbereich: Wir schließen allgemeine, reine Hardwareausgaben sowie umfassendes IT-Outsourcing aus, das nicht direkt mit der Implementierung oder dem Betrieb einer Data-Lake-Umgebung verbunden ist.
Übersicht der Segmentierung
- Nach Angebot
- Lösungen
- Datenerkennung und Katalogisierung
- Datenintegration und ETL/ELT
- Analyse- und Visualisierungstools
- Governance- und Sicherheitsplattformen
- Dienstleistungen
- Professionelle Dienstleistungen (Beratung, Integration)
- Verwaltete Dienste
- Lösungen
- Nach Bereitstellung
- Cloud
- Öffentliche Cloud
- Private Cloud
- Hybrid/Multi-Cloud
- Vor Ort
- Cloud
- Nach Unternehmensgröße
- Großunternehmen
- Kleine und mittlere Unternehmen (KMU)
- Nach Geschäftsfunktion
- Betrieb und Lieferkette
- Finanzen und Risiko
- Vertrieb und Marketing
- Personalwesen
- Nach Endnutzerbranche
- IT und Telekommunikation
- BFSI
- Gesundheitswesen und Biowissenschaften
- Einzelhandel und E-Commerce
- Fertigung und Industrie
- Medien und Unterhaltung
- Regierung und öffentlicher Sektor
- Energie und Versorgungsunternehmen
- Sonstige (Bildung, Gastgewerbe)
- Nach Geografie
- Nordamerika
- Vereinigte Staaten
- Kanada
- Mexiko
- Südamerika
- Brasilien
- Argentinien
- Chile
- Peru
- Rest von Südamerika
- Europa
- Deutschland
- Vereinigtes Königreich
- Frankreich
- Italien
- Spanien
- Rest von Europa
- Asien-Pazifik
- China
- Japan
- Indien
- Australien
- Neuseeland
- Rest von Asien-Pazifik
- Naher Osten
- Vereinigte Arabische Emirate
- Saudi-Arabien
- Türkei
- Rest des Nahen Ostens
- Afrika
- Südafrika
- Rest von Afrika
- Nordamerika
Datenquellen, Marktdimensionierung und Validierung
Schreibtischrecherche
Die Schreibtischarbeit beginnt mit dem Aufbau einer einfachen Faktenbasis rund um Unternehmensdatenwachstum, Cloud-Einführung und Datengovernance-Anforderungen, da diese Faktoren eng mit der Einführung von Data Lakes in IT-Abteilungen zusammenhängen. Wir beziehen uns auf öffentliche Quellen wie das US Bureau of Labor Statistics für IT-Ausgabensignale, das US Census Bureau für Unternehmenszahlen nach Branche sowie OECD- und Weltbank-Indikatoren für Vergleiche der digitalen Wirtschaft über verschiedene Regionen hinweg.
Wir werten außerdem technische Indikatoren und Adoptionssignale aus Quellen wie NIST-Publikationen, begutachteten Fachzeitschriften zu Datenmanagement-Architekturen und öffentlichen Beschaffungsportalen aus, die Ausschreibungssprache rund um Analyseplattformen und Datenmodernisierung zeigen. Geschäftsberichte von Unternehmen, Notizen zu Earnings Calls und Investorenpräsentationen helfen uns, die Produktverpackung (Software versus Dienstleistungen) zu verstehen sowie wie Cloud- und Abonnementumsätze erfasst werden. Wo erforderlich, nutzen wir kostenpflichtige Abonnements für Unternehmensfinanzdaten und -informationen, Nachrichten und Finanzdaten sowie Patentdatenbanken, um Zeitpläne und Eigentumsverhältnisse zentraler Plattformfähigkeiten abzugleichen. Die hier aufgeführten Quellen sind beispielhaft, und viele weitere öffentliche Referenzen wurden verwendet, um Eingaben zu erfassen, zu validieren und zu klären.
Primärinterviews und Umfragen
Primärdaten werden verwendet, um Adoptionsannahmen und Preisspannen mit Personen zu testen, die Data-Lake-Umgebungen kaufen, einführen und betreiben, darunter IT-Führungskräfte, Data-Engineering-Manager, Cloud-Architekten und Servicepartner. Für eine globale Sichtweise verteilen wir Gespräche über die wichtigsten Nachfrageregionen und überprüfen anschließend größere Abweichungen mit Nachfragen, sodass das endgültige Modell typische Unternehmenseinführungen widerspiegelt.
Verteilung der Befragten der primären Forschungsarbeit
| Unternehmenstyp | Position der Befragten | Region |
|---|---|---|
| Top-Tier: 35 % | CXOs: 16 % | APAC: 43 % |
| Mid-Tier: 44 % | Funktions-/Bereichsleiter: 25 % | EMEA: 37 % |
| Kleinere Akteure: 21 % | Manager: 59 % | Amerika: 20 % |
Marktdimensionierung & Prognose
Die Dimensionierung erfolgt mittels eines Top-Down-Ansatzes, bei dem Ausgabenpools für Unternehmensdatenplattformen nach Regionen rekonstruiert und anschließend anhand von Adoptions- und Migrationsraten für Data-Lake-Anwendungsfälle gefiltert werden. Wir bestätigen die Gesamtsummen durch selektive Bottom-up-Prüfungen, etwa durch Stichproben typischer jährlicher Vertragswerte, die Validierung des Verhältnisses von Lösungen zu Dienstleistungen und die Belastungsprüfung von Volumina durch Kanalgespräche und Implementierungszeitpläne.
Zu den wichtigsten Modelleingaben zählen der Mix aus Cloud- und On-Premise-Bereitstellung, die durchschnittliche Preisentwicklung von Abonnement und Support, Dienstleistungsanteile für Implementierung und verwalteten Betrieb, das mit Analyseprojekten verbundene Workload-Wachstum sowie branchenspezifische Unterschiede in der Adoption über regulierte Sektoren hinweg. Fehlt ein Datenpunkt für ein Land oder eine Branche, füllen wir Lücken mithilfe von Proxy-Indikatoren wie Unternehmenszahlen und Cloud-Reifegrad und passen die Ergebnisse an, nachdem sie mit Primärbefragten überprüft wurden. Bei der Prognose kommt eine Szenarioanalyse zum Einsatz, unterstützt durch regressionsähnliche Sensitivitätsprüfungen der wichtigsten Treiber (Tempo der Cloud-Migration, Datenwachstum und compliance-getriebene Modernisierung), und die Annahmen werden aktualisiert, wenn Experten auf eine klare Verschiebung des Kaufverhaltens hinweisen.
Datenvalidierung & Aktualisierungszyklus
Die Validierung erfolgt durch wiederholte Abgleiche zwischen dem Modell und unabhängigen Signalen, wie der Richtung der regionalen IT-Ausgaben, Wachstumssignalen bei Cloud-Diensten und Veränderungen bei den Prioritäten des Unternehmensdatenmanagements. Ausreißer werden frühzeitig markiert, und die zugrunde liegenden Annahmen werden von einem anderen Analysten überprüft, bevor die Zahlen finalisiert werden, was hilft, vermeidbare Abweichungen zu reduzieren.
Die Arbeit wird jährlich aktualisiert, und Zwischenaktualisierungen werden ausgelöst, wenn wesentliche Ereignisse auftreten, wie große Preisänderungen, bedeutende regulatorische Verschiebungen oder ein klarer Sprung in den Mustern der Cloud-Einführung. Vor der Auslieferung führen wir eine abschließende Prüfung durch, um sicherzustellen, dass aktuelle Entwicklungen berücksichtigt sind, und größere Abweichungen gegenüber früheren Ausgaben werden erklärt und durch kurze erneute Expertengespräche nachgeprüft.
Vergleich der Marktgröße für Data Lakes von Mordor Intelligence mit anderen veröffentlichten Schätzungen
Veröffentlichte Marktgrößen für Data Lakes können sehr unterschiedlich ausfallen, selbst wenn sie ähnliche Käuferbedürfnisse beschreiben, da die Wahl des Anwendungsbereichs nicht immer konsistent ist und die Preislogik nicht immer erläutert wird. Unterschiede zeigen sich auch, wenn eine Schätzung ein anderes Basisjahr zugrunde legt oder ein längeres Prognosefenster verwendet, was ändern kann, was als aktueller Umsatz gezählt wird.
Die Hauptdiskrepanz ergibt sich daraus, ob angrenzende Datenmanagement-Kategorien in die Gesamtsumme eingerechnet werden. In dieser Arbeit erfasst Mordor Intelligence Data-Lake-Lösungen und zugehörige Dienstleistungen, verzichtet aber darauf, umfassendere Data-Warehousing- und allgemeine Analyseplattformen einzubeziehen, es sei denn, diese werden als Teil einer Data-Lake-Umgebung verkauft und bereitgestellt.
Benchmark-Vergleich
| Quelle | Marktgröße | Lücken in der Forschungsmethodik |
|---|---|---|
| Mordor Intelligence | 18,68 Mrd. USD (2025) | |
| Globale Beratungsgesellschaft A | 11,07 Mrd. USD (2025) | Verwendet eine engere Umsatzerfassung im Basisjahr, wodurch Dienstleistungsanteile und Hybridbereitstellungen, die weiterhin bezahlte Plattform- und Integrationsarbeit antreiben, unterzählt werden können. |
| Branchenverlag B | 10,70 Mrd. USD (2025) | Wendet eine andere Komponentenaufteilung an und stützt sich oft auf eine konservativere Umrechnung des Basisjahres in US-Dollar, was die gemeldete Gesamtsumme für 2025 im Vergleich zu Modellen, die Preisgestaltung und Bereitstellungsmix normalisieren, verringern kann. |
Betrachtet man die Tabelle, so erklärt sich die Spanne hauptsächlich dadurch, was innerhalb des Ausgabenpools für Data Lakes gezählt wird und wie Dienstleistungen und Hybrid-Anwendungsfälle im Basisjahr behandelt werden. Indem wir die Eingaben eng an klare Adoptions-, Bereitstellungsmix- und Preisannahmen koppeln, können wir jeden Schritt erklären und die Gesamtsummen bei neuen Marktsignalen überprüfen, ohne das Modell von Grund auf neu aufzubauen.


Im Bericht beantwortete Schlüsselfragen
Warum wechseln Unternehmen von Warehouses zu Lakehouses?
Lakehouses senken die Analyse-TCO um 35–40 % und unterstützen das Training von KI-Modellen auf Rohdaten, während ACID-Leistungsgarantien erhalten bleiben.
Wie groß ist der Data-Lake-Markt im Jahr 2026?
Der Data-Lake-Markt wird im Jahr 2026 auf 22,8 Milliarden USD geschätzt und wird bis 2031 voraussichtlich 61,84 Milliarden USD erreichen.
Welche Region wächst bei der Data-Lake-Einführung am schnellsten?
Asien-Pazifik führt mit einem prognostizierten CAGR von 23,5 % zwischen 2026 und 2031, angetrieben durch rasante digitale Transformation und Investitionen in souveräne Cloud-Infrastrukturen.
Was ist die größte Herausforderung, die Data Lakes daran hindert, Mehrwert zu liefern?
Metadatendrift kann Data Lakes in „Datensümpfe” verwandeln, was Investitionen in automatisierte Kataloge und Herkunftsverfolgung erforderlich macht, um das Vertrauen zu erhalten.
Wie wirken sich offene Tabellenformate auf die Anbieterabhängigkeit aus?
Formate wie Apache Iceberg und Delta Lake ermöglichen Multi-Cloud-Portabilität, indem sie Storage von Compute-Engines entkoppeln und es Teams ermöglichen, dieselben Daten über verschiedene Clouds hinweg abzufragen.
Welche Branche wird voraussichtlich am schnellsten wachsen?
Gesundheitswesen und Biowissenschaften werden bis 2031 voraussichtlich mit einem CAGR von 25,6 % wachsen und Data Lakes für Präzisionsmedizin und Echtzeit-Patientenanalysen nutzen.
Seite zuletzt aktualisiert am:



