
Taille et parts du marché de la préparation des données
VUE D’ENSEMBLE DU MARCHÉ
| Période d'étude | 2020 - 2031 |
|---|---|
| Taille du Marché (2026) | 8.05 Milliards de dollars |
| Taille du Marché (2031) | 16.84 Milliards de dollars |
| Taux de croissance (2026 - 2031) | 15.92 % |
| Marché à la Croissance la Plus Rapide | Asie-Pacifique |
| Plus Grand Marché | Amérique du Nord |
| Concentration du Marché | Moyen |
Acteurs majeurs *Avis de non-responsabilité : les principaux acteurs sont triés sans ordre particulier Image © Mordor Intelligence. La réutilisation nécessite une attribution sous CC BY 4.0. | |
Analyse du marché de la préparation des données par Mordor Intelligence
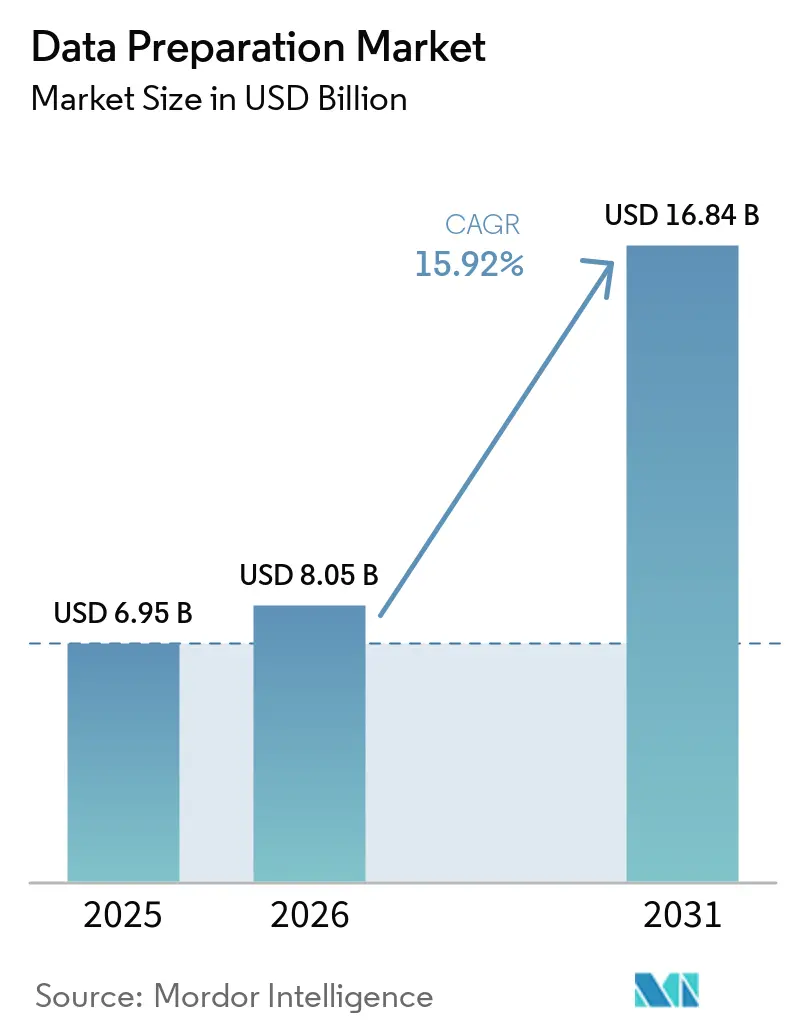
La taille du marché de la préparation des données devrait passer de 6,95 milliards USD en 2025 à 8,05 milliards USD en 2026 et devrait atteindre 16,84 milliards USD d'ici 2031, avec un CAGR de 15,92 % sur la période 2026-2031. Cette expansion reflète la montée en puissance des infrastructures prêtes pour l'IA, alors que les entreprises intègrent l'IA générative dans leurs flux de travail quotidiens ; le taux d'adoption a atteint 83 % des organisations en Chine et des déploiements en production complète dans 24 % des entreprises aux États-Unis[1]. La prolifération des programmes de gouvernance des données, désormais présents dans 71 % des organisations contre 60 % en 2023, renforce les dépenses consacrées aux outils systématiques de préparation des données.
Principaux enseignements du rapport
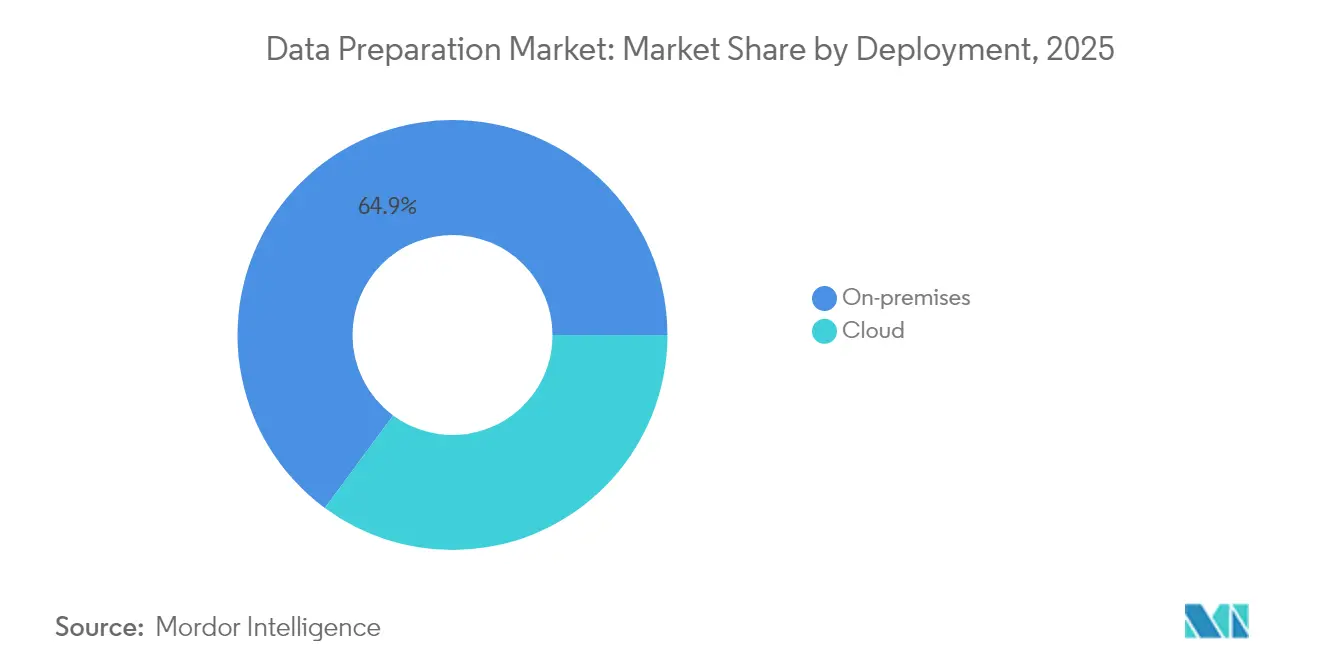
- Par déploiement, les plateformes sur site ont détenu 64,88 % des parts du marché de la préparation des données en 2025 ; les modèles cloud devraient se développer à un TCAC de 17,12 % jusqu'en 2031.
- Par taille d'entreprise, les grandes organisations ont dominé avec 68,05 % des parts de revenus en 2025, tandis que les PME progressent à un TCAC de 17,62 % jusqu'en 2031.
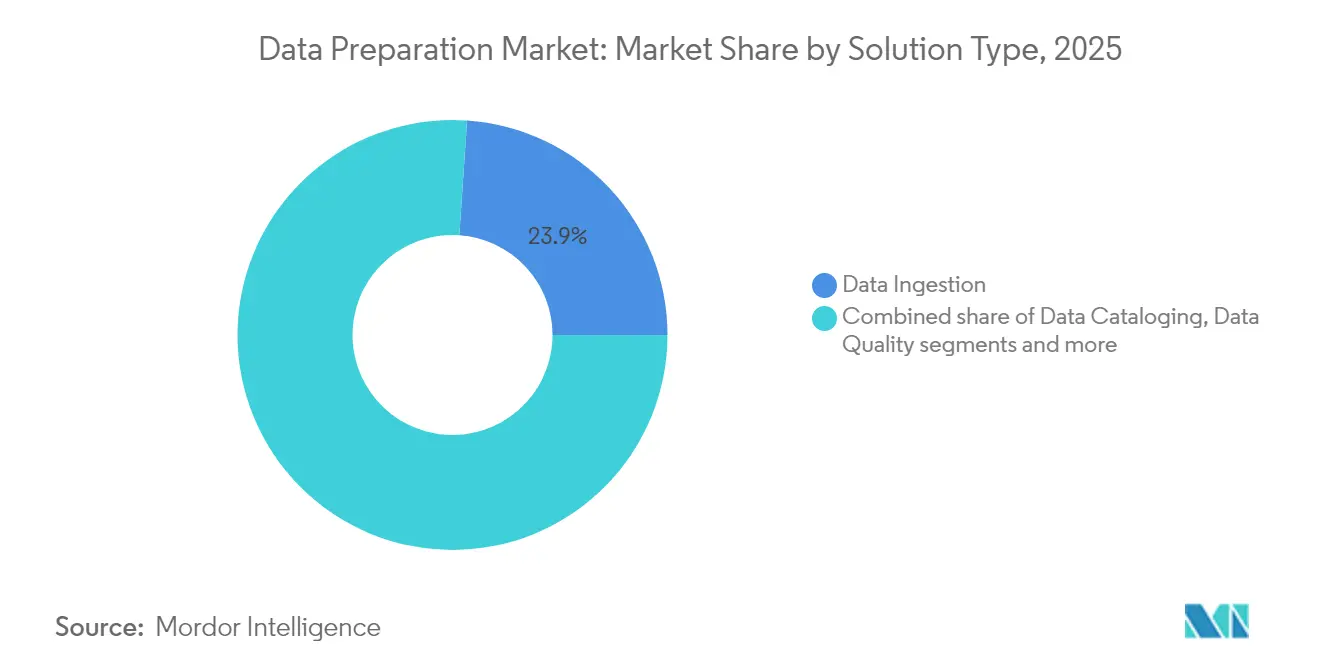
- Par type de solution, l'ingestion de données a capturé 23,92 % des revenus de 2025 ; les solutions de gouvernance des données devraient croître à un TCAC de 16,74 % jusqu'en 2031.
- Par secteur d'utilisation final, l'informatique et les télécommunications ont représenté 22,35 % des ventes de 2025 ; la santé et les sciences de la vie affichent le TCAC le plus rapide de 16,31 % jusqu'en 2031.
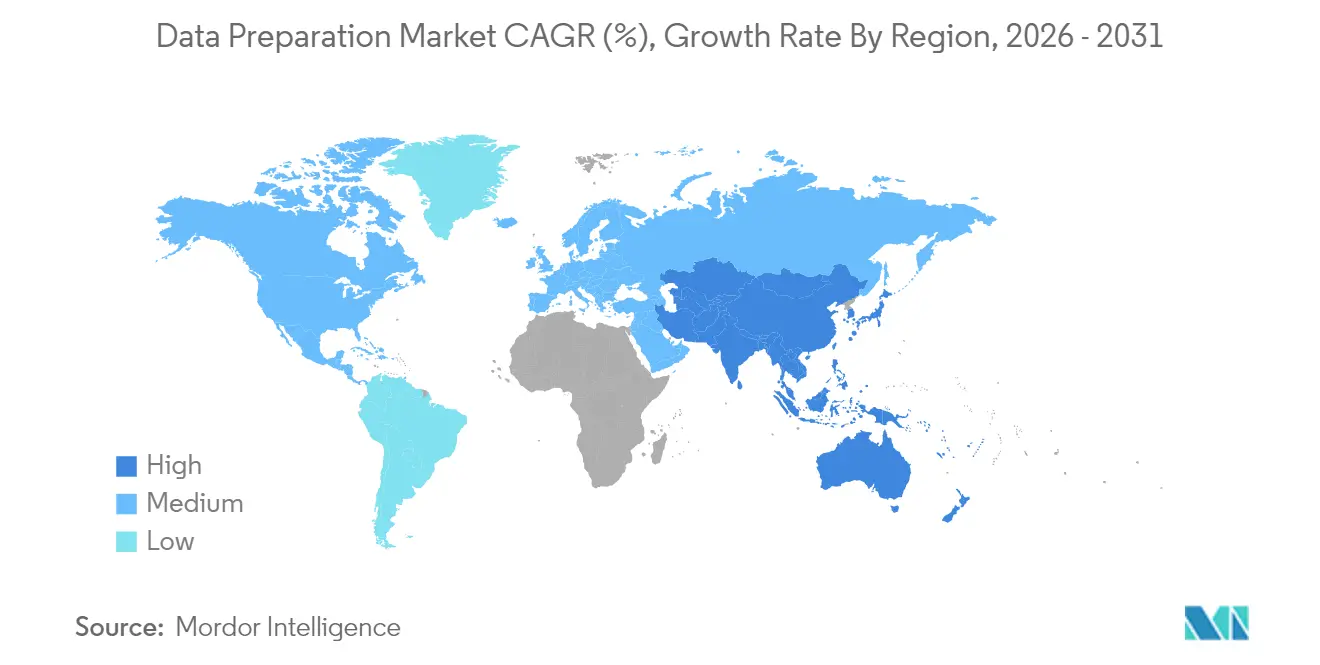
- Par géographie, l'Amérique du Nord a commandé 36,62 % des parts de revenus en 2025 ; l'Asie-Pacifique affiche les perspectives de TCAC les plus solides à 16,98 % jusqu'en 2031.
Remarque : Les chiffres de la taille du marché et des prévisions de ce rapport sont générés à l’aide du cadre d’estimation propriétaire de Mordor Intelligence, mis à jour avec les données et analyses les plus récentes disponibles en 2026.
Tendances et Analyses du Marché
Analyse de l'impact des moteurs*
| Moteur | (~) % d'impact sur les prévisions de TCAC | Pertinence géographique | Horizon temporel d'impact |
|---|---|---|---|
| Outils d'analyse en libre-service à faible code / sans code | +3.2% | Mondial, porté par l'Amérique du Nord et l'Europe | Moyen terme (2 à 4 ans) |
| Adoption du cloud par les équipes d'analyse des PME | +2.8% | Mondial, avec la croissance la plus élevée en Asie-Pacifique | Court terme (≤ 2 ans) |
| Copilotes d'IA générative intégrés aux flux de travail de préparation des données | +3.5% | Amérique du Nord et Asie-Pacifique en tête, extension vers l'Europe | Moyen terme (2 à 4 ans) |
| Regroupement des fournisseurs en suites de tissu de données | +2.1% | Mondial, accent sur les grandes entreprises dans les marchés développés | Long terme (≥ 4 ans) |
| Pipelines de préparation des données par IA spécifiques à un secteur vertical | +2.4% | Amérique du Nord et Europe, expansion vers l'Asie-Pacifique | Moyen terme (2 à 4 ans) |
| Réglementation sur les clouds souverains et rapatriement | +1.8% | Asie-Pacifique et Europe, accent réglementaire | Long terme (≥ 4 ans) |
| Source: Mordor Intelligence | |||
Accélération du passage aux outils d'analyse en libre-service à faible code / sans code
Les interfaces à faible code redéfinissent le marché de la préparation des données en permettant aux spécialistes métier de construire des pipelines via des conceptions par glisser-déposer plutôt que par des scripts. La préparation des données BigQuery de Google Cloud illustre cette tendance, offrant des conseils basés sur l'IA qui nettoient, profilent et transforment les données à l'aide d'invites en langage naturel[2]. Cette approche réduit la dépendance aux ingénieurs de données rares, raccourcit les cycles de développement et aligne la livraison des analyses avec l'expertise métier. L'augmentation par l'IA générative se répand rapidement ; les prévisions du secteur suggèrent que presque toutes les plateformes de BI intégreront l'IA générative d'ici 2026. L'adoption nécessite cependant une gouvernance rigoureuse pour maintenir les flux créés par les utilisateurs métier en conformité avec les normes de qualité et de sécurité de l'entreprise.
Forte adoption du cloud parmi les équipes d'analyse des PME
Les PME développent des pipelines natifs du cloud pour combler les écarts de capacité avec leurs concurrents plus importants, stimulant une demande incrémentale en Asie-Pacifique où 60 % des entreprises prévoient de mettre en œuvre des modèles de langage IA d'ici 2025. L'élasticité du cloud et la tarification à la consommation permettent aux petites entreprises d'éviter les dépenses en capital tout en accédant à des fonctions avancées de préparation des données. Des recherches au Royaume-Uni montrent que moins de 1 % des PME exploitent aujourd'hui l'analyse des mégadonnées, soulignant le potentiel de croissance à mesure que les obstacles liés aux coûts et à la complexité diminuent. Les pénuries de compétences persistent néanmoins ; les fournisseurs de services gérés interviennent pour configurer les pipelines et assurer la conformité, notamment autour des règles émergentes de localisation des données.
Intégration de copilotes d'IA générative dans les flux de travail de préparation des données
Soixante-quinze pour cent des organisations ont l'intention de financer l'IA générative dans les douze prochains mois, faisant des copilotes IA un élément central des stratégies de transformation. Les copilotes automatisent le profilage fastidieux, suggèrent des jointures optimales et signalent les anomalies, comprimant les 94 % du temps de projet traditionnellement consacrés au nettoyage. L'interaction en langage naturel abaisse le seuil d'expertise, bien que les résultats automatisés doivent encore passer par des contrôles de gouvernance qui suivent la traçabilité et valident l'exactitude. La dynamique d'investissement est la plus forte dans les secteurs à forte intensité de données tels que les télécommunications et la finance, où même des gains de temps marginaux génèrent un retour sur investissement significatif.
Regroupement par les fournisseurs des modules de préparation des données dans des suites de tissu de données plus larges
Des acquisitions telles que Salesforce-Informatica illustrent la consolidation vers des tissus unifiés regroupant catalogue, qualité, traçabilité et orchestration. Cette stratégie simplifie la charge d'intégration en offrant un espace de travail de bout en bout, de l'ingestion à la BI, améliorant la cohérence dans les environnements multi-cloud. Cependant, cette approche tout-en-un accroît les risques de dépendance vis-à-vis d'un fournisseur et limite l'agilité plug-and-play. Les entreprises évaluent des normes telles qu'OpenLineage et Apache Arrow pour préserver leurs options.
Analyse de l'impact des freins*
| Frein | (~) % d'impact sur les prévisions de TCAC | Pertinence géographique | Horizon temporel d'impact |
|---|---|---|---|
| Pénurie de compétences pour la configuration de la gouvernance des données | -2.3% | Mondial, aiguë dans les marchés émergents | Moyen terme (2 à 4 ans) |
| Coût total de possession élevé des pipelines de données multi-cloud | -1.9% | Amérique du Nord et Europe | Court terme (≤ 2 ans) |
| Escalade des pénalités liées à la souveraineté des données | -1.4% | Asie-Pacifique et Amérique latine | Moyen terme (2 à 4 ans) |
| Les tâches à forte intensité de calcul font face à des quotas carbone | -1.1% | Europe et Amérique du Nord | Long terme (≥ 4 ans) |
| Source: Mordor Intelligence | |||
Pénurie de compétences pour la configuration complexe de la gouvernance des données
Près d'un tiers des directeurs des systèmes d'information citent la complexité de la gestion des données comme un obstacle critique, et les pénuries de spécialistes en gouvernance retardent le déploiement de pipelines évolutifs[3]. Le défi s'intensifie là où des législations telles que la règle californienne sur la divulgation climatique imposent la capture automatisée des émissions de portée 1 à 3. Les marchés émergents font face à des pénuries plus profondes, les programmes académiques étant à la traîne, poussant les entreprises vers des consultants externes et des contrats de services gérés qui gonflent les budgets de déploiement.
Coût total de possession élevé pour les pipelines de données multi-cloud
La majorité des programmes multi-cloud manquent leurs objectifs de retour sur investissement, les dépenses d'intégration, de réplication et de surveillance augmentant plus vite que prévu. Le stockage spécifique à chaque région imposé par les lois de localisation gonfle davantage les dépenses, les entreprises dupliquant leur infrastructure dans plusieurs zones. Les frais opérationnels peuvent dépasser 25 % des budgets cloud agrégés une fois les outils de sécurité et de traçabilité ajoutés, poussant les acheteurs du marché intermédiaire à trouver un compromis entre l'élégance architecturale et l'accessibilité financière.
*Nos prévisions considèrent les impacts des moteurs et des contraintes comme directionnels et non additifs. Les prévisions d'impact reflètent la croissance de référence, les effets de composition et les interactions entre variables.
Analyse des segments
Par déploiement :
l'accélération du cloud équilibre la domination sur siteLa taille du marché de la préparation des données pour les plateformes sur site s'est élevée à 4,51 milliards USD en 2025, représentant 64,88 % des parts du marché de la préparation des données, reflet de la demande des entreprises pour un contrôle direct face à des règles de localisation plus strictes. La loi vietnamienne sur les données et les règles indiennes de protection des données personnelles numériques renforcent les modèles sur site et de cloud souverain qui maintiennent les données sensibles à l'intérieur des frontières nationales. Les services cloud, bien que plus modestes, devraient progresser à un taux composé de 17,12 % jusqu'en 2031, les PME et les unités nativement numériques privilégiant l'agilité. En Amérique du Nord, les architectures hybrides prédominent, fusionnant des clusters locaux pour les données réglementées avec des réservoirs hyperscale pour les charges de travail à moindre risque. Les fournisseurs cloud répondent avec des instances régionales dédiées et un contrôle des clés de chiffrement pour atténuer les craintes de conformité, élargissant l'adoption au-delà des pôles technologiques traditionnels à mesure que les villes de taille moyenne bénéficient de connexions fibre directes.
Le calcul économique dépend de la variabilité des charges de travail : les lots ETL stables et les tâches d'enrichissement prévisibles restent sur site en raison de l'amortissement des licences, tandis que l'inférence IA par rafales et les environnements sandbox des développeurs citoyens migrent vers des clouds à la consommation. Plus de la moitié des multinationales devraient exploiter des instances de cloud souverain d'ici 2029, créant une demande de mise en application transparente des politiques sur les nœuds privés, publics et périphériques. Les fournisseurs mettent désormais l'accent sur des plans de contrôle unifiés qui propagent les règles de qualité des données et les graphes de traçabilité quel que soit le substrat.



Par taille d'entreprise :
les PME propulsent la croissance future malgré la domination des grandes entreprisesLes grandes entreprises ont généré 4,73 milliards USD de revenus en 2025, soit 68,05 % du marché de la préparation des données, soutenues par des équipes de gouvernance dédiées et des empreintes mondiales. Leurs dépenses favorisent les offres groupées de plateformes qui intègrent catalogue, traçabilité et observabilité dans les tissus de données existants. À l'inverse, les PME ont contribué à hauteur de 2,22 milliards USD mais surpasseront les autres cohortes avec un TCAC de 17,62 %, portant la taille du marché de la préparation des données pour les solutions PME à un montant projeté de 5,02 milliards USD d'ici 2031. La facturation à la consommation et la détection automatisée des schémas réduisent les obstacles en capital, permettant aux détaillants régionaux, aux fintechs et aux start-ups SaaS d'atteindre la parité avec les acteurs établis.
Une enquête du Small Business Institute Journal montre que 70 % des PME américaines reconnaissent la valeur de l'analyse, mais seule une minorité dispose de talents internes pour exécuter des pipelines de bout en bout. Les établis de travail cloud à faible code et les écosystèmes de services gérés comblent les lacunes, tandis que les associations professionnelles proposent des formations modulaires pour accélérer l'utilisation par les utilisateurs citoyens. Des défis persistent dans l'élaboration de cadres politiques correspondant aux obligations émergentes des lois sur l'IA, créant des opportunités pour les partenaires de distribution spécialisés dans les couches de conformité.
Par type de solution :
la gouvernance gagne en vitesse tandis que l'ingestion conserve la première placeL'ingestion de données a conservé une part dominante de 23,92 % des revenus de 2025, soulignant le besoin fondamental de collecter des flux structurés, semi-structurés et non structurés pour un traitement en aval. Cependant, les modules de gouvernance afficheront le TCAC le plus rapide à 16,74 %, reflétant le pivot réglementaire vers des divulgations ESG et d'éthique de l'IA prêtes pour l'audit. La taille du marché de la préparation des données pour les outils de gouvernance devrait atteindre 3,74 milliards USD d'ici 2031. Les catalogues intégrés pilotés par les métadonnées attachent désormais des contrôles de politique automatisés, faisant des visualisations de traçabilité un élément central de la gestion des risques. Les générateurs de données synthétiques intègrent des protections de la vie privée tout en élargissant les ensembles d'entraînement de l'IA, aidant les entreprises à respecter les exigences de minimisation sans dégrader la précision des modèles.
Les catégories adjacentes — qualité, transformation, enrichissement — se regroupent en couches d'interface utilisateur uniques. Les feuilles de route produit privilégient les suggestions contextuelles qui apprennent les règles métier préférées et proposent des modèles de standardisation. Les fournisseurs courtisent les écosystèmes de partenaires pour packager des modèles verticaux, tels que les normalisateurs HL7-FHIR pour la santé ou les mappeurs de protocole FIX pour la finance, augmentant le délai de valorisation et renforçant les coûts de changement.

Par secteur d'utilisation final :
la santé progresse rapidement tandis que l'informatique et les télécommunications restent en têteL'informatique et les télécommunications ont enregistré 1,55 milliard USD en 2025, soit 22,35 % du marché de la préparation des données, alimentés par les déploiements 5G qui génèrent de la télémétrie nécessitant un nettoyage et un enrichissement rapides. Les opérateurs s'appuient sur l'IA pour optimiser l'utilisation du réseau et prédire le désabonnement, stimulant les dépenses en automatisation de pipelines à haut débit. La santé et les sciences de la vie, à 1 018 millions USD en 2025, progresseront le plus rapidement avec un TCAC de 16,31 % à mesure que les hôpitaux numérisent les parcours patients et que les entreprises pharmaceutiques orchestrent des ensembles de données multi-omiques pour la découverte de médicaments. Le secteur de la préparation des données fait face à des stipulations strictes de la loi HIPAA, du RGPD et de la prochaine loi européenne sur l'IA qui élèvent les modules de gouvernance au rang d'éléments indispensables.
Les secteurs de la banque, des services financiers et de l'assurance (BFSI) adoptent l'IA générative pour la détection des fraudes et les conseils hyper-personnalisés — la Chine enregistre déjà 83 % d'utilisation organisationnelle — mettant fortement l'accent sur l'explicabilité et la traçabilité pour satisfaire les conseils de surveillance. Les détaillants déploient l'enrichissement des graphes clients pour alimenter les API de recommandation et mesurer les émissions de portée 3, reliant les enregistrements transactionnels aux audits des fournisseurs pour répondre aux engagements de durabilité émergents. Les programmes gouvernementaux exploitent les portails de données ouvertes et les tableaux de bord internes pour des politiques fondées sur des données probantes, bien que les plafonds budgétaires et les cycles d'approvisionnement allongent les délais des projets.
Analyse géographique
Marché de la préparation des données en Amérique du Nord
Les dépenses de 2,54 milliards USD de l'Amérique du Nord en 2025 ont reflété une part de marché de 36,62 % dans la préparation des données, résultat d'une expérimentation précoce de l'IA et de denses écosystèmes de fournisseurs. La loi californienne sur la divulgation climatique oblige les entreprises dont le chiffre d'affaires dépasse 1 milliard USD à publier leurs émissions de portées 1 à 3, renforçant la demande d'outils de gouvernance à travers le continent. Les multinationales dont le siège est établi ailleurs mais qui sont actives aux États-Unis doivent également se conformer à ces obligations, étendant ainsi leur influence au-delà des frontières. Le Canada fait progresser des cadres parallèles à travers la Loi sur la protection de la vie privée des consommateurs du projet de loi C-27, tandis que les propositions mexicaines de localisation des données suscitent des plans d'architecture en nuage hybride pour les chaînes d'approvisionnement maquiladora transfrontalières. L'orientation des investissements dans la région a pivoté des capacités initiales d'ingestion vers l'observabilité avancée et la remédiation automatisée, réduisant ainsi la charge opérationnelle.
Marché de la préparation des données en Asie-Pacifique
L'Asie-Pacifique est la région qui progresse le plus rapidement, avec une expansion annuelle de 16,98 % alors que la croissance du cloud public dépasse celle des autres régions. L'adoption à 83 % de l'IA générative en Chine se manifeste par une modernisation agressive des pipelines, tandis que la Corée du Sud et le Japon allouent des fonds nationaux dédiés à l'IA pour la numérisation des dossiers de santé et les programmes d'usines intelligentes. La loi vietnamienne sur les données et les règles DPDP indiennes déclenchent des couches de résidence des données au sein des infrastructures des multinationales, augmentant les déploiements en périphérie sur site et stimulant la demande de moteurs de politique intégrés. Les entreprises australiennes font face à de nouvelles obligations en matière de sécurité des infrastructures critiques qui exigent une détection des anomalies en temps réel dans les étapes amont de préparation des données. Par ailleurs, les subventions de l'IMDA de Singapour poussent les PME vers les services en nuage, renforçant l'élan du marché de masse dans la région.
Marché de la préparation des données en Europe
L'Europe affiche une croissance stable à deux chiffres intermédiaires, les mandats ESG stimulant les investissements dans des pipelines « prêts pour le reporting ». La directive européenne sur la publication d'informations en matière de durabilité des entreprises oblige environ 50 000 entreprises à enregistrer leurs indicateurs de gaz à effet de serre selon des taxonomies cohérentes, élevant les outils de catalogue de données et de qualité des données à l'ordre du jour des dirigeants. L'Allemagne et la France sont en tête des dépenses, bien que la dynamique s'accélère en Italie et en Espagne grâce aux subventions du Mécanisme pour la reprise et la résilience qui financent les projets de transition numérique. La loi européenne sur l'IA exige la transparence, la surveillance des biais et les journaux de supervision humaine, approfondissant le besoin d'archives de traçabilité sécurisées couvrant les nœuds périphériques et les zones des hyperscalers. Les États d'Europe de l'Est renforcent leurs capacités de cloud local pour conserver les données des citoyens sur le territoire national, encourageant les partenariats entre les opérateurs télécoms régionaux et les hyperscalers mondiaux.
Analyse de la chaîne de valeur
La chaîne de valeur de la préparation des données commence par les sources de données amont, notamment les applications d'entreprise telles que l'ERP/CRM, les bases de données opérationnelles, l'IoT/télémétrie, les journaux, les documents et les jeux de données tiers, ainsi que l'infrastructure qui les stocke et les traite, telle que les plateformes de données sur site et les entrepôts cloud et le stockage lakehouse. L'ingestion et la connectivité des données constituent le premier goulot d'étranglement d'exécution, où les connecteurs gérés, la gouvernance des API et les schémas de capture des changements de données déterminent la rapidité avec laquelle les équipes peuvent intégrer de nouvelles sources et maintenir la stabilité des pipelines. Les évolutions récentes des plateformes vers des bibliothèques de connecteurs plus vastes, par exemple l'extension de Databricks Lakeflow Connect à plus de 100 connecteurs natifs gérés en juin 2026, témoignent d'une demande soutenue visant à réduire les intégrations tierces fragiles et la charge de maintenance continue.
Les étapes intermédiaires couvrent le profilage, le nettoyage, la transformation, l'enrichissement et la capture de métadonnées, y compris le catalogue, la traçabilité et les politiques, qui convertissent les données brutes en actifs prêts pour l'analyse destinés aux charges de travail BI, ML et GenAI en aval. La préparation assistée par IA s'intègre de plus en plus comme une capacité transversale dans les suites logicielles ; par exemple, Microsoft Research a publié Data Formulator 0.7 en mai 2026, une approche open source alimentée par l'IA visant à rationaliser les transformations et à réduire la manipulation manuelle répétitive des données, tandis que les contrôles de gouvernance et de qualité fonctionnent comme des fonctions de filtrage pour les cas d'usage réglementés. Les acteurs en aval incluent les outils d'analyse et de visualisation, les plateformes ML, les places de marché de produits de données et les partenaires de services gérés qui opérationnalisent les pratiques DataOps (versionnement, CI/CD, observabilité) et les contrôles de conformité dans des environnements hybrides et de cloud souverain, avec une distribution principalement via des abonnements SaaS, des places de marché d'hyperscalers et des offres groupées de licences d'entreprise liées à des piles de tissu de données plus larges.
Paysage concurrentiel
Concentration du Marché
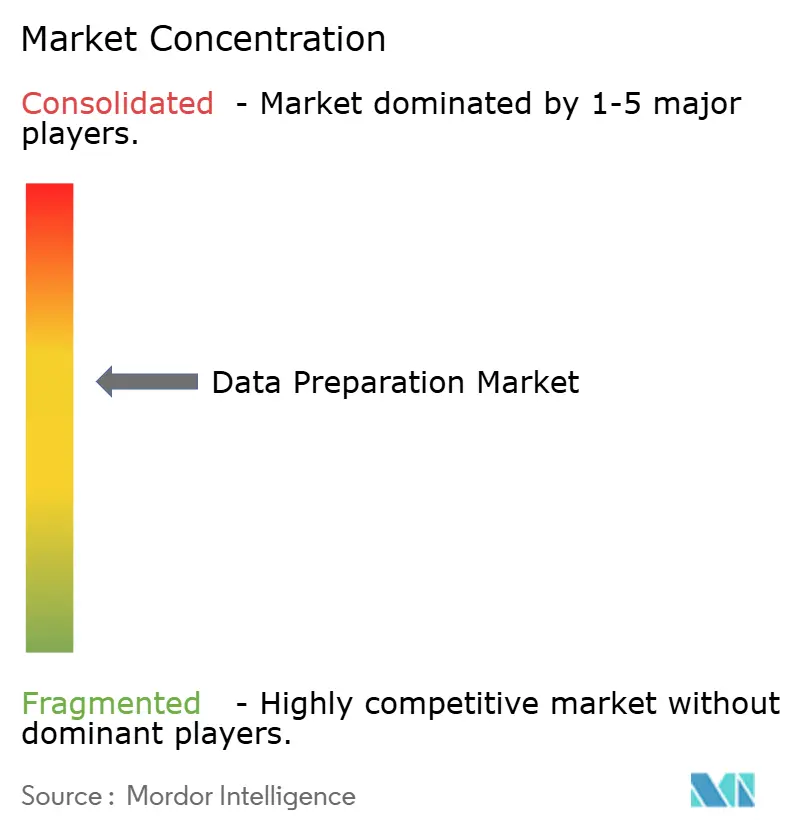
La consolidation remodèle la carte des fournisseurs. L'accord de Salesforce de 8 milliards USD pour acquérir Informatica souligne le pivot vers des suites complètes combinant ingestion, gouvernance, catalogue et analyses assistées par l'IA sous une seule licence commerciale. Cette démarche répond aux offres groupées de Microsoft et Oracle et fidélise une large base de clients à la plateforme Agentforce de Salesforce. L'appétit du capital-investissement reste élevé : Clearlake Capital et Insight Partners ont retiré Alteryx de la cote pour 4,4 milliards USD, accélérant sa transition vers le SaaS natif du cloud et les copilotes d'IA générative. IBM, Microsoft et Oracle étendent leurs empreintes avec des versions horizontales qui intègrent l'observabilité de la traçabilité et la remédiation automatisée dans des studios d'IA plus larges, tandis que Google Cloud redouble d'efforts sur la préparation des données BigQuery.
Les perturbateurs se concentrent sur des architectures axées sur l'IA. Scale AI a levé 1 milliard USD lors d'un financement de série F alors que Meta a investi 14,3 milliards USD et a recruté le PDG Alexandr Wang pour diriger un nouveau laboratoire de super-intelligence. Des start-ups natives du cloud telles que Prophecy mettent l'accent sur des pipelines visuels et un copilote de migration qui porte le code ETL hérité vers Spark et Snowpark, séduisant les entreprises qui modernisent leurs charges de travail sur mainframe. Des spécialistes verticaux émergent : Tamr pour la résolution d'entités en sciences de la vie, Precisely pour l'alignement des indicateurs ESG, et One Data pour les places de marché de produits de données.
L'intensité concurrentielle s'accroît autour des leviers de différenciation : remédiation automatisée de la qualité des données, calcul améliorant la confidentialité intégré, et modèles sectoriels qui rassurent les régulateurs. La concurrence par les prix reste modérée car les acheteurs privilégient la réduction des risques et la conformité réglementaire plutôt que le coût le plus bas, bien que les niveaux freemium des acteurs open source exercent une pression sur le segment inférieur du marché des PME.
Leaders du secteur de la préparation des données
-
Informatica LLC
-
IBM Corporation
-
SAS Institute Inc.
-
Microstrategy Inc.
-
Tableau Software, LLC (Salesforce.com Inc.)
- *Avis de non-responsabilité : les principaux acteurs sont triés sans ordre particulier
Marché de la préparation des données Entreprises couvertes dans ce rapport
- Alteryx Inc.
- Informatica LLC
- IBM Corporation
- Microsoft Corporation
- Tableau Software LLC (Salesforce)
- SAP SE
- SAS Institute Inc.
- QlikTech International AB
- TIBCO Software Inc.
- Talend SA
- Oracle Corporation
- Trifacta Inc. (Google)
- Databricks Inc.
- Snowflake Inc.
- Dataiku SAS
- MicroStrategy Inc.
- RapidMiner Inc.
- Paxata Inc. (DataRobot)
- Unifi Software Inc.
- Denodo Technologies Inc.
Opportunités de marché et perspectives d'avenir
Les opportunités se concentrent de plus en plus autour de produits qui rendent la préparation des données directement exploitable au sein des workflows d'agents IA et de RAG, en particulier lorsque du contenu non structuré tel que des documents, PDF, tickets, e-mails et transcriptions d'appels doit être transformé en contexte gouverné et interrogeable. IBM a explicitement formalisé ce workflow avec OpenRAG pour watsonx.data en mars 2026, suivi d'améliorations ajoutant des capacités d'évaluation des risques et de gestion de la confidentialité via StoredIQ InstaScan au sein de Cloud Pak for Data en juin 2026. Ensemble, ces annonces suggèrent une demande des acheteurs pour des étapes de préparation packagées et conformes plutôt que des scripts sur mesure.
Un second espace blanc concerne la préparation et la gouvernance des données sans tête (headless) et in situ qui s'intègrent aux outils d'IA d'entreprise sans imposer de déplacement des données ni une interface utilisateur unique. Informatica a mis cela en avant en mai 2026 avec la gestion headless des données pour AWS, tout en approfondissant sa collaboration avec Microsoft pour rendre disponibles des serveurs Model Context Protocol au sein de Microsoft Foundry. Alors que les organisations standardisent leurs pratiques autour des schémas lakehouse et des formats de table ouverts tels qu'Apache Iceberg et Delta Lake dans des environnements hybrides, les fournisseurs proposant des métadonnées portables, une traçabilité et des contrôles de politique à travers ces environnements d'exécution disposent d'une marge d'expansion, en particulier lorsque les besoins de localisation et d'audit poussent les acheteurs à conserver les jeux de données sensibles dans le pays tout en permettant une préparation en libre-service et un partage gouverné.
Développements industriels récents dans Marché de la préparation des données
- Juin 2026 : IBM a annoncé des améliorations de Cloud Pak for Data intégrant les capacités StoredIQ InstaScan pour une évaluation rapide des risques et la gestion de la confidentialité des données. Cette mise à jour améliore la manière dont les entreprises analysent, classifient et préparent les jeux de données sensibles avant leur partage ou leur utilisation par l'IA, renforçant le lien entre la préparation des données et les workflows de conformité.
- Mai 2026 : Informatica a introduit la gestion headless des données pour AWS et a élargi ses capacités orientées agents en rendant disponibles les serveurs Model Context Protocol et les compétences CLAIRE Agent via les interfaces IA d'AWS telles que l'AWS Agent Registry. Cette initiative relie les fonctions de préparation, de gouvernance et de qualité des données aux architectures émergentes d'agents IA, où les données restent en place au sein des services cloud.
- Mai 2024 : Clearlake Capital et Insight Partners ont finalisé le rachat privé d'Alteryx pour 4,4 milliards USD. Cette transaction a soutenu une transition plus rapide vers une livraison cloud native et accéléré l'itération produit autour des fonctionnalités d'automatisation et de préparation de données assistée par IA.
Marché de la préparation des données Portée du rapport et méthodologie de recherche
Définition et périmètre du marché
Le marché de la préparation des données est comptabilisé comme le chiffre d'affaires généré par les logiciels et les abonnements associés utilisés pour ingérer, profiler, nettoyer, transformer et publier des données afin qu'elles puissent être utilisées pour l'analytique, les tableaux de bord et l'apprentissage automatique.
Exclusions du périmètre : Nous excluons les moteurs d'intégration de données purs, les appliances ETL et les prestations de services professionnels ponctuelles qui se terminent sous forme de scripts personnalisés.
Aperçu de la segmentation
- Par déploiement
- Sur site
- Cloud
- Par taille d'entreprise
- Petites et moyennes entreprises (PME)
- Grandes entreprises
- Par type de solution
- Ingestion de données
- Catalogage de données
- Qualité des données
- Gouvernance des données
- Transformation des données
- Enrichissement des données
- Par secteur d'utilisation final
- BFSI
- Santé et sciences de la vie
- Commerce de détail et commerce électronique
- Fabrication et industrie
- Informatique et télécommunications
- Gouvernement et secteur public
- Autres (énergie, éducation, médias)
- Par géographie
- Amérique du Nord
- États-Unis
- Canada
- Mexique
- Europe
- Allemagne
- Royaume-Uni
- France
- Italie
- Espagne
- Russie
- Reste de l'Europe
- Asie-Pacifique
- Chine
- Japon
- Inde
- Corée du Sud
- Australie et Nouvelle-Zélande
- Reste de l'Asie-Pacifique
- Amérique du Sud
- Brésil
- Argentine
- Reste de l'Amérique du Sud
- Moyen-Orient et Afrique
- Moyen-Orient
- Arabie saoudite
- Émirats arabes unis
- Turquie
- Reste du Moyen-Orient
- Afrique
- Afrique du Sud
- Nigéria
- Reste de l'Afrique
- Moyen-Orient
- Amérique du Nord
Sources de données, dimensionnement du marché et validation
Recherche documentaire
La recherche documentaire a été utilisée pour définir les limites du marché et créer le premier ensemble de signaux d'offre et de demande avant la construction du modèle. Nous nous sommes appuyés sur des sources publiques telles que le Bureau of Labor Statistics des États-Unis, le Bureau du recensement des États-Unis, Eurostat, les ensembles de données sur l'économie numérique de l'OCDE et les indicateurs TIC de la Banque mondiale pour comprendre l'orientation des dépenses numériques et l'intensité des recrutements autour des métiers de la donnée.
Pour relier ces indicateurs macroéconomiques à ce marché, nous avons examiné les dépôts auprès de la SEC et les rapports annuels, les présentations aux investisseurs, la documentation produit sur les sites web des entreprises, ainsi que la couverture presse de référence relative aux mises à jour de plateformes et aux acquisitions. Le cas échéant, nous avons eu recours à des abonnements payants pour les données financières et le renseignement sur les entreprises, les actualités et données financières, ainsi que les bases de données de brevets, afin de recouper le positionnement produit et les schémas de reporting des revenus. Ces exemples ne sont pas exhaustifs, et nous avons également référencé d'autres sources publiques et payantes pour la collecte, la validation et la clarification des données.
Entretiens primaires et enquêtes
Des discussions primaires ont été menées avec des éditeurs de logiciels, des partenaires cloud et de distribution, des intégrateurs de systèmes, ainsi que des responsables de la donnée côté acheteur qui gèrent des programmes d'analytique et de gouvernance. Nous avons utilisé ces contributions pour confirmer quelles offres sont achetées en tant qu'outils de préparation des données par opposition aux outils adjacents, valider les évolutions tarifaires typiques et tester la robustesse de l'adoption par secteur et par région avant de finaliser les totaux de la demande.
Répartition des répondants aux travaux de terrain de la recherche primaire
| Type d'entreprise | Poste du répondant | Région |
|---|---|---|
| Premier niveau : 31 % | Directeurs généraux (CXO) : 13 % | APAC : 46 % |
| Niveau intermédiaire : 54 % | Responsables fonctionnels/d'unité : 34 % | EMEA : 30 % |
| Acteurs de plus petite taille : 15 % | Managers : 53 % | Amériques : 24 % |
Dimensionnement et prévisions du marché
Le dimensionnement commence par une construction descendante dans laquelle les dépenses en logiciels d'entreprise et en gestion des données sont filtrées vers un bassin de demande en préparation des données à l'aide de signaux d'adoption et d'intensité d'utilisation. Une fois cette structure en place, nous utilisons des approximations ascendantes sélectives, telles que les revenus d'éditeurs échantillonnés, les vérifications de canaux sur les offres groupées d'abonnements et une logique de type prix de vente moyen multiplié par utilisateurs actifs. Nous ajustons ensuite les totaux uniquement lorsque l'écart est explicable.
Les principaux paramètres du modèle comprennent le rythme de migration vers le cloud pour les infrastructures analytiques, la croissance des volumes de données et la part des données semi-structurées, le déploiement des programmes de gouvernance et de conformité, le passage des flux de travail de données pilotés par l'informatique vers le libre-service, et le comportement typique des prix des abonnements (y compris les changements de conditionnement selon les licences, la capacité et les niveaux de fonctionnalités). Les prévisions s'appuient sur une analyse de scénarios étayée par les avis d'experts sur les fonctionnalités de préparation assistée par l'IA, les cycles budgétaires et le rythme des activités de consolidation. Lorsque les données ascendantes sont incomplètes, nous utilisons des hypothèses de pénétration conservatrices et les revérifions par rapport aux indicateurs de recrutement, aux indicateurs de budget logiciel et aux informations divulguées sur la composition des revenus des fournisseurs.
Cycle de validation et de mise à jour des données
Des vérifications sont appliquées à plusieurs étapes afin que le chiffre final soit en adéquation avec les signaux du monde réel. Nous comparons les résultats à des indicateurs indépendants tels que l'orientation des dépenses en logiciels, les commentaires des fournisseurs sur la composition de leurs revenus et les tendances régionales d'adoption du cloud, puis nous examinons les écarts importants avant validation finale.
Si une valeur aberrante est identifiée, nous revoyons les hypothèses et, si nécessaire, nous déclenchons des entretiens de suivi pour confirmer si un élément de périmètre a été mal classifié ou si un changement de prix était temporaire. Les rapports sont actualisés annuellement, avec des mises à jour intermédiaires lorsque des événements majeurs modifient sensiblement la demande ou l'offre. Avant la livraison, nous effectuons une relecture analytique finale afin que la vision reflète les dernières informations publiques disponibles et les hypothèses validées les plus récentes.
Dimensionnement du marché de la préparation des données par Mordor Intelligence comparé à d'autres estimations publiées
Il est courant de voir différentes valeurs de marché publiées pour la préparation des données, même lorsque le nom du sujet semble identique. Les écarts proviennent généralement de la manière dont chaque étude trace la frontière entre la préparation des données et les catégories de logiciels voisines, ainsi que des différences dans l'année de référence utilisée, le calendrier de conversion des devises et le traitement des abonnements.
Certains éditeurs combinent la préparation des données avec les revenus plus larges de l'ETL, de l'intégration des données ou des services professionnels, tandis que d'autres se concentrent uniquement sur les outils et les abonnements récurrents. L'écart peut également être dû à la manière dont les offres groupées sont traitées, à la normalisation ou non des prix cloud et sur site, et au fait que les prévisions supposent une adoption agressive des fonctionnalités assistées par l'IA ou une montée en charge plus progressive des acheteurs. En excluant les services professionnels et en ne comptabilisant les revenus de plateforme que lorsque la fonction principale est le profilage, le nettoyage et la transformation des données pour l'analytique en aval, le total 2025 s'établit à 6,95 milliards USD dans le périmètre utilisé par Mordor Intelligence.
Dans l'ensemble de la comparaison 2025, les différences s'expliquent largement par les règles de périmètre et le calendrier, plutôt que par un changement des signaux de demande sous-jacents.
Comparaison de référence
| Source | Taille du marché | Lacunes dans la méthodologie de recherche |
|---|---|---|
| Mordor Intelligence | 6,95 milliards USD (2025) | |
| Global Consultancy A | 7,01 milliards USD (2024) | Utilise une approche centrée sur les outils uniquement avec une année de base 2024, et la description du périmètre ne précise pas les exclusions relatives aux moteurs d'intégration ou aux modules adjacents groupés, ce qui peut faire varier les totaux selon le conditionnement des éditeurs. |
| Industry Publisher B | 6,50 milliards USD (2024) | Utilise une année de base 2024 et fournit peu de détails sur ce qui est inclus au-delà des grands segments de déploiement et d'entreprise, ce qui peut sous-estimer les expansions d'abonnements liées aux fonctionnalités de préparation axées sur la gouvernance et assistées par l'IA. |
Pris dans leur ensemble, les éléments de comparaison montrent principalement que le choix de l'année et les règles de périmètre créent l'essentiel de la variance, et non un désaccord sur la direction de la demande. Notre approche reste traçable car chaque hypothèse est rattachée à des signaux d'adoption, à une logique tarifaire et à une validation par entretiens, ce qui rend la valeur finale du marché plus facile à reproduire et à mettre à jour.
Questions clés auxquelles le rapport répond
Quelle est la taille actuelle du marché de la préparation des données ?
Le marché de la préparation des données est évalué à 8,05 milliards USD en 2026.
À quelle vitesse le marché de la préparation des données devrait-il croître ?
Les revenus devraient augmenter à un TCAC de 15,92 %, atteignant 16,84 milliards USD d'ici 2031.
Quel modèle de déploiement se développe le plus rapidement ?
Les déploiements basés sur le cloud progressent à un TCAC de 17,12 %, portés par l'adoption des PME et l'élasticité des charges de travail IA.
Pourquoi les outils de gouvernance des données gagnent-ils en dynamique ?
Les réglementations mondiales en matière de durabilité et d'IA exigent une traçabilité transparente, une qualité et des rapports ESG, poussant les modules de gouvernance à un TCAC de 16,74 %.
Quelle région affichera la croissance la plus forte ?
L'Asie-Pacifique devrait mener avec un TCAC de 16,98 %, soutenue par des programmes de transformation numérique et des investissements dans les clouds souverains.
Comment les fusions et acquisitions façonnent-elles la concurrence ?
De grandes suites se forment à travers des opérations telles que Salesforce-Informatica et le retrait de la cote d'Alteryx, consolidant l'ingestion, le catalogue et la gouvernance sous des plateformes unifiées.