
Taille et part du marché de la bioinformatique
VUE D’ENSEMBLE DU MARCHÉ
| Période d'étude | 2020 - 2031 |
|---|---|
| Taille du Marché (2026) | 19.97 Milliards de dollars |
| Taille du Marché (2031) | 37.03 Milliards de dollars |
| Growth Rate (2026 - 2031) | 13.10 % |
| Marché à la Croissance la Plus Rapide | Asie-Pacifique |
| Plus Grand Marché | Amérique du Nord |
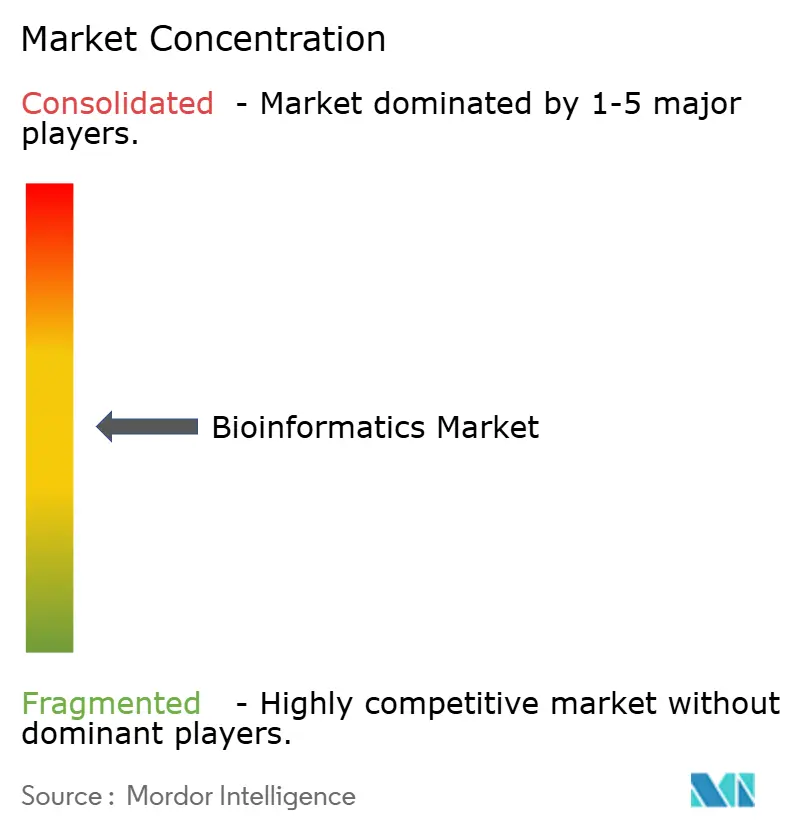
| Concentration du Marché | Moyen |
Acteurs majeurs *Avis de non-responsabilité : les principaux acteurs sont triés sans ordre particulier Image © Mordor Intelligence. La réutilisation nécessite une attribution sous CC BY 4.0. | |
Analyse du marché de la bioinformatique par Mordor Intelligence
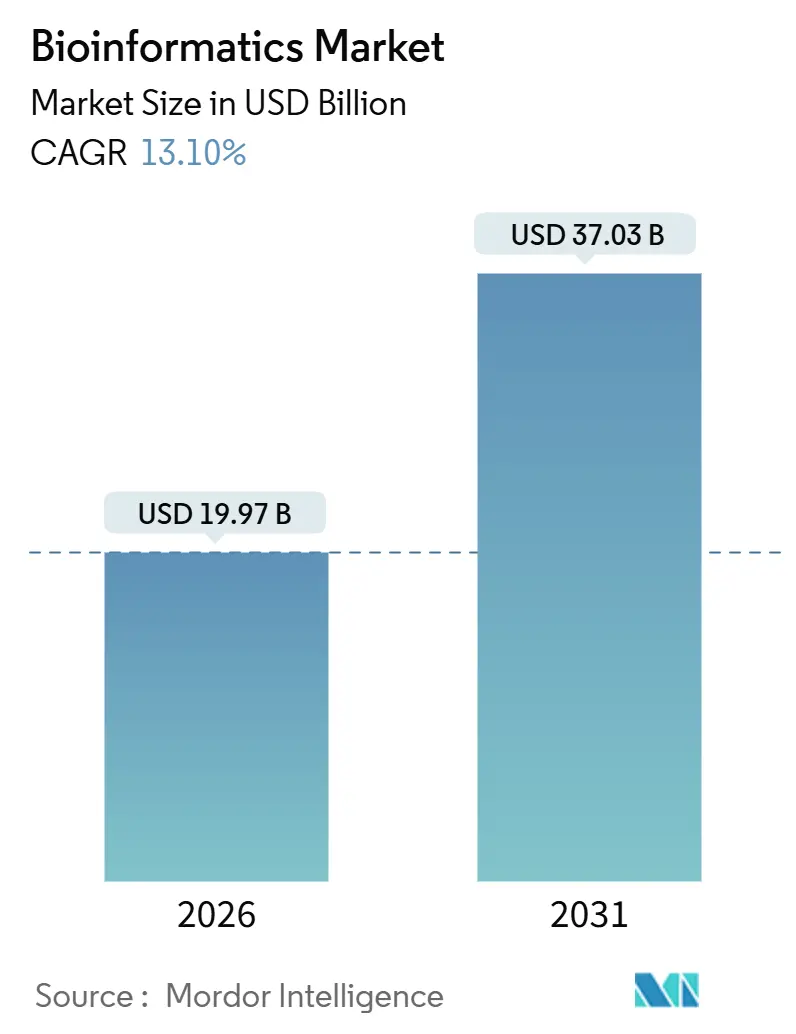
La taille du marché de la bioinformatique est estimée à 19,97 milliards USD en 2026, et devrait atteindre 37,03 milliards USD d'ici 2031, avec un CAGR de 13,10 % au cours de la période de prévision (2026-2031).
Un pipeline en expansion d'études multi-omiques, une pression réglementaire croissante en faveur des diagnostics de précision et le pivot du secteur pharmaceutique vers une R&D centrée sur les données continuent de repositionner les plateformes de bioinformatique, qui passent d'outils tactiques à une infrastructure d'entreprise. Les hyperscalers du cloud intègrent des services optimisés pour la génomique qui font passer les dépenses d'investissement vers des modèles basés sur la consommation, tandis que l'analytique de proximité des instruments réduit la latence et les coûts de sortie des données dans les laboratoires cliniques. Les fournisseurs qui combinent des algorithmes natifs à l'IA avec un calcul élastique captent la plus grande part des nouveaux déploiements, même si les lacunes en matière de cybersécurité et de main-d'œuvre tempèrent la scalabilité à court terme. Le paysage concurrentiel qui en résulte est défini par la convergence : les fabricants d'instruments de séquençage, les organisations de recherche sous contrat et les start-ups logicielles se disputent désormais la même pile analytique.
Points clés du rapport
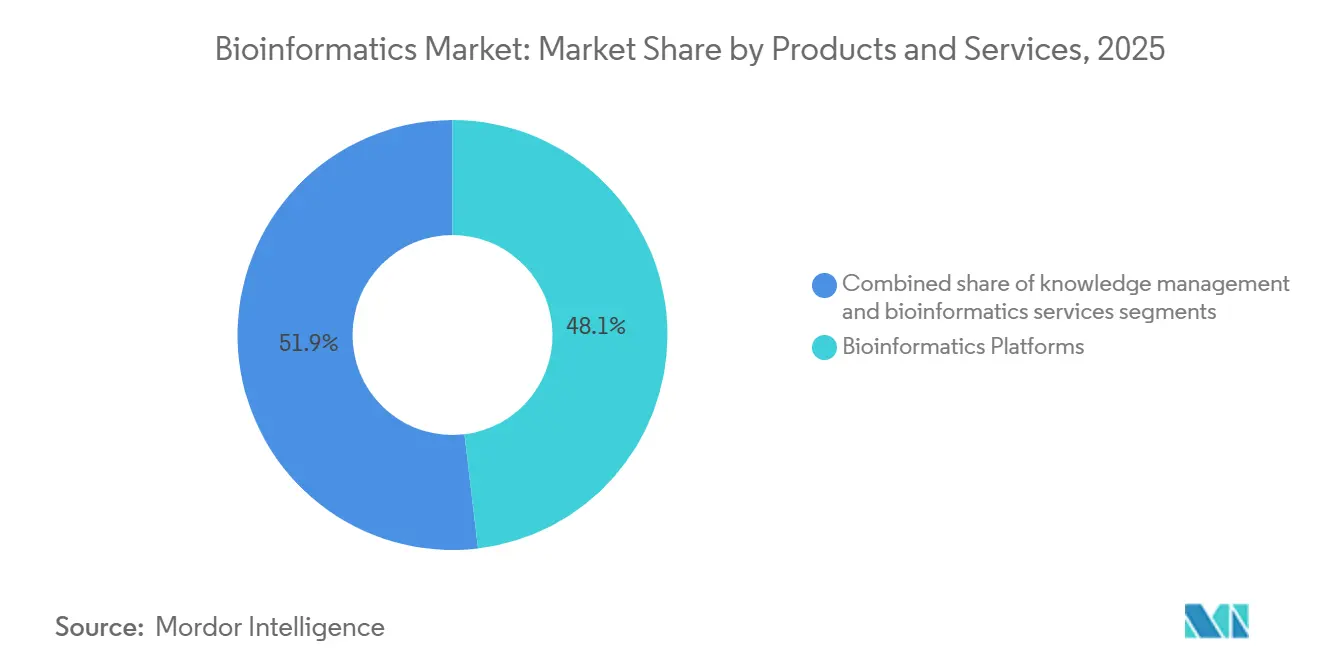
- Par produits et services, les plateformes de bioinformatique ont dominé avec une part de revenus de 48,1 % en 2025, tandis que les services de bioinformatique progressent à un CAGR de 14,1 % jusqu'en 2031.
- Par application, la génomique et la transcriptomique ont représenté 34,6 % de la taille du marché de la bioinformatique en 2025, tandis que la protéomique et la métabolomique devraient se développer à un CAGR de 14,43 % jusqu'en 2031.
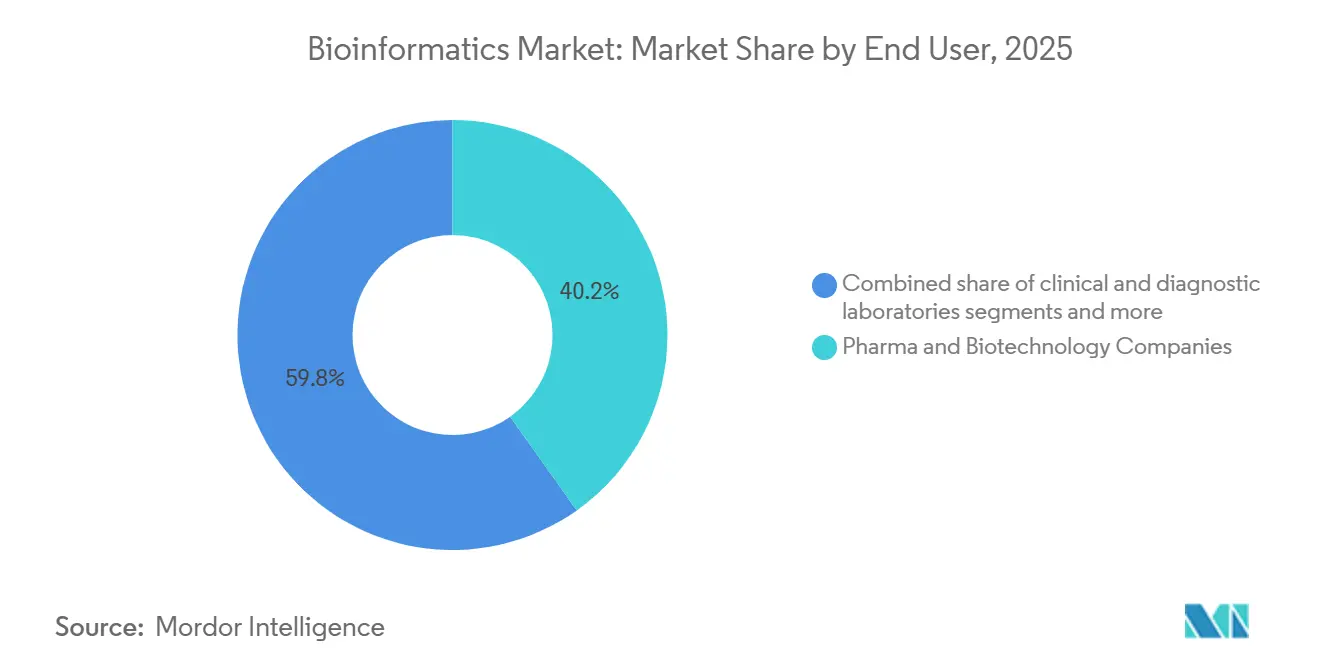
- Par utilisateur final, les entreprises pharmaceutiques et biotechnologiques ont représenté 40,2 % de la part du marché de la bioinformatique en 2025 ; les organisations de recherche sous contrat constituent le segment à la croissance la plus rapide avec un CAGR de 13,98 % jusqu'en 2031.
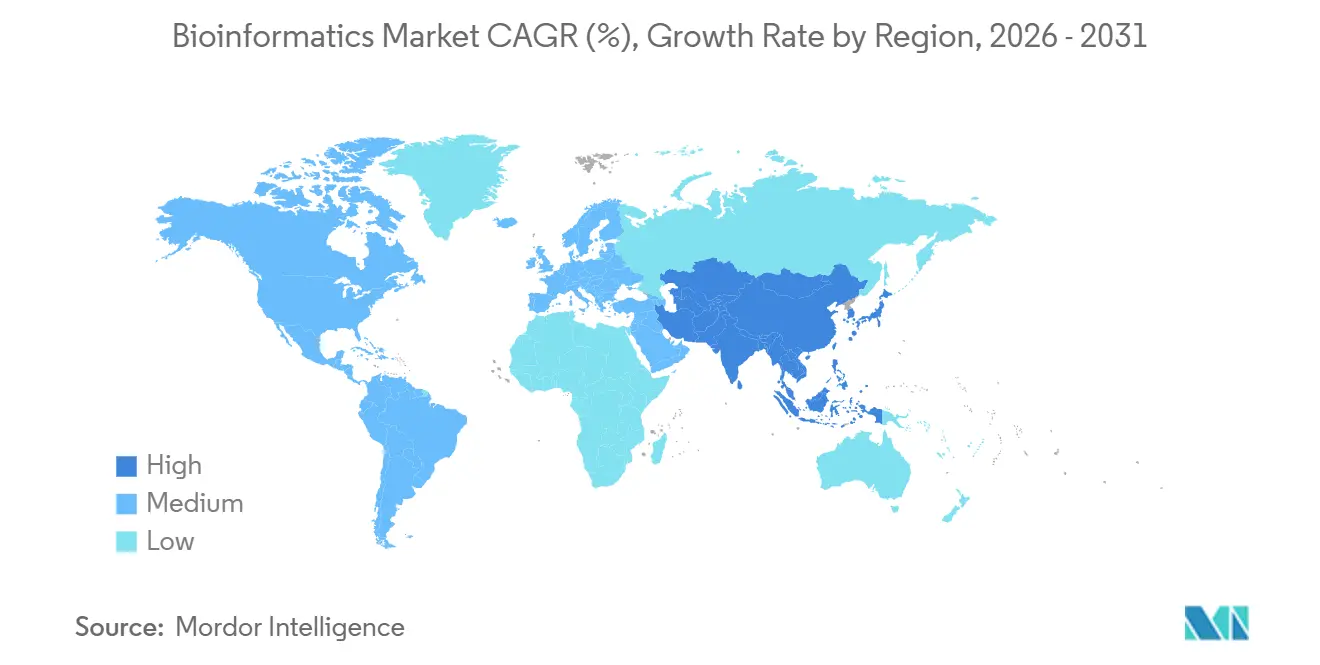
- Par géographie, l'Amérique du Nord détenait une part de 39,4 % en 2025, mais l'Asie-Pacifique devrait enregistrer un CAGR de 14,89 % jusqu'en 2031.
Note : La taille du marché et les prévisions figurant dans ce rapport sont générées à l'aide du cadre d'estimation exclusif de Mordor Intelligence, mis à jour avec les dernières données et informations disponibles en janvier 2026.
Tendances et Analyses du Marché
Analyse de l'impact des moteurs*
| Moteur | (~) % d'impact sur les prévisions de CAGR | Pertinence géographique | Horizon temporel d'impact |
|---|---|---|---|
| Explosion des volumes de données multi-omiques | +2.8% | Mondial, pic en Amérique du Nord et en Chine | Court terme (≤ 2 ans) |
| Médecine de précision et diagnostics compagnons | +2.5% | Amérique du Nord, Europe, Japon | Moyen terme (2-4 ans) |
| Transition pharma-biotech vers une R&D centrée sur les données | +2.2% | Mondial, porté par l'Amérique du Nord et l'Europe | Moyen terme (2-4 ans) |
| Initiatives génomiques financées par les gouvernements | +1.9% | Amérique du Nord, Royaume-Uni, Chine, Inde | Long terme (≥ 4 ans) |
| Traitement en périphérie ou à proximité des instruments | +1.6% | Amérique du Nord, Europe, cœur de l'Asie-Pacifique | Court terme (≤ 2 ans) |
| Places de marché de modèles d'IA | +1.4% | Mondial, adoption précoce en Amérique du Nord | Moyen terme (2-4 ans) |
| Source: Mordor Intelligence | |||
Explosion des volumes de données multi-omiques
Le débit de séquençage a dépassé 20 pétabases par instrument et par an, mais l'infrastructure de stockage et de calcul est à la traîne par rapport à la demande, créant des goulots d'étranglement que les plateformes de bioinformatique doivent résoudre. Le coût du séquençage d'un génome humain est tombé en dessous de 200 USD en 2024, mais l'analyse en aval coûte désormais trois à cinq fois ce montant, ce qui stimule les investissements dans les algorithmes de compression et l'apprentissage fédéré qui traitent les données in situ. Les commanditaires pharmaceutiques intègrent de plus en plus des ensembles de données génomiques, transcriptomiques, protéomiques et métabolomiques provenant de cohortes de patients identiques, un flux de travail qui dépend de clusters GPU et d'un stockage d'objets optimisé pour des charges de travail à l'échelle du pétaoctet. Des fournisseurs de cloud tels qu'AWS, Google Cloud et Microsoft Azure répondent avec des pipelines gérés qui accélèrent l'appel de variants et l'annotation. Les appareils de périphérie intégrés dans les séquenceurs minimisent davantage les frais de transfert de données en gérant l'appel de bases et l'analyse primaire localement. Ensemble, ces dynamiques soutiennent des dépenses à deux chiffres en calcul élastique, même si les coûts de séquençage par échantillon diminuent.
Adoption de la médecine de précision et des diagnostics compagnons
Les approbations réglementaires pour les diagnostics compagnons ont augmenté en 2025 par rapport à 2024, renforçant ainsi la nécessité de pipelines capables de détecter des altérations génomiques complexes avec une précision de niveau clinique. Les thérapies agnostiques de la tumeur ciblant les fusions NTRK et les signatures MSI-élevées nécessitent des panels interrogeant plus de 300 gènes, ce qui fait évoluer la demande des tests monogéniques vers le profilage complet. L'Agence européenne des médicaments a finalisé en 2024 des orientations qui imposent une validation analytique sur des cohortes ethniques diverses, incitant à l'expansion des ensembles de données de référence et des algorithmes tenant compte de l'ethnicité. Le Japon a ajouté des codes de remboursement pour la surveillance par biopsie liquide en 2025, catalysant l'adoption d'outils qui suivent la dynamique de l'ADN tumoral circulant. Collectivement, ces politiques ancrent les dépenses de bioinformatique en oncologie, tout en se répercutant sur la cardiologie et les maladies rares à mesure que les payeurs reconnaissent la valeur pharmacoéconomique des thérapeutiques stratifiées.
Transition pharma-biotech vers une R&D centrée sur les données
Les pipelines pharmaceutiques s'appuient désormais sur la génération d'hypothèses in silico pour raccourcir les cycles en laboratoire humide. La publication en accès libre par AlphaFold de 200 millions de structures protéiques a démontré que des années de cristallographie peuvent être compressées en quelques heures de temps GPU, accélérant la conception de médicaments guidée par la structure. La découverte d'anticorps bénéficie particulièrement de modèles génératifs entraînés sur des données de répertoire immunitaire qui proposent des liants avec une développabilité prédite, réduisant considérablement les pools de candidats. Les grands commanditaires élargissent donc leurs unités d'IA internes tout en s'associant à des fournisseurs qui proposent des flux de travail de prédiction de structure clés en main. Les organisations de recherche sous contrat développent des capacités similaires auprès de plusieurs clients, convertissant l'infrastructure en services facturables et stimulant l'adoption parmi les start-ups biotechnologiques à ressources limitées.
Initiatives génomiques financées par les gouvernements
Le programme NIH All of Us a publié des séquences de génome entier pour 245 000 participants en 2025, créant la plus grande cohorte ethniquement diverse pour la recherche en médecine de précision [1]National Institutes of Health, "Mise à jour du programme de recherche All of Us," nih.gov. La Biobanque du Royaume-Uni a ajouté des couches protéomiques et métabolomiques pour 50 000 volontaires, produisant des ensembles de données intégrés que les laboratoires académiques exploitent pour les biomarqueurs cardiovasculaires. Le Centre national de données génomiques de Chine stocke désormais plus de 10 pétaoctets de données de séquençage, permettant la construction de génomes de référence spécifiques à la population qui améliorent l'interprétation des variants pour les cohortes asiatiques. Le projet Genome India a terminé le séquençage de 10 000 individus, posant les bases d'études d'optimisation des doses qui réduisent les effets indésirables liés aux allèles CYP2C19 et CYP2D6. Ces initiatives à grande échelle stimulent la construction de clouds nationaux et alimentent des partenariats analytiques transfrontaliers.
Analyse de l'impact des freins*
| Frein | (~) % d'impact sur les prévisions de CAGR | Pertinence géographique | Horizon temporel d'impact |
|---|---|---|---|
| Pénurie de bioinformaticiens qualifiés | -1.8% | Mondial, aiguë en Amérique du Nord et en Europe | Moyen terme (2-4 ans) |
| Normes de données fragmentées | -1.4% | Mondial, perturbateur dans les essais multi-sites | Long terme (≥ 4 ans) |
| Risques liés à la cybersécurité et à la confidentialité des données génomiques | -1.2% | Mondial, forte pression réglementaire en Occident | Court terme (≤ 2 ans) |
| Hausse des frais de sortie du cloud et de stockage à long terme | -1.0% | Mondial, aiguë pour les projets à l'échelle de la population | Moyen terme (2-4 ans) |
| Source: Mordor Intelligence | |||
Pénurie de bioinformaticiens qualifiés
Les programmes académiques ont diplômé environ 8 500 biologistes computationnels en 2025, contre une demande industrielle de plus de 15 000 nouvelles recrues, creusant un déficit de talents qui fait grimper les salaires au-delà de 150 000 USD pour les professionnels en milieu de carrière [2]Bureau of Labor Statistics des États-Unis, "Perspectives professionnelles pour les scientifiques en bioinformatique," bls.gov. Les entreprises lancent des formations internes pour perfectionner les biologistes moléculaires en Python et R, tandis que les fournisseurs de plateformes intègrent des interfaces sans code pour élargir l'utilisabilité. Les viviers de talents offshore en Inde et en Europe de l'Est offrent un soulagement partiel, bien que les contraintes de fuseau horaire et de souveraineté des données limitent les flux de travail impliquant des informations de santé protégées.
Risques liés à la cybersécurité et à la confidentialité des données génomiques
Les attaques par rançongiciel ciblant les ensembles de données génomiques ont augmenté de manière significative d'une année sur l'autre en 2025, obligeant les laboratoires à mettre à niveau leurs architectures de confiance zéro et à se conformer à une application plus stricte de la HIPAA et du RGPD. Les primes d'assurance pour la couverture cybernétique ont fortement augmenté, et certains payeurs exigent désormais des tests de pénétration externes comme condition préalable au remboursement des tests génomiques. Le chiffrement au repos et l'analyse fédérée atténuent l'exposition mais ajoutent des coûts supplémentaires qui réduisent les marges des centres de diagnostic plus petits.
*Nos prévisions considèrent les impacts des moteurs et des contraintes comme directionnels et non additifs. Les prévisions d'impact reflètent la croissance de référence, les effets de composition et les interactions entre variables.
Analyse des segments
Par produits et services :
les plateformes dominent tandis que les services cloud s'accélèrentLes plateformes représentaient 48,1 % du marché de la bioinformatique en 2025, portées par des flux de travail d'analyse de séquences étroitement couplés aux instruments Illumina et Oxford Nanopore. Dans cette catégorie, le déploiement cloud à la consommation gagne des parts de marché à mesure que les laboratoires migrent depuis des clusters sur site en cours d'amortissement. Les services progressent à un CAGR de 14,1 % jusqu'en 2031 en convertissant les dépenses d'investissement en charges d'exploitation variables et en intégrant des cadres de conformité satisfaisant aux exigences CLIA et CE-IVDR. L'analyse de séquences reste au cœur du marché, mais les modules d'intégration multi-omique et de gestion des connaissances intègrent désormais des bases de données graphiques et des moteurs d'exploration de texte qui font émerger les informations sur les voies biologiques plus rapidement que la curation manuelle. Les éditeurs de plateformes incapables de fournir à la fois des bases de code cloud et edge subissent une pression de consolidation, comme en témoignent les récentes fusions de niveau intermédiaire.
Les services de bioinformatique captent une part croissante des budgets des petites biotechs et des laboratoires académiques qui ne disposent pas d'quipes informatiques internes. Les hyperscalers amplifient cette tendance en intégrant des boîtes à outils génomiques — AWS HealthOmics, Google Cloud Life Sciences API — dans des offres cloud plus larges, souvent proposées en dessous du coût de revient pour stimuler la consommation de stockage et de calcul. En conséquence, la taille du marché de la bioinformatique imputable aux licences logicielles autonomes est en déclin, même si les dépenses globales augmentent. Les abonnements et les frais par échantillon remplacent les revenus matériels ponctuels, alignant les incitations des éditeurs sur les volumes de données des clients. Les outils de gestion des connaissances continuent de monétiser la qualité de la curation, mais les ressources en libre accès érodent leur pouvoir de fixation des prix, déplaçant l'accent vers des algorithmes propriétaires qui s'intègrent aux cahiers de laboratoire électroniques et aux systèmes d'information de laboratoire.
Note: Les parts de segments de tous les segments individuels sont disponibles à l'achat du rapport


Par application :
la protéomique émerge comme leader de la croissanceLa génomique et la transcriptomique détenaient 34,6 % de la taille du marché de la bioinformatique en 2025, ancrées par les programmes de séquençage nationaux et les diagnostics en oncologie. La protéomique et la métabolomique enregistrent cependant un CAGR de 14,43 % jusqu'en 2031, portées par les avancées en spectrométrie de masse qui quantifient plus de 10 000 protéines par échantillon. Les techniques spatiales superposent les signaux moléculaires sur l'architecture tissulaire, stimulant la demande de visualisation accélérée par GPU. Les pipelines de découverte de médicaments intègrent des algorithmes de prédiction de structure avec la chimie générative pour réduire les délais précliniques, tandis que la génomique microbienne gagne en urgence à mesure que les gouvernements surveillent la résistance aux antimicrobiens.
Les cas d'usage de la médecine de précision passent de la recherche à la clinique, avec des étiquettes pharmacogénomiques approuvées par la FDA dépassant 400 en 2025. La génomique agricole et environnementale progresse également à mesure que les régulateurs évaluent les cultures éditées par CRISPR pour les effets hors cible. Le séquençage unicellulaire associe l'imagerie et l'omique, produisant des ensembles de données à l'échelle du téraoctet qui nécessitent une analytique en temps réel et un calcul en périphérie. Collectivement, ces applications émergentes rééquilibrent les portefeuilles des fournisseurs et réduisent la dépendance aux revenus mono-omiques.
Par utilisateur final :
les ORC capitalisent sur la vague d'externalisationLes entreprises pharmaceutiques et biotechnologiques ont généré 40,2 % de la demande en 2025, déployant des clouds privés qui intègrent les données expérimentales aux soumissions réglementaires. Les organisations de recherche sous contrat dépassent les autres groupes avec un CAGR de 13,98 %, tirant parti d'une infrastructure partagée pour amortir le calcul entre les commanditaires et fournir des rapports analytiques clés en main. Les instituts académiques et de recherche restent influents mais perdent des parts à mesure que le financement par subventions plafonne.
Les laboratoires cliniques et de diagnostic intègrent des pipelines réglementés conformes aux listes de contrôle CLIA et CAP, une démarche qui élève la demande de moteurs d'interprétation de variants validés. Les entreprises de tests agri-génomiques et environnementaux, bien que de niche, connaissent une croissance rapide à mesure que les semenciers mettent en œuvre la sélection génomique. Les acquisitions d'ORC de fournisseurs de plateformes, comme l'achat en 2024 par IQVIA d'une division génomique, illustrent l'intégration verticale qui capture plus de valeur par échantillon.
Note: Les parts de segments de tous les segments individuels sont disponibles à l'achat du rapport
Analyse géographique
Marché de la bioinformatique en Amérique du Nord
L'Amérique du Nord a représenté 39,4 % du marché de la bioinformatique en 2025, soutenue par une concentration dense de sièges sociaux pharmaceutiques, de centres académiques et de financements en capital-risque. Les orientations de la FDA publiées en 2024 ont renforcé les normes de validité clinique pour les tests de séquençage de nouvelle génération, allongeant les cycles de développement tout en augmentant la complexité globale de l'analyse des données. Les réseaux d'onco-précision du Canada déploient des plateformes fédérées conformes aux lois provinciales sur la protection de la vie privée, et les producteurs de biosimilaires du Mexique adoptent des outils de bioinformatique pour les protocoles de comparabilité, diversifiant ainsi la demande régionale.
Marché de la bioinformatique en Asie-Pacifique
La région Asie-Pacifique devrait se développer à un CAGR de 14,89 % jusqu'en 2031, à mesure que l'écosystème génomique soutenu par l'État en Chine accroît sa capacité de séquençage et intègre verticalement les plateformes d'analyse [3]BGI Genomics, "Présentation aux relations investisseurs," bgi.com L'Inde incube des start-ups qui localisent les pipelines pour les haplotypes sud-asiatiques, et le Japon élargit le remboursement des panels de plus de 500 gènes, stimulant l'adoption par les hôpitaux de logiciels à usage clinique. L'Australie et la Corée du Sud investissent dans des programmes nationaux de médecine de précision qui associent l'informatique en nuage à des centres de données souverains, garantissant la conformité avec les lois nationales sur la cybersécurité.
Marché de la bioinformatique en EMEA et en Amérique du Sud
Le règlement européen relatif aux dispositifs de diagnostic in vitro, applicable depuis 2024, oblige les logiciels utilisés dans le diagnostic à obtenir la certification CE-IVDR, augmentant ainsi les coûts de conformité pour les fournisseurs. Le Centre national du génome d'Allemagne centralise les flux de travail liés aux maladies rares, tandis que le Royaume-Uni intègre le séquençage du génome entier au sein du Service national de santé, imposant des délais d'exécution inférieurs à 14 jours. Le marché d'Amérique du Sud est centré sur les projets pilotes de pharmacogénomique du Brésil et les programmes de génomique des cultures d'Argentine, tandis que le Moyen-Orient et l'Afrique restent des marchés naissants, les Émirats arabes unis et l'Arabie saoudite finançant le séquençage à grande échelle dans le cadre de leurs programmes de diversification économique.

Paysage réglementaire
La bioinformatique utilisée dans les flux de travail cliniques réglementés est de plus en plus considérée comme un logiciel pouvant éclairer la prise de décision diagnostique. Aux États-Unis, la FDA maintient sa supervision des tests de profilage tumoral par séquençage de nouvelle génération sous le code produit PZM (21 CFR 866.6080), où les logiciels et algorithmes de bioinformatique associés s'inscrivent dans un contexte réglementaire de Classe II lorsqu'ils sont utilisés pour soutenir l'aide à la décision clinique et le reporting. En janvier 2026, la FDA a mis à jour les lignes directrices relatives aux logiciels d'aide à la décision clinique, clarifiant quelles fonctions sont exclues de la définition du dispositif au titre de la section 520(o)(1)(E) du FD&C Act, ce qui affecte la manière dont les fournisseurs intègrent l'analytique dans les applications destinées aux cliniciens.
Du côté des données et de l'interopérabilité, le programme de certification en informatique de santé de l'ONC a établi USCDI Version 3 comme référence obligatoire pour l'informatique de santé certifiée à partir du 1er janvier 2026, renforçant les exigences relatives aux éléments de données standardisés consommés par les systèmes de bioinformatique et de médecine de précision en aval. L'ONC a également fait progresser son Standards Version Advancement Process (SVAP) avec le cycle 2026, incluant le guide d'implémentation HL7 FHIR US Core STU 9.0.0 pour une incorporation volontaire à partir du 29 août 2026, afin de soutenir un échange de données basé sur des API plus cohérent vers les environnements analytiques. Dans l'UE, le Règlement (UE) 2025/327 (Espace européen des données de santé, EHDS) est entré en vigueur le 26 mars 2025, formalisant les règles d'accès aux données de santé électroniques et leur utilisation secondaire pour la recherche et la médecine personnalisée ; le Règlement d'exécution de la Commission (UE) 2026/771 (publié le 7 avril 2026) a établi le Conseil de l'EHDS pour coordonner une application cohérente entre les États membres.
Analyse de la chaîne de valeur
La chaîne de valeur de la bioinformatique commence par la génération de données multi-omiques en amont (séquençage et spectrométrie de masse) et se poursuit par le traitement primaire, l'analytique, l'interprétation et la livraison des résultats dans les systèmes de recherche et cliniques. Les fournisseurs d'instruments et de tests intègrent de plus en plus l'analytique proche de l'instrument ou intégrée (incluant le basecalling, l'alignement, l'appel de variants et le contrôle qualité), tandis que les hyperscalers cloud fournissent une orchestration de pipelines gérée, du calcul élastique et des environnements conformes qui réduisent le besoin pour les laboratoires de maintenir des clusters sur site. Un goulot d'étranglement récurrent se situe entre le stockage et le calcul, où les contraintes d'E/S et les étapes répétées de décompression et de formatage ralentissent l'analyse à grande échelle, ce qui stimule la demande pour des formats de données optimisés, des moteurs de workflow et des architectures réduisant les déplacements de données.
Les acteurs intermédiaires comprennent les fournisseurs de plateformes, les prestataires de services de bioinformatique et les CRO qui standardisent les pipelines pour les essais multi-sites et le reporting réglementé, les contrôles de cybersécurité et de confidentialité devenant des exigences intégrées plutôt que des ajouts. En aval, les résultats alimentent des couches de gestion des connaissances et des systèmes cliniques ou d'entreprise, où les normes d'interopérabilité, telles que les échanges alignés sur FHIR dans les environnements informatiques de santé, influencent la manière dont les résultats sont opérationnalisés. De plus en plus, les modèles de données fédérés maintiennent les données génomiques sensibles en place tout en permettant l'interrogation et l'analyse inter-ensembles de données, réduisant les frictions liées aux transferts transfrontaliers et s'alignant avec les contraintes de souveraineté des données, y compris les efforts de l'industrie pour construire des ensembles de données fédérés mondiaux pour des génomes complets à haute fidélité. L'infrastructure des ensembles de données financés publiquement et la gouvernance de l'accès façonnent également le débit et la reproductibilité pour les utilisateurs académiques et translationnels, créant une dépendance à une gestion stable des données et un accès évolutif au calcul.
Paysage concurrentiel
Les cinq premiers fournisseurs, Illumina, Thermo Fisher Scientific, QIAGEN, Agilent Technologies et Roche, détenaient une part majoritaire en 2025, indiquant une concentration modérée. Illumina poursuit sa stratégie d'intégration verticale, couplant l'accélération DRAGEN aux ventes d'instruments pour générer 450 millions USD de revenus logiciels récurrents. Thermo Fisher poursuit une expansion horizontale, acquérant des solutions ponctuelles et les intégrant dans une plateforme cloud qui couvre de la préparation des échantillons à l'interprétation des variants.
Les perturbateurs comprennent des entreprises axées sur l'IA telles qu'Insitro et Recursion, qui commercialisent des piles analytiques propriétaires initialement construites pour la découverte interne de médicaments. La boîte à outils BioNeMo de NVIDIA permet aux entreprises pharmaceutiques d'entraîner des modèles de fondation sur des données locales, réduisant la dépendance aux plateformes tierces. Des organismes de normalisation comme GA4GH publient des API ouvertes qui pourraient commoditiser l'alignement de routine et l'appel de variants, intensifiant la concurrence par les prix.
Leaders du secteur de la bioinformatique
Illumina Inc.
Thermo Fischer Scientific
Qiagen NV
Agilent Technologies
F. Hoffmann-La Roche Ltd.
- *Avis de non-responsabilité : les principaux acteurs sont triés sans ordre particulier
Marché de la bioinformatique
- 3rd Millennium
- Agilent Technologies
- BGI Genomics Co. Ltd.
- Dassault Systèmes SE (BIOVIA)
- Data4Cure Inc.
- DNAnexus Inc.
- Eagle Genomics Ltd.
- Roche
- Gene42 Inc.
- Genedata
- Geneious (Biomatters)
- Illumina
- Ontoforce NV
- Oracle Corporation (Oracle Healthcare)
- Partek Inc.
- PerkinElmer
- QIAGEN
- Seven Bridges Genomics Inc.
- SoftGenetics LLC
- Thermo Fisher Scientific
- WuXi NextCODE Genomics

Opportunités de marché et perspectives d'avenir
Une opportunité à court terme réside dans l'expansion clinique des flux de travail multi-omiques et oncologiques qui nécessitent une analytique validée et de bout en bout plutôt que des outils autonomes. Les systèmes hospitaliers et les services de santé nationaux traduisent la biopsie liquide et le séquençage à large panel en parcours de routine, ce qui accroît la demande pour des plateformes combinant des pipelines spécifiques aux tests, le contrôle qualité, l'interprétation des variants et un reporting auditable. En 2026, SOPHiA GENETICS a élargi les signaux d'adoption clinique, avec le Mount Sinai Health System adoptant la plateforme SOPHiA DDM pour le NGS oncologique, et un partenariat avec Synnovis pour soutenir les tests de biopsie liquide ctDNA à travers le NHS England (visant environ 7 000 tests annuels). Ces déploiements favorisent les fournisseurs capables d'opérationnaliser des flux de travail réglementés sur plusieurs sites tout en respectant les exigences de confidentialité et de sécurité.
L'interopérabilité et l'accès conforme aux données pour usage secondaire restent également un domaine d'opportunité ciblé, à mesure que les réglementations sur les données de santé et les référentiels de certification renforcent le lien entre les systèmes de données cliniques et les piles de bioinformatique. Dans l'UE, le cadre EHDS offre une voie structurée pour l'utilisation transorganisationnelle des données dans la recherche et la médecine personnalisée, augmentant la valeur des plateformes conçues pour le consentement, la gouvernance et l'analyse fédérée. Aux États-Unis, les référentiels de certification de l'ONC (USCDI v3 à partir de janvier 2026) et les avancées FHIR pilotées par le SVAP renforcent les incitations à acquérir des systèmes capables de consommer des données cliniques standardisées et de restituer des résultats traçables, en particulier lorsque l'analytique nécessite des contrôles de cycle de vie et une auditabilité. Les fournisseurs et prestataires de services qui livrent des pipelines validés, une traçabilité des données et des environnements de collaboration préservant la confidentialité sont positionnés pour capter les dépenses à mesure que les organisations consolident des flux de travail fragmentés en infrastructure d'entreprise.
Recent Industry Developments in Marché de la bioinformatique
- Juin 2026 : Thermo Fisher Scientific a introduit de nouvelles plateformes de spectrométrie de masse Orbitrap lors de l'ASMS 2026, notamment l'Orbitrap Tribrid Apex. Une protéomique à plus haut débit augmente les exigences en aval pour des pipelines de bioinformatique robustes, accélérant la demande pour des logiciels d'analyse, de visualisation et d'interprétation évolutifs dans la biopharma et la recherche translationnelle.
- Mai 2026 : Illumina a annoncé une solution de recherche sur la maladie résiduelle moléculaire (MRD) basée sur le séquençage du génome entier, en accès anticipé. La MRD basée sur le WGS repousse les volumes de données et la complexité analytique au-delà des panels ciblés, augmentant l'importance de l'alignement optimisé, de l'appel de variants et de l'analytique longitudinale au sein de plateformes de bioinformatique intégrées.
- Février 2025 : QIAGEN a acquis Bioinformatics Solutions Inc. (BSI) pour renforcer ses capacités en analyse de données de protéomique et de spectrométrie de masse. L'accord a élargi la capacité de QIAGEN à fournir une analytique multi-omique intégrée et a soutenu les ventes croisées auprès des laboratoires exécutant à la fois des flux de séquençage et de protéomique.


Marché de la bioinformatique Portée du rapport et méthodologie de recherche
Définition et périmètre du marché
Ce marché couvre les revenus générés par les logiciels de bioinformatique, les plateformes, les outils de gestion des connaissances et les services analytiques payants utilisés pour stocker, traiter, visualiser et interpréter des données biologiques issues de domaines tels que la génomique, la transcriptomique, la protéomique et la métabolomique dans les principales régions.
Exclusions du périmètre : Nous excluons les instruments de séquençage et le matériel de laboratoire, ainsi que le calcul ou le stockage cloud générique vendu sans couche de flux de travail de bioinformatique.
Aperçu de la segmentation
- Par produits et services
- Outils de gestion des connaissances
- Plateformes de bioinformatique
- Plateformes d'analyse de séquences
- Plateformes d'alignement de séquences
- Plateformes de manipulation de séquences
- Plateformes d'analyse structurelle et fonctionnelle
- Plateformes d'intégration multi-omiques
- Services de bioinformatique
- Services de séquençage et de génération de données
- Construction et gestion de bases de données
- Services d'analyse et d'interprétation des données
- Bioinformatique en tant que service natif du cloud
- Par application
- Génomique et transcriptomique
- Protéomique et métabolomique
- Découverte et développement de médicaments
- Génomique microbienne (métagénomique et résistance aux antimicrobiens)
- Médecine de précision et personnalisée
- Autres applications
- Par utilisateur final
- Entreprises pharmaceutiques et biotechnologiques
- Instituts académiques et de recherche
- Laboratoires cliniques et de diagnostic
- Organisations de recherche sous contrat (ORC)
- Autres utilisateurs finaux
- Géographie
- Amérique du Nord
- États-Unis
- Canada
- Mexique
- Europe
- Allemagne
- Royaume-Uni
- France
- Italie
- Espagne
- Reste de l'Europe
- Asie-Pacifique
- Chine
- Japon
- Inde
- Corée du Sud
- Australie
- Reste de l'Asie-Pacifique
- Moyen-Orient et Afrique
- CCG
- Afrique du Sud
- Reste du Moyen-Orient et de l'Afrique
- Amérique du Sud
- Brésil
- Argentine
- Reste de l'Amérique du Sud
- Amérique du Nord
Sources de données, dimensionnement du marché et validation
Recherche documentaire
La recherche documentaire a été utilisée pour cartographier le bassin de la demande et pour construire des hypothèses pratiques reproductibles. Nous nous sommes appuyés sur des sources scientifiques et sanitaires publiques telles que le NCBI (NIH), le National Human Genome Research Institute, les indicateurs de santé et d'innovation de l'OCDE, les séries macroéconomiques de la Banque mondiale, ainsi que des sources comme l'OMS pour des signaux de santé plus larges.
Pour relier l'activité scientifique aux dépenses, nous avons également examiné les rapports annuels d'entreprises, les présentations de résultats, les annonces réglementaires et de financement, les articles évalués par des pairs et les publications d'associations traitant des volumes de séquençage, de l'adoption multi-omique et des charges de travail de bioinformatique. Le cas échéant, nous avons utilisé des abonnements payants limités aux données financières et de renseignement sur les entreprises, aux actualités et données financières, ainsi qu'aux bases de données de brevets pour recouper l'exposition aux revenus et les orientations technologiques. Les sources documentaires listées ici ne sont pas exhaustives, et nous avons examiné d'autres documents publics pour la collecte, la validation et la clarification des données selon les besoins.
Entretiens primaires et enquêtes
Les travaux primaires visaient à confirmer ce qui est réellement payé en bioinformatique, et ce qui est intégré dans des éléments adjacents tels que les services de laboratoire ou les dépenses cloud. Nous avons échangé avec un ensemble de fournisseurs de solutions, d'équipes de services, de responsables de la recherche et de fonctions achats en APAC, EMEA et dans les Amériques, afin de corriger puis de retester les hypothèses sur les prix, le calendrier d'adoption et la répartition des cas d'usage.
Répartition des répondants aux travaux de terrain de la recherche primaire
| Type d'entreprise | Poste du répondant | Région |
|---|---|---|
| Premier niveau : 27 % | Directeurs généraux (CXO) : 12 % | APAC : 38 % |
| Niveau intermédiaire : 59 % | Responsables fonctionnels/d'unité : 43 % | EMEA : 35 % |
| Acteurs de plus petite taille : 14 % | Managers : 45 % | Amériques : 27 % |
Dimensionnement du marché et prévisions
Le dimensionnement commence par une construction descendante dans laquelle les dépenses adressables en bioinformatique sont reconstituées à partir de l'activité de recherche multi-omique et clinique, puis filtrées par les taux d'adoption et de monétisation des plateformes, des outils et des services payants. Une fois cette structure établie, nous utilisons des vérifications ascendantes sélectives pour nous assurer que les totaux ne dérivent pas, notamment des ventilations de revenus échantillonnées issues de documents publics, des fourchettes de prix par poste ou par abonnement issues des entretiens, et des approximations volume × prix moyen pour les flux de travail couramment achetés.
Les principaux intrants utilisés dans le modèle comprennent les signaux de débit de séquençage et multi-omique, la part des projets utilisant la génomique et la transcriptomique par rapport à la protéomique et à la métabolomique, le glissement de la répartition entre les outils déployés sur site et dans le cloud, la progression typique des prix des licences et des abonnements, ainsi que la répartition des utilisateurs finaux entre biopharma, instituts académiques et autres groupes de clients. Lorsque les données ascendantes font défaut pour des géographies plus petites ou des applications de niche, nous avons comblé les lacunes à l'aide de ratios d'adoption par proxy ancrés à l'intensité du financement de la recherche et des publications, ces ratios ayant ensuite été soumis à des tests de résistance avec des experts.
Pour les prévisions, une analyse de scénarios a été utilisée avec une couche de régression multivariée dans laquelle la croissance est liée à des indicateurs tels que l'orientation du financement de la recherche, les tendances de la capacité de séquençage installée et les schmas de consommation des logiciels. Les hypothèses n'ont été finalisées qu'après que les retours primaires ont convergé sur ce à quoi ressemblent un cycle d'achat normal et un comportement de renouvellement pour les utilisateurs finaux à la fin de la période de prévision.
Validation des données et cycle de mise à jour
Les résultats ont été validés par triangulation avec des signaux indépendants, tels que l'intensité de la recherche régionale, les calendriers connus d'adoption multi-omique et les glissements observés entre les dépenses de plateformes et de services. Si un résultat par pays ou par application semblait hors norme, nous avons réexaminé les facteurs déterminants, puis effectué une revue en deuxième passe pour confirmer la logique unitaire, le traitement des devises et l'alignement des années.
Avant validation finale, le classeur complet est examiné par étapes afin que les erreurs soient détectées tôt et que les hypothèses restent cohérentes entre les régions et les utilisateurs finaux. Le rapport est actualisé annuellement, et des mises à jour intermédiaires sont effectuées lorsque des événements significatifs modifient le comportement de dépense ou les prix. Avant la livraison, un analyste effectue une nouvelle passe afin que les clients reçoivent la vue la plus récente et actualisée.
Estimation du marché mondial de la bioinformatique par Mordor Intelligence comparée à d'autres estimations publiées
Les différentes tailles publiées pour la bioinformatique ne concordent pas toujours, car les éléments inclus et l'année mesurée ne sont pas les mêmes, ce qui modifie le calcul avant même que les prévisions ne commencent. Les écarts proviennent également de la manière dont les prix sont traités pour les logiciels, les plateformes et les services, ainsi que de la vitesse d'adoption supposée dans les régions à forte croissance.
Les instruments de séquençage et le matériel de laboratoire se situent en dehors du périmètre de Mordor Intelligence, ce qui peut faire paraître certains totaux plus larges en technologies de l'information pour les sciences du vivant plus élevés lorsque ces revenus adjacents sont comptabilisés ensemble. Des écarts apparaissent également lorsqu'une source utilise une année de base différente, applique une expansion de prix plus agressive pour les abonnements logiciels, ou convertit les devises à un moment différent — et nous avons clairement observé ces effets lors de la réconciliation des mêmes régions et de la même répartition des utilisateurs finaux.
Comparaison de référence
| Source | Taille du marché | Lacunes dans la méthodologie de recherche |
|---|---|---|
| Mordor Intelligence | 19,97 milliards USD (2026) | |
| Éditeur sectoriel A | 18,69 milliards USD (2025) | Utilise une année de dimensionnement antérieure et une configuration d'année de base différente, ce qui décale le bassin de revenus de départ et peut sous-estimer la progression liée à la récente adoption multi-omique et aux évolutions de prix. |
| Cabinet de conseil mondial B | 31,74 milliards USD (2025) | Rapporte une valeur 2025 plus élevée qui reflète probablement des inclusions plus larges et des hypothèses d'escalade de prix plus agressives pour les logiciels et les services, ce qui pousse les totaux à la hausse avant que les vérifications d'adoption régionale ne soient appliquées. |
L'écart dans le tableau s'explique principalement par ce qui est comptabilisé comme revenu de bioinformatique, l'année utilisée pour la taille déclarée, et la manière dont la croissance des prix est appliquée aux dépenses portées par les logiciels. En maintenant les intrants liés à des signaux d'activité observables et en répétant les mêmes règles d'alignement des années et de périmètre entre les régions, l'estimation finale reste pratique à auditer et cohérente à mettre à jour.


Questions clés auxquelles répond le rapport
À quel rythme le marché de la bioinformatique devrait-il croître jusqu'en 2031 ?
Le marché de la bioinformatique devrait se développer de 19,97 milliards USD en 2026 à 37,03 milliards USD d'ici 2031, enregistrant un CAGR de 13,1 %.
Quelle catégorie de produits contribue actuellement le plus aux revenus ?
Les plateformes de bioinformatique ont contribué à hauteur de 48,1 % du chiffre d'affaires total en 2025, reflétant leur rôle central dans l'analyse de séquences et l'intégration multi-omiques.
Pourquoi les organisations de recherche sous contrat gagnent-elles des parts de marché ?
Les ORC développent l'infrastructure de bioinformatique auprès de plusieurs commanditaires, réduisant les coûts par projet et atteignant un CAGR projeté de 13,98 % de la demande jusqu'en 2031.
Pourquoi la médecine de précision est-elle importante pour la croissance du marché de la bioinformatique ?
La médecine de précision dépend de la traduction des données génomiques en actions cliniques, et les plateformes de bioinformatique fournissent l'analytique qui permet cette traduction.
Quelle région connaîtra la croissance la plus rapide d'ici 2031 ?
L'Asie-Pacifique devrait croître à un CAGR de 14,89 %, portée par les initiatives gouvernementales de génomique à grande échelle en Chine, en Inde et au Japon.
Comment les fournisseurs répondent-ils aux préoccupations en matière de sécurité des données ?
Les fournisseurs déploient des architectures de confiance zéro, un traitement local en périphérie et une analyse fédérée pour se conformer à la HIPAA et au RGPD tout en réduisant l'exposition aux attaques par rançongiciel.
Dernière mise à jour de la page le:



