
Taille et part du marché de la classification des données
VUE D’ENSEMBLE DU MARCHÉ
| Période d'étude | 2020 - 2031 |
|---|---|
| Taille du Marché (2026) | 2.28 Milliards de dollars |
| Taille du Marché (2031) | 5.98 Milliards de dollars |
| Growth Rate (2026 - 2031) | 21.28 % |
| Marché à la Croissance la Plus Rapide | Asie-Pacifique |
| Plus Grand Marché | Amérique du Nord |
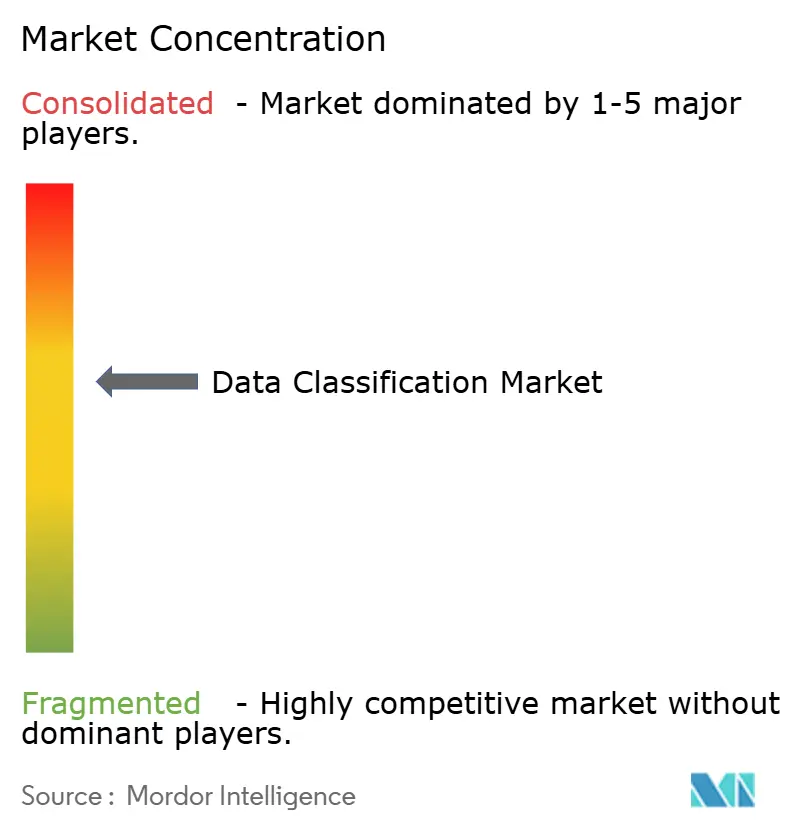
| Concentration du Marché | Moyen |
Acteurs majeurs *Avis de non-responsabilité : les principaux acteurs sont triés sans ordre particulier Image © Mordor Intelligence. La réutilisation nécessite une attribution sous CC BY 4.0. | |
Analyse du marché de la classification des données par Mordor Intelligence
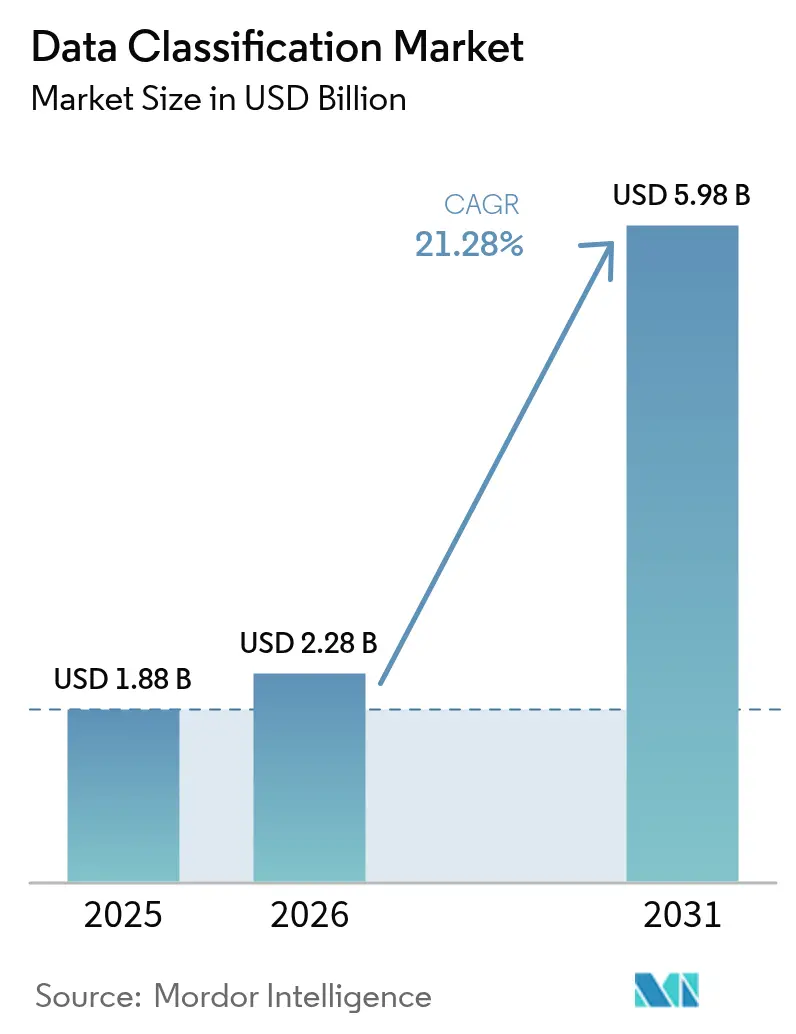
La taille du marché de la classification des données en 2026 est estimée à 2,28 milliards USD, en hausse par rapport à la valeur de 2025 de 1,88 milliard USD, avec des projections pour 2031 indiquant 5,98 milliards USD, croissant à un TCAC de 21,28 % sur la période 2026-2031. La croissance rapide des données, estimée à 328,77 millions de To créés chaque jour, et des mandats mondiaux de confidentialité plus stricts poussent les entreprises à adopter l'étiquetage des données en temps réel, alimenté par l'IA, qui s'adapte aux environnements cloud hybrides. Les moteurs de classification alimentés par l'IA intégrés dans des architectures cloud natives détectent désormais les informations sensibles dans les référentiels non structurés, tandis que les initiatives de cloud souverain en Asie-Pacifique stimulent la demande régionale. Le paysage des menaces croissant, où le coût moyen d'une violation dans le secteur de l'énergie a atteint 4,78 millions USD en 2024, souligne davantage l'urgence d'une gouvernance automatisée. Les investissements des hyperscalers tels qu'AWS et Microsoft dans des centres de données régionaux ajoutent de l'élan en réduisant la latence et en respectant les règles de résidence des données.
Points clés du rapport
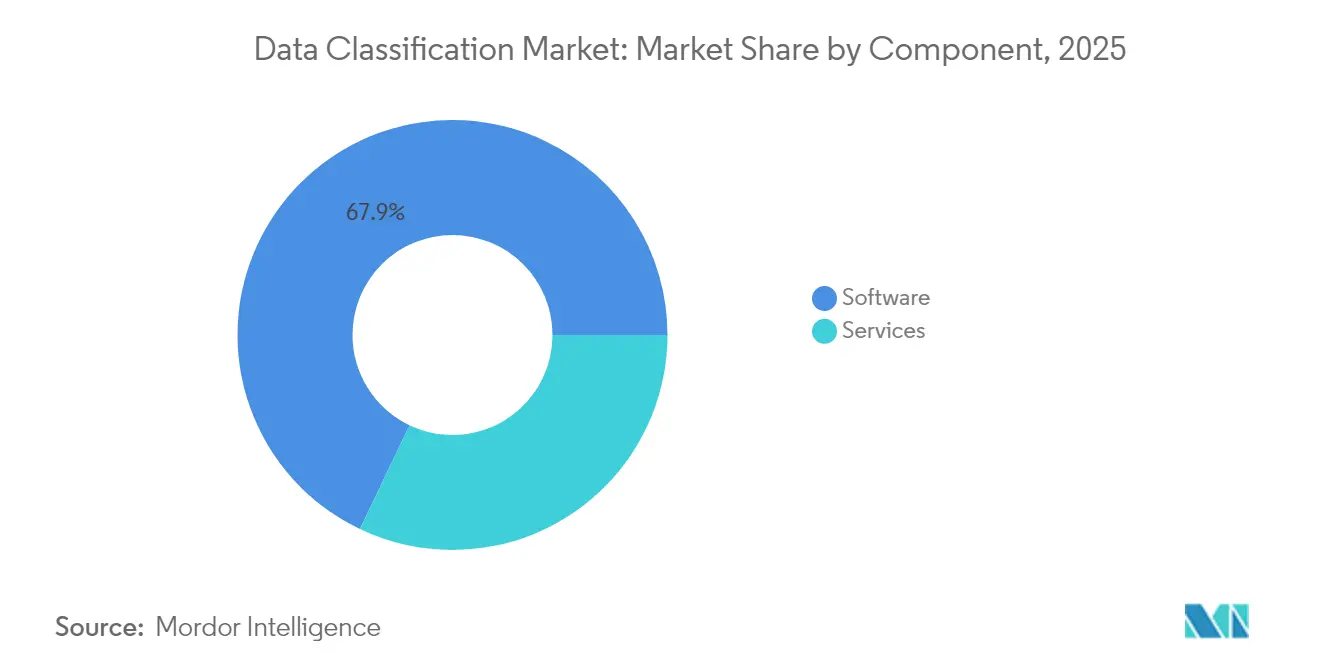
- Par composant, les logiciels ont dominé avec une part de revenus de 67,92 % en 2025, tandis que les services devraient croître à un TCAC de 23,62 % jusqu'en 2031.
- Par méthode de classification, les modèles basés sur le contenu ont capturé une part de 42,76 % en 2025 ; les approches pilotées par l'apprentissage automatique devraient se développer à un TCAC de 22,44 % jusqu'en 2031.
- Par taille d'organisation, les grandes entreprises détenaient 70,55 % de la part du marché de la classification des données en 2025, tandis que le segment des PME devrait croître à un TCAC de 23,29 %.
- Par application, le contrôle d'accès et l'IAM représentaient 56,12 % de la taille du marché de la classification des données en 2025 ; la gouvernance et la conformité progressent à un TCAC de 22,91 %.
- Par secteur vertical, le BFSI a contribué à hauteur de 35,12 % des revenus en 2025 ; le gouvernement et la défense sont positionnés pour une croissance de 21,78 % de TCAC.
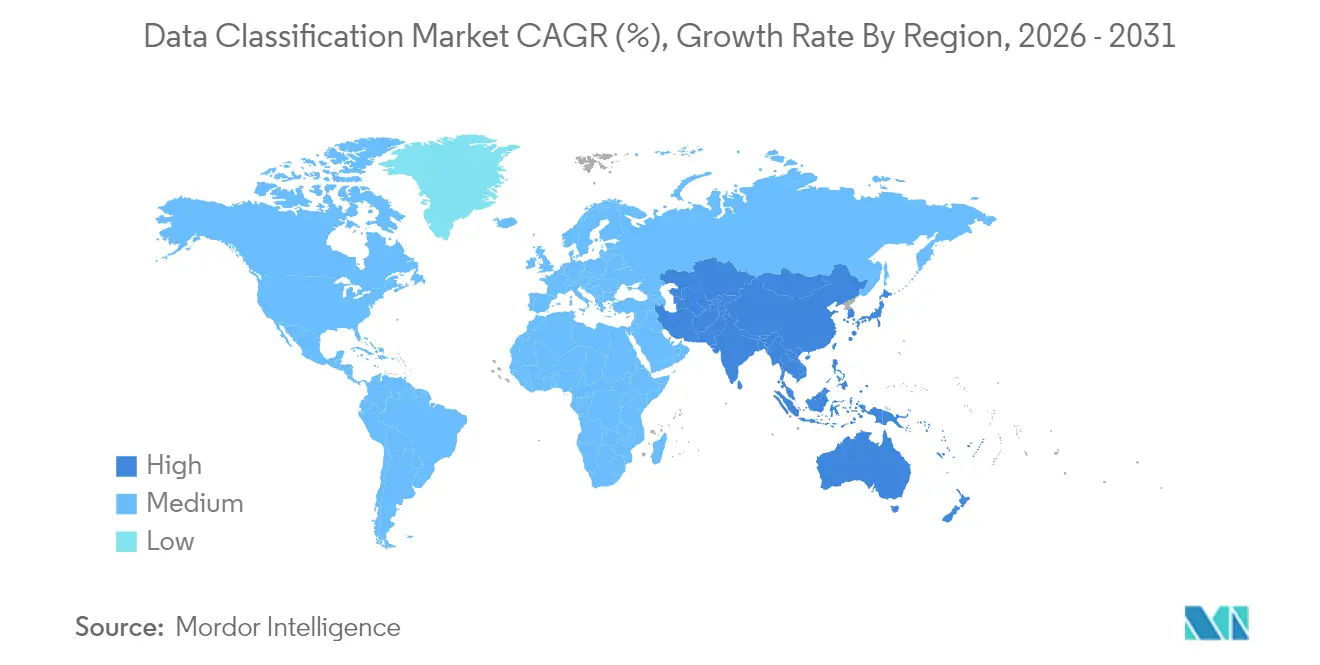
- Par géographie, l'Amérique du Nord commandait 40,62 % de part en 2025, mais l'Asie-Pacifique devrait enregistrer un TCAC de 22,07 % jusqu'en 2031.
Remarque : Les chiffres de la taille du marché et des prévisions de ce rapport sont générés à l’aide du cadre d’estimation propriétaire de Mordor Intelligence, mis à jour avec les données et analyses les plus récentes disponibles en 2026.
Tendances et Analyses du Marché
Analyse de l'impact des moteurs*
| Moteur | (~) % d'impact sur les prévisions de TCAC | Pertinence géographique | Horizon temporel d'impact |
|---|---|---|---|
| Expansion des mandats mondiaux de confidentialité | +4.2% | Mondial, avec un impact concentré dans l'UE, l'Amérique du Nord et l'APAC | Moyen terme (2-4 ans) |
| Croissance explosive des données non structurées et risque de violation | +3.8% | Mondial, particulièrement aigu en Amérique du Nord et en Europe | Court terme (≤ 2 ans) |
| Demande de classification des données cloud native | +3.5% | Cœur APAC, débordement vers le Moyen-Orient et l'Afrique et l'Amérique latine | Moyen terme (2-4 ans) |
| Classification automatique alimentée par l'IA/apprentissage automatique atteignant la production à grande échelle | +3.1% | Amérique du Nord et UE en tête, adoption rapide en APAC | Court terme (≤ 2 ans) |
| Jeux de puces d'informatique confidentielle permettant l'étiquetage en ligne | +2.4% | Amérique du Nord et certains marchés de l'UE | Long terme (≥ 4 ans) |
| Sécurité de l'IA générative nécessitant un étiquetage des données à granularité fine | +2.7% | Mondial, avec une adoption précoce dans les secteurs réglementés | Moyen terme (2-4 ans) |
| Source: Mordor Intelligence | |||
Expansion des mandats mondiaux de confidentialité
Les règles européennes DORA et les normes HIPAA mises à jour font passer la conformité des audits planifiés à la vérification continue, obligeant les entreprises à intégrer la logique de classification directement dans les flux de traitement des données[1]Registre fédéral américain, "Contrôles de sécurité et de confidentialité pour les systèmes d'information fédéraux," federalregister.gov. Les entreprises multinationales opérant dans plusieurs juridictions appliquent souvent l'exigence mondiale la plus stricte comme référence, ce qui accélère le déploiement d'architectures de classification unifiées. Les institutions financières doivent satisfaire aux obligations de déclaration anti-blanchiment d'argent en quelques minutes, ce qui accroît la demande de découverte pilotée par des politiques. Une pression similaire provient des lois latino-américaines sur la souveraineté des données qui s'alignent sur le RGPD. Ensemble, ces mandats raccourcissent les cycles d'approvisionnement, incitant même les entreprises de taille moyenne à adopter des outils SaaS qui mettent à jour les politiques automatiquement.
Croissance explosive des données non structurées et risque de violation
Les référentiels non structurés croissent de 62 % chaque année, laissant les équipes de sécurité aveugles quant aux détenteurs d'enregistrements sensibles. Les entreprises signalent des autorisations excessives sur 82 % des partages de fichiers, ce qui expose des conceptions précieuses et des données clients. Les services publics d'énergie subissent désormais 1 100 cyberattaques hebdomadaires, et les enquêtes sur les violations révèlent que des documents mal classifiés en sont une cause profonde. Les cabinets juridiques souffrent d'une exposition similaire car les fichiers clients se trouvent dans des lecteurs partagés sans étiquettes. La reconnaissance de modèles pilotée par l'IA est de plus en plus choisie car les ensembles de règles statiques ne peuvent pas suivre le rythme des plateformes de collaboration dynamiques.
Demande de classification des données cloud native
Soixante-quatre pour cent des organisations australiennes testent des stratégies de souveraineté, et près de la moitié des agences du secteur public de l'APAC prévoient d'adopter de tels contrôles dans l'année. Les moteurs de classification doivent fonctionner sur des empreintes multi-cloud tout en respectant les contraintes de résidence locales. Le partenariat de Microsoft d'une valeur de 1,5 milliard USD avec G42, basé aux Émirats arabes unis, met en évidence l'expansion régionale du calcul qui dépend de l'étiquetage intégré pour séparer les charges de travail réglementées. L'adoption du cloud souverain oblige les entreprises à maintenir des couches de politique doubles : des normes mondiales et des étiquettes spécifiques à la juridiction. Les fournisseurs qui automatisent ce mappage obtiennent une différenciation claire.
Classification automatique alimentée par l'IA/apprentissage automatique atteignant la production à grande échelle
Les entreprises signalent désormais des améliorations de 96 % de la qualité des données après avoir superposé l'apprentissage automatique aux pipelines de découverte existants. Forcepoint a intégré le modèle auto-apprenant de Getvisibility pour éliminer la création de règles longues, permettant à la précision de s'améliorer grâce aux retours en temps réel. Microsoft Purview fournit plus de 200 types d'informations intégrés qui étiquettent automatiquement le contenu dans Exchange, SharePoint et les ressources SQL. L'amélioration de la précision des modèles réduit les faux positifs, ce qui à son tour réduit la charge du service d'assistance et accélère l'adoption par les utilisateurs. Les PME en bénéficient le plus car elles manquaient auparavant de ressources pour le réglage manuel.
Analyse de l'impact des contraintes*
| Contrainte | (~) % d'impact sur les prévisions de TCAC | Pertinence géographique | Horizon temporel d'impact |
|---|---|---|---|
| Absence de normes de taxonomie intersectorielles | -2.1% | Mondial, avec des défis particuliers dans les marchés émergents | Long terme (≥ 4 ans) |
| Coût d'intégration élevé dans les environnements existants | -1.8% | Amérique du Nord et Europe avec une infrastructure informatique établie | Moyen terme (2-4 ans) |
| « Dette de classification » due à la prolifération des données synthétiques | -1.5% | Mondial, concentré dans les secteurs et régions à forte intensité d'IA | Moyen terme (2-4 ans) |
| Chiffrement homomorphe retardant l'inspection en texte clair | -1.2% | Amérique du Nord et UE en tête de l'adoption, déploiement sélectif en entreprise | Long terme (≥ 4 ans) |
| Source: Mordor Intelligence | |||
Absence de normes de taxonomie intersectorielles
Les régulateurs financiers classifient les données de risque différemment des autorités médicales, obligeant les fournisseurs à maintenir des bibliothèques de règles spécifiques au secteur. Les multinationales doivent concilier la terminologie du RGPD avec la définition chinoise des « données importantes » lors du transfert de fichiers. Cette fragmentation entraîne des efforts de codage personnalisé, accroît les craintes de dépendance vis-à-vis des fournisseurs et ralentit les décisions d'achat. Les alliances industrielles élaborent des propositions de schémas ouverts, mais l'adoption reste inégale. En conséquence, les intégrateurs tirent des revenus considérables des ateliers de mappage plutôt que des licences logicielles pures.
Coût d'intégration élevé dans les environnements existants
Les fournisseurs d'infrastructures critiques exploitent encore des systèmes mis en service il y a plus de 20 ans, dont beaucoup manquent d'API modernes[2]Thales Group, "Rapport sur la cybersécurité des infrastructures critiques," thalesgroup.com. La mise à niveau de la classification dans de tels environnements dépasse souvent 18 mois, pendant lesquels les risques de conformité restent non résolus. Les PME connaissent des frictions similaires car le personnel de sécurité rare doit équilibrer les opérations quotidiennes avec les projets de transformation. Les responsables budgétaires reportent parfois les déploiements de classification jusqu'à ce que des mises à niveau ERP plus larges soient planifiées. Les fournisseurs promeuvent désormais des connecteurs sans agent et des pipelines préconstruits pour réduire ces coûts, mais la complexité reste un inhibiteur clé.
*Nos prévisions considèrent les impacts des moteurs et des contraintes comme directionnels et non additifs. Les prévisions d'impact reflètent la croissance de référence, les effets de composition et les interactions entre variables.
Analyse des segments
Par composant :
les services propulsent la croissance au-delà des licences logiciellesLes logiciels ont continué à générer les revenus les plus élevés, représentant 67,92 % du marché de la classification des données en 2025. Les ventes de licences se sont concentrées sur les moteurs de politique, les robots d'exploration de découverte et les tableaux de bord SaaS. Néanmoins, les services professionnels et gérés se développent à un TCAC de 23,62 % car les entreprises ont besoin de conseils pour résorber la dette de classification accumulée. Les engagements commencent souvent par des analyses de plusieurs pétaoctets qui alimentent les arriérés de remédiation et sollicitent les ressources internes. Les fournisseurs de services gérés comblent les lacunes en compétences en gérant le réentraînement des modèles, les mises à jour réglementaires et le tri des tickets sur une base d'abonnement. Ces contrats peuvent s'étendre sur plusieurs années, ce qui fait passer les dépenses d'une dépense en capital unique à des dépenses d'exploitation récurrentes. Cette approche est bien accueillie par les conseils d'administration qui recherchent des budgets prévisibles et des preuves prêtes pour l'audit. En termes monétaires, les services pourraient représenter 2,16 milliards USD de la taille du marché de la classification des données d'ici 2031, reflétant leur importance stratégique. Les éditeurs de logiciels regroupent donc des capacités de conseil dans des niveaux premium pour protéger leurs marges.
Les implémentations de deuxième génération reposent sur un réglage continu plutôt que sur des bilans de santé annuels. Les partenaires de service construisent des pipelines DevSecOps qui déclenchent la classification chaque fois que de nouvelles données arrivent dans le stockage d'objets. Ils codifient également des taxonomies partagées entre les unités commerciales, ce qui comprime les délais d'intégration pour les acquisitions. La tendance élargit le marché de la classification des données car les entreprises de taille intermédiaire peuvent louer une expertise plutôt que d'embaucher des spécialistes rares. Les places de marché des fournisseurs répertorient désormais des offres de services organisées alignées sur les modèles ISO 27001, HIPAA ou PCI, démocratisant davantage l'adoption. À mesure que les revenus des services s'accélèrent, les intégrateurs de systèmes acquièrent des cabinets de conseil spécialisés pour renforcer les connaissances du domaine et sécuriser leur part de portefeuille.


Par méthode de classification :
l'apprentissage automatique redéfinit les références de précisionL'inspection basée sur le contenu détenait 42,76 % des dépenses en 2025 en exploitant les expressions régulières et les empreintes digitales pour signaler la propriété intellectuelle. Pourtant, les modèles pilotés par l'apprentissage automatique et sémantiques se développent à un TCAC de 22,44 % en apprenant le contexte à partir de millions de documents étiquetés. Les capacités aveugles aux modèles, telles que les réseaux de transformateurs qui analysent la structure des phrases, améliorent les taux de rappel et réduisent les fausses alertes. Microsoft Purview s'entraîne sur la télémétrie mondiale, ce qui alimente des actualisations régulières des modèles sans action du client. Digital Guardian superpose des signaux contextuels tels que la localisation et la posture de l'appareil sur les indices de contenu, permettant un étiquetage pondéré par le risque. Les approches combinées sont désormais livrées sous forme de packs préconfigurés afin que les administrateurs puissent intégrer progressivement de nouveaux moteurs sans perturber les activités.
Les premiers adoptants rapportent que l'apprentissage automatique améliore la productivité des examinateurs de 35 %, car moins d'éléments nécessitent une adjudication humaine. Les organisations disposant d'archives multilingues bénéficient d'avantages mesurables car les modèles sémantiques gèrent mieux la variance linguistique que les listes de mots-clés manuelles. Les fournisseurs ouvrent des API pour intégrer des ontologies spécifiques aux clients, apportant une précision sur mesure sans développement de zéro. Ce changement stimule le marché de la classification des données car il transforme ce qui était autrefois une capacité d'élite en une case à cocher SaaS. Les données d'entraînement restent néanmoins un goulot d'étranglement pour les domaines de niche, ce qui incite certaines entreprises à partager des corpus anonymisés dans le cadre d'accords de bénéfice mutuel. Sur l'horizon de prévision, l'adoption de l'apprentissage automatique devrait réduire le délai de rentabilisation de plusieurs trimestres à quelques semaines, cimentant son rôle de méthodologie par défaut.
Par taille d'organisation :
les plateformes cloud natives démocratisent l'étiquetage de niveau entrepriseLes grandes entreprises ont contribué à hauteur de 70,55 % des revenus de 2025 en raison de leur exposition réglementaire et de leur capacité budgétaire. Elles ont été les premières à adopter des suites de gouvernance intégrées couvrant les serveurs de fichiers sur site et les environnements multi-cloud. Néanmoins, les PME représentent désormais la cohorte à la croissance la plus rapide avec un TCAC de 23,29 %, bénéficiant des offres SaaS sans infrastructure. La plupart des plateformes se provisionnent en quelques heures et ne nécessitent que des connecteurs légers pour la messagerie, la collaboration et le stockage d'objets. Les niveaux d'abonnement alignent le coût sur l'utilisation, rendant les points d'entrée viables pour les entreprises de moins de 500 employés. Les modèles adaptés au contenu de santé, financier et juridique accélèrent le déploiement car les PME manquent de responsables de la conformité à temps plein.
Les ressources éducatives, telles que les ateliers communautaires de Microsoft, abaissent davantage les barrières en formant les généralistes informatiques à gérer les politiques de classification. Le cadre PUZZLE fournit des listes de contrôle pratiques qui permettent aux PME d'intégrer une sécurité minimale viable dans les charges de travail cloud. Les associations industrielles diffusent également des packs de règles open source afin que les membres puissent démarrer sans partir de pages blanches. À mesure que l'adoption s'élargit, les éditeurs de plateformes collectent des données de télémétrie qui améliorent la précision de l'apprentissage automatique pour tous les locataires, créant un effet d'entraînement qui bénéficie de manière disproportionnée aux petites entreprises. Ce modèle incite les places de marché à répertorier des connecteurs de niche pour les systèmes de comptabilité, de ressources humaines et de gestion de la relation client populaires dans le marché intermédiaire, élargissant la couverture sans scripts sur mesure.
Par application :
la gouvernance et la conformité passent au premier planLe contrôle d'accès et l'IAM ont absorbé 56,12 % des dépenses en 2025 car les autorisations pilotées par étiquettes constituent l'épine dorsale des politiques de confiance zéro. La protection des e-mails et des appareils mobiles a suivi, car les effectifs distribués partagent des documents sensibles via des canaux de messagerie instantanée et des appareils personnels. La croissance la plus rapide, à un TCAC de 22,91 %, se situe dans les tableaux de bord de gouvernance et de conformité qui présentent des métriques aux régulateurs et aux conseils d'administration. Ces outils s'appuient sur la télémétrie de classification pour visualiser la résidence, la rétention et la lignée des données. Ils exportent des rapports lisibles par machine pour les portails d'assurance automatisés, réduisant la préparation des audits de plusieurs semaines à quelques heures. La capacité devient critique dans le cadre de mandats de divulgation quasi en temps réel tels que la règle de cybersécurité de la SEC.
Les intégrations avec les moteurs de notation des risques permettent aux équipes de conformité de prioriser la remédiation en fonction de la criticité des données plutôt que du nombre de fichiers. Les tableaux de bord avancés intègrent des analyses prédictives qui estiment les amendes potentielles si des enregistrements mal étiquetés quittent une région. Par conséquent, les schémas de dépenses passent des plugins DLP ponctuels aux plateformes unifiées avec des analyses intégrées. Les fournisseurs positionnent les modules de conformité comme des leviers de croissance pilotés par les produits, offrant des niveaux de licence freemium qui révèlent les résultats de risque et orientent les ventes incitatives vers des suites complètes. La transparence qui en résulte favorise le parrainage des dirigeants, élargissant le marché de la classification des données au-delà du département de sécurité.

Par secteur vertical :
le gouvernement et la défense accélèrent leur trajectoire de dépensesLe BFSI a généré 35,12 % des revenus de 2025, alimenté par les règles de capital de Bâle III et les obligations de détection du blanchiment d'argent. Le secteur de la santé a suivi, porté par la modernisation de HIPAA et la poussée vers les dossiers de santé électroniques. L'expansion la plus rapide, à un TCAC de 21,78 %, concerne le gouvernement et la défense, où les exigences de confiance zéro et les flux de travail d'informations classifiées exigent un étiquetage précis. Le programme de sécurité de l'information du DoD mis à jour oblige les contractants à appliquer des règles de marquage uniformes dans les e-mails, les plateformes de collaboration et le stockage cloud. Les fenêtres de validation pour les restrictions de données techniques s'étendent désormais à 6 ans, garantissant des revenus de services soutenus. Les agences de défense investissent également dans l'étiquetage en ligne aux passerelles réseau pour prendre en charge des solutions sécurisées inter-domaines.
Les opérateurs d'infrastructures critiques, tels que les services publics expérimentant l'analyse de réseau intelligent, reproduisent de plus en plus les pratiques de niveau défense pour bloquer les menaces étatiques. Les stratégies nationales de données appellent à des installations cloud souveraines, qui à leur tour nécessitent une segmentation multi-locataires appliquée par des étiquettes de classification. Les grands intégrateurs de systèmes forment des coentreprises avec des entités du secteur public pour aligner les feuilles de route des produits sur les besoins opérationnels. Comme ces contrats spécifient souvent un hébergement domestique, la localisation renforce les empreintes SaaS régionales. La spécialisation verticale devient donc un différenciateur concurrentiel et assure des flux réguliers vers le marché de la classification des données.
Analyse géographique
Marché de la Classification des Données en Amérique du Nord
L'Amérique du Nord a conservé sa position de leader avec 40,62 % des revenus de 2025, car des réglementations strictes et une adoption précoce de l'IA ont poussé les entreprises à moderniser leurs programmes de découverte des données. Le tour de financement de 60 millions USD de BigID en 2025 illustre l'appétit des capital-risqueurs pour les solutions qui automatisent l'hygiène des données en amont des nouvelles règles de divulgation de la SEC. Les institutions financières déploient l'étiquetage pour satisfaire aux exigences de reporting intrajournalier, tandis que les prestataires de soins de santé intègrent les balises dans les dossiers médicaux électroniques afin de se conformer aux évolutions des extensions de l'HIPAA. Les lois provinciales canadiennes sur la protection de la vie privée reflètent les exigences fédérales, renforçant une demande constante. Les pôles technologiques mexicains adoptent des plateformes hébergées dans le cloud pour satisfaire aux clauses de transfert de données de l'ACEUM, bien que l'adoption se concentre dans les filiales multinationales.
Marché de la Classification des Données en Asie-Pacifique
L'Asie-Pacifique est la région à la croissance la plus rapide avec un CAGR de 22,07 %, reflétant les mandats de cloud souverain et les lourds investissements en infrastructure des hyperscalers. AWS a promis 6 milliards USD à la Malaisie et NTT s'est engagé à hauteur de 90 millions USD pour des centres de données à Bangkok, créant une capacité de calcul locale qui réduit la latence pour les moteurs de politique. La Chine propose d'assouplir les approbations de transfert de données transfrontalières, mais continue de classer de nombreux ensembles de données comme « importants », imposant des contrôles doubles. Le Japon et la Corée du Sud déploient la classification dans la fabrication 5G pour protéger les secrets commerciaux. Les exportateurs de services informatiques indiens exigent un étiquetage multi-locataires pour segmenter les données clients, élargissant ainsi le bassin adressable d'abonnés au cloud.
Marché de la Classification des Données en Europe
L'Europe se classe solidement en deuxième position par valeur, portée par la loi sur la résilience opérationnelle numérique qui exige des tests de contrôle continus d'ici 2025. Les usines Industrie 4.0 allemandes étiquettent les données opérationnelles pour protéger la propriété intellectuelle et se conformer aux audits de sécurité de la chaîne d'approvisionnement. Le Royaume-Uni équilibre l'adéquation post-Brexit avec les règles d'innovation nationales, de sorte que les entreprises surveillent les flux transfrontaliers dans le cadre de politiques doubles. La France promeut des zones de cloud souverain pour héberger les charges de travail du secteur public, tandis que l'Italie renforce les protections des infrastructures critiques. Les pays nordiques, premiers adoptants du RGPD, pilotent désormais des puces de calcul confidentiel permettant un étiquetage en ligne sans exposer le texte en clair, positionnant la région pour l'innovation de prochaine génération.

Paysage réglementaire
L'adoption de la classification des données est directement influencée par les régimes de sécurité et de confidentialité qui formalisent la manière dont les informations sensibles sont étiquetées, contrôlées et parfois conservées dans le pays. En Chine, la norme GB/T 43697-2024 (publiée par la State Administration for Market Regulation, entrée en vigueur le 1er octobre 2024) propose une approche structurée de la classification et de la hiérarchisation des données. Les réglementations de la RPC sur la gestion de la sécurité des données de réseau (adoptées en août 2024, en vigueur depuis le 1er janvier 2025) exigent une protection catégorisée et classifiée des données de réseau en fonction de leur importance pour la sécurité, ce qui renforce les exigences de conformité pour les entreprises exploitant des flux de données transfrontaliers.
Aux États-Unis, les directives du NIST continuent d'ancrer les contrôles opérationnels et la terminologie utilisée par de nombreux programmes mondiaux, notamment NIST SP 800-53 Rev. 5 et NIST IR 8496 (2023) pour le langage de classification de référence soutenant les mises en œuvre Zero Trust. De nouvelles exigences de souveraineté et de résidence des données émergent également : le décret exécutif n° 119 des Philippines (signé le 13 juillet 2026) établit un cadre obligatoire de classification et de résidence des données gouvernementales qui distingue les données à accès restreint des données à accès libre. Cela renforce le marquage tenant compte des juridictions et l'application de la résidence des données en tant qu'exigences d'approvisionnement pour les outils et services concernés.
Analyse de la chaîne de valeur
La chaîne de valeur commence par la définition des politiques et de la taxonomie, puis la découverte et l'inventaire des données dans les référentiels structurés et non structurés. Elle se poursuit avec l'exécution du moteur de classification (contenu, contexte, rôle et modèles ML/sémantiques), suivie de l'application des politiques (IAM/ABAC, DLP, chiffrement, conservation), et se termine par le reporting et les preuves pour les audits et les contrôles continus. Les hyperscalers et les plateformes de gouvernance (par exemple, Microsoft Purview et les piles natives cloud d'AWS et d'autres) fournissent des contrôles et connecteurs intégrés, tandis que les éditeurs spécialisés ajoutent une analyse approfondie du contenu et des tableaux de bord de confidentialité. La prestation est assurée par des intégrateurs de systèmes, des fournisseurs de services de sécurité managés et des cabinets de conseil qui effectuent des analyses multi-pétaoctets, ajustent les modèles, cartographient les taxonomies sectorielles et maintiennent les mises à jour des politiques, soutenant ainsi le glissement du marché vers des services récurrents associés au logiciel.
Les principaux points de blocage se situent au niveau de l'harmonisation des taxonomies et des couches d'intégration. La fragmentation des définitions entre secteurs et juridictions accroît les besoins de personnalisation, tandis que les parcs existants sans API modernes prolongent les cycles de déploiement et augmentent la dépendance aux services. Les architectures de cloud souverain et de secteurs réglementés ajoutent des exigences en matière de contrôle cryptographique et de segmentation, comme l'illustre Deutsche Telekom qui construit une plateforme de données souveraine sur Google Cloud avec gestion externe des clés et chiffrement préservant le format pour répondre au RGPD et aux exigences allemandes en matière de confidentialité des télécommunications. Les normes et guides pratiques tels que le projet de guide pratique du NIST NCCoE sur la découverte et l'étiquetage des données non structurées (SP 1800-39 IPD, février 2026) alimentent l'écosystème en donnant aux acheteurs des modèles de référence exploitables que les éditeurs et intégrateurs transforment en accélérateurs packagés.
Paysage concurrentiel
Le marché de la classification des données présente une fragmentation modérée car les fournisseurs cloud hyperscale et les entreprises de sécurité spécialisées se disputent la part de plateforme. Microsoft Purview intègre l'étiquetage dans Azure, Microsoft 365 et les services SQL, offrant une gouvernance en guichet unique qui attire les grandes entreprises. AWS, Google Cloud et IBM intègrent des contrôles similaires dans les API de stockage, réduisant les frictions d'adoption pour les développeurs. Des fournisseurs spécialisés tels que Varonis et BigID se différencient par des analyses de contenu approfondies et des tableaux de bord de confidentialité qui visualisent la lignée des données. Des acteurs émergents comme Cyera se concentrent sur la gestion de la posture de sécurité des données cloud native, attirant des financements rapides et accélérant l'innovation.
L'activité d'acquisition remodèle la dynamique concurrentielle. Forcepoint a acquis Getvisibility pour associer des modèles auto-apprenants à son moteur DLP, améliorant la précision dans les clouds hybrides. Capgemini a racheté Syniti pour fusionner les services de qualité des données avec le conseil en gouvernance, élargissant les offres à valeur ajoutée. L'acquisition de Reka AI par Snowflake et l'achat de MosaicML par Databricks illustrent la convergence des capacités d'analyse, d'IA et d'étiquetage. Ces mouvements répondent à la préférence des acheteurs pour des plateformes consolidées qui réduisent la complexité des licences et intègrent les preuves de conformité.
Les modèles de tarification évoluent vers des niveaux basés sur la consommation liés aux téraoctets analysés et aux utilisateurs protégés. Les fournisseurs regroupent des kits de démarrage avec des taxonomies préconstruites pour accélérer le délai de rentabilisation. Les partenaires de distribution construisent des accélérateurs verticaux qui codifient les réglementations sectorielles, créant des écosystèmes fidélisants. L'avantage concurrentiel se concentre de plus en plus sur le retour sur investissement démontrable, les fournisseurs mettant en avant l'évitement des coûts de violation et les économies de ressources d'audit. Les nouveaux entrants proposant des solutions ponctuelles étroites subissent des pressions à mesure que les clients se consolident autour de suites intégrées soutenues par des réseaux de support mondiaux.
Leaders du secteur de la classification des données
Amazon Web Services, Inc.
Boldon James Ltd (QinetiQ)
IBM Corporation
Microsoft Corporation
Broadcom Inc. (Symantec Corporation)
- *Avis de non-responsabilité : les principaux acteurs sont triés sans ordre particulier
Marché de la Classification des Données
- Amazon Web Services
- Microsoft Corporation
- IBM Corporation
- Broadcom (Symantec)
- Google LLC
- OpenText (TITUS)
- Thales Group
- Fortra (Boldon James)
- SECLORE
- Digital Guardian
- Forcepoint
- Varonis Systems
- BigID Inc.
- Concentric AI
- Netwrix Corporation
- Spirion LLC
- Immuta Inc.
- OneTrust LLC
- PKWARE Inc.
- Palo Alto Networks
Lire l’analyse des entreprises de classification des données

Opportunités de marché et perspectives d'avenir
La transformation en produit de la classification automatisée au sein des plateformes de données centrales élargit le bassin d'acheteurs adressables au-delà des outils autonomes, en particulier pour les données semi-structurées et non structurées qui représentent la majeure partie de l'exposition à la conformité et aux violations de données. En 2026, Snowflake a rendu disponible en version générale la classification des données sensibles pour les types de données JSON semi-structurées (VARIANT, ARRAY, OBJECT). Databricks a rendu disponible en version générale la classification automatisée des données dans Unity Catalog, avec un contrôle d'accès basé sur les attributs, en la reliant explicitement à des contextes de conformité tels que le RGPD et l'HIPAA. L'intégration au niveau de la plateforme crée un espace pour les éditeurs et fournisseurs de services afin de proposer des connecteurs, des packs de taxonomie et des flux de gouvernance couvrant les parcs hybrides et reliant directement les étiquettes à l'application des contrôles (contrôles de lignes/colonnes, DLP et politiques d'accès).
Des opportunités s'ouvrent également autour des modèles opérationnels de l'ère de l'IA, où la classification devient un prérequis pour une utilisation sûre de l'IA générative et pour l'application des contrôles à grande échelle sur les services de collaboration et de cloud. Cloudflare a ajouté la classification des données dans les profils DLP (avril 2026), et AWS a introduit une approche par agent IA pour la classification automatisée dans Amazon SageMaker Catalog (mars 2026), reflétant une évolution vers une découverte assistée par agents et une intégration plus rapide des nouveaux jeux de données. L'intérêt des acheteurs pour des pratiques auditables et reproductibles est renforcé par des travaux d'orientation du secteur public tels que le projet SP 1800-39 du NIST NCCoE (période de commentaires ouverte jusqu'au 30 mars 2026), qui soutient la demande de services de mise en œuvre traduisant les architectures de référence en politiques de production, preuves de tests et procédures opérationnelles dans les secteurs réglementés et les déploiements de cloud souverain.
Recent Industry Developments in Marché de la Classification des Données
- Juillet 2026 : Microsoft a lancé une feuille de route en préversion publique pour intégrer Microsoft Purview Data Loss Prevention avec Entra Internet Access afin d'étendre les contrôles basés sur la classification à la couche réseau. Cette feuille de route vise à empêcher le téléchargement de données sensibles vers des services d'IA non autorisés et des destinations non gérées. Elle élargit également l'application au-delà des points de terminaison et des fichiers, renforçant la gouvernance dans les environnements de travail hybride et fortement dépendants du SaaS.
- Juin 2025 : IBM a présenté un nouveau logiciel pour unifier la gouvernance et la sécurité de l'IA agentique, alignant les contrôles de politique sur la manière dont les agents automatisés accèdent aux données de l'entreprise et les utilisent. Cette annonce renforce la convergence de la classification des données, des preuves de gouvernance et des contrôles de sécurité de l'IA au sein de plateformes unifiées. Pour les acheteurs, elle soutient les stratégies de consolidation des fournisseurs où la classification et la télémétrie d'application alimentent la même couche de gouvernance.
- Décembre 2024 : Microsoft a annoncé de nouvelles capacités Microsoft Purview visant à protéger et gouverner les données à l'ère de l'IA, élargissant la manière dont les étiquettes de sensibilité et les contrôles associés sont appliqués dans les environnements Microsoft. Cette mise à jour a accru la couverture pratique de la classification et de l'application des politiques sur les services de collaboration et de données. Elle a également renforcé l'effet d'entraînement des suites intégrées, où l'étiquetage se connecte directement aux contrôles d'accès et au reporting de conformité.


Marché de la Classification des Données Portée du rapport et méthodologie de recherche
Définition et périmètre du marché
Ce marché couvre les logiciels et services associés utilisés pour identifier, marquer et étiqueter les données d'entreprise afin qu'elles puissent être traitées correctement en matière de sécurité, de gouvernance et de conformité dans les environnements cloud, sur site et hybrides.
Exclusions du périmètre : nous excluons les outils généraux de catalogue de données, de découverte de données et d'étiquetage de données utilisés principalement pour l'entraînement de modèles d'IA lorsqu'ils ne sont pas vendus ou positionnés comme des offres de classification des données.
Aperçu de la segmentation
- Par composant
- Logiciels
- Services
- Par méthode de classification
- Basée sur le contenu
- Basée sur le contexte
- Basée sur l'utilisateur/le rôle
- Pilotée par l'apprentissage automatique et sémantique
- Par taille d'organisation
- Grandes entreprises
- Petites et moyennes entreprises (PME)
- Par application
- Contrôle d'accès et IAM
- Gouvernance et conformité
- Protection des e-mails et des appareils mobiles
- Par secteur vertical
- BFSI
- Santé et sciences de la vie
- Gouvernement et défense
- Technologies de l'information et télécommunications
- Énergie et services publics
- Autres secteurs verticaux
- Par géographie
- Amérique du Nord
- États-Unis
- Canada
- Mexique
- Europe
- Allemagne
- Royaume-Uni
- France
- Italie
- Espagne
- Reste de l'Europe
- Asie-Pacifique
- Chine
- Japon
- Inde
- Corée du Sud
- Australie
- Reste de l'Asie-Pacifique
- Amérique du Sud
- Brésil
- Argentine
- Reste de l'Amérique du Sud
- Moyen-Orient et Afrique
- Moyen-Orient
- Arabie saoudite
- Émirats arabes unis
- Turquie
- Reste du Moyen-Orient
- Afrique
- Afrique du Sud
- Égypte
- Nigéria
- Reste de l'Afrique
- Moyen-Orient
- Amérique du Nord
Sources de données, dimensionnement du marché et validation
Recherche documentaire
La recherche documentaire commence par l'établissement du contexte de la demande et du cadre politique de la classification des données, puis relie cela aux dépenses habituelles des entreprises en outils et services de ce type. Nous nous appuyons principalement sur des sources publiques et réglementaires telles que les directives du NIST, les avis de la CISA et les règles de divulgation de cybersécurité de la SEC, car ces exigences influencent les priorités d'adoption et les calendriers d'achat.
Pour les données de marché, nous examinons également des sources telles que les indicateurs de l'économie numérique de l'US Census et d'Eurostat, les publications de l'OCDE sur la sécurité numérique, et les rapports de l'ENISA sur les pratiques de cloud et de protection des données. Ces sources sont complétées par les rapports annuels des entreprises, les transcriptions des appels de résultats, la documentation produit et une couverture médiatique reconnue, afin de saisir le packaging, les modèles de déploiement et le parcours d'achat type. Dans certains cas, nous utilisons des abonnements payants pour les données financières des entreprises et les bases de données de brevets afin de vérifier l'orientation des revenus et l'intensité de l'innovation, tout en conservant la liste des sources documentaires NIST, CISA et SEC comme point d'ancrage de la couverture. Cette liste de sources documentaires n'est pas exhaustive, et des sources supplémentaires ont été utilisées pour des vérifications croisées et des clarifications.
Entretiens et enquêtes primaires
Les entretiens primaires servent à confirmer ce qui constitue une dépense de classification des données, et à tester les principaux moteurs d'adoption tels que l'urgence réglementaire, la migration vers le cloud et la maturité de la posture de sécurité. Nous nous sommes entretenus avec un mélange de fournisseurs de solutions, de partenaires de distribution et d'utilisateurs finaux au sein des équipes IT, sécurité et risque, avec des entretiens couvrant l'APAC, l'EMEA et les Amériques afin que les différences régionales d'achat soient reflétées dans le modèle final.
Répartition des répondants à l'étude de terrain primaire
| Type d'entreprise | Poste du répondant | Région |
|---|---|---|
| Premier rang : 38 % | Directeurs (CXO) : 12 % | APAC : 43 % |
| Rang intermédiaire : 47 % | Responsables fonctionnels/d'unité : 29 % | EMEA : 34 % |
| Acteurs plus petits : 15 % | Managers : 59 % | Amériques : 23 % |
Dimensionnement du marché et prévisions
Le dimensionnement est construit selon une logique descendante et ascendante. Nous partons d'un bassin de demande descendant reconstitué à partir des schémas de dépenses des entreprises en matière de sécurité et de conformité, puis nous le restreignons à la part attribuable aux cas d'usage de classification des données. Pour garder le modèle ancré dans la réalité, nous l'appuyons sur des variables de marché telles que la croissance des volumes de données d'entreprise, les niveaux d'adoption du cloud et des architectures hybrides, l'activité réglementaire et d'audit, les tendances en matière de violations de données et de risques internes, et la part des charges de travail nécessitant des contrôles d'accès et de gouvernance.
Après avoir établi le bassin de demande, nous corroborons les totaux à l'aide d'approximations ascendantes sélectives, notamment des signaux de revenus de fournisseurs échantillonnés, des vérifications de canaux sur les tailles de transactions habituelles, et une vue de l'ASP par mode de déploiement (abonnement cloud contre licences sur site plus services). Lorsque les offres groupées de produits créent des lacunes de mesure, les dépenses ne sont allouées que lorsque la fonctionnalité de classification est clairement tarifée, contractualisée ou activement déployée. Ces allocations sont ensuite revérifiées à l'aide des retours d'entretiens.
Les prévisions utilisent une analyse de scénarios avec un lissage de tendance à court terme sur les indicateurs clés, car les changements de politique et les incidents de sécurité peuvent modifier rapidement les budgets. Le scénario de base est ajusté à l'aide d'avis d'experts sur le rythme d'automatisation des flux de classification, les taux d'attachement de services attendus, et la rapidité avec laquelle les secteurs réglementés élargissent leur couverture des types de données.
Validation des données et cycle de mise à jour
La validation s'effectue par des vérifications croisées répétées à travers le modèle. Nous comparons les résultats à des indicateurs indépendants tels que la croissance des logiciels de sécurité, l'expansion des charges de travail cloud et les tendances rapportées en matière d'investissement en conformité. Si un segment ou une région présente une hausse inhabituelle, nous réexaminons les hypothèses sous-jacentes, et les répondants sont recontactés lorsque l'écart ne peut être expliqué par des indicateurs publics.
Avant validation finale, nous effectuons une revue en plusieurs étapes afin que la logique de calcul, le traitement des devises et l'alignement des années restent cohérents dans les tableaux et les analyses. Les rapports sont actualisés annuellement, et des mises à jour intermédiaires sont effectuées lorsque des événements importants surviennent, tels que des actions majeures d'application réglementaire ou des variations marquées des dépenses IT des entreprises. Juste avant la livraison, nous effectuons une nouvelle passe de mise à jour afin que les clients reçoivent la vision la plus récente disponible.
Taille du marché de la classification des données selon Mordor Intelligence comparée à d'autres estimations publiées
Les valeurs de marché publiées pour la classification des données peuvent varier largement car le marché est défini différemment, l'année de base n'est pas la même, et les services ne sont pas toujours traités de manière cohérente. Nous constatons également des écarts lorsque les études utilisent un calendrier de devises différent, supposent une croissance plus rapide que celle observée, ou ne revérifient pas les hypothèses avec les retours des praticiens.
Une divergence fréquente concerne le fait de savoir si des domaines connexes tels que la découverte de données, le catalogage ou des plateformes de gouvernance des données plus larges sont comptabilisés dans le même bassin de revenus, puis projetés comme un seul marché. Certaines estimations utilisent également des horizons de prévision plus longs qui s'accumulent naturellement en valeurs finales plus élevées, et elles peuvent appliquer un taux de croissance annuel composé (TCAC) unique et élevé sans le tester par rapport à des indicateurs à court terme tels que les projets d'origine réglementaire ou le rythme de migration vers le cloud. Mordor Intelligence limite le total au logiciel de classification des données et aux services professionnels ou managés associés, et nous excluons les plateformes plus larges à moins que les dépenses de classification puissent être isolées et validées.
Comparaison de référence
| Source | Taille du marché | Lacunes de la méthodologie de recherche |
|---|---|---|
| Mordor Intelligence | 2,28 milliards USD (2026) | |
| Cabinet de conseil mondial A | 1,85 milliard USD (2024) | Utilise une année de base antérieure avec une fenêtre historique plus courte et applique une trajectoire de croissance plus rapide jusqu'en 2030, ce qui peut rehausser la courbe prospective même si l'attachement de services à court terme est plus faible. |
| Éditeur sectoriel B | 1,94 milliard USD (2024) | Utilise une vue de segmentation large et une fenêtre de prévision différente jusqu'en 2035, et la période de composition plus longue peut inflater la valeur finale du marché par rapport à une prévision à moyen terme plus resserrée. |
Le tableau indique que les choix de calendrier et de périmètre expliquent une grande partie de l'écart, avant même de prendre en compte la technique de prévision. Notre approche reste traçable à des moteurs de dépenses spécifiques, sépare le logiciel des services lorsque cela est possible, puis utilise des vérifications basées sur des entretiens pour maintenir les totaux alignés sur ce que les acheteurs mettent réellement en œuvre.


Questions clés auxquelles le rapport répond
Quelle est la taille actuelle du marché de la classification des données ?
Le marché est évalué à 2,28 milliards USD en 2026 et devrait atteindre 5,98 milliards USD d'ici 2031, représentant un TCAC de 21,28 %.
Quelle région connaît la croissance la plus rapide ?
L'Asie-Pacifique affiche la croissance la plus élevée, avec un marché de la classification des données qui devrait afficher un TCAC de 22,07 % jusqu'en 2031 en raison des mandats de cloud souverain et des investissements en infrastructure.
Quel segment de composant se développe le plus rapidement ?
Les services croissent à un TCAC de 23,62 % car les organisations ont besoin de conseils professionnels pour déployer et maintenir l'étiquetage alimenté par l'IA dans les environnements hybrides.
Comment les méthodes d'apprentissage automatique impactent-elles l'adoption ?
La classification pilotée par l'apprentissage automatique améliore la précision, réduit les faux positifs et diminue le réglage manuel, aidant les petites entreprises à accéder à une protection de niveau entreprise.
Quels secteurs investissent le plus massivement ?
Le BFSI est en tête des dépenses actuelles grâce à des réglementations strictes, tandis que le gouvernement et la défense affichent la croissance la plus rapide à un TCAC de 21,78 % en raison des exigences de sécurité nationale.
Quelle est la principale contrainte à un déploiement plus large ?
L'intégration de la classification dans les environnements existants reste coûteuse et chronophage, en particulier pour les secteurs d'infrastructures critiques qui exploitent encore des systèmes obsolètes.
Dernière mise à jour de la page le:



