
Tamaño y Participación del Mercado de Data Lake
Visión General del Mercado
| Período de Estudio | 2020 - 2031 |
|---|---|
| Tamaño del Mercado (2026) | 22.8 Mil millones de dólares |
| Tamaño del Mercado (2031) | 61.84 Mil millones de dólares |
| Growth Rate (2026 - 2031) | 22.08 % |
| Mercado de Crecimiento Más Rápido | Asia |
| Mercado Más Grande | América del Norte |
| Concentración del Mercado | Medio |
Jugadores principales *Nota aclaratoria: los principales jugadores no se ordenaron de un modo en especial Imagen © Mordor Intelligence. El uso requiere atribución según CC BY 4.0. | |
Análisis del Mercado de Data Lake por Mordor Intelligence
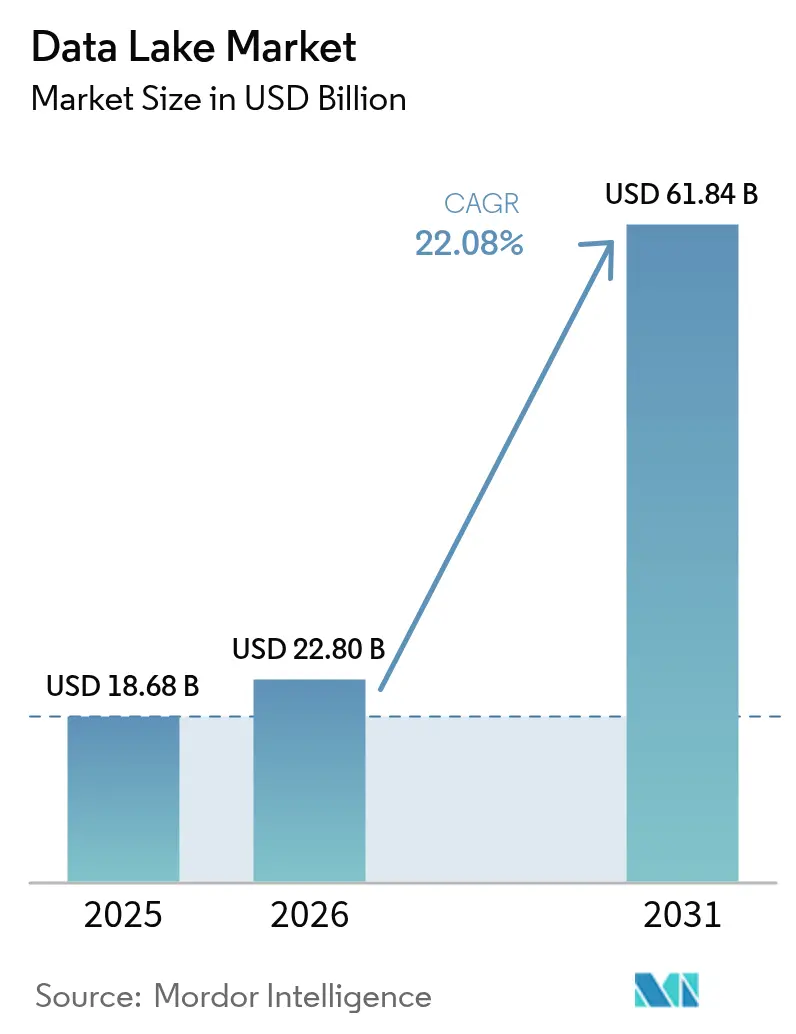
Se espera que el tamaño del mercado de data lakes crezca de USD 18,68 mil millones en 2025 a USD 22,8 mil millones en 2026 y se prevé que alcance USD 61,84 mil millones en 2031 a una CAGR del 22,08% durante 2026-2031. El crecimiento se debe al aumento de los volúmenes de datos no estructurados generados por las canalizaciones de IA generativa, la expansión de los mandatos regulatorios de mantenimiento de registros y el cambio hacia arquitecturas de tipo lakehouse que consolidan los entornos de lago y almacén de datos en un único nivel. Las empresas Fortune 500 reportan ahorros del 35-40% en el costo total de propiedad tras adoptar los lakehouses, mientras que las cargas de trabajo en tiempo real de ESG y pruebas de estrés de riesgo están ampliando los casos de uso hacia los sectores industrial y financiero. Los formatos de tabla abierta sin servidor anclan ahora las estrategias de portabilidad multinube, y están surgiendo capas de gobernanza automatizada para prevenir los problemas de "pantano de datos" sin frenar la innovación.
Conclusiones Clave del Informe
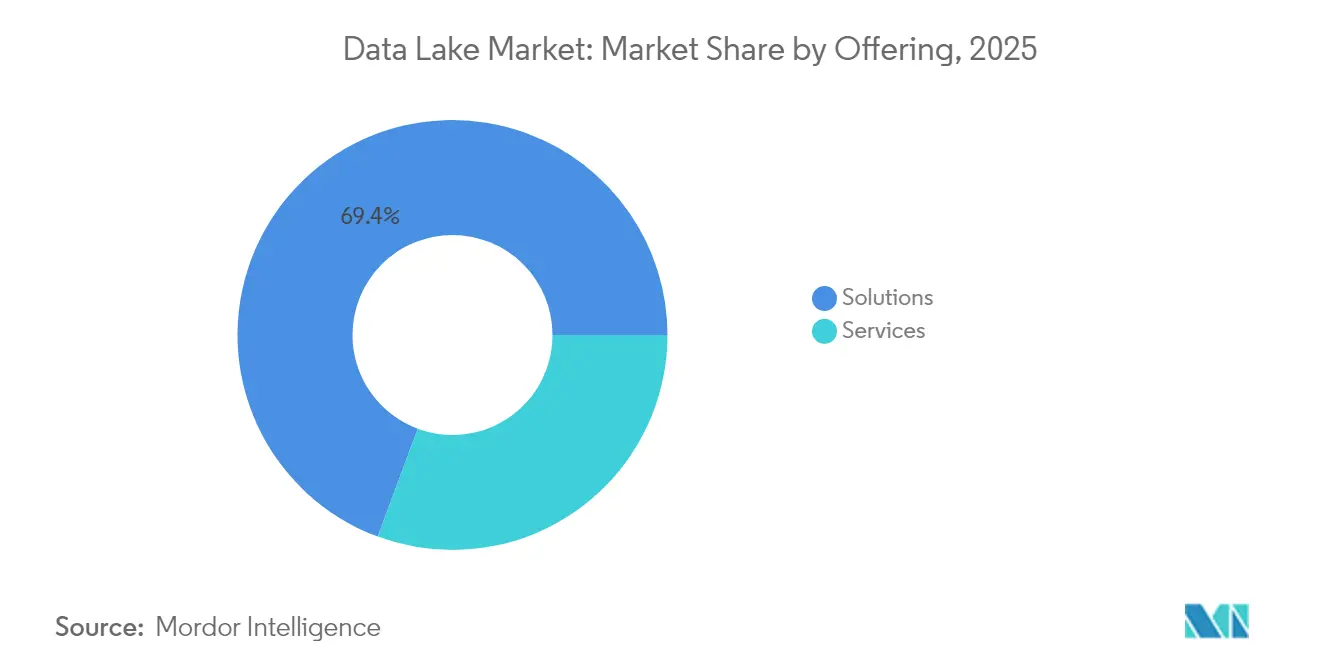
- Por oferta, las soluciones lideraron con una participación de ingresos del 69,35% en 2025; se proyecta que los servicios se expandirán a una CAGR del 24,77% hasta 2031.
- Por implementación, la nube capturó el 64,20% de la participación del mercado de data lakes en 2025, mientras que se prevé que la nube híbrida/multinube crezca a una CAGR del 23,1% entre 2026-2031.
- Por tamaño de organización, las grandes empresas representaron el 71,10% del tamaño del mercado de data lakes en 2025; las pymes son las de mayor crecimiento con una CAGR del 26,1% hasta 2031.
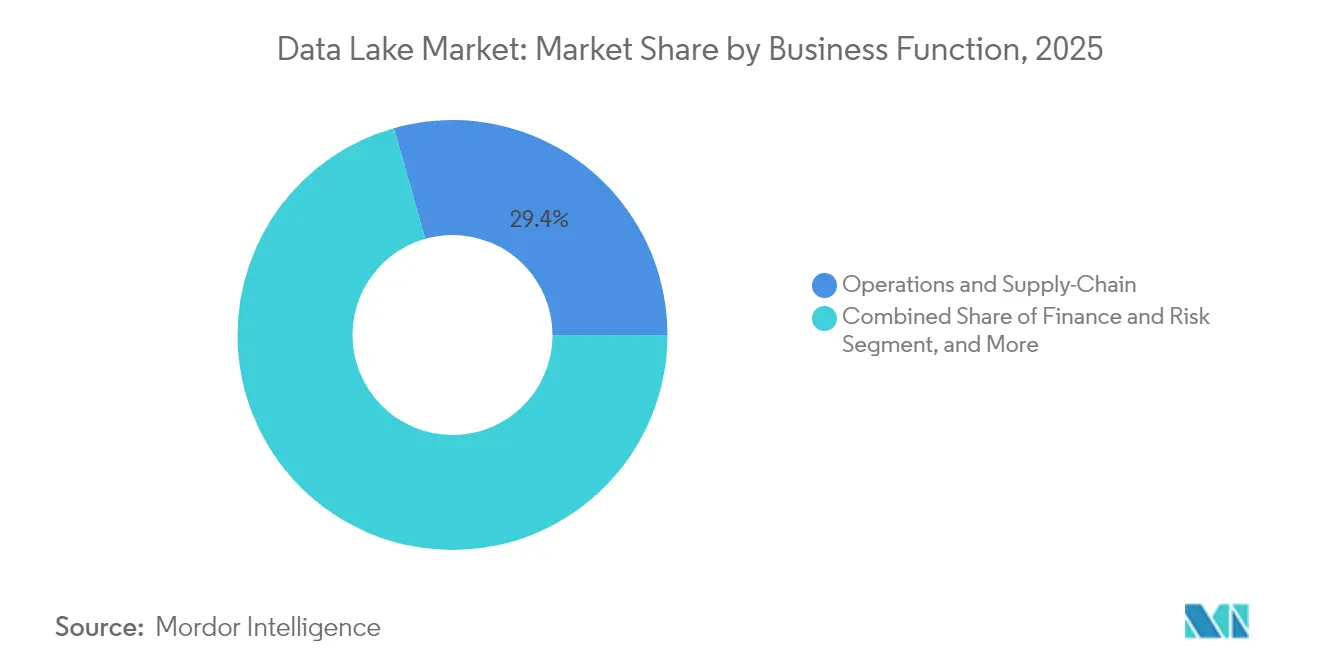
- Por función empresarial, operaciones y cadena de suministro tuvo una participación del 29,40% del mercado de data lakes en 2025, mientras que finanzas y riesgo avanza a una CAGR del 25,2% hasta 2031.
- Por vertical de usuario final, TI y telecomunicaciones lideró con una participación de ingresos del 21,60% en 2025; salud y ciencias de la vida está preparada para expandirse a una CAGR del 25,6% hasta 2031.
- Por geografía, América del Norte dominó con una participación del 37,40% en 2025, mientras que Asia se acelerará a una CAGR del 23,5% hasta 2031.
Nota: Las cifras de tamaño del mercado y previsión de este informe se generan utilizando el marco de estimación propietario de Mordor Intelligence, actualizado con los últimos datos e información disponibles a partir de 2026.
Tendencias e Información del Mercado
Análisis del Impacto de los Impulsores*
| Impulsor | (~) % de Impacto en el Pronóstico de CAGR | Relevancia Geográfica | Horizonte Temporal del Impacto |
|---|---|---|---|
| Explosión de datos no estructurados y multimodales provenientes de cargas de trabajo de IA generativa | +7.5% | Global con concentración en América del Norte y Europa Occidental | Mediano plazo (2-4 años) |
| Mandatos de residencia de datos en Europa que aceleran la adopción de lagos basados en la nube | +5.2% | Unión Europea, Reino Unido, Suiza y Asia-Pacífico | Corto plazo (≤ 2 años) |
| Convergencia de lakehouses que genera ahorros del 35–40% en el costo total de propiedad para empresas Fortune 500 | +6.3% | Global con adopción temprana en América del Norte | Mediano plazo (2-4 años) |
| Formatos de tabla sin servidor (Iceberg/Delta) que desbloquean la portabilidad multinube | +4.8% | Global, más fuerte donde las estrategias multinube están activas | Mediano plazo (2-4 años) |
| Requisitos de captura de datos ESG de Alcance 3 en tiempo real en el sector industrial | +3.2% | Europa, América del Norte, economías avanzadas de Asia-Pacífico | Largo plazo (≥ 4 años) |
| Pruebas de estrés regulatorias en servicios financieros que exigen la retención de datos de operaciones a escala de una década | +2.9% | Centros financieros globales (Nueva York, Londres, Singapur, Hong Kong) | Mediano plazo (2-4 años) |
| Fuente: Mordor Intelligence | |||
Explosión de datos no estructurados y multimodales provenientes de cargas de trabajo de IA generativa
Las aplicaciones de IA generativa crean grandes volúmenes de imágenes, audio y texto que requieren almacenamiento con esquema en lectura. Las empresas esperan que el 30% de la esfera de datos global de 175 zettabytes requiera procesamiento en tiempo real para 2025, un perfil inadecuado para los almacenes de datos rígidos. Los data lakes se convierten así en la zona de aterrizaje predeterminada para los corpus multimodales utilizados en los ciclos de ingeniería de instrucciones.[1]Acceldata, "Data Lakes Empresariales: Revolucionando los Datos Empresariales," acceldata.ioEl plano de lakehouse de Google Cloud muestra cómo el almacenamiento en formato nativo combinado con la indexación vectorial acelera el ajuste fino de modelos de fundación al tiempo que reduce los costos de almacenamiento. Las empresas que retrasen la adopción corren el riesgo de ciclos de innovación más lentos y mayores costos unitarios en las cargas de trabajo de IA.
Mandatos de residencia de datos en Europa que aceleran la adopción de lagos basados en la nube
La Ley de Gobernanza de Datos y la Ley de Datos de la UE obligan a las organizaciones a localizar las cargas de trabajo sensibles. Los hiperescaladores están respondiendo: AWS está invirtiendo EUR 7,8 mil millones en una región de nube soberana que incluye controles integrados de ubicación de datos.[2]Databricks, "Databricks Acuerda Adquirir Tabular," databricks.com Las empresas ahora implementan data lakes segmentados por región que cumplen con las normas de residencia y aún pueden consultarse a través de motores federados, lo que genera demanda de catálogos de metadatos ricos en linaje capaces de mostrar el uso de datos transfronterizos en informes de auditoría.
Convergencia de lakehouses que genera ahorros del 35-40% en el costo total de propiedad
Un lakehouse de un solo nivel elimina la duplicación que antes afectaba a los lagos y almacenes de datos separados. Las empresas encuestadas que trasladan trabajos analíticos a motores de lakehouse citan una reducción a la mitad de los costos de movimiento de datos y ahorros de almacenamiento impulsados por la compresión. Las ganancias de rendimiento de los planificadores de consultas con reconocimiento vectorial reducen aún más los tiempos de cómputo, liberando presupuesto para la experimentación con IA. El ochenta y uno por ciento de las empresas ahora entrenan modelos de aprendizaje automático directamente en tablas de lakehouse, lo que indica que la convergencia ya no es una práctica marginal sino un patrón generalizado.
Formatos de tabla sin servidor que desbloquean la portabilidad multinube
Apache Iceberg, Delta Lake y Hudi introducen transacciones ACID, evolución de esquemas y viaje en el tiempo en los almacenes de objetos. Los formatos desacoplan el cómputo del almacenamiento, permitiendo que los motores de análisis en nubes rivales consulten los mismos conjuntos de datos sin replicación. La adquisición de Tabular por parte de Databricks en 2024 subraya el valor estratégico de los metadatos de tablas abiertas, mientras que la función Omni de Google BigLake consulta particiones de Iceberg en nubes rivales, validando la tesis del formato neutral.[3]Comisión Europea, "Una Estrategia Europea para los Datos," digital-strategy.ec.europa.eu
Análisis del Impacto de las Restricciones*
| Restricción | (~) % de Impacto en el Pronóstico de CAGR | Relevancia Geográfica | Horizonte Temporal del Impacto |
|---|---|---|---|
| Deriva de metadatos que crea "pantanos de datos" | -3.8% | Global, más agudo en implementaciones heredadas | Corto plazo (≤ 2 años) |
| Escasez de talento especializado en ingeniería de data lakes | -2.9% | Asia-Pacífico, América Latina, Oriente Medio y África | Mediano plazo (2-4 años) |
| Los casos de uso sensibles a la latencia aún prefieren los almacenes de datos | -2.1% | Centros financieros y de telecomunicaciones en todo el mundo | Corto plazo (≤ 2 años) |
| Precios opacos basados en el consumo en la nube | -1.7% | Empresas del mercado medio a nivel global | Mediano plazo (2-4 años) |
| Fuente: Mordor Intelligence | |||
Deriva de metadatos que crea "pantanos de datos"
Cuando la ingesta supera las actualizaciones del catálogo, los data lakes se convierten en repositorios en los que no se puede realizar búsquedas. Para 2025, el volumen global de datos alcanzará los 163 zettabytes, lo que aumenta el riesgo de archivos aislados sin contexto. Las empresas están respondiendo adoptando rastreadores de linaje automatizados como Unity Catalog, que registra cada lectura-escritura y señala los activos huérfanos. Sin controles similares, la sobrecarga de gobernanza puede eliminar los ahorros proyectados de la consolidación de lakehouses.
Escasez de talento en ingeniería de lagos en regiones emergentes
Las empresas de Asia-Pacífico y América Latina citan una escasez de ingenieros que comprendan los sistemas de archivos distribuidos, los formatos de tabla abierta y la optimización de costos en la nube. Los datos de POPsights muestran que la creación de roles impulsada por IA supera la oferta de formación local. La investigación de la OCDE destaca una creciente brecha urbano-rural en el acceso a habilidades avanzadas en datos.[4]OCDE, "Creación de Empleo y Desarrollo Económico Local 2024," oecd.org Los servicios gestionados y las canalizaciones de bajo código están mitigando la escasez, aunque la falta de talento sigue alargando los ciclos de implementación, lo que ralentiza la penetración del mercado de data lakes.
*Nuestras previsiones consideran los impactos de impulsores y restricciones como direccionales, no aditivos. Las previsiones de impacto reflejan el crecimiento base, los efectos de mezcla y las interacciones entre variables.
Análisis de Segmentos
Por Oferta:
Las soluciones lideran, los servicios se disparanLas soluciones generaron el 69,35% de los ingresos del mercado de data lakes en 2025, lo que equivale a un tamaño del mercado de data lakes de USD 12,95 mil millones. El dominio proviene de las empresas que estandarizan en motores de almacenamiento, aceleradores de consultas y suites de gobernanza que forman la columna vertebral de los entornos preparados para IA. Los proveedores agrupan paneles de optimización de costos, niveles automatizados y soporte nativo de tablas abiertas, manteniendo su relevancia a medida que evolucionan las cargas de trabajo.
El subsegmento de servicios avanza a una CAGR del 24,77% hasta 2031, lo que refleja la demanda de planes de migración, ajuste de rendimiento y operaciones gestionadas las 24 horas del día, los 7 días de la semana. Muchas empresas carecen de personal que pueda migrar los entornos heredados de Hadoop, por lo que contratan especialistas que prometen resultados de SLA predecibles. El ajustado mercado de talento garantiza que las reservas de servicios profesionales seguirán creciendo más rápido que el mercado general de data lakes.


Por Implementación:
La nube domina, el entorno híbrido se aceleraLas implementaciones en la nube capturaron el 64,20% de la participación del mercado de data lakes en 2025, ya que las organizaciones buscaban escalabilidad instantánea y seguridad integrada. Los almacenes de objetos elásticos como Amazon S3 eliminan el gasto de capital al tiempo que ofrecen automatización del ciclo de vida que mueve automáticamente los datos fríos a clases de bajo costo. Los motores de análisis se activan entonces bajo demanda, manteniendo el gasto de cómputo alineado con el ritmo del proyecto.
Las configuraciones híbridas y multinube se están expandiendo a una CAGR del 23,1% hasta 2031. Los formatos de tabla abierta permiten que una única definición de metadatos abarque depósitos locales y en la nube pública, reduciendo drásticamente las necesidades de replicación. Las normas de cumplimiento regional impulsan aún más las estrategias híbridas, ya que las empresas fijan las cargas de trabajo reguladas en regiones soberanas y aún las consultan a través de tejidos multinube. Como resultado, el tamaño del mercado de data lakes para entornos híbridos está aumentando en paralelo con los lanzamientos de nubes soberanas.
Por Tamaño de Organización:
Las grandes empresas dominan, las pymes ganan terrenoLas grandes empresas representaron el 71,10% del tamaño del mercado de data lakes en 2025, o aproximadamente USD 13,28 mil millones. Sus complejos entornos a escala de petabytes requieren control de acceso basado en roles avanzado, linaje automatizado y gobernanza de FinOps. Los bancos, fabricantes y empresas de telecomunicaciones dependen de los lakehouses para consolidar silos y respaldar aplicaciones de IA en tiempo real.
Las pequeñas y medianas empresas registran la CAGR más rápida del 26,1% porque los planes gestionados por proveedores ahora ofrecen facturación de "pago por procesamiento". La orquestación de bajo código y los esquemas basados en plantillas acortan los ciclos de implementación. Las ediciones comunitarias de Iceberg y Delta exponen capacidades de nivel empresarial sin tarifas de licencia, lo que permite a las empresas con recursos limitados incorporarse al mercado principal de data lakes.
Por Función Empresarial:
Operaciones estable, finanzas y riesgo en augeLas cargas de trabajo de operaciones y cadena de suministro generaron el 29,40% del gasto de 2025, con fabricantes que combinan telemetría de IoT, EDI de proveedores y flujos logísticos para el mantenimiento predictivo. La flexibilidad del esquema en lectura hace que los lagos sean ideales para fusionar archivos de sensores semiestructurados con tablas de ERP, respaldando paneles de control de torre que reducen el riesgo de tiempo de inactividad.
Las aplicaciones de finanzas y riesgo están creciendo a una CAGR del 25,2%. Los reguladores ahora esperan historiales de operaciones de una década de profundidad, y los lakehouses almacenan estos volúmenes de manera eficiente. La propuesta de regla de reserva de capital de la Reserva Federal de abril de 2025 subraya la necesidad de modelar los impactos de capital bajo condiciones de estrés. Los bancos que centralizan los registros de riesgo, tesorería y ESG dentro de un lago gobernado eliminan los retrasos de conciliación, ganando agilidad en los informes.
Por Vertical de Usuario Final:
TI y telecomunicaciones lideran, la salud avanzaLos operadores de TI y telecomunicaciones representaron el 21,60% de los ingresos de 2025. Los operadores ingieren registros de detalles de llamadas, KPI de red y transcripciones de soporte en los lagos, y luego ejecutan análisis de detección de fraude y abandono de clientes que mejoran el valor de vida del cliente. Softteco señala que Vodafone y AT&T utilizan arquitecturas de lago impulsadas por IA para optimizar torres y personalizar ofertas.
Se proyecta que la salud y las ciencias de la vida escalarán a una CAGR del 25,6%. Los hospitales combinan registros de salud electrónicos, imágenes y genómica en repositorios unificados que impulsan estudios de medicina de precisión. Las implementaciones de Microsoft Fabric ilustran cómo las canalizaciones de ingesta unificadas reducen los tiempos de preparación de datos, habilitando alertas clínicas en tiempo real. Las empresas farmacéuticas aprovechan los flujos de trabajo de lago repetibles para reducir los ciclos de descubrimiento, impulsando una inversión sostenida en el mercado de data lakes.
Análisis Geográfico
Mercado de Data Lake en América del Norte
América del Norte generó el 37,40% de los ingresos de 2025 y continúa estableciendo referencias en madurez arquitectónica. Las instituciones financieras amplían la retención de series temporales para cumplir con las plantillas de pruebas de estrés en evolución, mientras que las redes hospitalarias construyen gráficos multimodales de pacientes que sustentan el diagnóstico impulsado por inteligencia artificial. El capital de riesgo también impulsa la formación de empresas emergentes de gobernanza, garantizando un ecosistema dinámico.
Mercado de Data Lake en Asia-Pacífico
Asia-Pacífico es la región de expansión más rápida, registrando una CAGR del 23,5% hasta 2031. Los gobiernos de Japón, India y Singapur patrocinan proyectos de nube soberana, impulsando la demanda de zonas de lago conformes con las regulaciones regionales. Las empresas de telecomunicaciones en China analizan enormes registros de 5G para la planificación de capacidad, mientras que las fintech indonesias comparten lagos de inteligencia contra el fraude para reducir el cibercrimen. Los proveedores que establecen sedes en Asia-Pacífico, como Wasabi en Japón, apuntan a aprovechar el proyectado repunte del 36% en IaaS.
Mercado de Data Lake en Europa
Europa acelera la adopción bajo estrictos mandatos de soberanía de datos. La Estrategia Europea de Datos impulsa la inversión en alojamiento local, y AWS abrirá una región en Brandeburgo a finales de 2025 para cumplir con las normas de residencia de datos. Los fabricantes almacenan emisiones de Alcance 3 en tiempo real para los informes de CSRD, y los bancos refinan los cálculos de Basilea III dentro de lagos listos para auditoría. Las plantillas de pruebas de estrés de 2025 de la Autoridad Bancaria Europea refuerzan los requisitos técnicos que los lakehouses satisfacen.
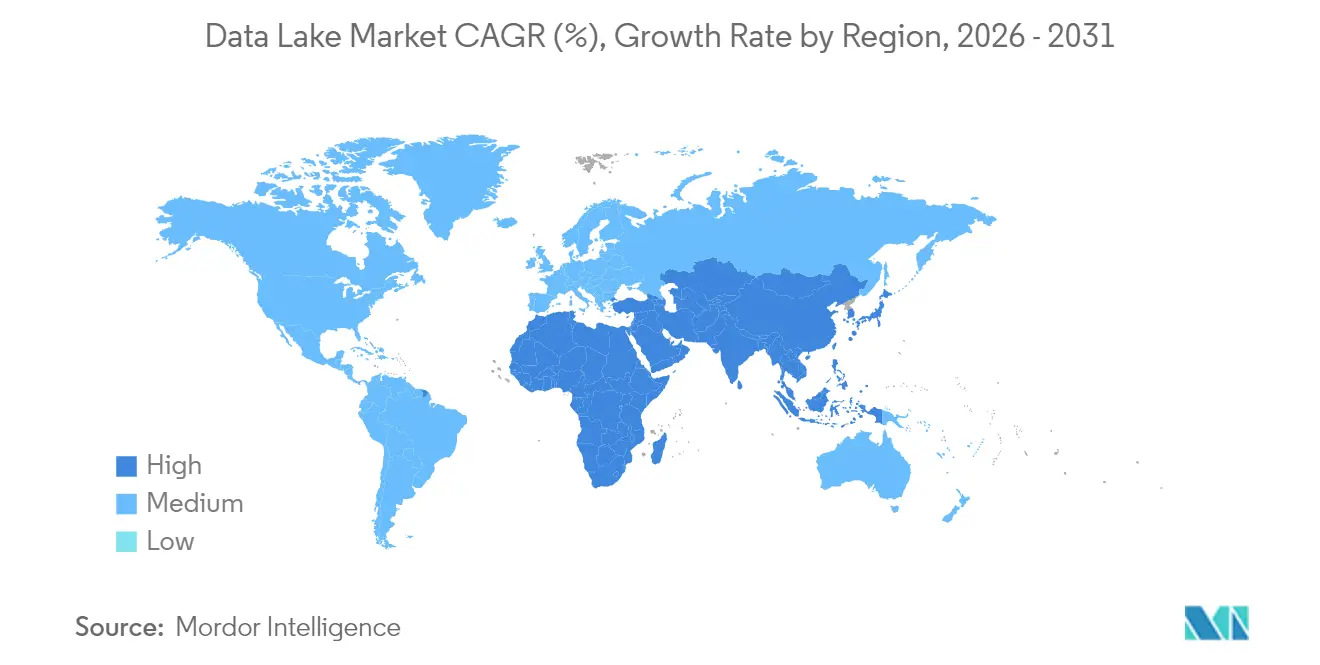

Panorama regulatorio
Los requisitos regulatorios en torno al acceso, la ubicación y la gobernanza de datos se están endureciendo de formas que determinan cómo las empresas diseñan y operan los data lakes. En la Unión Europea, la Ley de Datos (Reglamento (UE) 2023/2854) entra en aplicación por etapas, con efectividad a partir del 12 de septiembre de 2025 y fechas clave de aplicación que comienzan el 12 de septiembre de 2026. Esto refuerza las obligaciones en torno al acceso y la portabilidad de datos, lo que aumenta la demanda de metadatos estandarizados, controles de intercambio auditables y arquitecturas multientorno. Por separado, la Ley de Inteligencia Artificial de la UE introduce expectativas explícitas de gobernanza de datos para la IA de alto riesgo. El artículo 10 establece requisitos sobre la calidad y gobernanza de los datos de entrenamiento, validación y prueba, y las obligaciones completas para los sistemas de alto riesgo (incluidos los artículos 10 a 12) se aplican a partir del 2 de agosto de 2026, elevando la prioridad del linaje, la procedencia y la documentación de conjuntos de datos dentro de las capas de gobernanza de lakehouse y data lake.
Los impulsores de cumplimiento del sector público y transfronterizo también elevan las expectativas de referencia en materia de seguridad y gestión de la información en plataformas de datos a gran escala. En Estados Unidos, los memorandos de la OMB M-25-04 (orientación del año fiscal 2025 sobre requisitos de gestión de seguridad y privacidad de la información federal bajo FISMA) y M-25-05 (orientación de implementación de la Fase 2 para la Foundations for Evidence-Based Policymaking Act of 2018 sobre acceso y gestión de datos abiertos) refuerzan las expectativas de manejo disciplinado de datos, control de acceso y artefactos de gobernanza. Estos se corresponden estrechamente con los patrones de catalogación, aplicación de políticas y almacenamiento listo para auditoría utilizados en los data lakes empresariales. En el Reino Unido, la política de gestión de activos de datos del gobierno publicada en mayo de 2026 exige a los departamentos identificar, registrar e informar de manera centralizada los activos de datos al Government Digital Service, aumentando el énfasis en la capacidad de descubrimiento y los inventarios de datos estandarizados que favorecen los modelos operativos empresariales de catálogo y data lake.
Panorama Competitivo
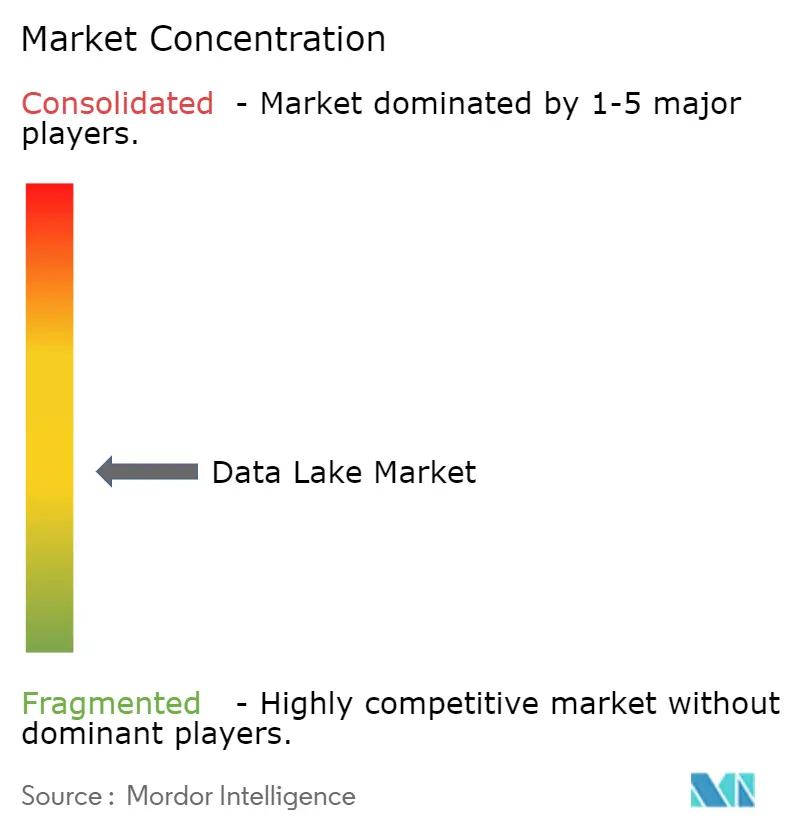
El mercado de data lakes está moderadamente fragmentado. Los hiperescaladores —AWS, Microsoft Azure, Google Cloud— dominan la infraestructura, aprovechando las regiones globales y la gobernanza integrada. Plataformas especializadas como Databricks y Snowflake se distinguen por el rendimiento, la integración de cuadernos y la completitud del lakehouse. Las comunidades de código abierto dirigen Iceberg, Delta y Hudi, ofreciendo a los compradores opciones de formato que reducen la dependencia de los proveedores.
Las adquisiciones estratégicas están redefiniendo las cadenas de valor. Databricks adquirió Tabular en 2024 para integrar el linaje de Iceberg en los flujos de trabajo de Delta, apostando por los metadatos universales. Fivetran compró Census en 2025, unificando la ingesta y el ETL inverso para cerrar el ciclo de activación. El acuerdo de Commvault con Clumio en 2024 añade instantáneas de recuperación ante ransomware para los lagos de S3. Estos movimientos apuntan a un futuro donde las suites integradas abarcan la ingesta, la gobernanza, la protección y la activación.
A pesar del peso de los hiperescaladores, los cinco principales proveedores capturan aproximadamente el 55% del gasto total, dejando espacio para los innovadores que se especializan en optimización de costos, aceleración de consultas multinube y planes de gobernanza específicos por sector. La observabilidad de la calidad de datos aumentada por IA y la gobernanza de nube soberana son dos espacios emergentes que probablemente atraerán nuevos participantes.
Líderes de la Industria de Data Lake
Microsoft Corporation
Amazon.com Inc.
Capgemini SE
Oracle Corporation
Teradata Corporation
- *Nota aclaratoria: los principales jugadores no se ordenaron de un modo en especial
Mercado de Data Lake
- Amazon Web Services (AWS)
- Microsoft Corporation
- Google LLC
- IBM Corporation
- Oracle Corporation
- Snowflake Inc.
- SAP SE
- Cloudera Inc.
- Teradata Corporation
- Informatica Inc.
- Databricks Inc.
- Hitachi Vantara LLC
- Dell Technologies Inc.
- Atos SE
- SAS Institute Inc.
- Zaloni Inc.
- Dremio Corporation
- Qubole Inc.
- Talend SA
- HPE (Ezmeral)

Oportunidades de mercado y perspectivas futuras
La gobernanza impulsada por el cumplimiento normativo y la interoperabilidad entre plataformas están ampliando el espacio comercial en blanco en torno a los data lakes más allá del almacenamiento y la consulta, especialmente en entornos regulados de IA y soberanía de datos. La Ley de IA de la UE introduce obligaciones de gobernanza de datos de obligado cumplimiento para la IA de alto riesgo a partir del 2 de agosto de 2026 (incluido el artículo 10). Esto crea demanda de soluciones que operacionalicen la procedencia de los conjuntos de datos, los flujos de evaluación de sesgos, el linaje y los controles sobre la preparación y documentación de datos. Como resultado, los compradores se están inclinando hacia implementaciones de lakehouse y tablas abiertas donde las políticas de gobernanza, los catálogos y los permisos granulares se puedan auditar, y los proveedores y prestadores de servicios pueden empaquetar arquitecturas de referencia listas para la gobernanza de IA, publicación controlada de productos de datos y operaciones de cumplimiento gestionadas.
La ejecución en telecomunicaciones también apunta a vías de inversión activas vinculadas a bases de datos unificadas para operaciones impulsadas por IA. En abril de 2026, IBM implementó un data lakehouse listo para IA utilizando IBM watsonx para Tata Play Fiber con el fin de consolidar datos fragmentados que abarcan cliente, marketing, finanzas y operaciones de red. En junio de 2026, Nokia y Databricks completaron una prueba de concepto conjunta para una plataforma de datos unificada e independiente del sustrato con el fin de respaldar redes autónomas impulsadas por IA. En conjunto, estos programas subrayan oportunidades en torno a la generación automatizada de productos de datos, las superposiciones de tejido y malla de datos (data fabric y mesh), y los patrones de cómputo hacia los datos que reducen el movimiento de datos sensibles mientras mejoran la reutilización. A medida que los formatos de tablas abiertas como Apache Iceberg y Delta Lake se convierten en estándares de adquisición por su portabilidad, los proveedores pueden diferenciarse mediante funciones de interoperabilidad, automatización de la gobernanza que evita resultados de tipo "pantano de datos" y modernización liderada por servicios para entornos híbridos y multinube donde la residencia de datos y el control de costos determinan las decisiones arquitectónicas.
Recent Industry Developments in Mercado de Data Lake
- Junio de 2026: AWS actualizó Lake Formation para permitir la lectura y escritura de los archivos de datos subyacentes de Amazon S3 para tablas registradas en el AWS Glue Data Catalog, alineando los permisos entre patrones de acceso basados en SQL y en archivos. El cambio respalda modelos operativos de motor mixto donde diferentes herramientas interactúan con las mismas tablas del lago, elevando el nivel exigido para una gobernanza unificada y reduciendo la fricción en implementaciones multiherramienta de data lakes.
- Febrero de 2026: Microsoft anunció la disponibilidad general de la interoperabilidad entre OneLake y Snowflake, permitiendo el almacenamiento nativo de tablas Apache Iceberg gestionadas por Snowflake en OneLake. Esto refuerza a Iceberg como una capa de tablas neutral y ayuda a las empresas a reducir la duplicación al mantener los datos en una base de almacenamiento de lago compartida, permitiendo que múltiples plataformas de análisis operen sobre ella.
- Mayo de 2025: Fivetran adquirió Census, añadiendo capacidades de ETL inverso que activan datos en sistemas operativos. El acuerdo conecta la ingesta y la activación en un ciclo de vida de datos más completo, aumentando el papel estratégico de los entornos de data lake y lakehouse como la fuente gobernada que alimenta las aplicaciones empresariales posteriores.


Mercado de Data Lake Alcance del informe y metodología de investigación
Definición y alcance del mercado
Este mercado cubre los ingresos obtenidos por el software de data lakes y los servicios relacionados que ayudan a almacenar, organizar y analizar grandes volúmenes de datos estructurados y no estructurados, en entornos de nube, locales e híbridos.
Exclusiones del alcance: excluimos el gasto de propósito general exclusivamente en hardware y la subcontratación amplia de TI que no esté directamente vinculada a la implementación o el funcionamiento de un entorno de data lake.
Descripción general de la segmentación
- Por Oferta
- Soluciones
- Descubrimiento y Catalogación de Datos
- Integración de Datos y ETL/ELT
- Herramientas de Análisis y Visualización
- Plataformas de Gobernanza y Seguridad
- Servicios
- Servicios Profesionales (Consultoría, Integración)
- Servicios Gestionados
- Soluciones
- Por Implementación
- Nube
- Nube Pública
- Nube Privada
- Nube Híbrida/Multinube
- Local
- Nube
- Por Tamaño de Organización
- Grandes Empresas
- Pequeñas y Medianas Empresas (Pymes)
- Por Función Empresarial
- Operaciones y Cadena de Suministro
- Finanzas y Riesgo
- Ventas y Marketing
- Recursos Humanos
- Por Vertical de Usuario Final
- TI y Telecomunicaciones
- Banca, Servicios Financieros y Seguros
- Salud y Ciencias de la Vida
- Comercio Minorista y Comercio Electrónico
- Manufactura e Industrial
- Medios de Comunicación y Entretenimiento
- Gobierno y Sector Público
- Energía y Servicios Públicos
- Otros (Educación, Hospitalidad)
- Por Geografía
- América del Norte
- Estados Unidos
- Canadá
- México
- América del Sur
- Brasil
- Argentina
- Chile
- Perú
- Resto de América del Sur
- Europa
- Alemania
- Reino Unido
- Francia
- Italia
- España
- Resto de Europa
- Asia-Pacífico
- China
- Japón
- India
- Australia
- Nueva Zelanda
- Resto de Asia-Pacífico
- Oriente Medio
- Emiratos Árabes Unidos
- Arabia Saudita
- Turquía
- Resto de Oriente Medio
- África
- Sudáfrica
- Resto de África
- América del Norte
Fuentes de datos, dimensionamiento de mercado y validación
Investigación documental
El trabajo documental comienza construyendo una base de hechos sencilla en torno al crecimiento de los datos empresariales, la adopción de la nube y las necesidades de gobernanza de datos, ya que estos factores se corresponden estrechamente con las implementaciones de data lakes en los departamentos de TI. Recurrimos a fuentes públicas como la US Bureau of Labor Statistics para señales de gasto en TI, la US Census Bureau para el recuento de empresas por sector, e indicadores de la OCDE y el Banco Mundial para comparaciones de la economía digital entre regiones.
También examinamos indicadores técnicos y de adopción de fuentes como publicaciones del NIST, revistas revisadas por pares sobre arquitecturas de gestión de datos, y portales de contratación pública que muestran el lenguaje de licitaciones en torno a plataformas de análisis y modernización de datos. Los informes anuales de empresas, las notas de las conferencias de resultados y las presentaciones a inversores nos ayudan a comprender el empaquetado de productos (software frente a servicios) y cómo se reconocen los ingresos por nube y suscripción. Cuando es necesario, utilizamos suscripciones de pago para datos financieros e inteligencia empresarial, noticias y finanzas, y bases de datos de patentes para verificar cronologías y titularidad de capacidades clave de plataforma. Las fuentes aquí enumeradas son ilustrativas, y se utilizaron muchas otras referencias públicas para recopilar, validar y aclarar los datos.
Entrevistas primarias y encuestas
Los insumos primarios se utilizan para poner a prueba los supuestos de adopción y los rangos de precios con personas que compran, implementan y operan entornos de data lake, incluidos líderes de TI, gerentes de ingeniería de datos, arquitectos de nube y socios de servicios. Para obtener una visión global, distribuimos las conversaciones entre las principales regiones de demanda y luego verificamos cualquier diferencia significativa mediante preguntas de seguimiento, de modo que el modelo final refleje las implementaciones empresariales típicas.
Distribución de los encuestados del trabajo de campo de investigación primaria
| Tipo de empresa | Cargo del encuestado | Región |
|---|---|---|
| Nivel superior: 35% | Directivos (CXOs): 16% | APAC: 43% |
| Nivel medio: 44% | Líderes funcionales/de unidad: 25% | EMEA: 37% |
| Actores más pequeños: 21% | Gerentes: 59% | América: 20% |
Dimensionamiento y previsión del mercado
El dimensionamiento se construye utilizando un enfoque descendente (top-down) donde los fondos de gasto en plataformas de datos empresariales se reconstruyen por región, y luego se filtran utilizando tasas de adopción y migración específicas para los casos de uso de data lakes. Corroboramos los totales con verificaciones ascendentes (bottom-up) selectivas, como el muestreo de valores contractuales anuales típicos, la validación de la combinación de soluciones y servicios, y la puesta a prueba de los volúmenes mediante conversaciones con canales y cronogramas de implementación.
Los insumos clave del modelo incluyen la combinación de despliegue en la nube frente a local, la progresión promedio de precios de suscripción y soporte, las tasas de adjunción de servicios para implementación y operaciones gestionadas, el crecimiento de la carga de trabajo vinculado a proyectos de análisis, y las diferencias de adopción a nivel sectorial en industrias reguladas. Cuando falta un dato para un país o vertical, cubrimos las lagunas utilizando indicadores sustitutos como el número de empresas y la madurez en la nube, y luego ajustamos el resultado tras revisarlo con los encuestados primarios. La previsión utiliza análisis de escenarios respaldado por verificaciones de sensibilidad de tipo regresión sobre los impulsores más fuertes (ritmo de migración a la nube, crecimiento de los datos y modernización impulsada por el cumplimiento normativo), y los supuestos se actualizan cuando los expertos indican un cambio claro en el comportamiento de compra.
Validación de datos y ciclo de actualización
La validación se realiza mediante verificaciones cruzadas repetidas entre el modelo y señales independientes, como la dirección del gasto regional en TI, indicios de crecimiento de servicios en la nube y cambios en las prioridades de gestión de datos empresariales. Los valores atípicos se señalan de forma temprana, y los supuestos que los sustentan son revisados por otro analista antes de finalizar las cifras, lo que ayuda a reducir la varianza evitable.
El trabajo se actualiza anualmente, y se activan actualizaciones intermedias cuando ocurren eventos materiales, como grandes cambios de precios, cambios regulatorios importantes o un cambio claro de nivel en los patrones de adopción de la nube. Antes de la entrega, realizamos una revisión final para asegurarnos de que los desarrollos recientes estén reflejados, y cualquier diferencia importante frente a ediciones anteriores se explica y se vuelve a poner a prueba mediante recontactos rápidos con expertos.
Comparación del tamaño del mercado de data lakes de Mordor Intelligence con otras estimaciones publicadas
Los tamaños de mercado publicados para los data lakes pueden parecer muy distantes entre sí incluso cuando describen necesidades similares de los compradores, porque las decisiones de alcance no siempre son consistentes y la lógica de precios no siempre se explica. Las diferencias también surgen cuando una estimación se ancla en un año base distinto o utiliza una ventana de pronóstico más larga, lo que puede cambiar lo que se contabiliza como ingreso actual.
La principal brecha proviene de si se incluyen en el total categorías adyacentes de gestión de datos. En este trabajo, Mordor Intelligence contabiliza las soluciones de data lake y los servicios relacionados, pero evita incorporar plataformas más amplias de almacenamiento de datos (data warehousing) y análisis general, a menos que se vendan e implementen como parte de un entorno de data lake.
Comparación de referencia
| Fuente | Tamaño del mercado | Brechas en la metodología de investigación |
|---|---|---|
| Mordor Intelligence | 18,68 mil millones USD (2025) | |
| Consultora Global A | 11,07 mil millones USD (2025) | Utiliza una captura de ingresos más estrecha en el año base, lo que puede subestimar la adjunción de servicios y las implementaciones híbridas que aún impulsan el trabajo pagado de plataforma e integración. |
| Editorial del Sector B | 10,70 mil millones USD (2025) | Aplica una división de componentes diferente y a menudo se apoya en una conversión más conservadora a dólares estadounidenses en el año base, lo que puede reducir el total reportado de 2025 en comparación con modelos que normalizan la mezcla de precios y despliegue. |
Al observar la tabla, la dispersión se explica principalmente por lo que se contabiliza dentro del fondo de gasto en data lakes y cómo se tratan los servicios y los casos de uso híbridos en el año base. Al mantener los insumos vinculados a supuestos claros de adopción, mezcla de despliegue y precios, podemos explicar cada paso y volver a verificar los totales cuando aparezcan nuevas señales del mercado sin tener que reconstruir el modelo desde cero.


Preguntas Clave Respondidas en el Informe
¿Por qué las empresas están migrando de los almacenes de datos a los lakehouses?
Los lakehouses reducen el costo total de propiedad analítico en un 35–40% y admiten el entrenamiento de modelos de IA en datos sin procesar mientras preservan las garantías de rendimiento ACID.
¿Cuál es el tamaño del mercado de data lakes en 2026?
El mercado de data lakes está valorado en USD 22,8 mil millones en 2026 y se prevé que alcance USD 61,84 mil millones en 2031.
¿Qué región está creciendo más rápido en la adopción de data lakes?
Asia-Pacífico lidera con una CAGR proyectada del 23,5% entre 2026 y 2031, impulsada por la rápida transformación digital y las inversiones en nube soberana.
¿Cuál es el principal desafío que impide que los data lakes generen valor?
La deriva de metadatos puede convertir los lagos en "pantanos de datos", lo que impulsa la inversión en catálogos automatizados y seguimiento de linaje para mantener la confianza.
¿Cómo afectan los formatos de tabla abierta al bloqueo de proveedores?
Formatos como Apache Iceberg y Delta Lake permiten la portabilidad multinube al desacoplar el almacenamiento de los motores de cómputo, lo que permite a los equipos consultar los mismos datos en diferentes nubes.
¿Qué vertical de la industria tiene el pronóstico de mayor crecimiento?
Se prevé que la salud y las ciencias de la vida se expandan a una CAGR del 25,6% hasta 2031, aprovechando los data lakes para la medicina de precisión y el análisis de pacientes en tiempo real.
Última actualización de la página el:



