
Marktgröße und Marktanteil der Computationalen Biologie
Marktübersicht
| Studienzeitraum | 2020 - 2031 |
|---|---|
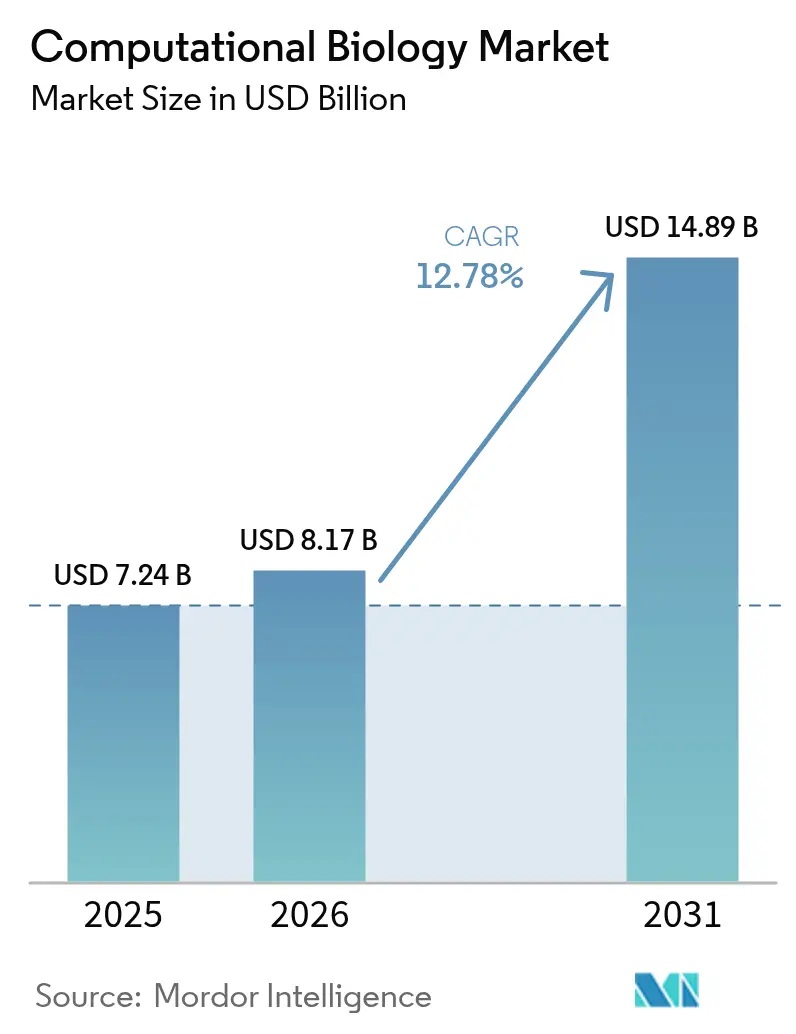
| Marktgröße (2026) | 8.17 Milliarden US-Dollar |
| Marktgröße (2031) | 14.89 Milliarden US-Dollar |
| Wachstumsrate (2026 - 2031) | 12.78 % |
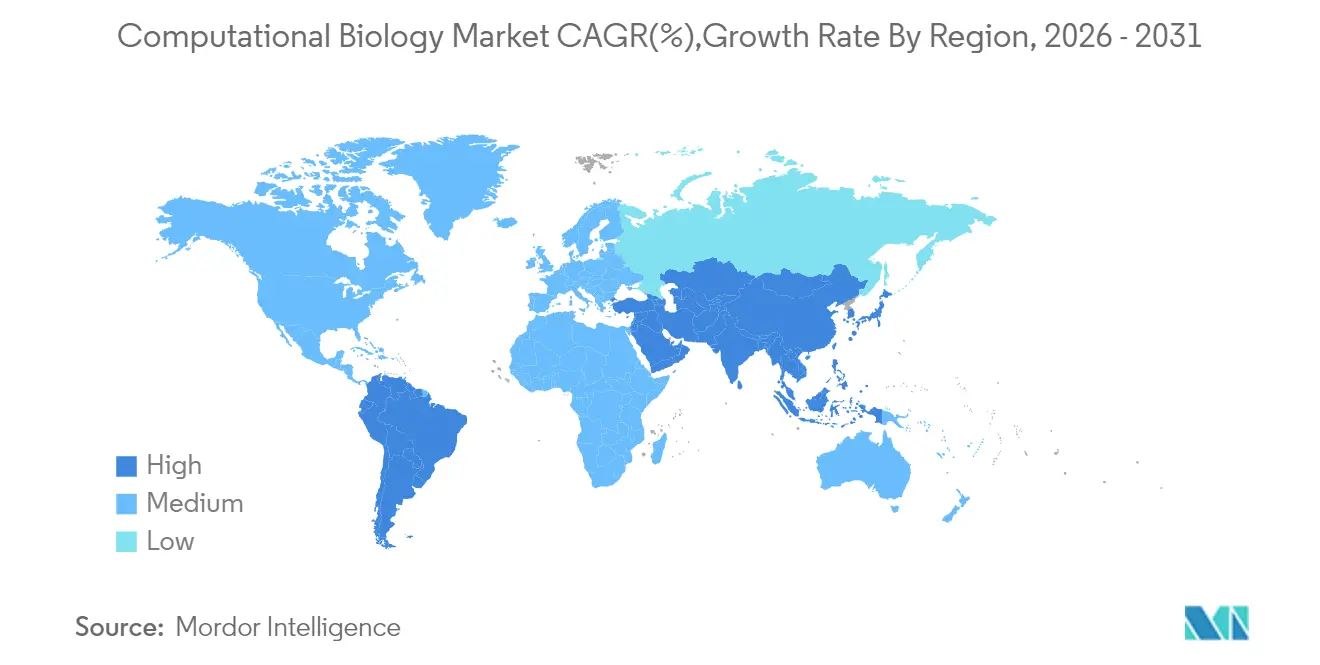
| Schnellstwachsender Markt | Asien-Pazifik |
| Größter Markt | Nordamerika |
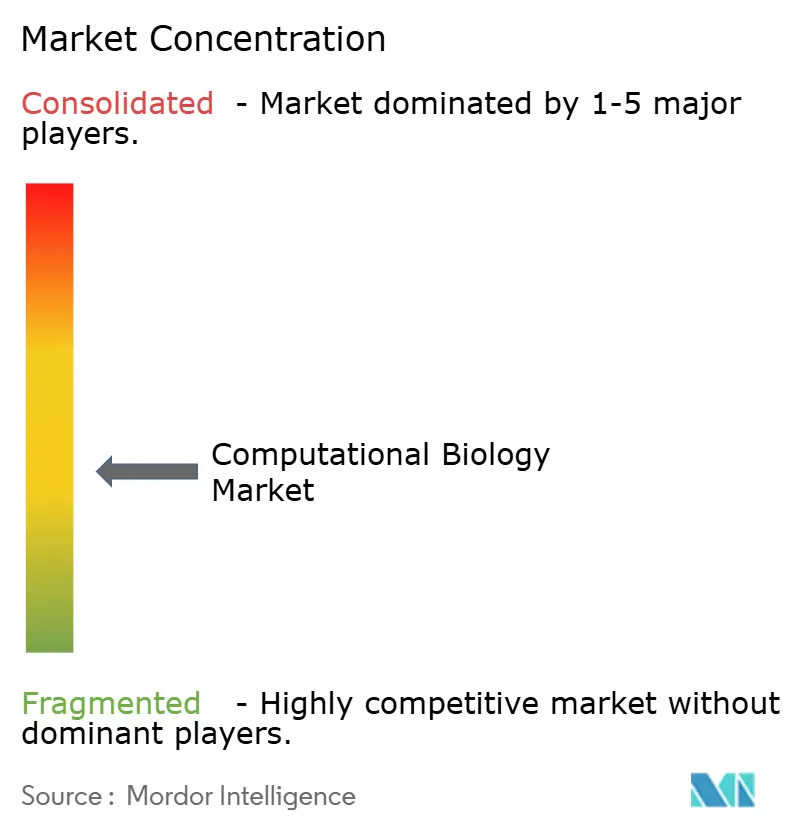
| Marktkonzentration | Mittel |
Hauptakteure *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert Bild © Mordor Intelligence. Wiederverwendung erfordert Namensnennung gemäß CC BY 4.0. | |
Marktanalyse der Computationalen Biologie von Mordor Intelligence
Die Marktgröße der Computationalen Biologie wird im Jahr 2026 auf 8,17 Milliarden USD geschätzt, ausgehend von einem Wert von 7,24 Milliarden USD im Jahr 2025, mit Prognosen für 2031 von 14,89 Milliarden USD, was einem Wachstum von 12,78 % CAGR über den Zeitraum 2026–2031 entspricht. Diese Aussicht signalisiert, wie transformatorbasierte Genomsprachmodelle, digitale Zwillinge der synthetischen Biologie und eine breitere KI-Nutzung nun jede Anwendungsschicht des Marktes für Computationale Biologie prägen. Ein starker Anstieg von Multi-Omics-Datensätzen, anhaltende Verlagerungen hin zu Auftragsforschungsdienstleistungen und der Bedarf an skalierbarer Cloud-Infrastruktur treiben die Nachfrage weiter an. Nordamerika verankert den Markt für Computationale Biologie weiterhin dank ausgereifter Biotechnologieregulierung, aber die Supercomputer-Investitionen im asiatisch-pazifischen Raum und die expandierende pharmazeutische Fertigungsbasis positionieren die Region als nächste Wachstumslokomotive. Unterdessen spiegeln strategische Akquisitionen wie Siemens' 5,1-Milliarden-USD-Deal für Dotmatics die zunehmende Plattformkonsolidierung im Markt für Computationale Biologie wider.
Wichtigste Erkenntnisse des Berichts
- Nach Anwendung entfiel auf zelluläre und biologische Simulation im Jahr 2025 ein Anteil von 32,10 % am Markt für Computationale Biologie, während Wirkstoffforschung und Krankheitsmodellierung bis 2031 mit einer CAGR von 15,33 % wachsen sollen.
- Nach Werkzeug hielten Datenbanken im Jahr 2025 den größten Anteil von 35,95 % an der Marktgröße der Computationalen Biologie; Analysesoftware und -dienstleistungen sollen jedoch bis 2031 mit einer CAGR von 14,49 % expandieren.
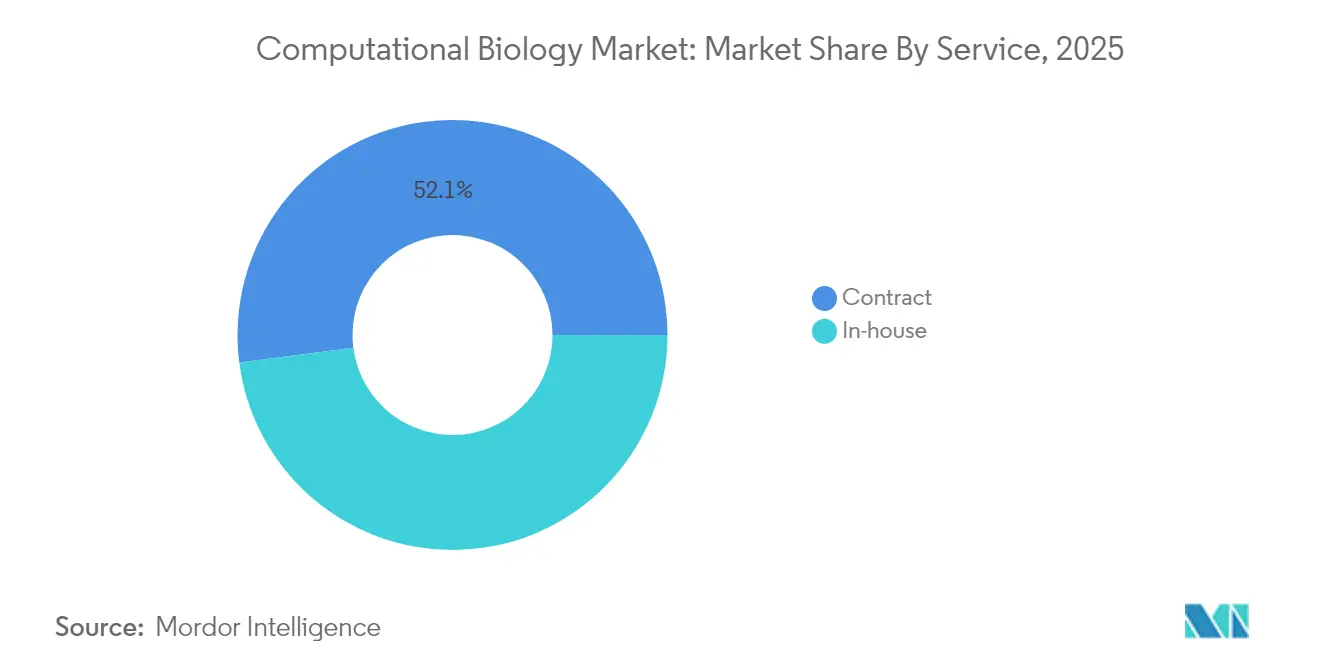
- Nach Dienstleistungsmodell entfielen auf Auftragsvereinbarungen im Jahr 2025 52,05 % des Marktanteils der Computationalen Biologie, und es wird prognostiziert, dass sie bis 2031 mit einer CAGR von 15,72 % wachsen.
- Nach Endnutzer hielt die Wissenschaft im Jahr 2025 einen Umsatzanteil von 44,10 %, während Industrie- und Gewerbenutzer bis 2031 eine CAGR von 14,27 % erzielen sollen.
- Nach Region führte Nordamerika im Jahr 2025 mit einem Marktanteil von 42,30 % an der Computationalen Biologie; der asiatisch-pazifische Raum weist bis 2031 die schnellste CAGR-Prognose von 16,02 % auf.
Hinweis: Die Marktgrößen- und Prognosezahlen in diesem Bericht werden mithilfe des proprietären Schätzrahmens von Mordor Intelligence erstellt und mit den neuesten verfügbaren Daten und Erkenntnissen bis 2026 aktualisiert.
Markttrends und Einblicke
Analyse der Treiberwirkung*
| Treiber | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Steigendes Volumen an Omics-Daten und bioinformatischer Forschung | +2.8% | Global, konzentriert in Nordamerika und der EU | Mittelfristig (2–4 Jahre) |
| Beschleunigter Einsatz in der Wirkstoffforschung und Krankheitsmodellierung | +3.1% | Global, angeführt von Nordamerika, Ausweitung auf den asiatisch-pazifischen Raum | Kurzfristig (≤ 2 Jahre) |
| Ausweitung klinischer pharmakogenomischer und pharmakokinetischer Studien | +1.9% | Nordamerika und EU, aufkommend im asiatisch-pazifischen Raum | Mittelfristig (2–4 Jahre) |
| Transformatorbasierte Genomsprachmodelle ermöglichen schnelle Annotation | +2.2% | Global, frühe Übernahme durch Forschungsinstitute | Kurzfristig (≤ 2 Jahre) |
| Digitale Zwillinge der synthetischen Biologie für In-silico-Workflows | +1.7% | Nordamerika und EU, Pilotprojekte im asiatisch-pazifischen Raum | Langfristig (≥ 4 Jahre) |
| Open-Source-Einzelzell-Abstammungsverfolgungsalgorithmen | +1.5% | Global, akademisch geführt mit industrieller Übernahme | Mittelfristig (2–4 Jahre) |
| Quelle: Mordor Intelligence | |||
Steigendes Volumen an Omics-Daten und bioinformatischer Forschung
Terabyte-skalige Einzelzell-RNA-Sequenzierung, Multi-Omics-Integration und sinkende Sequenzierungskosten weiten die Datenflüsse in den Markt für Computationale Biologie weiter aus. Fortschritte in der Sequenzierung haben die RNA-Seq-Kosten um 50–70 % gesenkt und den Zugang zu Präzisionsmedizin-Datensätzen erweitert. Große Sprachmodelle automatisieren nun 94 % der gängigen Datenelement-Zuordnung und fördern die Interoperabilität.[1]Die daraus resultierenden Datennetzwerkeffekte stärken die Vorteile der Erstmover für Akteure, die die größten Repositorien kontrollieren. Cloud-Bioinformatikplattformen sind daher zu einer obligatorischen Infrastruktur für Organisationen geworden, denen lokale Hochleistungsrechner fehlen.
Beschleunigter Einsatz in der Wirkstoffforschung und Krankheitsmodellierung
Protein-Sprachmodelle wie ESM-3 simulieren evolutionäre Prozesse und erzeugen neuartige Proteinkandidaten in einem Tempo, das Arzneimittelentwickler vor einigen Jahren nicht erreichen konnten. Hybride KI-Quantensysteme, exemplarisch durch Model Medicines' GALILEO, liefern nun antivirale Screens mit einer Trefferquote von 100 %.[2]Digitale Zwillinge ermöglichen es Forschern, Millionen virtueller Experimente durchzuführen und damit Hypothesentestzyklen zu verkürzen und Nasslab-Kosten zu senken. Ein Benchmark mit 479.000 maschinellen Lernversuchen liefert beispiellose Trainingsdaten für die Optimierung des Studiendesigns. Fusionen und Übernahmen, wie die 688-Millionen-USD-Fusion von Recursion und Exscientia, zeigen, dass etablierte Unternehmen darum wetteifern, diese KI-Vorteile zu internalisieren und Plattformen zu konsolidieren.
Ausweitung klinischer pharmakogenomischer und pharmakokinetischer Studien
Präventive pharmakogenomische Tests reduzierten psychiatrische unerwünschte Arzneimittelreaktionen um 34,1 % und Krankenhauseinweisungen um 41,2 %.[3] Reale Panels zeigen, dass 60,4 % der Patienten mindestens eine umsetzbare Verschreibung erhalten. Die UCLA nutzte eine Biobank mit 342.000 Personen, um 156 Gene zu identifizieren, die die Statin-Wirksamkeit modulieren, und lieferte damit den Beweis, dass genetische Vielfalt die Dosierungsgenauigkeit verbessert. KI-gestützte PK/PD-Modelle berücksichtigen nun populationsspezifische Varianten, eine Anforderung, da die Übernahme der Pharmakogenomik im asiatisch-pazifischen Raum zunimmt.
Transformatorbasierte Genomsprachmodelle ermöglichen schnelle Annotation
Open-Source-Proteinmodelle liefern AlphaFold-ähnliche Leistung und benötigen dabei nur handelsübliche GPUs. Bidirektionale DNA-Grundlagenmodelle wie JanusDNA verarbeiten 1 Million Basenpaare ohne spezialisierte Hardware. Parametereffiziente Feinabstimmungsmethoden wie LoRA senken die Trainingskosten und erhalten oder verbessern gleichzeitig die nachgelagerte Vorhersagegenauigkeit. Diese Fortschritte demokratisieren fortgeschrittene Analysen und senken Eintrittsbarrieren, wodurch der Markt für Computationale Biologie weit über traditionelle Bioinformatikzentren hinaus ausgedehnt wird.
Analyse der Hemmnisauswirkungen*
| Hemmnis | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Mangel an multidisziplinären Fachkräften | -1.8% | Global, akut in Nordamerika und der EU | Kurzfristig (≤ 2 Jahre) |
| Interoperabilitäts- und Datenstandardisierungslücken | -1.2% | Global, insbesondere bei grenzüberschreitenden Kooperationen | Mittelfristig (2–4 Jahre) |
| Steigende Cloud- und Rechenkosten | -0.9% | Global, stärkste Auswirkung in kostenempfindlichen Märkten | Kurzfristig (≤ 2 Jahre) |
| Biosicherheits- und Dual-Use-Regulierungsüberprüfung | -0.7% | Hauptsächlich Nordamerika und EU, weltweite Ausweitung | Langfristig (≥ 4 Jahre) |
| Quelle: Mordor Intelligence | |||
Mangel an multidisziplinären Fachkräften
Die Nachfrage nach Fachleuten mit Kenntnissen in Biologie, Softwareentwicklung und Statistik übersteigt das Angebot. Arbeitgeber in den Biowissenschaften rechnen bis 2030 mit einem Fehlbestand von 35 %, wobei die Einstellungsnachfrage voraussichtlich mit einer jährlichen Rate von 11,75 % wachsen wird. Gehaltsinflation und Projektverzögerungen sind die Folge, insbesondere für mittelgroße Biotechnologieunternehmen, die mit Technologiegiganten konkurrieren, die in das Feld eintreten. Kompetenzbasierte Einstellung, Ausbildungsprogramme und branchenübergreifende Rekrutierung sind vorübergehende Abhilfestrategien.
Interoperabilitäts- und Datenstandardisierungslücken
Während Matrix- und Analyse-Metadatenstandards (MAMS) beginnen, Einzelzell-Datensätze anzugleichen, bleibt eine breite Harmonisierung schwer erreichbar. Semantische Zuordnungswerkzeuge können unstrukturierte Gesundheitsakten integrieren; jedoch verlangsamen Implementierungsaufwände ihre Übernahme. Föderierte Lernpiloten schützen die Privatsphäre, stehen aber weiterhin vor regulatorischer Unsicherheit, sodass multinationale Studien auf manuelle Datenbereinigung angewiesen sind.
*Unsere Prognosen behandeln die Auswirkungen von Treibern und Einschränkungen als richtungsweisend und nicht additiv. Die Wirkungsprognosen berücksichtigen Basiswachstum, Mischungseffekte und Wechselwirkungen zwischen Variablen.
Segmentanalyse
Nach Anwendung:
Wirkstoffforschung und Krankheitsmodellierung treiben Workflows der nächsten Generation anWirkstoffforschung und Krankheitsmodellierung verzeichnen bereits die schnellste CAGR von 15,33 %, während zelluläre und biologische Simulation bis 2025 einen Anteil von 32,10 % an der Marktgröße der Computationalen Biologie hielt. KI-gestützte Zielidentifikation und Lead-Optimierung ermöglichen es Unternehmen wie Insilico Medicine, Millionen von Verbindungen in silico zu screenen. Präklinische Teams integrieren nun genomische, proteomische und metabolomische Datensätze, um die Erfolgswahrscheinlichkeit von der Verbindung bis zur Klinik zu erhöhen. Klinische Studienoperationen nutzen retrieval-augmentierte Systeme, die eine Genauigkeit von 97,9 % bei der Eignungsüberprüfung erreichen und damit Rekrutierungsengpässe reduzieren. Eine wachsende Zahl von Forschern nutzt digitale Zwillinge für virtuelle Dosis-Wirkungs-Studien und verkürzt damit die Nasslab-Zeitpläne. Folglich erlebt der Markt für Computationale Biologie ein tieferes pharmazeutisches Engagement in jeder Phase der Forschung und Entwicklung.
Simulationssoftware für den menschlichen Körper entwickelt sich zu einem hochpotentiellen Teilsegment. Stanfords KI-gestützte „virtuelle Zelle” veranschaulicht, wie integrierte Multi-Omics- und biophysikalische Modelle Signalwegstörungen für individualisierte Therapiestrategien kartieren können. Diese Entwicklung erweitert den Markt für Computationale Biologie auf Kliniker der Präzisionsmedizin an vorderster Front. Da die Genauigkeit digitaler Zwillinge zunimmt, beginnen Versicherer, Erstattungsmodelle für computeroptimierte Behandlungspläne zu evaluieren, was auf potenzielle Möglichkeiten für nachgelagerte Einnahmequellen hinweist.


Nach Werkzeug:
Analysesoftware beschleunigt die KI-IntegrationDatenbanken machen weiterhin 35,95 % des Marktanteils der Computationalen Biologie aus, aber Analysesoftware und -dienstleistungen verzeichnen das schnellste Wachstum mit einer CAGR von 14,49 %. Protein- und Genomsprachmodelle veranlassen Organisationen, in analytische Kapazitäten zu investieren, anstatt statische Archive zu pflegen. Anbieter integrieren multimodale Datenpipelines, die genomische, proteomische und klinische Datenströme zusammenführen. Die Verlagerung fördert auch akademisch-industrielle Konsortien zur gemeinsamen Entwicklung von Open-Source-Stacks; Boltz-1's AlphaFold-vergleichbare Genauigkeit auf Standard-GPUs unterstreicht, wie Community-Innovation eine breitere Übernahme fördert.
Lokale Hochleistungsrechner bleiben wichtig für die Verarbeitung sensibler Datensätze; jedoch fördern Cloud-Kostenkurven und die Reife verwalteter Dienste die Migration. Anbieter differenzieren sich durch automatische Skalierungsalgorithmen und Sicherheitszertifizierungen. Datenbankinhaber reagieren, indem sie Analyseebenen auf Repositorien aufbauen, um ihre installierte Basis zu verteidigen. Der Nettoeffekt erhöht den Wettbewerb, hebt aber die Gesamtsoftwarequalität an und unterstützt ein nachhaltiges Wachstum im Markt für Computationale Biologie.
Nach Dienstleistung:
Auftragsmodelle dominieren das WachstumAuftragsforschungsdienstleistungen führen sowohl bei Anteil als auch bei Dynamik – 52,05 % im Jahr 2025 und eine CAGR-Prognose von 15,72 % –, da Pharmaunternehmen komplexe In-silico-Workflows auslagern. Auftragsforschungsorganisationen bündeln nun Genomanalyse, KI-Modellentwicklung und virtuelles Screening in einheitlichen Abonnements. Interne Teams behalten kernige, IP-intensive Algorithmen, arbeiten aber extern für rechenintensive Simulationen zusammen.
Hybride Dienstleistungsrahmen gewinnen an Bedeutung. Unternehmen pflegen Datenverwaltungsknoten vor Ort und nutzen gleichzeitig Cloud-basierte Auftragsforschungsplattformen für Spitzenlasten. Strategische Allianzen verteilen das Risiko: Kunden zahlen nutzungsbasierte Gebühren, während Anbieter Service-Level-Vereinbarungen garantieren, die regulatorische Unterstützung umfassen. Mit zunehmender Übernahme integriert sich der Markt für Computationale Biologie weiter in traditionelle Wertschöpfungsketten der Arzneimittelentwicklung.
Nach Endnutzer:
Industrielle Übernahme beschleunigt sichDie Wissenschaft kontrollierte im Jahr 2025 44,10 % des Umsatzes, doch Industrienutzer gewannen mit einer CAGR von 14,27 % bis 2031 an Dynamik. Sinkende Sequenzierungskosten, validierte KI-Pipelines und dringende therapeutische Zeitpläne treiben die pharmazeutische Übernahme voran. Unternehmenskäufer suchen schlüsselfertige Lösungen, die Prüfpfade einbetten und GxP-Vorschriften entsprechen.
Akademische Einrichtungen bleiben Wissensmotoren und entwickeln Algorithmen, die später kommerziell lizenziert werden. Um Budgetbeschränkungen entgegenzuwirken, erweitern Universitäten Partnerschaftsmodelle, bei denen Technologieanbieter Rechenkapazitätsguthaben im Austausch für Mitautorenschaft und frühen Zugang zu Feedback bereitstellen. Diese Symbiose erhält Innovationstrichter für die Branche der Computationalen Biologie aufrecht.
Geografische Analyse
Markt für Computationale Biologie in Nordamerika
Nordamerika, das 2025 einen Umsatzanteil von 42,30 % auf sich vereint, profitiert von einem tiefen Biotech-Risikokapital, einer ausgereiften Regulierungsbehördenbeziehung und einem dichten Talentpool. Der sich weiterentwickelnde KI-Rahmen der FDA bietet lokalen Unternehmen einen unkomplizierteren Kommerzialisierungsweg als vielen ihrer Mitbewerber. Thermo Fishers mehrjährige Inlandsinvestition in Höhe von 2 Milliarden USD unterstreicht das Vertrauen in die Skalierbarkeit der Infrastruktur; dennoch bremsen Arbeitskräftemangel und steigende Cloud-Kosten die Beschleunigung.
Markt für Computationale Biologie im asiatisch-pazifischen Raum
Der asiatisch-pazifische Raum verzeichnet mit 16,02 % die höchste jährliche Wachstumsrate. Regierungen finanzieren Exaflop-Supercomputer – Südkoreas Plan sieht einen Start bis 2025 vor –, während Chinas dezentrale nationale Zentren bereits Multi-Omics-Projekte vorantreiben. Die regionale pharmazeutische Fertigung boomt, und genetische Diversitätsforschungsprogramme passen KI-Modelle an lokale Bevölkerungsgruppen an, wodurch einzigartige Randdaten entstehen, die anderswo nicht verfügbar sind. Dezentralisierte klinische Studien-Pilotprojekte und der Aufbau von mRNA-Plattformen stärken die langfristige Nachfrage nach Kapazitäten im Markt für Computationale Biologie.
Markt für Computationale Biologie in EMEA und Lateinamerika
Europa verzeichnet ein stetiges Wachstum, getragen von grenzüberschreitenden Konsortien und robusten Datenschutzbestimmungen. Ethische KI-Initiativen erhöhen den Compliance-Aufwand, fördern jedoch auch das Vertrauen bei Kostenträgern und Regulierungsbehörden. Digitale-Zwilling-Pilotprojekte stehen im Einklang mit den Zielen des öffentlichen Gesundheitswesens zur Optimierung der Ressourcennutzung. Unterdessen machen Lateinamerika, Afrika und der Nahe Osten Fortschritte, da die Internetinfrastruktur und bioinformatische Lehrpläne ausgebaut werden. Partnerschaften mit multinationalen Pharmakonzernen kompensieren lokale Finanzierungslücken und sichern eine schrittweise, aber beständige Marktdurchdringung in der Computationalen Biologie.

Regulatorisches Umfeld
In den Vereinigten Staaten formalisiert die FDA zunehmend die Erwartungen an KI-gestützte computergestützte Methoden, die bei der Entwicklung von Arzneimitteln und Biologika eingesetzt werden. Im Januar 2025 veröffentlichte die Behörde einen Leitlinienentwurf zur Nutzung künstlicher Intelligenz zur Unterstützung regulatorischer Entscheidungen für Arzneimittel und biologische Produkte, mit Schwerpunkt auf einer risikobasierten Glaubwürdigkeitsbewertung von KI-Ergebnissen, die in Einreichungen verwendet werden. Die FDA treibt zudem weiterhin New Approach Methodologies (NAMs) voran und veröffentlichte im März 2026 einen Leitlinienentwurf zu Alternativen zu Tierversuchen, der die regulatorischen Anerkennungswege für validierte In-silico- und andere humanrelevante Ansätze stärkt.
In Europa erhöhen KI-Governance- und Life-Science-Politikinitiativen die Compliance-Anforderungen für computergestützte Biologieplattformen, die sensible biomedizinische Daten verarbeiten. Die Europäische Kommission entwickelt eine umfassendere Biotechnologie-Politikagenda, einschließlich der Initiative zum europäischen Biotech-Gesetz, während der KI-Regulierungsrahmen der EU lebenszyklusbezogene Pflichten in Bezug auf Dokumentation, Risikomanagement und Datenverwaltung hinzufügt, die beeinflussen können, wie computergestützte Modelle in regulierten Arbeitsabläufen entwickelt und eingesetzt werden. Parallel dazu unterstreicht die Dynamik bei der Standardsetzung in den USA, einschließlich vorgeschlagener Gesetzgebung, die NIST-verknüpfte Arbeiten an Definitionen und Rahmenwerken für KI-taugliche biologische Datensätze vorschreibt (H.R. 7907), die Bedeutung von Datenqualität, Herkunftsnachweis und Interoperabilität in der Multi-Omics-Analytik, die in regulatorische Entscheidungen einfließt.
Wertschöpfungskettenanalyse
Die Wertschöpfungskette der computergestützten Biologie beginnt mit der Erzeugung biologischer und klinischer Daten (Sequenzierung, Proteomik, Bildgebung und Real-World-Klinikdaten), gefolgt von Erfassung, Kuratierung, Harmonisierung und sicherer Speicherung in Repositorien und Data Lakes. Modellentwicklung und -validierung hängen dann von skalierbarer Infrastruktur ab, einschließlich HPC-Clustern und Cloud-Beschleunigern, sowie von spezialisierten Softwareschichten wie Workflow-Orchestrierung, Analysesoftware, Simulationsengines und Fachdatenbanken. Die Ergebnisse werden in Unternehmens-Workflows für Wirkstoffforschung, Krankheitsmodellierung, Pharmakogenomik und klinische Studienabläufe verpackt und über lizenzierte Plattformen, interne Teams oder Vertragsdienstleister bereitgestellt.
Die nachgelagerte Bereitstellung hängt zunehmend von integrierten Ökosystemen ab, die Algorithmen, Rechenleistung und kontrollierten Datenzugang miteinander verbinden. Partnerschaften wie die von Illumina und NVIDIA (Januar 2025) zeigen, wie Omics-Pipelines, einschließlich DRAGEN-Analytik, mit beschleunigten Compute-Stacks verknüpft werden, um die Durchlaufzeit für große Multi-Omics-Workloads zu verkürzen. Zu den wichtigsten Engpässen zählen Reibungsverluste bei der Datenmigration für Datensätze im Terabyte-Bereich, Interoperabilitätslücken zwischen proprietären Umgebungen und Anbieterabhängigkeitsrisiken, wenn Workflows eng an bestimmte Cloud-Konfigurationen gekoppelt sind, was die Reproduzierbarkeit und Prüfbarkeit in regulierten Umgebungen beeinträchtigen kann.
Wettbewerbslandschaft
Der Markt für Computationale Biologie bleibt mäßig fragmentiert, zeigt aber einen klaren Trend zu Fusionen und Übernahmen. Siemens' 5,1-Milliarden-USD-Übernahme von Dotmatics integriert Labor-Informatik mit industriellen Angeboten für digitale Zwillinge und spiegelt den Wunsch der Käufer nach End-to-End-Stacks wider. Danaher hat Genedata in sein Portfolio aufgenommen und folgt damit derselben Logik. Illumina arbeitet mit NVIDIA zusammen, um GPU-gestützte Omics-Analysen zu beschleunigen – ein Beispiel für die Konvergenz von Technologie und Biotechnologie.
Start-ups nutzen Open-Source-Gemeinschaften, um über ihre Gewichtsklasse hinaus zu agieren. EvolutionaryScale sammelte 142 Millionen USD ein, um proteingenerierendeKI zu kommerzialisieren, die direkt mit den proprietären Chemien der etablierten Unternehmen konkurriert. Patentanmeldungen rund um hybride Quanten-klassische Modelle und Abstammungsverfolgungsalgorithmen deuten auf eine Intensivierung von IP-Kämpfen hin. Der Wettbewerbserfolg wird vom Zugang zu kuratierten Datensätzen, skalierbaren Rechenkapazitäten und integrierten Workflows abhängen, die die Wechselkosten minimieren.
Große Anbieter verfolgen Ökosystem-Lock-in durch Abonnementlizenzierung und Datennetzwerkeffekte. Mittelgroße Akteure differenzieren sich durch vertikale Spezialisierung – Einzelzellanalysen, Engines für digitale Zwillinge oder pharmakogenomische Toolkits. Der Preiswettbewerb ist gedämpft, da Genauigkeit, regulatorische Compliance und Durchlaufgeschwindigkeit entscheidende Kaufkriterien bleiben.
Marktführer der Computationalen Biologie
-
Dassault Systèmes SE
-
Schrödinger Inc.
-
Certara
-
Simulation Plus Inc.
-
Illumina Inc.
- *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert
Markt für Computationale Biologie
- Dassault Systèmes SE
- Certara
- Chemical Computing Group
- Compugen
- Rosa
- Genedata
- Insilico Biotechnology
- Instem Plc (Leadscope Inc.)
- Nimbus Therapeutics LLC
- Strand Life Sciences
- Schrödinger Inc.
- Simulation Plus
- Illumina
- Thermo Fisher Scientific
- QIAGEN
- Deep Genomics Inc.
- Benevolent AI
- Ginkgo Bioworks
- Atomwise Inc.
- DNAnexus Inc.
- Bio-Rad Laboratories
Lesen Sie die Analyse der Computationale Biologie-Unternehmen

Marktchancen und Zukunftsaussichten
Umfangreiche, mehrjährige Investitionen in den Aufbau prädiktiver, multimodaler Biologiemodelle schaffen Freiräume für Plattformen, die interoperable Datenpipelines, mechanistische Simulation und kontrollierte Modellwiederverwendung operationalisieren können. Im April 2026 kündigte Biohub eine fünfjährige Virtual Biology Initiative im Umfang von 500 Millionen USD an, die sich auf prädiktive Modelle des Lebens unter Verwendung multimodaler Datensätze konzentriert und die Nachfrage nach Tools erhöht, die Multi-Omics integrieren, die Herkunft bewahren und institutionsübergreifende reproduzierbare Modellentwicklung unterstützen können.
Die Modernisierung der klinischen Entwicklung erweitert zudem die Chancen für Anbieter computergestützter Biologie, die sichere Cloud-Analytik, Echtzeitüberwachung und nachvollziehbare Modellergebnisse anbieten, die sich in einreichungsfertige Workflows einfügen. Im April 2026 initiierte die FDA eine Proof-of-Concept-Klinikstudie mit AstraZeneca, UT MD Anderson und der University of Pennsylvania, um eine Echtzeit-Endpunktüberwachung in der Cloud zu ermöglichen, was die Anforderungen an skalierbare, kontrollierte Datenverarbeitung während Studien erhöht. Standardisierungsprogramme wie ARPA-H IGoR (angekündigt im Mai 2026) verstärken die Nachfrage nach wiederverwendbaren, überprüfbaren experimentellen Daten und Protokollen und unterstützen Anbieter von Tools, die interoperable Metadatenstandards und Validierung in alltägliche computergestützte Arbeitsabläufe einbetten können.
Recent Industry Developments in Markt für Computationale Biologie
- Mai 2026: Veristat schloss die Übernahme des Regulatory- und Medical-Writing-Geschäfts von Certara ab, einschließlich der Übernahme von mehr als 200 Regulatory-Experten. Die Transaktion verlagert diese Fähigkeiten zu einem spezialisierten Anbieter klinischer und regulatorischer Dienstleistungen, während Certara seinen Fokus stärker auf seine Kernangebote im Bereich Arzneimittelentwicklungssoftware und modellgestützte Entscheidungsunterstützung richtet.
- April 2026: Certara schloss eine endgültige Vereinbarung zum Verkauf seines Regulatory-Writing- und Medical-Writing-Geschäfts an Veristat für bis zu 135 Millionen USD. Die Veräußerung spiegelt eine Portfoliobereinigung hin zu skalierbaren computergestützten Plattformen wider und signalisiert zudem eine anhaltende Konsolidierung und Spezialisierung bei ausgelagerten regulatorischen Dienstleistungen im Zusammenhang mit datenintensiven Entwicklungsprogrammen.
- Januar 2026: Schrödinger ging eine Partnerschaft mit Eli Lilly and Company ein, um die Lilly-TuneLab-KI-Plattform als vorrangige Schnittstelle innerhalb der Enterprise-Informatikplattform LiveDesign von Schrödinger verfügbar zu machen. Der Integrationsansatz erhöht die Bindung von Enterprise-Discovery-Workflows, indem KI-Fähigkeiten von Drittanbietern in etablierte Umgebungen für Computerchemie und -biologie eingebettet werden.


Markt für Computationale Biologie Berichtsumfang und Forschungsmethodik
Marktdefinition und Erfassungsbereich
Dieser Markt umfasst Umsätze aus computergestützten Tools und Dienstleistungen, die dabei helfen, biologische Daten für Forschungs- und Entwicklungsarbeiten zu speichern, zu verarbeiten und zu modellieren, einschließlich Wirkstoffforschung, Krankheitsmodellierung, Genomik und Proteomik.
Ausschlüsse: Wir schließen kostenlose akademische Software und Open-Source-Code aus, der ohne kostenpflichtige Lizenz, kostenpflichtigen Support oder kostenpflichtiges Abonnement bereitgestellt wird.
Übersicht der Segmentierung
- Nach Anwendung
- Zelluläre und Biologische Simulation
- Computergestützte Genomik
- Computergestützte Proteomik
- Pharmakogenomik
- Sonstige Simulationen (Transkriptomik/Metabolomik)
- Wirkstoffforschung und Krankheitsmodellierung
- Zielidentifikation
- Zielvalidierung
- Lead-Entdeckung
- Lead-Optimierung
- Präklinische Wirkstoffentwicklung
- Pharmakokinetik
- Pharmakodynamik
- Klinische Studien
- Phase I
- Phase II
- Phase III
- Simulationssoftware für den menschlichen Körper
- Zelluläre und Biologische Simulation
- Nach Werkzeug
- Datenbanken
- Infrastruktur (Hardware)
- Analysesoftware und -dienstleistungen
- Nach Dienstleistung
- Intern
- Auftrag
- Nach Endnutzer
- Wissenschaft
- Industrie und Gewerbe
- Nach Geografie
- Nordamerika
- Vereinigte Staaten
- Kanada
- Mexiko
- Europa
- Deutschland
- Vereinigtes Königreich
- Frankreich
- Italien
- Spanien
- Übriges Europa
- Asiatisch-pazifischer Raum
- China
- Japan
- Indien
- Australien
- Südkorea
- Übriger asiatisch-pazifischer Raum
- Naher Osten und Afrika
- Golfkooperationsrat
- Südafrika
- Übriger Naher Osten und Afrika
- Südamerika
- Brasilien
- Argentinien
- Übriges Südamerika
- Nordamerika
Datenquellen, Marktdimensionierung und Validierung
Schreibtischrecherche
Die Schreibtischarbeit beginnt mit dem Aufbau einer soliden Faktenbasis zu Life-Science-F&E-Aktivitäten und Datenerzeugung und bildet anschließend ab, wo Ausgaben für computergestützte Biologie typischerweise innerhalb dieser Aktivität liegen. Wir nutzen öffentliche Quellen wie die Fördermitteldatenbanken der National Institutes of Health, öffentliche Zulassungen und Studienregister der US-FDA und der EMA, Repository-Statistiken von NCBI und EMBL-EBI sowie Wissenschafts- und Technologieindikatoren der OECD und der Weltbank.
Wir prüfen zudem begutachtete Fachzeitschriften zur Anwendung computergestützter Methoden, Patente, um zu verstehen, wo neue Algorithmen und Workflows entwickelt werden, sowie Unternehmensmeldungen und Investorenpräsentationen, um Umsatzexposition und Preislogik zu identifizieren. Zum Abgleich werden selektiv ein kostenpflichtiges Abonnement mit Fokus auf Unternehmensfinanzen und eine kostenpflichtige Patentdatenbank genutzt, um Vergleichsgruppen zu standardisieren und das Risiko zu verringern, private Marktteilnehmer zu übersehen. Diese Quellen sind nicht erschöpfend, und wir nutzen bei Bedarf zusätzliche öffentliche und kostenpflichtige Referenzen zur Datenerhebung, Validierung und Klärung.
Primärinterviews und Umfragen
Primärarbeit dient dazu, zu bestätigen, wofür bezahlt wird und was frei genutzt wird, was in der computergestützten Biologie von Bedeutung ist. Wir sprachen mit Lösungsanbietern, Forschungsleitern und Managern auf Käuferseite in der Region APAC, EMEA und Amerika, um Adoptionsraten, typische Vertragsgrößen und die Aufteilung zwischen Software, Dienstleistungen und Datenbankzugang zu validieren, bevor die endgültigen Annahmen festgelegt wurden.
Verteilung der Befragten der primären Feldforschung
| Unternehmenstyp | Position des Befragten | Region |
|---|---|---|
| Top-Tier: 34% | CXOs: 16% | APAC: 48% |
| Mid-Tier: 46% | Funktions-/Bereichsleiter: 25% | EMEA: 32% |
| Kleinere Akteure: 20% | Manager: 59% | Amerika: 20% |
Marktdimensionierung und Prognose
Unsere Dimensionierung nutzt einen Top-down-Ansatz, der bei Life-Science-F&E- und klinischen Aktivitätssignalen beginnt und dann den zahlungspflichtigen Nachfragepool für computergestützte Biologie durch Anwendung von Adoptions- und Ausgabenintensitätsfaktoren rekonstruiert. Die Summen werden dann durch selektive Bottom-up-Näherungen überprüft, einschließlich Stichproben-Umsatzabbildungen von Anbietern, typischer jährlicher Abonnement- oder Lizenzpreisspannen sowie Volumenprüfungen anhand aktiver Nutzergruppen in Forschungsinstituten und Pharmaumgebungen.
Zu den erfassten Eingaben zählen Sequenzierungs- und Omics-Datenvolumina (die den Bedarf an Rechenleistung und Datenbanken erhöhen), die Anzahl und Zusammensetzung von Wirkstoffforschungsprogrammen und klinischen Studien sowie das Tempo der Nutzung von KI und Simulation in Discovery-Workflows. Wir beobachten zudem den Mix aus Cloud- und On-Premise-Bereitstellung sowie die typische Preisentwicklung für Lizenzen und Dienstleistungen mit zunehmender Skalierung der Workloads. Wo Bottom-up-Signale für kleinere geografische Regionen dünn sind, wenden wir regionsspezifische Adoptionskurven an, die in Interviews validiert und anschließend anhand von Förder- und Publikationsintensität plausibilisiert wurden.
Für die Prognose stützen wir uns hauptsächlich auf Szenarioanalysen, unterstützt durch multivariate Regressionsprüfungen, da sich der Markt gleichzeitig durch mehrere Treiber bewegt und nicht durch eine einzelne Reihe. Annahmen zu Fördermitteln, Studienaktivität und Rechenintensität werden mit Expertenkonsens aktualisiert, damit die Prognose praktikabel und nachvollziehbar bleibt.
Datenvalidierung und Aktualisierungszyklus
Die Ergebnisse werden durch mehrere Gegenprüfungen validiert, sodass eine einzelne Datenreihe den Endwert nicht übermäßig beeinflusst. Wir vergleichen die Ergebnisse mit unabhängigen Signalen wie der Richtung öffentlicher Forschungsförderung, Trendlinien der Studienaktivität und offengelegter Umsatzexposition relevanter Marktteilnehmer und untersuchen anschließend etwaige ungewöhnliche Sprünge vor der internen Freigabe.
Wenn eine wesentliche politische Änderung, eine starke Verschiebung bei der Förderung oder eine Beschleunigung der Cloud-Migration festgestellt wird, werden Experten erneut kontaktiert, um die wichtigsten Annahmen erneut zu prüfen, und das Modell wird neu berechnet. Der Bericht wird jährlich aktualisiert, wesentliche Ereignisse können Zwischenaktualisierungen auslösen, gefolgt von einer abschließenden Überprüfung vor der Lieferung, damit die Kunden die aktuellste Sicht erhalten.
Vergleich der Marktgröße für computergestützte Biologie von Mordor Intelligence mit anderen veröffentlichten Schätzungen
Veröffentlichte Marktgrößen für computergestützte Biologie können weit auseinanderliegen, da Unternehmen nicht immer dieselben Umsatzströme erfassen und zudem unterschiedliche Basisjahre und Wachstumszeiträume wählen. Unterschiede darin, ob kostenlose Forschungstools als bezahlte Äquivalente behandelt werden, sowie darin, wie Software, Dienstleistungen und Datenbankzugang gruppiert werden, sind in der Regel die Hauptgründe.
Die Vergleichstabelle zeigt eine Streuung, die hauptsächlich durch Umfang und Zeitpunkt erklärt wird, und im Modell von Mordor Intelligence umfasst die Gesamtsumme für 2026 bezahlte Softwareplattformen, zugehörige Dienstleistungen, Infrastruktur-Tools und spezialisierte Datenbanken, lässt jedoch akademische Freeware und Open-Source-Code außen vor, der ohne monetarisierten Support vertrieben wird.
Vergleichsanalyse
| Quelle | Marktgröße | Lücken in der Forschungsmethodik |
|---|---|---|
| Mordor Intelligence | 8,17 Mrd. USD (2026) | |
| Branchenverlag A | 5,90 Mrd. USD (2024) | Verwendet ein früheres Basisjahr und kann bezahlte Umsätze mit breiteren Proxys für Forschungsaktivität vermischen, was in der Regel die kommerzielle Nutzung in späteren Phasen unterschätzt und Skaleneffekte durch Cloud- und KI-gestützte Workflows verzögert. |
| Branchenverlag B | 5,14 Mrd. USD (2025) | Geht von einem anderen Basisjahr aus und wendet häufig engere kommerzielle Definitionen für Plattformumsätze an, was den Beitrag bezahlter Dienstleistungen und spezialisierten Datenbankzugangs, den Käufer oft zusätzlich zu Tools erwerben, verringern kann. |
Wenn diese Unterschiede explizit gemacht werden, lässt sich die verbleibende Abweichung leichter interpretieren. Unser Ansatz bleibt nachvollziehbar an klaren Grenzen bezahlter Umsätze und wiederholbaren Nachfragetreibern orientiert, was Entscheidungsträgern hilft, Regionen und Zeiträume zu vergleichen, ohne kostenlose Nutzung mit bezahltem Marktwert zu vermischen.


Im Bericht beantwortete Schlüsselfragen
Wie groß ist der aktuelle Markt für Computationale Biologie?
Der Markt für Computationale Biologie generiert im Jahr 2026 einen Umsatz von 8,17 Milliarden USD und ist auf dem Weg, bis 2031 einen Wert von 14,89 Milliarden USD zu erreichen.
Welcher Anwendungsbereich wächst am schnellsten?
Wirkstoffforschung und Krankheitsmodellierung verzeichnet bis 2031 die höchste CAGR von 15,33 %, angetrieben durch KI-gestützte Zielidentifikation und Workflows mit digitalen Zwillingen.
Warum wachsen Auftragsforschungsdienstleistungen so schnell?
Pharmaunternehmen lagern datenintensive Modellierung an spezialisierte Auftragsforschungsorganisationen aus, was Auftragsdienstleistungen einen Anteil von 52,05 % und eine Wachstumsrate von 15,72 % beschert.
Welche Region wird am meisten zum zukünftigen Wachstum beitragen?
Der asiatisch-pazifische Raum führt mit einer CAGR von 16,02 % dank staatlicher Supercomputer-Projekte und einer rasch expandierenden pharmazeutischen Fertigung.
Was hindert eine breitere Übernahme von Plattformen der Computationalen Biologie?
Ein Mangel an multidisziplinären Fachkräften, steigende Cloud-Rechenkosten und sich entwickelnde Biosicherheitsvorschriften sind die wesentlichen Einschränkungen.


 Ihre Daten sind sicher und werden niemals verkauft oder weitergegeben.

