
Bioinformatik-Marktgröße und -Marktanteil
Marktübersicht
| Studienzeitraum | 2020 - 2031 |
|---|---|
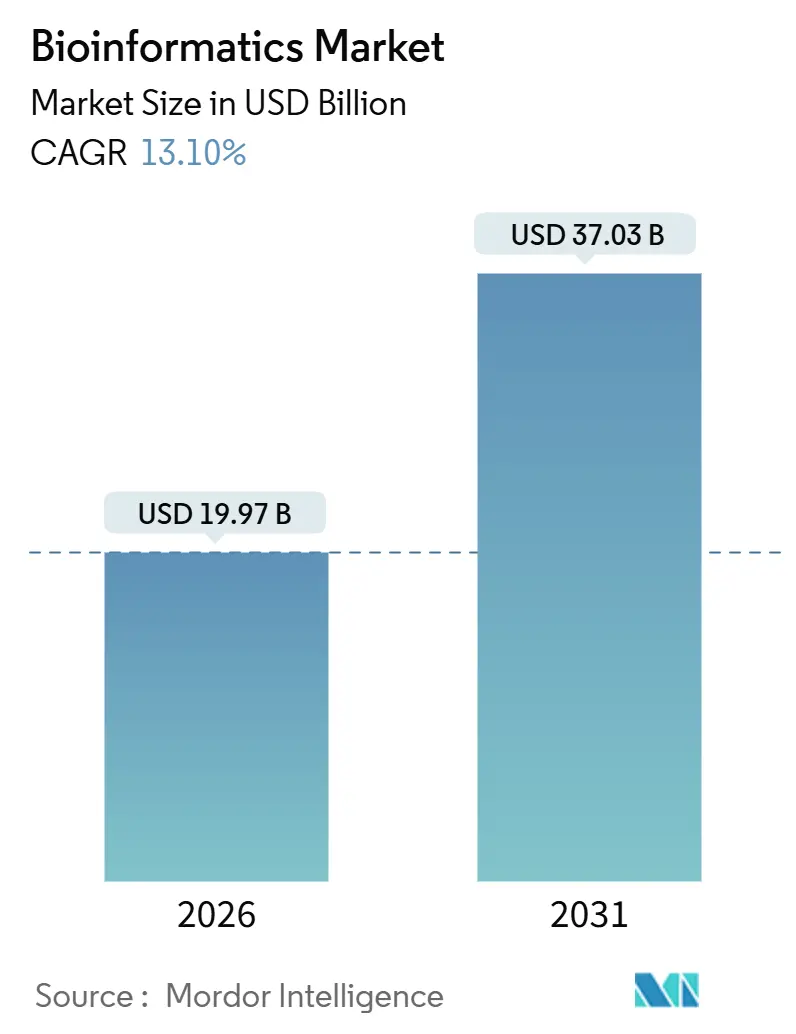
| Marktgröße (2026) | 19.97 Milliarden US-Dollar |
| Marktgröße (2031) | 37.03 Milliarden US-Dollar |
| Wachstumsrate (2026 - 2031) | 13.10 % |
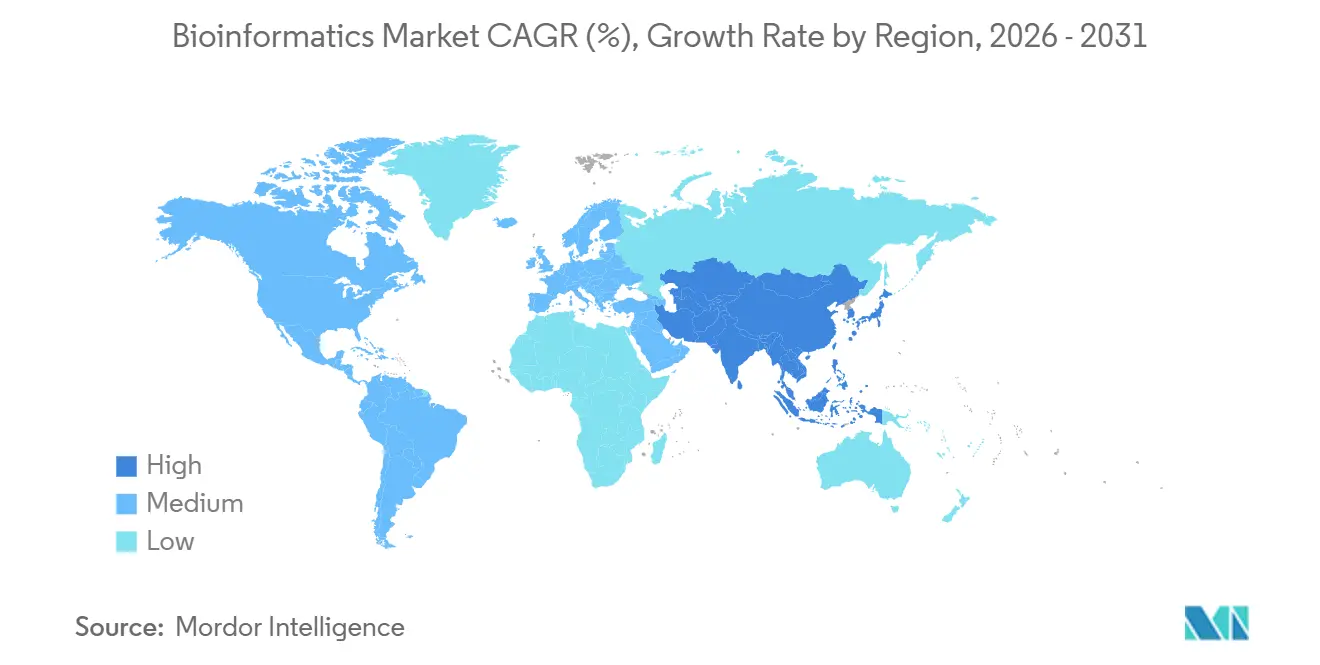
| Schnellstwachsender Markt | Asien-Pazifik |
| Größter Markt | Nordamerika |
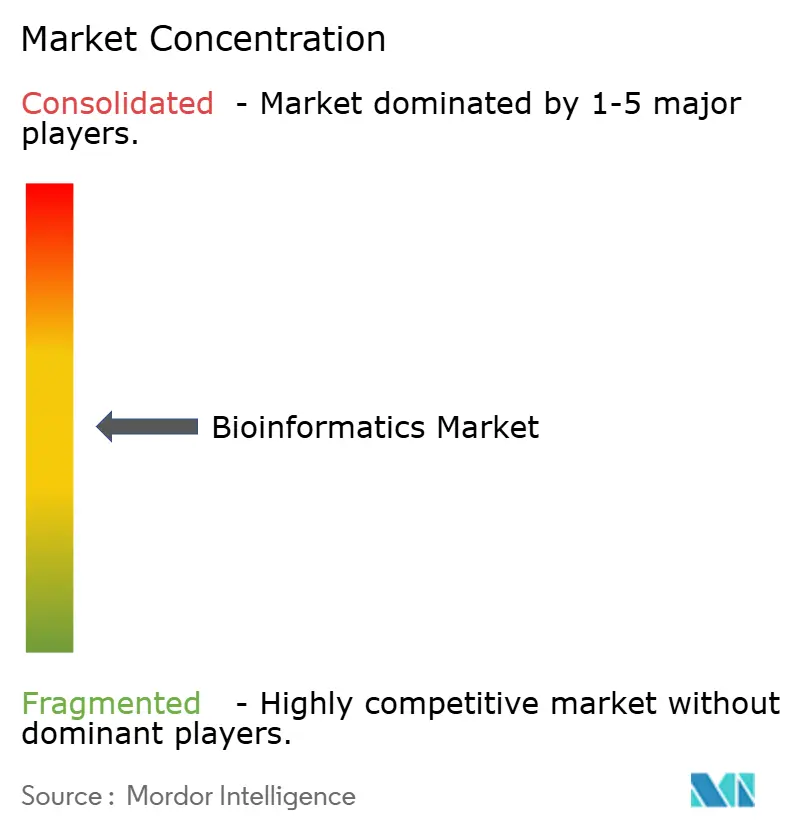
| Marktkonzentration | Mittel |
Hauptakteure
*Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert Bild © Mordor Intelligence. Wiederverwendung erfordert Namensnennung gemäß CC BY 4.0. |
|
Bioinformatik-Marktanalyse von Mordor Intelligence
Die Bioinformatik-Marktgröße wird im Jahr 2026 auf 19,97 Milliarden USD geschätzt und soll bis 2031 einen Wert von 37,03 Milliarden USD erreichen, bei einem CAGR von 13,10 % während des Prognosezeitraums (2026–2031).
Eine wachsende Pipeline von Multi-Omics-Studien, zunehmender regulatorischer Druck für Präzisionsdiagnostik und die Neuausrichtung des Pharmasektors auf datenzentrierte Forschung und Entwicklung positionieren Bioinformatik-Plattformen zunehmend von taktischen Werkzeugen zu Unternehmensinfrastruktur. Cloud-Hyperscaler integrieren genomikoptimierte Dienste, die Investitionsausgaben auf verbrauchsbasierte Modelle verlagern, während Analysen in Instrumentennähe die Latenz und Datenübertragungskosten in klinischen Labors reduzieren. Anbieter, die KI-native Algorithmen mit elastischem Computing kombinieren, gewinnen den größten Anteil an neuen Implementierungen, auch wenn Cybersicherheits- und Fachkräftemangel die kurzfristige Skalierbarkeit dämpfen. Die daraus resultierende Wettbewerbslandschaft ist durch Konvergenz geprägt: Hersteller von Sequenzierungsinstrumenten, Auftragsforschungsorganisationen und Software-Start-ups konkurrieren nun um denselben Analyse-Stack.
Wichtigste Erkenntnisse des Berichts
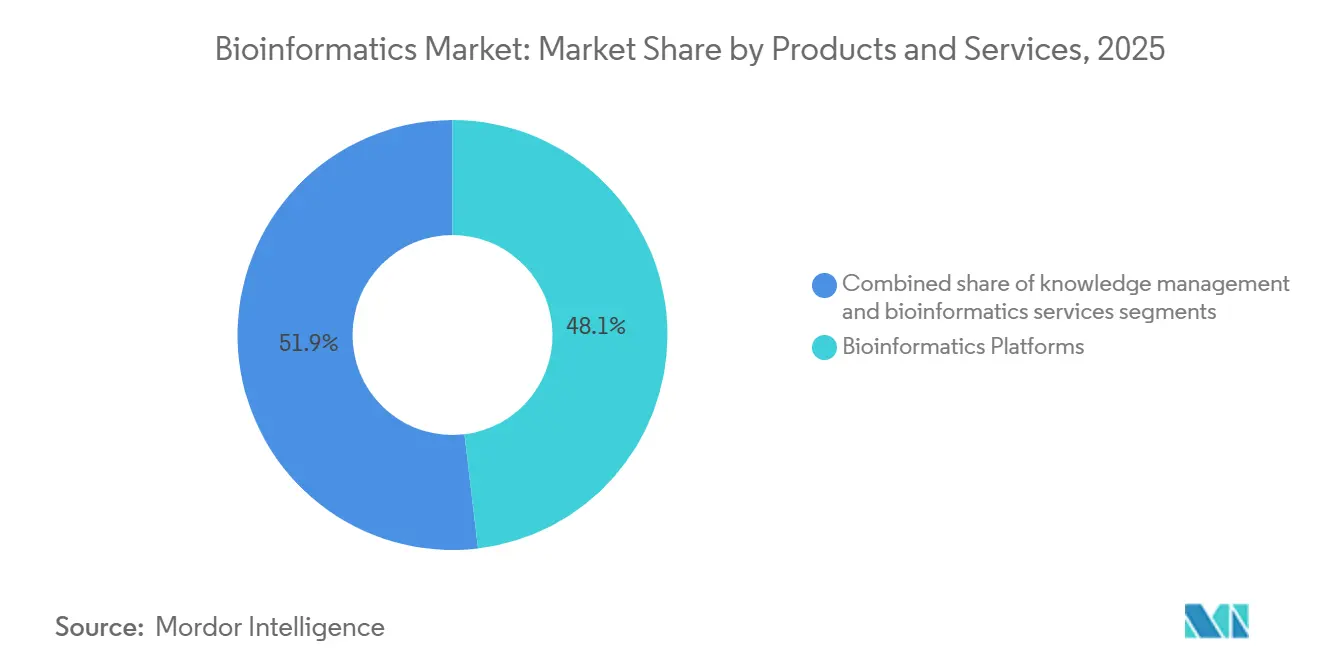
- Nach Produkten und Dienstleistungen führten Bioinformatik-Plattformen im Jahr 2025 mit einem Umsatzanteil von 48,1 %, während Bioinformatik-Dienstleistungen bis 2031 mit einem CAGR von 14,1 % wachsen.
- Nach Anwendung entfielen im Jahr 2025 34,6 % der Bioinformatik-Marktgröße auf Genomik und Transkriptomik, während Proteomik und Metabolomik bis 2031 voraussichtlich mit einem CAGR von 14,43 % wachsen werden.
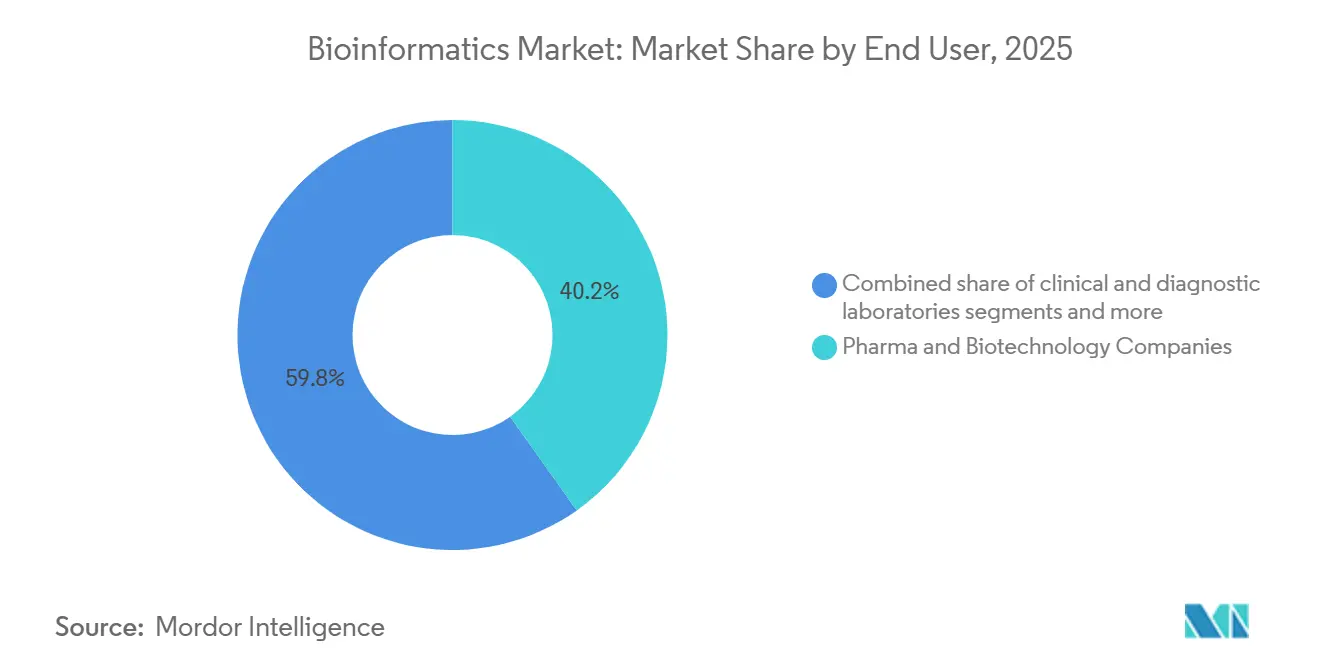
- Nach Endnutzer entfielen im Jahr 2025 40,2 % des Bioinformatik-Marktanteils auf Pharma- und Biotechnologieunternehmen; Auftragsforschungsorganisationen sind das am schnellsten wachsende Segment mit einem CAGR von 13,98 % bis 2031.
- Nach Geografie hielt Nordamerika im Jahr 2025 einen Anteil von 39,4 %, während für den Asien-Pazifik-Raum bis 2031 ein CAGR von 14,89 % prognostiziert wird.
Hinweis: Die Marktgröße und Prognosezahlen in diesem Bericht werden mithilfe des proprietären Schätzungsrahmens von Mordor Intelligence erstellt und mit den neuesten verfügbaren Daten und Erkenntnissen vom Januar 2026 aktualisiert.
Markttrends und Einblicke
Analyse der Treiberwirkung*
| Treiber | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Explosion der Multi-Omics-Datenmengen | +2.8% | Global, Spitzenwerte in Nordamerika und China | Kurzfristig (≤ 2 Jahre) |
| Präzisionsmedizin und Begleitdiagnostik | +2.5% | Nordamerika, Europa, Japan | Mittelfristig (2–4 Jahre) |
| Verlagerung der Pharma-Biotech-Branche hin zu datenzentrierter Forschung und Entwicklung | +2.2% | Global, angeführt von Nordamerika und Europa | Mittelfristig (2–4 Jahre) |
| Staatlich geförderte Genomik-Initiativen | +1.9% | Nordamerika, Vereinigtes Königreich, China, Indien | Langfristig (≥ 4 Jahre) |
| Edge- oder instrumentennahe Verarbeitung | +1.6% | Nordamerika, Europa, Kernregionen Asien-Pazifik | Kurzfristig (≤ 2 Jahre) |
| KI-Modell-Marktplätze | +1.4% | Global, frühe Einführung in Nordamerika | Mittelfristig (2–4 Jahre) |
| Quelle: Mordor Intelligence | |||
Explosion der Multi-Omics-Datenmengen
Der Sequenzierungsdurchsatz hat 20 Petabasen pro Instrument und Jahr überschritten, doch die Speicher- und Recheninfrastruktur hinkt der Nachfrage hinterher und schafft Engpässe, die Bioinformatik-Plattformen lösen müssen. Die Kosten für die Sequenzierung eines menschlichen Genoms fielen 2024 unter 200 USD, doch die nachgelagerte Analyse kostet nun das Drei- bis Fünffache dieses Betrags, was Investitionen in Kompressionsalgorithmen und föderiertes Lernen antreibt, die Daten vor Ort verarbeiten. Pharmazeutische Auftraggeber integrieren zunehmend genomische, transkriptomische, proteomische und metabolomische Datensätze aus identischen Patientenkohorten – ein Arbeitsablauf, der auf GPU-Cluster und für Petabyte-Workloads optimierten Objektspeicher angewiesen ist. Cloud-Anbieter wie AWS, Google Cloud und Microsoft Azure reagieren mit verwalteten Pipelines, die Variantenidentifizierung und -annotation beschleunigen. In Sequenziergeräte integrierte Edge-Appliances minimieren Datenübertragungsgebühren weiter, indem sie Base-Calling und Primäranalyse lokal durchführen. Zusammen sorgen diese Dynamiken für zweistellige Ausgaben für elastisches Computing, auch wenn die Sequenzierungskosten pro Probe sinken.
Einführung von Präzisionsmedizin und Begleitdiagnostik
Die Zulassungen für Begleitdiagnostika stiegen im Jahr 2025 im Vergleich zu 2024, was den Bedarf an Pipelines verstärkt, die komplexe genomische Veränderungen mit klinischer Genauigkeit erkennen. Tumoragnostische Therapien, die auf NTRK-Fusionen und MSI-high-Signaturen abzielen, erfordern Panels, die mehr als 300 Gene untersuchen, und verlagern die Nachfrage von Einzelgen-Assays hin zu umfassenden Profilierungen. Die Europäische Arzneimittel-Agentur schloss 2024 eine Leitlinie ab, die eine analytische Validierung über verschiedene ethnische Kohorten hinweg vorschreibt, was die Erweiterung von Referenzdatensätzen und ethnizitätsbewussten Algorithmen vorantreibt. Japan fügte 2025 Erstattungscodes für die Überwachung mittels Flüssigbiopsie hinzu, was die Einführung von Tools zur Verfolgung der Dynamik zirkulierender Tumor-DNA katalysiert. Insgesamt verankern diese Maßnahmen die Bioinformatik-Ausgaben in der Onkologie, greifen jedoch auch auf Kardiologie und seltene Erkrankungen über, da Kostenträger den pharmakoökonomischen Wert stratifizierter Therapeutika anerkennen.
Verlagerung der Pharma-Biotech-Branche hin zu datenzentrierter Forschung und Entwicklung
Pharmazeutische Pipelines stützen sich zunehmend auf die In-silico-Hypothesengenerierung, um Nasslab-Zyklen zu verkürzen. Die offene Veröffentlichung von 200 Millionen Proteinstrukturen durch AlphaFold zeigte, dass jahrelange Kristallographie in Stunden GPU-Zeit komprimiert werden kann, was das strukturbasierte Wirkstoffdesign beschleunigt. Die Antikörperentdeckung profitiert besonders, da generative Modelle, die auf Immunrepertoire-Daten trainiert wurden, Binder mit vorhergesagter Entwickelbarkeit vorschlagen und Kandidatenpools erheblich reduzieren. Große Auftraggeber erweitern daher interne KI-Einheiten und kooperieren gleichzeitig mit Anbietern, die schlüsselfertige Strukturvorhersage-Workflows liefern. Auftragsforschungsorganisationen skalieren ähnliche Kapazitäten für mehrere Kunden, wandeln Infrastruktur in abrechenbare Dienstleistungen um und steigern die Einführung bei kapitalknappen Biotech-Start-ups.
Staatlich geförderte Genomik-Initiativen
Das NIH-Programm „All of Us” veröffentlichte 2025 Gesamtgenomsequenzen für 245.000 Teilnehmer und schuf damit die größte ethnisch diverse Kohorte für die Präzisionsmedizinforschung [1]National Institutes of Health, "All of Us Research Program Update," nih.gov. Die UK Biobank fügte proteomische und metabolomische Schichten für 50.000 Freiwillige hinzu und produzierte integrierte Datensätze, die akademische Labors für kardiovaskuläre Biomarker nutzen. Das Nationale Genomik-Datenzentrum Chinas speichert nun mehr als 10 Petabyte an Sequenzierungsdaten und ermöglicht die Erstellung populationsspezifischer Referenzgenome, die die Varianteninterpretation für asiatische Kohorten verbessern. Indiens Genome-India-Projekt schloss die Sequenzierung von 10.000 Personen ab und legte damit den Grundstein für Dosierungsoptimierungsstudien, die unerwünschte Ereignisse im Zusammenhang mit CYP2C19- und CYP2D6-Allelen reduzieren. Diese groß angelegten Initiativen stimulieren den inländischen Cloud-Ausbau und fördern grenzüberschreitende Analysepartnerschaften.
Analyse der Hemmnisse*
| Hemmnis | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Mangel an qualifizierten Bioinformatikern | -1.8% | Global, akut in Nordamerika und Europa | Mittelfristig (2–4 Jahre) |
| Fragmentierte Datenstandards | -1.4% | Global, störend bei multizentrischen Studien | Langfristig (≥ 4 Jahre) |
| Cybersicherheits- und Datenschutzrisiken bei Genomdaten | -1.2% | Global, hoher regulatorischer Druck im Westen | Kurzfristig (≤ 2 Jahre) |
| Steigende Cloud-Übertragungsgebühren und Langzeitspeicherkosten | -1.0% | Global, akut bei bevölkerungsweiten Projekten | Mittelfristig (2–4 Jahre) |
| Quelle: Mordor Intelligence | |||
Mangel an qualifizierten Bioinformatikern
Akademische Programme haben im Jahr 2025 rund 8.500 Computerbiologen ausgebildet, gegenüber einem industriellen Bedarf von mehr als 15.000 neuen Stellen, was eine Talentlücke vergrößert, die die Gehälter für Fachleute in der Mitte ihrer Karriere auf über 150.000 USD treibt [2]U.S. Bureau of Labor Statistics, "Occupational Outlook for Bioinformatics Scientists," bls.gov. Unternehmen starten interne Schulungen, um Molekularbiologen in Python und R weiterzubilden, während Plattformanbieter No-Code-Schnittstellen integrieren, um die Benutzerfreundlichkeit zu erweitern. Offshore-Talentpools in Indien und Osteuropa bieten teilweise Entlastung, obwohl Zeitzonenunterschiede und Datensouveränitätsbeschränkungen Workflows mit geschützten Gesundheitsinformationen einschränken.
Cybersicherheits- und Datenschutzrisiken bei Genomdaten
Ransomware-Angriffe auf Genomdatensätze stiegen im Jahr 2025 erheblich im Jahresvergleich, was Labors dazu zwang, Zero-Trust-Architekturen aufzurüsten und strengere HIPAA- und DSGVO-Durchsetzungsmaßnahmen einzuhalten. Versicherungsprämien für Cyberversicherungen sind stark gestiegen, und einige Kostenträger verlangen nun externe Penetrationstests als Voraussetzung für die Erstattung genomischer Assays. Verschlüsselung im Ruhezustand und föderierte Analysen mindern das Risiko, verursachen jedoch zusätzliche Kostenaufwände, die die Margen kleinerer Diagnosezentren belasten.
*Unsere Prognosen behandeln die Auswirkungen von Treibern und Einschränkungen als richtungsweisend und nicht additiv. Die Wirkungsprognosen berücksichtigen Basiswachstum, Mischungseffekte und Wechselwirkungen zwischen Variablen.
Segmentanalyse
Nach Produkten und Dienstleistungen:
Plattformen führen, während Cloud-Dienste beschleunigenPlattformen machten 2025 48,1 % des Bioinformatik-Marktes aus, angetrieben durch eng gekoppelte Sequenzanalyse-Workflows mit Illumina- und Oxford-Nanopore-Instrumenten. Innerhalb dieser Kategorie gewinnt die verbrauchsbasierte Cloud-Bereitstellung Marktanteile, da Labore von abschreibungspflichtigen On-Premise-Clustern abwandern. Dienstleistungen wachsen bis 2031 mit einem CAGR von 14,1 %, indem Investitionsausgaben in variable Betriebskosten umgewandelt und Compliance-Rahmenwerke gebündelt werden, die CLIA- und CE-IVDR-Anforderungen erfüllen. Die Sequenzanalyse bleibt zentral, doch Multi-Omics-Integration und Wissensmanagement-Module bündeln nun Graphdatenbanken und Text-Mining-Engines, die Pathway-Erkenntnisse schneller als manuelle Kuratierung liefern. Plattformanbieter, die keine Cloud- und Edge-Codebasen bereitstellen können, stehen unter Konsolidierungsdruck, wie jüngste Fusionen im mittleren Marktsegment belegen.
Bioinformatik-Dienstleistungen gewinnen wachsende Budgetanteile von kleinen Biotechnologieunternehmen und akademischen Laboren, denen interne Rechenteams fehlen. Hyperscaler verstärken diesen Trend, indem sie Genomik-Toolkits – AWS HealthOmics, Google Cloud Life Sciences API – in umfassendere Cloud-Angebote einbetten, die häufig unter Selbstkosten bepreist werden, um Speicher- und Rechenverbrauch anzukurbeln. Infolgedessen sinkt der dem Bioinformatik-Markt zuzurechnende Anteil eigenständiger Softwarelizenzen, obwohl die Gesamtausgaben steigen. Abonnement- und Pro-Probe-Gebühren ersetzen einmalige Hardware-Erlöse und gleichen die Anreize der Anbieter mit den Datenvolumina der Kunden ab. Wissensmanagement-Tools monetarisieren weiterhin Kurationsqualität, doch Open-Access-Ressourcen erodieren ihre Preissetzungsmacht und verlagern den Schwerpunkt auf proprietäre Algorithmen, die sich in elektronische Labornotizbücher und Laborinformationssysteme integrieren.


Nach Anwendung:
Proteomik entwickelt sich zum WachstumsführerGenomik und Transkriptomik hielten im Jahr 2025 einen Anteil von 34,6 % an der Bioinformatik-Marktgröße, gestützt durch nationale Sequenzierungsprogramme und Onkologiediagnostik. Proteomik und Metabolomik verzeichnen jedoch bis 2031 einen CAGR von 14,43 %, getragen von Massenspektrometrie-Fortschritten, die mehr als 10.000 Proteine pro Probe quantifizieren. Räumliche Techniken überlagern molekulare Signale auf die Gewebearchitektur und treiben die Nachfrage nach GPU-beschleunigter Visualisierung an. Wirkstoffforschungs-Pipelines integrieren Strukturvorhersagealgorithmen mit generativer Chemie, um präklinische Zeitpläne zu verkürzen, während mikrobielle Genomik an Dringlichkeit gewinnt, da Regierungen die Antibiotikaresistenz überwachen.
Anwendungsfälle der Präzisionsmedizin wechseln von der Forschung in die Klinik, wobei FDA-zugelassene pharmakogenomische Kennzeichnungen im Jahr 2025 die Marke von 400 überschritten. Agrar- und Umweltgenomik steigen ebenfalls, da Regulierungsbehörden CRISPR-editierte Nutzpflanzen auf Off-Target-Effekte bewerten. Einzelzell-Sequenzierung verbindet Bildgebung und Omics und produziert Datensätze im Terabyte-Maßstab, die Echtzeit-Analysen und Edge-Computing erfordern. Insgesamt gleichen diese aufkommenden Anwendungen die Anbieterportfolios neu aus und verringern die Abhängigkeit von Einzel-Omics-Einnahmen.
Nach Endnutzer:
Auftragsforschungsorganisationen profitieren von der Outsourcing-WellePharma- und Biotechnologieunternehmen generierten im Jahr 2025 40,2 % der Nachfrage und setzten private Clouds ein, die experimentelle Daten mit regulatorischen Einreichungen integrieren. Auftragsforschungsorganisationen übertreffen andere Gruppen mit einem CAGR von 13,98 % und nutzen gemeinsame Infrastruktur, um Rechenkosten über Auftraggeber hinweg zu amortisieren und schlüsselfertige Analyseberichte zu liefern. Akademische und Forschungsinstitute bleiben einflussreich, verlieren jedoch Marktanteile, da die Förderfinanzierung stagniert.
Klinische und diagnostische Labors integrieren regulierte Pipelines, die CLIA- und CAP-Checklisten entsprechen, was die Nachfrage nach validierten Varianteninterpretations-Engines steigert. Agrar-Genomik- und Umwelttestunternehmen wachsen zwar in einer Nische, aber schnell, da Saatgutunternehmen genomische Selektion implementieren. Übernahmen von Plattformanbietern durch Auftragsforschungsorganisationen, wie IQVIAs Kauf einer Genomik-Sparte im Jahr 2024, veranschaulichen die vertikale Integration, die mehr Wert pro Probe erfasst.
Geografische Analyse
Bioinformatik-Markt Nordamerika
Nordamerika dominierte den Bioinformatik-Markt im Jahr 2025 mit einem Anteil von 39,4 %, gestützt durch eine dichte Konzentration von Pharmaunternehmenszentralen, akademischen Zentren und Risikokapitalfinanzierungen. Die im Jahr 2024 veröffentlichten FDA-Leitlinien verschärften die klinischen Validierungsstandards für Next-Generation-Sequencing-Tests, verlängerten die Entwicklungszyklen und erhöhten gleichzeitig die Gesamtkomplexität der Datenanalyse. Kanadas Präzisionsonkologie-Netzwerke setzen föderierte Plattformen ein, die den provinziellen Datenschutzgesetzen entsprechen, und Mexikos Biosimilar-Hersteller übernehmen Bioinformatik-Tools für Vergleichbarkeitsprotokolle, was die regionale Nachfrage diversifiziert.
Bioinformatik-Markt Asien-Pazifik
Die Asien-Pazifik-Region wird voraussichtlich bis 2031 mit einer CAGR von 14,89 % wachsen, da Chinas staatlich gefördertes Genomik-Ökosystem die Sequenzierungskapazität ausbaut und Analyseplattformen vertikal integriert [3]BGI Genomics, "Investor Relations Presentation," bgi.com Indien fördert Start-ups, die Pipelines für südasiatische Haplotypen lokalisieren, und Japan weitet die Kostenerstattung für Genpanels mit mehr als 500 Genen aus, was die Akzeptanz klinisch zugelassener Software in Krankenhäusern vorantreibt. Australien und Südkorea investieren in nationale Präzisionsmedizin-Programme, die Cloud-Computing mit nationalen Rechenzentren verbinden und die Einhaltung inländischer Cybersicherheitsgesetze gewährleisten.
Bioinformatik-Markt EMEA und Südamerika
Die europäische In-vitro-Diagnostika-Verordnung, die ab 2024 verbindlich gilt, verpflichtet in der Diagnostik eingesetzte Software zur Erlangung der CE-IVDR-Zertifizierung, was die Compliance-Kosten der Anbieter erhöht. Deutschlands Nationales Genomzentrum zentralisiert Arbeitsabläufe für seltene Erkrankungen, während das Vereinigte Königreich die Gesamtgenomsequenzierung in den Nationalen Gesundheitsdienst integriert und Bearbeitungszeiten von weniger als 14 Tagen vorschreibt. Der südamerikanische Markt konzentriert sich auf Brasiliens Pharmakogenomik-Pilotprojekte und Argentiniens Pflanzengenomik-Programme, während der Nahe Osten und Afrika noch in den Anfängen stecken, wobei die Vereinigten Arabischen Emirate und Saudi-Arabien im Rahmen ihrer wirtschaftlichen Diversifizierungsagenden groß angelegte Sequenzierungsprojekte finanzieren.

Regulatorisches Umfeld
Bioinformatik, die in regulierten klinischen Arbeitsabläufen eingesetzt wird, wird zunehmend als Software behandelt, die diagnostische Entscheidungsfindung beeinflussen kann. In den Vereinigten Staaten übt die FDA die Aufsicht über Tumorprofilierungstests mittels Next-Generation-Sequenzierung unter dem Produktcode PZM (21 CFR 866.6080) aus, wobei die zugehörige Bioinformatik-Software und Algorithmen in einen Klasse-II-Regulierungskontext fallen, wenn sie zur Unterstützung klinischer Entscheidungsfindung und Berichterstattung eingesetzt werden. Im Januar 2026 aktualisierte die FDA ihre Leitlinie zu Clinical Decision Support Software und stellte klar, welche Funktionen gemäß Abschnitt 520(o)(1)(E) des FD&C Act von der Gerätedefinition ausgenommen sind, was Auswirkungen darauf hat, wie Anbieter Analytik in klinisch ausgerichtete Anwendungen verpacken.
Im Bereich Daten und Interoperabilität hat das ONC Health IT Certification Program USCDI Version 3 ab dem 1. Januar 2026 als verpflichtende Basis für zertifizierte Health-IT festgelegt, wodurch die Anforderungen an standardisierte Datenelemente, die nachgelagerte Bioinformatik- und Präzisionsmedizinsysteme nutzen, verschärft werden. Die ONC hat außerdem ihren Standards Version Advancement Process (SVAP) mit dem Zyklus 2026 vorangetrieben, einschließlich des HL7 FHIR US Core Implementation Guide STU 9.0.0 zur freiwilligen Einführung ab dem 29. August 2026, um einen konsistenteren API-basierten Datenaustausch mit Analyseumgebungen zu unterstützen. In der EU trat die Verordnung (EU) 2025/327 (European Health Data Space, EHDS) am 26. März 2025 in Kraft und formalisierte Regeln für den Zugang zu elektronischen Gesundheitsdaten sowie deren Sekundärnutzung für Forschung und personalisierte Medizin; die Durchführungsverordnung (EU) 2026/771 der Kommission (veröffentlicht am 7. April 2026) richtete das EHDS-Board ein, um eine konsistente Anwendung in den Mitgliedstaaten zu koordinieren.
Wertschöpfungskettenanalyse
Die Bioinformatik-Wertschöpfungskette beginnt mit der vorgelagerten Multi-Omics-Datenerzeugung (Sequenzierung und Massenspektrometrie) und verläuft über die Primärverarbeitung, Analytik, Interpretation und Bereitstellung von Ergebnissen in Forschungs- und klinische Systeme. Instrumentenhersteller und Assay-Anbieter bündeln zunehmend geräte-nahe oder integrierte Analytik (einschließlich Basecalling, Alignment, Variantenaufruf und QC), während Cloud-Hyperscaler verwaltete Pipeline-Orchestrierung, elastische Rechenleistung und konforme Umgebungen bereitstellen, die den Bedarf an vor-Ort-Clustern für Labore verringern. Ein wiederkehrender Engpass besteht zwischen Speicherung und Rechenleistung, wo E/A-Beschränkungen sowie wiederholte Dekomprimierungs- und Formatierungsschritte die Analyse im großen Maßstab verlangsamen, was die Nachfrage nach optimierten Datenformaten, Workflow-Engines und Architekturen zur Reduzierung von Datenbewegungen antreibt.
Zu den Marktteilnehmern in der Mittelstufe zählen Plattformanbieter, Bioinformatik-Dienstleister und CROs, die Pipelines für standortübergreifende Studien und regulierte Berichterstattung standardisieren, wobei Cybersicherheits- und Datenschutzkontrollen zunehmend integrierte Anforderungen statt Zusatzoptionen darstellen. Nachgelagert fließen die Ergebnisse in Wissensmanagement-Schichten sowie klinische oder unternehmensweite Systeme ein, wobei Interoperabilitätsstandards, wie beispielsweise der FHIR-orientierte Datenaustausch in IT-Umgebungen des Gesundheitswesens, beeinflussen, wie Ergebnisse operationalisiert werden. Zunehmend halten föderierte Datenmodelle sensible genomische Daten am Ursprungsort, während sie datensatzübergreifende Abfragen und Analysen ermöglichen, wodurch grenzüberschreitende Übertragungshindernisse reduziert werden und sich diese in datensouveränitätsbezogene Beschränkungen einfügen, einschließlich Branchenbemühungen zum Aufbau globaler föderierter Datensätze für hochauflösende Gesamtgenome. Öffentlich finanzierte Datensatzinfrastruktur und Zugangsgovernance prägen ebenfalls den Durchsatz und die Reproduzierbarkeit für akademische und translationale Nutzer und schaffen eine Abhängigkeit von stabiler Datenverwaltung und skalierbarem Rechenzugang.
Wettbewerbslandschaft
Die fünf größten Anbieter – Illumina, Thermo Fisher Scientific, QIAGEN, Agilent Technologies und Roche – hielten im Jahr 2025 einen Mehrheitsanteil, was auf eine moderate Konzentration hindeutet. Illumina setzt seine vertikale Integrationsstrategie fort und koppelt DRAGEN-Beschleunigung mit Instrumentenverkäufen, um 450 Millionen USD an wiederkehrenden Software-Einnahmen zu erzielen. Thermo Fisher verfolgt eine horizontale Expansion, übernimmt Einzellösungen und integriert sie in eine Cloud-Plattform, die von der Probenvorbereitung bis zur Varianteninterpretation reicht.
Zu den Disruptoren gehören KI-zentrierte Unternehmen wie Insitro und Recursion, die proprietäre Analyse-Stacks kommerzialisieren, die ursprünglich für die interne Wirkstoffforschung entwickelt wurden. NVIDIAs BioNeMo-Toolkit ermöglicht es Pharmaunternehmen, Grundlagenmodelle auf lokalen Daten zu trainieren und die Abhängigkeit von Drittanbieter-Plattformen zu reduzieren. Normungsgremien wie GA4GH veröffentlichen offene APIs, die routinemäßige Ausrichtung und Variantenidentifizierung kommodifizieren könnten, was den Preiswettbewerb verschärft.
Marktführer in der Bioinformatik-Branche
-
Illumina Inc.
-
Thermo Fischer Scientific
-
Qiagen NV
-
Agilent Technologies
-
F. Hoffmann-La Roche Ltd.
- *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert
Bioinformatik-Markt
- 3rd Millennium
- Agilent Technologies
- BGI Genomics Co. Ltd.
- Dassault Systèmes SE (BIOVIA)
- Data4Cure Inc.
- DNAnexus Inc.
- Eagle Genomics Ltd.
- Roche
- Gene42 Inc.
- Genedata
- Geneious (Biomatters)
- Illumina
- Ontoforce NV
- Oracle Corporation (Oracle Healthcare)
- Partek Inc.
- PerkinElmer
- QIAGEN
- Seven Bridges Genomics Inc.
- SoftGenetics LLC
- Thermo Fisher Scientific
- WuXi NextCODE Genomics

Marktchancen und Zukunftsaussichten
Eine kurzfristige Chance liegt in der klinischen Ausweitung von Multi-Omics- und Onkologie-Workflows, die validierte End-to-End-Analytik anstelle von eigenständigen Tools erfordern. Krankenhaussysteme und nationale Gesundheitsdienste überführen Flüssigbiopsie und breite Panel-Sequenzierung in Routinepfade, was die Nachfrage nach Plattformen erhöht, die assay-spezifische Pipelines, QC, Varianteninterpretation und prüffähige Berichterstattung kombinieren. Im Jahr 2026 verstärkte SOPHiA GENETICS die Signale klinischer Akzeptanz: Mount Sinai Health System übernahm die SOPHiA-DDM-Plattform für onkologisches NGS, und Synnovis ging eine Partnerschaft ein, um ctDNA-Flüssigbiopsietests im gesamten NHS England zu unterstützen (mit einem Ziel von rund 7.000 Tests jährlich). Diese Implementierungen begünstigen Anbieter, die regulierte Arbeitsabläufe standortübergreifend operationalisieren können und dabei Datenschutz- und Sicherheitsanforderungen erfüllen.
Interoperabilität und konformer Datenzugang für die Sekundärnutzung bleiben ebenfalls ein zentraler Chancenbereich, da Gesundheitsdatenvorschriften und Zertifizierungsgrundlagen die Verbindung zwischen klinischen Datensystemen und Bioinformatik-Stacks enger gestalten. In der EU bietet der EHDS-Rahmen einen strukturierten Weg für organisationsübergreifende Datennutzung in Forschung und personalisierter Medizin, was den Wert von Plattformen erhöht, die für Einwilligung, Governance und föderierte Analyse konzipiert sind. In den Vereinigten Staaten erhöhen die ONC-Zertifizierungsgrundlagen (USCDI v3 ab Januar 2026) und die durch SVAP vorangetriebenen FHIR-Fortschritte die Anreize, Systeme zu beschaffen, die standardisierte klinische Daten verarbeiten und nachverfolgbare Ergebnisse liefern können, insbesondere dort, wo Analytik Lebenszykluskontrollen und Prüffähigkeit benötigt. Anbieter und Dienstleister, die validierte Pipelines, Datenherkunftsnachweise und datenschutzwahrende Kollaborationsumgebungen liefern, sind gut positioniert, um Ausgaben zu erschließen, während Organisationen fragmentierte Arbeitsabläufe zu Unternehmensinfrastruktur konsolidieren.
Recent Industry Developments in Bioinformatik-Markt
- Juni 2026: Thermo Fisher Scientific stellte auf der ASMS 2026 neue Orbitrap-Massenspektrometrie-Plattformen vor, darunter das Orbitrap Tribrid Apex. Höherer Durchsatz in der Proteomik erhöht die nachgelagerten Anforderungen an robuste Bioinformatik-Pipelines und beschleunigt die Nachfrage nach skalierbarer Analyse-, Visualisierungs- und Interpretationssoftware in Biopharma und translationaler Forschung.
- Mai 2026: Illumina kündigte eine auf Ganzgenomsequenzierung basierende Forschungslösung für molekulare Resterkrankung (MRD) im Early Access an. WGS-basierte MRD erhöht die Datenmengen und die analytische Komplexität über gezielte Panels hinaus und steigert die Bedeutung von optimiertem Alignment, Variantenaufruf und longitudinaler Analytik innerhalb integrierter Bioinformatik-Plattformen.
- Februar 2025: QIAGEN übernahm Bioinformatics Solutions Inc. (BSI), um seine Kompetenzen in der Proteomik- und Massenspektrometrie-Datenanalyse zu stärken. Der Deal erweiterte QIAGENs Fähigkeit, integrierte Multi-Omics-Analytik anzubieten, und unterstützte Cross-Selling in Labore, die sowohl Sequenzierungs- als auch Proteomik-Workflows betreiben.


Bioinformatik-Markt Berichtsumfang und Forschungsmethodik
Marktdefinition und Abdeckung
Dieser Markt umfasst Erlöse aus Bioinformatik-Software, Plattformen, Wissensmanagement-Tools und kostenpflichtigen Analysedienstleistungen, die zur Speicherung, Verarbeitung, Visualisierung und Interpretation biologischer Daten aus Bereichen wie Genomik, Transkriptomik, Proteomik und Metabolomik in den wichtigsten Regionen eingesetzt werden.
Ausschlüsse aus dem Umfang: Sequenzierungsinstrumente und Laborhardware sind ausgeschlossen, ebenso generische Cloud-Rechenleistung oder -Speicherung, die ohne eine Bioinformatik-Workflow-Schicht verkauft wird.
Segmentierungsübersicht
-
Nach Produkten und Dienstleistungen
- Wissensmanagement-Tools
-
Bioinformatik-Plattformen
- Sequenzanalyse-Plattformen
- Sequenzausrichtungs-Plattformen
- Sequenzmanipulations-Plattformen
- Struktur- und Funktionsanalyse-Plattformen
- Multi-Omics-Integrationsplattformen
-
Bioinformatik-Dienstleistungen
- Sequenzierungs- und Datengenerierungsdienstleistungen
- Datenbankaufbau und -verwaltung
- Datenanalyse- und Interpretationsdienstleistungen
- Cloud-native Bioinformatik als Dienstleistung
-
Nach Anwendung
- Genomik und Transkriptomik
- Proteomik und Metabolomik
- Wirkstoffforschung und -entwicklung
- Mikrobielle Genomik (Metagenomik und Antibiotikaresistenz)
- Präzisions- und personalisierte Medizin
- Sonstige Anwendungen
-
Nach Endnutzer
- Pharma- und Biotechnologieunternehmen
- Akademische und Forschungsinstitute
- Klinische und diagnostische Labors
- Auftragsforschungsorganisationen (AROs)
- Sonstige Endnutzer
-
Geografie
-
Nordamerika
- Vereinigte Staaten
- Kanada
- Mexiko
-
Europa
- Deutschland
- Vereinigtes Königreich
- Frankreich
- Italien
- Spanien
- Übriges Europa
-
Asien-Pazifik
- China
- Japan
- Indien
- Südkorea
- Australien
- Übriger Asien-Pazifik-Raum
-
Naher Osten und Afrika
- Golfkooperationsrat
- Südafrika
- Übriger Naher Osten und Afrika
-
Südamerika
- Brasilien
- Argentinien
- Übriges Südamerika
-
Nordamerika
Datenquellen, Marktgrößenbestimmung und Validierung
Desk-Research
Desk-Research wurde verwendet, um den Nachfragepool zu kartieren und praktische Annahmen zu entwickeln, die wiederholbar sind. Wir stützten uns auf öffentliche Wissenschafts- und Gesundheitsquellen wie NCBI (NIH), das National Human Genome Research Institute, OECD-Gesundheits- und Innovationsindikatoren, makroökonomische Datenreihen der Weltbank sowie Quellen wie die WHO für übergeordnete Gesundheitssignale.
Um wissenschaftliche Aktivitäten mit Ausgaben zu verknüpfen, haben wir außerdem Jahresberichte von Unternehmen, Ergebnispräsentationen, regulatorische und Finanzierungsankündigungen, begutachtete Artikel sowie Verbandspublikationen ausgewertet, die Sequenzierungsvolumina, Multi-Omics-Adoption und Bioinformatik-Workloads behandeln. Wo hilfreich, nutzten wir kostenpflichtige Abonnements, die auf Unternehmensfinanzdaten und -informationen, Nachrichten und Finanzdaten sowie Patentdatenbanken beschränkt waren, um Umsatzexposition und Technologieausrichtung zu überprüfen. Die hier aufgeführten Desk-Quellen sind nicht abschließend; wir haben weitere öffentliche Dokumente zur Datenerhebung, Validierung und Klärung herangezogen.
Primärinterviews und Umfragen
Die Primärarbeit konzentrierte sich darauf, zu bestätigen, wofür in der Bioinformatik tatsächlich gezahlt wird und was in angrenzende Posten wie Labordienstleistungen oder Cloud-Ausgaben eingebettet ist. Wir sprachen mit einer Mischung aus Lösungsanbietern, Serviceteams, Forschungsleitern und Beschaffungsverantwortlichen in APAC, EMEA und Amerika, damit Annahmen zu Preisgestaltung, Adoptionszeitpunkt und Anwendungsfall-Mix korrigiert und erneut getestet werden konnten.
Verteilung der Befragten in der primären Forschungsfeldarbeit
| Unternehmenstyp | Position des Befragten | Region |
|---|---|---|
| Oberes Segment: 27 % | CXOs: 12 % | APAC: 38 % |
| Mittleres Segment: 59 % | Funktions-/Einheitsleiter: 43 % | EMEA: 35 % |
| Kleinere Akteure: 14 % | Manager: 45 % | Amerika: 27 % |
Marktgrößenbestimmung und Prognose
Die Größenbestimmung beginnt mit einem Top-down-Aufbau, bei dem die adressierbare Bioinformatik-Ausgabe aus Multi-Omics-Forschungs- und klinischen Aktivitäten rekonstruiert und dann durch Adoptions- und Monetarisierungsraten für Plattformen, Tools und kostenpflichtige Dienstleistungen gefiltert wird. Sobald diese Struktur festgelegt ist, verwenden wir selektive Bottom-up-Prüfungen, um sicherzustellen, dass die Gesamtwerte nicht abweichen – einschließlich stichprobenartiger Umsatzaufteilungen aus öffentlichen Einreichungen, Preis-pro-Lizenz- oder Abonnementspannen aus Interviews sowie Volumen-mal-Durchschnittspreis-Näherungen für häufig erworbene Workflows.
Zu den im Modell verwendeten Schlüsselinputs gehören Sequenzierungs- und Multi-Omics-Durchsatzsignale, der Anteil von Projekten, die Genomik und Transkriptomik gegenüber Proteomik und Metabolomik nutzen, die Verschiebung zwischen On-Premise- und Cloud-basierten Tools, die typische Lizenz- und Abonnementpreisentwicklung sowie der Endnutzer-Mix zwischen Biopharma, akademischen Einrichtungen und anderen Kundengruppen. Wenn Bottom-up-Daten für kleinere Regionen oder Nischenanwendungen fehlen, wurden Lücken mithilfe von Proxy-Adoptionsquoten geschlossen, die an Forschungsfinanzierung und Publikationsintensität verankert sind; diese Quoten wurden anschließend mit Experten einem Stresstest unterzogen.
Für die Prognose wurde eine Szenarioanalyse mit einer multivariaten Regressionsschicht verwendet, bei der das Wachstum an Indikatoren wie der Richtung der Forschungsfinanzierung, Trends bei der installierten Sequenzierungskapazität und Software-Verbrauchsmustern geknüpft ist. Annahmen wurden erst nach Konvergenz des Primärfeedbacks darüber finalisiert, wie ein normaler Kaufzyklus und das Verlängerungsverhalten der Endnutzer am Ende des Prognosezeitraums aussehen.
Datenvalidierung und Aktualisierungszyklus
Die Ergebnisse wurden durch Triangulation mit unabhängigen Signalen validiert, wie regionaler Forschungsintensität, bekannten Multi-Omics-Adoptionszeitplänen und beobachteten Verschiebungen zwischen Plattform- und Dienstleistungsausgaben. Wenn ein Länder- oder Anwendungsergebnis außerhalb des Musters lag, wurden die Treiber erneut überprüft und anschließend eine zweite Prüfungsrunde durchgeführt, um die Einheitenlogik, die Währungsbehandlung und die Jahresausrichtung zu bestätigen.
Vor der Freigabe wird das vollständige Arbeitsbuch schrittweise überprüft, damit Fehler frühzeitig erkannt werden und die Annahmen über Regionen und Endnutzer hinweg konsistent bleiben. Der Bericht wird jährlich aktualisiert, und Zwischenaktualisierungen werden vorgenommen, wenn wesentliche Ereignisse das Ausgabeverhalten oder die Preisgestaltung verändern. Vor der Auslieferung führt ein Analyst eine abschließende Prüfung durch, damit die Kunden die aktuellste Ansicht erhalten.
Schätzung des globalen Bioinformatik-Marktes von Mordor Intelligence im Vergleich mit anderen veröffentlichten Schätzungen
Unterschiedliche veröffentlichte Größen für Bioinformatik stimmen nicht immer überein, weil die enthaltenen Posten und das gemessene Jahr nicht identisch sind, was die Berechnung verändert, noch bevor die Prognose beginnt. Abweichungen entstehen auch dadurch, wie die Preisgestaltung über Software, Plattformen und Dienstleistungen hinweg behandelt wird, sowie durch die angenommene Adoptionsgeschwindigkeit in schnell wachsenden Regionen.
Sequenzierungsinstrumente und Laborhardware liegen außerhalb des Umfangs von Mordor Intelligence, was dazu führen kann, dass einige umfassendere Life-Science-IT-Gesamtwerte höher erscheinen, wenn diese angrenzenden Erlöse zusammengezählt werden. Lücken zeigen sich auch, wenn eine Quelle ein anderes Basisjahr verwendet, eine aggressivere Preisexpansion für Software-Abonnements ansetzt oder Währungen zu einem anderen Zeitpunkt umrechnet – diese Effekte wurden beim Abgleich derselben Regionen und des Endnutzer-Mix deutlich sichtbar.
Benchmark-Vergleich
| Quelle | Marktgröße | Lücken in der Forschungsmethodik |
|---|---|---|
| Mordor Intelligence | 19,97 Milliarden USD (2026) | |
| Branchenpublizist A | 18,69 Milliarden USD (2025) | Verwendet ein früheres Größenbestimmungsjahr und eine andere Basisjahrkonfiguration, was den Ausgangserlöspool verschiebt und den Anstieg durch jüngste Multi-Omics-Adoption und Preisänderungen unterschätzen kann. |
| Globale Unternehmensberatung B | 31,74 Milliarden USD (2025) | Weist einen größeren Wert für 2025 aus, der wahrscheinlich breitere Einschlüsse und aggressivere Preiseskalationsannahmen für Software und Dienstleistungen widerspiegelt, was die Gesamtwerte vor der Anwendung regionaler Adoptionsprüfungen nach oben treibt. |
Die Streuung in der Tabelle erklärt sich größtenteils dadurch, was als Bioinformatik-Erlös gezählt wird, welches Jahr für die angegebene Größe verwendet wird und wie das Preiswachstum auf softwaregetriebene Ausgaben angewendet wird. Indem die Inputs an beobachtbare Aktivitätssignale gebunden und dieselben Jahresausrichtungs- und Umfangsregeln über Regionen hinweg wiederholt werden, bleibt die endgültige Schätzung praktisch prüfbar und konsistent aktualisierbar.


Im Bericht beantwortete Schlüsselfragen
Wie schnell wird der Bioinformatik-Markt bis 2031 voraussichtlich wachsen?
Der Bioinformatik-Markt wird voraussichtlich von 19,97 Milliarden USD im Jahr 2026 auf 37,03 Milliarden USD bis 2031 wachsen und dabei einen CAGR von 13,1 % verzeichnen.
Welche Produktkategorie trägt derzeit den größten Umsatzanteil bei?
Bioinformatik-Plattformen trugen im Jahr 2025 48,1 % des Gesamtumsatzes bei, was ihre zentrale Rolle bei der Sequenzanalyse und Multi-Omics-Integration widerspiegelt.
Warum gewinnen Auftragsforschungsorganisationen Marktanteile?
Auftragsforschungsorganisationen skalieren Bioinformatik-Infrastruktur über mehrere Auftraggeber hinweg, senken die Kosten pro Projekt und erzielen bis 2031 einen prognostizierten CAGR von 13,98 % bei der Nachfrage.
Warum ist Präzisionsmedizin wichtig für das Wachstum des Bioinformatik-Marktes?
Präzisionsmedizin hängt davon ab, genomische Daten in klinische Maßnahmen zu übersetzen, und Bioinformatik-Plattformen liefern die Analysen, die diese Übersetzung ermöglichen.
Welche Region wird bis 2031 die schnellste Expansion verzeichnen?
Der Asien-Pazifik-Raum wird voraussichtlich mit einem CAGR von 14,89 % wachsen, angetrieben durch groß angelegte staatliche Genomik-Initiativen in China, Indien und Japan.
Wie gehen Anbieter mit Datensicherheitsbedenken um?
Anbieter setzen Zero-Trust-Architekturen, lokale Edge-Verarbeitung und föderierte Analysen ein, um HIPAA- und DSGVO-Anforderungen zu erfüllen und gleichzeitig die Anfälligkeit für Ransomware-Angriffe zu reduzieren.
Seite zuletzt aktualisiert am:



