
Marktgröße und Marktanteil für Big-Data-Engineering-Services
Marktübersicht
| Studienzeitraum | 2020 - 2031 |
|---|---|
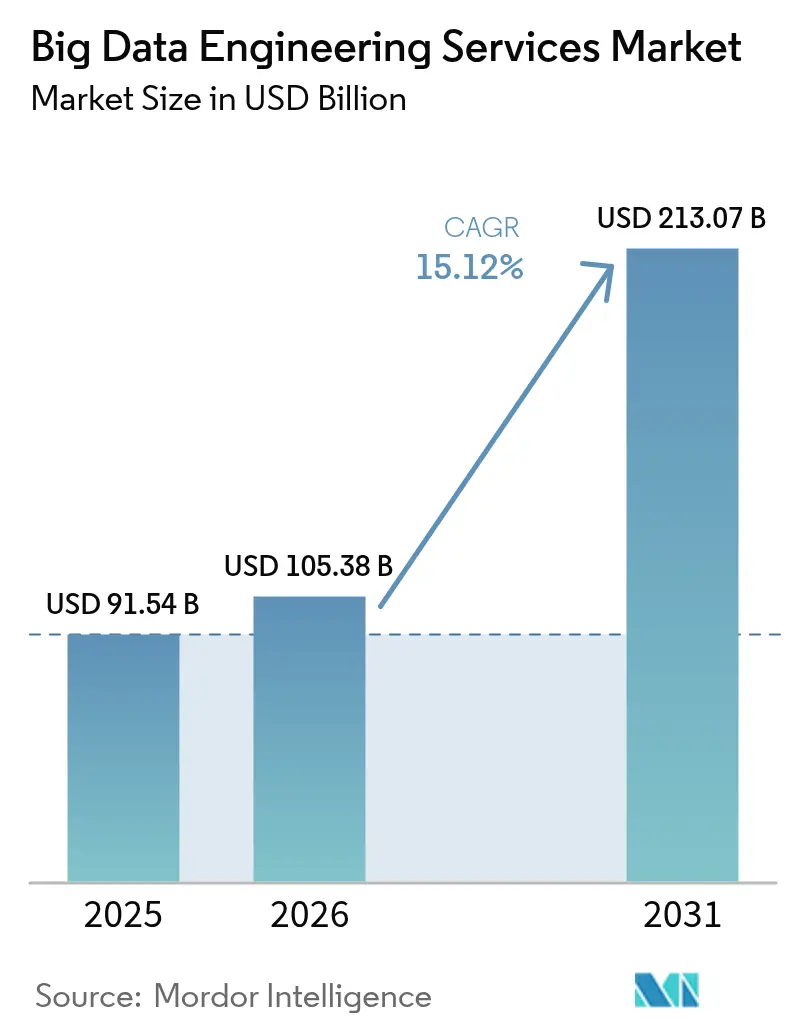
| Marktgröße (2026) | 105.38 Milliarden US-Dollar |
| Marktgröße (2031) | 213.07 Milliarden US-Dollar |
| Growth Rate (2026 - 2031) | 15.12 % |
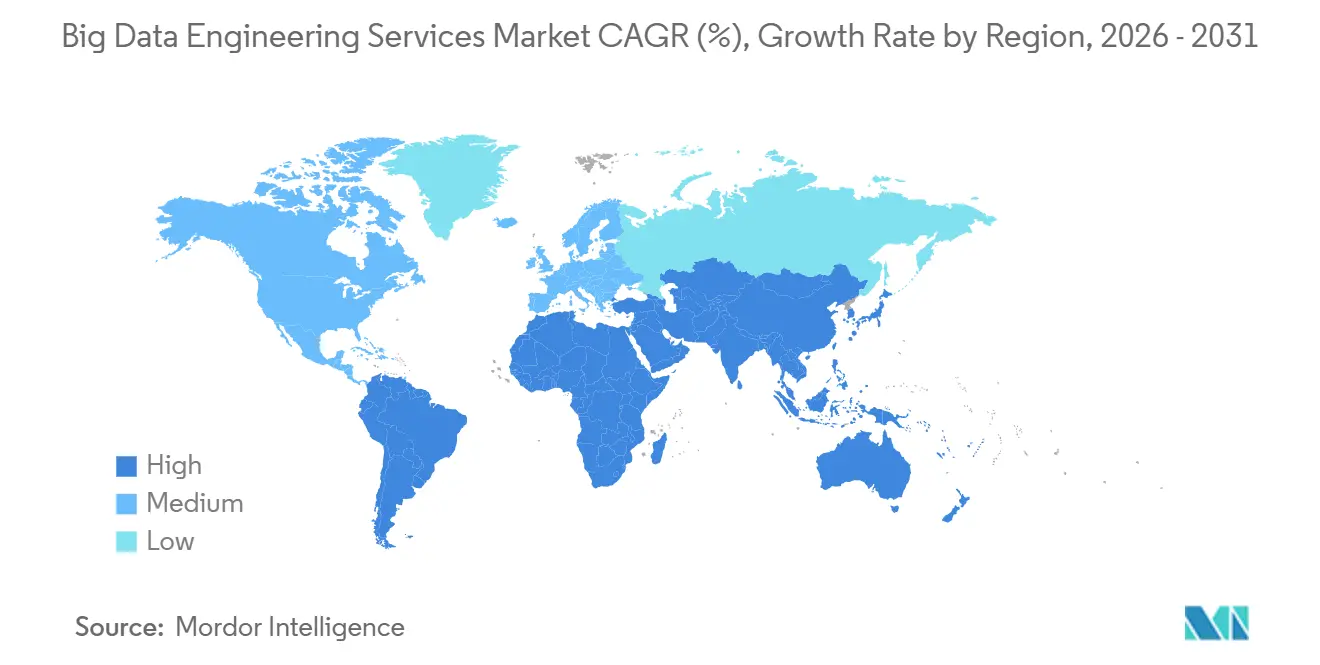
| Schnellstwachsender Markt | Asien-Pazifik |
| Größter Markt | Nordamerika |
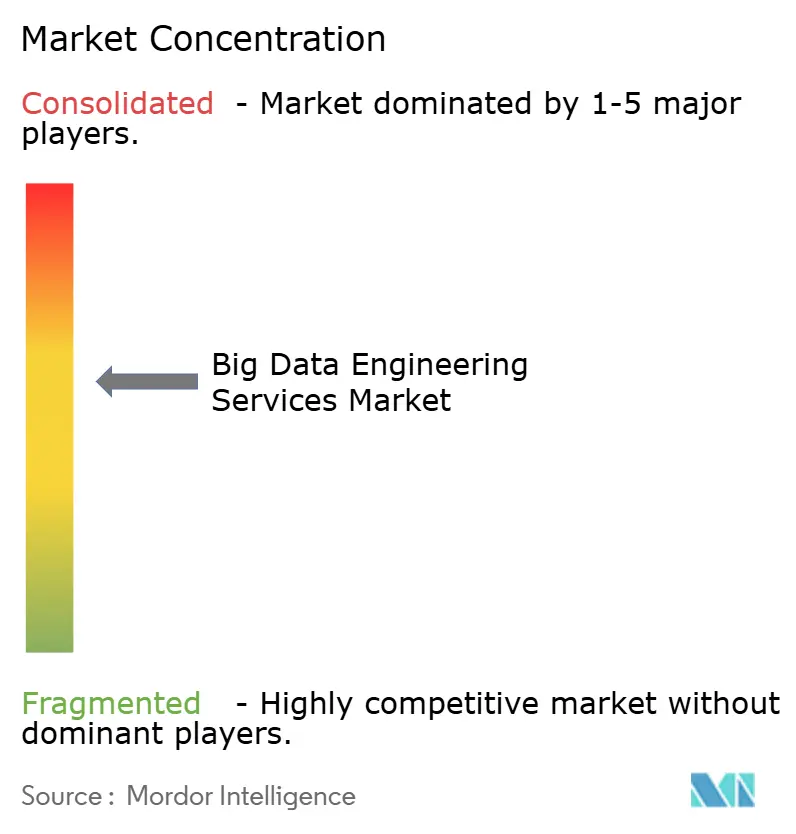
| Marktkonzentration | Mittel |
Hauptakteure *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert Bild © Mordor Intelligence. Wiederverwendung erfordert Namensnennung gemäß CC BY 4.0. | |
Marktanalyse für Big-Data-Engineering-Services von Mordor Intelligence
Die Marktgröße für Big-Data-Engineering-Services wird voraussichtlich von USD 91,54 Milliarden im Jahr 2025 auf USD 105,38 Milliarden im Jahr 2026 wachsen und soll bis 2031 bei einer CAGR von 15,12 % über den Zeitraum 2026–2031 USD 213,07 Milliarden erreichen. Wachsende Mengen an Sensortelemetrie, Social-Media-Streams und Videodateien haben Unternehmen dazu veranlasst, Batch-Data-Warehouses durch Echtzeit-Lakehouse-Pipelines zu ersetzen. Cloud-native Bereitstellungen bilden bereits die Grundlage für mehr als 60 % der Produktionsumgebungen, während KI-gesteuerte Orchestrierung die Extrahierungs-, Transformations- und Ladezyklen von Wochen auf Stunden verkürzt. Hybride Architekturen gewinnen in regulierten Sektoren an Bedeutung, die sensible Daten lokal aufbewahren müssen, aber dennoch elastische Rechenkapazität für unkritische Analysen benötigen. Ein anhaltender Fachkräftemangel und steigende Compliance-Kosten dämpfen das Wachstum, doch ergebnisbasierte Preismodelle senken die Einstiegshürden für kleine und mittlere Unternehmen und verbreitern den Marktfußabdruck der Big-Data-Engineering-Services.
Wichtigste Erkenntnisse des Berichts
- Nach Servicetyp führte Datenintegration und ETL im Jahr 2025 mit einem Marktanteil von 39,22 % am Markt für Big-Data-Engineering-Services, während Erweiterte Analytik und Visualisierung bis 2031 voraussichtlich mit einer CAGR von 15,91 % wachsen wird.
- Nach Geschäftsfunktion entfielen im Jahr 2025 34,86 % der Ausgaben auf Marketing und Vertrieb; Betrieb und Lieferkette sollen bis 2031 mit einer CAGR von 15,96 % wachsen.
- Nach Unternehmensgröße hielten Großunternehmen im Jahr 2025 einen Marktanteil von 58,91 % am Markt für Big-Data-Engineering-Services, während kleine und mittlere Unternehmen voraussichtlich mit einer CAGR von 15,56 % wachsen werden.
- Nach Bereitstellungsmodus hielten Cloud-Bereitstellungen im Jahr 2025 einen Marktanteil von 63,47 % am Markt für Big-Data-Engineering-Services, doch hybride Architekturen werden mit der höchsten CAGR von 15,78 % bis 2031 wachsen.
- Nach Geografie dominierte Nordamerika im Jahr 2025 mit einem Anteil von 42,38 %, und Asien-Pazifik wird voraussichtlich die stärkste CAGR von 16,14 % über den Prognosezeitraum verzeichnen.
Hinweis: Die Marktgrößen- und Prognosezahlen in diesem Bericht werden mithilfe des proprietären Schätzrahmens von Mordor Intelligence erstellt und mit den neuesten verfügbaren Daten und Erkenntnissen bis 2026 aktualisiert.
Globale Trends und Erkenntnisse zum Markt für Big-Data-Engineering-Services
Analyse der Treiberwirkung*
| Treiber | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Auswirkungszeitraum |
|---|---|---|---|
| Verbreitung unstrukturierter IoT- und Social-Daten | +3.5% | Global, konzentriert im nordamerikanischen Fertigungsgürtel und in asiatisch-pazifischen Smart-City-Korridoren | Mittelfristig (2–4 Jahre) |
| Kosteneffiziente, ergebnisbasierte Serviceverträge | +2.8% | Nordamerika und Europa, Ausweitung in Asien-Pazifik | Kurzfristig (≤ 2 Jahre) |
| Einführung von Cloud-nativen Big-Data-Stacks | +3.2% | Global, angeführt von Nordamerika und Europa, rasante Verbreitung in Indien und Südostasien | Kurzfristig (≤ 2 Jahre) |
| Regulatorischer Druck für datengestützte Entscheidungsfindung | +2.5% | Europa, Nordamerika, aufkommende Rahmenbedingungen in Asien-Pazifik | Langfristig (≥ 4 Jahre) |
| Aufstieg KI-automatisierter Datenpipelines | +3.0% | Global, frühe Einführung im nordamerikanischen Technologiesektor und im asiatisch-pazifischen E-Commerce | Mittelfristig (2–4 Jahre) |
| Branchenspezifische Datenmärkte | +2.0% | Nordamerikanisches Gesundheitswesen und Finanzwesen, europäische Fertigung, asiatisch-pazifischer Einzelhandel | Langfristig (≥ 4 Jahre) |
| Quelle: Mordor Intelligence | |||
Verbreitung unstrukturierter IoT- und Social-Daten
Unternehmen verarbeiten heute Sensormesswerte im Millisekundenbereich, Überwachungsvideos und Gesprächstranskripte, die zusammen im Jahr 2025 181 Zettabyte überschritten haben. Fertigungslinien übertragen Vibrationsmesswerte von jedem Robotergelenk an entfernte Objektspeicher, während Einzelhändler Kamerafeeds von der Decke mit Kassenbons verknüpfen, um Planogramme zu verfeinern.[1]Siemens AG, "Geschäftsbericht 2025," siemens.com Soziale Kanäle liefern Stimmungssignale, die Vermarkter innerhalb von Minuten aktivieren, was einen Schwenk von nächtlichen Batches zu kontinuierlichen Pipelines erzwingt. Schema-on-Read-Techniken verschieben die Modellierung bis zum Abfragezeitpunkt und vermeiden starre relationale Einschränkungen. Der Markt für Big-Data-Engineering-Services priorisiert daher Streaming-Plattformen, die die Latenz unter 1 Minute halten, um die Kundenabwanderung zu minimieren.
Kosteneffiziente, ergebnisbasierte Serviceverträge
Variable Abrechnung, die an verarbeitete Abfragen oder gescannte Datensätze geknüpft ist, ermöglicht es Finanzverantwortlichen, Ausgaben mit Einnahmen abzugleichen. Service-Level-Agreements versprechen nun eine Pipeline-Verfügbarkeit von 99,9 %, wodurch das Risiko auf Anbieter verlagert und die Automatisierung gefördert wird, die Arbeitsstunden reduziert.[2]Accenture plc, "Geschäftsbericht 2025," accenture.com Mittelständische Unternehmen profitieren am meisten, da sie eine Dateninfrastruktur auf Unternehmensebene ohne Kapitalausgabenschocks erhalten. Strafen für verfehlte Leistungsziele erhöhen die Anbieterverantwortlichkeit und fördern die Verwendung wiederverwendbarer Beschleuniger gegenüber individuellem Code. Diese kommerzielle Neuausrichtung erweitert den Markt für Big-Data-Engineering-Services über die Global-2000-Käufer hinaus.
Einführung von Cloud-nativen Big-Data-Stacks
Lakehouse-Designs vereinen Objektspeicher und SQL-Governance, sodass Unternehmen parallele Hadoop- und relationale Systeme ablösen können. Zero-ETL-Replikation überträgt Transaktionen von operativen Datenbanken in analytische Speicher in Sekunden und verwandelt Monatsabschlussberichte in nahezu echtzeitfähige Dashboards. Elastische Cluster skalieren auf null herunter, wenn sie inaktiv sind, und reduzieren Infrastrukturkosten um 60 %. Offene Tabellenformate wie Iceberg ermöglichen Zeitreiseabfragen und Schema-Evolution und festigen die Cloud als bevorzugte Grundlage. Diese Einführungswelle bildet die Grundlage für mehr als die Hälfte der aktuellen Aufträge im Markt für Big-Data-Engineering-Services.
Regulatorischer Druck für datengestützte Entscheidungsfindung
DSGVO-Strafen erreichten im Zeitraum 2024–2025 EUR 4,5 Milliarden (USD 5,0 Milliarden) und zwangen zur Einführung nachvollziehbarer Datenherkunft und Echtzeit-Einwilligungsverwaltung.[3]Europäischer Datenschutzausschuss, "Jahresbericht 2025," edpb.europa.eu US-amerikanische Staatsgesetze verkürzten die Fristen für den Datenzugang und zwangen Einzelhändler zur Einführung sofortiger Abfragefähigkeiten. Bankaufsichtsbehörden verlangen Provenienz auf Merkmalebene, und Gesundheitsprüfer fordern unveränderliche Zugriffsprotokolle. Compliance verbraucht nun ein Fünftel der Budgets für Daten-Engineering, treibt aber auch die Nachfrage nach Governance-Toolchains an, die als verwaltete Dienste bereitgestellt werden. Der politische Schwung stärkt daher die Entwicklung des Marktes für Big-Data-Engineering-Services.
Analyse der Hemmnisswirkung*
| Hemmnis | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Auswirkungszeitraum |
|---|---|---|---|
| Akuter Mangel an Fachkräften im Daten-Engineering | −2.5% | Global, am stärksten in Nordamerika und Europa | Kurzfristig (≤ 2 Jahre) |
| Kosten für Cybersicherheit und Datenschutz-Compliance | −2.0% | Europa, Nordamerika, zunehmend in Asien-Pazifik | Mittelfristig (2–4 Jahre) |
| Komplexität der Integration von Altsystemen | −1.8% | Mainframe-Bestände in Nordamerika und Europa | Langfristig (≥ 4 Jahre) |
| Cloud-Egress- und Anbieterabhängigkeitsökonomie | −1.5% | Globale multinationale Unternehmen | Mittelfristig (2–4 Jahre) |
| Quelle: Mordor Intelligence | |||
Akuter Mangel an Fachkräften im Daten-Engineering
Die Nachfrage überstieg das Angebot im Jahr 2025 im Verhältnis drei zu eins, da neue Tools die Universitätslehrpläne überholten. Erfahrene Ingenieure im Silicon Valley fordern nun Vergütungspakete von USD 250.000. Offshore-Zentren in Indien und Osteuropa bieten Entlastung, doch der Koordinierungsaufwand schmälert die Einsparungen. Die Lücke treibt die Premiumpreise für verwaltete Dienste in die Höhe, verlangsamt aber auch interne Projekte und hemmt den Markt für Big-Data-Engineering-Services kurzfristig.
Kosten für Cybersicherheit und Datenschutz-Compliance
Die durchschnittlichen Kosten einer Datenpanne erreichten im Jahr 2025 USD 4,88 Millionen. Obligatorische Verschlüsselung und Multi-Cloud-Schlüsselrotation verursachen operativen Mehraufwand und reduzieren die Abfragegeschwindigkeit um bis zu 40 %. Prüfungsnachweise verbrauchen jährlich Hunderte von Engineering-Stunden und lenken Talente von Innovationen ab. Diese Gemeinkosten erhöhen die Gesamtbetriebskosten und können die Einführung bei budgetbeschränkten Organisationen verzögern, was das Wachstum des Marktes für Big-Data-Engineering-Services mäßigt.
*Unsere Prognosen behandeln die Auswirkungen von Treibern und Einschränkungen als richtungsweisend und nicht additiv. Die Wirkungsprognosen berücksichtigen Basiswachstum, Mischungseffekte und Wechselwirkungen zwischen Variablen.
Segmentanalyse
Nach Servicetyp: Integrationskern, Analytik im Aufstieg
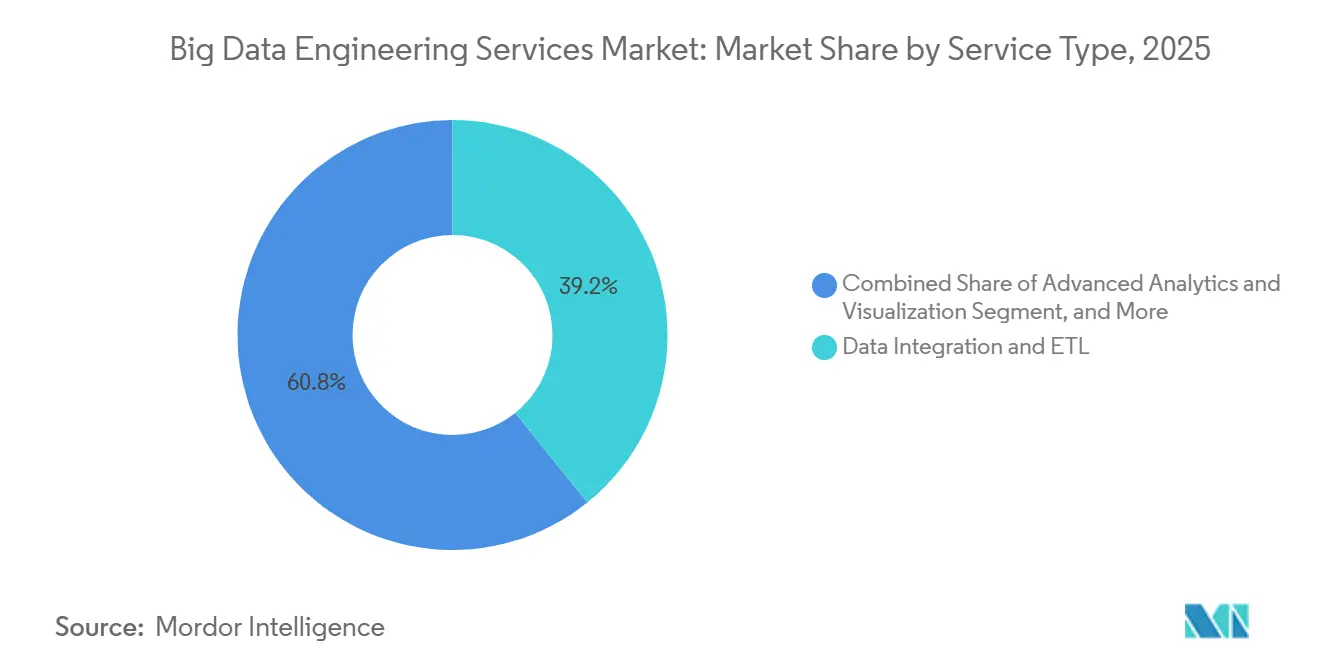
Datenintegrations- und ETL-Dienste erfassten im Jahr 2025 39,22 % des Marktanteils für Big-Data-Engineering-Services und machten sie zum größten einzelnen Umsatzstrom innerhalb des Segmentmixes. Kunden sind auf diese Aufträge angewiesen, um isolierte ERP-, CRM- und IoT-Daten in Lakehouse-Umgebungen zu vereinen und Schema-Konsistenz sowie zuverlässige Datenherkunft sicherzustellen. Die Marktgröße für Big-Data-Engineering-Services, die mit Integration und ETL verbunden ist, bleibt widerstandsfähig, da Schema-Drift und Eigenheiten von Altsystemen weiterhin Pipelines unterbrechen und eine ständige Überarbeitung erfordern. Unterdessen wird Erweiterte Analytik und Visualisierung bis 2031 voraussichtlich mit einer CAGR von 15,91 % wachsen, da Unternehmen über beschreibende Erkenntnisse hinausgehen und zu prädiktiven und präskriptiven Modellen übergehen, die Echtzeit-Aktionen empfehlen.
Zero-ETL-Replikationstechnologien, die operative Daten direkt in analytische Speicher streamen, komprimieren die Latenz, verlagern jedoch die Transformationsverantwortung auf Domänenteams und erhöhen die Governance-Komplexität. Anbieter bündeln nun Beobachtbarkeit, Katalogisierung und Herkunftsverfolgung mit der Kerningestion, um die Metrikkonsistenz über Geschäftsbereiche hinweg zu sichern. Automatisierte Datenqualitätsprüfungen kennzeichnen doppelte Datensätze oder außerhalb des Bereichs liegende Sensormesswerte, bevor sie Führungsdashboards beeinträchtigen, und stärken die Nachfrage nach integrierten Plattformen. Infolgedessen bevorzugen Käufer zunehmend Einzelanbieterangebote, die von der Ingestion bis zur Visualisierung reichen, was Beschaffungszyklen verkürzt und die Anbietervielfalt im Markt für Big-Data-Engineering-Services reduziert.


Nach Geschäftsfunktion: Marketing dominiert, Betrieb beschleunigt
Marketing und Vertrieb machten im Jahr 2025 34,86 % des Marktes für Big-Data-Engineering-Services aus, da Unternehmen darum wetteiferten, Kundendatenplattformen aufzubauen, die Personalisierung auf Millisekundenebene ermöglichen. Diese Projekte verknüpfen Clickstream-, Callcenter- und Kassendaten, sodass Empfehlungsmaschinen Website-Inhalte spontan anpassen können. Echtzeit-Zielgruppensegmentierung erfordert Abfrageleistung unter einer Sekunde, was hohe Investitionen in In-Memory-Feature-Stores und Streaming-Orchestrierung antreibt. Parallel dazu nutzt das Finanzwesen Streaming-Analytik für die Betrugserkennung und regulatorische Berichterstattung, während das Personalwesen Modelle zur Vorhersage von Mitarbeiterfluktuation erprobt, obwohl Datenschutzbedenken in Europa letzteres verlangsamen.
Betriebs- und Lieferkettenarbeitslasten sollen mit einer CAGR von 15,96 % wachsen und sich bis 2031 als die am schnellsten wachsende Geschäftsfunktion positionieren. Algorithmen zur vorausschauenden Wartung analysieren industrielle IoT-Telemetrie, um Geräteausfälle Tage im Voraus vorherzusagen und kostspielige ungeplante Ausfallzeiten zu vermeiden. Einzelhändler und Hersteller integrieren auch Versandmanifeste und GPS-Feeds, um Bestände umzuleiten, wenn Häfen verstopfen oder geopolitische Verschiebungen eintreten. Reverse-ETL-Tools, die analytische Ausgaben zurück in operative Systeme senden, stellen sicher, dass Frontline-Teams Neigungswerte oder Risikowarnungen dort sehen, wo sie arbeiten, und schließen den Aktionskreislauf. Diese Front-to-Back-Integration hebt den Betrieb von einem Kostenzentrum zu einem strategischen Wachstumshebel und erweitert seine Rolle im Markt für Big-Data-Engineering-Services.
Nach Unternehmensgröße: Großunternehmen führen, KMU gewinnen an Tempo
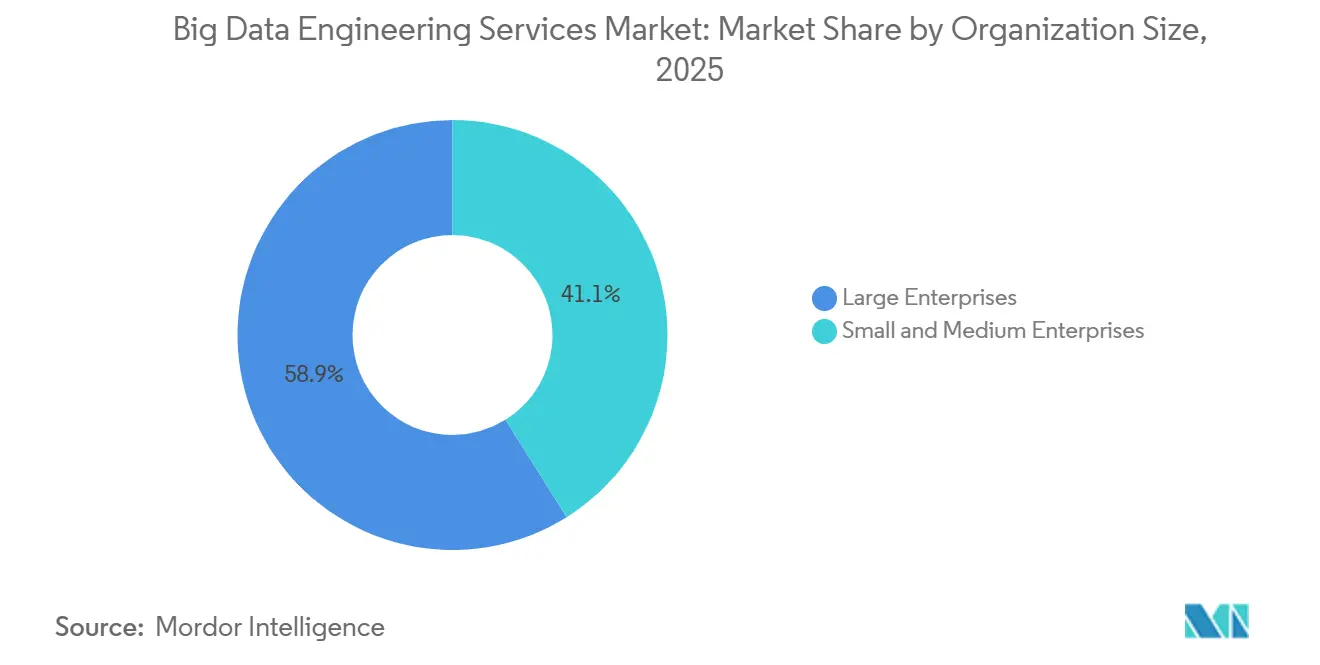
Großunternehmen machten im Jahr 2025 58,91 % des Marktanteils für Big-Data-Engineering-Services aus, angetrieben durch mehrjährige Cloud-Migrationen, die häufig USD 50 Millionen an Ausgaben übersteigen. Diese Organisationen priorisieren Anbieter mit globaler Lieferung, 24/7-Support und umfassenden Sicherheitszertifizierungen, was Aufträge zu Tier-1-Integratoren lenkt. Lange Budgetierungszyklen und komplexe Governance-Prüfungen verlängern Projektzeitpläne, doch einmal begonnen, können Verträge fünf Jahre und Hunderte von Arbeitslasten umfassen und vorhersehbare Einnahmen für Dienstleister sichern.
Kleine und mittlere Unternehmen werden bis 2031 eine robuste CAGR von 15,56 % verzeichnen, da Verbrauchspreise die Ausgaben mit dem Umsatzwachstum in Einklang bringen. Low-Code-Datenpipeline-Tools ermöglichen es zehnköpfigen Engineering-Teams, eine Reife zu erreichen, die einst Unternehmen mit 100 Ingenieuren vorbehalten war, und verkürzen die Zeit bis zur Erkenntnis von Monaten auf Tage. Verwaltete Dienste, die nach verarbeiteten Zeilen oder ausgeführten Abfragen berechnet werden, senken die Einstiegshürden weiter und umgehen den Fachkräftemangel. Dennoch bleiben KMU vorsichtig gegenüber der Anbieterabhängigkeit durch proprietäre Transformationsschichten, was hybride Betriebsmodelle fördert, die Open-Source-Frameworks mit kommerziellen Beschleunigern kombinieren. Dieses sorgfältige Gleichgewicht unterstreicht die wachsende Chance für maßgeschneiderte Angebote im Markt für Big-Data-Engineering-Services.
Nach Bereitstellungsmodus: Cloud dominiert, Hybrid im Aufstieg
Cloud-Bereitstellungen machten im Jahr 2025 63,47 % des Umsatzes im Markt für Big-Data-Engineering-Services aus, da Unternehmen verwaltete Elastizität, automatisierte Skalierung und niedrigere Vorabkosten nutzten. Verwaltete Lakehouse-Plattformen eliminieren Hardware-Aktualisierungszyklen und Patch-Management und ermöglichen es Ingenieuren, sich auf die Modellentwicklung statt auf die Infrastrukturpflege zu konzentrieren. Mehrregionale Verfügbarkeitszonen bilden auch die Grundlage für globale Notfallwiederherstellungsstrategien, eine wesentliche Anforderung für immer verfügbare digitale Unternehmen.
Hybride Bereitstellungsmodelle werden jedoch voraussichtlich die höchste CAGR von 15,78 % erreichen, da regulierte Branchen sensible Daten lokal aufbewahren müssen, während sie Cloud-Burst-Kapazität für unkritische Analysen nutzen. Finanzinstitute halten Transaktionsbücher häufig in lokalen Rechenzentren, übertragen Risikosimulationen jedoch auf GPU-Cluster in der öffentlichen Cloud und verbinden so Compliance mit Rechenelastizität. Zustandsbehaftete Edge-Geräte in Fertigungsanlagen streamen ähnlich nur zusammengefasste Telemetrie in Cloud-Speicher, minimieren Egress-Kosten und erfüllen gleichzeitig Latenzanforderungen. Auf Kubernetes basierende Analyse-Engines versprechen Portabilität über Umgebungen hinweg, erfordern jedoch fortgeschrittene DevOps-Kenntnisse und schaffen neue Beratungsmöglichkeiten. Diese Doppelfußabdruckstrategie erweitert die gesamte adressierbare Nachfrage und festigt hybride Lösungen als kritischen Wachstumsvektor für den Markt für Big-Data-Engineering-Services.
Geografische Analyse
Nordamerika trug im Jahr 2025 42,38 % des Umsatzes bei, dank dichter Hyperscaler-Präsenz in Regionen mit günstigen Energiekosten und einem Flickenteppich staatlicher Datenschutzgesetze, die eine feinkörnige Governance erfordern. Risikokapital finanziert weiterhin Open-Source-Kommerzialisierungen und speist eine Pipeline von Akquisitionszielen für globale Integratoren. Kanada kämpft mit grenzüberschreitenden Datenübertragungsbewertungen unter dem PIPEDA, während Mexikos Nearshoring-Boom Lieferkettentelemetrieprojekte ankurbelt.
Asien-Pazifik wird voraussichtlich die am schnellsten wachsende Region mit einer CAGR von 16,14 % sein. Indiens Digital-India-Fonds injiziert USD 1,2 Milliarden in die nationale Dateninfrastruktur, und Chinas Provinzsubventionen decken die Hälfte der Migrationskosten für staatseigene Hersteller. Japan schreibt digitale Zwillinge in Automobilwerken bis 2026 vor und treibt IoT-Integrationsarbeiten voran. Südkorea erweitert die Betroffenenrechte auf algorithmische Transparenz und erhöht die Nachfrage nach erklärbaren KI-Pipelines. Australien erklärt Rechenzentren zu kritischer Infrastruktur und löst damit verwaltete Sicherheitsprojekte aus, die mit Engineering-Diensten gebündelt werden.
Europa bleibt von der DSGVO regiert, die im Zeitraum 2024–2025 Bußgelder in Höhe von EUR 4,5 Milliarden (USD 5,0 Milliarden) verhängte und Herkunftsverfolgung und Einwilligungsverwaltung zu unverzichtbaren Anforderungen macht. Deutschland setzt On-Premises-Regeln für kritische Infrastruktur durch, Frankreich finanziert eine souveräne Cloud, und die Angemessenheit des Vereinigten Königreichs nach dem Brexit ist noch vorläufig, was Unsicherheit schafft. Südamerika beginnt mit Brasiliens LGPD, während Staatsfonds im Nahen Osten Hyperscale-Rechenzentren als Teil von Smart-City-Initiativen finanzieren. Afrika sieht Pilotprojekte in Südafrika und Nigeria, obwohl unzuverlässige Stromnetze eine breitere Einführung einschränken.

Regulatorisches Umfeld
Regulierung prägt zunehmend die Architekturen des Big-Data-Engineerings durch Datenschutzdurchsetzung, Kontrollen für grenzüberschreitende Übertragungen und Anforderungen an die Rechenschaftspflicht von KI. In Europa blieb die DSGVO-Durchsetzung ein wesentlicher Kostentreiber, mit 4,5 Milliarden EUR an Bußgeldern in den Jahren 2024–2025, was Käufer dazu bewegt, überprüfbare Datenherkunft, Einwilligungsmanagement und unveränderliche Zugriffsprotokolle als Teil des Umfangs von Engineering-Dienstleistungen zu fordern.
Neue und sich verschärfende nationale Rahmenwerke fügen zudem Lokalisierungs- und technische Protokollierungspflichten hinzu, die globale Liefermodelle betreffen. China setzte im Januar 2025 die Regulations on Network Data Security Management in Kraft, wodurch Governance und Genehmigungen für bestimmte Kategorien der Datenverarbeitung verschärft wurden. Die EU erweiterte formalisierte Bedingungen für den Datenzugang durch die Delegierte Verordnung (EU) 2025/2050 der Kommission (Juli 2025) für den Datenaustausch zwischen großen Online-Plattformen und geprüften Forschern, was die Erwartungen an kontrollierten Zugang und Nachverfolgbarkeit erhöht. Auf den Philippinen führte die Executive Order Nr. 119 (Juli 2026) ein Data Residency Framework und eine staatliche Datenklassifizierung ein, was die Nachfrage nach hybriden Bereitstellungen und Verarbeitung im Inland steigert. Zudem tritt der EU AI Act im August 2026 in eine wichtige Durchsetzungsphase für Hochrisikosysteme ein, wodurch Anforderungen wie Audit-Trail-Protokollierung und Dokumentation von Trainingsdaten zu Aufgaben des Engineerings während der Erstellung werden. In den Vereinigten Staaten signalisierte der im April 2026 eingeführte SECURE Data Act eine Bewegung hin zu einem bundesweiten Datenschutzstandard, was Programmen zur Compliance-by-Design zusätzlichen Schwung verleiht, die helfen können, den heutigen Flickenteppich bundesstaatlicher Anforderungen zu rationalisieren.
Wertschöpfungskettenanalyse
Die Wertschöpfungskette für Big-Data-Engineering-Dienstleistungen beginnt mit Datenquellen und Instrumentierung (Unternehmensanwendungen, IoT-/Edge-Telemetrie und digitale Kanäle), führt über Konnektivität und Speicherung (Netzwerke, Objektspeicher und Lakehouse-Tabellenformate) und wird über Plattformen und Werkzeuge (Streaming, Orchestrierung, Observability, Katalog, Governance und Sicherheit) operationalisiert. Dienstleister erbringen dann Beratung, Migration, Integration/ETL, Datenqualität und Governance sowie die Implementierung fortgeschrittener Analytik, unterstützt von Cloud- und Hardware-Infrastrukturanbietern sowie plattformeigenen Konnektoren und Beschleunigern.
Im Jahr 2026 verändern die Infrastrukturexpansion und KI-zentrierte Plattform-Roadmaps die vorgelagerten Abhängigkeiten und die nachgelagerte Verpackung von Dienstleistungen. Groß angelegte Rechenzentrumsausbauten und GPU-zentrierte Kapazitätserweiterungen verbessern die Verfügbarkeit elastischer Rechenleistung für Streaming- und KI-erweiterte Pipelines, während Strom- und Komponentenengpässe Unternehmen zu Designs drängen, die den Egress kontrollieren, Datenbewegungen minimieren und auf offene Tabellenformate standardisieren. Partnerschaften zwischen Infrastruktur-, Cloud- und Datenplattformanbietern beeinflussen ebenfalls die Bereitstellungsansätze, darunter Nokia, AWS und Databricks, die eine cloud-agnostische Datenplattform für autonome Netzwerkbetriebe demonstrieren (Juni 2026), was die Nachfrage nach Konnektor-Abstraktionsschichten und Portabilitätsdiensten unterstützt. Über die gesamte Kette hinweg verschieben Compliance-Anforderungen (Datenschutz, Datenresidenz und KI-Auditierbarkeit) Governance, Datenherkunft und Protokollierung von nachgerüsteten Tools in das Kern-Pipeline-Engineering und in Runbooks für Managed Services.
Wettbewerbslandschaft
Der Markt für Big-Data-Engineering-Services ist mäßig fragmentiert, wobei die Top-10-Anbieter etwa 45 % des Marktanteils auf sich vereinen. Accenture, IBM und Cognizant nutzen globale Lieferzentren für Follow-the-Sun-Support, während Hyperscaler die Grenzen zwischen Software und Beratung verwischen, indem sie professionelle Dienste in Plattformabonnements einbetten. Indische Großunternehmen wie Tata Consultancy Services und Infosys konkurrieren über Kostenvorteile, doch Lohninflation verringert diesen Abstand.
Nischenberatungsunternehmen wie Thoughtworks und Slalom differenzieren sich durch agile, vor-Ort-basierte Engagement-Modelle, die den Wissenstransfer beschleunigen. Plattformanbieter, insbesondere Databricks und Snowflake, stellen nun ehemalige Big-Four-Berater ein, um End-to-End-Implementierungen zu liefern und traditionelle Integratoren zu umgehen. Patenttrends unterstreichen die Spezialisierung. IBM konzentriert sich auf föderiertes Lernen, während Palantir das graphbasierte Herkunftsmanagement vorantreibt.
Branchenspezifische Datenmärkte entstehen als neues Wettbewerbsfeld. Clearinghäuser im Gesundheitswesen und Aggregatoren von Kassendaten im Einzelhandel erfordern eine enge Schema-Harmonisierung und schaffen Möglichkeiten für Boutique-Unternehmen mit vertikaler Expertise. Sicherheitszertifizierungen wie ISO 27001 und SOC 2 Typ II sind zu Mindestanforderungen geworden, wobei Beschaffungsteams nicht zertifizierte Bieter von der Auswahlliste ausschließen.
Marktführer im Bereich Big-Data-Engineering-Services
Accenture plc
Cognizant Technology Solutions Corporation
Capgemini SE
Infosys Limited
Genpact Limited
- *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert

Marktchancen und Zukunftsaussichten
KI-native Datenengineering schafft kurzfristig Freiraum für Dienstleistungen, die über klassisches ETL hinausgehen zu governten Echtzeit-Pipelines, die RAG, Vektorsuche und multimodale Analytik versorgen. Plattform-Releases im Jahr 2026 zeigen diesen Wandel, darunter Databricks, das Lakeflow Connect auf mehr als 100 native verwaltete Konnektoren erweitert (Juni 2026), und Google Cloud, das Conversational Analytics in BigQuery in die allgemeine Verfügbarkeit überführt (Juli 2026). Diese Releases erhöhen die Käufernachfrage nach Integrationsmustern, Bereitschaft der semantischen Schicht und Sicherheitsvorkehrungen, die den natürlichsprachlichen und agentengesteuerten Zugriff mit Katalogrichtlinien, zeilenbasierten Kontrollen und überprüfbarer Datenherkunft in Einklang halten.
Ein zweiter Chancenbereich konzentriert sich auf hybride und souveränitätsfähige Betriebsmodelle, die elastische Rechenleistung mit Datenresidenz und sektoralen Kontrollen in Einklang bringen. Regulatorische Maßnahmen wie die philippinische Executive Order Nr. 119 (Juli 2026) und die im August 2026 beginnende Durchsetzungsphase des EU AI Act erhöhen den Umsetzungsaufwand rund um Datenklassifizierung, Verarbeitung im Inland, Audit-Trail-Protokollierung und Dokumentation von Trainingsdaten. Gleichzeitig unterstützt die anhaltende Investitionstätigkeit von Hyperscalern und Rechenzentren größere Modernisierungsprogramme, was die Nachfrage nach ergebnisorientierten Managed Services erhöht, die Sicherheit, Observability und Kostenkontrollen bündeln, einschließlich Egress-Management und Portabilität über Cloud- und On-Premise-Umgebungen hinweg. Anbieter, die Migrationsfabriken für die Lakehouse-Einführung standardisieren, Compliance-by-Design-Kontrollen implementieren und Pipeline-Betriebe mit KI-gestütztem Engineering automatisieren können, können Ausgaben erschließen, wenn Unternehmen von Batch-Warehouses zu kontinuierlichen Pipelines und governter Self-Service-Analytik übergehen.
Aktuelle Branchenentwicklungen
- Juni 2026: Accenture Ventures tätigte eine strategische Investition in AlphaSense und ging eine Partnerschaft ein, um KI-gestützte Marktintelligenz in agentische Unternehmensworkflows einzubetten. Dieser Schritt erweitert Accentures Fähigkeit, externe und interne Daten innerhalb governter Pipelines zu operationalisieren, und verstärkt die Nachfrage nach Integration, Observability und Zugriffskontrollen über Datenlandschaften hinweg.
- April 2026: Cognizant schloss eine endgültige Vereinbarung zur Übernahme von Astreya, einem KI-first-Anbieter für Managed Services und Lösungen, um die Fähigkeiten in KI-Infrastruktur und -Betrieb zu vertiefen. Der Zusammenschluss unterstützt größere Managed-Engagements, bei denen Engineering-Dienstleistungen Datenplattformen, Arbeitsplatzbetriebe und dauerhaft aktive Produktionsumgebungen umfassen.
- Dezember 2025: Databricks übernahm Tabular für 1,2 Milliarden USD, um die Apache-Iceberg-Tabellenfähigkeiten zu stärken. Dies beschleunigte die Einführung offener Tabellenformate innerhalb von Lakehouse-Stacks und erhöhte den Implementierungsaufwand rund um Migration, Interoperabilität und Governance über Multi-Cloud-Datenarchitekturen hinweg.


Rahmen der Forschungsmethodik und Umfang des Berichts
Marktdefinition und Abdeckung
Wir definieren den Markt für Big-Data-Engineering-Dienstleistungen als Drittanbieterdienste, die Unternehmensdatenfundamente entwerfen, aufbauen, modernisieren und betreiben, einschließlich Pipelines, Datenspeicher und Governance, die zur Bereitstellung analysefähiger und KI-tauglicher Datensätze erforderlich sind.
Umfangsausschlüsse: Diese Marktgrößenbestimmung schließt Umsätze aus Softwarelizenzpaketen und interne firmeneigene Engineering-Kosten aus, die nicht als externe Dienstleistungen abgerechnet werden.
Übersicht der Segmentierung
- Nach Servicetyp
- Datenmodellierung und Architektur
- Datenintegration und ETL
- Datenqualität und Governance
- Erweiterte Analytik und Visualisierung
- Nach Geschäftsfunktion
- Marketing und Vertrieb
- Finanzen
- Betrieb und Lieferkette
- Personalwesen
- Nach Unternehmensgröße
- Kleine und mittlere Unternehmen
- Großunternehmen
- Nach Bereitstellungsmodus
- Cloud
- On-Premises
- Hybrid
- Nach Geografie
- Nordamerika
- Vereinigte Staaten
- Kanada
- Mexiko
- Südamerika
- Brasilien
- Argentinien
- Übriges Südamerika
- Europa
- Vereinigtes Königreich
- Deutschland
- Frankreich
- Italien
- Übriges Europa
- Asien-Pazifik
- China
- Japan
- Indien
- Südkorea
- Übriger Asien-Pazifik-Raum
- Naher Osten und Afrika
- Naher Osten
- Vereinigte Arabische Emirate
- Saudi-Arabien
- Übriger Naher Osten
- Afrika
- Südafrika
- Ägypten
- Übriges Afrika
- Naher Osten
- Nordamerika
Datenquellen, Marktgrößenbestimmung und Validierung
Sekundärforschung
Sekundärforschung wurde genutzt, um die Grenzen dessen festzulegen, was als Engineering-Dienstleistung gilt, und um makroökonomische Nachfragesignale zu verankern, die die Ausgaben prägen. Wir stützten uns auf öffentliche Quellen wie das US Bureau of Economic Analysis, das US Bureau of Labor Statistics, Eurostat, die OECD und die Weltbank, um die Richtung der IT-Dienstleistungsausgaben, Trends bei Cloud-Investitionen und Lohninflation zu verstehen, die die Lieferpreise beeinflussen.
Wir überprüften auch Geschäftsberichte und Transkripte von Ergebnisgesprächen von Unternehmen, Investorenpräsentationen sowie Inhalte von NIST und anderen Verbänden und Normungsgremien, um Governance- und Compliance-Erwartungen zu verstehen, die den Projektumfang beeinflussen. Bei Bedarf ergänzten wir dies durch kostenpflichtige Abonnements mit Fokus auf Unternehmensfinanzen und Nachrichten, Patentdatenbanken für Innovationssignale im Datenstack sowie globale Verträge und Ausschreibungen, um zu sehen, wie Käufer Engineering-Arbeit in der Beschaffungssprache beschreiben. Diese Sekundärquellen sind nicht erschöpfend, und viele weitere öffentliche Referenzen wurden zur Datenerhebung, Validierung und Forschungsklärung genutzt.
Primärinterviews und Umfragen
Die Primärforschung konzentrierte sich darauf, zu validieren, was Käufer in ein typisches Datenengineering-Programm einbeziehen und wie sich die Preisgestaltung zwischen Cloud-, On-Premise- und hybriden Lieferformen bewegt. Wir sprachen mit Führungskräften im Service Delivery, Solution Architects, Beschaffungs- und IT-Managern sowie funktionalen Verantwortlichen in den wichtigsten Regionen, damit die Modellannahmen anhand realer Projektumfänge und Liefermix überprüft werden konnten.
Verteilung der Befragten der primären Forschungsarbeit
| Unternehmenstyp | Position der Befragten | Region |
|---|---|---|
| Top-Tier: 34% | CXOs: 12% | APAC: 53% |
| Mid-Tier: 44% | Funktions-/Bereichsleiter: 30% | EMEA: 29% |
| Kleinere Anbieter: 22% | Manager: 58% | Amerika: 18% |
Marktgrößenbestimmung & Prognose
Die Größenbestimmung beginnt mit einem Top-down-Aufbau des Nachfragepools, bei dem Ausgaben für Unternehmens-IT-Dienstleistungen und Aktivitäten der Cloud-Migration in einen adressierbaren Anteil für Datenengineering-Arbeit übersetzt und anschließend nach Bereitstellungsart und Region aufgeschlüsselt werden. Um die Gesamtsummen realistisch zu halten, bestätigen wir das Ergebnis mit selektiven Bottom-up-Prüfungen, wie beispielsweise stichprobenhaften Projektlaufraten, typischer Teamgröße und -dauer sowie einer leichten Zusammenfassung der Umsätze der Servicelinien, wo die Offenlegungen klar sind.
Im Modell umfassen die wichtigsten Eingaben das Tempo der Cloud-Einführung für Datenplattformen, den Anteil der Workloads, die in hybriden Konfigurationen für regulierte Branchen laufen, typische Bewegungen der Abrechnungssätze nach Region, die Verschiebung des Mixes hin zu verwalteten Datenoperationen und den durchschnittlichen Neubau-Rhythmus für Pipelines, wenn neue Analytik- und KI-Anwendungsfälle hinzugefügt werden. Prognosen werden mittels Szenarioanalyse entwickelt, wobei der Basisfall vom Expertenkonsens zu Cloud-Ausgabenwachstum, Verfügbarkeit von Arbeitskräften und Governance-Intensität geleitet und anschließend für einen schnelleren KI-Programmhochlauf oder langsamere Budgetzyklen stresstestet wird. Wo Bottom-up-Signale für kleinere Märkte fehlen, werden Lücken mit konservativen Annahmen zu Durchdringung und Preisen behandelt, die später durch Folgegespräche und Überprüfungen der Beschaffungssprache erneut geprüft werden.
Datenvalidierung & Aktualisierungszyklus
Die Ergebnisse werden mit unabhängigen Signalen abgeglichen, einschließlich Einstellungstrends im Dienstleistungssektor, Richtung des Cloud-Verbrauchs und Ankündigungen großer Programme, die anzeigen, wann sich die Engineering-Ausgaben beschleunigen. Wenn die Ergebnisse von diesen Indikatoren abweichen, werden die Annahmen erneut geöffnet, gefolgt von einer zweiten Analystenprüfung vor der endgültigen Freigabe.
Berichte werden jährlich aktualisiert, und zwischenzeitliche Aktualisierungen werden ausgelöst, wenn wichtige Ereignisse die Ausgabenmuster verändern, etwa eine starke Änderung der Cloud-Preise, politisch bedingte Anforderungen an die Datenresidenz oder ein plötzlicher Nachfrageanstieg für KI-taugliche Datenpipelines. Vor der Auslieferung wird ein finaler Durchlauf abgeschlossen, damit Kunden eine aktuelle Sicht mit den zuletzt validierten Eingaben erhalten.
Marktgröße für Big-Data-Engineering-Dienstleistungen von Mordor Intelligence im Vergleich zu anderen veröffentlichten Schätzungen
Veröffentlichte Marktgrößen für Big-Data-Engineering-Dienstleistungen können weit voneinander abweichen, selbst wenn sie ein ähnliches Käuferproblem beschreiben. Die Unterschiede resultieren in der Regel daraus, was als Engineering-Dienstleistung im Gegensatz zu angrenzender IT-Arbeit gezählt wird, welches Jahr als Ausgangspunkt behandelt wird und wie sich Preisgestaltung und Liefermix annahmegemäß verändern.
Die Tabelle zeigt eine deutliche Spannbreite, hauptsächlich weil einige Schätzungen breitere Beratungs- oder Managed-Services-Leistungen in denselben Topf einordnen, und einige sich auf aggressive Multiplikatoren für die Cloud-Migration verlassen, ohne zu prüfen, wie viel Arbeit On-Premise bleibt oder aufgrund von Governance-Anforderungen zu hybriden Formen wechselt. Die Tabelle zeigt, dass im Modell von Mordor Intelligence Umsätze nur für Dienstleistungen gezählt werden, die mit dem Aufbau und Betrieb von Datenpipelines, Integration und ETL, Datenqualität und Governance sowie Datenmodellierung und Architektur verbunden sind, anstatt nicht verwandte Analysesoftware oder allgemeines IT-Outsourcing zu bündeln.
Vergleichsanalyse
| Quelle | Marktgröße | Lücken in der Forschungsmethodik |
|---|---|---|
| Mordor Intelligence | 105,38 Milliarden USD (2026) | |
| Fachzeitschrift A | 68,76 Milliarden USD (2023) | Verwendet ein früheres Basisjahr und gruppiert Datenengineering häufig mit breiteren Modernisierungsdienstleistungen für Datenplattformen, was verändern kann, was als reiner Umsatz aus Engineering-Lieferung gezählt wird. |
| Regionale Beratungsgesellschaft B | 61,20 Milliarden USD (2025) | Deckt eine breitere Bezeichnung von Datenengineering-Dienstleistungen ab mit begrenzter Einsicht in den Cloud- versus hybriden Liefermix, was den Wert je nach angenommenen Abrechnungssätzen und Projektdauer komprimieren oder aufblähen kann. |
Über alle drei Zahlen hinweg ist die wichtigste Erkenntnis, dass Umfang und Jahreswahl den größten Teil der Abweichung verursachen, gefolgt davon, wie Liefermix und Preisgestaltung behandelt werden. Indem wir die Eingaben an beobachtbare Ausgabensignale koppeln und Annahmen mit Praxisprüfungen validieren, wollen wir die Schätzung reproduzierbar und leichter überprüfbar halten, wenn Kunden Szenarien nachbauen.


Im Bericht beantwortete Schlüsselfragen
Wie schnell wachsen die Ausgaben für Big-Data-Engineering weltweit?
Der globale Umsatz wird voraussichtlich mit einer CAGR von 15,12 % von 2026 bis 2031 wachsen und sich von USD 105,38 Milliarden im Jahr 2026 auf USD 213,07 Milliarden im Jahr 2031 mehr als verdoppeln.
Welche Regionen werden die schnellste Einführung von Echtzeit-Datenpipelines verzeichnen?
Asien-Pazifik führt mit einer prognostizierten CAGR von 16,14 %, da öffentliche Initiativen in Indien, China und Japan die nationale Dateninfrastruktur und industrielle IoT-Programme finanzieren.
Welche Servicekategorie erzielt derzeit den höchsten Umsatz?
Datenintegration und ETL macht 39,22 % der Ausgaben im Jahr 2025 aus und spiegelt die anhaltende Nachfrage nach der Verbindung verschiedener Quellsysteme wider.
Warum wachsen hybride Bereitstellungen schneller als reine Cloud-Lösungen?
Regulierte Branchen halten sensible Daten aus Gründen der Datenresidenz und Latenz lokal vor, lagern jedoch unkritische Arbeitslasten für elastische Rechenkapazität in die Cloud aus, was eine CAGR von 15,78 % bei der hybriden Einführung antreibt.
Wie gravierend ist der Fachkräftemangel im Daten-Engineering?
Im Jahr 2025 überstieg die Nachfrage das Angebot im Verhältnis drei zu eins, wobei erfahrene Ingenieure eine Gesamtvergütung von USD 250.000 forderten, was viele Unternehmen zu verwalteten Diensten drängt.
Was ist der wichtigste Compliance-Druck, der Datenplattformen prägt?
Die Durchsetzung der DSGVO und ähnlicher Datenschutzgesetze hat seit 2024 Bußgelder in Höhe von USD 5,0 Milliarden verhängt und macht prüfbare Herkunftsverfolgung und Einwilligungsverwaltung zu obligatorischen Funktionen.
Seite zuletzt aktualisiert am:



