
Tamanho e Participação do Mercado de Web Scraping
Análise do Mercado de Web Scraping por Mordor Intelligence
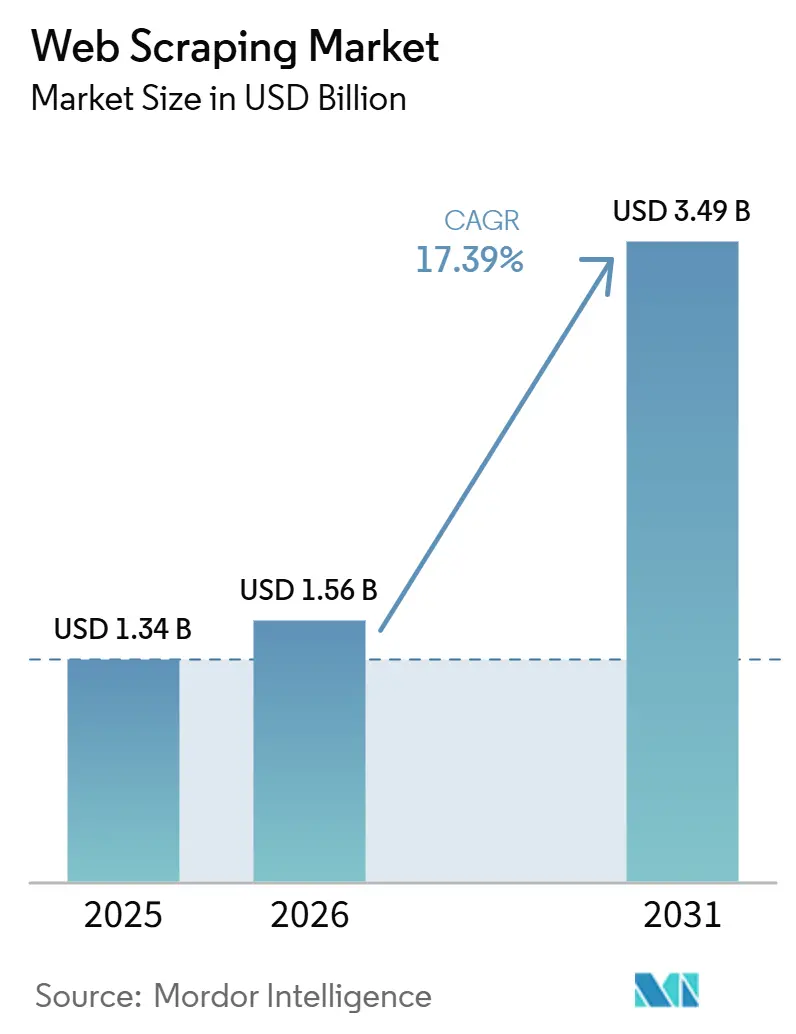
O tamanho do mercado de web scraping foi avaliado em 1,56 bilhões de USD em 2026 e estima-se que cresça de 1,83 bilhões de USD em 2027 para atingir 4,03 bilhões de USD até 2032, a um CAGR de 17,08% durante o período de previsão (2027-2032).
O crescimento do varejo online nos Estados Unidos e o uso de dados derivados da web por empresas de investimento sustentam uma demanda recorrente por coleta. A extração assistida por IA produz registros com restrições de esquema, fornecendo às equipes campos de saída definidos para verificar antes da análise. O acesso restrito a plataformas também aumenta o valor de validar o que cada rota de coleta recupera. Os fornecedores escolhem entre vender software reutilizável e entregar conjuntos de dados prontos, assumindo responsabilidade por diferentes partes da coleta. Os custos de sites protegidos e as restrições legais limitam a amplitude com que esses serviços podem coletar e manter a entrega.
Principais Conclusões do Relatório
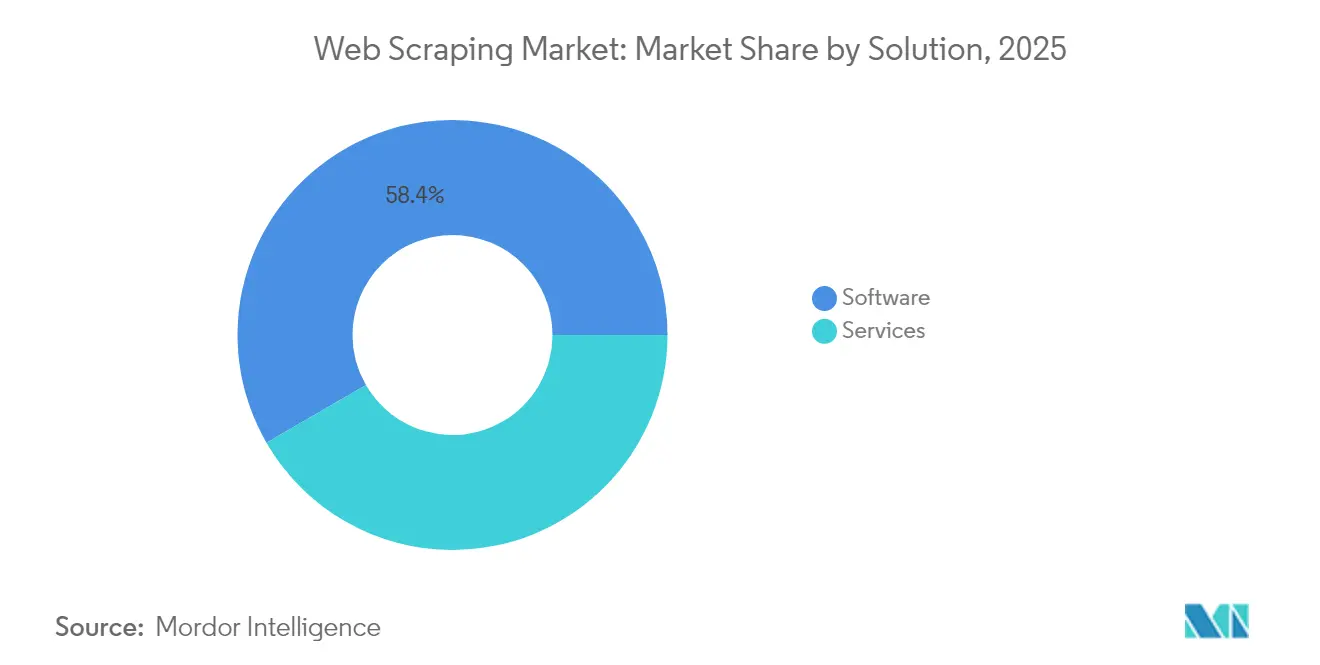
- Entre as soluções, o software detinha uma participação de 57,93% no mercado de web scraping em 2026, enquanto os serviços têm previsão de crescer mais rapidamente, a um CAGR de 18,35% durante 2027-2032.
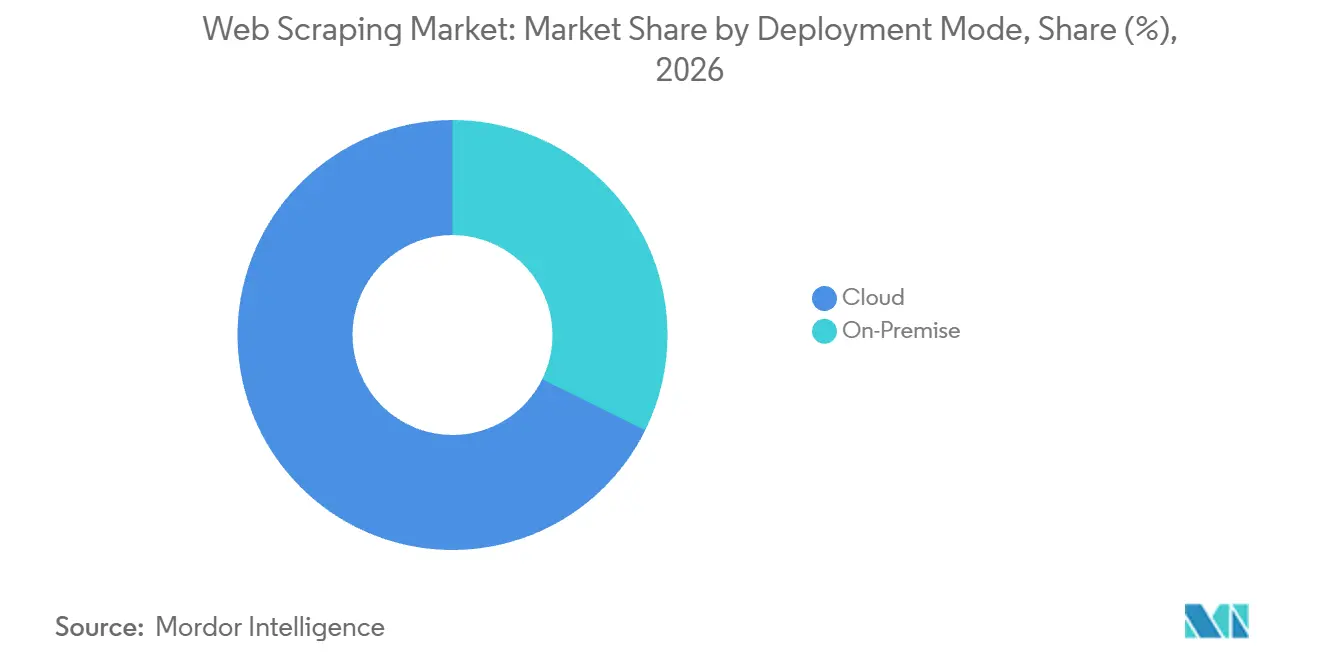
- A implantação em nuvem representou uma participação de 67,7% no tamanho do mercado de web scraping em 2026 e tem previsão de crescer mais rapidamente, a um CAGR de 17,52% durante 2027-2032.
- Entre os setores de usuários finais, o BFSI liderou com 29,39% da receita em 2026, enquanto o segmento de publicidade e mídia tem previsão de crescer mais rapidamente, a um CAGR de 18,5% durante 2027-2032.
- Por caso de uso, a extração de dados / ETL liderou com 35,89% da receita em 2026, com o monitoramento de preços e competitivo projetado para crescer mais rapidamente, a um CAGR de 18,05% durante 2027-2032.
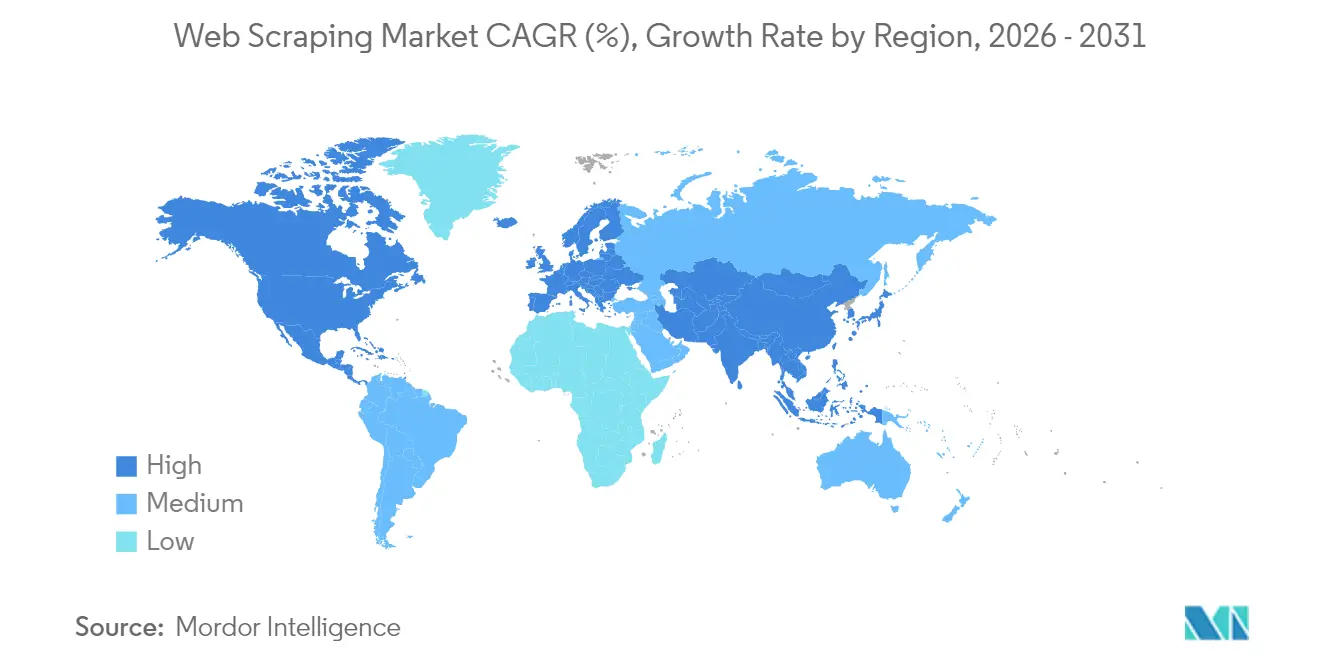
- Geograficamente, a América do Norte detinha 33,94% da receita em 2026, enquanto a Ásia-Pacífico tem previsão de crescer mais rapidamente, a um CAGR de 18,35% durante 2027-2032.
Nota: Os números de mercado apresentados neste relatório são baseados na estrutura de estimativa proprietária da Mordor Intelligence, que combina nove meses de dados reais com projeções do quarto trimestre para o ano base de 2026.
Tendências e Insights de Mercado
Análise de Impacto dos Impulsionadores*
| Impulsionador | (~) % de Impacto na Previsão de CAGR | Relevância Geográfica | Prazo de Impacto |
|---|---|---|---|
| Crescimento do Comércio Eletrônico e dos Marketplaces Online | +5.1% | América do Norte e Ásia-Pacífico | Curto prazo (≤ 2 anos) |
| Avanços em IA/ML para Extração de Dados | +4.6% | América do Norte, Europa e Ásia-Pacífico | Curto prazo (≤ 2 anos) |
| Crescente Demanda por Dados Alternativos em Finanças | +4.1% | América do Norte e Europa | Médio prazo (2-4 anos) |
| Descontinuação de APIs em Grandes Plataformas Impulsionando o Scraping | +3.6% | Estados Unidos e Europa | Curto prazo (≤ 2 anos) |
| Requisitos de Dados de Treinamento para IA Generativa | +3.2% | América do Norte e Ásia-Pacífico | Longo prazo (≥ 4 anos) |
| Mandatos de Dados Abertos Revelando Lacunas de Dados | +1.8% | Alemanha, França e Espanha | Médio prazo (2-4 anos) |
| Fonte: Mordor Intelligence | |||
Crescimento do Comércio Eletrônico e dos Marketplaces Online
Um maior fluxo de vendas online aumenta o valor comercial de observar preços e disponibilidade em lojas digitais. As vendas de comércio eletrônico no varejo dos EUA, ajustadas sazonalmente, atingiram 340,2 bilhões de USD no segundo trimestre de 2026, alta de 12,2% (±0,9%) em relação ao segundo trimestre de 2025, sem ajuste para variações de preços. As vendas totais do varejo dos EUA cresceram 6,7% (±0,5%) no mesmo período, de modo que as observações de preços online dizem respeito a um canal que ganha peso nas vendas. Para varejistas que acompanham um conjunto recorrente de produtos, a tarefa de coleta é separar as variações de preço das variações de sortimento. Comparar produtos correspondentes entre execuções de coleta pode fundamentar o próximo ajuste de oferta no reajuste de preço de um concorrente, em vez de uma aparente variação de preço causada por um mix de produtos diferente.
Avanços em IA/ML para Extração de Dados
O desenvolvimento de spiders assistido por IA pode ampliar o leque de sites-alvo que uma equipe de coleta pode se dar ao luxo de manter. Durante o segundo e terceiro trimestres de 2025, o ScrapeGraphAI coletou cerca de 9 milhões de eventos de telemetria opt-in provenientes do uso em produção de sua biblioteca de extração web de código aberto. Os pesquisadores deduplicaram e equilibraram esses eventos brutos por esquema em um conjunto de dados publicado de 93.695 eventos de extração. Em março de 2026, a Zyte Group Ltd. disponibilizou o Web Scraping Copilot 1.0 para uso geral, uma extensão do Visual Studio Code que usa IA para gerar, testar e implantar spiders Scrapy. Integrar essas tarefas ao editor do desenvolvedor pode reduzir o esforço de engenharia por site-alvo e ampliar o escopo economicamente viável do programa Scrapy de uma equipe.
Crescente Demanda por Dados Alternativos em Finanças
Em uma pesquisa realizada entre setembro e outubro de 2025 com 56 empresas do lado comprador nos Estados Unidos, no Reino Unido e na Europa, a Crisil Coalition Greenwich constatou que 63% dos investidores planejavam aumentar os gastos com dados alternativos. Em uma divulgação de março de 2026, a AQR afirmou que seu consultor usa dados alternativos para gerir determinados fundos, incluindo comportamento do consumidor, sentimento em mídias sociais e dados de pesquisa e tráfego na internet. Essa divulgação alertou que a infraestrutura de tecnologia da informação frequentemente menos robusta dos fornecedores pode deixar conjuntos de dados suspensos, atrasados ou indisponíveis. As intenções de gastos ampliam a oportunidade potencial para fornecedores de dados alternativos, enquanto o alerta da AQR sobre possíveis interrupções destaca a importância da continuidade do fornecimento. Para equipes de investimento, uma interrupção de fornecedor pode remover uma entrada de modelo na próxima atualização. A continuidade do fornecimento pode, então, distinguir fornecedores de dados que seriam igualmente adequados.
Descontinuação de APIs em Grandes Plataformas Impulsionando o Scraping
Em entrevistas realizadas entre outubro de 2024 e fevereiro de 2025, pesquisadores de mídias sociais descreveram o web scraping como uma alternativa às APIs de plataformas e levantaram preocupações legais, éticas e de confiabilidade. O Reddit anunciou em 5 de agosto de 2026 que restringiria gradualmente novas solicitações de API pública.[1] O Reddit também planeja começar a remover o acesso à API de Dados para aplicativos e usuários não registrados ou inativos em 12 de janeiro de 2027, e encerrar o acesso restante à API pública em março de 2027. Um estudo do TikTok de 2026 constatou que as ferramentas de scraping via API e de front-end recuperavam conteúdo com diferentes períodos de tempo e níveis de popularidade. Para compradores que enfrentam acesso restrito, essas diferenças tornam uma rota de coleta alternativa comercialmente útil apenas quando seu resultado se adequa à análise pretendida. O plano do Reddit de encerrar o acesso restante à API pública em março de 2027 dá às equipes que atualmente dependem de extrações via API uma data fixa até a qual qualquer rota substituta precisa ter sua cobertura verificada.
Análise de Impacto das Restrições*
| Restrição | (~) % de Impacto na Previsão de CAGR | Relevância Geográfica | Prazo de Impacto |
|---|---|---|---|
| Incerteza Legal e Ética | -2.2% | Estados Unidos e China | Médio prazo (2-4 anos) |
| Altos Custos e Complexidade Técnica | -1.6% | Estados Unidos e Reino Unido | Curto prazo (≤ 2 anos) |
| Ferramentas Avançadas de Mitigação de Bots Aumentam as Taxas de Falha | -1% | Estados Unidos e Reino Unido | Curto prazo (≤ 2 anos) |
| APIs Oficiais Canibalizando Alguns Casos de Uso de Scraping | -0.5% | América do Norte e Europa | Médio prazo (2-4 anos) |
| Fonte: Mordor Intelligence | |||
Incerteza Legal e Ética
Um conjunto de dados pode perder sua utilidade comercial quando o método de aquisição cria uma obrigação de exclusão. Em julho de 2025, o LinkedIn afirmou que sua resolução exigiu que a Proxycurl excluísse permanentemente os dados do LinkedIn obtidos por meios não autorizados e parasse de acessar o LinkedIn ilegalmente. O LinkedIn descreveu o caso como envolvendo scraping não autorizado por meio de contas falsas e outras atividades fraudulentas. Para um comprador, uma restrição comparável interromperia os fluxos de trabalho dependentes dos registros afetados. A mesma resolução proibiu a Proxycurl de continuar acessando o LinkedIn ilegalmente, de modo que a rota que produziu os registros excluídos não poderia ser usada para reconstruí-los.
Altos Custos e Complexidade Técnica
Sites protegidos criam um limite de custo que pode restringir o alcance econômico de um programa de scraping. Em uma pesquisa de dezembro de 2025, 88,7% dos entrevistados relataram aumento de custos ao direcionar sites protegidos por medidas antibot.[2] Para os profissionais de scraping, um custo de coleta mais elevado aumenta os recursos necessários para adicionar alvos protegidos a um programa. Esse ônus eleva a despesa de adicionar cada alvo protegido a um programa, o que pode limitar quantos desses alvos uma equipe assume. Uma cobertura maior ou uma coleta mais frequente deve absorver a pressão de custo relatada.
*Nossas previsões tratam os impactos dos impulsionadores e restrições como direcionais, e não aditivos. As previsões de impacto refletem o crescimento de base, os efeitos de composição e as interações entre variáveis.
Análise de Segmentos
Por Solução:
Software Reutilizável Lidera Enquanto os Serviços de Dados se ExpandemO software representou uma participação de 57,93% no tamanho do mercado de web scraping em 2026. A Apify Technologies s.r.o. reporta uma base de clientes mundial de 91.000 para sua plataforma de web scraping e automação de navegador. Com uma plataforma de software, um comprador pode reter a lógica de extração que configura e aplicá-la a execuções de coleta sucessivas. A coleta repetida deriva valor econômico do código reutilizável e da configuração de fluxo de trabalho, pois se baseia em uma implementação existente. A plataforma pode escalar por meio de infraestrutura de execução compartilhada, preservando as rotinas específicas do cliente.
Os serviços são o segmento de crescimento mais rápido, com um CAGR projetado de 18,35% durante 2027-2032. Em 1º de dezembro de 2025, a Statistics Canada concedeu à Mobius365 Knowledge Services, Inc. um contrato para dados obtidos por web scraping de sites canadenses.[3] O contrato cobriu finalidades estatísticas e de pesquisa de 1º de abril de 2026 a 31 de março de 2027, com 4 opções de extensão de um ano. A agência especificou que estava adquirindo dados, mantendo o contrato focado nas informações entregues, e não em software ou licença de Software como Serviço. O valor potencial de renovação depende do desempenho no conjunto de dados solicitado sob uma obrigação contínua de fornecimento de dados.

Por Modo de Implantação:
Escala em Nuvem Encontra Controle do OperadorA nuvem representou uma participação de 67,7% no mercado de web scraping em 2026 e é o segmento de crescimento mais rápido, com um CAGR de 17,52% durante 2027-2032. A Apify Technologies s.r.o. executa sua plataforma de web scraping, extração de dados e automação na nuvem por meio de programas sem servidor chamados Actors. A empresa reporta o processamento de mais de 1 petabyte de dados mensalmente em toda essa plataforma. A execução gerenciada pelo fornecedor pode se adequar a um comprador cuja demanda de coleta varia entre execuções, pois a capacidade pode ser considerada separadamente da definição dos registros solicitados. A nuvem concentra a obrigação de capacidade no fornecedor da plataforma, de modo que um comprador pode executar coletas de alto volume sem provisionar cada ambiente separadamente.
A implantação local coloca o ambiente de coleta sob o controle direto do operador, trazendo a configuração e a manutenção para o mesmo limite organizacional. Para uma organização que precisa que os registros coletados e os logs de extração permaneçam em sua própria rede, a execução local alinha o crawler com esse requisito interno. A organização deve então alocar pessoal para a operação do crawler, a configuração de proxy e os reparos de análise como parte do programa de coleta. Uma mudança no layout da página pode consumir o tempo dessa equipe mesmo quando os campos de dados desejados permanecem os mesmos. O argumento para manter a execução local repousa nesse requisito interno de tratamento de dados, com a manutenção do analisador tratada como um custo contínuo para atendê-lo.
Por Setor do Usuário Final:
Fluxos de Trabalho de Investimento e Inteligência Publicitária Moldam a DemandaO BFSI foi o maior segmento, representando 29,39% da receita de mercado em 2026. A pesquisa de 2025 da Lowenstein Sandler abrangeu respondentes de empresas de private equity, gestores de fundos de hedge e empresas de capital de risco. Ela identificou o web scraping entre as fontes de dados usadas em sistemas de IA personalizados para pesquisa de investimentos, otimização de portfólio ou negociação. Para esses compradores, a extração fornece potenciais entradas para modelos, enquanto a pesquisa de investimentos, a otimização de portfólio e a negociação envolvem diferentes decisões sobre como essas entradas devem ser usadas. Adaptar as variáveis entregues a uma tarefa de investimento específica dá a um fornecedor de extração uma base clara para o trabalho de integração dentro do modelo que usa esses registros.
O segmento de publicidade e mídia é o segmento de crescimento mais rápido, com um CAGR projetado de 18,5% durante 2027-2032. A Adbeat rastreia 1,3 milhão de páginas e detecta, analisa e processa 3,8 milhões de anúncios diariamente. O processamento diário nessa escala mostra como a inteligência publicitária cria cargas de trabalho recorrentes de busca de páginas e processamento de anúncios. Para anunciantes que comparam campanhas de concorrentes, coletar o mesmo conjunto de editores em dias sucessivos pode distinguir novos posicionamentos de observações anteriores. A oportunidade comercial reside na manutenção desse histórico de campanhas, de modo que a frequência de coleta importa tanto quanto o número de páginas cobertas.
Por Caso de Uso:
Pipelines Repetíveis Apoiam a Visibilidade CompetitivaA extração de dados / ETL foi o maior segmento, representando 35,89% da receita de mercado em 2026. Esse caso de uso transforma páginas web em registros estruturados que podem percorrer etapas de extração, transformação e carregamento. Seu papel econômico é horizontal, pois a mesma infraestrutura de coleta pode alimentar diversas análises posteriores sem prescrever uma única decisão. Para um comprador que combina múltiplas fontes web, a escolha de design crítica é onde padronizar os registros antes de passá-los para outros sistemas. Nesse ponto de transferência, um fornecedor de extração pode vender entradas confiáveis independentemente do software de análise posterior.
O monitoramento de preços e competitivo é o segmento de crescimento mais rápido, com um CAGR projetado de 18,05% durante 2027-2032. Em 7 de outubro de 2026, a RateGain Travel Technologies anunciou que a Vietnam Airlines havia selecionado sua plataforma de inteligência de tarifas AirGain. A cobertura anunciada incluía mais de 300 companhias aéreas, mais de 170 agências de viagens online e mais de 50 plataformas de metabusca. Essa amplitude mostra por que o monitoramento competitivo precisa de um quadro de observação que cubra tanto fornecedores diretos quanto intermediários, uma vez que os canais escolhidos definem o que o conjunto de dados representa. A decisão de cobertura relevante é quais canais de companhias aéreas e intermediários monitorar em conjunto, pois um feed exclusivo de operadoras abordaria uma questão de precificação mais restrita.
Análise Geográfica
Mercado de Web Scraping da América do Norte
A América do Norte representou uma participação de 33,94% no tamanho do mercado de web scraping em 2026. Os detalhes do programa de IPC de outubro de 2025 da Statistics Canada identificam o web scraping automatizado, os arquivos de transações de varejistas e a coleta manual online como fontes de preços não tradicionais. Um programa de fontes mistas incorpora a extração web em um sistema de medição existente, onde as comparações de preços dependem em parte do canal de coleta. Para o operador estatístico, uma série de preços automatizada deve se encaixar no mesmo ciclo de produção mensal que os arquivos de transações e as observações coletadas manualmente.
Mercado de Web Scraping da Ásia-Pacífico
A Ásia-Pacífico é a região de crescimento mais rápido, com um CAGR projetado de 18,35% durante 2027-2032. A agência nacional de estatísticas da Indonésia, por meio de sua unidade de estatísticas de distribuição e serviços, usou o web scraping em 2025 para coletar preços de diversas commodities em sites de marketplace. Em junho de 2026, o Australian Bureau of Statistics usa o web scraping para extrair informações de preços, produtos e outras informações de sites específicos para fins estatísticos. Para o IPC da Austrália, o ABS afirma que os dados obtidos por web scraping representam um aumento de 500 vezes nos preços coletados em comparação com a coleta manual. A migração da coleta de preços de visitas manuais para rotinas automatizadas expande as observações que um programa pode atualizar, aumentando as cargas de trabalho de extração nessas utilizações estatísticas.
Na América do Sul, a licitação de janeiro de 2026 da ChileCompra buscou captura massiva de preços e monitoramento recorrente, incluindo web scraping, para produtos em acordos-quadro governamentais. Na Europa, a Statistics Iceland coletou cerca de 490 preços de gasolina e diesel em sites de empresas às sextas-feiras durante cada semana de coleta mensal para seu Índice Harmonizado de Preços ao Consumidor de 2025. No Oriente Médio e África, um relatório do FMI de agosto de 2026 descreveu o progresso significativo do Kenya National Bureau of Statistics na estabilização da coleta por web scraping para um índice de preços de imóveis residenciais inédito, apesar dos desafios de qualidade de dados e robustez do modelo, especialmente fora de Nairóbi. No Oriente Médio, o Artigo 15 do Regulamento de Finanças Abertas dos Emirados Árabes Unidos restringe o scraping para atividades sujeitas a esse regulamento, exceto quando permitido pelas leis aplicáveis. O escopo local do produto e as condições de qualidade dos dados definem esses programas de preços, enquanto as atividades financeiras cobertas dos Emirados Árabes Unidos enfrentam um limite legal adicional.
Estrutura Regulatória e Perspectivas
A comparação abrange jurisdições selecionadas sob a perspectiva de fornecedores comerciais que coletam dados da web, incluindo dados pessoais quando seus serviços os envolvem. A atratividade da política reflete a clareza e o ônus operacional das regras de acesso e de dados pessoais comparadas para esse fornecedor. As obrigações dependem da atividade real do fornecedor, pois as estruturas estabelecem condições diferentes para métodos de acesso, coleta automatizada e tratamento de informações pessoais.
Tabela Regulatória
| Fator de decisão | Estados Unidos | Brasil | Alemanha | China |
|---|---|---|---|---|
| Autoridade principal | Serviço Secreto dos Estados Unidos, entre as agências investigativas autorizadas | Autoridade Nacional de Proteção de Dados (ANPD) | Autoridades estaduais (Länder) competentes de proteção de dados | Administração do Ciberespaço da China para coordenação, com outras autoridades competentes |
| Principais instrumentos ou diretrizes | Lei de Fraude e Abuso de Computadores, 18 U.S.C. § 1030 | LGPD, Artigos 3 e 7; orientação sobre agregadores em elaboração interna | GDPR Artigo 14; Lei Federal de Proteção de Dados § 40; proposta de Omnibus Digital | Regulamento de Gestão de Segurança de Dados de Rede, Artigo 18, em vigor desde 1º de janeiro de 2025 |
| Efeito comercial | O acesso intencional sem autorização ou além da autorização que obtém informações cobertas pode gerar exposição criminal | O processamento de dados pessoais coberto territorialmente necessita de uma base legal do Artigo 7 | Os controladores que obtêm dados pessoais indiretamente devem fornecer informações especificadas aos titulares dos dados, sujeito às exceções do Artigo 14 | Os processadores de dados de rede cobertos que usam acesso automatizado devem avaliar os efeitos no serviço; intrusão e interferência ilegais são proibidas |
| Atratividade atual da política | Médio | Médio | Médio | Baixo |
| Direção futura da atratividade da política | Sem alteração | Endurecimento | Flexibilização | Sem alteração |
| Fonte: Mordor Intelligence | ||||
Sob o teste de acesso baseado em conduta dos Estados Unidos, as condições de autorização de uma rota de coleta são uma consideração comercial contínua. No Brasil, o processamento de dados pessoais coberto territorialmente necessita de uma base legal do Artigo 7, enquanto a orientação da ANPD sobre agregadores permanecia em elaboração interna sem consulta pública em 20 de outubro de 2026. Os controladores alemães que obtêm dados pessoais indiretamente têm obrigações de informação do Artigo 14 com exceções, enquanto a proposta de simplificação do Omnibus Digital de novembro de 2025 permanecia no processo colegislativo em outubro de 2026. O dever de avaliação de acesso automatizado da China torna o efeito sobre os serviços de rede uma responsabilidade operacional para os processadores cobertos, apoiando a continuidade sob a regra em vigor desde 1º de janeiro de 2025.
Etapas da Cadeia de Valor
A cadeia de valor compara a configuração do crawler, a extração estruturada e o controle de qualidade necessário para entregar conjuntos de dados utilizáveis. A distinção comercial central é entre fornecer ferramentas de extração e aceitar responsabilidade pelos registros resultantes. Um fornecedor que abrange várias etapas pode conectar a receita de implementação ao trabalho de entrega contínua, mas também assume responsabilidade por falhas que cruzam essas etapas. Os fornecedores de ferramentas obtêm receita de software, enquanto os fornecedores que entregam conjuntos de dados verificados obtêm receita de serviços e assumem responsabilidade pela etapa de controle de qualidade.
Tabela de Análise da Cadeia de Valor
| Atividade primária | Principais participantes | Captura de valor | Gargalo | Resposta de resiliência |
|---|---|---|---|---|
| Configuração do crawler | Operadores de crawler gerenciados, como PromptCloud Technologies Pvt Ltd | Receita de serviço de extração gerenciada | Definição dos campos-alvo e do escopo de coleta | Acordar registros de amostra e limites de coleta antes de escalar |
| Extração e estruturação de páginas | Fornecedores de software de extração, como Bright Data Ltd., Zyte Group Ltd., Apify Technologies s.r.o. | Receita de software e API de extração | Manutenção de campos consistentes em variações de página | Testar a extração em tipos de página representativos e validar os campos necessários |
| Controle de qualidade e entrega de conjuntos de dados | Fornecedores de controle de qualidade e entrega, como PromptCloud Technologies Pvt Ltd; fornecedores de entrega gerenciada, como Zyte Group Ltd. | Receita de serviço de entrega de dados gerenciada | Detecção de registros incorretos antes da entrega | Combinar validação de registros com revisão de exceções direcionada |
| Fonte: Mordor Intelligence | ||||
A combinação de verificações de qualidade por aprendizado de máquina e humanas da PromptCloud Technologies Pvt Ltd ilustra uma responsabilidade de entrega que vai além da coleta do conteúdo da página. Essa responsabilidade dá aos fornecedores gerenciados uma base para capturar valor a partir da confiabilidade do conjunto de dados entregue. Uma maior automação deslocaria o teste comercial para a identificação econômica de exceções, pois uma coleta maior tem valor limitado quando registros inutilizáveis passam despercebidos.
Cenário Competitivo
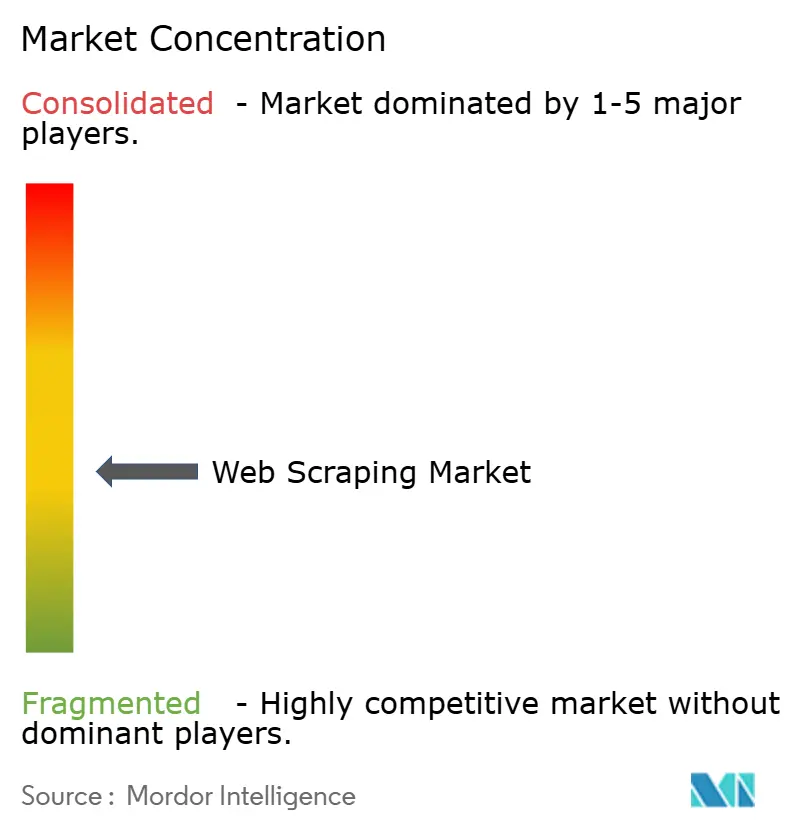
A concorrência é fragmentada entre plataformas integradas e fornecedores especializados, com a Bright Data Ltd. oferecendo ferramentas de scraping, conjuntos de dados e serviços gerenciados. A Zyte Group Ltd. fornece APIs e ferramentas para desenvolvedores, enquanto a Apify Technologies s.r.o. oferece uma plataforma em nuvem e serviços profissionais. A Octopus Data, Inc. fornece o Octoparse, e a Import.io Ltd., dentro da Neuralogics, combina extração self-service com entrega gerenciada de dados web. A Bright Data reportou atender 14 dos 20 maiores laboratórios de modelos de linguagem de grande porte (LLM) em 2025. O acesso a compradores de laboratórios de LLM cria uma posição comercial distinta dentro dessa base de fornecedores variada, ao lado da concorrência em formatos sobrepostos de software e serviços.
A Import.io Ltd. integrou o grupo Neuralogics em outubro de 2025, mantendo seu próprio nome, plataforma, clientes e equipes. A empresa está investindo em produtos nativos de IA sobre seu mecanismo de extração, colocando o desenvolvimento de produtos ao lado de sua oferta de extração estabelecida. A Zyte Group Ltd. descreveu seu Web Scraping Copilot em 2025 como um assistente de IA voltado para código, incorporado diretamente nos fluxos de trabalho dos desenvolvedores, uma abordagem que mantém os engenheiros no controle de seus próprios pipelines. A Import.io Ltd., por sua vez, adiciona produtos nativos de IA ao mecanismo de extração que seus clientes existentes já utilizam, de modo que ambos os fornecedores ampliam as rotinas atuais em vez de substituí-las.
A direção competitiva está se movendo em direção a uma extração que os agentes de IA podem solicitar dentro de seus próprios fluxos de trabalho. Em 30 de setembro de 2026, a Zyte Group Ltd. introduziu um servidor de Protocolo de Contexto de Modelo (MCP) hospedado que disponibiliza a API da Zyte e o Scrapy Cloud para agentes de IA e de codificação compatíveis. A API AgentTools da Octoparse guia os agentes pela descoberta de modelos, validação de parâmetros, extração em nuvem e exportação de dados, com a execução exigindo um modelo executável em nuvem compatível. Onde os testes territoriais da LGPD do Brasil se aplicam, o processamento de dados pessoais necessita de uma base legal do Artigo 7, enquanto os controladores alemães que obtêm dados pessoais indiretamente devem fornecer as informações especificadas no Artigo 14 do GDPR, sujeito às suas exceções. Os especialistas podem competir tornando uma tarefa de extração restrita executável por meio das interfaces de agente que seus compradores utilizam.
Líderes do Setor de Web Scraping
-
Bright Data Ltd.
-
Zyte Group Ltd.
-
Apify Technologies s.r.o.
-
Octopus Data, Inc.
-
Import.io Ltd.
- *Isenção de responsabilidade: Principais participantes classificados em nenhuma ordem específica
Mercado de Web Scraping Empresas cobertas neste relatório
- Bright Data Ltd.
- Zyte Group Ltd.
- Apify Technologies s.r.o.
- Octopus Data, Inc.
- Import.io Ltd.
- The Phantom Company SAS (PhantomBuster)
- Diffbot Technologies Corp.
- Mozenda, Inc.
- Sequentum Inc.
- ScrapeHero LLC
- ParseHub Inc.
- UAB Oxylabs
- DataWeave Pvt Ltd
- PromptCloud Technologies Pvt Ltd
- DATAANT Sp. z o.o. (ScrapingAnt)
- DataHen Inc.
- Actowiz Solutions LLC
- SysNucleus Software Pvt Ltd (product: WebHarvy)
- PilotFish Technology LLC
- Datopian Ltd.
- Newprosoft LLC
- UAB Data troops (Decodo)
- Datafiniti LLC
- Crawlbase LLC
- Bright Data Labs Ltd.
Principais Oportunidades para os Participantes do Mercado
A comparação de oportunidades concentra-se na coleta de dados de treinamento que melhora a cobertura e o controle sob acesso restrito. A Inria caracterizou os novos dados de treinamento públicos online como cada vez mais escassos em dezembro de 2025, enquanto a OECD.AI reportou mais de 50 processos judiciais de direitos autorais e proteção de dados em todo o mundo até 2025. A OECD.AI também reportou que os sites estavam usando cada vez mais barreiras técnicas e contratuais para impedir o scraping. Em conjunto, a escassez e as restrições de acesso favorecem os serviços de coleta que definem a cobertura utilizável e as condições de origem dos registros antes de expandir um corpus.
Tabela de Oportunidades de Mercado
| Oportunidade | Por que agora | Segmento comprador / principal | Estratégia recomendada | Principal barreira | Prováveis beneficiários |
|---|---|---|---|---|---|
| Corpora de treinamento específicos por vertical | Escassez de novos dados de treinamento públicos | Equipes de treinamento de IA e LLM | Definir uma vertical restrita e curar sua cobertura de fontes | Estabelecer a adequação do conjunto de dados para a vertical escolhida | Fornecedores de dados especializados, como Bright Data Ltd. |
| Coleta incremental de corpus | Necessidade de novo material de treinamento público | Equipes de modelos que expandem corpora existentes | Entregar lotes incrementais com datas de origem documentadas | Obter material genuinamente novo e utilizável | Fornecedores de pipelines de dados personalizados, como Bright Data Ltd. |
| Feeds de treinamento com registros de origem | Disputas legais e restrições de coleta | Desenvolvedores de modelos que avaliam as origens do corpus | Anexar origem, hora de coleta e condições de uso a cada lote | Barreiras de acesso técnicas e contratuais | Fornecedores de dados web, como Bright Data Ltd. |
| Fonte: Mordor Intelligence | |||||
O papel de sourcing específico por vertical e de pipeline personalizado da Bright Data Ltd. fornece um ponto de partida comercial para o trabalho com dados de treinamento. Estender esse papel para feeds incrementais ou feeds com registros de origem exigiria requisitos de entrega explícitos e uma base confirmada para coletar cada fonte. A abertura mais forte é transformar uma coleta definida de forma restrita em um arranjo de fornecimento repetível cujo escopo e origem permaneçam claros à medida que o corpus muda.
Desenvolvimentos industriais recentes em Mercado de Web Scraping
- Out 2026: A UAB Oxylabs introduziu a Web API, combinando pesquisa e scraping web com análise baseada em IA para dados web estruturados.
- Out 2026: A RateGain Travel Technologies Limited anunciou que a Vietnam Airlines selecionou o AirGain, sua plataforma de inteligência de precificação para companhias aéreas, para fortalecer a comparação de tarifas e a precificação competitiva.
- Set 2026: A Zyte Group Ltd. introduziu o Zyte MCP, trazendo acesso web em tempo real, extração estruturada e operações do Scrapy Cloud para agentes de codificação.
Mercado de Web Scraping Escopo do relatório e metodologia de pesquisa
Definição e Cobertura do Mercado
O mercado global de web scraping mede a receita anual de fornecedores proveniente de software comercial e serviços gerenciados que extraem programaticamente o conteúdo de páginas web públicas para organizações pagantes em setores e casos de uso diversos. Abrange vendas de licenças de software e assinaturas e taxas de serviço de ofertas em nuvem e locais em todo o mundo.
Exclusões de escopo: Scripts internos de uso próprio executados exclusivamente dentro de uma empresa, serviços autônomos de proxy ou rotação de IP, e ferramentas gerais de análise web ou SEO que não extraem programaticamente o conteúdo de páginas web públicas estão excluídos.
Visão Geral da Segmentação
- Por Solução
- Software
- Serviços
- Por Modo de Implantação
- Nuvem
- Local
- Por Setor do Usuário Final
- BFSI
- Varejo e Comércio Eletrônico
- Imóveis
- Manufatura
- Governo
- Saúde
- Publicidade e Mídia
- Outros
- Por Caso de Uso
- Extração de Dados / ETL
- Monitoramento de Preços e Concorrência
- Geração de Leads e Inteligência de Vendas
- Dados Financeiros Alternativos
- Análise de Sentimento e Redes Sociais
- Por Geografia
- América do Norte
- Estados Unidos
- Canadá
- México
- América do Sul
- Brasil
- Argentina
- Restante da América do Sul
- Europa
- Alemanha
- Reino Unido
- França
- Itália
- Espanha
- Rússia
- Restante da Europa
- Ásia-Pacífico
- China
- Japão
- Índia
- Coreia do Sul
- Austrália e Nova Zelândia
- Restante da Ásia-Pacífico
- Oriente Médio e África
- Oriente Médio
- Arábia Saudita
- Emirados Árabes Unidos
- Turquia
- Restante do Oriente Médio
- África
- África do Sul
- Nigéria
- Quênia
- Restante da África
- Oriente Médio
- América do Norte
Fontes de Dados, Dimensionamento de Mercado e Validação
Pesquisa Documental
A pesquisa documental baseia-se em fontes como as Vendas Trimestrais de Comércio Eletrônico no Varejo do U.S. Census Bureau para o contexto do varejo online, o aviso da plataforma de desenvolvedores do Reddit sobre as mudanças nas condições de acesso público, o estudo arXiv sobre extração web com restrições de esquema para questões de desempenho técnico e o relatório State of Web Scraping da Apify Technologies s.r.o. para as condições operacionais relatadas pelos profissionais. Essas fontes ajudam a enquadrar os casos de uso de demanda, as condições de acesso, as necessidades de qualidade de dados e os custos de extração sem tratar indicadores adjacentes como receita de mercado.
Os registros e materiais de investidores das empresas ajudam a identificar os modelos de receita dos fornecedores e os limites dos produtos, enquanto os contratos públicos adjudicados e a imprensa tecnológica e empresarial de reputação podem esclarecer se uma transação cobre software, dados entregues ou ambos. Os totais de mercado são verificados em relação à sua base de receita declarada, geografia, período e inclusões. Essas fontes nomeadas são ilustrativas e não exaustivas, e outras fontes informam a coleta, a validação e o esclarecimento.
Entrevistas e Pesquisas Primárias
O design da pesquisa utiliza entrevistas estruturadas ou pesquisas com fornecedores de software de web scraping, provedores de extração gerenciada e compradores organizacionais em finanças, varejo, mídia, manufatura e casos de uso do setor público na APAC, EMEA e nas Américas. Respondentes com responsabilidades de produto, comercial, entrega, aquisição e operações de dados podem esclarecer os limites de receita, as compras em nuvem versus locais, o uso pelos clientes e as mudanças na carga de trabalho de extração. As perguntas dos analistas testam as interpretações de fontes secundárias e investigam lacunas na receita dos fornecedores, no agrupamento de serviços, na alocação geográfica e na adoção, e os relatos são triangulados entre evidências de fornecedores, compradores e públicas antes de as premissas serem mantidas.
Distribuição dos respondentes do trabalho de campo da pesquisa primária
| Tipo de empresa | Cargo do respondente | Região |
|---|---|---|
| Nível superior: 35% | CEOs e diretores: 20% | APAC: 38% |
| Nível médio: 45% | Líderes funcionais/de unidade: 35% | EMEA: 32% |
| Participantes menores: 20% | Gerentes: 45% | Américas: 30% |
Dimensionamento de Mercado e Previsão
O modelo estima a receita anual global dos fornecedores de software comercial de web scraping e serviços de extração gerenciada, alocando esse total entre solução, implantação, setor do usuário final, caso de uso e geografia do cliente. Uma estimativa de cima para baixo parte de divulgações de receita e estimativas de nível de mercado, ajustadas à venda definida de licenças, assinaturas e serviços de extração. Verificações seletivas de baixo para cima comparam os totais de receita dos fornecedores e os preços de contratos ou serviços amostrados multiplicados pelos volumes estimados de clientes, com lacunas registradas e reconciliadas em vez de tratadas como um censo completo. Os principais indicadores incluem receita e mix de produtos dos fornecedores, divulgações de clientes e contratos, adoção em nuvem versus local, atividade de varejo online e marketplace, e demanda de finanças ou mídia por dados alternativos. Cada um informa o envelope geral de receita, as participações de segmento ou os impulsionadores de previsão. Uma regressão multivariada pode relacionar a série anual de receita a esses indicadores onde existe um histórico consistente, enquanto a análise de cenários lida com descontinuidades como restrições de acesso, mudanças legais ou novas capacidades de extração automatizada. As observações ausentes usam interpolação documentada ou premissas limitadas. As participações de segmento são construídas a partir de divisões reportadas, evidências de uso pelos clientes, descrições de produtos e alocação de compradores entre setores e aplicações, com o resíduo atribuído somente após as categorias suportadas serem avaliadas. Especialistas primários podem verificar a razoabilidade dos caminhos de crescimento em nível de variável e as mudanças no mix de soluções, e as diferenças não resolvidas entre as verificações dos fornecedores e o total de cima para baixo são revisitadas por meio de verificações de fonte e limite.
Ciclo de Validação e Atualização de Dados
Os analistas triangulam as divulgações dos fornecedores, as evidências do lado comprador, os contratos públicos e os sinais de mercado independentes, verificando então os totais, as participações, as taxas de crescimento e as revisões históricas em busca de anomalias ou variações materiais. Uma revisão em múltiplas etapas confirma as datas e definições das fontes, testa se os valores discrepantes refletem mudanças reais ou limites inconsistentes e resolve os problemas antes da aprovação final. O recontato é acionado quando uma resposta material conflita com evidências publicadas ou deixa a propriedade da receita, o agrupamento ou a geografia pouco claros. O conjunto de dados é atualizado anualmente, revisado entre ciclos para eventos materiais de mercado e submetido a uma nova revisão pré-entrega de fontes, cálculos e consistência narrativa.
Tamanho do Mercado de Web Scraping da Mordor Intelligence em Comparação com Outras Estimativas Publicadas
As estimativas publicadas podem diferir nas transações e produtos que contabilizam e nos insumos usados para modelar a demanda. O mercado global de web scraping mede a receita anual de fornecedores proveniente de software comercial e serviços gerenciados que extraem programaticamente o conteúdo de páginas web públicas para organizações pagantes em setores e casos de uso diversos.
Os principais fatores de divergência incluem a cobertura definida do estudo e as escolhas de modelagem específicas do mercado. Os principais indicadores incluem receita e mix de produtos dos fornecedores, divulgações de clientes e contratos, adoção em nuvem versus local, atividade de varejo online e marketplace, e demanda de finanças ou mídia por dados alternativos.
Comparação de referência
| Fonte | Tamanho do Mercado | Lacunas na Metodologia de Pesquisa |
|---|---|---|
| Mordor Intelligence | 1,83 bilhões de USD (2027) | |
| Consultoria Global A | 990 milhões de USD (2025) | Em sua base de 2025, esta estimativa está 45,9% abaixo do valor de 2027 deste relatório de 1,83 bilhões de USD, 2 anos depois. O ano-base anterior posiciona a estimativa antes do crescimento subsequente do mercado. |
| Consultoria Global B | 909,9 milhões de USD (2024) | Em sua base de 2024, esta estimativa está 50,3% abaixo do valor de 2027 deste relatório de 1,83 bilhões de USD, 3 anos depois. A cobertura exclusiva de software exclui os serviços de extração gerenciada, e seu ano-base antecede o crescimento subsequente do mercado. |
Os analistas da Mordor Intelligence triangulam as divulgações dos fornecedores, as evidências do lado comprador, os contratos públicos e os sinais de mercado independentes, verificando então os totais, as participações, as taxas de crescimento e as revisões históricas em busca de anomalias ou variações materiais.
Principais Perguntas Respondidas no Relatório
Qual é o tamanho do mercado de web scraping e a previsão de crescimento?
O tamanho é estimado em 1,83 bilhões de USD em 2027 e projetado para atingir 4,03 bilhões de USD até 2032, a um CAGR de 17,08% durante 2027-2032.
O que impulsiona a demanda por software e serviços de web scraping?
A expansão do varejo online nos EUA e o desenvolvimento de spiders assistido por IA sustentam a demanda. Em uma pesquisa de 2025 com 56 empresas do lado comprador nos Estados Unidos, no Reino Unido e na Europa, 63% planejavam aumentar os gastos com dados alternativos.
Qual solução lidera a receita do web scraping comercial?
O software representou 57,93% da receita em 2026, enquanto os serviços têm projeção de crescer a um CAGR de 18,35% durante 2027-2032.
Quais empresas são os principais fornecedores de software e serviços de web scraping?
Os principais fornecedores incluem Bright Data Ltd., Zyte Group Ltd., Apify Technologies s.r.o., Octopus Data, Inc. e Import.io Ltd., que opera dentro da Neuralogics.
Quais desafios moldam as perspectivas para o web scraping comercial?
Em uma pesquisa de dezembro de 2025, 88,7% dos entrevistados relataram custos mais elevados ao direcionar sites protegidos por antibot. Para os profissionais de scraping, essa pressão de custo pode restringir a cobertura de sites protegidos e a frequência de atualização.
Qual região lidera o setor de web scraping comercial e onde o crescimento é mais rápido?
A América do Norte detinha 33,94% da receita em 2026, enquanto a Ásia-Pacífico tem previsão de crescer mais rapidamente, a um CAGR de 18,35% durante 2027-2032.