
Taille et part du marché du web scraping
Analyse du marché du web scraping par Mordor Intelligence
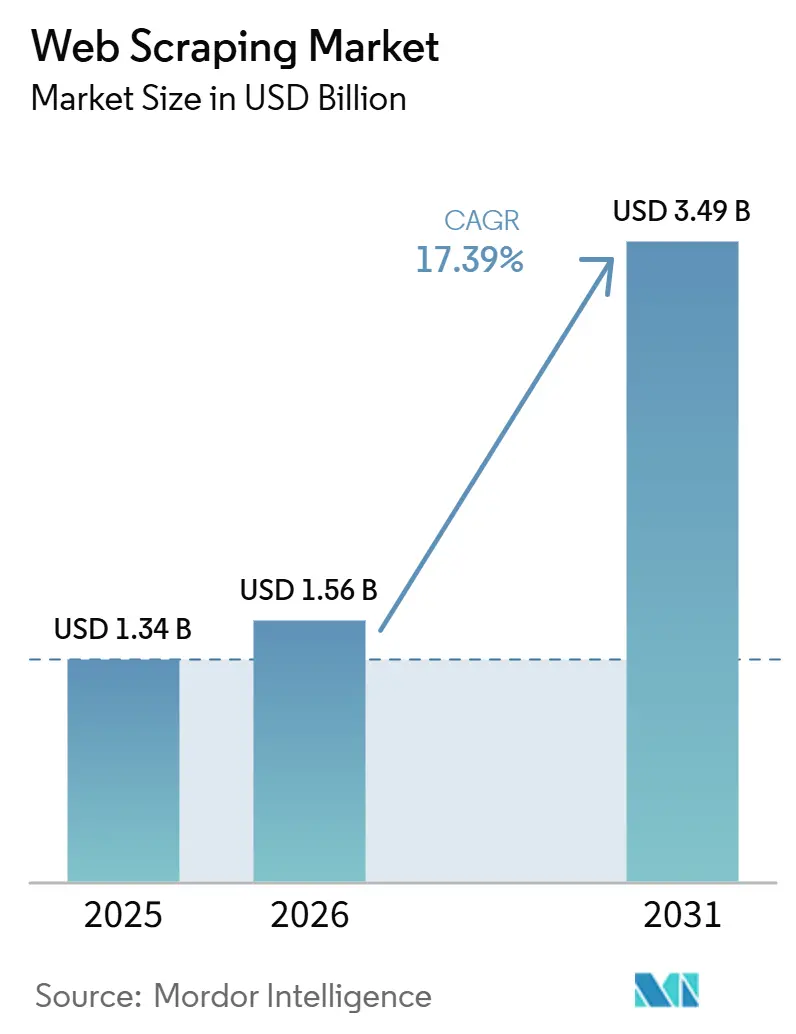
La taille du marché du web scraping était évaluée à 1,56 milliard USD en 2026 et devrait croître de 1,83 milliard USD en 2027 pour atteindre 4,03 milliards USD d'ici 2032, à un CAGR de 17,08 % durant la période de prévision (2027-2032).
La croissance du commerce en ligne aux États-Unis et l'utilisation de données issues du web par les sociétés d'investissement soutiennent une demande récurrente de collecte. L'extraction assistée par IA produit des enregistrements contraints par schéma, offrant aux équipes des champs de sortie définis à vérifier avant l'analyse. L'accès restreint aux plateformes accroît également la valeur de la validation de ce que chaque voie de collecte récupère. Les fournisseurs choisissent entre la vente de logiciels réutilisables et la livraison de jeux de données finalisés, assumant la responsabilité de différentes parties de la collecte. Les coûts liés aux sites protégés et les restrictions légales limitent l'étendue de la collecte et la pérennité de la livraison de ces services.
Points clés du rapport
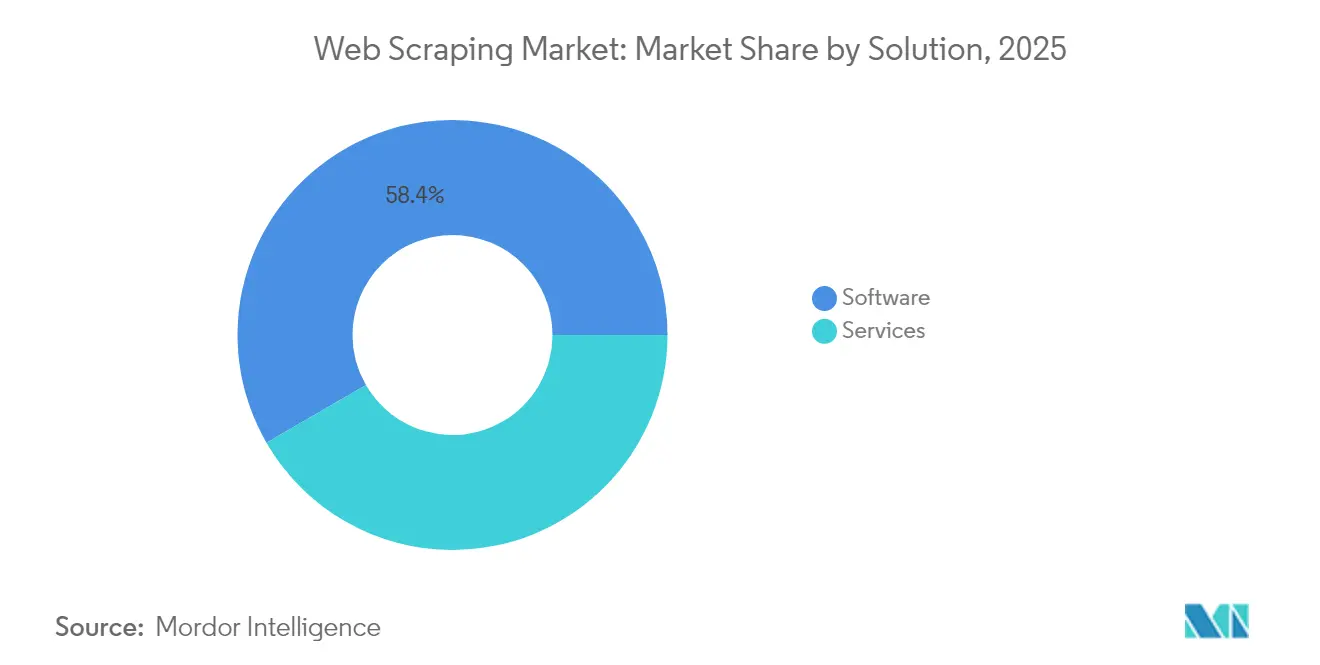
- Parmi les solutions, les logiciels détenaient une part de marché du web scraping de 57,93 % en 2026, tandis que les services devraient connaître la croissance la plus rapide avec un CAGR de 18,35 % durant 2027-2032.
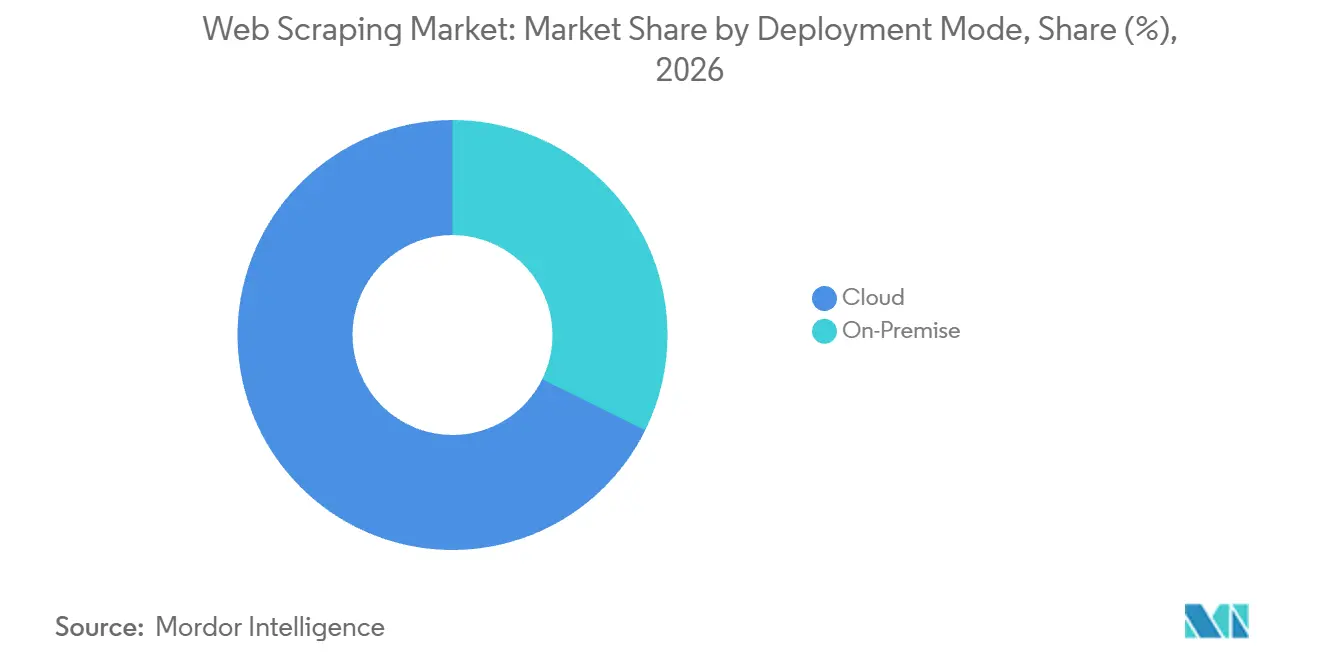
- Le déploiement cloud représentait une part de 67,7 % de la taille du marché du web scraping en 2026 et devrait connaître la croissance la plus rapide avec un CAGR de 17,52 % durant 2027-2032.
- Parmi les secteurs d'utilisateurs finaux, le BFSI était en tête avec 29,39 % des revenus en 2026, tandis que le segment publicité et médias devrait connaître la croissance la plus rapide avec un CAGR de 18,5 % durant 2027-2032.
- Par cas d'utilisation, l'extraction de données / ETL était en tête avec 35,89 % des revenus en 2026, la surveillance des prix et de la concurrence devant connaître la croissance la plus rapide avec un CAGR de 18,05 % durant 2027-2032.
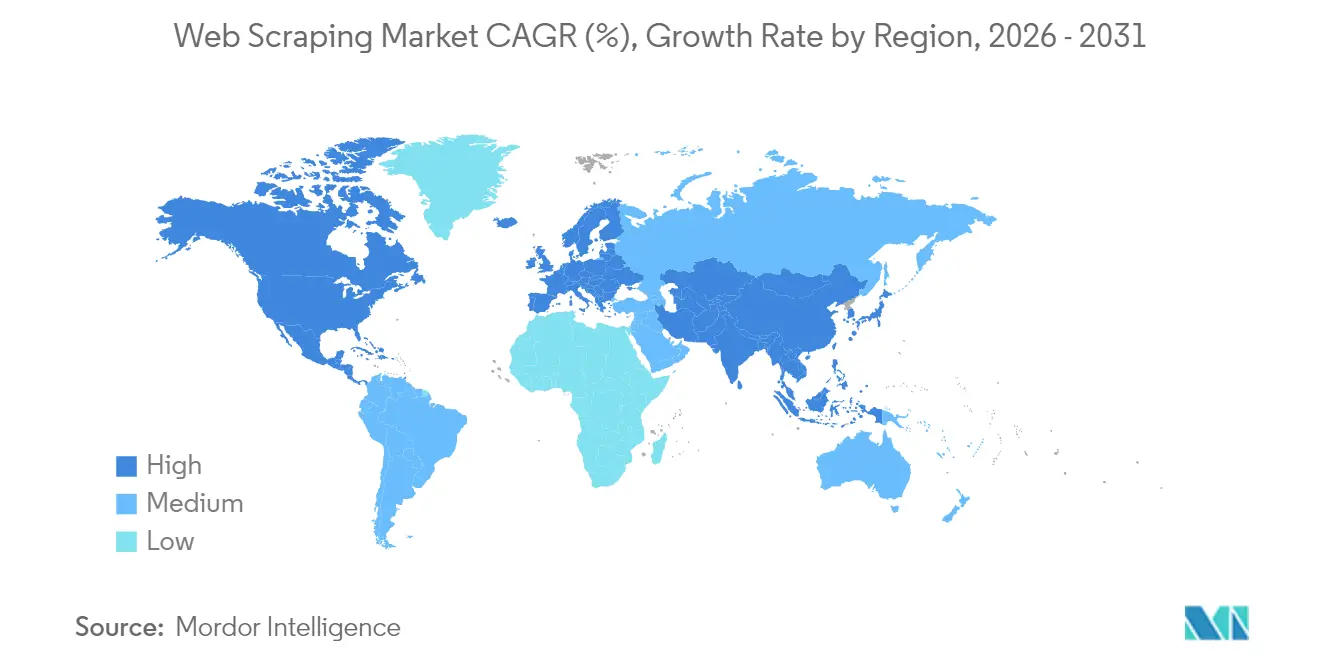
- Géographiquement, l'Amérique du Nord détenait 33,94 % des revenus en 2026, tandis que l'Asie-Pacifique devrait connaître la croissance la plus rapide avec un CAGR de 18,35 % durant 2027-2032.
Remarque : Les chiffres du marché présentés dans ce rapport reposent sur le cadre d'estimation exclusif de Mordor Intelligence, qui combine neuf mois de données réelles avec les projections du quatrième trimestre pour l'année de référence 2026.
Tendances et Analyses du Marché
Analyse de l'impact des moteurs*
| Moteur | (~) % d'impact sur les prévisions de CAGR | Pertinence géographique | Horizon temporel de l'impact |
|---|---|---|---|
| Croissance du e-commerce et des places de marché en ligne | +5.1% | Amérique du Nord et Asie-Pacifique | Court terme (≤ 2 ans) |
| Avancées de l'IA/ML pour l'extraction de données | +4.6% | Amérique du Nord, Europe et Asie-Pacifique | Court terme (≤ 2 ans) |
| Demande croissante de données alternatives dans le secteur financier | +4.1% | Amérique du Nord et Europe | Moyen terme (2-4 ans) |
| Dépréciation des API sur les grandes plateformes favorisant le scraping | +3.6% | États-Unis et Europe | Court terme (≤ 2 ans) |
| Besoins en données d'entraînement pour l'IA générative | +3.2% | Amérique du Nord et Asie-Pacifique | Long terme (≥ 4 ans) |
| Mandats de données ouvertes révélant des lacunes en matière de données | +1.8% | Allemagne, France et Espagne | Moyen terme (2-4 ans) |
| Source: Mordor Intelligence | |||
Croissance du e-commerce et des places de marché en ligne
Un flux plus important de ventes en ligne accroît la valeur commerciale de l'observation des prix et de la disponibilité sur les vitrines numériques. Les ventes de e-commerce de détail aux États-Unis, corrigées des variations saisonnières, ont atteint 340,2 milliards USD au deuxième trimestre 2026, en hausse de 12,2 % (±0,9 %) par rapport au deuxième trimestre 2025, sans ajustement pour les variations de prix. Les ventes totales de détail aux États-Unis ont augmenté de 6,7 % (±0,5 %) sur la même période, de sorte que les observations de prix en ligne concernent un canal gagnant en poids dans les ventes. Pour les détaillants suivant un ensemble de produits récurrents, la tâche de collecte consiste à distinguer les variations de prix des changements d'assortiment. La comparaison de produits identiques entre les cycles de collecte peut fonder le prochain ajustement d'offre sur la révision tarifaire d'un concurrent plutôt que sur une variation de prix apparente causée par un mix produit différent.
Avancées de l'IA/ML pour l'extraction de données
Le développement de robots d'exploration assisté par IA peut élargir la gamme de sites cibles qu'une équipe de collecte peut se permettre de maintenir. Au cours du deuxième et troisième trimestre 2025, ScrapeGraphAI a collecté environ 9 millions d'événements de télémétrie opt-in issus de l'utilisation en production de sa bibliothèque open source d'extraction web. Les chercheurs ont dédupliqué et équilibré ces événements bruts par schéma pour constituer un jeu de données publié de 93 695 événements d'extraction. En mars 2026, Zyte a rendu généralement disponible Web Scraping Copilot 1.0, une extension Visual Studio Code qui utilise l'IA pour générer, tester et déployer des robots Scrapy. L'intégration de ces tâches dans l'éditeur du développeur peut réduire l'effort d'ingénierie par site cible et élargir la portée économiquement viable du programme Scrapy d'une équipe.
Demande croissante de données alternatives dans le secteur financier
Dans une enquête menée en septembre-octobre 2025 auprès de 56 sociétés côté acheteur aux États-Unis, au Royaume-Uni et en Europe, Crisil Coalition Greenwich a constaté que 63 % des investisseurs prévoyaient d'augmenter leurs dépenses en données alternatives. Dans une communication de mars 2026, AQR a indiqué que son conseiller utilise des données alternatives pour gérer certains fonds, notamment des données sur le comportement des consommateurs, le sentiment des médias sociaux, ainsi que les données de recherche et de trafic internet. Cette communication avertissait que l'infrastructure informatique souvent moins robuste des fournisseurs peut entraîner la suspension, le retard ou l'indisponibilité des jeux de données. Les intentions de dépenses élargissent l'opportunité potentielle pour les fournisseurs de données alternatives, tandis que l'avertissement d'AQR concernant d'éventuelles interruptions souligne l'importance de la continuité de l'approvisionnement. Pour les équipes d'investissement, une interruption d'un fournisseur peut supprimer une entrée de modèle lors de la prochaine mise à jour. La continuité de l'approvisionnement peut alors distinguer des fournisseurs de données par ailleurs appropriés.
Dépréciation des API sur les grandes plateformes favorisant le scraping
Dans des entretiens menés d'octobre 2024 à février 2025, des chercheurs en médias sociaux ont décrit le web scraping comme une alternative aux API de plateformes et ont soulevé des préoccupations juridiques, éthiques et de fiabilité. Reddit a annoncé le 5 août 2026 qu'il restreindrait progressivement les nouvelles demandes d'API publiques.[1] Reddit prévoit également de commencer à supprimer l'accès à l'API de données pour les applications et utilisateurs non enregistrés ou inactifs le 12 janvier 2027, et de mettre fin à l'accès restant à l'API publique en mars 2027. Une étude TikTok de 2026 a révélé que les outils de scraping via API et via l'interface frontale récupéraient du contenu avec des périodes temporelles et des niveaux de popularité différents. Pour les acheteurs confrontés à un accès restreint, ces différences rendent une voie de collecte alternative commercialement utile uniquement lorsque ses résultats correspondent à l'analyse prévue. Le plan de Reddit de mettre fin à l'accès restant à l'API publique en mars 2027 donne aux équipes qui dépendent actuellement des extractions via API une date fixe à laquelle toute voie de remplacement doit avoir sa couverture vérifiée.
Analyse de l'impact des freins*
| Frein | (~) % d'impact sur la prévision du CAGR | Pertinence géographique | Horizon temporel de l'impact |
|---|---|---|---|
| Incertitude juridique et éthique | -2.2% | États-Unis et Chine | Moyen terme (2-4 ans) |
| Coûts élevés et complexité technique | -1.6% | États-Unis et Royaume-Uni | Court terme (≤ 2 ans) |
| Les outils avancés de lutte contre les robots augmentent les taux d'échec | -1% | États-Unis et Royaume-Uni | Court terme (≤ 2 ans) |
| Les API officielles cannibalisent certains cas d'utilisation du scraping | -0.5% | Amérique du Nord et Europe | Moyen terme (2-4 ans) |
| Source: Mordor Intelligence | |||
Incertitude juridique et éthique
Un jeu de données peut perdre son utilité commerciale lorsque sa méthode d'acquisition crée une obligation de suppression. En juillet 2025, LinkedIn a indiqué que sa résolution exigeait que Proxycurl supprime définitivement les données LinkedIn obtenues par des moyens non autorisés et cesse d'accéder à LinkedIn de manière illicite. LinkedIn a décrit l'affaire comme impliquant un scraping non autorisé utilisant de faux comptes et d'autres activités frauduleuses. Pour un acheteur, une restriction comparable perturberait les flux de travail dépendant des enregistrements concernés. La même résolution a interdit à Proxycurl tout accès illicite ultérieur à LinkedIn, de sorte que la voie ayant produit les enregistrements supprimés ne pouvait pas être utilisée pour les reconstituer.
Coûts élevés et complexité technique
Les sites web protégés créent un seuil de coût qui peut limiter la portée économique d'un programme de scraping. Dans une enquête de décembre 2025, 88,7 % des répondants ont signalé une augmentation des coûts lors du ciblage de sites web protégés par des mesures anti-robots.[2] Pour les praticiens du scraping, des coûts de collecte plus élevés augmentent les ressources nécessaires pour ajouter des cibles protégées à un programme. Cette charge accroît les dépenses liées à l'ajout de chaque cible protégée à un programme, ce qui peut limiter le nombre de telles cibles qu'une équipe prend en charge. Une couverture plus large ou une collecte plus fréquente doit absorber la pression sur les coûts signalée.
*Nos prévisions considèrent les impacts des moteurs et des contraintes comme directionnels et non additifs. Les prévisions d'impact reflètent la croissance de référence, les effets de composition et les interactions entre variables.
Analyse des segments
Par solution :
les logiciels réutilisables en tête tandis que les services de données se développentLes logiciels représentaient une part de 57,93 % de la taille du marché du web scraping en 2026. Apify fait état d'une base de clients mondiale de 91 000 pour sa plateforme de web scraping et d'automatisation de navigateur. Avec une plateforme logicielle, un acheteur peut conserver la logique d'extraction qu'il configure et l'appliquer à des cycles de collecte successifs. La collecte répétée tire sa valeur économique du code réutilisable et de la configuration des flux de travail, car elle s'appuie sur une implémentation existante. La plateforme peut évoluer grâce à une infrastructure d'exécution partagée tout en préservant les routines spécifiques aux clients.
Les services constituent le segment à la croissance la plus rapide, avec un CAGR projeté de 18,35 % durant 2027-2032. Le 1er décembre 2025, Statistique Canada a attribué à Mobius365 Knowledge Services, Inc. un contrat pour des données issues du web scraping de sites web canadiens.[3] Le contrat couvrait des fins statistiques et de recherche du 1er avril 2026 au 31 mars 2027, avec 4 options de prolongation d'un an. L'agence a précisé qu'elle acquérait des données, maintenant le contrat axé sur les informations livrées plutôt que sur un logiciel ou une licence SaaS. La valeur potentielle de renouvellement dépend des performances sur le jeu de données demandé dans le cadre d'une obligation continue de fourniture de données.

Par mode de déploiement :
l'échelle du cloud face au contrôle de l'opérateurLe cloud représentait une part de marché du web scraping de 67,7 % en 2026 et constitue le segment à la croissance la plus rapide, avec un CAGR de 17,52 % durant 2027-2032. Apify exploite sa plateforme de web scraping, d'extraction de données et d'automatisation dans le cloud via des programmes sans serveur appelés Actors. La société indique traiter plus d'un pétaoctet de données mensuellement sur cette plateforme. L'exécution gérée par le fournisseur peut convenir à un acheteur dont la demande de collecte varie d'un cycle à l'autre, car la capacité peut être envisagée indépendamment de la définition des enregistrements demandés. Le cloud concentre l'obligation de capacité auprès du fournisseur de plateforme, de sorte qu'un acheteur peut effectuer des collectes à grand volume sans provisionner chaque environnement séparément.
Le déploiement sur site place l'environnement de collecte sous le contrôle direct de l'opérateur, intégrant la configuration et la maintenance dans le même périmètre organisationnel. Pour une organisation qui a besoin que les enregistrements collectés et les journaux d'extraction restent sur son propre réseau, l'exécution locale aligne le robot d'exploration sur cette exigence interne. L'organisation doit alors assurer en interne l'exploitation du robot, la configuration des proxys et les réparations d'analyse dans le cadre du programme de collecte. Une modification de la mise en page d'une page peut mobiliser le temps de cette équipe même lorsque les champs de données souhaités restent identiques. L'argument en faveur du maintien de l'exécution locale repose sur cette exigence interne de traitement des données, la maintenance des analyseurs étant traitée comme un coût continu pour y répondre.
Par secteur d'utilisateur final :
les flux de travail d'investissement et l'intelligence publicitaire façonnent la demandeLe BFSI était le segment le plus important, représentant 29,39 % des revenus du marché en 2026. L'enquête 2025 de Lowenstein Sandler portait sur des répondants issus de sociétés de capital-investissement, de gestionnaires de fonds spéculatifs et de sociétés de capital-risque. Elle a identifié le web scraping parmi les sources de données utilisées dans les systèmes d'IA personnalisés pour la recherche en investissement, l'optimisation de portefeuille ou le trading. Pour ces acheteurs, l'extraction fournit des entrées potentielles pour les modèles, tandis que la recherche en investissement, l'optimisation de portefeuille et le trading impliquent des décisions différentes quant à la manière dont ces entrées doivent être utilisées. L'adaptation des variables livrées à une tâche d'investissement spécifique donne à un fournisseur d'extraction une base claire pour le travail d'intégration au sein du modèle qui utilise ces enregistrements.
Le segment publicité et médias est le segment à la croissance la plus rapide, avec un CAGR projeté de 18,5 % durant 2027-2032. Adbeat explore 1,3 million de pages et détecte, analyse et traite 3,8 millions de publicités quotidiennement. Un traitement quotidien à cette échelle montre comment l'intelligence publicitaire crée des charges de travail récurrentes de récupération de pages et de traitement des publicités. Pour les annonceurs comparant les campagnes de leurs concurrents, la collecte du même ensemble d'éditeurs sur des jours successifs peut distinguer les nouveaux placements des observations antérieures. L'opportunité commerciale réside dans le maintien de cet historique de campagnes, de sorte que la fréquence de collecte importe autant que le nombre de pages couvertes.
Par cas d'utilisation :
des pipelines reproductibles soutiennent la visibilité concurrentielleL'extraction de données / ETL était le segment le plus important, représentant 35,89 % des revenus du marché en 2026. Ce cas d'utilisation transforme les pages web en enregistrements structurés pouvant transiter par des étapes d'extraction, de transformation et de chargement. Son rôle économique est horizontal, car la même infrastructure de collecte peut alimenter plusieurs analyses en aval sans prescrire une décision unique. Pour un acheteur combinant plusieurs sources web, le choix de conception critique est de déterminer où standardiser les enregistrements avant de les transmettre à d'autres systèmes. À ce point de transfert, un fournisseur d'extraction peut vendre des entrées fiables indépendamment du logiciel d'analyse en aval.
La surveillance des prix et de la concurrence est le segment à la croissance la plus rapide, avec un CAGR projeté de 18,05 % durant 2027-2032. Le 7 octobre 2026, RateGain Travel Technologies a annoncé que Vietnam Airlines avait sélectionné sa plateforme d'intelligence tarifaire AirGain. La couverture annoncée comprenait plus de 300 compagnies aériennes, plus de 170 agences de voyage en ligne et plus de 50 plateformes de métarecherche. Cette étendue montre pourquoi la surveillance concurrentielle nécessite un cadre d'observation couvrant à la fois les fournisseurs directs et les intermédiaires, car les canaux choisis définissent ce que le jeu de données représente. La décision de couverture pertinente est de déterminer quels canaux de compagnies aériennes et d'intermédiaires surveiller ensemble, car un flux limité aux seules compagnies aériennes répondrait à une question tarifaire plus restreinte.
Analyse géographique
Marché du Web Scraping en Amérique du Nord
L'Amérique du Nord représentait une part de 33,94 % de la taille du marché du web scraping en 2026. Les détails du programme IPC d'octobre 2025 de Statistique Canada identifient le web scraping automatisé, les fichiers de transactions des détaillants et la collecte manuelle en ligne comme des sources de prix non traditionnelles. Un programme à sources mixtes intègre l'extraction web dans un système de mesure existant, où les comparaisons de prix dépendent en partie du canal de collecte. Pour l'opérateur statistique, une série de prix automatisée doit s'inscrire dans le même cycle de production mensuel que les fichiers de transactions et les observations collectées manuellement.
Marché du web scraping en Asie-Pacifique
L'Asie-Pacifique est la région à la croissance la plus rapide, avec un CAGR projeté de 18,35 % durant 2027-2032. L'agence nationale de statistiques d'Indonésie, par l'intermédiaire de son unité de statistiques de la distribution et des services, a utilisé le web scraping en 2025 pour collecter des prix de plusieurs produits sur des sites de places de marché. En juin 2026, le Bureau australien des statistiques utilise le web scraping pour extraire des informations sur les prix, les produits et d'autres données de sites web spécifiques à des fins statistiques. Pour l'IPC australien, le Bureau australien des statistiques indique que les données issues du web scraping représentent une augmentation de 500 fois du nombre de prix collectés par rapport à la collecte manuelle. Le passage de la collecte manuelle des prix à des routines automatisées élargit les observations qu'un programme peut actualiser, augmentant les charges de travail d'extraction dans ces usages statistiques.
En Amérique du Sud, l'appel d'offres de janvier 2026 de ChileCompra portait sur la capture de prix en masse et la surveillance récurrente, incluant le web scraping, pour des produits dans les accords-cadres gouvernementaux. En Europe, Statistiques Islande a extrait environ 490 prix d'essence et de diesel à partir de sites web d'entreprises le vendredi de chaque semaine de collecte mensuelle pour son Indice harmonisé des prix à la consommation 2025. Au Moyen-Orient et en Afrique, un rapport du FMI d'août 2026 décrivait les progrès significatifs du Bureau national des statistiques du Kenya dans la stabilisation de la collecte par web scraping pour un premier indice des prix de l'immobilier résidentiel, malgré des défis liés à la qualité des données et à la robustesse des modèles, notamment en dehors de Nairobi. Au Moyen-Orient, l'article 15 du règlement sur la finance ouverte des Émirats arabes unis restreint le scraping pour les activités soumises à ce règlement, sauf autorisation en vertu des lois applicables. La portée locale des produits et les conditions de qualité des données définissent ces programmes de prix, tandis que les activités financières couvertes aux Émirats arabes unis font face à une limite juridique supplémentaire.
Cadre réglementaire et perspectives
La comparaison couvre certaines juridictions du point de vue des fournisseurs commerciaux collectant des données web, y compris des données personnelles lorsque leurs services l'impliquent. L'attractivité des politiques reflète la clarté et la charge opérationnelle des règles d'accès et de protection des données personnelles comparées pour ce fournisseur. Les obligations dépendent de l'activité réelle du fournisseur, car les cadres établissent des conditions différentes pour les méthodes d'accès, la collecte automatisée et le traitement des informations personnelles.
Tableau réglementaire
| Facteur de décision | États-Unis | Brésil | Allemagne | Chine |
|---|---|---|---|---|
| Autorité principale | Service secret des États-Unis, parmi les agences d'enquête autorisées | Autorité nationale de protection des données (ANPD) | Autorités compétentes de protection des données des États fédérés (Länder) | Administration du cyberespace de Chine pour la coordination, avec d'autres autorités compétentes |
| Instruments ou orientations clés | Computer Fraud and Abuse Act, 18 U.S.C. § 1030 | LGPD, articles 3 et 7 ; orientations sur les agrégateurs en rédaction interne | RGPD article 14 ; Loi fédérale sur la protection des données § 40 ; proposition d'Omnibus numérique | Règlement sur la gestion de la sécurité des données de réseau, article 18, en vigueur le 1er janvier 2025 |
| Effet commercial | L'accès intentionnel sans autorisation ou au-delà de l'autorisation permettant d'obtenir des informations couvertes peut entraîner une exposition pénale | Le traitement de données personnelles couvert territorialement nécessite une base juridique au titre de l'article 7 | Les responsables du traitement obtenant des données personnelles indirectement doivent fournir des informations spécifiées aux personnes concernées, sous réserve des exceptions de l'article 14 | Les processeurs de données de réseau couverts utilisant un accès automatisé doivent évaluer les effets sur les services ; l'intrusion et l'interférence illicites sont interdites |
| Attractivité actuelle des politiques | Moyen | Moyen | Moyen | Faible |
| Orientation future de l'attractivité des politiques | Sans changement | Durcissement | Assouplissement | Sans changement |
| Source: Mordor Intelligence | ||||
En vertu du test d'accès basé sur la conduite aux États-Unis, les conditions d'autorisation d'une voie de collecte constituent une considération commerciale continue. Au Brésil, le traitement de données personnelles couvert territorialement nécessite une base juridique au titre de l'article 7, tandis que les orientations de l'ANPD sur les agrégateurs restaient en rédaction interne sans consultation publique au 20 octobre 2026. Les responsables du traitement allemands obtenant des données personnelles indirectement sont soumis aux obligations d'information de l'article 14 avec des exceptions, tandis que la proposition de simplification de l'Omnibus numérique de novembre 2025 était toujours en cours de codécision en octobre 2026. L'obligation d'évaluation de l'accès automatisé en Chine fait de l'effet sur les services de réseau une responsabilité opérationnelle pour les processeurs couverts, soutenant la continuité dans le cadre de la règle en vigueur depuis le 1er janvier 2025.
Étapes de la chaîne de valeur
La chaîne de valeur compare la configuration des robots d'exploration, l'extraction structurée et le contrôle qualité nécessaires pour livrer des jeux de données utilisables. La distinction commerciale centrale est entre la fourniture d'outils d'extraction et l'acceptation de la responsabilité des enregistrements résultants. Un fournisseur couvrant plusieurs étapes peut associer les revenus de mise en œuvre au travail de livraison continu, mais assume également la responsabilité des défaillances qui traversent ces étapes. Les fournisseurs d'outils perçoivent des revenus logiciels, tandis que les fournisseurs livrant des jeux de données vérifiés perçoivent des revenus de services et assument la responsabilité de l'étape de contrôle qualité.
Tableau d'analyse de la chaîne de valeur
| Activité principale | Participants clés | Capture de valeur | Goulot d'étranglement | Réponse en matière de résilience |
|---|---|---|---|---|
| Configuration du robot d'exploration | Opérateurs de robots d'exploration gérés tels que PromptCloud Technologies Pvt Ltd | Revenus de services d'extraction gérés | Définition des champs cibles et du périmètre de collecte | Convenir d'enregistrements types et des limites de collecte avant la mise à l'échelle |
| Extraction et structuration des pages | Fournisseurs de logiciels d'extraction tels que Bright Data Ltd., Zyte Group Ltd., Apify Technologies s.r.o. | Revenus de logiciels et d'API d'extraction | Maintien de champs cohérents à travers les variations de pages | Tester l'extraction sur des types de pages représentatifs et valider les champs requis |
| Contrôle qualité et livraison des jeux de données | Fournisseurs de contrôle qualité et de livraison tels que PromptCloud Technologies Pvt Ltd ; fournisseurs de livraison gérée tels que Zyte Group Ltd. | Revenus de services de livraison de données gérés | Détection des enregistrements incorrects avant la livraison | Combiner la validation des enregistrements avec une révision ciblée des exceptions |
| Source: Mordor Intelligence | ||||
La combinaison de contrôles qualité par apprentissage automatique et humains chez PromptCloud illustre une responsabilité de livraison qui va au-delà de la collecte du contenu des pages. Cette responsabilité donne aux fournisseurs gérés une base pour capturer de la valeur à partir de la fiabilité du jeu de données livré. Une automatisation accrue déplacerait le test commercial vers l'identification économique des exceptions, car une collecte plus importante a une valeur limitée lorsque des enregistrements inutilisables passent sans être détectés.
Paysage concurrentiel
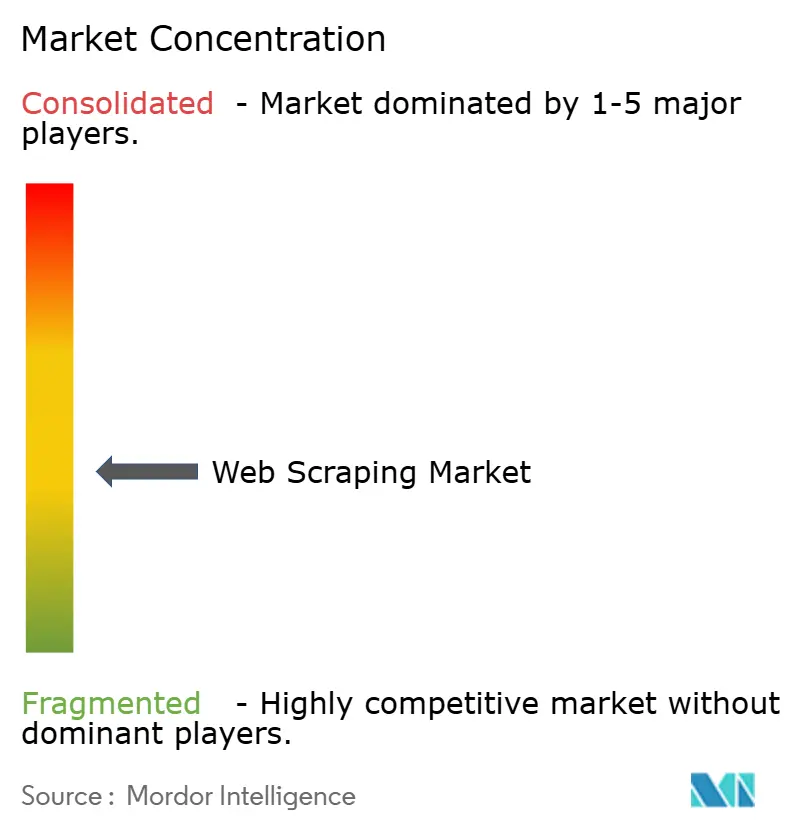
La concurrence est fragmentée entre des plateformes intégrées et des fournisseurs spécialisés, Bright Data Ltd. proposant des outils de scraping, des jeux de données et des services gérés. Zyte Group Ltd. fournit des API et des outils pour développeurs, tandis qu'Apify Technologies s.r.o. propose une plateforme cloud et des services professionnels. Octopus Data, Inc. fournit Octoparse, et Import.io Ltd., au sein de Neuralogics, combine l'extraction en libre-service avec la livraison gérée de données web. Bright Data a déclaré servir 14 des 20 principaux laboratoires de grands modèles de langage (LLM) en 2025. L'accès aux acheteurs des laboratoires de LLM crée un ancrage commercial distinct au sein de cette base de fournisseurs variée, aux côtés de la concurrence sur des formats logiciels et de services qui se chevauchent.
Import.io a rejoint le groupe Neuralogics en octobre 2025, conservant son propre nom, sa plateforme, ses clients et ses équipes. La société investit dans des produits natifs à l'IA sur son moteur d'extraction, plaçant le développement de produits aux côtés de son offre d'extraction établie. Zyte a décrit son Web Scraping Copilot en 2025 comme un assistant IA axé sur le code intégré directement dans les flux de travail des développeurs, une approche qui maintient les ingénieurs en contrôle de leurs propres pipelines. Import.io ajoute plutôt des produits natifs à l'IA au moteur d'extraction que ses clients existants utilisent déjà, de sorte que les deux fournisseurs étendent les routines actuelles plutôt que de les remplacer.
La direction concurrentielle évolue vers une extraction que les agents IA peuvent demander dans leurs propres flux de travail. Le 30 septembre 2026, Zyte a introduit un serveur hébergé de protocole de contexte de modèle (MCP) qui rend l'API Zyte et Scrapy Cloud disponibles aux agents IA et de codage compatibles. L'API AgentTools d'Octoparse guide les agents à travers la découverte de modèles, la validation des paramètres, l'extraction cloud et l'exportation de données, l'exécution nécessitant un modèle exécutable dans le cloud pris en charge. Là où les tests territoriaux de la LGPD brésilienne s'appliquent, le traitement des données personnelles nécessite une base juridique au titre de l'article 7, tandis que les responsables du traitement allemands obtenant des données personnelles indirectement doivent fournir les informations spécifiées à l'article 14 du RGPD, sous réserve de ses exceptions. Les spécialistes peuvent se démarquer en rendant une tâche d'extraction étroite exécutable via les interfaces d'agents que leurs acheteurs utilisent.
Leaders du secteur du web scraping
-
Bright Data Ltd.
-
Zyte Group Ltd.
-
Apify Technologies s.r.o.
-
Octopus Data, Inc.
-
Import.io Ltd.
- *Avis de non-responsabilité : les principaux acteurs sont triés sans ordre particulier
Marché du Web Scraping Entreprises couvertes dans ce rapport
- Bright Data Ltd.
- Zyte Group Ltd.
- Apify Technologies s.r.o.
- Octopus Data, Inc.
- Import.io Ltd.
- The Phantom Company SAS (PhantomBuster)
- Diffbot Technologies Corp.
- Mozenda, Inc.
- Sequentum Inc.
- ScrapeHero LLC
- ParseHub Inc.
- UAB Oxylabs
- DataWeave Pvt Ltd
- PromptCloud Technologies Pvt Ltd
- DATAANT Sp. z o.o. (ScrapingAnt)
- DataHen Inc.
- Actowiz Solutions LLC
- SysNucleus Software Pvt Ltd (product: WebHarvy)
- PilotFish Technology LLC
- Datopian Ltd.
- Newprosoft LLC
- UAB Data troops (Decodo)
- Datafiniti LLC
- Crawlbase LLC
- Bright Data Labs Ltd.
Principales opportunités pour les acteurs du marché
La comparaison des opportunités se concentre sur la collecte de données d'entraînement qui améliore la couverture et le contrôle dans un contexte d'accès restreint. Inria a caractérisé les nouvelles données d'entraînement publiques en ligne comme de plus en plus rares en décembre 2025, tandis qu'OECD.AI a signalé plus de 50 procès pour droits d'auteur et protection des données dans le monde d'ici 2025. OECD.AI a également signalé que les sites web utilisaient de plus en plus des barrières techniques et contractuelles pour empêcher le scraping. Ensemble, la rareté et les restrictions d'accès favorisent les services de collecte qui définissent une couverture utilisable et les conditions de source des enregistrements avant d'élargir un corpus.
Tableau des opportunités de marché
| Opportunité | Pourquoi maintenant | Segment acheteur / segment principal | Approche recommandée | Principal obstacle | Bénéficiaires probables |
|---|---|---|---|---|---|
| Corpus d'entraînement spécifiques à un secteur vertical | Rareté des nouvelles données d'entraînement publiques | Équipes d'entraînement IA et LLM | Définir un secteur vertical étroit et organiser sa couverture de sources | Établir l'adéquation du jeu de données pour le secteur vertical choisi | Fournisseurs de données spécialisés tels que Bright Data Ltd. |
| Collecte incrémentale de corpus | Besoin de nouveau matériel d'entraînement public | Équipes de modèles élargissant les corpus existants | Livrer des lots incrémentiels avec des dates de source documentées | Obtenir du matériel genuinement nouveau et utilisable | Fournisseurs de pipelines de données personnalisés tels que Bright Data Ltd. |
| Flux d'entraînement avec enregistrements de source | Litiges juridiques et restrictions de collecte | Développeurs de modèles évaluant les origines des corpus | Associer la source, la date de collecte et les conditions d'utilisation à chaque lot | Barrières d'accès techniques et contractuelles | Fournisseurs de données web tels que Bright Data Ltd. |
| Source: Mordor Intelligence | |||||
Le rôle de Bright Data dans l'approvisionnement spécifique à des secteurs verticaux et dans les pipelines personnalisés constitue un point de départ commercial pour le travail sur les données d'entraînement. L'extension de ce rôle vers des flux incrémentiels ou des flux avec enregistrements de source nécessiterait des exigences de livraison explicites et une base confirmée pour la collecte de chaque source. L'ouverture la plus forte consiste à transformer une collecte étroitement définie en un arrangement d'approvisionnement reproductible dont le périmètre et l'origine restent clairs à mesure que le corpus évolue.
Développements industriels récents dans Marché du Web Scraping
- Oct 2026 : UAB Oxylabs a lancé Web API, combinant la recherche web et le scraping avec une analyse alimentée par IA pour des données web structurées.
- Oct 2026 : RateGain Travel Technologies Limited a annoncé que Vietnam Airlines avait sélectionné AirGain, sa plateforme d'intelligence tarifaire pour compagnies aériennes, pour renforcer la veille tarifaire et la tarification concurrentielle.
- Sep 2026 : Zyte Group Ltd. a lancé Zyte MCP, intégrant l'accès web en direct, l'extraction structurée et les opérations Scrapy Cloud dans les agents de codage.
Marché du Web Scraping Portée du rapport et méthodologie de recherche
Définition du marché et périmètre
Le marché mondial du web scraping mesure les revenus annuels des fournisseurs provenant de logiciels commerciaux et de services gérés qui extraient de manière programmatique le contenu des pages web publiques pour des organisations payantes dans tous les secteurs et cas d'utilisation. Il couvre les ventes de licences logicielles et d'abonnements ainsi que les frais de service des offres cloud et sur site dans le monde entier.
Exclusions du périmètre : les scripts internes développés en interne et exécutés uniquement au sein d'une entreprise, les services autonomes de proxy ou de rotation d'adresses IP, et les outils généraux d'analyse web ou de référencement naturel qui n'extraient pas de manière programmatique le contenu des pages web publiques sont exclus.
Aperçu de la segmentation
- Par solution
- Logiciels
- Services
- Par mode de déploiement
- Cloud
- Sur site
- Par secteur d'utilisateur final
- BFSI
- Commerce de détail et e-commerce
- Immobilier
- Fabrication
- Gouvernement
- Santé
- Publicité et médias
- Autres
- Par cas d'utilisation
- Extraction de données / ETL
- Surveillance des prix et de la concurrence
- Génération de leads et intelligence commerciale
- Données financières alternatives
- Analyse des sentiments et des réseaux sociaux
- Par géographie
- Amérique du Nord
- États-Unis
- Canada
- Mexique
- Amérique du Sud
- Brésil
- Argentine
- Reste de l'Amérique du Sud
- Europe
- Allemagne
- Royaume-Uni
- France
- Italie
- Espagne
- Russie
- Reste de l'Europe
- Asie-Pacifique
- Chine
- Japon
- Inde
- Corée du Sud
- Australie et Nouvelle-Zélande
- Reste de l'Asie-Pacifique
- Moyen-Orient et Afrique
- Moyen-Orient
- Arabie saoudite
- Émirats arabes unis
- Turquie
- Reste du Moyen-Orient
- Afrique
- Afrique du Sud
- Nigéria
- Kenya
- Reste de l'Afrique
- Moyen-Orient
- Amérique du Nord
Sources de données, dimensionnement du marché et validation
Recherche documentaire
La recherche documentaire s'appuie sur des sources telles que les données trimestrielles de ventes de e-commerce de détail du Bureau du recensement des États-Unis pour le contexte du commerce en ligne, l'avis de la plateforme développeur de Reddit sur l'évolution des conditions d'accès public, l'étude arXiv sur l'extraction web contrainte par schéma pour les questions de performance technique, et le rapport State of Web Scraping d'Apify pour les conditions d'exploitation rapportées par les praticiens. Ces sources aident à cadrer les cas d'utilisation de la demande, les conditions d'accès, les besoins en qualité des données et les coûts d'extraction sans traiter les indicateurs adjacents comme des revenus du marché.
Les dépôts d'entreprises et les documents destinés aux investisseurs aident à identifier les modèles de revenus des fournisseurs et les limites des produits, tandis que les attributions de contrats publics et la presse technologique et commerciale réputée peuvent clarifier si une transaction couvre des logiciels, des données livrées ou les deux. Les totaux du marché sont recoupés avec leur base de revenus déclarée, leur géographie, leur période et leurs inclusions. Ces sources nommées sont illustratives et non exhaustives, et d'autres sources informent la collecte, la validation et la clarification.
Entretiens primaires et enquêtes
La conception de la recherche utilise des entretiens structurés ou des enquêtes auprès de fournisseurs de logiciels de web scraping, de prestataires d'extraction gérée et d'acheteurs organisationnels dans les secteurs de la finance, du commerce de détail, des médias, de la fabrication et du secteur public dans les régions APAC, EMEA et Amériques. Les répondants ayant des responsabilités en matière de produits, de commerce, de livraison, d'approvisionnement et d'opérations de données peuvent clarifier les limites des revenus, les achats cloud par rapport aux achats sur site, l'utilisation par les clients et les évolutions de la charge de travail d'extraction. Les questions des analystes testent les interprétations des sources secondaires et examinent les lacunes dans les revenus des fournisseurs, le regroupement des services, l'allocation géographique et l'adoption, et les comptes sont triangulés entre les preuves des fournisseurs, des acheteurs et les preuves publiques avant que les hypothèses ne soient retenues.
Répartition des répondants aux travaux de terrain de la recherche primaire
| Type d'entreprise | Poste du répondant | Région |
|---|---|---|
| Premier niveau : 35 % | Directeurs généraux (CXO) : 20 % | APAC : 38 % |
| Niveau intermédiaire : 45 % | Responsables fonctionnels/d'unité : 35 % | EMEA : 32 % |
| Acteurs plus petits : 20 % | Responsables : 45 % | Amériques : 30 % |
Dimensionnement du marché et prévisions
Le modèle estime les revenus annuels mondiaux des fournisseurs pour les logiciels commerciaux de web scraping et les services d'extraction gérés, puis répartit ce total entre les solutions, les modes de déploiement, les secteurs d'utilisateurs finaux, les cas d'utilisation et la géographie des clients. Une estimation descendante part des communications de revenus et des estimations au niveau du marché, ajustées à la vente définie de licences, d'abonnements et de services d'extraction. Des vérifications ascendantes sélectives comparent les cumuls de revenus des fournisseurs et les prix de contrats ou de services échantillonnés multipliés par les volumes de clients estimés, les écarts étant enregistrés et réconciliés plutôt que traités comme un recensement complet. Les indicateurs clés comprennent les revenus des fournisseurs et le mix produit, les communications sur les clients et les contrats, l'adoption du cloud par rapport au déploiement sur site, l'activité du commerce en ligne et des places de marché, et la demande de données alternatives dans la finance ou les médias. Chacun informe l'enveloppe globale des revenus, les parts de segments ou les moteurs de prévision. Une régression multivariée peut relier la série de revenus annuels à ces indicateurs lorsqu'un historique cohérent existe, tandis que l'analyse de scénarios gère les discontinuités telles que les restrictions d'accès, les changements juridiques ou les nouvelles capacités d'extraction automatisée. Les observations manquantes utilisent une interpolation documentée ou des hypothèses bornées. Les parts de segments sont construites à partir de répartitions rapportées, de preuves d'utilisation par les clients, de descriptions de produits et d'allocations des acheteurs entre secteurs et applications, le résidu n'étant attribué qu'après évaluation des catégories soutenues. Les experts primaires peuvent vérifier le caractère raisonnable des trajectoires de croissance au niveau des variables et des évolutions du mix de solutions, et les différences non résolues entre les vérifications des fournisseurs et le total descendant sont réexaminées par des vérifications des sources et des limites.
Validation des données et cycle de mise à jour
Les analystes triangulent les communications des fournisseurs, les preuves côté acheteur, les contrats publics et les signaux de marché indépendants, puis vérifient les totaux, les parts, les taux de croissance et les révisions historiques pour détecter les anomalies ou les écarts significatifs. Un examen en plusieurs étapes confirme les dates et définitions des sources, teste si les valeurs aberrantes reflètent de véritables changements ou des limites incohérentes, et résout les problèmes avant la validation finale. Un nouveau contact est déclenché lorsqu'une réponse significative contredit les preuves publiées ou laisse la propriété des revenus, le regroupement ou la géographie peu clairs. Le jeu de données est actualisé annuellement, mis à jour entre les cycles pour les événements de marché significatifs, et fait l'objet d'un examen préalable à la livraison des sources, des calculs et de la cohérence narrative.
Taille du marché du web scraping selon Mordor Intelligence par rapport aux autres estimations publiées
Les estimations publiées peuvent différer dans les transactions et produits qu'elles comptabilisent et dans les données utilisées pour modéliser la demande. Le marché mondial du web scraping mesure les revenus annuels des fournisseurs provenant de logiciels commerciaux et de services gérés qui extraient de manière programmatique le contenu des pages web publiques pour des organisations payantes dans tous les secteurs et cas d'utilisation.
Les principaux facteurs d'écart comprennent la couverture définie de l'étude et les choix de modélisation spécifiques au marché. Les indicateurs clés comprennent les revenus des fournisseurs et le mix produit, les communications sur les clients et les contrats, l'adoption du cloud par rapport au déploiement sur site, l'activité du commerce en ligne et des places de marché, et la demande de données alternatives dans la finance ou les médias.
Comparaison de référence
| Source | Taille du marché | Lacunes dans la méthodologie de recherche |
|---|---|---|
| Mordor Intelligence | 1,83 milliard USD (2027) | |
| Cabinet de conseil mondial A | 990 millions USD (2025) | À sa base de 2025, cette estimation est inférieure de 45,9 % à la valeur de ce rapport pour 2027 de 1,83 milliard USD, 2 ans plus tard. L'année de base antérieure place l'estimation avant la croissance ultérieure du marché. |
| Cabinet de conseil mondial B | 909,9 millions USD (2024) | À sa base de 2024, cette estimation est inférieure de 50,3 % à la valeur de ce rapport pour 2027 de 1,83 milliard USD, 3 ans plus tard. La couverture limitée aux logiciels exclut les services d'extraction gérés, et son année de base précède la croissance ultérieure du marché. |
Les analystes de Mordor Intelligence triangulent les communications des fournisseurs, les preuves côté acheteur, les contrats publics et les signaux de marché indépendants, puis vérifient les totaux, les parts, les taux de croissance et les révisions historiques pour détecter les anomalies ou les écarts significatifs.
Questions clés auxquelles le rapport répond
Quelle est la taille du marché du web scraping et sa croissance prévue ?
La taille est estimée à 1,83 milliard USD en 2027 et devrait atteindre 4,03 milliards USD d'ici 2032, à un CAGR de 17,08 % durant 2027-2032.
Quels sont les moteurs de la demande de logiciels et de services de web scraping ?
L'expansion du commerce en ligne aux États-Unis et le développement de robots d'exploration assisté par IA soutiennent la demande. Dans une enquête 2025 auprès de 56 sociétés côté acheteur aux États-Unis, au Royaume-Uni et en Europe, 63 % prévoyaient des dépenses plus élevées en données alternatives.
Quelle solution génère le plus de revenus dans le web scraping commercial ?
Les logiciels représentaient 57,93 % des revenus en 2026, tandis que les services devraient croître à un CAGR de 18,35 % durant 2027-2032.
Quelles entreprises sont les principaux fournisseurs de logiciels et de services de web scraping ?
Les principaux fournisseurs comprennent Bright Data Ltd., Zyte Group Ltd., Apify Technologies s.r.o., Octopus Data, Inc. et Import.io Ltd., qui opère au sein de Neuralogics.
Quels défis façonnent les perspectives du web scraping commercial ?
Dans une enquête de décembre 2025, 88,7 % des répondants ont signalé des coûts plus élevés lors du ciblage de sites web protégés contre les robots. Pour les praticiens du scraping, cette pression sur les coûts peut contraindre la couverture des sites protégés et la fréquence d'actualisation.
Quelle région est en tête du secteur du web scraping commercial, et où la croissance est-elle la plus rapide ?
L'Amérique du Nord détenait 33,94 % des revenus en 2026, tandis que l'Asie-Pacifique devrait connaître la croissance la plus rapide avec un CAGR de 18,35 % durant 2027-2032.