
Tamaño y Participación del Mercado de Web Scraping
Análisis del Mercado de Web Scraping por Mordor Intelligence
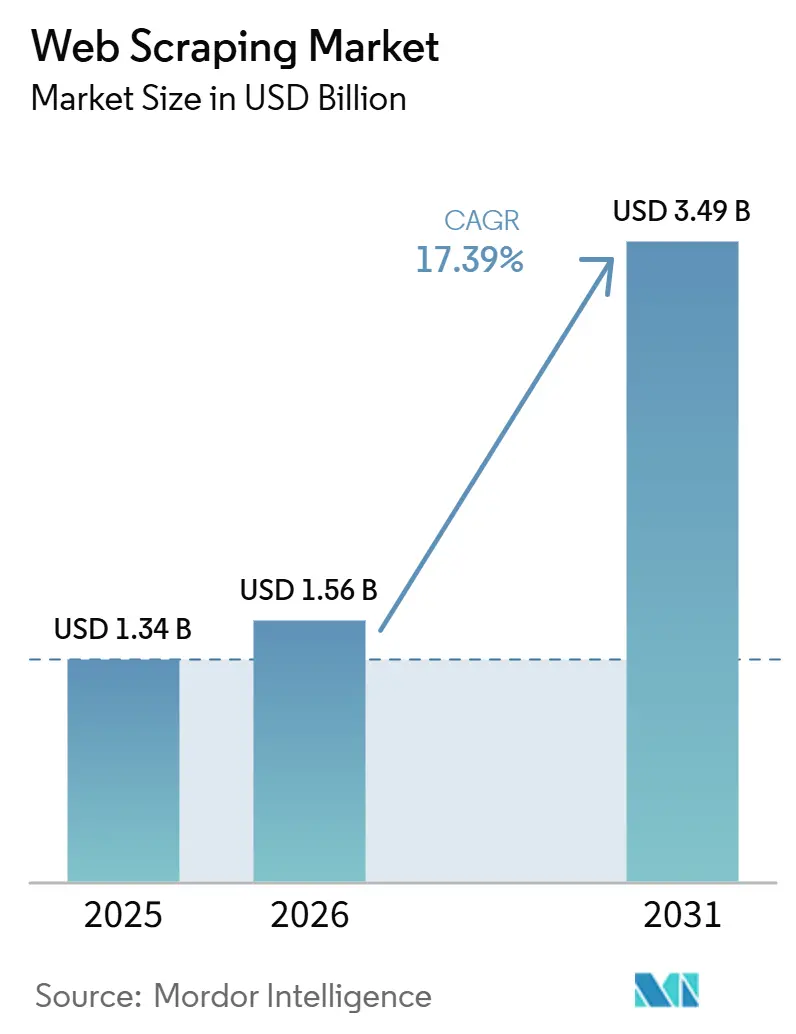
El tamaño del mercado de web scraping fue valorado en 1,56 mil millones de USD en 2026 y se estima que crecerá desde 1,83 mil millones de USD en 2027 hasta alcanzar 4,03 mil millones de USD para 2032, a un CAGR del 17,08% durante el período de previsión (2027-2032).
El crecimiento del comercio minorista en línea en los Estados Unidos y el uso de datos derivados de la web por parte de firmas de inversión sostienen una demanda recurrente de recopilación. La extracción asistida por IA produce registros con esquemas definidos, lo que proporciona a los equipos campos de salida definidos para verificar antes del análisis. El acceso restringido a plataformas también aumenta el valor de validar lo que cada ruta de recopilación recupera. Los proveedores eligen entre vender software reutilizable y entregar conjuntos de datos finalizados, asumiendo responsabilidad por diferentes partes de la recopilación. Los costos de sitios protegidos y las restricciones legales limitan la amplitud con la que esos servicios pueden recopilar y mantener la entrega.
Conclusiones Clave del Informe
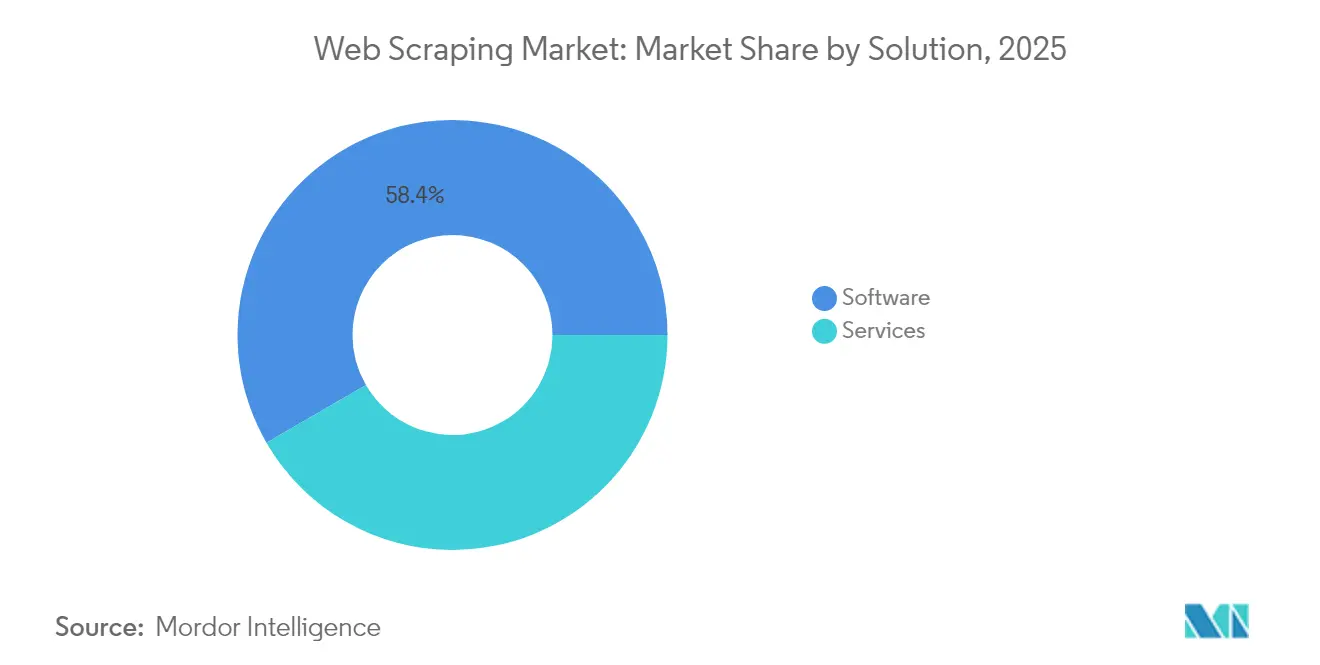
- Dentro de las soluciones, el software tuvo una participación del 57,93% en el mercado de web scraping en 2026, mientras que se prevé que los servicios crezcan más rápido con un CAGR del 18,35% durante 2027-2032.
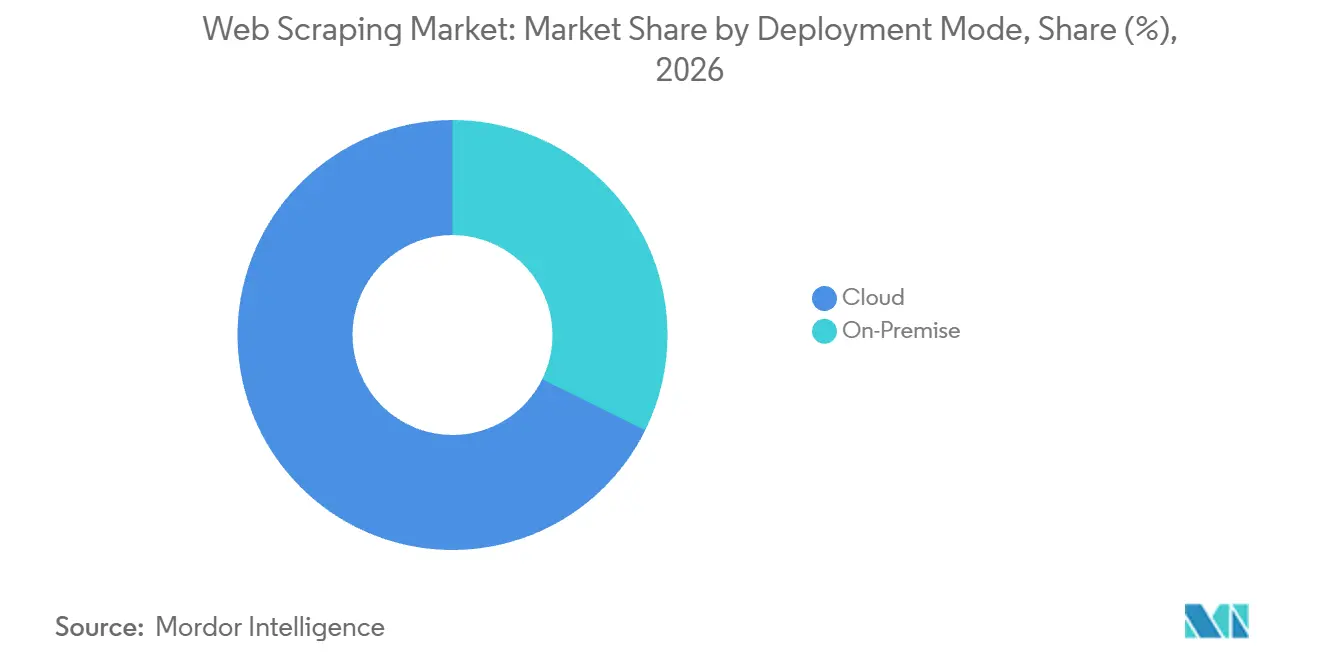
- La implementación en la nube representó una participación del 67,7% del tamaño del mercado de web scraping en 2026 y se prevé que crezca más rápido con un CAGR del 17,52% durante 2027-2032.
- Entre las industrias de usuarios finales, BFSI lideró con el 29,39% de los ingresos en 2026, mientras que se prevé que el segmento de publicidad y medios crezca más rápido con un CAGR del 18,5% durante 2027-2032.
- Por caso de uso, la extracción de datos / ETL lideró con el 35,89% de los ingresos en 2026, con el monitoreo de precios y competencia proyectado para crecer más rápido con un CAGR del 18,05% durante 2027-2032.
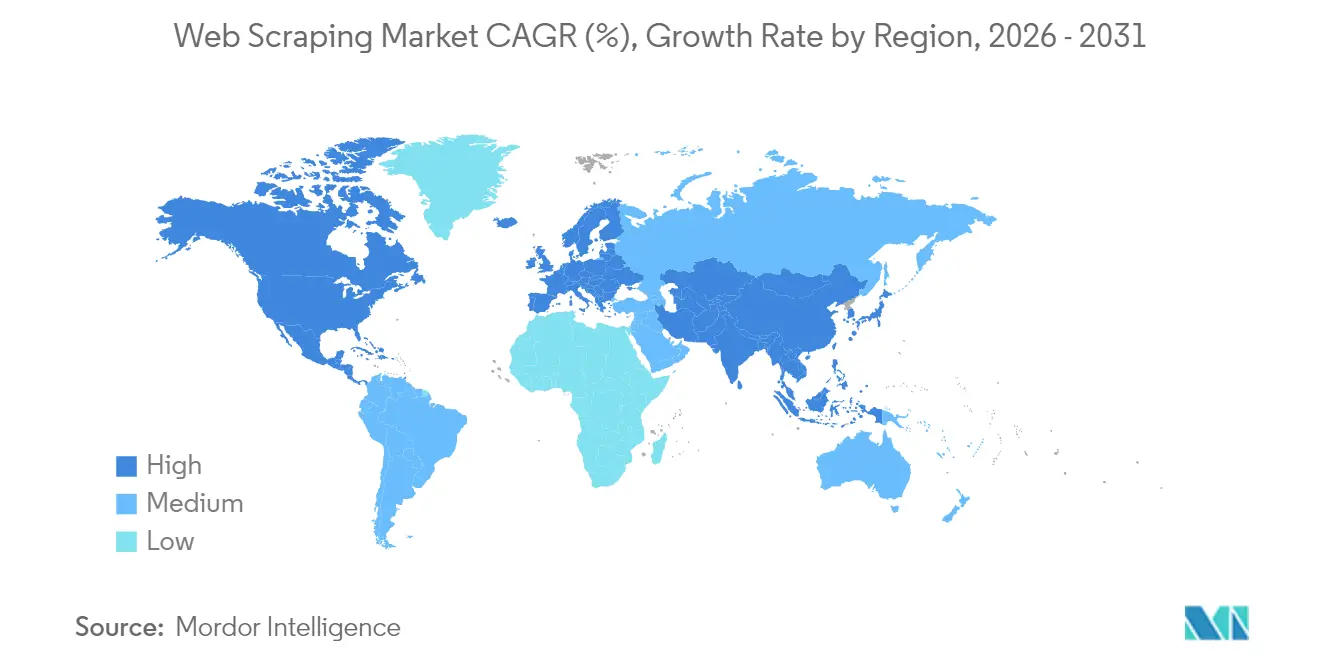
- Geográficamente, América del Norte tuvo el 33,94% de los ingresos en 2026, mientras que se prevé que Asia-Pacífico crezca más rápido con un CAGR del 18,35% durante 2027-2032.
Nota: Las cifras de mercado de este informe se basan en el marco de estimación propietario de Mordor Intelligence, que combina nueve meses de datos reales con proyecciones del cuarto trimestre para el año base 2026.
Tendencias e Información del Mercado
Análisis del Impacto de los Impulsores*
| Impulsor | (~) % de Impacto en el Pronóstico de CAGR | Relevancia Geográfica | Horizonte Temporal del Impacto |
|---|---|---|---|
| Crecimiento del Comercio Electrónico y los Mercados en Línea | +5.1% | América del Norte y Asia-Pacífico | Corto plazo (≤ 2 años) |
| Avances en IA/ML para la Extracción de Datos | +4.6% | América del Norte, Europa y Asia-Pacífico | Corto plazo (≤ 2 años) |
| Creciente Demanda de Datos Alternativos en Finanzas | +4.1% | América del Norte y Europa | Mediano plazo (2-4 años) |
| Desactivación de API en Plataformas Principales que Impulsa el Scraping | +3.6% | Estados Unidos y Europa | Corto plazo (≤ 2 años) |
| Requisitos de Datos de Entrenamiento para IA Generativa | +3.2% | América del Norte y Asia-Pacífico | Largo plazo (≥ 4 años) |
| Mandatos de Datos Abiertos que Revelan Brechas de Datos | +1.8% | Alemania, Francia y España | Mediano plazo (2-4 años) |
| Fuente: Mordor Intelligence | |||
Crecimiento del Comercio Electrónico y los Mercados en Línea
Un mayor flujo de ventas en línea incrementa el valor comercial de observar precios y disponibilidad en las tiendas digitales. Las ventas minoristas de comercio electrónico en los Estados Unidos, ajustadas estacionalmente, alcanzaron 340,2 mil millones de USD en el segundo trimestre de 2026, un aumento del 12,2% (±0,9%) respecto al segundo trimestre de 2025 sin ajuste por cambios de precios. Las ventas minoristas totales en los Estados Unidos aumentaron un 6,7% (±0,5%) durante el mismo período, por lo que las observaciones de precios en línea conciernen a un canal que gana peso en ventas. Para los minoristas que siguen un conjunto de productos recurrente, la tarea de recopilación consiste en separar los cambios de precios de los cambios en el surtido. Comparar productos equivalentes entre ejecuciones de recopilación puede fundamentar el próximo ajuste de oferta en la fijación de precios de un competidor, en lugar de en un aparente cambio de precio causado por una combinación de productos diferente.
Avances en IA/ML para la Extracción de Datos
El desarrollo de arañas web asistido por IA puede ampliar el rango de sitios objetivo que un equipo de recopilación puede permitirse mantener. Durante el segundo y tercer trimestre de 2025, ScrapeGraphAI recopiló aproximadamente 9 millones de eventos de telemetría de participación voluntaria del uso en producción de su biblioteca de extracción web de código abierto. Los investigadores deduplicaron y equilibraron esos eventos brutos por esquema en un conjunto de datos publicado de 93.695 eventos de extracción. En marzo de 2026, Zyte puso a disposición general Web Scraping Copilot 1.0, una extensión de Visual Studio Code que utiliza IA para generar, probar e implementar arañas Scrapy. Incorporar esas tareas en el editor del desarrollador puede reducir el esfuerzo de ingeniería por sitio objetivo y ampliar el alcance económicamente viable del programa Scrapy de un equipo.
Creciente Demanda de Datos Alternativos en Finanzas
En una encuesta realizada entre septiembre y octubre de 2025 a 56 firmas del lado comprador en los Estados Unidos, el Reino Unido y Europa, Crisil Coalition Greenwich encontró que el 63% de los inversores planeaba aumentar el gasto en datos alternativos. En una divulgación de marzo de 2026, AQR indicó que su asesor utiliza datos alternativos para gestionar ciertos fondos, incluyendo comportamiento del consumidor, sentimiento en redes sociales, y datos de búsqueda y tráfico en internet. Esa divulgación advirtió que la infraestructura tecnológica de información a menudo menos robusta de los proveedores puede dejar los conjuntos de datos suspendidos, retrasados o no disponibles. Las intenciones de gasto amplían la oportunidad potencial para los proveedores de datos alternativos, mientras que la advertencia de AQR sobre posibles interrupciones destaca la importancia de la continuidad del suministro. Para los equipos de inversión, una interrupción del proveedor puede eliminar una entrada del modelo en la próxima actualización. La continuidad del suministro puede entonces diferenciar a los proveedores de datos que de otro modo serían adecuados.
Desactivación de API en Plataformas Principales que Impulsa el Scraping
En entrevistas realizadas entre octubre de 2024 y febrero de 2025, investigadores de redes sociales describieron el web scraping como una alternativa a las API de plataformas y plantearon preocupaciones legales, éticas y de fiabilidad. Reddit anunció el 5 de agosto de 2026 que restringiría gradualmente las nuevas solicitudes de API públicas.[1] Reddit también planea comenzar a eliminar el acceso a la API de datos para aplicaciones y usuarios no registrados o no activos el 12 de enero de 2027, y finalizar el acceso restante a la API pública en marzo de 2027. Un estudio de TikTok de 2026 encontró que las herramientas de scraping de API y de interfaz de usuario recuperaban contenido con diferentes períodos de tiempo y niveles de popularidad. Para los compradores que enfrentan acceso restringido, estas diferencias hacen que una ruta de recopilación alternativa sea comercialmente útil solo cuando su resultado se ajusta al análisis previsto. El plan de Reddit de finalizar el acceso restante a la API pública en marzo de 2027 da a los equipos que ahora dependen de extracciones de API una fecha fija para la cual cualquier ruta de reemplazo necesita verificar su cobertura.
Análisis del Impacto de las Restricciones*
| Restricción | (~) % de Impacto en la Previsión del CAGR | Relevancia Geográfica | Horizonte Temporal del Impacto |
|---|---|---|---|
| Incertidumbre Legal y Ética | -2.2% | Estados Unidos y China | Mediano plazo (2-4 años) |
| Altos Costos y Complejidad Técnica | -1.6% | Estados Unidos y Reino Unido | Corto plazo (≤ 2 años) |
| Herramientas Avanzadas de Mitigación de Bots que Aumentan las Tasas de Fallo | -1% | Estados Unidos y Reino Unido | Corto plazo (≤ 2 años) |
| API Oficiales que Canibalizan Algunos Casos de Uso de Scraping | -0.5% | América del Norte y Europa | Mediano plazo (2-4 años) |
| Fuente: Mordor Intelligence | |||
Incertidumbre Legal y Ética
Un conjunto de datos puede perder su utilidad comercial cuando su método de adquisición crea una obligación de eliminación. En julio de 2025, LinkedIn indicó que su resolución requería que Proxycurl eliminara permanentemente los datos de LinkedIn obtenidos por medios no autorizados y dejara de acceder a LinkedIn de forma ilícita. LinkedIn describió el caso como uno que involucraba scraping no autorizado mediante cuentas falsas y otras actividades fraudulentas. Para un comprador, una restricción comparable interrumpiría los flujos de trabajo dependientes de los registros afectados. La misma resolución prohibió a Proxycurl seguir accediendo ilícitamente a LinkedIn, por lo que la ruta que produjo los registros eliminados no podría utilizarse para reconstruirlos.
Altos Costos y Complejidad Técnica
Los sitios web protegidos crean un umbral de costos que puede limitar el alcance económico de un programa de scraping. En una encuesta de diciembre de 2025, el 88,7% de los encuestados reportó mayores costos al apuntar a sitios web protegidos por medidas anti-bot.[2] Para los profesionales del scraping, un mayor gasto de recopilación incrementa los recursos necesarios para agregar objetivos protegidos a un programa. Esa carga aumenta el gasto de agregar cada objetivo protegido a un programa, lo que puede limitar cuántos de esos objetivos asume un equipo. Una mayor cobertura o una recopilación más frecuente debe absorber la presión de costos reportada.
*Nuestras previsiones consideran los impactos de impulsores y restricciones como direccionales, no aditivos. Las previsiones de impacto reflejan el crecimiento base, los efectos de mezcla y las interacciones entre variables.
Análisis de Segmentos
Por Solución:
El Software Reutilizable Lidera Mientras los Servicios de Datos se ExpandenEl software representó una participación del 57,93% del tamaño del mercado de web scraping en 2026. Apify reporta una base de clientes mundial de 91.000 para su plataforma de web scraping y automatización de navegadores. Con una plataforma de software, un comprador puede retener la lógica de extracción que configura y aplicarla a ejecuciones de recopilación sucesivas. La recopilación repetida deriva valor económico del código reutilizable y la configuración del flujo de trabajo porque se basa en una implementación existente. La plataforma puede escalar a través de infraestructura de ejecución compartida mientras preserva las rutinas específicas del cliente.
Los servicios son el segmento de más rápido crecimiento, con un CAGR proyectado del 18,35% durante 2027-2032. El 1 de diciembre de 2025, Statistics Canada adjudicó a Mobius365 Knowledge Services, Inc. un contrato para datos obtenidos mediante web scraping de sitios web canadienses.[3] La adjudicación cubrió fines estadísticos y de investigación desde el 1 de abril de 2026 hasta el 31 de marzo de 2027, con 4 opciones de extensión de un año. La agencia especificó que estaba adquiriendo datos, manteniendo el contrato enfocado en información entregada en lugar de software o una licencia de Software como Servicio. El valor potencial de renovación depende del desempeño en el conjunto de datos solicitado bajo una obligación continua de suministro de datos.

Por Modo de Implementación:
La Escala en la Nube se Combina con el Control del OperadorLa nube representó una participación del 67,7% en el mercado de web scraping en 2026 y es el segmento de más rápido crecimiento, con un CAGR del 17,52% durante 2027-2032. Apify ejecuta su plataforma de web scraping, extracción de datos y automatización en la nube a través de programas sin servidor llamados Actors. La empresa reporta el procesamiento de más de 1 petabyte de datos mensualmente en esa plataforma. La ejecución gestionada por el proveedor puede adaptarse a un comprador cuya demanda de recopilación varía entre ejecuciones, porque la capacidad puede considerarse de forma independiente a la definición de los registros solicitados. La nube concentra la obligación de capacidad con el proveedor de la plataforma, por lo que un comprador puede ejecutar recopilaciones de alto volumen sin aprovisionar cada entorno por separado.
La implementación local coloca el entorno de recopilación bajo el control directo del operador, incorporando la configuración y el mantenimiento dentro del mismo límite organizacional. Para una organización que necesita que los registros recopilados y los registros de extracción permanezcan en su propia red, la ejecución local alinea el rastreador con ese requisito interno. La organización debe entonces gestionar la operación del rastreador, la configuración del proxy y las reparaciones de análisis como parte del programa de recopilación. Un cambio en el diseño de la página puede consumir el tiempo de ese equipo incluso cuando los campos de datos deseados permanecen iguales. El argumento para mantener la ejecución local descansa en ese requisito interno de manejo de datos, con el mantenimiento del analizador tratado como un costo continuo de cumplirlo.
Por Industria de Usuario Final:
Los Flujos de Trabajo de Inversión y la Inteligencia Publicitaria Configuran la DemandaBFSI fue el segmento más grande, representando el 29,39% de los ingresos del mercado en 2026. La encuesta de 2025 de Lowenstein Sandler cubrió encuestados de firmas de capital privado, gestores de fondos de cobertura y firmas de capital de riesgo. Identificó el web scraping entre las fuentes de datos utilizadas en sistemas de IA personalizados para investigación de inversiones, optimización de carteras o negociación. Para dichos compradores, la extracción suministra posibles entradas al modelo, mientras que la investigación de inversiones, la optimización de carteras y la negociación implican diferentes decisiones sobre cómo deben utilizarse esas entradas. Adaptar las variables entregadas a una tarea de inversión específica proporciona a un proveedor de extracción una base clara para el trabajo de integración dentro del modelo que utiliza esos registros.
El segmento de publicidad y medios es el segmento de más rápido crecimiento, con un CAGR proyectado del 18,5% durante 2027-2032. Adbeat rastrea 1,3 millones de páginas y detecta, analiza y procesa 3,8 millones de anuncios diariamente. El procesamiento diario a esa escala muestra cómo la inteligencia publicitaria crea cargas de trabajo recurrentes de obtención de páginas y procesamiento de anuncios. Para los anunciantes que comparan campañas de la competencia, recopilar el mismo conjunto de publicaciones en días sucesivos puede distinguir nuevas ubicaciones de observaciones anteriores. La oportunidad comercial radica en mantener ese historial de campañas, por lo que la frecuencia de recopilación importa junto con el número de páginas cubiertas.
Por Caso de Uso:
Las Canalizaciones Repetibles Apoyan la Visibilidad CompetitivaLa extracción de datos / ETL fue el segmento más grande, representando el 35,89% de los ingresos del mercado en 2026. Este caso de uso convierte páginas web en registros estructurados que pueden pasar por pasos de extracción, transformación y carga. Su función económica es horizontal, porque la misma infraestructura de recopilación puede alimentar varios análisis posteriores sin prescribir una única decisión. Para un comprador que combina múltiples fuentes web, la elección de diseño crítica es dónde estandarizar los registros antes de pasarlos a otros sistemas. En ese punto de transferencia, un proveedor de extracción puede vender entradas fiables de forma independiente del software de análisis posterior.
El monitoreo de precios y competencia es el segmento de más rápido crecimiento, con un CAGR proyectado del 18,05% durante 2027-2032. El 7 de octubre de 2026, RateGain Travel Technologies anunció que Vietnam Airlines había seleccionado su plataforma de inteligencia de tarifas AirGain. La cobertura anunciada incluyó más de 300 aerolíneas, más de 170 agencias de viajes en línea y más de 50 plataformas de metabúsqueda. Esa amplitud muestra por qué el monitoreo competitivo necesita un marco de observación que cubra tanto a los proveedores directos como a los intermediarios, ya que los canales elegidos definen lo que representa el conjunto de datos. La decisión de cobertura relevante es qué canales de aerolíneas e intermediarios monitorear conjuntamente, porque un feed exclusivo de aerolíneas abordaría una pregunta de precios más limitada.
Análisis Geográfico
Mercado de Web Scraping en América del Norte
América del Norte representó una participación del 33,94% del tamaño del mercado de web scraping en 2026. Los detalles del programa del Índice de Precios al Consumidor de Statistics Canada de octubre de 2025 identifican el web scraping automatizado, los archivos de transacciones de minoristas y la recopilación manual en línea como fuentes de precios no tradicionales. Un programa de fuentes mixtas incorpora la extracción web dentro de un sistema de medición existente, donde las comparaciones de precios dependen en parte del canal de recopilación. Para el operador estadístico, una serie de precios automatizada debe ajustarse al mismo ciclo de producción mensual que los archivos de transacciones y las observaciones recopiladas manualmente.
Mercado de Web Scraping en Asia-Pacífico
Asia-Pacífico es la región de más rápido crecimiento, con un CAGR proyectado del 18,35% durante 2027-2032. La agencia nacional de estadísticas de Indonesia, a través de su unidad de estadísticas de distribución y servicios, utilizó el web scraping en 2025 para recopilar precios de varios productos básicos de sitios de mercado en línea. A partir de junio de 2026, la Oficina Australiana de Estadísticas utiliza el web scraping para extraer información de precios, productos y otra información de sitios web específicos con fines estadísticos. Para el Índice de Precios al Consumidor de Australia, la Oficina Australiana de Estadísticas indica que los datos obtenidos mediante web scraping representan un aumento de 500 veces en los precios recopilados en comparación con la recopilación manual. Pasar la recopilación de precios de visitas manuales a rutinas automatizadas amplía las observaciones que un programa puede actualizar, aumentando las cargas de trabajo de extracción dentro de estos usos estadísticos.
En América del Sur, la licitación de enero de 2026 de ChileCompra buscó la captura masiva de precios y el monitoreo recurrente, incluido el web scraping, para productos en acuerdos marco del gobierno. En Europa, Statistics Iceland extrajo alrededor de 490 precios de gasolina y diésel de sitios web de empresas los viernes durante cada semana de recopilación mensual para su Índice Armonizado de Precios al Consumidor de 2025. Dentro de Oriente Medio y África, un informe del FMI de agosto de 2026 describió el progreso significativo de la Oficina Nacional de Estadísticas de Kenia en la estabilización de la recopilación mediante web scraping para un índice de precios de propiedades residenciales por primera vez, a pesar de los desafíos de calidad de datos y robustez del modelo, especialmente fuera de Nairobi. En Oriente Medio, el Artículo 15 del Reglamento de Finanzas Abiertas de los Emiratos Árabes Unidos restringe el scraping para actividades sujetas a dicho reglamento, excepto cuando lo permitan las leyes aplicables. El alcance del producto local y las condiciones de calidad de los datos definen estos programas de precios, mientras que las actividades financieras cubiertas de los Emiratos Árabes Unidos enfrentan un límite legal adicional.
Marco Regulatorio y Perspectivas
La comparación abarca jurisdicciones seleccionadas desde la perspectiva de los proveedores comerciales que recopilan datos web, incluidos datos personales cuando sus servicios los involucran. El atractivo de la política refleja la claridad y la carga operativa de las normas de acceso y datos personales comparadas para ese proveedor. Las obligaciones dependen de la actividad real del proveedor porque los marcos establecen condiciones diferentes para los métodos de acceso, la recopilación automatizada y el manejo de información personal.
Tabla Regulatoria
| Factor de decisión | Estados Unidos | Brasil | Alemania | China |
|---|---|---|---|---|
| Autoridad principal | Servicio Secreto de los Estados Unidos, entre las agencias de investigación autorizadas | Autoridad Nacional de Protección de Datos (ANPD) | Autoridades competentes de protección de datos de los estados federados (Länder) | Administración del Ciberespacio de China para coordinación, con otras autoridades competentes |
| Instrumentos clave o dirección | Ley de Fraude y Abuso Informático, 18 U.S.C. § 1030 | LGPD, Artículos 3 y 7; orientación sobre agregadores en redacción interna | RGPD Artículo 14; Ley Federal de Protección de Datos § 40; propuesta de Ómnibus Digital | Reglamento de Gestión de Seguridad de Datos de Red, Artículo 18, en vigor desde el 1 de enero de 2025 |
| Efecto comercial | El acceso intencional sin autorización o más allá de la autorización que obtiene información cubierta puede generar exposición penal | El procesamiento de datos personales cubierto territorialmente necesita una base legal del Artículo 7 | Los responsables del tratamiento que obtienen datos personales de forma indirecta deben proporcionar información específica a los interesados, sujeto a las excepciones del Artículo 14 | Los procesadores de datos de red cubiertos que utilizan acceso automatizado deben evaluar los efectos en el servicio; la intrusión e interferencia ilícitas están prohibidas |
| Atractivo actual de la política | Medio | Medio | Medio | Bajo |
| Dirección futura del atractivo de la política | Sin cambios | Endurecimiento | Flexibilización | Sin cambios |
| Fuente: Mordor Intelligence | ||||
Bajo la prueba de acceso basada en conducta de los Estados Unidos, las condiciones de autorización de una ruta de recopilación son una consideración comercial continua. En Brasil, el procesamiento de datos personales cubierto territorialmente necesita una base legal del Artículo 7, mientras que la orientación de la ANPD sobre agregadores permaneció en redacción interna sin consulta pública el 20 de octubre de 2026. Los responsables del tratamiento alemanes que obtienen datos personales de forma indirecta tienen obligaciones de información del Artículo 14 con excepciones, mientras que la propuesta de simplificación del Ómnibus Digital de noviembre de 2025 permaneció en el proceso colegislativo en octubre de 2026. El deber de evaluación de acceso automatizado de China convierte el efecto sobre los servicios de red en una responsabilidad operativa para los procesadores cubiertos, apoyando la continuidad bajo la norma en vigor desde el 1 de enero de 2025.
Etapas de la Cadena de Valor
La cadena de valor compara la configuración del rastreador, la extracción estructurada y el control de calidad necesario para entregar conjuntos de datos utilizables. La distinción comercial central es entre suministrar herramientas de extracción y asumir responsabilidad por los registros resultantes. Un proveedor que abarca varias etapas puede conectar los ingresos de implementación con el trabajo de entrega continua, pero también asume responsabilidad por los fallos que cruzan esas etapas. Los proveedores de herramientas obtienen ingresos por software, mientras que los proveedores que entregan conjuntos de datos verificados obtienen ingresos por servicios y asumen responsabilidad por la etapa de control de calidad.
Tabla de Análisis de la Cadena de Valor
| Actividad principal | Participantes clave | Captura de valor | Cuello de botella | Respuesta de resiliencia |
|---|---|---|---|---|
| Configuración del rastreador | Operadores de rastreadores gestionados como PromptCloud Technologies Pvt Ltd | Ingresos por servicio de extracción gestionada | Definir los campos objetivo y el alcance de la recopilación | Acordar registros de muestra y límites de recopilación antes de escalar |
| Extracción y estructuración de páginas | Proveedores de software de extracción como Bright Data Ltd., Zyte Group Ltd., Apify Technologies s.r.o. | Ingresos por software y API de extracción | Mantener campos consistentes en las variaciones de página | Probar la extracción con tipos de página representativos y validar los campos requeridos |
| Control de calidad y entrega del conjunto de datos | Proveedores de control de calidad y entrega como PromptCloud Technologies Pvt Ltd; proveedores de entrega gestionada como Zyte Group Ltd. | Ingresos por servicio de entrega de datos gestionada | Detectar registros incorrectos antes de la entrega | Combinar la validación de registros con la revisión de excepciones específicas |
| Fuente: Mordor Intelligence | ||||
La combinación de controles de calidad mediante aprendizaje automático y humanos de PromptCloud ilustra una responsabilidad de entrega que va más allá de recopilar el contenido de la página. Esa responsabilidad da a los proveedores gestionados una base para capturar valor a partir de la fiabilidad del conjunto de datos entregado. Una mayor automatización desplazaría la prueba comercial hacia la identificación económica de excepciones, porque una recopilación más grande tiene un valor limitado cuando los registros inutilizables pasan sin ser detectados.
Panorama Competitivo
La competencia está fragmentada entre plataformas integradas y proveedores especializados, con Bright Data Ltd. ofreciendo herramientas de scraping, conjuntos de datos y servicios gestionados. Zyte Group Ltd. suministra API y herramientas para desarrolladores, mientras que Apify Technologies s.r.o. ofrece una plataforma en la nube y servicios profesionales. Octopus Data, Inc. suministra Octoparse, e Import.io Ltd., dentro de Neuralogics, combina la extracción de autoservicio con la entrega gestionada de datos web. Bright Data reportó atender a 14 de los 20 principales laboratorios de modelos de lenguaje de gran escala (LLM) en 2025. El acceso a compradores de laboratorios de LLM crea una posición comercial diferenciada dentro de esta variada base de proveedores, junto con la competencia en formatos superpuestos de software y servicios.
Import.io se unió al grupo Neuralogics en octubre de 2025, conservando su propio nombre, plataforma, clientes y equipos. La empresa está invirtiendo en productos nativos de IA sobre su motor de extracción, situando el desarrollo de productos junto a su oferta de extracción establecida. Zyte describió su Web Scraping Copilot en 2025 como un asistente de IA orientado al código integrado directamente en los flujos de trabajo de los desarrolladores, un enfoque que mantiene a los ingenieros en control de sus propias canalizaciones. Import.io, en cambio, añade productos nativos de IA al motor de extracción que sus clientes existentes ya utilizan, por lo que ambos proveedores amplían las rutinas actuales en lugar de reemplazarlas.
La dirección competitiva se está moviendo hacia una extracción que los agentes de IA pueden solicitar dentro de sus propios flujos de trabajo. El 30 de septiembre de 2026, Zyte introdujo un servidor de Protocolo de Contexto de Modelo (MCP) alojado que pone la API de Zyte y Scrapy Cloud a disposición de agentes de IA y codificación compatibles. La API AgentTools de Octoparse guía a los agentes a través del descubrimiento de plantillas, la validación de parámetros, la extracción en la nube y la exportación de datos, con la ejecución requiriendo una plantilla ejecutable en la nube compatible. Donde se aplican las pruebas territoriales de la LGPD de Brasil, el procesamiento de datos personales necesita una base legal del Artículo 7, mientras que los responsables del tratamiento alemanes que obtienen datos personales de forma indirecta deben proporcionar la información especificada en el Artículo 14 del RGPD, sujeto a sus excepciones. Los especialistas pueden competir haciendo que una tarea de extracción específica sea ejecutable a través de las interfaces de agente que utilizan sus compradores.
Líderes de la Industria de Web Scraping
-
Bright Data Ltd.
-
Zyte Group Ltd.
-
Apify Technologies s.r.o.
-
Octopus Data, Inc.
-
Import.io Ltd.
- *Nota aclaratoria: los principales jugadores no se ordenaron de un modo en especial
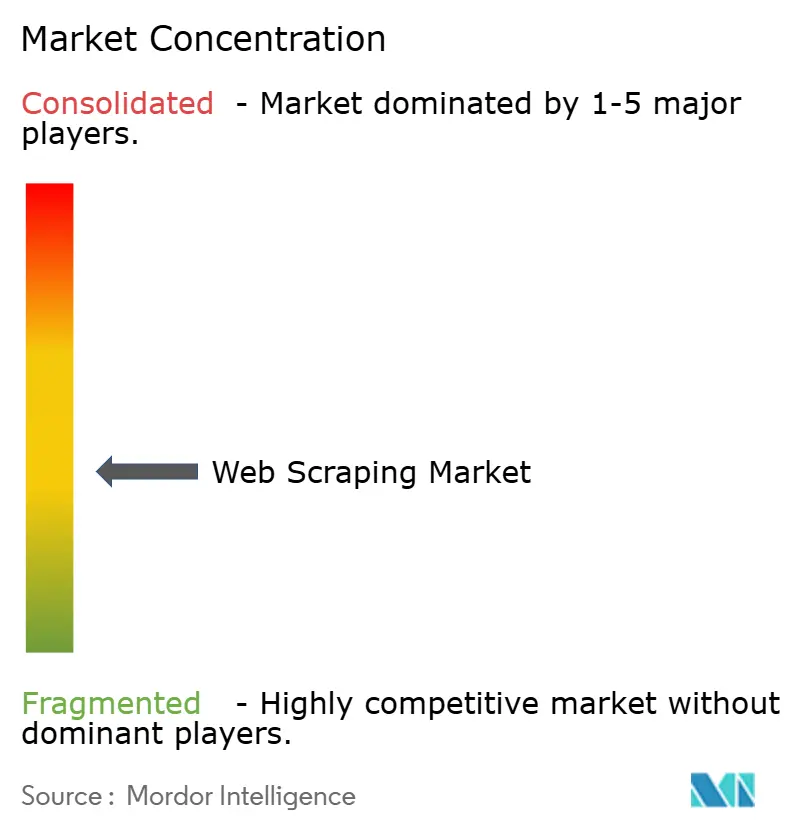
Mercado de Web Scraping Empresas cubiertas en este informe
- Bright Data Ltd.
- Zyte Group Ltd.
- Apify Technologies s.r.o.
- Octopus Data, Inc.
- Import.io Ltd.
- The Phantom Company SAS (PhantomBuster)
- Diffbot Technologies Corp.
- Mozenda, Inc.
- Sequentum Inc.
- ScrapeHero LLC
- ParseHub Inc.
- UAB Oxylabs
- DataWeave Pvt Ltd
- PromptCloud Technologies Pvt Ltd
- DATAANT Sp. z o.o. (ScrapingAnt)
- DataHen Inc.
- Actowiz Solutions LLC
- SysNucleus Software Pvt Ltd (product: WebHarvy)
- PilotFish Technology LLC
- Datopian Ltd.
- Newprosoft LLC
- UAB Data troops (Decodo)
- Datafiniti LLC
- Crawlbase LLC
- Bright Data Labs Ltd.
Oportunidades Clave para los Participantes del Mercado
La comparación de oportunidades se centra en la recopilación de datos de entrenamiento que mejora la cobertura y el control bajo acceso restringido. Inria caracterizó los nuevos datos de entrenamiento públicos en línea como cada vez más escasos en diciembre de 2025, mientras que OECD.AI reportó más de 50 demandas por derechos de autor y protección de datos en todo el mundo para 2025. OECD.AI también reportó que los sitios web utilizaban cada vez más barreras técnicas y contractuales para impedir el scraping. En conjunto, la escasez y las restricciones de acceso favorecen los servicios de recopilación que definen la cobertura utilizable y las condiciones de origen de los registros antes de ampliar un corpus.
Tabla de Oportunidades de Mercado
| Oportunidad | Por qué ahora | Segmento comprador / líder | Estrategia recomendada | Barrera principal | Beneficiarios probables |
|---|---|---|---|---|---|
| Corpus de entrenamiento específicos por sector | Escasez de nuevos datos de entrenamiento públicos | Equipos de entrenamiento de IA y LLM | Definir un sector específico y curar su cobertura de fuentes | Establecer la adecuación del conjunto de datos para el sector elegido | Proveedores de datos especializados como Bright Data Ltd. |
| Recopilación incremental de corpus | Necesidad de nuevo material de entrenamiento público | Equipos de modelos que amplían corpus existentes | Entregar lotes incrementales con fechas de fuente documentadas | Obtener material genuinamente nuevo y utilizable | Proveedores de canalizaciones de datos personalizadas como Bright Data Ltd. |
| Feeds de entrenamiento con registros de origen | Disputas legales y restricciones de recopilación | Desarrolladores de modelos que evalúan los orígenes del corpus | Adjuntar fuente, tiempo de recopilación y condiciones de uso a cada lote | Barreras de acceso técnicas y contractuales | Proveedores de datos web como Bright Data Ltd. |
| Fuente: Mordor Intelligence | |||||
El papel de abastecimiento específico por sector y de canalización personalizada de Bright Data proporciona un punto de partida comercial para el trabajo con datos de entrenamiento. Extender ese papel hacia feeds incrementales o feeds con registros de origen requeriría requisitos de entrega explícitos y una base confirmada para recopilar cada fuente. La apertura más sólida es convertir una recopilación definida de forma específica en un acuerdo de suministro repetible cuyo alcance y origen permanezcan claros a medida que el corpus cambia.
Desarrollos recientes de la industria en Mercado de Web Scraping
- Oct 2026: UAB Oxylabs introdujo Web API, combinando búsqueda web y scraping con análisis impulsado por IA para datos web estructurados.
- Oct 2026: RateGain Travel Technologies Limited anunció que Vietnam Airlines seleccionó AirGain, su plataforma de inteligencia de precios para aerolíneas, para fortalecer la comparación de tarifas y la fijación de precios competitiva.
- Sep 2026: Zyte Group Ltd. introdujo Zyte MCP, incorporando acceso web en tiempo real, extracción estructurada y operaciones de Scrapy Cloud en agentes de codificación.
Mercado de Web Scraping Alcance del informe y metodología de investigación
Definición del Mercado y Cobertura
El mercado global de web scraping mide los ingresos anuales de los proveedores procedentes de software comercial y servicios gestionados que extraen programáticamente el contenido de páginas web públicas para organizaciones pagadoras en todas las industrias y casos de uso. Abarca las ventas de licencias de software y suscripciones, y las tarifas de servicio de ofertas en la nube y locales en todo el mundo.
Exclusiones del alcance: Se excluyen los scripts internos de uso propio ejecutados únicamente dentro de una empresa, los servicios independientes de proxy o rotación de IP, y las herramientas generales de análisis web o SEO que no extraen programáticamente el contenido de páginas web públicas.
Descripción General de la Segmentación
- Por Solución
- Software
- Servicios
- Por Modo de Implementación
- Nube
- Local
- Por Industria de Usuario Final
- Banca, Servicios Financieros y Seguros
- Comercio Minorista y Comercio Electrónico
- Bienes Raíces
- Manufactura
- Gobierno
- Salud
- Publicidad y Medios
- Otros
- Por Caso de Uso
- Extracción de Datos / ETL
- Monitoreo de Precios y Competencia
- Generación de Prospectos e Inteligencia de Ventas
- Datos Financieros Alternativos
- Análisis de Sentimiento y Redes Sociales
- Por Geografía
- América del Norte
- Estados Unidos
- Canadá
- México
- América del Sur
- Brasil
- Argentina
- Resto de América del Sur
- Europa
- Alemania
- Reino Unido
- Francia
- Italia
- España
- Rusia
- Resto de Europa
- Asia-Pacífico
- China
- Japón
- India
- Corea del Sur
- Australia y Nueva Zelanda
- Resto de Asia-Pacífico
- Oriente Medio y África
- Oriente Medio
- Arabia Saudita
- Emiratos Árabes Unidos
- Turquía
- Resto de Oriente Medio
- África
- Sudáfrica
- Nigeria
- Kenia
- Resto de África
- Oriente Medio
- América del Norte
Fuentes de Datos, Dimensionamiento del Mercado y Validación
Investigación Documental
La investigación documental se basa en fuentes como las Ventas Trimestrales de Comercio Electrónico Minorista de la Oficina del Censo de los Estados Unidos para el contexto del comercio minorista en línea, el aviso de la plataforma para desarrolladores de Reddit sobre las condiciones cambiantes de acceso público, el estudio de arXiv sobre extracción web con esquemas definidos para preguntas de rendimiento técnico, y el informe Estado del Web Scraping de Apify para las condiciones operativas reportadas por los profesionales. Estas fuentes ayudan a enmarcar los casos de uso de la demanda, las condiciones de acceso, las necesidades de calidad de los datos y los costos de extracción sin tratar los indicadores adyacentes como ingresos del mercado.
Los archivos de las empresas y los materiales para inversores ayudan a identificar los modelos de ingresos de los proveedores y los límites de los productos, mientras que los contratos públicos adjudicados y la prensa tecnológica y empresarial de reputación pueden aclarar si una transacción cubre software, datos entregados o ambos. Los totales del mercado se contrastan con su base de ingresos declarada, geografía, período e inclusiones. Estas fuentes nombradas son ilustrativas y no exhaustivas, y otras fuentes informan la recopilación, validación y aclaración.
Entrevistas y Encuestas Primarias
El diseño de la investigación utiliza entrevistas estructuradas o encuestas con proveedores de software de web scraping, proveedores de extracción gestionada y compradores organizacionales en finanzas, comercio minorista, medios, manufactura y casos de uso del sector público en APAC, EMEA y las Américas. Los encuestados con responsabilidades de producto, comerciales, de entrega, adquisición y operaciones de datos pueden aclarar los límites de ingresos, las compras en la nube frente a las locales, el uso por parte de los clientes y los cambios en la carga de trabajo de extracción. Las preguntas de los analistas ponen a prueba las interpretaciones de fuentes secundarias e investigan las brechas en los ingresos de los proveedores, la agrupación de servicios, la asignación geográfica y la adopción, y las cuentas se triangularon entre evidencia de proveedores, compradores y pública antes de retener los supuestos.
Distribución de los encuestados del trabajo de campo de investigación primaria
| Tipo de empresa | Cargo del encuestado | Región |
|---|---|---|
| Nivel superior: 35% | Directores ejecutivos: 20% | APAC: 38% |
| Nivel medio: 45% | Líderes funcionales/de unidad: 35% | EMEA: 32% |
| Actores más pequeños: 20% | Gerentes: 45% | Américas: 30% |
Dimensionamiento del Mercado y Previsión
El modelo estima los ingresos anuales globales de los proveedores por software comercial de web scraping y servicios de extracción gestionada, y luego asigna ese total entre solución, implementación, industria de usuario final, caso de uso y geografía del cliente. Una estimación descendente parte de las divulgaciones de ingresos y las estimaciones a nivel de mercado, ajustadas a la venta definida de licencias, suscripciones y servicios de extracción. Las verificaciones ascendentes selectivas comparan los totales de ingresos de los proveedores y los precios de contratos o servicios muestreados multiplicados por los volúmenes estimados de clientes, con las brechas registradas y conciliadas en lugar de tratadas como un censo completo. Los indicadores clave incluyen los ingresos y la combinación de productos de los proveedores, las divulgaciones de clientes y contratos, la adopción en la nube frente a la local, la actividad del comercio minorista y los mercados en línea, y la demanda de datos alternativos en finanzas o medios. Cada uno informa el volumen total de ingresos, las participaciones de segmento o los impulsores de la previsión. Una regresión multivariante puede relacionar la serie anual de ingresos con estos indicadores donde existe un historial consistente, mientras que el análisis de escenarios maneja las discontinuidades como las restricciones de acceso, los cambios legales o las nuevas capacidades de extracción automatizada. Las observaciones faltantes utilizan interpolación documentada o supuestos acotados. Las participaciones de segmento se construyen a partir de divisiones reportadas, evidencia de uso por parte de los clientes, descripciones de productos y asignación de compradores entre industrias y aplicaciones, con el residual asignado solo después de evaluar las categorías respaldadas. Los expertos primarios pueden verificar la razonabilidad de las trayectorias de crecimiento a nivel de variable y los cambios en la combinación de soluciones, y las diferencias no resueltas entre las verificaciones de los proveedores y el total descendente se revisan a través de verificaciones de fuentes y límites.
Ciclo de Validación de Datos y Actualización
Los analistas triangularon las divulgaciones de los proveedores, la evidencia del lado comprador, los contratos públicos y las señales de mercado independientes, y luego verifican los totales, las participaciones, las tasas de crecimiento y las revisiones históricas en busca de anomalías o variaciones materiales. Una revisión de múltiples pasos confirma las fechas y definiciones de las fuentes, comprueba si los valores atípicos reflejan cambios reales o límites inconsistentes, y resuelve los problemas antes de la aprobación. Se activa el recontacto cuando una respuesta material entra en conflicto con la evidencia publicada o deja sin aclarar la propiedad de los ingresos, la agrupación o la geografía. El conjunto de datos se actualiza anualmente, se actualiza entre ciclos para eventos materiales del mercado, y se somete a una revisión previa a la entrega de fuentes, cálculos y coherencia narrativa.
Tamaño del Mercado de Web Scraping de Mordor Intelligence en Comparación con Otras Estimaciones Publicadas
Las estimaciones publicadas pueden diferir en las transacciones y productos que contabilizan y en los insumos utilizados para modelar la demanda. El mercado global de web scraping mide los ingresos anuales de los proveedores procedentes de software comercial y servicios gestionados que extraen programáticamente el contenido de páginas web públicas para organizaciones pagadoras en todas las industrias y casos de uso.
Los factores clave de diferencia incluyen la cobertura definida del estudio y las elecciones de modelado específicas del mercado. Los indicadores clave incluyen los ingresos y la combinación de productos de los proveedores, las divulgaciones de clientes y contratos, la adopción en la nube frente a la local, la actividad del comercio minorista y los mercados en línea, y la demanda de datos alternativos en finanzas o medios.
Comparación de referencia
| Fuente | Tamaño del Mercado | Brechas en la Metodología de Investigación |
|---|---|---|
| Mordor Intelligence | 1,83 mil millones de USD (2027) | |
| Consultora Global A | 990 millones de USD (2025) | En su base de 2025, esta estimación está un 45,9% por debajo del valor de este informe para 2027 de 1,83 mil millones de USD, 2 años después. El año base anterior sitúa la estimación antes del crecimiento posterior del mercado. |
| Consultora Global B | 909,9 millones de USD (2024) | En su base de 2024, esta estimación está un 50,3% por debajo del valor de este informe para 2027 de 1,83 mil millones de USD, 3 años después. La cobertura exclusiva de software excluye los servicios de extracción gestionada, y su año base precede al crecimiento posterior del mercado. |
Los analistas de Mordor Intelligence triangularon las divulgaciones de los proveedores, la evidencia del lado comprador, los contratos públicos y las señales de mercado independientes, y luego verifican los totales, las participaciones, las tasas de crecimiento y las revisiones históricas en busca de anomalías o variaciones materiales.
Preguntas Clave Respondidas en el Informe
¿Cuál es el tamaño del mercado de web scraping y el crecimiento previsto?
El tamaño se estima en 1,83 mil millones de USD en 2027 y se proyecta que alcance 4,03 mil millones de USD para 2032, a un CAGR del 17,08% durante 2027-2032.
¿Qué impulsa la demanda de software y servicios de web scraping?
La expansión del comercio minorista en línea en los Estados Unidos y el desarrollo de arañas web asistido por IA respaldan la demanda. En una encuesta de 2025 realizada a 56 firmas del lado comprador en los Estados Unidos, el Reino Unido y Europa, el 63% planeaba un mayor gasto en datos alternativos.
¿Qué solución lidera los ingresos del web scraping comercial?
El software representó el 57,93% de los ingresos en 2026, mientras que se proyecta que los servicios crezcan a un CAGR del 18,35% durante 2027-2032.
¿Qué empresas son los principales proveedores de software y servicios de web scraping?
Los principales proveedores incluyen Bright Data Ltd., Zyte Group Ltd., Apify Technologies s.r.o., Octopus Data, Inc. e Import.io Ltd., que opera dentro de Neuralogics.
¿Qué desafíos configuran las perspectivas del web scraping comercial?
En una encuesta de diciembre de 2025, el 88,7% de los encuestados reportó mayores costos al apuntar a sitios web protegidos por anti-bots. Para los profesionales del scraping, esa presión de costos puede limitar la cobertura de sitios protegidos y la frecuencia de actualización.
¿Qué región lidera la industria de web scraping comercial y dónde es más rápido el crecimiento?
América del Norte tuvo el 33,94% de los ingresos en 2026, mientras que se prevé que Asia-Pacífico crezca más rápido con un CAGR del 18,35% durante 2027-2032.