
Web-Scraping-Markt Größe und Anteil
Web-Scraping-Marktanalyse von Mordor Intelligence
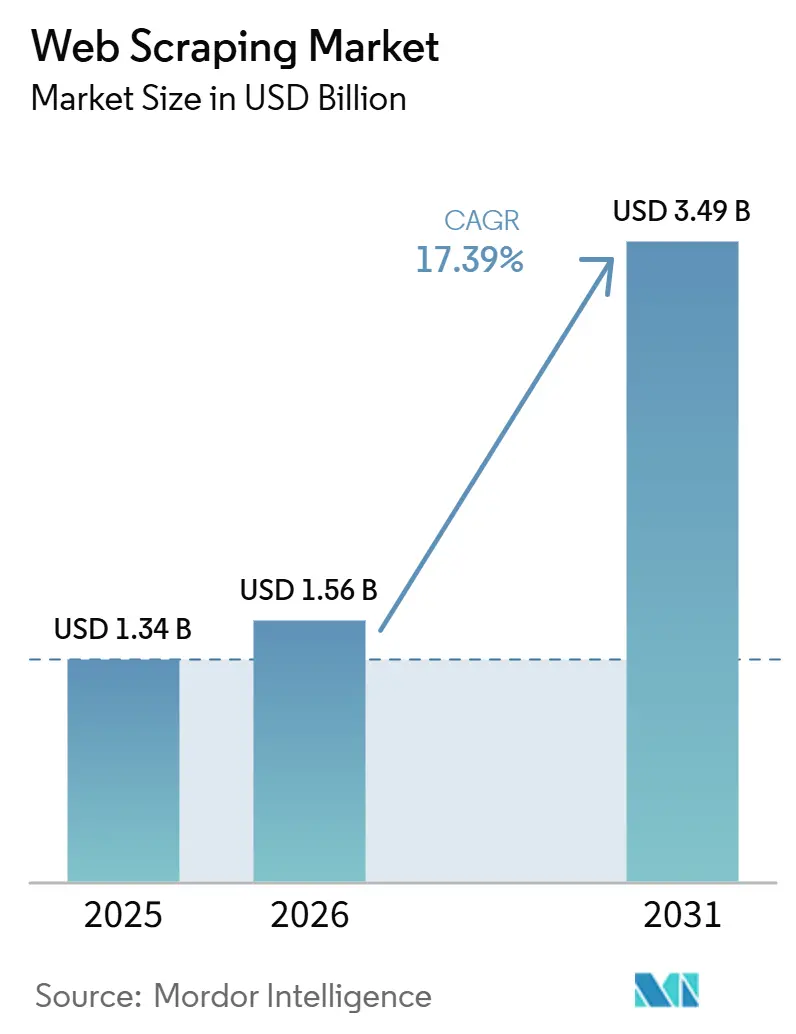
Die Web Scraping Marktgröße wurde im Jahr 2026 auf 1,56 Milliarden USD geschätzt und soll von 1,83 Milliarden USD im Jahr 2027 auf 4,03 Milliarden USD bis 2032 wachsen, bei einer CAGR von 17,08 % während des Prognosezeitraums (2027–2032).
Das Wachstum des Online-Einzelhandels in den Vereinigten Staaten und die Nutzung webbasierter Daten durch Investmentgesellschaften sorgen für eine wiederkehrende Nachfrage nach Datenerhebung. KI-gestützte Extraktion erzeugt schemakonforme Datensätze und liefert Teams definierte Ausgabefelder zur Überprüfung vor der Analyse. Eingeschränkter Plattformzugang erhöht zudem den Wert der Validierung, was jede Erhebungsroute tatsächlich abruft. Anbieter wählen zwischen dem Verkauf wiederverwendbarer Software und der Lieferung fertiger Datensätze und übernehmen dabei Verantwortung für unterschiedliche Teile der Erhebung. Kosten für geschützte Websites und rechtliche Einschränkungen begrenzen, wie umfassend diese Dienste erheben und die Lieferung aufrechterhalten können.
Wichtigste Erkenntnisse des Berichts
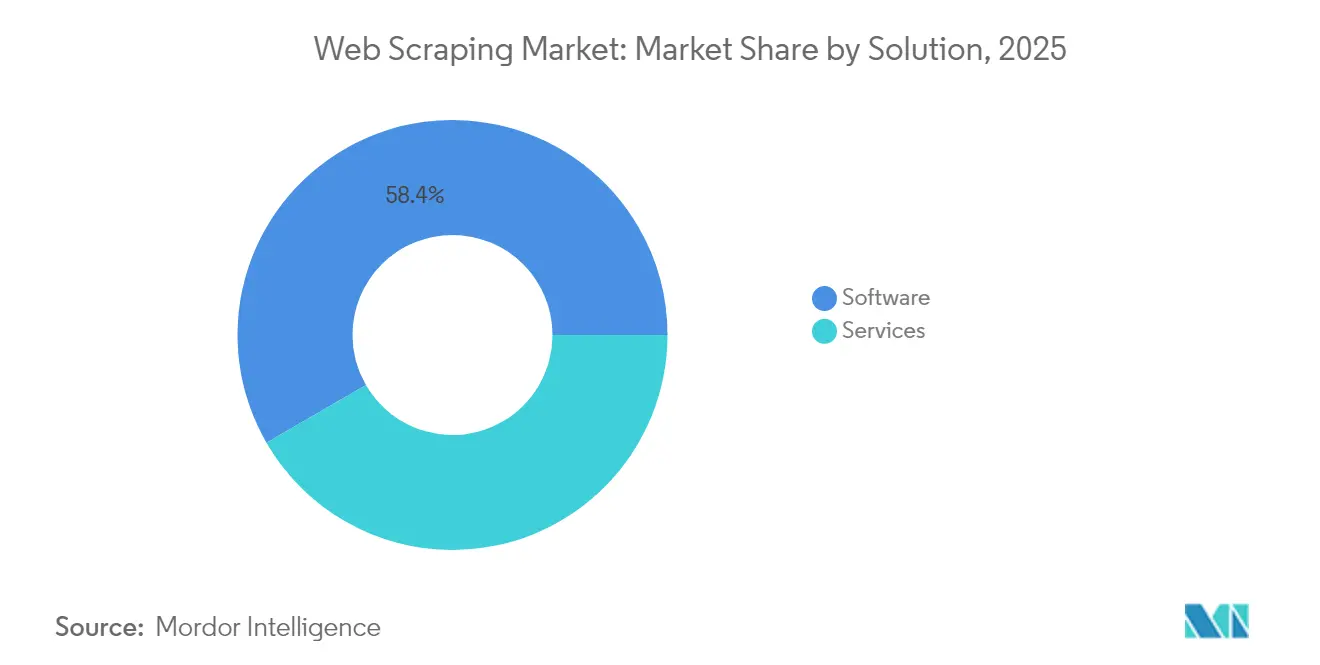
- Im Bereich Lösungen hielt Software im Jahr 2026 einen Web Scraping Marktanteil von 57,93 %, während Dienstleistungen mit einer CAGR von 18,35 % im Zeitraum 2027–2032 am schnellsten wachsen sollen.
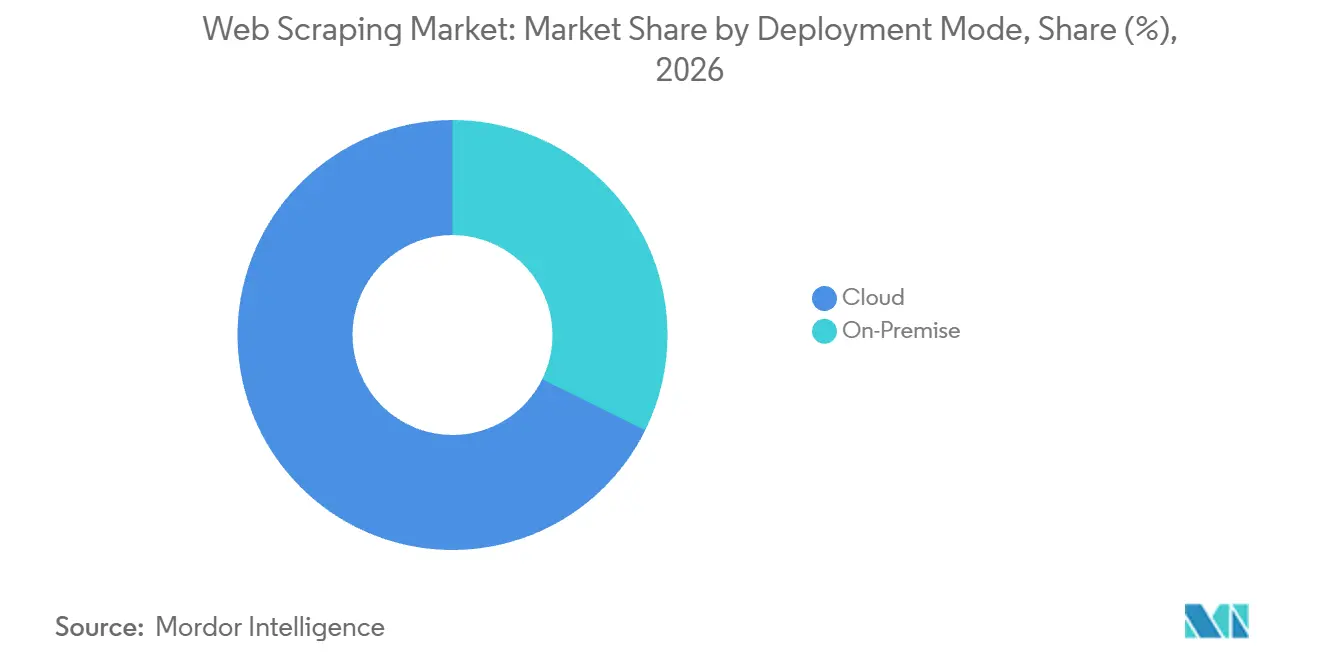
- Die Cloud-Bereitstellung machte im Jahr 2026 einen Anteil von 67,7 % an der Web Scraping Marktgröße aus und soll mit einer CAGR von 17,52 % im Zeitraum 2027–2032 am schnellsten wachsen.
- Unter den Endnutzerbranchen führte BFSI mit 29,39 % des Umsatzes im Jahr 2026, während das Segment Werbung und Medien mit einer CAGR von 18,5 % im Zeitraum 2027–2032 am schnellsten wachsen soll.
- Nach Anwendungsfall führte Daten-Scraping / ETL mit 35,89 % des Umsatzes im Jahr 2026, wobei Preis- und Wettbewerbsüberwachung mit einer CAGR von 18,05 % im Zeitraum 2027–2032 am schnellsten wachsen soll.
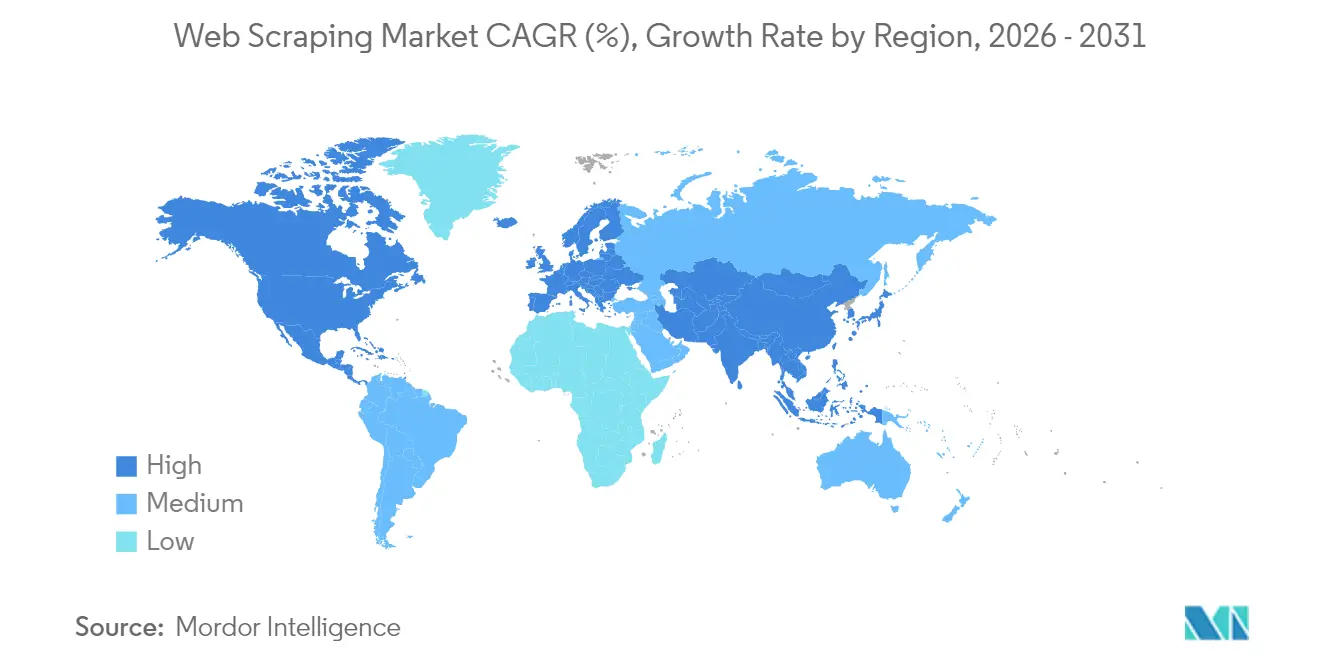
- Geografisch hielt Nordamerika im Jahr 2026 einen Anteil von 33,94 % am Umsatz, während Asien-Pazifik mit einer CAGR von 18,35 % im Zeitraum 2027–2032 am schnellsten wachsen soll.
Hinweis: Die in diesem Bericht angegebenen Marktzahlen basieren auf dem proprietären Schätzrahmen von Mordor Intelligence, der neun Monate an Ist-Daten mit den Prognosen für das vierte Quartal des Basisjahres 2026 kombiniert.
Markttrends und Einblicke
Analyse der Auswirkungen von Wachstumstreibern*
| Treiber | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Wachstum des E-Commerce und der Online-Marktplätze | +5.1% | Nordamerika und Asien-Pazifik | Kurzfristig (≤ 2 Jahre) |
| Fortschritte in KI/ML zur Datenextraktion | +4.6% | Nordamerika, Europa und Asien-Pazifik | Kurzfristig (≤ 2 Jahre) |
| Steigende Nachfrage nach alternativen Daten im Finanzbereich | +4.1% | Nordamerika und Europa | Mittelfristig (2–4 Jahre) |
| Abschaffung von APIs auf großen Plattformen treibt Scraping voran | +3.6% | Vereinigte Staaten und Europa | Kurzfristig (≤ 2 Jahre) |
| Trainingsdatenanforderungen für generative KI | +3.2% | Nordamerika und Asien-Pazifik | Langfristig (≥ 4 Jahre) |
| Open-Data-Mandate decken Datenlücken auf | +1.8% | Deutschland, Frankreich und Spanien | Mittelfristig (2–4 Jahre) |
| Quelle: Mordor Intelligence | |||
Wachstum des E-Commerce und der Online-Marktplätze
Ein größeres Volumen an Online-Verkäufen erhöht den kommerziellen Wert der Beobachtung von Preisen und Verfügbarkeit in digitalen Verkaufskanälen. Die saisonbereinigten US-amerikanischen Einzelhandels-E-Commerce-Umsätze erreichten im zweiten Quartal 2026 340,2 Milliarden USD, ein Anstieg von 12,2 % (±0,9 %) gegenüber dem zweiten Quartal 2025 ohne Preisbereinigung. Der gesamte US-amerikanische Einzelhandelsumsatz stieg im gleichen Zeitraum um 6,7 % (±0,5 %), sodass Online-Preisbeobachtungen einen Kanal betreffen, der an Umsatzgewicht gewinnt. Für Einzelhändler, die ein wiederkehrendes Produktsortiment verfolgen, besteht die Erhebungsaufgabe darin, Preisänderungen von Sortimentsänderungen zu trennen. Der Vergleich übereinstimmender Produkte über mehrere Erhebungsläufe hinweg kann die nächste Angebotsanpassung auf der Grundlage der Neupreisgestaltung eines Wettbewerbers statt einer scheinbaren Preisverschiebung durch einen anderen Produktmix fundieren.
Fortschritte in KI/ML zur Datenextraktion
KI-gestützte Spider-Entwicklung kann die Bandbreite der Zielseiten erweitern, die ein Erhebungsteam wirtschaftlich pflegen kann. Im zweiten und dritten Quartal 2025 erfasste ScrapeGraphAI rund 9 Millionen Opt-in-Telemetrieereignisse aus dem Produktionseinsatz seiner Open-Source-Webextraktionsbibliothek. Die Forscher deduplizierten und balancierten diese Rohereignisse nach Schema zu einem veröffentlichten Datensatz von 93.695 Extraktionsereignissen. Im März 2026 stellte Zyte Web Scraping Copilot 1.0 allgemein zur Verfügung, eine Visual Studio Code-Erweiterung, die KI nutzt, um Scrapy-Spider zu generieren, zu testen und bereitzustellen. Die Integration dieser Aufgaben in die Entwicklungsumgebung kann den Engineering-Aufwand pro Zielseite reduzieren und den wirtschaftlich tragfähigen Umfang des Scrapy-basierten Programms eines Teams erweitern.
Steigende Nachfrage nach alternativen Daten im Finanzbereich
In einer Umfrage von September bis Oktober 2025 unter 56 Buy-Side-Unternehmen in den Vereinigten Staaten, dem Vereinigten Königreich und Europa stellte Crisil Coalition Greenwich fest, dass 63 % der Investoren planten, ihre Ausgaben für alternative Daten zu erhöhen. In einer Offenlegung vom März 2026 erklärte AQR, dass sein Berater alternative Daten zur Verwaltung bestimmter Fonds verwendet, darunter Verbraucherverhalten, Stimmung in sozialen Medien sowie Daten zu Internetsuche und -traffic. Diese Offenlegung warnte davor, dass die oft weniger robuste IT-Infrastruktur der Anbieter dazu führen kann, dass Datensätze ausgesetzt, verzögert oder nicht verfügbar sind. Ausgabenabsichten erweitern die potenzielle Chance für Anbieter alternativer Daten, während AQRs Warnung vor möglichen Unterbrechungen die Bedeutung der Versorgungskontinuität unterstreicht. Für Investmentteams kann eine Anbieterunterbrechung beim nächsten Update einen Modellinput entfernen. Versorgungskontinuität kann dann ansonsten geeignete Datenanbieter voneinander unterscheiden.
Abschaffung von APIs auf großen Plattformen treibt Scraping voran
In Interviews, die von Oktober 2024 bis Februar 2025 durchgeführt wurden, beschrieben Forscher sozialer Medien Web Scraping als Alternative zu Plattform-APIs und äußerten rechtliche, ethische und Zuverlässigkeitsbedenken. Reddit gab am 5. August 2026 bekannt, neue öffentliche API-Anfragen schrittweise einzuschränken.[1] Reddit plant außerdem, ab dem 12. Januar 2027 den Datenzugang über die Data API für nicht registrierte oder inaktive Apps und Nutzer schrittweise zu entfernen und den verbleibenden öffentlichen API-Zugang im März 2027 zu beenden. Eine TikTok-Studie aus dem Jahr 2026 ergab, dass API- und Frontend-Scraping-Tools Inhalte mit unterschiedlichen Zeiträumen und Popularitätsniveaus abriefen. Für Käufer, die mit eingeschränktem Zugang konfrontiert sind, ist eine alternative Erhebungsroute nur dann kommerziell nützlich, wenn ihre Ausgabe zur beabsichtigten Analyse passt. Reddits Plan, den verbleibenden öffentlichen API-Zugang im März 2027 zu beenden, gibt Teams, die derzeit auf API-Abrufe angewiesen sind, ein festes Datum, bis zu dem jede Ersatzroute auf ihre Abdeckung geprüft sein muss.
Analyse der Auswirkungen von Hemmnissen*
| Hemmnis | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Rechtliche und ethische Unsicherheit | -2.2% | Vereinigte Staaten und China | Mittelfristig (2–4 Jahre) |
| Hohe Kosten und technische Komplexität | -1.6% | Vereinigte Staaten und Vereinigtes Königreich | Kurzfristig (≤ 2 Jahre) |
| Fortschrittliche Bot-Abwehrtools erhöhen Fehlerquoten | -1% | Vereinigte Staaten und Vereinigtes Königreich | Kurzfristig (≤ 2 Jahre) |
| Offizielle APIs kannibalisieren einige Scraping-Anwendungsfälle | -0.5% | Nordamerika und Europa | Mittelfristig (2–4 Jahre) |
| Quelle: Mordor Intelligence | |||
Rechtliche und ethische Unsicherheit
Ein Datensatz kann seinen kommerziellen Nutzen verlieren, wenn die Methode seiner Beschaffung eine Löschpflicht begründet. Im Juli 2025 erklärte LinkedIn, dass seine Einigung Proxycurl verpflichtete, auf unrechtmäßigem Wege beschaffte LinkedIn-Daten dauerhaft zu löschen und den unrechtmäßigen Zugang zu LinkedIn einzustellen. LinkedIn beschrieb den Fall als unbefugtes Scraping unter Verwendung gefälschter Konten und anderer betrügerischer Aktivitäten. Für einen Käufer würde eine vergleichbare Einschränkung Arbeitsabläufe stören, die von den betroffenen Datensätzen abhängen. Dieselbe Einigung untersagte Proxycurl weiteren unrechtmäßigen Zugang zu LinkedIn, sodass die Route, die die gelöschten Datensätze erzeugt hatte, nicht zur Wiederherstellung genutzt werden konnte.
Hohe Kosten und technische Komplexität
Geschützte Websites schaffen eine Kostenschwelle, die die wirtschaftliche Reichweite eines Scraping-Programms einschränken kann. In einer Umfrage vom Dezember 2025 berichteten 88,7 % der Befragten von gestiegenen Kosten beim Targeting von Websites, die durch Anti-Bot-Maßnahmen geschützt sind.[2] Für Scraping-Praktiker erhöhen höhere Erhebungskosten den Ressourcenaufwand, um geschützte Ziele in ein Programm aufzunehmen. Diese Belastung erhöht den Aufwand für das Hinzufügen jedes geschützten Ziels zu einem Programm, was die Anzahl solcher Ziele, die ein Team übernimmt, begrenzen kann. Größere Abdeckung oder häufigere Erhebung muss den berichteten Kostendruck absorbieren.
*Unsere Prognosen behandeln die Auswirkungen von Treibern und Einschränkungen als richtungsweisend und nicht additiv. Die Wirkungsprognosen berücksichtigen Basiswachstum, Mischungseffekte und Wechselwirkungen zwischen Variablen.
Segmentanalyse
Nach Lösung:
Wiederverwendbare Software führt, während Datendienste expandierenSoftware machte im Jahr 2026 einen Anteil von 57,93 % an der Web Scraping Marktgröße aus. Apify meldet eine weltweite Kundenbasis von 91.000 für seine Web Scraping- und Browser-Automatisierungsplattform. Mit einer Softwareplattform kann ein Käufer die von ihm konfigurierte Extraktionslogik behalten und auf aufeinanderfolgende Erhebungsläufe anwenden. Wiederkehrende Erhebungen ziehen wirtschaftlichen Nutzen aus wiederverwendbarem Code und Workflow-Konfiguration, da sie auf einer bestehenden Implementierung aufbauen. Die Plattform kann durch gemeinsam genutzte Ausführungsinfrastruktur skalieren und dabei kundenspezifische Routinen beibehalten.
Dienstleistungen sind das am schnellsten wachsende Segment mit einer prognostizierten CAGR von 18,35 % im Zeitraum 2027–2032. Am 1. Dezember 2025 vergab Statistics Canada einen Auftrag an Mobius365 Knowledge Services, Inc. für web-gescrapte Daten von kanadischen Websites.[3] Der Auftrag umfasste statistische und Forschungszwecke vom 1. April 2026 bis zum 31. März 2027 mit 4 einjährigen Verlängerungsoptionen. Die Behörde spezifizierte, dass sie Daten beschafft, wobei der Vertrag auf gelieferte Informationen und nicht auf Software oder eine SaaS-Lizenz ausgerichtet war. Der potenzielle Verlängerungswert hängt von der Leistung beim angeforderten Datensatz im Rahmen einer fortlaufenden Datenlieferverpflichtung ab.
Notiz: Segmentanteile aller einzelnen Segmente sind nach dem Berichtskauf verfügbar
Nach Bereitstellungsmodus:
Cloud-Skalierung trifft auf BetreiberkontrolleCloud repräsentierte im Jahr 2026 einen Web Scraping Marktanteil von 67,7 % und ist das am schnellsten wachsende Segment mit einer CAGR von 17,52 % im Zeitraum 2027–2032. Apify betreibt seine Web Scraping-, Datenextraktions- und Automatisierungsplattform in der Cloud über serverlose Programme, sogenannte Actors. Das Unternehmen berichtet, monatlich mehr als 1 Petabyte an Daten über diese Plattform zu verarbeiten. Die vom Anbieter betriebene Ausführung kann für einen Käufer geeignet sein, dessen Erhebungsbedarf von Lauf zu Lauf variiert, da die Kapazität unabhängig von der Definition der angeforderten Datensätze betrachtet werden kann. Cloud konzentriert die Kapazitätsverpflichtung beim Plattformanbieter, sodass ein Käufer umfangreiche Erhebungen durchführen kann, ohne jede Umgebung separat bereitzustellen.
Die On-Premise-Bereitstellung stellt die Erhebungsumgebung unter die direkte Kontrolle des Betreibers und bringt Konfiguration und Wartung in dieselbe organisatorische Grenze. Für eine Organisation, die erfordert, dass erhobene Datensätze und Extraktionsprotokolle im eigenen Netzwerk verbleiben, entspricht die lokale Ausführung dieser internen Anforderung. Die Organisation muss dann den Crawler-Betrieb, die Proxy-Konfiguration und Parser-Reparaturen als Teil des Erhebungsprogramms personell besetzen. Ein sich änderndes Seitenlayout kann die Zeit dieses Teams in Anspruch nehmen, selbst wenn die gewünschten Datenfelder gleich bleiben. Das Argument für die Beibehaltung der lokalen Ausführung beruht auf dieser internen Datenverarbeitungsanforderung, wobei die Parser-Pflege als fortlaufende Kosten für deren Erfüllung behandelt wird.
Notiz: Segmentanteile aller einzelnen Segmente sind nach dem Berichtskauf verfügbar
Nach Endnutzerbranche:
Investment-Workflows und Werbeintelligenz prägen die NachfrageBFSI war das größte Segment und repräsentierte im Jahr 2026 29,39 % des Marktumsatzes. Die Umfrage von Lowenstein Sandler aus dem Jahr 2025 umfasste Befragte aus Private-Equity-Unternehmen, Hedgefonds-Managern und Risikokapitalgesellschaften. Sie identifizierte Web Scraping unter den Datenquellen, die in maßgeschneiderten KI-Systemen für Anlageforschung, Portfoliooptimierung oder Handel eingesetzt werden. Für solche Käufer liefert die Extraktion potenzielle Modellinputs, während Anlageforschung, Portfoliooptimierung und Handel unterschiedliche Entscheidungen darüber beinhalten, wie diese Inputs verwendet werden sollen. Die Anpassung gelieferter Variablen an eine Investitionsaufgabe gibt einem Extraktionsanbieter eine klare Grundlage für Integrationsarbeiten innerhalb des Modells, das diese Datensätze verwendet.
Das Segment Werbung und Medien ist das am schnellsten wachsende Segment mit einer prognostizierten CAGR von 18,5 % im Zeitraum 2027–2032. Adbeat crawlt täglich 1,3 Millionen Seiten und erkennt, analysiert und verarbeitet täglich 3,8 Millionen Anzeigen. Die tägliche Verarbeitung in diesem Umfang zeigt, wie Werbeintelligenz wiederkehrende Seitenabruf- und Anzeigenverarbeitungsworkloads erzeugt. Für Werbetreibende, die konkurrierende Kampagnen vergleichen, kann das Erheben desselben Publisher-Sets an aufeinanderfolgenden Tagen neue Platzierungen von früheren Beobachtungen unterscheiden. Die kommerzielle Chance liegt in der Pflege dieser Kampagnenhistorie, sodass die Erhebungsfrequenz neben der Anzahl der abgedeckten Seiten von Bedeutung ist.
Nach Anwendungsfall:
Wiederholbare Pipelines unterstützen WettbewerbstransparenzDaten-Scraping / ETL war das größte Segment und machte im Jahr 2026 35,89 % des Marktumsatzes aus. Dieser Anwendungsfall wandelt Webseiten in strukturierte Datensätze um, die durch Extraktions-, Transformations- und Ladeschritte verarbeitet werden können. Seine wirtschaftliche Rolle ist horizontal, da dieselbe Erhebungsinfrastruktur mehrere nachgelagerte Analysen speisen kann, ohne eine einzige Entscheidung vorzuschreiben. Für einen Käufer, der mehrere Webquellen kombiniert, ist die entscheidende Designentscheidung, wo Datensätze standardisiert werden sollen, bevor sie in andere Systeme übergeben werden. An diesem Übergabepunkt kann ein Extraktionsanbieter zuverlässige Inputs unabhängig von der nachgelagerten Analysesoftware verkaufen.
Preis- und Wettbewerbsüberwachung ist das am schnellsten wachsende Segment mit einer prognostizierten CAGR von 18,05 % im Zeitraum 2027–2032. Am 7. Oktober 2026 gab RateGain Travel Technologies bekannt, dass Vietnam Airlines seine Preisintelligenplattform AirGain ausgewählt hatte. Die angekündigte Abdeckung umfasste mehr als 300 Fluggesellschaften, mehr als 170 Online-Reisebüros und mehr als 50 Metasuch-Plattformen. Diese Breite zeigt, warum Wettbewerbsüberwachung einen Beobachtungsrahmen benötigt, der sowohl direkte Anbieter als auch Vermittler abdeckt, da die gewählten Kanäle definieren, was der Datensatz repräsentiert. Die relevante Abdeckungsentscheidung ist, welche Fluggesellschafts- und Vermittlerkanäle gemeinsam überwacht werden sollen, da ein nur auf Fluggesellschaften ausgerichteter Feed eine engere Preisfrage adressieren würde.
Geografische Analyse
Web-Scraping-Markt Nordamerika
Nordamerika machte im Jahr 2026 einen Anteil von 33,94 % an der Web Scraping Marktgröße aus. Die CPI-Programmdetails von Statistics Canada vom Oktober 2025 identifizieren automatisiertes Web Scraping, Einzelhändler-Transaktionsdateien und manuelle Online-Erhebung als nicht-traditionelle Preisquellen. Ein gemischtes Quellenprogramm bettet Webextraktion in ein bestehendes Messsystem ein, bei dem Preisvergleiche teilweise vom Erhebungskanal abhängen. Für den statistischen Betreiber muss eine automatisierte Preisreihe in denselben monatlichen Produktionszyklus passen wie Transaktionsdateien und manuell erhobene Beobachtungen.
Web Scraping Markt Asien-Pazifik
Asien-Pazifik ist die am schnellsten wachsende Region mit einer prognostizierten CAGR von 18,35 % im Zeitraum 2027–2032. Die nationale Statistikbehörde Indonesiens nutzte über ihre Einheit für Distributions- und Dienstleistungsstatistiken im Jahr 2025 Web Scraping, um Preise für mehrere Waren von Marktplatz-Websites zu erheben. Seit Juni 2026 nutzt das Australische Statistikamt Web Scraping, um Preis-, Produkt- und andere Informationen von bestimmten Websites für statistische Zwecke zu extrahieren. Für den australischen Verbraucherpreisindex erklärt das Australische Statistikamt, dass web-gescrapte Daten eine 500-fache Steigerung der erhobenen Preise im Vergleich zur manuellen Erhebung darstellen. Die Verlagerung der Preiserhebung von manuellen Besuchen zu automatisierten Routinen erweitert die Beobachtungen, die ein Programm aktualisieren kann, und erhöht die Extraktionsworkloads innerhalb dieser statistischen Verwendungen.
In Südamerika suchte ChilCompras Ausschreibung vom Januar 2026 nach Massenpreiserfassung und wiederkehrender Überwachung, einschließlich Web Scraping, für Produkte in staatlichen Rahmenvereinbarungen. In Europa scrapte Statistics Iceland im Rahmen seines Harmonisierten Verbraucherpreisindex 2025 freitags während jeder monatlichen Erhebungswoche rund 490 Benzin- und Dieselpreise von Unternehmenswebsites. Im Nahen Osten und Afrika beschrieb ein IWF-Bericht vom August 2026 die erheblichen Fortschritte des Kenianischen Nationalen Statistikamts bei der Stabilisierung der Web Scraping-Erhebung für einen erstmaligen Wohnimmobilienpreisindex, trotz Herausforderungen bei der Datenqualität und Modellrobustheit, insbesondere außerhalb Nairobis. Im Nahen Osten schränkt Artikel 15 der VAE-Verordnung über offene Finanzen das Scraping für Aktivitäten ein, die dieser Verordnung unterliegen, außer soweit nach geltendem Recht zulässig. Lokaler Produktumfang und Datenqualitätsbedingungen definieren diese Preisprogramme, während abgedeckte VAE-Finanzaktivitäten einer zusätzlichen rechtlichen Grenze unterliegen.
Regulatorischer Rahmen und Ausblick
Der Vergleich umfasst ausgewählte Rechtsordnungen aus der Perspektive kommerzieller Anbieter, die Webdaten erheben, einschließlich personenbezogener Daten, soweit ihre Dienste diese beinhalten. Die politische Attraktivität spiegelt die Klarheit und den operativen Aufwand der verglichenen Zugangs- und Datenschutzregeln für diesen Anbieter wider. Die Verpflichtungen hängen von der tatsächlichen Tätigkeit des Anbieters ab, da die Rahmenwerke unterschiedliche Bedingungen für Zugangsverfahren, automatisierte Erhebung und den Umgang mit personenbezogenen Informationen festlegen.
Regulatorische Tabelle
| Entscheidungsfaktor | Vereinigte Staaten | Brasilien | Deutschland | China |
|---|---|---|---|---|
| Primäre Behörde | United States Secret Service, unter anderem zuständige Ermittlungsbehörden | Nationale Datenschutzbehörde (ANPD) | Zuständige Landesdatenschutzbehörden | Cyberspace Administration of China für die Koordinierung, zusammen mit anderen zuständigen Behörden |
| Wesentliche Instrumente oder Ausrichtung | Computer Fraud and Abuse Act, 18 U.S.C. § 1030 | LGPD, Artikel 3 und 7; Aggregatorleitlinien in interner Ausarbeitung | DSGVO Artikel 14; Bundesdatenschutzgesetz § 40; Digitales-Omnibus-Vorschlag | Verordnung zur Verwaltung der Netzwerkdatensicherheit, Artikel 18, in Kraft seit dem 1. Januar 2025 |
| Kommerzielle Auswirkung | Vorsätzlicher Zugang ohne oder über die Autorisierung hinaus, der abgedeckte Informationen erlangt, kann strafrechtliche Konsequenzen auslösen | Territorial abgedeckte Verarbeitung personenbezogener Daten benötigt eine Rechtsgrundlage nach Artikel 7 | Verantwortliche, die personenbezogene Daten indirekt erlangen, müssen betroffenen Personen bestimmte Informationen bereitstellen, vorbehaltlich der Ausnahmen nach Artikel 14 | Abgedeckte Netzwerkdatenverarbeiter, die automatisierten Zugang nutzen, müssen die Auswirkungen auf den Dienst bewerten; rechtswidrige Eingriffe und Störungen sind verboten |
| Aktuelle politische Attraktivität | Mittel | Mittel | Mittel | Niedrig |
| Zukünftige Entwicklung der politischen Attraktivität | Keine Änderung | Verschärfung | Lockerung | Keine Änderung |
| Quelle: Mordor Intelligence | ||||
Unter dem verhaltensbasierten Zugangsprüfungstest der Vereinigten Staaten sind die Autorisierungsbedingungen einer Erhebungsroute eine fortlaufende kommerzielle Überlegung. In Brasilien benötigt territorial abgedeckte Verarbeitung personenbezogener Daten eine Rechtsgrundlage nach Artikel 7, während die Aggregatorleitlinien der ANPD am 20. Oktober 2026 ohne öffentliche Konsultation in interner Ausarbeitung verblieben. Deutsche Verantwortliche, die personenbezogene Daten indirekt erlangen, unterliegen den Informationspflichten nach Artikel 14 mit Ausnahmen, während der Vereinfachungsvorschlag des Digitalen Omnibus vom November 2025 im Oktober 2026 noch im Mitentscheidungsverfahren war. Chinas Pflicht zur Bewertung des automatisierten Zugangs macht die Auswirkung auf Netzwerkdienste zu einer operativen Verantwortung für abgedeckte Verarbeiter und unterstützt die Kontinuität unter der seit dem 1. Januar 2025 geltenden Regelung.
Stufen der Wertschöpfungskette
Die Wertschöpfungskette vergleicht die Crawler-Einrichtung, die strukturierte Extraktion und die Qualitätskontrolle, die zur Lieferung verwendbarer Datensätze erforderlich ist. Die zentrale kommerzielle Unterscheidung besteht zwischen der Bereitstellung von Extraktionswerkzeugen und der Übernahme von Verantwortung für die resultierenden Datensätze. Ein Anbieter, der mehrere Stufen abdeckt, kann Implementierungserlöse mit fortlaufender Lieferarbeit verbinden, übernimmt aber auch Verantwortung für Fehler, die diese Stufen überschreiten. Werkzeuganbieter erzielen Softwareerlöse, während Anbieter, die geprüfte Datensätze liefern, Dienstleistungserlöse erzielen und die Verantwortung für die Qualitätskontrollstufe tragen.
Tabelle zur Wertschöpfungskettenanalyse
| Primäre Aktivität | Wesentliche Teilnehmer | Wertschöpfung | Engpass | Resilienzreaktion |
|---|---|---|---|---|
| Crawler-Einrichtung | Verwaltete Crawler-Betreiber wie PromptCloud Technologies Pvt Ltd | Erlöse aus verwalteten Extraktionsdiensten | Definition von Zielfeldern und Erhebungsumfang | Musterdatensätze und Erhebungsgrenzen vor der Skalierung vereinbaren |
| Seitenextraktion und Strukturierung | Extraktionssoftwareanbieter wie Bright Data Ltd., Zyte Group Ltd., Apify Technologies s.r.o. | Software- und Extraktions-API-Erlöse | Aufrechterhaltung konsistenter Felder über Seitenvariationen hinweg | Extraktion gegen repräsentative Seitentypen testen und erforderliche Felder validieren |
| Qualitätskontrolle und Datensatzlieferung | Qualitätskontroll- und Lieferanbieter wie PromptCloud Technologies Pvt Ltd; verwaltete Lieferanbieter wie Zyte Group Ltd. | Erlöse aus verwalteten Datenlieferdiensten | Erkennung fehlerhafter Datensätze vor der Lieferung | Datensatzvalidierung mit gezielter Ausnahmeprüfung kombinieren |
| Quelle: Mordor Intelligence | ||||
PromptClouds Kombination aus maschinellem Lernen und menschlichen Qualitätsprüfungen veranschaulicht eine Lieferverantwortung, die über das Erheben von Seiteninhalten hinausgeht. Diese Verantwortung gibt verwalteten Anbietern eine Grundlage, um Wert aus der Zuverlässigkeit des gelieferten Datensatzes zu schöpfen. Weitere Automatisierung würde den kommerziellen Test in Richtung der wirtschaftlichen Identifizierung von Ausnahmen verschieben, da eine größere Erhebung begrenzten Wert hat, wenn unbrauchbare Datensätze unentdeckt durchlaufen.
Wettbewerbslandschaft
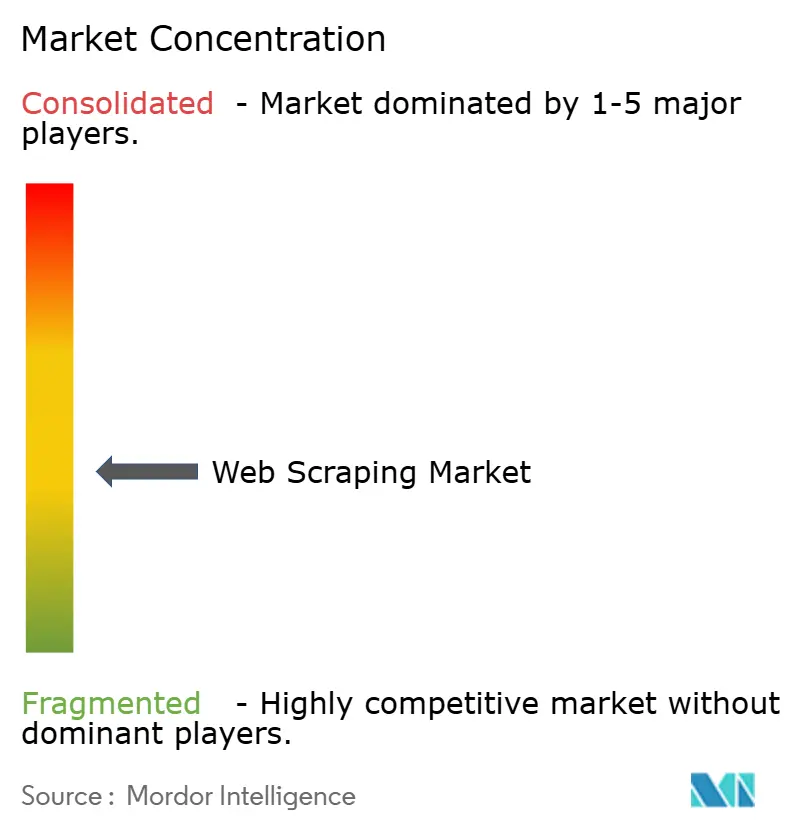
Der Wettbewerb ist fragmentiert zwischen integrierten Plattformen und spezialisierten Anbietern, wobei Bright Data Ltd. Scraping-Tools, Datensätze und verwaltete Dienste anbietet. Zyte Group Ltd. liefert APIs und Entwicklerwerkzeuge, während Apify Technologies s.r.o. eine Cloud-Plattform und professionelle Dienste anbietet. Octopus Data, Inc. liefert Octoparse, und Import.io Ltd., innerhalb von Neuralogics, kombiniert Self-Service-Extraktion mit verwalteter Webdatenlieferung. Bright Data berichtete, im Jahr 2025 14 der 20 größten Large Language Model (LLM)-Labore zu bedienen. Der Zugang zu LLM-Labor-Käufern schafft einen eigenständigen kommerziellen Stützpunkt innerhalb dieser vielfältigen Anbieterbasis, neben dem Wettbewerb über überlappende Software- und Dienstleistungsformate.
Import.io trat im Oktober 2025 der Neuralogics-Gruppe bei und behielt dabei seinen eigenen Namen, seine Plattform, Kunden und Teams. Das Unternehmen investiert in KI-native Produkte auf Basis seiner Extraktions-Engine und stellt die Produktentwicklung neben sein etabliertes Extraktionsangebot. Zyte beschrieb seinen Web Scraping Copilot im Jahr 2025 als einen code-first KI-Assistenten, der direkt in die Workflows der Entwickler eingebettet ist – ein Ansatz, der Ingenieure in der Kontrolle über ihre eigenen Pipelines lässt. Import.io hingegen fügt KI-native Produkte zur Extraktions-Engine hinzu, die seine bestehenden Kunden bereits nutzen, sodass beide Anbieter bestehende Routinen erweitern statt sie zu ersetzen.
Die Wettbewerbsrichtung bewegt sich hin zu einer Extraktion, die KI-Agenten innerhalb ihrer eigenen Workflows anfordern können. Am 30. September 2026 führte Zyte einen gehosteten Model Context Protocol (MCP)-Server ein, der Zyte API und Scrapy Cloud für kompatible KI- und Coding-Agenten verfügbar macht. Die AgentTools API von Octoparse führt Agenten durch Template-Erkennung, Parametervalidierung, Cloud-Extraktion und Datenexport, wobei die Ausführung ein unterstütztes cloud-ausführbares Template erfordert. Wo Brasiliens LGPD-Territorialtests gelten, benötigt die Verarbeitung personenbezogener Daten eine Rechtsgrundlage nach Artikel 7, während deutsche Verantwortliche, die personenbezogene Daten indirekt erlangen, die in DSGVO Artikel 14 festgelegten Informationen bereitstellen müssen, vorbehaltlich seiner Ausnahmen. Spezialisten können konkurrieren, indem sie eine enge Extraktionsaufgabe über die Agentenschnittstellen ausführbar machen, die ihre Käufer verwenden.
Marktführer im Web Scraping Bereich
-
Bright Data Ltd.
-
Zyte Group Ltd.
-
Apify Technologies s.r.o.
-
Octopus Data, Inc.
-
Import.io Ltd.
- *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert
Web Scraping Markt Unternehmen in diesem Bericht
- Bright Data Ltd.
- Zyte Group Ltd.
- Apify Technologies s.r.o.
- Octopus Data, Inc.
- Import.io Ltd.
- The Phantom Company SAS (PhantomBuster)
- Diffbot Technologies Corp.
- Mozenda, Inc.
- Sequentum Inc.
- ScrapeHero LLC
- ParseHub Inc.
- UAB Oxylabs
- DataWeave Pvt Ltd
- PromptCloud Technologies Pvt Ltd
- DATAANT Sp. z o.o. (ScrapingAnt)
- DataHen Inc.
- Actowiz Solutions LLC
- SysNucleus Software Pvt Ltd (product: WebHarvy)
- PilotFish Technology LLC
- Datopian Ltd.
- Newprosoft LLC
- UAB Data troops (Decodo)
- Datafiniti LLC
- Crawlbase LLC
- Bright Data Labs Ltd.
Wesentliche Chancen für Marktteilnehmer
Der Chancenvergleich konzentriert sich auf die Erhebung von Trainingsdaten, die die Abdeckung und Kontrolle unter eingeschränktem Zugang verbessert. Inria charakterisierte neue öffentliche Online-Trainingsdaten im Dezember 2025 als zunehmend knapp, während OECD.AI bis 2025 mehr als 50 Urheberrechts- und Datenschutzklagen weltweit meldete. OECD.AI berichtete auch, dass Websites zunehmend technische und vertragliche Barrieren einsetzen, um Scraping zu verhindern. Zusammen begünstigen Knappheit und Zugangsbeschränkungen Erhebungsdienste, die nutzbare Abdeckung und Datensatzquellbedingungen definieren, bevor ein Korpus erweitert wird.
Tabelle der Marktchancen
| Chance | Warum jetzt | Käufer / Leitsegment | Empfohlene Vorgehensweise | Wesentliche Barriere | Wahrscheinliche Nutznießer |
|---|---|---|---|---|---|
| Branchenspezifische Trainingskorpora | Knappheit neuer öffentlicher Trainingsdaten | KI- und LLM-Trainingsteams | Ein enges vertikales Segment definieren und seine Quellenabdeckung kuratieren | Feststellung der Datensatzeignung für das gewählte vertikale Segment | Spezialisierte Datenanbieter wie Bright Data Ltd. |
| Inkrementelle Korpuserhebung | Bedarf an neuem öffentlichen Trainingsmaterial | Modellteams, die bestehende Korpora erweitern | Inkrementelle Chargen mit dokumentierten Quelldaten liefern | Beschaffung von wirklich neuem, verwendbarem Material | Individuelle Datenpipeline-Anbieter wie Bright Data Ltd. |
| Trainingsfeeds mit Quelldatensätzen | Rechtsstreitigkeiten und Erhebungsbeschränkungen | Modellentwickler, die Korpusursprünge bewerten | Quelle, Erhebungszeitpunkt und Nutzungsbedingungen an jeden Batch anhängen | Technische und vertragliche Zugangshindernisse | Webdatenanbieter wie Bright Data Ltd. |
| Quelle: Mordor Intelligence | |||||
Bright Datas branchenspezifische Beschaffung und individuelle Pipeline-Rolle bietet einen kommerziellen Ausgangspunkt für Trainingsdatenarbeit. Die Ausweitung dieser Rolle auf inkrementelle Feeds oder Feeds mit Quelldatensätzen würde explizite Lieferanforderungen und eine bestätigte Grundlage für die Erhebung jeder Quelle erfordern. Die stärkste Einstiegsmöglichkeit besteht darin, eine eng definierte Erhebung in eine wiederholbare Liefervereinbarung umzuwandeln, deren Umfang und Ursprung klar bleiben, während sich der Korpus verändert.
Neueste Industrielle Entwicklungen in Web Scraping Markt
- Oktober 2026: UAB Oxylabs führte Web API ein und kombinierte Websuche und Scraping mit KI-gestütztem Parsing für strukturierte Webdaten.
- Oktober 2026: RateGain Travel Technologies Limited gab bekannt, dass Vietnam Airlines AirGain, seine Fluggesellschafts-Preisintelligenplattform, ausgewählt hat, um Rate Shopping und Wettbewerbspreisgestaltung zu stärken.
- September 2026: Zyte Group Ltd. führte Zyte MCP ein und brachte Live-Webzugang, strukturierte Extraktion und Scrapy Cloud-Operationen in Coding-Agenten.
Web Scraping Markt Berichtsumfang und Forschungsmethodik
Marktdefinition und Abdeckung
Der globale Web Scraping Markt misst den jährlichen Anbieterumsatz aus kommerzieller Web Scraping Software und verwalteten Extraktionsdiensten, die programmatisch öffentliche Webseiteninhalt für zahlende Organisationen in verschiedenen Branchen und Anwendungsfällen extrahieren. Er umfasst Software-Lizenz- und Abonnementverkäufe sowie Dienstleistungsgebühren aus Cloud- und On-Premise-Angeboten weltweit.
Ausschlüsse aus dem Umfang: Interne Do-it-yourself-Skripte, die ausschließlich innerhalb eines Unternehmens betrieben werden, eigenständige Proxy- oder IP-Rotationsdienste sowie allgemeine Webanalyse- oder SEO-Tools, die keine öffentlichen Webseiteninhalt programmatisch extrahieren, sind ausgeschlossen.
Segmentierungsübersicht
- Nach Lösung
- Software
- Dienstleistungen
- Nach Bereitstellungsmodell
- Cloud
- On-Premise
- Nach Endnutzerbranche
- BFSI
- Einzelhandel und E-Commerce
- Immobilien
- Fertigung
- Behörden
- Gesundheitswesen
- Werbung und Medien
- Sonstige
- Nach Anwendungsfall
- Daten-Scraping / ETL
- Preis- und Wettbewerbsüberwachung
- Lead-Generierung und Vertriebsinformationen
- Alternative Finanzdaten
- Stimmungs- und Sozialanalysen
- Nach Geografie
- Nordamerika
- Vereinigte Staaten
- Kanada
- Mexiko
- Südamerika
- Brasilien
- Argentinien
- Übriges Südamerika
- Europa
- Deutschland
- Vereinigtes Königreich
- Frankreich
- Italien
- Spanien
- Russland
- Übriges Europa
- Asien-Pazifik
- China
- Japan
- Indien
- Südkorea
- Australien und Neuseeland
- Übriger Asien-Pazifik-Raum
- Naher Osten und Afrika
- Naher Osten
- Saudi-Arabien
- Vereinigte Arabische Emirate
- Türkei
- Übriger Naher Osten
- Afrika
- Südafrika
- Nigeria
- Kenia
- Übriges Afrika
- Naher Osten
- Nordamerika
Datenquellen, Marktgrößenbestimmung und Validierung
Desk Research
Der Desk Research stützt sich auf Quellen wie die Quartalsberichte des US Census Bureau zu Einzelhandels-E-Commerce-Umsätzen für den Online-Einzelhandelskontext, Reddits Entwicklerplattform-Mitteilung zu sich ändernden öffentlichen Zugangsbedingungen, die arXiv-Studie zur schemakonformen Webextraktion für technische Leistungsfragen sowie Apifys State of Web Scraping-Bericht für von Praktikern gemeldete Betriebsbedingungen. Diese Quellen helfen dabei, Nachfrageanwendungsfälle, Zugangsbedingungen, Datenqualitätsanforderungen und Extraktionskosten zu rahmen, ohne benachbarte Indikatoren als Marktumsatz zu behandeln.
Unternehmenseinreichungen und Investorenmaterialien helfen dabei, Anbieterumsatzmodelle und Produktgrenzen zu identifizieren, während öffentliche Auftragsvergaben und seriöse Technologie- und Wirtschaftspresse klären können, ob eine Transaktion Software, gelieferte Daten oder beides abdeckt. Marktgesamtwerte werden gegen ihre angegebene Umsatzbasis, Geografie, Zeitraum und Einschlüsse gegengeprüft. Diese genannten Quellen sind illustrativ und nicht erschöpfend, und weitere Quellen informieren Erhebung, Validierung und Klärung.
Primärinterviews und Umfragen
Das Forschungsdesign verwendet strukturierte Interviews oder Umfragen mit Web Scraping Software-Anbietern, verwalteten Extraktionsanbietern und organisatorischen Käufern in den Bereichen Finanzen, Einzelhandel, Medien, Fertigung und öffentlicher Sektor in APAC, EMEA und Amerika. Befragte mit Produkt-, Handels-, Liefer-, Beschaffungs- und Datenoperationsverantwortung können Umsatzgrenzen, Cloud- versus On-Premise-Beschaffung, Kundennutzung und Änderungen im Extraktionsworkload klären. Analytikerfragen testen Interpretationen aus Sekundärquellen und untersuchen Lücken in Anbieterumsatz, Dienstleistungsbündelung, geografischer Zuweisung und Adoption, und Berichte werden über Anbieter-, Käufer- und öffentliche Belege trianguliert, bevor Annahmen beibehalten werden.
Verteilung der Befragten in der Primärforschung
| Unternehmenstyp | Position des Befragten | Region |
|---|---|---|
| Obere Ebene: 35 % | Führungskräfte (CXOs): 20 % | APAC: 38 % |
| Mittlere Ebene: 45 % | Funktions-/Bereichsleiter: 35 % | EMEA: 32 % |
| Kleinere Akteure: 20 % | Manager: 45 % | Amerika: 30 % |
Marktgrößenbestimmung und Prognose
Das Modell schätzt den globalen jährlichen Anbieterumsatz für kommerzielle Web Scraping Software und verwaltete Extraktionsdienste und verteilt diesen Gesamtwert dann auf Lösung, Bereitstellung, Endnutzerbranche, Anwendungsfall und Kundengeografie. Eine Top-down-Schätzung beginnt mit Umsatzoffenlegungen und Marktschätzungen, angepasst an den definierten Verkauf von Lizenzen, Abonnements und Extraktionsdiensten. Selektive Bottom-up-Prüfungen vergleichen Anbieterumsatz-Rollups und Stichproben von Vertrags- oder Dienstleistungspreisen multipliziert mit geschätzten Kundenvolumina, wobei Lücken erfasst und abgestimmt statt als vollständige Erhebung behandelt werden. Wesentliche Indikatoren umfassen Anbieterumsatz und Produktmix, Kunden- und Vertragsoffenlegungen, Cloud- versus On-Premise-Adoption, Online-Einzelhandels- und Marktplatzaktivität sowie Finanz- oder Medienbedarf nach alternativen Daten. Jeder informiert den Gesamtumsatzrahmen, Segmentanteile oder Prognosetreiber. Eine multivariate Regression kann die jährliche Umsatzreihe mit diesen Indikatoren in Beziehung setzen, wo konsistente Historie vorhanden ist, während die Szenarioanalyse Diskontinuitäten wie Zugangsbeschränkungen, rechtliche Änderungen oder neue automatisierte Extraktionsfähigkeiten behandelt. Fehlende Beobachtungen verwenden dokumentierte Interpolation oder begrenzte Annahmen. Segmentanteile werden aus gemeldeten Aufteilungen, Kundennutzungsnachweisen, Produktbeschreibungen und Käuferzuweisung über Branchen und Anwendungen aufgebaut, wobei der Restbetrag erst nach Bewertung der unterstützten Kategorien zugewiesen wird. Primärexperten können die Plausibilität von variablenspezifischen Wachstumspfaden und Verschiebungen im Lösungsmix prüfen, und ungelöste Unterschiede zwischen Anbieterprüfungen und dem Top-down-Gesamtwert werden durch Quell- und Grenzprüfungen erneut untersucht.
Datenvalidierung und Aktualisierungszyklus
Analysten triangulieren Anbieteroffenlegungen, käuferseitige Belege, öffentliche Verträge und unabhängige Marktsignale und prüfen dann Gesamtwerte, Anteile, Wachstumsraten und historische Revisionen auf Anomalien oder wesentliche Abweichungen. Eine mehrstufige Überprüfung bestätigt Quelldaten und Definitionen, testet, ob Ausreißer reale Veränderungen oder inkonsistente Grenzen widerspiegeln, und löst Probleme vor der Freigabe. Eine erneute Kontaktaufnahme wird ausgelöst, wenn eine wesentliche Antwort mit veröffentlichten Belegen in Konflikt steht oder Umsatzeigentümerschaft, Bündelung oder Geografie unklar lässt. Der Datensatz wird jährlich aktualisiert, zwischen den Zyklen für wesentliche Marktereignisse aktualisiert und erhält vor der Lieferung eine neue Überprüfung von Quellen, Berechnungen und narrativer Konsistenz.
Mordor Intelligence's Web Scraping Marktgröße im Vergleich zu anderen veröffentlichten Schätzungen
Veröffentlichte Schätzungen können sich in den Transaktionen und Produkten, die sie zählen, und den zur Modellierung der Nachfrage verwendeten Inputs unterscheiden. Der globale Web Scraping Markt misst den jährlichen Umsatz aus kommerzieller Software und verwalteten Diensten, die programmatisch öffentliche Webseiteninhalt für zahlende Organisationen in verschiedenen Branchen und Anwendungsfällen extrahieren.
Wesentliche Lückentreiber umfassen den definierten Abdeckungsbereich der Studie und marktspezifische Modellierungsentscheidungen. Wesentliche Indikatoren umfassen Anbieterumsatz und Produktmix, Kunden- und Vertragsoffenlegungen, Cloud- versus On-Premise-Adoption, Online-Einzelhandels- und Marktplatzaktivität sowie Finanz- oder Medienbedarf nach alternativen Daten.
Benchmark-Vergleich
| Quelle | Marktgröße | Lücken in der Forschungsmethodik |
|---|---|---|
| Mordor Intelligence | 1,83 Milliarden USD (2027) | |
| Globales Beratungsunternehmen A | 0,99 Milliarden USD (2025) | Bei seiner Basis von 2025 liegt diese Schätzung 45,9 % unter dem Wert dieses Berichts für 2027 von 1,83 Milliarden USD, 2 Jahre später. Das frühere Basisjahr platziert die Schätzung vor dem anschließenden Marktwachstum. |
| Globales Beratungsunternehmen B | 909,9 Millionen USD (2024) | Bei seiner Basis von 2024 liegt diese Schätzung 50,3 % unter dem Wert dieses Berichts für 2027 von 1,83 Milliarden USD, 3 Jahre später. Die ausschließliche Abdeckung von Software schließt verwaltete Extraktionsdienste aus, und das Basisjahr liegt vor dem anschließenden Marktwachstum. |
Mordor Intelligence's Analysten triangulieren Anbieteroffenlegungen, käuferseitige Belege, öffentliche Verträge und unabhängige Marktsignale und prüfen dann Gesamtwerte, Anteile, Wachstumsraten und historische Revisionen auf Anomalien oder wesentliche Abweichungen.
Im Bericht beantwortete Schlüsselfragen
Wie groß ist der Web Scraping Markt und wie lautet die Wachstumsprognose?
Die Größe wird für 2027 auf 1,83 Milliarden USD geschätzt und soll bis 2032 auf 4,03 Milliarden USD wachsen, bei einer CAGR von 17,08 % im Zeitraum 2027–2032.
Was treibt die Nachfrage nach Web Scraping Software und Dienstleistungen an?
Die Expansion des US-amerikanischen Online-Einzelhandels und KI-gestützte Spider-Entwicklung unterstützen die Nachfrage. In einer Umfrage aus dem Jahr 2025 unter 56 Buy-Side-Unternehmen in den Vereinigten Staaten, dem Vereinigten Königreich und Europa planten 63 % höhere Ausgaben für alternative Daten.
Welche Lösung führt beim Umsatz aus kommerziellem Web Scraping?
Software machte im Jahr 2026 57,93 % des Umsatzes aus, während Dienstleistungen mit einer CAGR von 18,35 % im Zeitraum 2027–2032 wachsen sollen.
Welche Unternehmen sind die wichtigsten Anbieter von Web Scraping Software und Dienstleistungen?
Zu den wichtigsten Anbietern gehören Bright Data Ltd., Zyte Group Ltd., Apify Technologies s.r.o., Octopus Data, Inc. und Import.io Ltd., das innerhalb von Neuralogics tätig ist.
Welche Herausforderungen prägen den Ausblick für kommerzielles Web Scraping?
In einer Umfrage vom Dezember 2025 berichteten 88,7 % der Befragten von höheren Kosten beim Targeting von Anti-Bot-geschützten Websites. Für Scraping-Praktiker kann dieser Kostendruck die Abdeckung geschützter Websites und die Aktualisierungsfrequenz einschränken.
Welche Region führt die kommerzielle Web Scraping Branche an, und wo ist das Wachstum am schnellsten?
Nordamerika hielt im Jahr 2026 einen Anteil von 33,94 % am Umsatz, während Asien-Pazifik mit einer CAGR von 18,35 % im Zeitraum 2027–2032 am schnellsten wachsen soll.