
Taille et Part du Marché de l'Analyse de Données de Séquençage de Nouvelle Génération
VUE D’ENSEMBLE DU MARCHÉ
| Période d'étude | 2020 - 2031 |
|---|---|
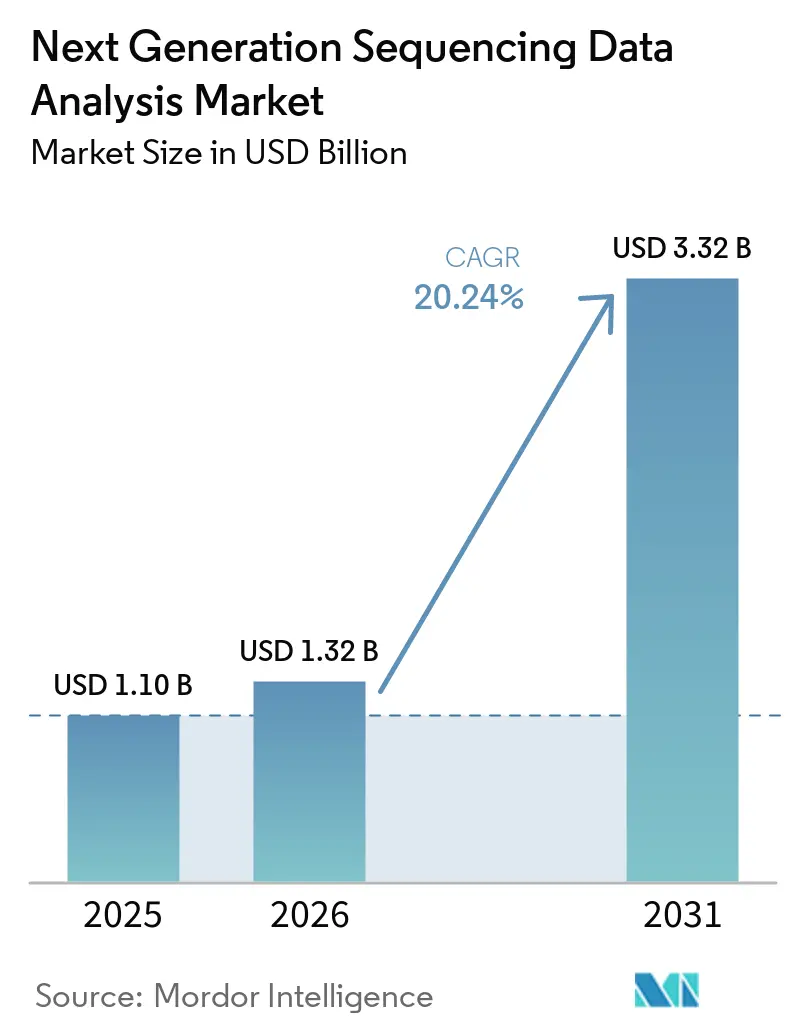
| Taille du Marché (2026) | 1.32 Milliards de dollars |
| Taille du Marché (2031) | 3.32 Milliards de dollars |
| Taux de croissance (2026 - 2031) | 20.24 % |
| Marché à la Croissance la Plus Rapide | Asie-Pacifique |
| Plus Grand Marché | Amérique du Nord |
| Concentration du Marché | Moyen |
Acteurs majeurs *Avis de non-responsabilité : les principaux acteurs sont triés sans ordre particulier Image © Mordor Intelligence. La réutilisation nécessite une attribution sous CC BY 4.0. | |
Analyse du Marché de l'Analyse de Données de Séquençage de Nouvelle Génération par Mordor Intelligence
La taille du Marché de l'Analyse de Données de Séquençage de Nouvelle Génération était évaluée à 1,10 milliard USD en 2025 et devrait croître de 1,32 milliard USD en 2026 pour atteindre 3,32 milliards USD d'ici 2031, à un CAGR de 20,24 % durant la période de prévision (2026-2031).
Le marché est soutenu par les investissements dans les systèmes d'interprétation des variants, les plateformes de bioinformatique hébergées dans le cloud et les pipelines analytiques automatisés. La demande reflète de plus en plus le défi que représente l'interprétation des ensembles de données multi-omiques et à l'échelle des populations, plutôt que le seul débit de séquençage. Les hôpitaux, les entreprises pharmaceutiques et les centres académiques ont besoin de flux de travail qui relient les données génomiques aux décisions cliniques et de recherche. Les exigences en matière de diagnostics compagnons, les programmes nationaux de séquençage et les flux de travail assistés par l'IA façonnent les priorités des fournisseurs. Ces conditions favorisent les plateformes capables de gérer des ensembles de données complexes tout en produisant des résultats reproductibles et cliniquement utiles.
Points Clés du Rapport
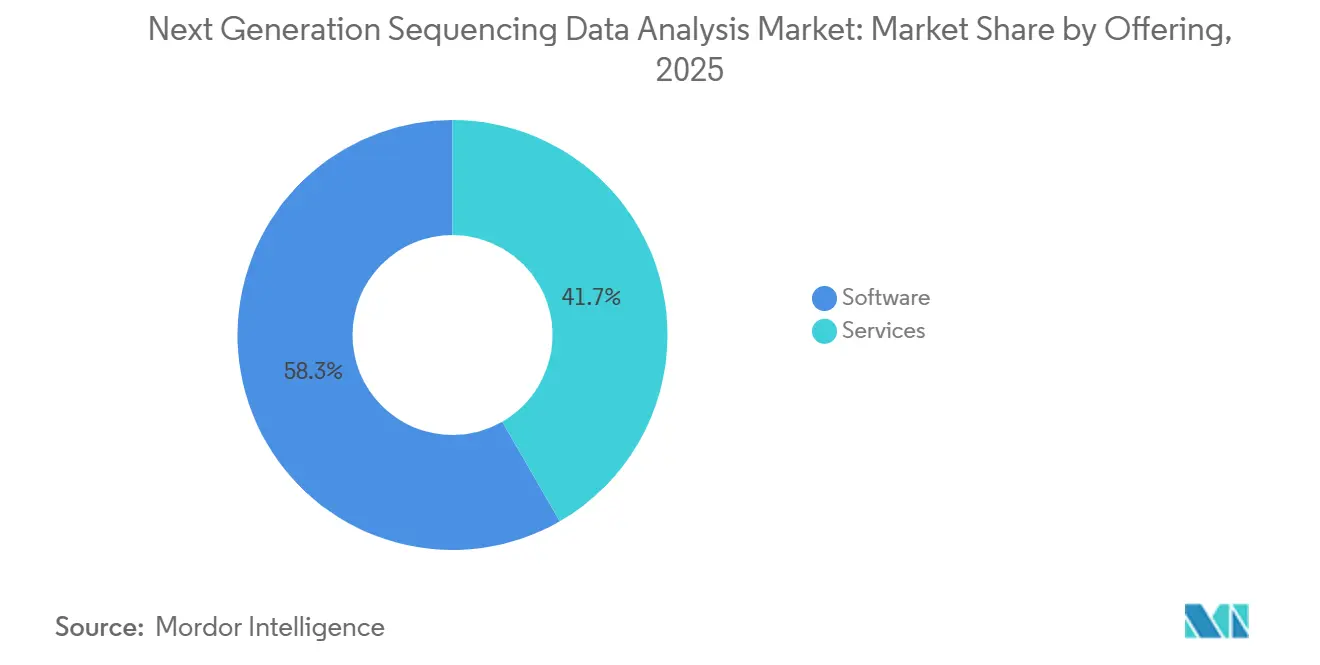
- Par offre, les logiciels détenaient 58,31 % de la part du Marché de l'Analyse de Données de Séquençage de Nouvelle Génération en 2025, tandis que les services devraient croître à un CAGR de 22,65 % jusqu'en 2031.
- Par flux de travail, l'analyse tertiaire détenait 48,24 % des revenus en 2025, tandis que l'analyse secondaire devrait se développer à un CAGR de 23,42 % jusqu'en 2031.
- Par mode de déploiement, le déploiement basé sur le cloud détenait 64,14 % de la part du Marché de l'Analyse de Données de Séquençage de Nouvelle Génération en 2025, tandis que le déploiement hybride devrait croître à un CAGR de 22,52 % jusqu'en 2031.
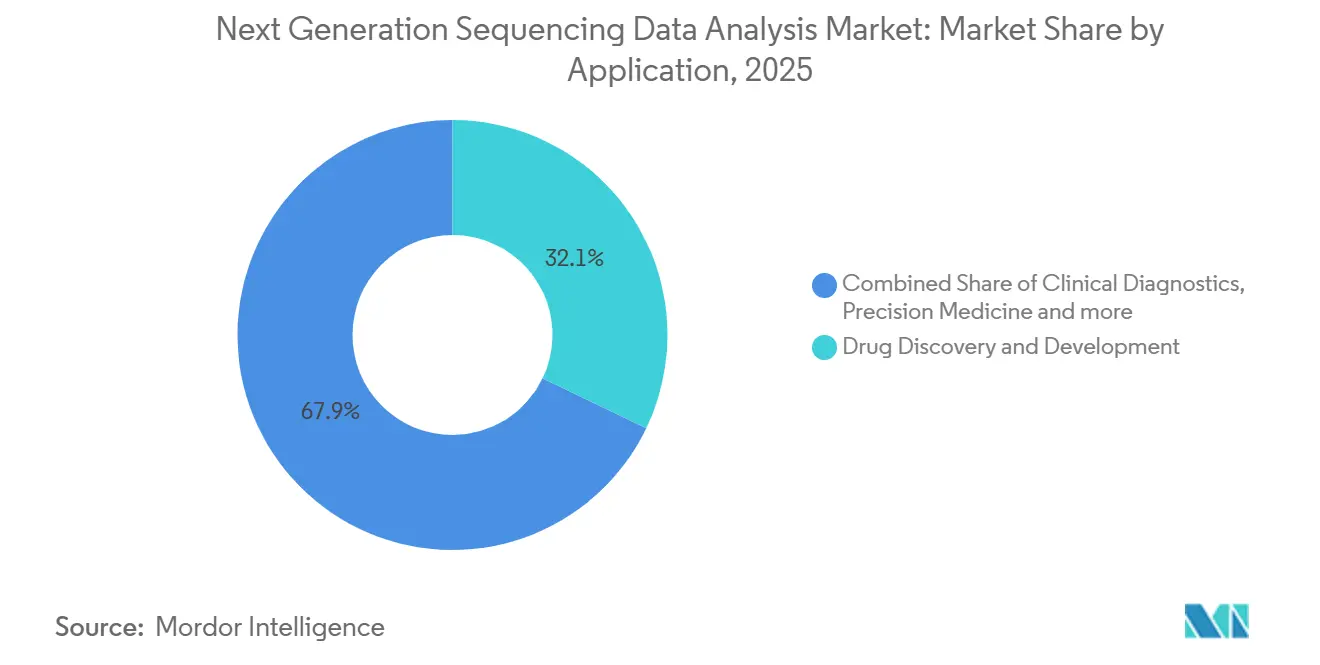
- Par application, la découverte et le développement de médicaments représentaient le cas d'usage le plus important, tandis que le segment des diagnostics cliniques devrait croître à un CAGR de 22,82 % jusqu'en 2031.
- Par utilisateur final, les instituts académiques et de recherche détenaient 37,84 % des revenus en 2025, tandis que les organisations de recherche sous contrat devraient croître à un CAGR de 23,22 % jusqu'en 2031.
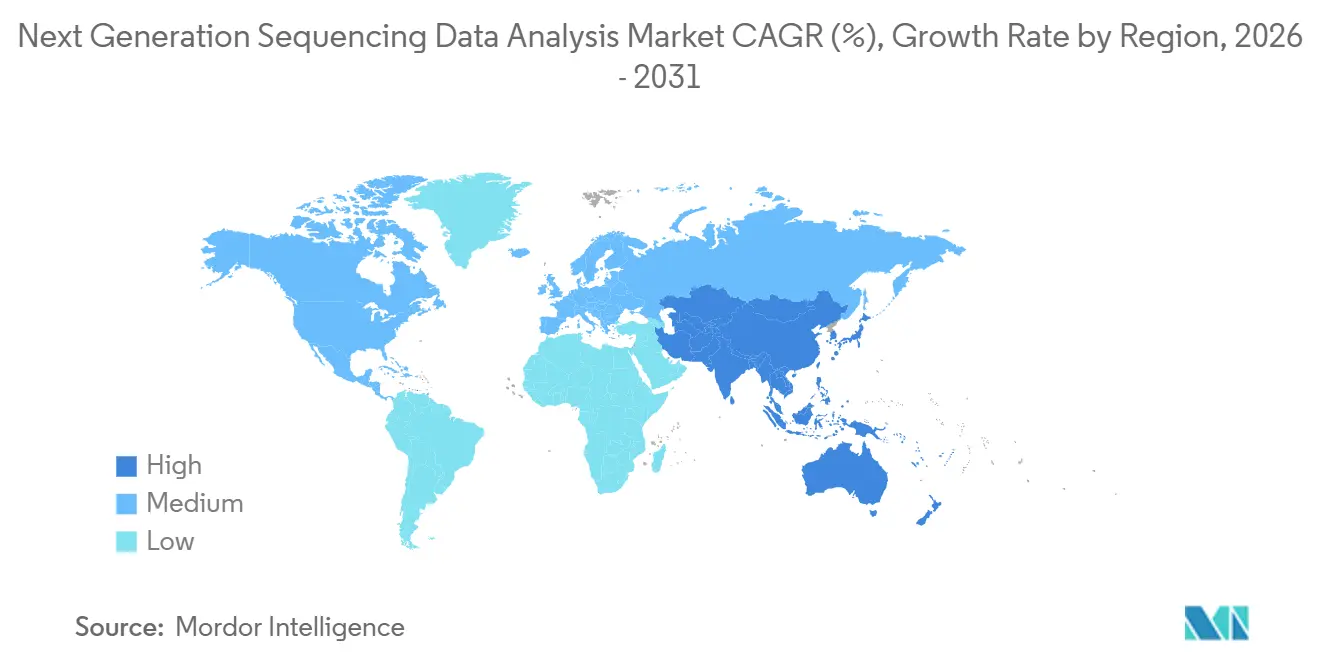
- Par géographie, l'Amérique du Nord détenait 42,41 % des revenus en 2025, tandis que l'Asie-Pacifique devrait être la région à la croissance la plus rapide avec un CAGR de 22,25 % jusqu'en 2031.
Note : La taille du marché et les prévisions figurant dans ce rapport sont générées à l'aide du cadre d'estimation exclusif de Mordor Intelligence, mis à jour avec les dernières données et informations disponibles en janvier 2026.
Tendances et Perspectives du Marché Mondial de l'Analyse de Données de Séquençage de Nouvelle Génération
Analyse de l'Impact des Moteurs*
| Moteur | (~) % d'Impact sur les Prévisions de CAGR | Pertinence Géographique | Horizon Temporel de l'Impact |
|---|---|---|---|
| Expansion des Tests NGS Cliniques en Oncologie et dans les Maladies Rares | +4.5% | Mondial, avec l'Amérique du Nord et l'Europe comme marchés principaux et une adoption rapide en Asie-Pacifique | Court terme (≤ 2 ans) |
| Adoption du Cloud et du Calcul Hybride | +3.5% | Mondial, avec l'Amérique du Nord et l'Europe en tête et l'Asie-Pacifique adoptant via des partenariats cloud | Moyen terme (2-4 ans) |
| Convergence de l'IA et de l'Apprentissage Automatique avec les Pipelines Génomiques | +4.0% | Mondial, concentré en Amérique du Nord, en Europe et en Asie de l'Est | Moyen terme (2-4 ans) |
| Baisse des Coûts de Séquençage et Programmes à l'Échelle des Populations | +3.0% | Mondial, avec l'Asie-Pacifique et l'Amérique du Sud progressant grâce à des programmes nationaux | Long terme (≥ 4 ans) |
| Reconnaissance Réglementaire des Logiciels Génomiques en tant que Dispositif Médical | +2.5% | Principalement en Amérique du Nord et en Europe, avec des cadres en développement en Asie-Pacifique | Court terme (≤ 2 ans) |
| Analyse Fédérée et Multi-Institutionnelle Préservant la Confidentialité | +1.5% | Europe et Amérique du Nord, avec une utilisation plus large via des programmes multilatéraux | Long terme (≥ 4 ans) |
| Source: Mordor Intelligence | |||
Expansion des Tests NGS Cliniques en Oncologie et dans les Maladies Rares
Le Marché de l'Analyse de Données de Séquençage de Nouvelle Génération bénéficie du passage de l'oncologie des tests sur un seul gène vers le profilage génomique complet. La reclassification proposée par la FDA en novembre 2025 ferait passer les diagnostics compagnons basés sur les acides nucléiques en oncologie des exigences PMA de classe III aux exigences 510(k) de classe II en vertu du 21 CFR 866.6075. Un seuil réglementaire plus bas peut augmenter les volumes de diagnostics compagnons sans réduire la complexité de l'analyse des résultats des tests. La concurrence dépend donc davantage de la précision analytique, des pipelines reproductibles et de la qualité des rapports cliniques. Les programmes sur les maladies rares ajoutent de la demande car les tests d'exome entier et de génome entier nécessitent des outils pour la résolution des variants incertains et la corrélation phénotype-génotype. Les fournisseurs de logiciels répondent avec des fonctions d'interprétation assistées par l'IA qui aident les laboratoires à gérer ces tâches de révision complexes.
Adoption du Cloud et du Calcul Hybride
L'infrastructure cloud aide les institutions à éviter de construire une capacité de calcul sur site pour les charges de travail génomiques de pointe. Oxford Nanopore Technologies a rapporté une réduction de 50 % du coût total de possession par rapport aux pipelines de stockage local traditionnels dans le cadre des travaux soutenant le programme national du génome de Singapour. Ce modèle permet aux institutions d'utiliser les ressources de calcul selon leurs besoins au lieu d'acheter de la capacité des années à l'avance. Le Marché de l'Analyse de Données de Séquençage de Nouvelle Génération est également confronté à une plus grande dépendance à un ensemble limité de grands environnements cloud à mesure que les charges de travail analytiques se déplacent hors site. Cette dépendance peut rendre la résidence des données et la migration des flux de travail plus difficiles pour les utilisateurs. Les systèmes hybrides répondent à ce problème en conservant les lectures brutes au sein d'une institution tout en utilisant les ressources cloud pour l'analyse secondaire et tertiaire.
Convergence de l'IA et de l'Apprentissage Automatique avec les Pipelines Génomiques
L'IA et l'apprentissage automatique passent des tâches de contrôle qualité à l'interprétation clinique des variants dans le Marché de l'Analyse de Données de Séquençage de Nouvelle Génération. Illumina a déclaré que DRAGEN v4.5, publié en avril 2026, a réduit les faux positifs de variants nucléotidiques simples liés aux FFPE de plus de 90 % et les faux positifs d'indels de plus de 87 % sans augmenter le temps d'exécution ni la charge de calcul[1]. Ces gains peuvent rendre les échantillons tumoraux FFPE archivés plus utiles pour la découverte de biomarqueurs. Une revue de 2025 a décrit l'utilisation de réseaux de neurones convolutifs, de transformeurs et de modèles hybrides dans des outils tels que DeepVariant et Clair3. Ces outils accroissent l'importance des logiciels analytiques spécialisés et des pratiques de validation. L'apprentissage fédéré peut soutenir le développement de modèles là où les données institutionnelles ne peuvent pas quitter les systèmes locaux.
Baisse des Coûts de Séquençage et Programmes à l'Échelle des Populations
La baisse des coûts de séquençage augmente le nombre de génomes nécessitant une analyse sur l'ensemble du Marché de l'Analyse de Données de Séquençage de Nouvelle Génération. Le séquenceur T20 de MGI a atteint un coût de séquençage inférieur à 100 USD par échantillon dans les déploiements commerciaux. Le programme de recherche NIH All of Us a rapporté plus de 1,3 milliard de variants génétiques sur plus de 535 000 séquences de génome entier dans sa publication de juin 2026. Le programme a également publié 14 500 génomes à lecture longue et a prévu d'autres publications multiomiques au cours de 2026. Le programme Genomas Brasil du Brésil intègre la génomique à grande échelle dans le système national de santé publique. Chaque génome ajoute de la demande pour l'analyse primaire, secondaire et tertiaire dans les logiciels et les services.
Analyse de l'Impact des Contraintes*
| Contrainte | (~) % d'Impact sur les Prévisions de CAGR | Pertinence Géographique | Horizon Temporel de l'Impact |
|---|---|---|---|
| Exigences Fragmentées en Matière de Confidentialité et de Souveraineté des Données | -1.5% | Europe, Amérique du Nord, Asie-Pacifique et programmes de recherche mondiaux | Moyen terme (2-4 ans) |
| Pénurie de Bioinformaticiens Cliniquement Formés et d'Experts en Validation | -1.2% | Mondial, en particulier dans les contextes cliniques en Amérique du Nord, en Europe et sur les marchés émergents d'Asie-Pacifique | Court terme (≤ 2 ans) |
| Coût de Stockage Génomique à Long Terme et de Calcul | -0.8% | Mondial, en particulier pour les petites institutions cliniques et les zones géographiques à faibles revenus | Long terme (≥ 4 ans) |
| Lacunes d'Interopérabilité entre les LIMS Hérités et les DSE | -0.7% | Mondial, concentré dans les systèmes de santé nationaux avec une infrastructure informatique fragmentée | Moyen terme (2-4 ans) |
| Source: Mordor Intelligence | |||
Exigences Fragmentées en Matière de Confidentialité et de Souveraineté des Données
Les règles de souveraineté des données déterminent où les données génomiques peuvent être stockées, traitées et partagées dans le Marché de l'Analyse de Données de Séquençage de Nouvelle Génération. Les exigences européennes et le cadre en développement de l'Espace Européen des Données de Santé peuvent limiter le traitement transfrontalier des données génomiques des citoyens. Ces règles peuvent fragmenter les collaborations qui créent de grands ensembles de données pour l'entraînement des modèles d'IA. SF-GWAS a démontré une analyse d'association pangénomique préservant la confidentialité sur une cohorte de la UK Biobank de 410 000 individus avec une précision comparable aux modèles centralisés[2]. Les méthodes fédérées offrent une réponse pratique là où les données ne peuvent pas franchir les frontières institutionnelles. Les fournisseurs font toujours face à des travaux d'ingénierie et juridiques supplémentaires lorsqu'ils exploitent des environnements de données spécifiques à une juridiction dans plusieurs zones géographiques.
Pénurie de Bioinformaticiens Cliniquement Formés et d'Experts en Validation
Le besoin de bioinformaticiens cliniquement formés et d'experts en validation peut limiter l'adoption sur l'ensemble du Marché de l'Analyse de Données de Séquençage de Nouvelle Génération. Les outils automatisés d'appel et de génération de rapports nécessitent toujours du personnel qualifié pour établir les spécifications des tests et examiner les résultats discordants. Les laboratoires cliniques ont également besoin de ces professionnels pour satisfaire aux exigences de validation et d'accréditation. Une revue de 2025 a identifié des lacunes dans l'infrastructure éducative, l'accès à la formation et le développement des compétences interdisciplinaires dans la science des données génomiques. Le défi est plus large que le recrutement pour l'exploitation de routine des pipelines, car les flux de travail cliniques nécessitent une supervision éclairée des résultats génomiques. Cela rend les prestataires de services et les plateformes gérées pertinents là où les utilisateurs finaux ne disposent pas de capacités internes suffisantes.
*Nos prévisions considèrent les impacts des moteurs et des contraintes comme directionnels et non additifs. Les prévisions d'impact reflètent la croissance de référence, les effets de composition et les interactions entre variables.
Analyse des Segments
Par Offre : Les Logiciels Intégrés Conservent la Position la Plus Importante
Les logiciels détenaient 58,31 % des revenus du Marché de l'Analyse de Données de Séquençage de Nouvelle Génération en 2025. Cette part du Marché de l'Analyse de Données de Séquençage de Nouvelle Génération reflétait la demande institutionnelle pour des suites intégrées couvrant l'analyse primaire, secondaire et tertiaire. Les logiciels d'interprétation tertiaire ont une valeur élevée car ils soutiennent la curation des variants, la génération de rapports cliniques et l'aide à la décision. Ces fonctions sont proches des décisions diagnostiques et thérapeutiques. Les logiciels d'analyse secondaire comprennent des fonctions d'alignement, d'appel de variants et de filtrage de qualité. Les fournisseurs de matériel intègrent de plus en plus cette couche dans leurs offres, ce qui peut exercer une pression sur les marges des logiciels autonomes.
Les outils de gestion des données, de stockage et de gestion des flux de travail gagnent en utilisation à mesure que les institutions traitent des centaines de téraoctets d'informations génomiques chaque année. Ces outils répondent aux besoins de gouvernance des données et de coordination des pipelines que les systèmes informatiques généraux ne satisfont pas pleinement. Les services constituent le segment d'offre à la croissance la plus rapide jusqu'en 2031 car de nombreuses institutions manquent d'équipes internes de bioinformatique. Le développement de pipelines personnalisés est important pour les tests à lecture longue, à cellule unique et multiomiques qui nécessitent une configuration au-delà des packages standard. L'analyse externalisée, l'interprétation des variants et la génération de rapports fournissent aux laboratoires hospitaliers des résultats de qualité clinique sans avoir à construire une infrastructure analytique interne. Le modèle de service soutient également les organisations de recherche sous contrat qui proposent des flux de travail intégrés de l'échantillon au rapport.
Par Flux de Travail : L'Analyse Tertiaire Détient la Position de Revenus la Plus Importante
L'analyse tertiaire détenait 48,24 % des revenus du flux de travail en 2025 dans le Marché de l'Analyse de Données de Séquençage de Nouvelle Génération. Le flux de travail couvre l'annotation des variants, la corrélation phénotype-génotype, les rapports cliniques et l'interprétation assistée par l'IA. Sa position montre que le défi central du diagnostic NGS est de transformer les listes de variants en conclusions cliniques étayées par des preuves. Les systèmes tertiaires se connectent aux dossiers de santé électroniques, aux bases de données génomiques telles que ClinVar et COSMIC, et aux fonctions de rapport réglementaire. Ces connexions rendent le flux de travail plus complexe que les étapes d'analyse antérieures. Elles rendent également les outils tertiaires plus différenciés dans les contextes cliniques et translationnels.
L'analyse secondaire est le segment de flux de travail à la croissance la plus rapide jusqu'en 2031. Elle comprend la cartographie des lectures, l'alignement des variants et l'appel de variants. Les plateformes à lecture longue d'Oxford Nanopore Technologies et de PacBio nécessitent des pipelines secondaires capables de gérer des lectures s'étendant à des dizaines de kilobases. Cela diffère des pipelines à lecture courte conçus pour les systèmes Illumina. Les modèles d'apprentissage automatique tels que DeepVariant et Clair3 peuvent améliorer la précision de l'appel tout en nécessitant une infrastructure logicielle spécialisée. L'analyse primaire reste l'étape à la marge la plus faible car les fournisseurs d'instruments l'intègrent de plus en plus dans des systèmes de calcul embarqués ou adjacents à l'instrument.
Par Mode de Déploiement : Le Cloud Domine Tandis que le Hybride Gagne du Terrain
Le déploiement basé sur le cloud représentait 64,14 % du Marché de l'Analyse de Données de Séquençage de Nouvelle Génération en 2025. Cette part du Marché de l'Analyse de Données de Séquençage de Nouvelle Génération reflète l'attrait de la tarification à l'échantillon et de la capacité de calcul flexible. Les institutions peuvent éviter de prévoir la demande d'infrastructure de pointe des années avant qu'elle ne se produise. Les systèmes cloud soutiennent également la collaboration entre sites sans déplacement physique des données. Cela est utile pour les essais cliniques multi-sites et les programmes à l'échelle des populations. Cela peut également simplifier l'accès aux environnements analytiques gérés de manière centralisée pour les groupes de recherche distribués.
Le déploiement hybride est le mode à la croissance la plus rapide jusqu'en 2031. Les utilisateurs adoptent ce modèle pour équilibrer l'économie du cloud avec les exigences de souveraineté des données et de conformité. Dans une configuration courante, les données de séquence brutes restent sur site tandis que les tâches secondaires et tertiaires s'exécutent dans le cloud. Les institutions peuvent télécharger des fichiers intermédiaires indexés et dépersonnalisés pour un traitement plus intensif en calcul. Les systèmes sur site restent pertinents pour les institutions de recherche en défense, les systèmes de santé souverains et les organisations pharmaceutiques disposant de données propriétaires sensibles. Les outils de gestion des flux de travail tels que Nextflow et WDL aident à coordonner les tâches dans les environnements locaux et cloud.
Par Application : La Découverte de Médicaments Domine Tandis que les Diagnostics Cliniques Croissent le Plus Vite
La découverte et le développement de médicaments est la plus grande application dans le Marché de l'Analyse de Données de Séquençage de Nouvelle Génération. Les entreprises pharmaceutiques utilisent le profilage génomique pour l'identification de cibles, la stratification des patients basée sur les biomarqueurs et le criblage de composés. L'application s'étend désormais au-delà du séquençage d'ARN en vrac et de l'appel de variants de routine. La multiomique à cellule unique et la génomique des perturbations produisent de grands ensembles de données à partir de criblages transcriptomiques sur de nombreux composés. Ces ensembles de données nécessitent des pipelines analytiques dédiés et une capacité de gestion des données. La médecine de précision et la recherche génomique sont également des domaines de revenus pertinents pour les centres académiques, les biobanques et les groupes de recherche translationnelle.
Les diagnostics cliniques devraient croître à un CAGR de 22,82 % jusqu'en 2031, ce qui en fait l'application à la croissance la plus rapide. La taille du Marché de l'Analyse de Données de Séquençage de Nouvelle Génération pour les diagnostics cliniques est soutenue par son utilisation en oncologie, dans les maladies rares, la santé reproductive et la pharmacogénomique. Les logiciels de qualité clinique nécessitent des dossiers de validation analytique, un contrôle de version des algorithmes et des pistes d'audit que les plateformes de qualité recherche peuvent ne pas fournir. Ces exigences élargissent la portée technique des offres de bioinformatique clinique. Tempus a reçu l'autorisation FDA 510(k) en septembre 2025 pour son dispositif de diagnostic NGS basé sur l'ARN Tempus xR IVD. Cette autorisation montre que les entreprises axées sur l'IA poursuivent un engagement réglementaire direct aux côtés des plateformes de diagnostic établies.

Par Utilisateur Final : Les Instituts Académiques Dominent Tandis que les ORC Se Développent le Plus Vite
Les instituts académiques et de recherche détenaient 37,84 % des revenus du Marché de l'Analyse de Données de Séquençage de Nouvelle Génération en 2025. Cette position est soutenue par les subventions, les programmes de biobanques financés par des fonds publics et les centres de séquençage institutionnels. Ces organisations génèrent des ensembles de données génomiques continus qui nécessitent une infrastructure d'analyse fiable. Les universités et les instituts de recherche utilisent également largement des outils open source tels que Nextflow, GATK et Bioconductor. Les fournisseurs commerciaux peuvent cibler cette base installée avec des plateformes cloud gérées. Les hôpitaux et les laboratoires cliniques ont une part actuelle plus faible mais une valeur plus élevée par cas en raison des obligations d'audit, de rapport et de réglementation.
Les organisations de recherche sous contrat sont la catégorie d'utilisateurs finaux à la croissance la plus rapide jusqu'en 2031. Les entreprises pharmaceutiques et biotechnologiques externalisent le développement de pipelines, l'exécution de l'échantillon au rapport, la gestion des données et les travaux de soumission réglementaire. Les ORC peuvent constituer des actifs différenciés à mesure qu'ils accumulent des pipelines validés et des ensembles de données génomiques dans le cadre de projets clients. Ces actifs peuvent soutenir des travaux récurrents et des services analytiques spécialisés. Les ORC mondiaux doivent également traiter les transferts transfrontaliers de données génomiques en vertu de règles incluant le RGPD et le PIPL. Ce besoin accroît les investissements dans la capacité d'analyse spécifique à une juridiction et les modèles de calcul fédérés.
Analyse Géographique
L'Amérique du Nord détenait 42,41 % des revenus du Marché de l'Analyse de Données de Séquençage de Nouvelle Génération en 2025. La position de la région reflète la capacité de séquençage des centres médicaux académiques, des laboratoires nationaux et des groupes de génomique pharmaceutique. NIH All of Us relie plus de 535 000 séquences de génome entier à près de 482 000 dossiers de santé électroniques dans sa publication de juin 2026[3]. Cette échelle soutient une demande continue pour les plateformes et services d'analyse. Le Canada et le Mexique ajoutent de la demande grâce à des programmes de génomique et à une infrastructure de recherche biomédicale en expansion. Les États-Unis disposent d'une large base de licences logicielles liées aux systèmes Illumina installés et à l'activité des ORC axées sur le NGS.
L'Europe occupe une position significative dans le Marché de l'Analyse de Données de Séquençage de Nouvelle Génération, menée par le Royaume-Uni, l'Allemagne et la France. Les programmes nationaux de génomique dans ces pays soutiennent la demande d'infrastructure analytique évolutive. L'initiative genomDE de l'Allemagne oriente les ressources publiques vers l'infrastructure de médecine génomique. L'expansion de l'assurance maladie du pays pour le remboursement du profilage tumoral en 2024 a ajouté environ 80 000 tests annuellement. La France s'est engagée à hauteur de 670 millions EUR (720 millions USD) aux taux de change moyens de 2025 pour 12 plateformes régionales de génomique dans le cadre de son plan national. La transition vers le RDIV de l'UE accroît le besoin d'outils soutenant des flux de travail de laboratoire validés et documentés.
L'Asie-Pacifique est la zone régionale à la croissance la plus rapide jusqu'en 2031. La Chine bénéficie des réductions de coûts de séquençage portées par MGI, l'Inde d'une base de recherche biotechnologique en expansion, et le Japon d'un contexte NGS clinique soutenu par le remboursement. La Corée du Sud, l'Australie et l'Inde contribuent à la capacité via des centres de séquençage académiques, des programmes d'agences de santé et l'expansion de la recherche sous contrat. Le Moyen-Orient et l'Afrique sont des zones à un stade plus précoce, menées par les investissements en médecine génomique des pays du CCG et les programmes de séquençage de recherche sud-africains. L'initiative Genomas Brasil du Brésil montre comment les programmes dirigés par les gouvernements peuvent façonner la capacité génomique en Amérique du Sud.
Paysage Concurrentiel
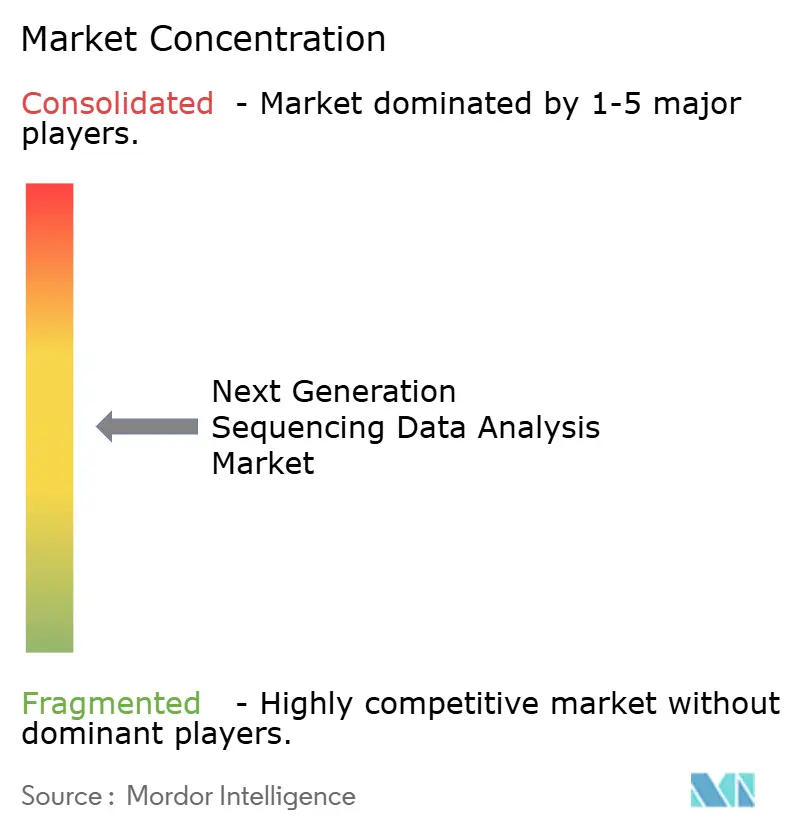
Le Marché de l'Analyse de Données de Séquençage de Nouvelle Génération présente une structure concurrentielle modérément concentrée et à plusieurs niveaux. Les intégrateurs instrument-logiciel comprennent Illumina, Thermo Fisher Scientific et Oxford Nanopore Technologies. Les plateformes natives du cloud telles que DNAnexus et Seven Bridges Genomics se distinguent par leur évolutivité, leur connectivité à l'écosystème et leur gestion des données. Les fournisseurs d'interprétation axés sur l'IA comprennent SOPHiA GENETICS, Fabric Genomics et Sentieon. Leur position dépend des performances algorithmiques et de l'intégration dans les flux de travail cliniques. Le Marché de l'Analyse de Données de Séquençage de Nouvelle Génération reste contestable car le cloud computing abaisse les barrières à l'entrée même si les plateformes existantes créent un verrouillage des flux de travail.
SOPHiA GENETICS a rapporté que sa plateforme SOPHiA DDM avait analysé plus de 2,5 millions de cas dans plus de 800 institutions dans 70 pays depuis 2014. En juin 2026, la société a signé un protocole d'accord avec le Memorial Sloan Kettering Cancer Center pour explorer une coentreprise en oncologie de précision. Illumina a publié DRAGEN v4.5 en avril 2026 avec des fonctions d'appel somatique par apprentissage automatique. En mars 2026, Illumina et Labcorp ont élargi leur collaboration pour co-commercialiser des kits de tests IVD de biopsie liquide et de tumeur solide avec analyse de données intégrée. Ces mouvements montrent l'importance de combiner logiciels analytiques, flux de travail cliniques et accès aux tests.
Les maladies rares et le dépistage néonatal restent des domaines où l'analyse tertiaire clinique nécessite une interprétation spécialisée guidée par le phénotype et des bases de données de variants rares. L'analyse fédérée multi-institutionnelle dispose également d'outils commerciaux matures limités là où les informations des patients ne peuvent pas quitter les systèmes institutionnels. Les fournisseurs développent des approches analytiques préservant la confidentialité basées sur le chiffrement homomorphe et le calcul multipartite sécurisé. Sentieon illustre le rôle continu de l'efficacité de calcul grâce à l'appel de variants accéléré par GPU. Le Marché de l'Analyse de Données de Séquençage de Nouvelle Génération connaît également une attention accrue sur la protection des algorithmes analytiques. La mise à jour DRAGEN d'Illumina reflète comment la concurrence s'étend de la chimie de séquençage aux méthodes logicielles et à l'interprétation clinique.
Leaders du Secteur de l'Analyse de Données de Séquençage de Nouvelle Génération
-
Illumina, Inc.
-
Thermo Fisher Scientific Inc.
-
QIAGEN N.V.
-
F. Hoffmann-La Roche Ltd
-
DNAnexus, Inc.
- *Avis de non-responsabilité : les principaux acteurs sont triés sans ordre particulier
Développements Récents du Secteur
- Septembre 2026 : Ultima Genomics a annoncé une collaboration avec NVIDIA pour permettre une analyse de séquençage du génome entier tenant compte du pangénome à une échelle sans précédent. L'analyse tenant compte du pangénome est devenue un outil important pour permettre une sensibilité et une précision plus élevées du NGS et pour réduire le biais de référence génomique en capturant la diversité génétique humaine mondiale.
- Août 2026 : Lexogen a annoncé la disponibilité de flux de travail de services NGS désignés opérés en conformité avec les principes des Bonnes Pratiques de Laboratoire Clinique de l'Organisation Mondiale de la Santé.
Portée du Rapport Mondial sur le Marché de l'Analyse de Données de Séquençage de Nouvelle Génération
Selon la portée du rapport, l'analyse de données de séquençage de nouvelle génération (NGS) est le processus de transformation des données produites par le séquençage d'ADN ou d'ARN à haut débit en résultats biologiques significatifs.
Le marché de l'analyse de données de séquençage de nouvelle génération est segmenté par offre en logiciels et services. Le segment des logiciels comprend les logiciels d'analyse de données primaires, les logiciels d'analyse secondaire, les logiciels d'analyse et d'interprétation tertiaires, les outils de gestion et de stockage des données, et les logiciels de gestion des flux de travail. Le segment des services comprend les services d'analyse de données, les services de gestion et de stockage des données, les services de développement et de personnalisation des pipelines, et d'autres services. Par flux de travail, le marché est segmenté en analyse primaire, analyse secondaire et analyse tertiaire. Par mode de déploiement, le marché est segmenté en solutions basées sur le cloud, sur site et hybrides. Par application, le marché est segmenté en diagnostics cliniques, découverte et développement de médicaments, médecine de précision, recherche génomique et autres applications. Par utilisateur final, le marché est segmenté en instituts académiques et de recherche, hôpitaux et laboratoires cliniques, entreprises pharmaceutiques et biotechnologiques, organisations de recherche sous contrat et autres utilisateurs finaux. Par géographie, le marché est segmenté en Amérique du Nord, Europe, Asie-Pacifique, Moyen-Orient et Afrique, et Amérique du Sud. Le rapport de marché couvre également les tailles de marché estimées et les tendances pour 17 pays dans les principales régions du monde. Pour chaque segment, la taille du marché et les prévisions sont fournies en termes de valeur (USD).
| Logiciels | Logiciels d'Analyse de Données Primaires |
| Logiciels d'Analyse Secondaire | |
| Logiciels d'Analyse et d'Interprétation Tertiaires | |
| Outils de Gestion et de Stockage des Données | |
| Logiciels de Gestion des Flux de Travail | |
| Services | Services d'Analyse de Données |
| Services de Gestion et de Stockage des Données | |
| Développement et Personnalisation des Pipelines | |
| Autres Services |
| Analyse Primaire |
| Analyse Secondaire |
| Analyse Tertiaire |
| Basé sur le Cloud |
| Sur Site |
| Hybride |
| Diagnostics Cliniques |
| Découverte et Développement de Médicaments |
| Médecine de Précision |
| Recherche Génomique |
| Autres Applications |
| Instituts Académiques et de Recherche |
| Hôpitaux et Laboratoires Cliniques |
| Entreprises Pharmaceutiques et Biotechnologiques |
| Organisations de Recherche sous Contrat |
| Autres Utilisateurs Finaux |
| Amérique du Nord | États-Unis |
| Canada | |
| Mexique | |
| Europe | Allemagne |
| Royaume-Uni | |
| France | |
| Italie | |
| Espagne | |
| Reste de l'Europe | |
| Asie-Pacifique | Chine |
| Japon | |
| Inde | |
| Australie | |
| Corée du Sud | |
| Reste de l'Asie-Pacifique | |
| Moyen-Orient et Afrique | CCG |
| Afrique du Sud | |
| Reste du Moyen-Orient et de l'Afrique | |
| Amérique du Sud | Brésil |
| Argentine | |
| Reste de l'Amérique du Sud |
| Par Offre | Logiciels | Logiciels d'Analyse de Données Primaires |
| Logiciels d'Analyse Secondaire | ||
| Logiciels d'Analyse et d'Interprétation Tertiaires | ||
| Outils de Gestion et de Stockage des Données | ||
| Logiciels de Gestion des Flux de Travail | ||
| Services | Services d'Analyse de Données | |
| Services de Gestion et de Stockage des Données | ||
| Développement et Personnalisation des Pipelines | ||
| Autres Services | ||
| Par Flux de Travail | Analyse Primaire | |
| Analyse Secondaire | ||
| Analyse Tertiaire | ||
| Par Mode de Déploiement | Basé sur le Cloud | |
| Sur Site | ||
| Hybride | ||
| Par Application | Diagnostics Cliniques | |
| Découverte et Développement de Médicaments | ||
| Médecine de Précision | ||
| Recherche Génomique | ||
| Autres Applications | ||
| Par Utilisateur Final | Instituts Académiques et de Recherche | |
| Hôpitaux et Laboratoires Cliniques | ||
| Entreprises Pharmaceutiques et Biotechnologiques | ||
| Organisations de Recherche sous Contrat | ||
| Autres Utilisateurs Finaux | ||
| Par Géographie | Amérique du Nord | États-Unis |
| Canada | ||
| Mexique | ||
| Europe | Allemagne | |
| Royaume-Uni | ||
| France | ||
| Italie | ||
| Espagne | ||
| Reste de l'Europe | ||
| Asie-Pacifique | Chine | |
| Japon | ||
| Inde | ||
| Australie | ||
| Corée du Sud | ||
| Reste de l'Asie-Pacifique | ||
| Moyen-Orient et Afrique | CCG | |
| Afrique du Sud | ||
| Reste du Moyen-Orient et de l'Afrique | ||
| Amérique du Sud | Brésil | |
| Argentine | ||
| Reste de l'Amérique du Sud | ||
Questions Clés Répondues dans le Rapport
Quelle est la taille du Marché de l'Analyse de Données de Séquençage de Nouvelle Génération ?
Le Marché de l'Analyse de Données de Séquençage de Nouvelle Génération était de 1,32 milliard USD en 2026 et devrait atteindre 3,32 milliards USD d'ici 2031 à un CAGR de 20,24 %.
Quelle offre domine les dépenses en analyse de données NGS ?
Les logiciels ont dominé avec 58,31 % des revenus en 2025 car les institutions privilégient les outils intégrés qui soutiennent l'analyse du traitement primaire jusqu'à l'interprétation.
Pourquoi les diagnostics cliniques connaissent-ils une croissance rapide ?
Les diagnostics cliniques devraient croître à un CAGR de 22,82 % jusqu'en 2031 à mesure que les tests NGS s'étendent à l'oncologie, aux maladies rares, à la santé reproductive et à la pharmacogénomique.
Quel modèle de déploiement dispose de la plus grande base installée ?
Le déploiement basé sur le cloud détenait 64,14 % en 2025, tandis que le déploiement hybride connaît la croissance la plus rapide à mesure que les institutions équilibrent la capacité de calcul flexible avec les besoins de souveraineté des données.
Quelle région domine les revenus de l'analyse de données NGS ?
L'Amérique du Nord détenait 42,41 % des revenus en 2025, soutenue par la capacité de recherche, les programmes cliniques et les initiatives de génomique à grande échelle.
Qu'est-ce qui limite l'adoption des plateformes d'analyse génomique ?
Les exigences de souveraineté des données et les pénuries de professionnels de la bioinformatique cliniquement formés et de la validation peuvent compliquer le déploiement et l'exploitation des plateformes.