
Marktgröße und Marktanteil der Analyse von Daten der Sequenzierung der nächsten Generation
Marktübersicht
| Studienzeitraum | 2020 - 2031 |
|---|---|
| Marktgröße (2026) | 1.32 Milliarden US-Dollar |
| Marktgröße (2031) | 3.32 Milliarden US-Dollar |
| Wachstumsrate (2026 - 2031) | 20.24 % |
| Schnellstwachsender Markt | Asien-Pazifik |
| Größter Markt | Nordamerika |
| Marktkonzentration | Mittel |
Hauptakteure *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert Bild © Mordor Intelligence. Wiederverwendung erfordert Namensnennung gemäß CC BY 4.0. | |
Marktanalyse der Analyse von Daten der Sequenzierung der nächsten Generation von Mordor Intelligence
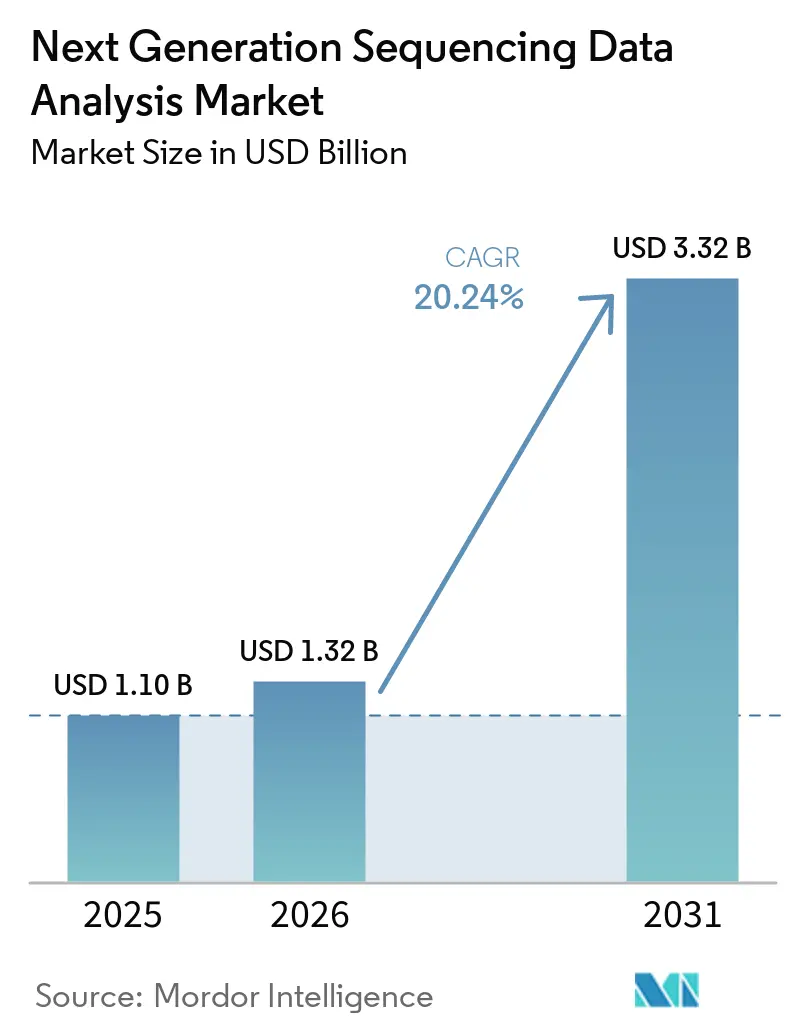
Die Marktgröße der Analyse von Daten der Sequenzierung der nächsten Generation wurde im Jahr 2025 auf 1,10 Milliarden USD geschätzt und soll von 1,32 Milliarden USD im Jahr 2026 auf 3,32 Milliarden USD bis 2031 wachsen, bei einer CAGR von 20,24 % während des Prognosezeitraums (2026–2031).
Der Markt wird durch Investitionen in Systeme zur Varianteninterpretation, Cloud-gehostete Bioinformatikplattformen und automatisierte Analysepipelines gestützt. Die Nachfrage spiegelt zunehmend die Herausforderung wider, Multi-Omics- und bevölkerungsweite Datensätze zu interpretieren, und nicht allein den Sequenzierungsdurchsatz. Krankenhäuser, Pharmaunternehmen und akademische Zentren benötigen Workflows, die genomische Daten mit klinischen und Forschungsentscheidungen verknüpfen. Anforderungen an Begleitdiagnostika, nationale Sequenzierungsprogramme und KI-gestützte Workflows prägen die Prioritäten der Anbieter. Diese Bedingungen begünstigen Plattformen, die komplexe Datensätze verwalten und dabei reproduzierbare und klinisch verwertbare Ergebnisse liefern können.
Wichtigste Erkenntnisse des Berichts
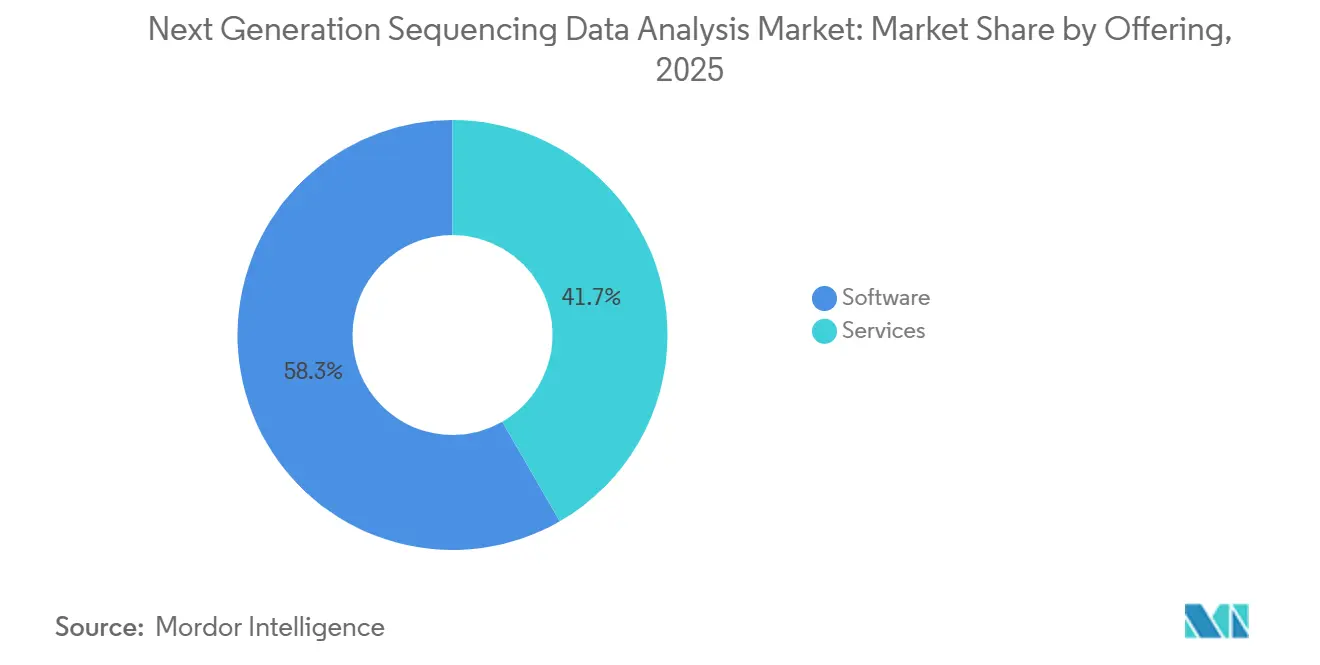
- Nach Angebot hielt Software im Jahr 2025 einen Anteil von 58,31 % am Markt für die Analyse von Daten der Sequenzierung der nächsten Generation, während Dienstleistungen bis 2031 mit einer CAGR von 22,65 % wachsen sollen.
- Nach Workflow hielt die Tertiäranalyse im Jahr 2025 einen Umsatzanteil von 48,24 %, während die Sekundäranalyse bis 2031 voraussichtlich mit einer CAGR von 23,42 % wachsen wird.
- Nach Bereitstellungsmodus hielt die Cloud-basierte Bereitstellung im Jahr 2025 einen Anteil von 64,14 % am Markt für die Analyse von Daten der Sequenzierung der nächsten Generation, während die hybride Bereitstellung bis 2031 mit einer CAGR von 22,52 % wachsen soll.
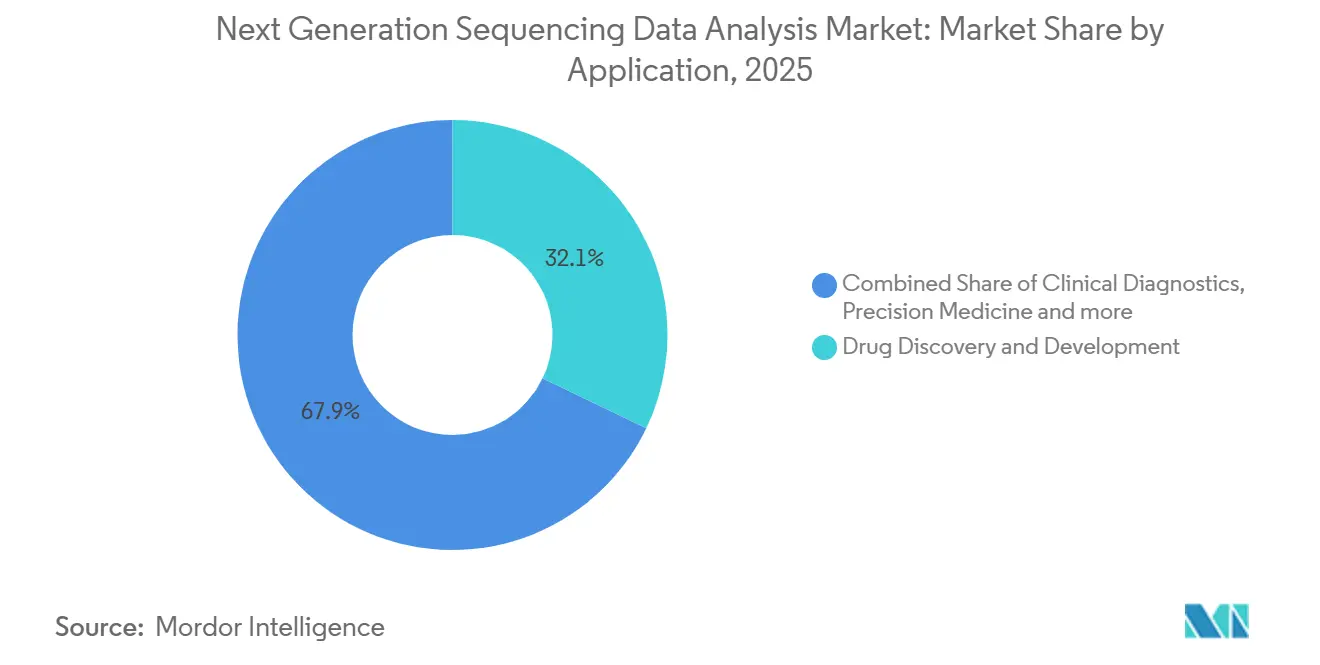
- Nach Anwendung war die Arzneimittelentdeckung und -entwicklung der größte Anwendungsfall, während das Segment der klinischen Diagnostik bis 2031 mit einer CAGR von 22,82 % wachsen soll.
- Nach Endnutzer hielten akademische und Forschungsinstitute im Jahr 2025 einen Umsatzanteil von 37,84 %, während Auftragsforschungsorganisationen bis 2031 mit einer CAGR von 23,22 % wachsen sollen.
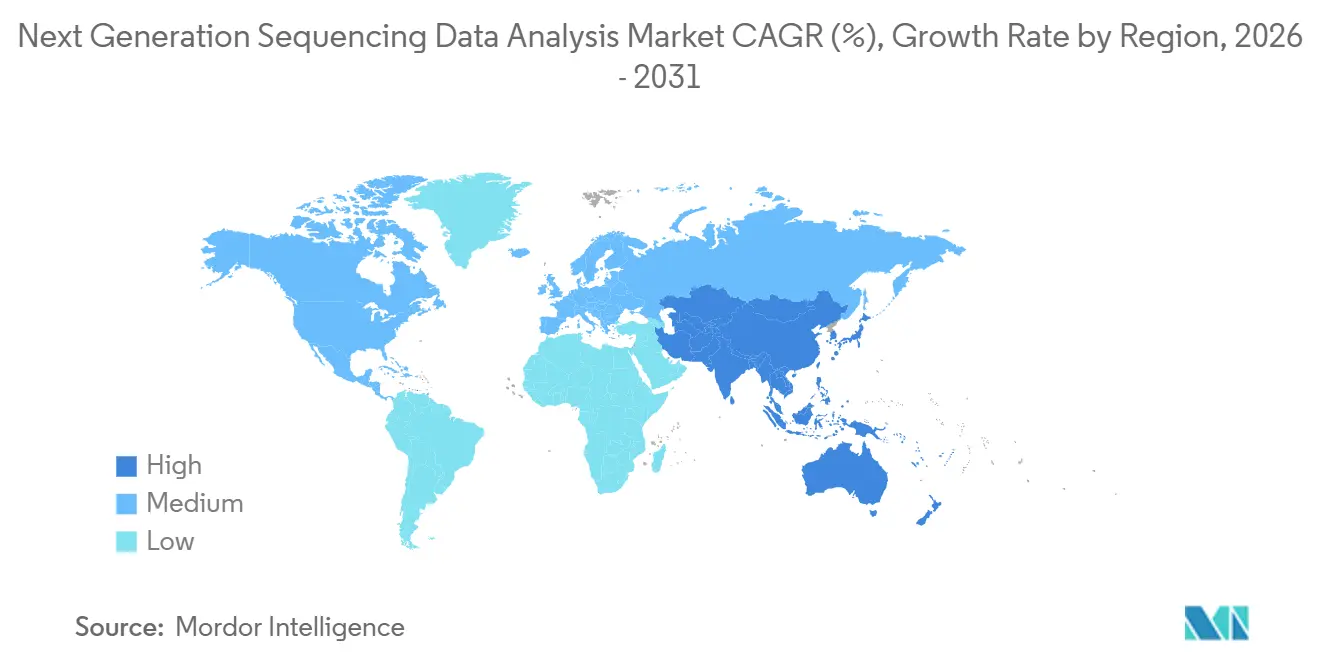
- Nach Geografie hielt Nordamerika im Jahr 2025 einen Umsatzanteil von 42,41 %, während der Asien-Pazifik-Raum mit einer CAGR von 22,25 % bis 2031 die am schnellsten wachsende Region sein soll.
Hinweis: Die Marktgröße und Prognosezahlen in diesem Bericht werden mithilfe des proprietären Schätzungsrahmens von Mordor Intelligence erstellt und mit den neuesten verfügbaren Daten und Erkenntnissen vom Januar 2026 aktualisiert.
Globale Trends und Erkenntnisse zum Markt für die Analyse von Daten der Sequenzierung der nächsten Generation
Analyse der Auswirkungen von Treibern*
| Treiber | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Ausweitung der klinischen NGS-Tests in der Onkologie und bei seltenen Krankheiten | +4.5% | Global, mit Nordamerika und Europa als Kernmärkte und schneller Übernahme im Asien-Pazifik-Raum | Kurzfristig (≤ 2 Jahre) |
| Einführung von Cloud- und Hybrid-Computing | +3.5% | Global, mit Nordamerika und Europa als Vorreiter und Asien-Pazifik mit Übernahme durch Cloud-Partnerschaften | Mittelfristig (2–4 Jahre) |
| Konvergenz von KI und maschinellem Lernen mit genomischen Pipelines | +4.0% | Global, konzentriert in Nordamerika, Europa und Ostasien | Mittelfristig (2–4 Jahre) |
| Sinkende Sequenzierungskosten und bevölkerungsweite Programme | +3.0% | Global, mit Asien-Pazifik und Südamerika, die durch nationale Programme voranschreiten | Langfristig (≥ 4 Jahre) |
| Regulatorische Anerkennung von genomischer Software als Medizinprodukt | +2.5% | Hauptsächlich Nordamerika und Europa, mit sich entwickelnden Rahmenbedingungen im Asien-Pazifik-Raum | Kurzfristig (≤ 2 Jahre) |
| Föderierte und datenschutzwahrende multi-institutionelle Analyse | +1.5% | Europa und Nordamerika, mit breiterem Einsatz durch multilaterale Programme | Langfristig (≥ 4 Jahre) |
| Quelle: Mordor Intelligence | |||
Ausweitung der klinischen NGS-Tests in der Onkologie und bei seltenen Krankheiten
Der Markt für die Analyse von Daten der Sequenzierung der nächsten Generation profitiert davon, dass die Onkologie von Einzelgen-Tests hin zu umfassenden genomischen Profilen übergeht. Die vorgeschlagene FDA-Neuklassifizierung vom November 2025 würde onkologische nukleinsäurebasierte Begleitdiagnostika von den Anforderungen der Klasse III PMA auf die Anforderungen der Klasse II 510(k) gemäß 21 CFR 866.6075 umstellen. Eine niedrigere regulatorische Schwelle kann das Volumen der Begleitdiagnostika erhöhen, ohne die Komplexität der Analyse von Testergebnissen zu verringern. Der Wettbewerb hängt daher stärker von analytischer Genauigkeit, reproduzierbaren Pipelines und der Qualität der klinischen Berichterstattung ab. Programme für seltene Krankheiten erhöhen die Nachfrage, da Whole-Exome- und Whole-Genome-Tests Werkzeuge zur Auflösung unsicherer Varianten und zur Phänotyp-Genotyp-Korrelation benötigen. Softwareanbieter reagieren mit KI-gestützten Interpretationsfunktionen, die Labore bei der Bewältigung dieser komplexen Überprüfungsaufgaben unterstützen.
Einführung von Cloud- und Hybrid-Computing
Cloud-Infrastruktur hilft Institutionen dabei, den Aufbau von On-Premises-Rechenkapazitäten für Spitzen-Genomik-Workloads zu vermeiden. Oxford Nanopore Technologies berichtete von einer Reduzierung der Gesamtbetriebskosten um 50 % im Vergleich zu herkömmlichen lokalen Speicherpipelines bei der Arbeit zur Unterstützung des nationalen Genomprogramms Singapurs. Dieses Modell ermöglicht es Institutionen, Rechenressourcen bei Bedarf zu nutzen, anstatt Kapazitäten Jahre im Voraus zu erwerben. Der Markt für die Analyse von Daten der Sequenzierung der nächsten Generation ist auch stärker von einer begrenzten Anzahl großer Cloud-Umgebungen abhängig, da analytische Workloads ausgelagert werden. Diese Abhängigkeit kann die Datenhaltung und die Workflow-Migration für Nutzer erschweren. Hybridsysteme lösen dieses Problem, indem sie Rohdaten innerhalb einer Institution belassen und gleichzeitig Cloud-Ressourcen für die Sekundär- und Tertiäranalyse nutzen.
Konvergenz von KI und maschinellem Lernen mit genomischen Pipelines
KI und maschinelles Lernen entwickeln sich im Markt für die Analyse von Daten der Sequenzierung der nächsten Generation von Qualitätskontrollaufgaben hin zur klinischen Varianteninterpretation. Illumina erklärte, dass DRAGEN v4.5, veröffentlicht im April 2026, FFPE-bedingte falsch-positive Einzelnukleotidvarianten um mehr als 90 % und falsch-positive Indels um mehr als 87 % reduzierte, ohne die Laufzeit oder den Rechenaufwand zu erhöhen[1]. Diese Fortschritte können archivierte FFPE-Tumorproben für die Biomarker-Entdeckung nützlicher machen. Eine Überprüfung aus dem Jahr 2025 beschrieb den Einsatz von CNNs, Transformatoren und Hybridmodellen in Werkzeugen wie DeepVariant und Clair3. Solche Werkzeuge erhöhen die Bedeutung spezialisierter Analysesoftware und Validierungspraktiken. Föderiertes Lernen kann die Modellentwicklung dort unterstützen, wo institutionelle Daten lokale Systeme nicht verlassen können.
Sinkende Sequenzierungskosten und bevölkerungsweite Programme
Niedrigere Sequenzierungskosten erhöhen die Anzahl der Genome, die im gesamten Markt für die Analyse von Daten der Sequenzierung der nächsten Generation analysiert werden müssen. MGIs T20-Sequenzierer erreichte in kommerziellen Einsätzen Sequenzierungskosten von unter 100 USD pro Probe. Das NIH-Programm „All of Us Research Program” meldete in seiner Veröffentlichung vom Juni 2026 mehr als 1,3 Milliarden genetische Varianten aus mehr als 535.000 Whole-Genome-Sequenzen. Das Programm veröffentlichte außerdem 14.500 Long-Read-Genome und plante weitere multiomische Veröffentlichungen im Jahr 2026. Brasiliens Programm Genomas Brasil integriert groß angelegte Genomik in das nationale öffentliche Gesundheitssystem. Jedes Genom erhöht die Nachfrage nach Primär-, Sekundär- und Tertiäranalyse über Software und Dienstleistungen hinweg.
Analyse der Auswirkungen von Hemmnissen*
| Hemmnis | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Fragmentierte Datenschutz- und Datensouveränitätsanforderungen | -1.5% | Europa, Nordamerika, Asien-Pazifik und globale Forschungsprogramme | Mittelfristig (2–4 Jahre) |
| Mangel an klinisch ausgebildeten Bioinformatikern und Validierungsexperten | -1.2% | Global, insbesondere in klinischen Umgebungen in Nordamerika, Europa und aufstrebenden Asien-Pazifik-Märkten | Kurzfristig (≤ 2 Jahre) |
| Langfristige genomische Speicher- und Rechenkosten | -0.8% | Global, insbesondere bei kleineren klinischen Institutionen und einkommensschwächeren Regionen | Langfristig (≥ 4 Jahre) |
| Interoperabilitätslücken bei Legacy-LIMS und EHR | -0.7% | Global, konzentriert in nationalen Gesundheitssystemen mit fragmentierter IT-Infrastruktur | Mittelfristig (2–4 Jahre) |
| Quelle: Mordor Intelligence | |||
Fragmentierte Datenschutz- und Datensouveränitätsanforderungen
Datensouveränitätsregeln bestimmen, wo genomische Daten im Markt für die Analyse von Daten der Sequenzierung der nächsten Generation gespeichert, verarbeitet und geteilt werden können. Europäische Anforderungen und der sich entwickelnde Europäische Gesundheitsdatenraum können die grenzüberschreitende Verarbeitung genomischer Bürgerdaten einschränken. Diese Regeln können die Kooperationen fragmentieren, die große Datensätze für das Training von KI-Modellen erzeugen. SF-GWAS demonstrierte eine datenschutzwahrende genomweite Assoziationsanalyse an einer UK-Biobank-Kohorte von 410.000 Personen mit einer Genauigkeit, die zentralisierten Modellen vergleichbar ist[2]. Föderierte Methoden bieten eine praktische Antwort, wo Daten institutionelle Grenzen nicht überschreiten können. Anbieter stehen weiterhin vor zusätzlichem Engineering- und Rechtsaufwand, wenn sie jurisdiktionsspezifische Datenumgebungen in mehreren Regionen betreiben.
Mangel an klinisch ausgebildeten Bioinformatikern und Validierungsexperten
Der Bedarf an klinisch ausgebildeten Bioinformatikern und Validierungsexperten kann die Einführung im gesamten Markt für die Analyse von Daten der Sequenzierung der nächsten Generation einschränken. Automatisierte Calling- und Berichtserstellungswerkzeuge erfordern weiterhin qualifiziertes Personal, um Assay-Spezifikationen festzulegen und diskordante Ergebnisse zu überprüfen. Klinische Labore benötigen diese Fachleute auch, um Validierungs- und Akkreditierungsanforderungen zu erfüllen. Eine Überprüfung aus dem Jahr 2025 identifizierte Lücken in der Bildungsinfrastruktur, im Zugang zu Schulungen und in der fachübergreifenden Kompetenzentwicklung in der genomischen Datenwissenschaft. Die Herausforderung geht über die Personalbesetzung für den routinemäßigen Pipeline-Betrieb hinaus, da klinische Workflows eine fundierte Überwachung genomischer Befunde erfordern. Dies macht Dienstleister und verwaltete Plattformen relevant, wo Endnutzer nicht über ausreichende interne Kapazitäten verfügen.
*Unsere Prognosen behandeln die Auswirkungen von Treibern und Einschränkungen als richtungsweisend und nicht additiv. Die Wirkungsprognosen berücksichtigen Basiswachstum, Mischungseffekte und Wechselwirkungen zwischen Variablen.
Segmentanalyse
Nach Angebot: Integrierte Software behält die größte Position
Software hielt im Jahr 2025 einen Anteil von 58,31 % am Umsatz des Marktes für die Analyse von Daten der Sequenzierung der nächsten Generation. Dieser Marktanteil spiegelte die institutionelle Nachfrage nach integrierten Suiten wider, die Primär-, Sekundär- und Tertiäranalyse abdecken. Tertiäre Interpretationssoftware hat einen hohen Wert, da sie die Variantenkuration, die Erstellung klinischer Berichte und die Entscheidungsunterstützung unterstützt. Diese Funktionen stehen diagnostischen und therapeutischen Entscheidungen nahe. Sekundäranalysesoftware umfasst Funktionen zur Ausrichtung, zum Variant Calling und zur Qualitätsfilterung. Hardware-Anbieter integrieren diese Schicht zunehmend in ihre Angebote, was den Margen eigenständiger Software Druck bereiten kann.
Werkzeuge für Datenverwaltung, Speicherung und Workflow-Management gewinnen an Bedeutung, da Institutionen jährlich Hunderte von Terabytes genomischer Informationen verarbeiten. Diese Werkzeuge adressieren Anforderungen an Data Governance und Pipeline-Koordination, die allgemeine IT-Systeme nicht vollständig erfüllen. Dienstleistungen sind das am schnellsten wachsende Angebotssegment bis 2031, da vielen Institutionen interne Bioinformatik-Teams fehlen. Die Entwicklung maßgeschneiderter Pipelines ist wichtig für Long-Read-, Einzelzell- und Multiomics-Assays, die eine Konfiguration über Standardpakete hinaus erfordern. Ausgelagerte Analyse, Varianteninterpretation und Berichtserstellung versorgen Krankenhauslabore mit klinisch hochwertigen Ergebnissen, ohne eine interne Analyseinfrastruktur aufbauen zu müssen. Das Dienstleistungsmodell unterstützt auch Auftragsforschungsorganisationen, die integrierte Proben-zu-Bericht-Workflows anbieten.


Nach Workflow: Tertiäranalyse hält die größte Umsatzposition
Die Tertiäranalyse hielt im Jahr 2025 einen Workflow-Umsatzanteil von 48,24 % im Markt für die Analyse von Daten der Sequenzierung der nächsten Generation. Der Workflow umfasst Variantenannotation, Phänotyp-Genotyp-Korrelation, klinische Berichterstattung und KI-gestützte Interpretation. Seine Position zeigt, dass die zentrale Herausforderung in der NGS-Diagnostik darin besteht, Variantenlisten in evidenzbasierte klinische Schlussfolgerungen umzuwandeln. Tertiärsysteme sind mit elektronischen Patientenakten, genomischen Datenbanken wie ClinVar und COSMIC sowie regulatorischen Berichtsfunktionen verbunden. Diese Verbindungen machen den Workflow komplexer als frühere Analysestufen. Sie machen tertiäre Werkzeuge auch differenzierter in klinischen und translationalen Umgebungen.
Die Sekundäranalyse ist das am schnellsten wachsende Workflow-Segment bis 2031. Sie umfasst Read-Mapping, Variantenausrichtung und Variant Calling. Long-Read-Plattformen von Oxford Nanopore Technologies und PacBio benötigen sekundäre Pipelines, die Reads verarbeiten können, die sich über Dutzende von Kilobasen erstrecken. Dies unterscheidet sich von Short-Read-Pipelines, die für Illumina-Systeme entwickelt wurden. Modelle des maschinellen Lernens wie DeepVariant und Clair3 können die Calling-Genauigkeit verbessern, erfordern jedoch eine spezialisierte Software-Infrastruktur. Die Primäranalyse bleibt die Stufe mit der niedrigsten Marge, da Instrumentenanbieter sie zunehmend in geräteinternen oder gerätenahen Rechensystemen integrieren.
Nach Bereitstellungsmodus: Cloud führt, während Hybrid an Boden gewinnt
Die Cloud-basierte Bereitstellung machte im Jahr 2025 64,14 % des Marktes für die Analyse von Daten der Sequenzierung der nächsten Generation aus. Dieser Marktanteil spiegelt die Attraktivität der Preisgestaltung pro Probe und der flexiblen Rechenkapazität wider. Institutionen können es vermeiden, den Spitzenbedarf an Infrastruktur Jahre im Voraus zu prognostizieren. Cloud-Systeme unterstützen auch die Zusammenarbeit zwischen Standorten ohne physische Datenbewegung. Dies ist nützlich für klinische Studien an mehreren Standorten und bevölkerungsweite Programme. Es kann auch den Zugang zu zentral verwalteten Analyseumgebungen für verteilte Forschungsgruppen vereinfachen.
Die hybride Bereitstellung ist der am schnellsten wachsende Modus bis 2031. Nutzer übernehmen dieses Modell, um Cloud-Wirtschaftlichkeit mit Datensouveränitäts- und Compliance-Anforderungen in Einklang zu bringen. In einer gängigen Konfiguration verbleiben Rohdaten vor Ort, während sekundäre und tertiäre Aufgaben in der Cloud ausgeführt werden. Institutionen können indizierte und de-identifizierte Zwischendateien für rechenintensivere Verarbeitungen hochladen. On-Premises-Systeme bleiben für Verteidigungsforschungsinstitutionen, souveräne Gesundheitssysteme und Pharmaunternehmen mit sensiblen proprietären Daten relevant. Workflow-Management-Werkzeuge wie Nextflow und WDL helfen dabei, Aufgaben über lokale und Cloud-Umgebungen hinweg zu koordinieren.
Nach Anwendung: Arzneimittelentdeckung führt, während klinische Diagnostik am schnellsten wächst
Arzneimittelentdeckung und -entwicklung ist die größte Anwendung im Markt für die Analyse von Daten der Sequenzierung der nächsten Generation. Pharmaunternehmen nutzen genomische Profilierung zur Zielidentifikation, biomarkerbasierter Patientenstratifizierung und Verbindungsscreening. Die Anwendung geht nun über Bulk-RNA-Sequenzierung und routinemäßiges Variant Calling hinaus. Einzelzell-Multiomics und Perturbationsgenomik erzeugen große Datensätze aus transkriptomischen Screens über viele Verbindungen hinweg. Diese Datensätze benötigen dedizierte Analysepipelines und Datenverwaltungskapazitäten. Präzisionsmedizin und genomische Forschung sind ebenfalls relevante Umsatzbereiche für akademische Kerne, Biobanken und translationale Forschungsgruppen.
Die klinische Diagnostik soll bis 2031 mit einer CAGR von 22,82 % wachsen und ist damit die am schnellsten wachsende Anwendung. Die Marktgröße der Analyse von Daten der Sequenzierung der nächsten Generation für die klinische Diagnostik wird durch den Einsatz in der Onkologie, bei seltenen Krankheiten, in der Reproduktionsmedizin und in der Pharmakogenomik gestützt. Klinisch zertifizierte Software benötigt analytische Validierungsaufzeichnungen, Algorithmusversionskontrolle und Prüfpfade, die forschungsorientierte Plattformen möglicherweise nicht bieten. Diese Anforderungen erweitern den technischen Umfang klinischer Bioinformatikangebote. Tempus erhielt im September 2025 die FDA-510(k)-Zulassung für sein Tempus xR IVD RNA-basiertes NGS-Diagnosegerät. Die Zulassung zeigt, dass KI-fokussierte Unternehmen neben etablierten Diagnoseplattformen direkte regulatorische Engagements verfolgen.

Nach Endnutzer: Akademische Institute führen, während Auftragsforschungsorganisationen am schnellsten wachsen
Akademische und Forschungsinstitute hielten im Jahr 2025 einen Umsatzanteil von 37,84 % am Markt für die Analyse von Daten der Sequenzierung der nächsten Generation. Diese Position wird durch Fördermittel, öffentlich finanzierte Biobank-Programme und institutionelle Sequenzierungskerne aufrechterhalten. Diese Organisationen erzeugen kontinuierliche genomische Datensätze, die eine zuverlässige Analyseinfrastruktur benötigen. Universitäten und Forschungsinstitute nutzen auch weit verbreitet Open-Source-Werkzeuge wie Nextflow, GATK und Bioconductor. Kommerzielle Anbieter können diese installierte Basis mit verwalteten Cloud-Plattformen ansprechen. Krankenhäuser und klinische Labore haben einen kleineren aktuellen Anteil, aber einen höheren Wert pro Fall aufgrund von Prüf-, Berichterstattungs- und regulatorischen Verpflichtungen.
Auftragsforschungsorganisationen sind die am schnellsten wachsende Endnutzerkategorie bis 2031. Pharma- und Biotechnologieunternehmen lagern Pipeline-Entwicklung, Proben-zu-Bericht-Ausführung, Datenverwaltung und regulatorische Einreichungsarbeiten aus. Auftragsforschungsorganisationen können differenzierte Vermögenswerte aufbauen, wenn sie validierte Pipelines und genomische Datensätze über Kundenprojekte hinweg ansammeln. Diese Vermögenswerte können Folgearbeiten und spezialisierte Analysedienstleistungen unterstützen. Globale Auftragsforschungsorganisationen müssen auch grenzüberschreitende genomische Datenübertragungen gemäß Regeln wie DSGVO und PIPL berücksichtigen. Dieser Bedarf erhöht die Investitionen in jurisdiktionsspezifische Analysekapazitäten und föderierte Rechenmodelle.
Geografische Analyse
Nordamerika hielt im Jahr 2025 einen Umsatzanteil von 42,41 % am Markt für die Analyse von Daten der Sequenzierung der nächsten Generation. Die Position der Region spiegelt die Sequenzierungskapazität in akademischen medizinischen Zentren, nationalen Laboratorien und pharmazeutischen Genomikgruppen wider. NIH All of Us verknüpft in seiner Veröffentlichung vom Juni 2026 mehr als 535.000 Whole-Genome-Sequenzen mit fast 482.000 elektronischen Patientenakten[3]. Dieser Umfang unterstützt die anhaltende Nachfrage nach Analyseplattformen und -dienstleistungen. Kanada und Mexiko tragen durch Genomikprogramme und eine wachsende biomedizinische Forschungsinfrastruktur zur Nachfrage bei. Die Vereinigten Staaten verfügen über eine große Basis an Softwarelizenzen, die an installierte Illumina-Systeme und NGS-fokussierte Auftragsforschungsorganisationsaktivitäten gebunden sind.
Europa hat eine bedeutende Position im Markt für die Analyse von Daten der Sequenzierung der nächsten Generation, angeführt von Großbritannien, Deutschland und Frankreich. Nationale Genomikprogramme in diesen Ländern unterstützen die Nachfrage nach skalierbarer Analyseinfrastruktur. Deutschlands genomDE-Initiative lenkt öffentliche Ressourcen in die Infrastruktur der Genommedizin. Die Ausweitung der Krankenversicherung des Landes für die Erstattung von Tumorprofilen im Jahr 2024 fügte schätzungsweise 80.000 Tests jährlich hinzu. Frankreich verpflichtete sich im Rahmen seines nationalen Plans zu 670 Millionen EUR (720 Millionen USD zu durchschnittlichen Wechselkursen von 2025) für 12 regionale Genomikplattformen. Der EU-IVDR-Übergang erhöht den Bedarf an Werkzeugen, die validierte und dokumentierte Laborworkflows unterstützen.
Der Asien-Pazifik-Raum ist die am schnellsten wachsende regionale Fläche bis 2031. China profitiert von MGI-getriebenen Sequenzierungskostensenkungen, Indien von einer wachsenden Biotechnologie-Forschungsbasis und Japan von einem erstattungsgestützten klinischen NGS-Umfeld. Südkorea, Australien und Indien tragen durch akademische Sequenzierungskerne, Gesundheitsbehördenprogramme und die Expansion der Auftragsforschung Kapazitäten bei. Der Nahe Osten und Afrika sind frühere Entwicklungsstufen, angeführt von GCC-Investitionen in genomische Medizin und südafrikanischen Forschungssequenzierungsprogrammen. Brasiliens Initiative Genomas Brasil zeigt, wie staatlich gelenkte Programme die genomische Kapazität in Südamerika gestalten können.

Wettbewerbslandschaft
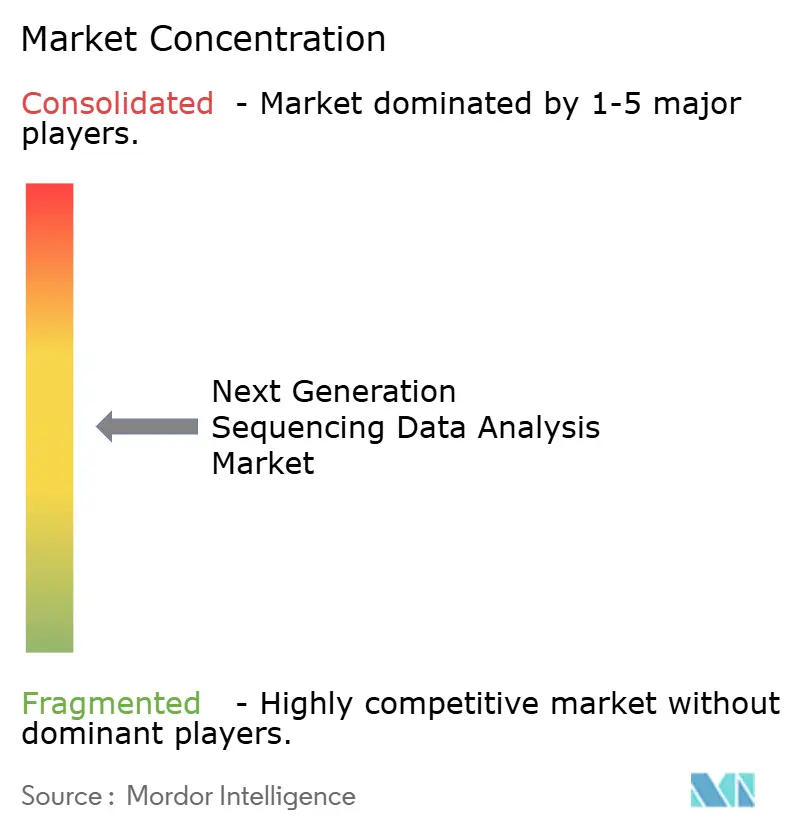
Der Markt für die Analyse von Daten der Sequenzierung der nächsten Generation weist eine mäßig konzentrierte, gestufte Wettbewerbsstruktur auf. Zu den Instrument-Software-Integratoren gehören Illumina, Thermo Fisher Scientific und Oxford Nanopore Technologies. Cloud-native Plattformen wie DNAnexus und Seven Bridges Genomics konkurrieren durch Skalierbarkeit, Ökosystemkonnektivität und Datenverwaltung. KI-fokussierte Interpretationsanbieter umfassen SOPHiA GENETICS, Fabric Genomics und Sentieon. Ihre Position hängt von der algorithmischen Leistung und der Integration in klinische Workflows ab. Der Markt für die Analyse von Daten der Sequenzierung der nächsten Generation bleibt angreifbar, da Cloud-Computing die Eintrittsbarrieren senkt, auch wenn bestehende Plattformen eine Workflow-Bindung aufbauen.
SOPHiA GENETICS berichtete, dass seine SOPHiA DDM-Plattform seit 2014 mehr als 2,5 Millionen Fälle in mehr als 800 Institutionen in 70 Ländern analysiert hat. Im Juni 2026 unterzeichnete das Unternehmen ein Memorandum of Understanding mit dem Memorial Sloan Kettering Cancer Center, um ein gemeinsames Präzisionsonkologie-Unternehmen zu erkunden. Illumina veröffentlichte DRAGEN v4.5 im April 2026 mit Funktionen zum somatischen Calling mittels maschinellem Lernen. Im März 2026 weiteten Illumina und Labcorp ihre Zusammenarbeit aus, um Flüssigbiopsie- und Festtumor-IVD-Testkits mit integrierter Datenanalyse gemeinsam zu vermarkten. Diese Schritte zeigen die Bedeutung der Kombination von Analysesoftware, klinischen Workflows und Testzugang.
Seltene Krankheiten und Neugeborenenscreening bleiben Bereiche, in denen die klinische Tertiäranalyse eine spezialisierte phänotypgeführte Interpretation und Datenbanken für seltene Varianten benötigt. Die multi-institutionelle föderierte Analyse verfügt auch über begrenzte ausgereifte kommerzielle Werkzeuge, wo Patienteninformationen institutionelle Systeme nicht verlassen können. Anbieter entwickeln datenschutzwahrende Analyseansätze auf Basis homomorpher Verschlüsselung und sicherer Mehrparteienberechnung. Sentieon veranschaulicht die anhaltende Rolle der Recheneffizienz durch GPU-beschleunigtes Variant Calling. Im Markt für die Analyse von Daten der Sequenzierung der nächsten Generation ist auch ein stärkerer Fokus auf den Schutz analytischer Algorithmen zu beobachten. Das DRAGEN-Update von Illumina spiegelt wider, wie sich der Wettbewerb von der Sequenzierungschemie auf Softwaremethoden und klinische Interpretation ausweitet.
Marktführer der Analyse von Daten der Sequenzierung der nächsten Generation
-
Illumina, Inc.
-
Thermo Fisher Scientific Inc.
-
QIAGEN N.V.
-
F. Hoffmann-La Roche Ltd
-
DNAnexus, Inc.
- *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert

Jüngste Branchenentwicklungen
- September 2026: Ultima Genomics gab eine Zusammenarbeit mit NVIDIA bekannt, um eine Pangenomik-bewusste Whole-Genome-Sequenzierung (WGS) in beispiellosem Maßstab zu ermöglichen. Die Pangenomik-bewusste Analyse wurde zu einem wichtigen Werkzeug, um eine höhere Sensitivität und Präzision der NGS zu ermöglichen und den Referenzgenom-Bias zu reduzieren, indem die globale genetische Vielfalt des Menschen erfasst wird.
- August 2026: Lexogen gab die Verfügbarkeit von designierten NGS-Service-Workflows bekannt, die in Übereinstimmung mit den Grundsätzen der Guten Klinischen Laborpraxis der Weltgesundheitsorganisation betrieben werden.


Berichtsumfang des globalen Marktes für die Analyse von Daten der Sequenzierung der nächsten Generation
Gemäß dem Umfang des Berichts ist die Analyse von Daten der Sequenzierung der nächsten Generation (NGS) der Prozess, bei dem Daten, die durch Hochdurchsatz-DNA- oder RNA-Sequenzierung erzeugt werden, in aussagekräftige biologische Ergebnisse umgewandelt werden.
Der Markt für die Analyse von Daten der Sequenzierung der nächsten Generation ist nach Angebot in Software und Dienstleistungen segmentiert. Das Software-Segment umfasst Software zur Primärdatenanalyse, Software zur Sekundäranalyse, Software zur Tertiäranalyse und -interpretation, Werkzeuge zur Datenverwaltung und -speicherung sowie Workflow-Management-Software. Das Dienstleistungssegment umfasst Datenanalysedienstleistungen, Datenverwaltungs- und Speicherdienstleistungen, Pipeline-Entwicklungs- und Anpassungsdienstleistungen sowie sonstige Dienstleistungen. Nach Workflow ist der Markt in Primäranalyse, Sekundäranalyse und Tertiäranalyse segmentiert. Nach Bereitstellungsmodus ist der Markt in Cloud-basierte, On-Premises- und Hybridlösungen segmentiert. Nach Anwendung ist der Markt in klinische Diagnostik, Arzneimittelentdeckung und -entwicklung, Präzisionsmedizin, genomische Forschung und sonstige Anwendungen segmentiert. Nach Endnutzer ist der Markt in akademische und Forschungsinstitute, Krankenhäuser und klinische Labore, Pharma- und Biotechnologieunternehmen, Auftragsforschungsorganisationen und sonstige Endnutzer segmentiert. Nach Geografie ist der Markt in Nordamerika, Europa, Asien-Pazifik, den Nahen Osten und Afrika sowie Südamerika segmentiert. Der Marktbericht deckt auch die geschätzten Marktgrößen und Trends für 17 Länder in den wichtigsten Regionen weltweit ab. Für jedes Segment werden Marktgröße und Prognose in Wert (USD) angegeben.
| Software | Software zur Primärdatenanalyse |
| Software zur Sekundäranalyse | |
| Software zur Tertiäranalyse und -interpretation | |
| Werkzeuge zur Datenverwaltung und -speicherung | |
| Workflow-Management-Software | |
| Dienstleistungen | Datenanalysedienstleistungen |
| Datenverwaltungs- und Speicherdienstleistungen | |
| Pipeline-Entwicklung und -Anpassung | |
| Sonstige Dienstleistungen |
| Primäranalyse |
| Sekundäranalyse |
| Tertiäranalyse |
| Cloud-basiert |
| On-Premise |
| Hybrid |
| Klinische Diagnostik |
| Arzneimittelentdeckung und -entwicklung |
| Präzisionsmedizin |
| Genomische Forschung |
| Sonstige Anwendungen |
| Akademische und Forschungsinstitute |
| Krankenhäuser und klinische Labore |
| Pharma- und Biotechnologieunternehmen |
| Auftragsforschungsorganisationen |
| Sonstige Endnutzer |
| Nordamerika | Vereinigte Staaten |
| Kanada | |
| Mexiko | |
| Europa | Deutschland |
| Vereinigtes Königreich | |
| Frankreich | |
| Italien | |
| Spanien | |
| Übriges Europa | |
| Asien-Pazifik | China |
| Japan | |
| Indien | |
| Australien | |
| Südkorea | |
| Übriger Asien-Pazifik-Raum | |
| Naher Osten und Afrika | GCC |
| Südafrika | |
| Übriger Naher Osten und Afrika | |
| Südamerika | Brasilien |
| Argentinien | |
| Übriges Südamerika |
| Nach Angebot | Software | Software zur Primärdatenanalyse |
| Software zur Sekundäranalyse | ||
| Software zur Tertiäranalyse und -interpretation | ||
| Werkzeuge zur Datenverwaltung und -speicherung | ||
| Workflow-Management-Software | ||
| Dienstleistungen | Datenanalysedienstleistungen | |
| Datenverwaltungs- und Speicherdienstleistungen | ||
| Pipeline-Entwicklung und -Anpassung | ||
| Sonstige Dienstleistungen | ||
| Nach Workflow | Primäranalyse | |
| Sekundäranalyse | ||
| Tertiäranalyse | ||
| Nach Bereitstellungsmodus | Cloud-basiert | |
| On-Premise | ||
| Hybrid | ||
| Nach Anwendung | Klinische Diagnostik | |
| Arzneimittelentdeckung und -entwicklung | ||
| Präzisionsmedizin | ||
| Genomische Forschung | ||
| Sonstige Anwendungen | ||
| Nach Endnutzer | Akademische und Forschungsinstitute | |
| Krankenhäuser und klinische Labore | ||
| Pharma- und Biotechnologieunternehmen | ||
| Auftragsforschungsorganisationen | ||
| Sonstige Endnutzer | ||
| Nach Geografie | Nordamerika | Vereinigte Staaten |
| Kanada | ||
| Mexiko | ||
| Europa | Deutschland | |
| Vereinigtes Königreich | ||
| Frankreich | ||
| Italien | ||
| Spanien | ||
| Übriges Europa | ||
| Asien-Pazifik | China | |
| Japan | ||
| Indien | ||
| Australien | ||
| Südkorea | ||
| Übriger Asien-Pazifik-Raum | ||
| Naher Osten und Afrika | GCC | |
| Südafrika | ||
| Übriger Naher Osten und Afrika | ||
| Südamerika | Brasilien | |
| Argentinien | ||
| Übriges Südamerika | ||


Im Bericht beantwortete Schlüsselfragen
Wie groß ist der Markt für die Analyse von Daten der Sequenzierung der nächsten Generation?
Der Markt für die Analyse von Daten der Sequenzierung der nächsten Generation betrug im Jahr 2026 1,32 Milliarden USD und soll bis 2031 bei einer CAGR von 20,24 % 3,32 Milliarden USD erreichen.
Welches Angebot führt die Ausgaben für die NGS-Datenanalyse an?
Software führte mit einem Umsatzanteil von 58,31 % im Jahr 2025, da Institutionen integrierte Werkzeuge bevorzugen, die die Analyse von der Primärverarbeitung bis zur Interpretation unterstützen.
Warum wächst die klinische Diagnostik schnell?
Die klinische Diagnostik soll bis 2031 mit einer CAGR von 22,82 % wachsen, da NGS-Tests in der Onkologie, bei seltenen Krankheiten, in der Reproduktionsmedizin und in der Pharmakogenomik zunehmen.
Welches Bereitstellungsmodell hat die größte installierte Basis?
Die Cloud-basierte Bereitstellung hielt im Jahr 2025 einen Anteil von 64,14 %, während die hybride Bereitstellung am schnellsten wächst, da Institutionen flexible Rechenkapazität mit Datensouveränitätsanforderungen in Einklang bringen.
Welche Region führt beim NGS-Datenanalyse-Umsatz?
Nordamerika hielt im Jahr 2025 einen Umsatzanteil von 42,41 %, gestützt durch Forschungskapazitäten, klinische Programme und groß angelegte Genomikinitiativen.
Was schränkt die Einführung von Plattformen zur genomischen Analyse ein?
Datensouveränitätsanforderungen und ein Mangel an klinisch ausgebildeten Bioinformatik- und Validierungsfachleuten können die Plattformbereitstellung und den Betrieb erschweren.


 Ihre Daten sind sicher und werden niemals verkauft oder weitergegeben.
