
Taille et part du marché des services d'infrastructure GPU gérés
VUE D’ENSEMBLE DU MARCHÉ
| Période d'étude | 2021 - 2032 |
|---|---|
| Taille du Marché (2027) | 4.56 Milliards de dollars |
| Taille du Marché (2032) | 14.21 Milliards de dollars |
| Taux de croissance (2027 - 2032) | 25.52 % |
| Marché à la Croissance la Plus Rapide | Asie-Pacifique |
| Plus Grand Marché | Amérique du Nord |
| Concentration du Marché | Moyen |
Acteurs majeurs *Avis de non-responsabilité : les principaux acteurs sont triés sans ordre particulier Image © Mordor Intelligence. La réutilisation nécessite une attribution sous CC BY 4.0. | |
Analyse du marché des services d'infrastructure GPU gérés par Mordor Intelligence
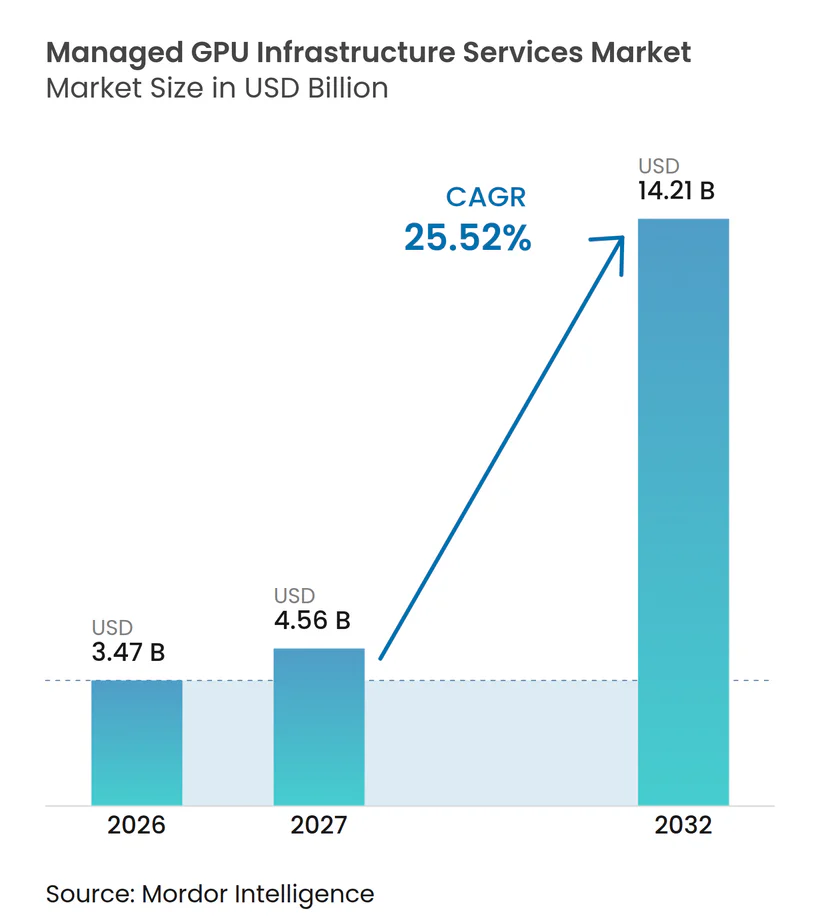
La taille du marché des services d'infrastructure GPU gérés devrait croître de 3,47 milliards USD en 2026 à 4,56 milliards USD en 2027 et devrait atteindre 14,21 milliards USD d'ici 2032 à un CAGR de 25,52 % sur la période 2027-2032. Le marché des services d'infrastructure GPU gérés évolue des achats périodiques de matériel vers des services informatiques à l'échelle de la production sous contrat, assortis d'engagements de niveau de service. La formation et l'inférence en IA générative accroissent le besoin de capacité fiable, de support opérationnel et de performances prévisibles. Les fournisseurs qui combinent orchestration, surveillance et opérations gérées peuvent servir des charges de travail plus complexes que ceux qui proposent une simple location de GPU. La disponibilité du matériel, notamment la mémoire à haute bande passante et la capacité d'encapsulation avancée, limite le rythme auquel les fournisseurs peuvent mettre en service de nouveaux clusters. Les exigences en matière d'informatique souveraine et les règles de résidence des données créent également des opportunités pour les fournisseurs régionaux capables de prendre en charge des charges de travail réglementées dans la juridiction requise.
Principaux enseignements du rapport
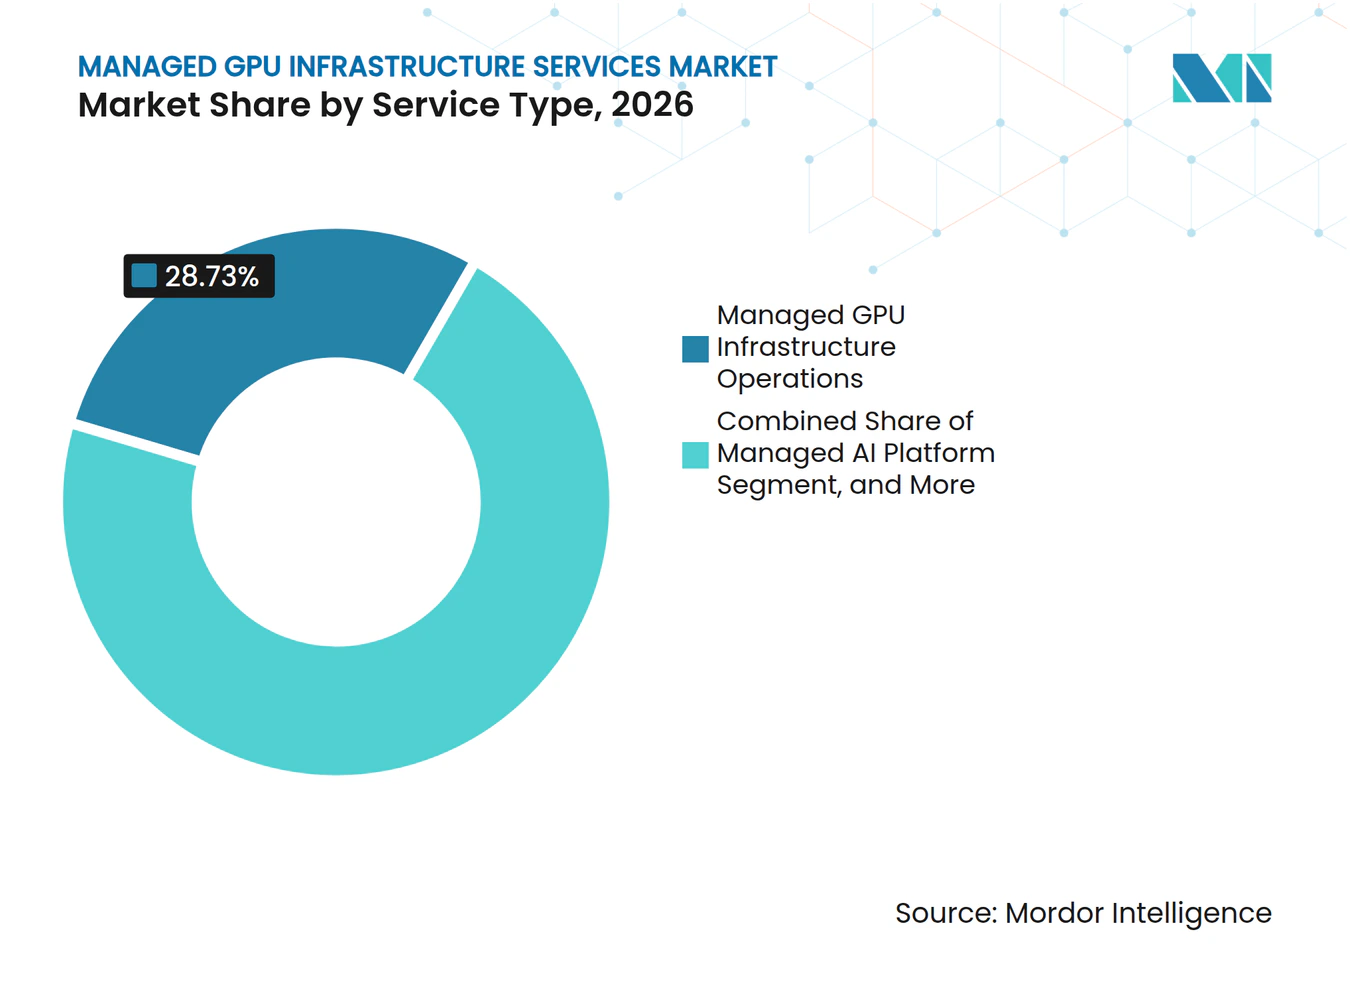
- Par type de service, les opérations d'infrastructure GPU gérées représentaient 28,73 % de la part du marché des services d'infrastructure GPU gérés en 2026, tandis que les opérations d'inférence gérée et de service de modèles devraient se développer à un CAGR de 26,81 % jusqu'en 2032.
- Par charge de travail GPU, l'inférence IA et le service de modèles représentaient 36,41 % de la part du marché des services d'infrastructure GPU gérés en 2026, tandis que l'affinage et la RAG devraient se développer à un CAGR de 27,62 % jusqu'en 2032.
- Par modèle de déploiement, le déploiement basé sur le cloud représentait 68,58 % de la part du marché des services d'infrastructure GPU gérés en 2026 et devrait se développer à un CAGR de 27,33 % jusqu'en 2032.
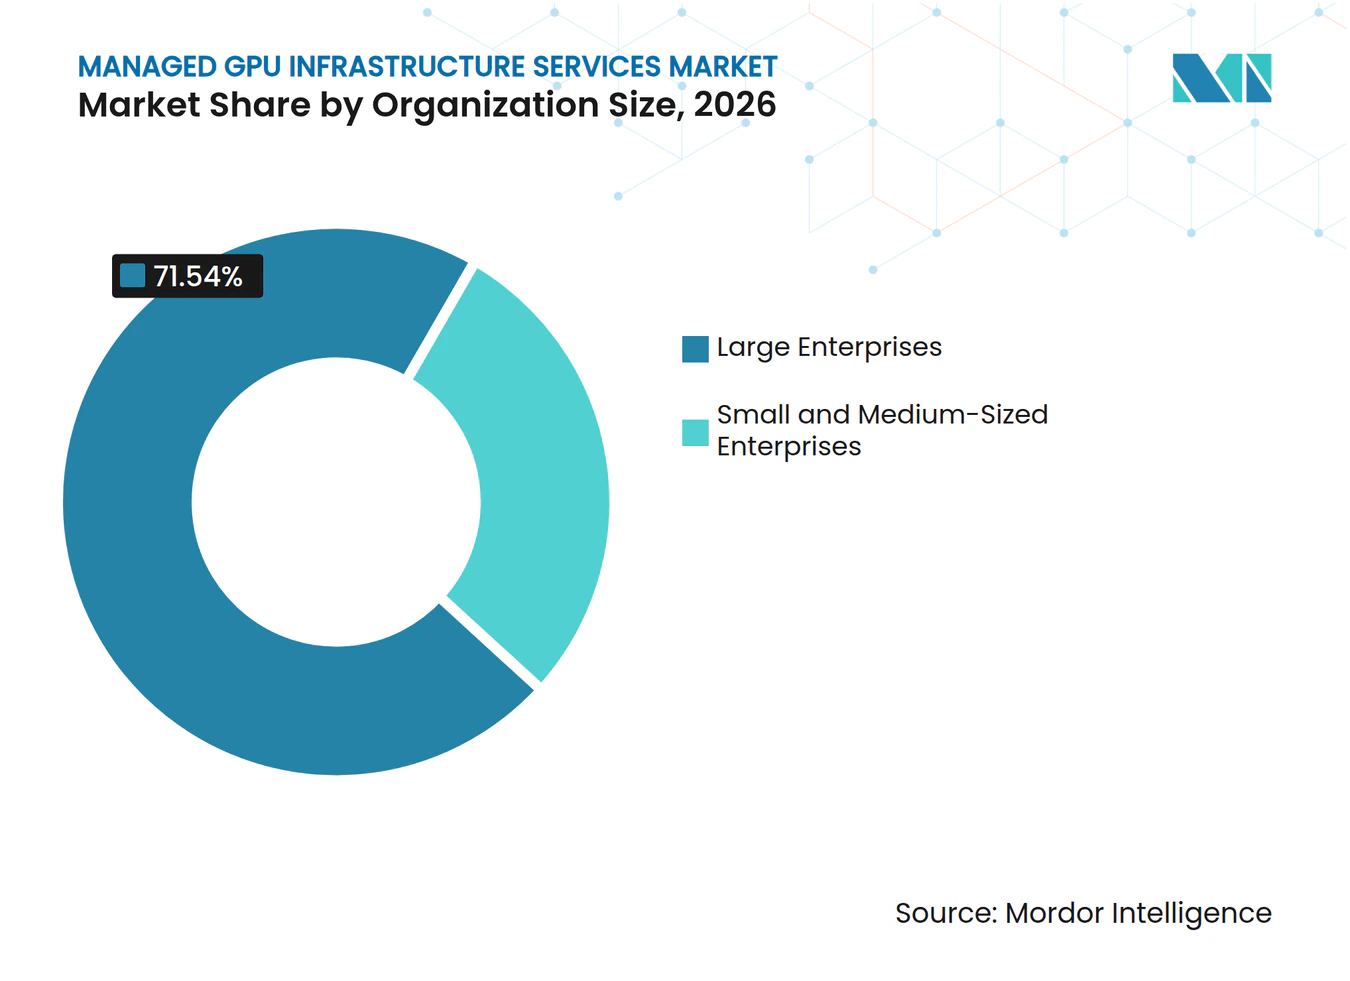
- Par taille d'organisation, les grandes entreprises détenaient une part de 71,54 % en 2026, tandis que les PME devraient se développer à un CAGR de 26,59 % jusqu'en 2032.
- Par utilisateur final, l'informatique et les télécommunications détenaient une part de 71,54 % en 2026, tandis que la santé et les sciences de la vie devraient se développer à un CAGR de 28,27 % jusqu'en 2032.
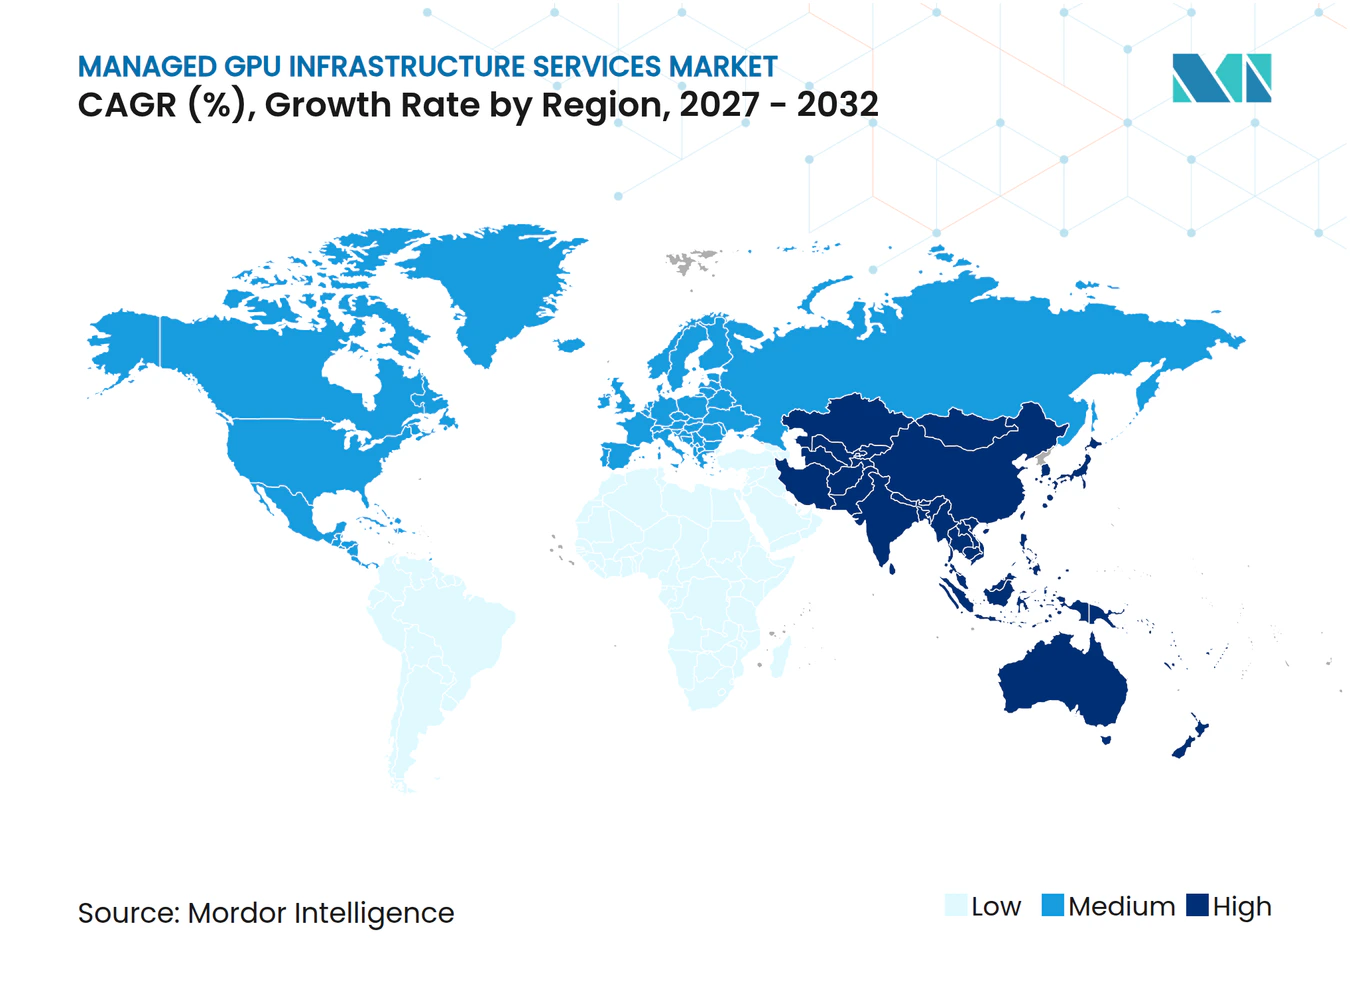
- Par géographie, l'Amérique du Nord détenait 38,64 % de la part du marché des services d'infrastructure GPU gérés en 2026, tandis que l'Asie-Pacifique devrait se développer à un CAGR de 27,91 % jusqu'en 2032.
Remarque : Les chiffres du marché présentés dans ce rapport reposent sur le cadre d'estimation exclusif de Mordor Intelligence, qui combine neuf mois de données réelles avec les projections du quatrième trimestre pour l'année de référence 2026.
Tendances et Analyses du Marché
Analyse de l'impact des moteurs*
| MOTEUR | (~) % D'IMPACT SUR LES PRÉVISIONS DE CAGR | PERTINENCE GÉOGRAPHIQUE | HORIZON TEMPOREL DE L'IMPACT |
|---|---|---|---|
| Formation et inférence en IA générative à l'échelle de la production | +8.5% | Mondial | Moyen terme (2-4 ans) |
| Densité d'inférence croissante et charges de travail d'IA agentique | +7.2% | Mondial | Court terme (≤ 2 ans) |
| Passage de la possession de GPU à une capacité gérée élastique | +5.8% | Amérique du Nord et Europe | Moyen terme (2-4 ans) |
| IA souveraine, résidence des données et demande de charges de travail réglementées | +3.4% | Europe, Asie-Pacifique, Moyen-Orient | Moyen terme (2-4 ans) |
| Optimisation de l'utilisation des GPU par allocation fractionnée et ordonnancement | +2.1% | Mondial | Court terme (≤ 2 ans) |
| Refroidissement géré, alimentation et opérations de clusters pour les racks à haute densité | +1.3% | Amérique du Nord, cœur de l'Asie-Pacifique | Long terme (≥ 4 ans) |
| Source: Mordor Intelligence | |||
Formation et inférence en IA générative à l'échelle de la production
La formation de modèles de langage de pointe nécessite des clusters composés de plusieurs milliers d'accélérateurs fonctionnant pendant de longues périodes. L'inférence en production requiert également une capacité soutenue, car les services doivent traiter des millions de requêtes quotidiennes avec des exigences strictes en matière de latence. Ces exigences dépassent les capacités d'approvisionnement et d'exploitation de nombreuses équipes informatiques d'entreprise. CoreWeave a déclaré un chiffre d'affaires de 5,1 milliards USD pour l'exercice 2025, contre 1,9 milliard USD pour l'exercice 2024, soulignant l'ampleur des engagements de capacité gérée sous contrat.[1] Eli Lilly a déployé 1 016 GPU NVIDIA Blackwell Ultra en octobre 2025 pour soutenir la formation de modèles de fondation pour la découverte de médicaments via Lilly TuneLab. Le marché des services d'infrastructure GPU gérés en bénéficie, car les secteurs sensibles aux données considèrent l'accès à une capacité informatique gérée comme une exigence opérationnelle plutôt que comme un besoin de projet temporaire.
Densité d'inférence croissante et charges de travail d'IA agentique
Une requête de chatbot conventionnelle peut libérer un GPU en quelques millisecondes après avoir produit une réponse. Une session agentique peut impliquer des appels de modèles répétés, des étapes de récupération et des actions d'outils, mobilisant les ressources informatiques beaucoup plus longtemps. Ce comportement augmente la densité et la durée de la demande d'inférence. Les fournisseurs doivent configurer l'infrastructure autour de la bande passante mémoire, de l'ordonnancement, du traitement par lots et de la gestion des temps de réponse. Les opérations d'inférence gérée et de service de modèles devraient se développer à un CAGR de 26,81 % jusqu'en 2032, reflétant cette exigence de production. Le marché des services d'infrastructure GPU gérés favorise donc les plateformes capables d'exploiter des flottes d'inférence persistantes sans que chaque client ait à constituer une équipe spécialisée en infrastructure.
Passage de la possession de GPU à une capacité gérée élastique
La possession de GPU comporte un risque plus élevé lorsque les générations de matériel évoluent rapidement. Une entreprise qui achète un cluster peut faire face à une efficacité réduite lorsque de nouvelles architectures deviennent disponibles. Les services gérés permettent aux clients d'accéder à une capacité plus récente sans posséder d'équipement susceptible de devenir obsolète. CoreWeave a déclaré un carnet de commandes de 55,6 milliards USD au troisième trimestre 2025, reflétant d'importants engagements contractuels pour l'infrastructure IA. Les engagements réservés peuvent également offrir aux prestataires de services la visibilité sur la demande nécessaire pour financer de nouvelles capacités de centres de données. Ce changement soutient le marché des services d'infrastructure GPU gérés, car la capacité sous contrat peut être plus adaptée que l'infrastructure détenue en propre pour répondre à l'évolution des exigences des charges de travail IA.
IA souveraine, résidence des données et demande de charges de travail réglementées
Les politiques gouvernementales exigent de plus en plus un contrôle accru sur la localisation et l'exploitation des ressources informatiques IA. La Commission européenne a proposé un acte sur le développement du cloud et de l'IA qui établit un cadre de souveraineté pour les services cloud et IA.[2] Les exigences d'assurance les plus élevées favorisent les fournisseurs disposant d'opérations, de personnel et de chaînes d'approvisionnement contrôlés localement. La mission IndiaAI de l'Inde a alloué une infrastructure GPU à 14 fournisseurs nationaux dans le cadre d'un programme de 10 372 crores INR (1,23 milliard USD), comme indiqué dans le document source. Les mesures régionales de localisation des données créent une exigence de service distincte au-delà du simple accès aux accélérateurs. Le marché des services d'infrastructure GPU gérés peut en bénéficier lorsque les fournisseurs démontrent une conformité vérifiable, un hébergement national et un support opérationnel local.
Analyse de l'impact des freins*
| FREIN | (~) % D'IMPACT SUR LES PRÉVISIONS DE CAGR | PERTINENCE GÉOGRAPHIQUE | HORIZON TEMPOREL DE L'IMPACT |
|---|---|---|---|
| Volatilité de l'approvisionnement en GPU, HBM et encapsulation avancée | -4.2% | Mondial | Court terme (≤ 2 ans) |
| Contraintes de modernisation de l'alimentation et du refroidissement à haute densité | -3.1% | Amérique du Nord et Europe | Moyen terme (2-4 ans) |
| Obsolescence rapide des accélérateurs et risque de mise à niveau | -1.8% | Mondial | Long terme (≥ 4 ans) |
| Sécurité des données, isolation multi-locataires et préoccupations de conformité | -1.4% | Mondial, avec focus Asie-Pacifique et Europe | Moyen terme (2-4 ans) |
| Source: Mordor Intelligence | |||
Volatilité de l'approvisionnement en GPU, HBM et encapsulation avancée
La chaîne d'approvisionnement des accélérateurs IA de pointe reste contrainte par la mémoire à haute bande passante et l'encapsulation avancée. Ces composants peuvent limiter la production d'accélérateurs même lorsque la capacité de fabrication de puces logiques est disponible. Un groupe restreint de fournisseurs contrôle une grande part de l'approvisionnement en encapsulation avancée et en mémoire. Les nouvelles lignes de fabrication nécessitent de longs délais d'approvisionnement, ce qui limite les ajouts rapides de capacité. Pour les prestataires de services, les pénuries peuvent retarder la mise en service des clusters et allonger les listes d'attente des clients. Le marché des services d'infrastructure GPU gérés peut connaître une expansion plus lente et des pressions sur les prix lorsque la demande contractuelle dépasse l'offre de matériel déployable.
Contraintes de modernisation de l'alimentation et du refroidissement à haute densité
Les déploiements de formation IA nécessitent des densités de racks bien supérieures à celles de l'infrastructure d'entreprise traditionnelle. Les clusters basés sur le NVIDIA GB300 NVL72 peuvent consommer jusqu'à 142 kW par rack.[3] De nombreuses installations existantes ont été conçues pour des charges électriques bien inférieures et un refroidissement par air conventionnel. Les clusters à plus haute densité nécessitent un refroidissement liquide direct ou des systèmes d'immersion, ainsi que des modifications connexes de la distribution électrique. Ces besoins de modernisation augmentent les exigences en capital et en exécution pour les opérateurs de centres de données. Le marché des services d'infrastructure GPU gérés pourrait donc favoriser les fournisseurs disposant d'installations plus récentes ou des ressources nécessaires pour reconcevoir les sites existants.
*Nos prévisions considèrent les impacts des moteurs et des contraintes comme directionnels et non additifs. Les prévisions d'impact reflètent la croissance de référence, les effets de composition et les interactions entre variables.
Analyse des segments
Par type de service :
les opérations et le support à l'inférence soutiennent l'adoption géréeLes opérations d'infrastructure GPU gérées représentaient 28,73 % du chiffre d'affaires total des services en 2026. Le segment couvre les tâches du cycle de vie des clusters telles que les mises à jour du micrologiciel, la planification de la capacité, la surveillance de l'état et la remédiation des pannes. Les organisations exploitant des clusters composés de plusieurs milliers de GPU manquent souvent du personnel interne nécessaire pour maintenir un temps de fonctionnement conforme aux niveaux de service. Les opérations entièrement gérées comblent cette lacune en combinant la supervision de l'infrastructure avec le support client. Kubernetes géré et l'orchestration de conteneurs soutiennent le déploiement d'applications dans des environnements informatiques partagés. Les opérations de plateforme IA gérée et de MLOps peuvent ensuite aider les clients à surveiller les modèles et à gérer les flux de travail de production.
Les opérations d'inférence gérée et de service de modèles devraient se développer à un CAGR de 26,81 % jusqu'en 2032. Leur périmètre comprend le routage des modèles, la mise à l'échelle automatique, la mise en cache des tokens et la gestion de la latence pour les services en production. Ces fonctions deviennent plus importantes à mesure que les entreprises passent de la formation occasionnelle de modèles à l'inférence continue. L'infrastructure gérée de formation et d'affinage de modèles soutient également les organisations travaillant avec des données propriétaires sensibles. Lambda a annoncé en octobre 2026 qu'il intégrerait le NVIDIA Run:ai open source avec Lambda Kubernetes Service pour le partage de fractions de GPU, l'ordonnancement tenant compte de la topologie, les quotas de partage équitable et la remédiation automatisée des nœuds.[4] Les clients peuvent utiliser ces fonctions pour gérer une infrastructure partagée tout en maintenant l'accès aux charges de travail et l'allocation des ressources selon des règles opérationnelles définies. Le modèle de service réduit également la nécessité de constituer des équipes distinctes pour l'administration des clusters, la politique d'ordonnancement et la remédiation quotidienne. Ces capacités montrent pourquoi la différenciation des services va au-delà du simple accès au matériel dans le secteur des services d'infrastructure GPU gérés.



Par charge de travail GPU :
la demande d'inférence remodèle l'utilisation des clustersL'inférence IA et le service de modèles représentaient 36,41 % du chiffre d'affaires total des services en 2026. Les entreprises utilisent de plus en plus les systèmes IA pour servir des applications en temps réel plutôt que de simples tâches de traitement par lots. Les charges de travail d'inférence mettent particulièrement l'accent sur la bande passante mémoire, le temps de réponse et l'allocation efficace des ressources. Les fournisseurs doivent configurer les clusters pour un service de production stable plutôt que pour les seules performances de pointe en formation. La formation de modèles de fondation reste pertinente pour les laboratoires IA de pointe disposant d'importantes exigences en données et en calcul. Les modèles à poids ouverts réduisent la nécessité pour de nombreuses organisations de former de grands modèles depuis le début.
L'affinage et la RAG devraient se développer à un CAGR de 27,62 % jusqu'en 2032. De nombreuses organisations adaptent les modèles de pointe ou à poids ouverts existants à leurs propres données plutôt que de construire des modèles de fondation de zéro. Cette approche crée une demande d'environnements sécurisés prenant en charge le développement et l'évaluation itératifs de modèles. Eli Lilly, Roche et Bristol Myers Squibb ont annoncé des déploiements dédiés de GPU SuperPOD jusqu'à mi-2026 pour les charges de travail IA liées à la recherche. Ces déploiements montrent que les utilisateurs scientifiques ont besoin d'un accès répétable à la capacité informatique lors de cycles de recherche itératifs. Les fournisseurs peuvent soutenir ce travail grâce à des environnements gérés combinant contrôle de l'infrastructure et continuité opérationnelle. Le calcul haute performance et la simulation scientifique conservent une demande distincte de la part des utilisateurs de la recherche, de l'ingénierie et du calcul technique. Les jumeaux numériques et le rendu utilisent également la capacité GPU gérée, bien que l'inférence et l'affinage prennent une part croissante des ressources disponibles.
Par modèle de déploiement :
le cloud est en tête tandis que l'hybride soutient les charges de travail contrôléesLe déploiement basé sur le cloud représentait 68,58 % de la taille du marché des services d'infrastructure GPU gérés en 2026. Il devrait également se développer à un CAGR de 27,33 % jusqu'en 2032. Les services cloud permettent aux clients de passer d'une petite exécution d'affinage à un cluster de formation beaucoup plus grand sans acheter de matériel physique. Cette flexibilité convient aux organisations dont la demande est inégale entre les cycles de développement et les périodes de production. Elle offre également aux fournisseurs un moyen de mutualiser la capacité entre les clients. Le modèle cloud soutient le marché plus large des services d'infrastructure GPU gérés en rendant le calcul avancé accessible via des modèles de service basés sur la consommation.
Les déploiements GPU gérés sur site restent pertinents pour les organisations confrontées à des restrictions d'exportation de données ou nécessitant une très faible latence. Les utilisateurs gouvernementaux et de défense peuvent également nécessiter une isolation physique pour certaines charges de travail. Les environnements hybrides et multi-cloud permettent aux entreprises de séparer l'inférence publique du développement de modèles propriétaires. Red Hat identifie le matériel, le tissu, l'ordonnanceur et la virtualisation comme des couches distinctes nécessitant des contrôles alignés pour l'isolation GPU multi-locataires. Cette conception en couches reflète le travail opérationnel requis lorsque les clients utilisent plus d'un environnement d'infrastructure. Elle aide également à expliquer pourquoi les services gérés sont pertinents lorsque les organisations ont besoin de politiques communes sur des sites distincts. Les politiques d'informatique souveraine peuvent exiger que certaines charges de travail restent dans une juridiction définie. Ces conditions créent une demande pour des fournisseurs capables d'exploiter des environnements coordonnés sur des infrastructures cloud, locales et souveraines.
Par taille d'organisation :
les grandes entreprises sont en tête, les PME améliorent leur accèsLes grandes entreprises détenaient une part de 71,54 % en 2026. Elles peuvent s'engager dans des contrats réservés pluriannuels qui soutiennent les décisions d'investissement dans les centres de données par les néoclouds et les hyperscalers. Les engagements réservés peuvent offrir des prix inférieurs à l'utilisation à la demande, mais nécessitent une planification claire des charges de travail et une capacité financière. Les grands clients achètent souvent un support opérationnel de plus grande valeur, une isolation de sécurité, des configurations réseau personnalisées et une intégration MLOps. Ces services contribuent à maintenir une capacité prévisible pour les programmes IA d'entreprise. La concentration des grands contrats offre également aux fournisseurs une base plus solide pour financer l'expansion de l'infrastructure.
Les PME devraient se développer à un CAGR de 26,59 % jusqu'en 2032. Les services GPU sans serveur et la facturation à la seconde réduisent l'engagement minimum nécessaire pour utiliser le calcul haute performance. L'allocation fractionnée permet à un client d'utiliser une partie d'un GPU au lieu de réserver un appareil complet. L'ordonnancement à partage équitable et la préemption d'instances spot peuvent rendre les pools partagés plus pratiques pour les charges de travail plus petites. Le provisionnement automatisé peut également limiter la charge administrative des équipes ne disposant pas de personnel dédié à l'infrastructure. Ces modèles de consommation permettent aux clients plus petits d'adapter plus étroitement l'utilisation de la capacité à la durée et au schéma de demande d'un projet. Ces modèles peuvent élargir l'accès aux organisations sans budget dédié à l'infrastructure IA. La demande des PME élargit la base de clients du marché des services d'infrastructure GPU gérés tout en accordant une plus grande importance au provisionnement automatisé et aux contrôles d'utilisation.

Par utilisateur final :
l'informatique et les télécommunications sont en tête, la santé se développeL'informatique et les télécommunications détenaient une part de 71,54 % en 2026. Le secteur est à la fois un grand constructeur et un grand utilisateur d'infrastructure informatique IA. Les fournisseurs de cloud ont besoin de capacité pour les plateformes clients et les services internes. Les opérateurs de télécommunications utilisent l'IA pour les opérations réseau et les services numériques associés. Les fournisseurs de SaaS nécessitent également une capacité GPU gérée lorsqu'ils ajoutent des fonctions d'IA générative à des produits existants. Ces exigences font du segment une source stable de demande à l'échelle de la production.
Le secteur de la santé et des sciences de la vie devrait se développer à un CAGR de 28,27 % jusqu'en 2032. Les organisations pharmaceutiques et biotechnologiques utilisent des systèmes intensifs en GPU pour la prédiction de la structure des protéines, l'amarrage moléculaire, la génomique et la formation de modèles biomédicaux. NVIDIA a rapporté que 57 % des répondants pharmaceutiques et biotechnologiques interrogés ont identifié la découverte de médicaments comme leur principal cas d'utilisation de l'IA, tandis que 44 % ont cité les applications de génomique.[5] Ces charges de travail nécessitent des environnements informatiques protégés car les données de recherche et les résultats des modèles peuvent être sensibles. Elles bénéficient également d'une fiabilité opérationnelle lorsque les processus computationnels nécessitent un accès répété à des ressources haute performance. Les utilisateurs du secteur BFSI appliquent le calcul géré à la modélisation des risques, à la détection des fraudes et aux charges de travail d'IA générative. Les organisations gouvernementales, industrielles et de commerce de détail utilisent les services pour des applications souveraines, des jumeaux numériques, la simulation d'ingénierie, les systèmes de recommandation et la personnalisation. Ces utilisations diverses réduisent la dépendance à une seule catégorie d'utilisateurs finaux dans le secteur des services d'infrastructure GPU gérés.
Analyse géographique
Marché des Services d'Infrastructure GPU Gérée en Amérique du Nord
L'Amérique du Nord détenait 38,64 % du chiffre d'affaires total en 2026. La région présente une forte concentration de fournisseurs de cloud hyperscale, d'entreprises natives de l'IA et d'opérateurs de cloud GPU dédiés. CoreWeave exploitait 43 centres de données avec plus de 850 MW de puissance active en 2025. La société a prévu entre 30 milliards et 35 milliards USD de dépenses en capital pour 2026 et visait plus de 8 GW de capacité totale d'ici 2030. Le Canada et le Mexique peuvent bénéficier des retombées infrastructurelles et de leur proximité avec les États-Unis.
Marché des Services d'Infrastructure GPU Gérée en Europe et en Asie-Pacifique
L'Europe développe ses capacités grâce aux régions hyperscale et aux programmes de cloud souverain. Le cadre européen proposé crée des exigences d'approvisionnement plus structurées pour les infrastructures cloud et IA conformes. L'Asie-Pacifique devrait se développer à un CAGR de 27,91 % jusqu'en 2032, le taux régional le plus élevé du marché des services d'infrastructure GPU gérée. L'Indonésie devient un site de déploiement grâce à l'engagement de 800 millions USD du Groupe Ooredoo envers Zankore, qui vise une capacité de 1 GW d'usine IA NVIDIA DSX. Le plan prévoit la mise en service de 200 MW au premier semestre 2027.
Marché des Services d'Infrastructure GPU Gérée en Asie-Pacifique, au Moyen-Orient et en Afrique et en Amérique du Sud
La mission IndiaAI de l'Inde, l'expansion du cloud national en Chine et les programmes de calcul soutenus par les gouvernements du Japon et de la Corée du Sud soutiennent une demande portée par les politiques publiques à travers l'Asie-Pacifique. Le Moyen-Orient est soutenu par les investissements des fonds souverains et les faibles coûts énergétiques en Arabie saoudite et aux Émirats arabes unis. L'Amérique du Sud a le Brésil comme principal pôle, avec une demande émanant des secteurs bancaire, du commerce de détail et de la transformation numérique des administrations publiques. Les investissements dans la région restent en deçà de l'ampleur du déploiement en Asie-Pacifique. L'Afrique demeure le plus petit segment régional, bien que l'Afrique du Sud, le Nigeria et le Kenya affichent une activité précoce. Les hyperscalers commencent à déployer des capacités GPU pour desservir l'économie numérique en expansion du continent.
Paysage concurrentiel
Concentration du Marché
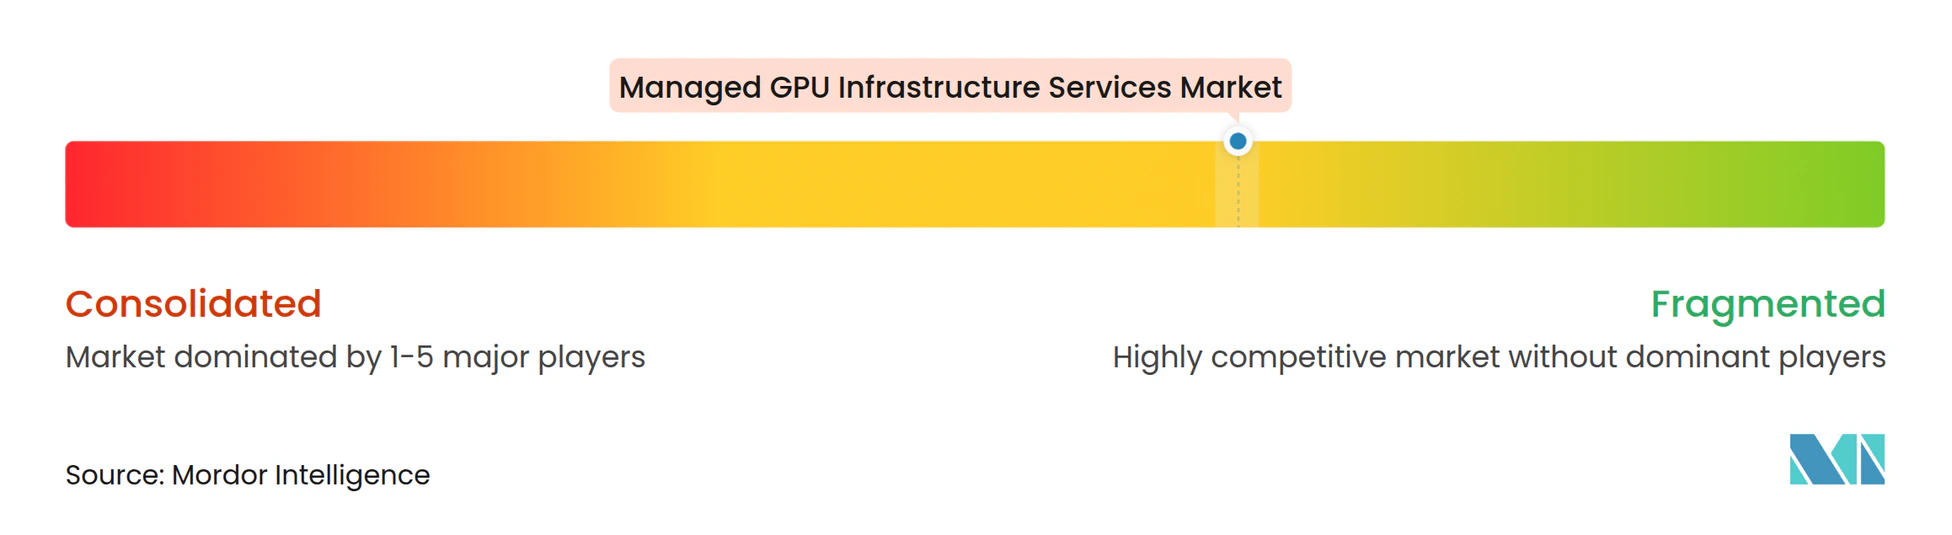
Le marché des services d'infrastructure GPU gérés est modérément fragmenté et présente une structure concurrentielle à plusieurs niveaux. AWS, Microsoft Azure, Google Cloud, Oracle Cloud Infrastructure et IBM Cloud se font concurrence grâce à une large couverture géographique, des logiciels intégrés et des relations établies avec les entreprises. CoreWeave, Lambda, Crusoe, Nebius, RunPod, Vast.ai et Voltage Park se font concurrence en se concentrant sur du matériel plus récent, des configurations mono-locataires et un provisionnement plus rapide. Les fournisseurs qui proposent uniquement une location de GPU indifférenciée font face à une pression accrue sur les prix à mesure que l'accès de base aux H100 devient plus largement disponible. L'avantage concurrentiel réside de plus en plus dans l'exploitation de l'infrastructure plutôt que dans la simple fourniture de l'accélérateur. Les fournisseurs doivent également prendre en charge la sécurité, l'observabilité, la planification de la capacité et les performances au niveau applicatif.
Les engagements de capacité à long terme peuvent renforcer les relations entre les principaux fournisseurs et leurs plus grands clients. CoreWeave a élargi sa relation avec OpenAI grâce à un contrat de 6,5 milliards USD en septembre 2025, portant la valeur totale déclarée de l'accord à 22,4 milliards USD sur 3 expansions. Crusoe a lancé Crusoe Spark Liquid en octobre 2026, une usine IA modulaire à refroidissement liquide destinée aux systèmes NVIDIA Vera Rubin NVL72. Lambda a annoncé son intégration NVIDIA Run:ai pour son service Kubernetes en octobre 2026. Ces initiatives portent sur la densité des clusters, l'ordonnancement et les opérations gérées, qui sont des domaines importants de différenciation des services.
Des opportunités subsistent dans l'infrastructure souveraine et réglementée, l'inférence gérée axée sur les PME et l'orchestration pour les charges de travail agentiques. Les opérateurs de télécommunications régionaux peuvent combiner la connectivité locale, les relations avec les entreprises et l'infrastructure locale lorsqu'ils entrent sur le marché des services GPU gérés. Les fournisseurs capables de valider l'ensemble de la pile technologique, de la configuration matérielle à l'observabilité MLOps, ont une position plus solide auprès des clients réglementés. Les pratiques d'assainissement et d'isolation des données sont également importantes lorsque les clients partagent l'infrastructure. Le marché reste compétitif sur les niveaux de service hyperscale, neocloud et régional. Les sources disponibles ne fournissent pas de parts de marché combinées pour les principaux acteurs, de sorte qu'un score de concentration numérique ne peut être soutenu sans introduire une estimation non étayée.
Leaders du secteur des services d'infrastructure GPU gérés
-
Amazon Web Services, Inc.
-
Microsoft Corporation
-
Google LLC
-
Oracle Corporation
-
International Business Machines Corporation
- *Avis de non-responsabilité : les principaux acteurs sont triés sans ordre particulier
Marché des Services d'Infrastructure GPU Gérée Entreprises couvertes dans ce rapport
- Amazon Web Services, Inc.
- Microsoft Corporation
- Google LLC
- Oracle Corporation
- International Business Machines Corporation
- CoreWeave, Inc.
- Lambda, Inc.
- RunPod, Inc.
- Vast.ai, Inc.
- Nebius Group N.V.
- Crusoe Energy Systems LLC
- Fluidstack Limited
- Voltage Park, Inc.
- DigitalOcean, LLC
- OVH SAS
- Rackspace Technology, Inc.
- Equinix, Inc.
- Digital Realty Trust, Inc.
- Alibaba Cloud Computing Ltd.
- Tencent Cloud Computing (Beijing) Co., Ltd.
- NVIDIA Corporation
- Advanced Micro Devices, Inc.
- Hewlett Packard Enterprise Company
- Dell Technologies Inc.
Développements industriels récents dans Marché des Services d'Infrastructure GPU Gérée
- Octobre 2026 : Crusoe a lancé Crusoe Spark Liquid au NVIDIA GTC Berlin, une usine IA modulaire à refroidissement liquide offrant 5 fois la densité de calcul de son prédécesseur à refroidissement par air, conçue pour les systèmes NVIDIA Vera Rubin NVL72. Crusoe a simultanément rejoint l'écosystème de partenaires de conception NVIDIA DSX POD et ouvert des aperçus privés de Managed RL et Managed MLflow.
- Octobre 2026 : Lambda a annoncé l'intégration du NVIDIA Run:ai open source avec Lambda Kubernetes Service, permettant le partage de fractions de GPU, l'ordonnancement tenant compte de la topologie, l'application de quotas de partage équitable et la remédiation automatisée des nœuds pour l'infrastructure IA partagée d'entreprise.
- Octobre 2025 : Eli Lilly a déployé 1 016 GPU NVIDIA Blackwell Ultra dans une configuration DGX SuperPOD pour la formation de modèles de fondation pour la découverte de médicaments via Lilly TuneLab.
- Septembre 2025 : CoreWeave a élargi son partenariat avec OpenAI avec un contrat d'infrastructure GPU gérée de 6,5 milliards USD, portant la valeur totale de l'accord à 22,4 milliards USD.
Périmètre du rapport mondial sur le marché des services d'infrastructure GPU gérés
Le marché des services d'infrastructure GPU gérés fournit aux entreprises des ressources de calcul GPU ainsi que des opérations dirigées par le fournisseur telles que le déploiement, la surveillance, la planification de la capacité, la maintenance des pilotes et du micrologiciel, les correctifs de sécurité, l'optimisation des performances et la réponse aux incidents. Ces services soutiennent la formation IA, l'inférence, le calcul haute performance, le rendu et d'autres charges de travail accélérées tout en réduisant le besoin d'expertise interne dans les opérations GPU.
Le rapport sur le marché des services d'infrastructure GPU gérés est segmenté par type de service (conception et déploiement de clusters GPU gérés, opérations d'infrastructure GPU gérées, Kubernetes géré et orchestration de conteneurs, opérations de plateforme IA gérée et de MLOps, infrastructure gérée de formation et d'affinage de modèles, opérations d'inférence gérée et de service de modèles, et autres types de services), charge de travail GPU (formation de modèles de fondation, affinage et génération augmentée par récupération, inférence IA et service de modèles, calcul haute performance et simulation scientifique, rendu, animation, VFX et production virtuelle, jumeaux numériques, ingénierie et simulation industrielle, et autres charges de travail GPU), mode de déploiement (basé sur le cloud, sur site, et hybride et multi-cloud), taille d'organisation (grandes entreprises et petites et moyennes entreprises), secteur d'utilisation final (banque, services financiers et assurance (BFSI), informatique et télécommunications, santé et sciences de la vie, gouvernement et administration publique, fabrication industrielle, commerce de détail et e-commerce, et autres secteurs d'utilisation final), et géographie (Amérique du Nord, Amérique du Sud, Europe, Asie-Pacifique, Moyen-Orient et Afrique). Les prévisions du marché sont fournies en termes de valeur (USD).
Aperçu de la segmentation
| Conception et déploiement de clusters GPU gérés |
| Opérations d'infrastructure GPU gérées |
| Kubernetes géré et orchestration de conteneurs |
| Opérations de plateforme IA gérée et de MLOps |
| Infrastructure gérée de formation et d'affinage de modèles |
| Opérations d'inférence gérée et de service de modèles |
| Autres types de services |
| Formation de modèles de fondation |
| Affinage et génération augmentée par récupération |
| Inférence IA et service de modèles |
| Calcul haute performance et simulation scientifique |
| Rendu, animation, VFX et production virtuelle |
| Jumeaux numériques, ingénierie et simulation industrielle |
| Autres charges de travail GPU |
| Basé sur le cloud |
| Sur site |
| Hybride et multi-cloud |
| Grandes entreprises |
| Petites et moyennes entreprises |
| Banque, services financiers et assurance (BFSI) |
| Informatique et télécommunications |
| Santé et sciences de la vie |
| Gouvernement et administration publique |
| Fabrication industrielle |
| Commerce de détail et e-commerce |
| Autres secteurs d'utilisation final |
| Amérique du Nord | États-Unis |
| Canada | |
| Mexique | |
| Amérique du Sud | Brésil |
| Reste de l'Amérique du Sud | |
| Europe | Allemagne |
| Royaume-Uni | |
| France | |
| Reste de l'Europe | |
| Asie-Pacifique | Chine |
| Japon | |
| Corée du Sud | |
| Inde | |
| Reste de l'Asie-Pacifique | |
| Moyen-Orient | Arabie saoudite |
| Émirats arabes unis | |
| Reste du Moyen-Orient | |
| Afrique | Afrique du Sud |
| Nigeria | |
| Reste de l'Afrique |
| Par type de service | Conception et déploiement de clusters GPU gérés | |
| Opérations d'infrastructure GPU gérées | ||
| Kubernetes géré et orchestration de conteneurs | ||
| Opérations de plateforme IA gérée et de MLOps | ||
| Infrastructure gérée de formation et d'affinage de modèles | ||
| Opérations d'inférence gérée et de service de modèles | ||
| Autres types de services | ||
| Par charge de travail GPU | Formation de modèles de fondation | |
| Affinage et génération augmentée par récupération | ||
| Inférence IA et service de modèles | ||
| Calcul haute performance et simulation scientifique | ||
| Rendu, animation, VFX et production virtuelle | ||
| Jumeaux numériques, ingénierie et simulation industrielle | ||
| Autres charges de travail GPU | ||
| Par modèle de déploiement | Basé sur le cloud | |
| Sur site | ||
| Hybride et multi-cloud | ||
| Par taille d'organisation | Grandes entreprises | |
| Petites et moyennes entreprises | ||
| Par utilisateur final | Banque, services financiers et assurance (BFSI) | |
| Informatique et télécommunications | ||
| Santé et sciences de la vie | ||
| Gouvernement et administration publique | ||
| Fabrication industrielle | ||
| Commerce de détail et e-commerce | ||
| Autres secteurs d'utilisation final | ||
| Par géographie | Amérique du Nord | États-Unis |
| Canada | ||
| Mexique | ||
| Amérique du Sud | Brésil | |
| Reste de l'Amérique du Sud | ||
| Europe | Allemagne | |
| Royaume-Uni | ||
| France | ||
| Reste de l'Europe | ||
| Asie-Pacifique | Chine | |
| Japon | ||
| Corée du Sud | ||
| Inde | ||
| Reste de l'Asie-Pacifique | ||
| Moyen-Orient | Arabie saoudite | |
| Émirats arabes unis | ||
| Reste du Moyen-Orient | ||
| Afrique | Afrique du Sud | |
| Nigeria | ||
| Reste de l'Afrique | ||
Questions clés auxquelles le rapport répond
Quelle est la taille du marché des services d'infrastructure GPU gérés ?
La taille du marché des services d'infrastructure GPU gérés devrait croître de 3,47 milliards USD en 2026 à 4,56 milliards USD en 2027 et devrait atteindre 14,21 milliards USD d'ici 2032 à un CAGR de 25,52 % sur la période 2027-2032.
Qu'est-ce qui stimule la demande de services d'infrastructure GPU gérés ?
La formation en IA générative à l'échelle de la production, l'inférence persistante, les charges de travail agentiques et le passage du matériel détenu en propre à la capacité sous contrat sont les principaux facteurs de demande.
Quel service GPU géré se développe le plus rapidement ?
Les opérations d'inférence gérée et de service de modèles devraient se développer à un CAGR de 26,81 % jusqu'en 2032, à mesure que les clients exploitent davantage de systèmes IA en production.
Quel modèle de déploiement est en tête des services GPU gérés ?
Le déploiement basé sur le cloud détenait une part de 68,58 % en 2026 et devrait se développer à un CAGR de 27,33 % jusqu'en 2032.
Quel secteur d'utilisation final présente la plus forte expansion projetée ?
La santé et les sciences de la vie devraient se développer à un CAGR de 28,27 % jusqu'en 2032, soutenues par la découverte de médicaments, la génomique et le développement de modèles biomédicaux.
Quelle région présente l'expansion projetée la plus rapide ?
L'Asie-Pacifique devrait se développer à un CAGR de 27,91 % jusqu'en 2032, soutenue par les programmes de calcul souverain et les investissements régionaux en capacité.