
Tamaño y Participación del Mercado de Servicios de Infraestructura GPU Gestionada
Visión General del Mercado
| Período de Estudio | 2021 - 2032 |
|---|---|
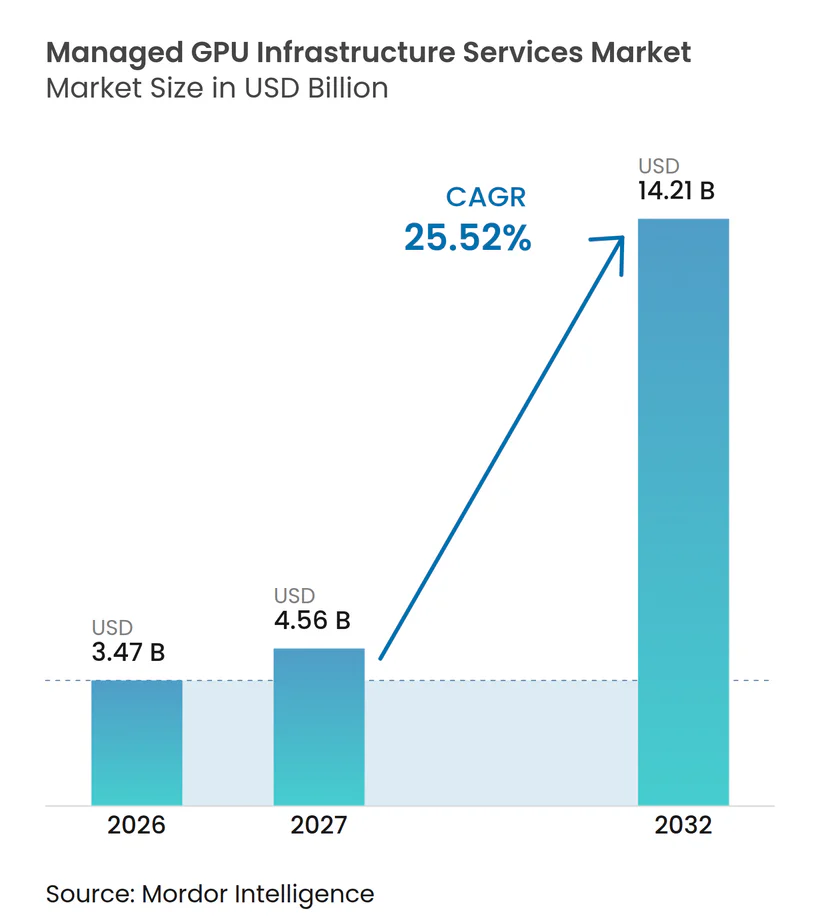
| Tamaño del Mercado (2027) | 4.56 Mil millones de dólares |
| Tamaño del Mercado (2032) | 14.21 Mil millones de dólares |
| Tasa de crecimiento (2027 - 2032) | 25.52 % |
| Mercado de Crecimiento Más Rápido | Asia-Pacífico |
| Mercado Más Grande | América del Norte |
| Concentración del Mercado | Medio |
Jugadores principales *Nota aclaratoria: los principales jugadores no se ordenaron de un modo en especial Imagen © Mordor Intelligence. El uso requiere atribución según CC BY 4.0. | |
Análisis del Mercado de Servicios de Infraestructura GPU Gestionada por Mordor Intelligence
Se espera que el tamaño del mercado de servicios de infraestructura GPU gestionada crezca de 3,47 mil millones de USD en 2026 a 4,56 mil millones de USD en 2027 y se prevé que alcance los 14,21 mil millones de USD en 2032 a una CAGR del 25,52% durante 2027-2032. El mercado de servicios de infraestructura GPU gestionada está transitando de compras periódicas de hardware hacia servicios de computación a escala de producción contratados con compromisos de nivel de servicio. El entrenamiento e inferencia de IA generativa están incrementando la necesidad de capacidad confiable, soporte operativo y rendimiento predecible. Los proveedores que combinan orquestación, monitoreo y operaciones gestionadas pueden atender cargas de trabajo más complejas que los proveedores que ofrecen alquiler básico de GPU. La disponibilidad de hardware, especialmente la memoria de alto ancho de banda y la capacidad de empaquetado avanzado, limita el ritmo al que los proveedores pueden poner en servicio nuevos clústeres. Los requisitos de computación soberana y las normas de residencia de datos también crean oportunidades para proveedores regionales que pueden dar soporte a cargas de trabajo reguladas dentro de la jurisdicción requerida.
Conclusiones Clave del Informe
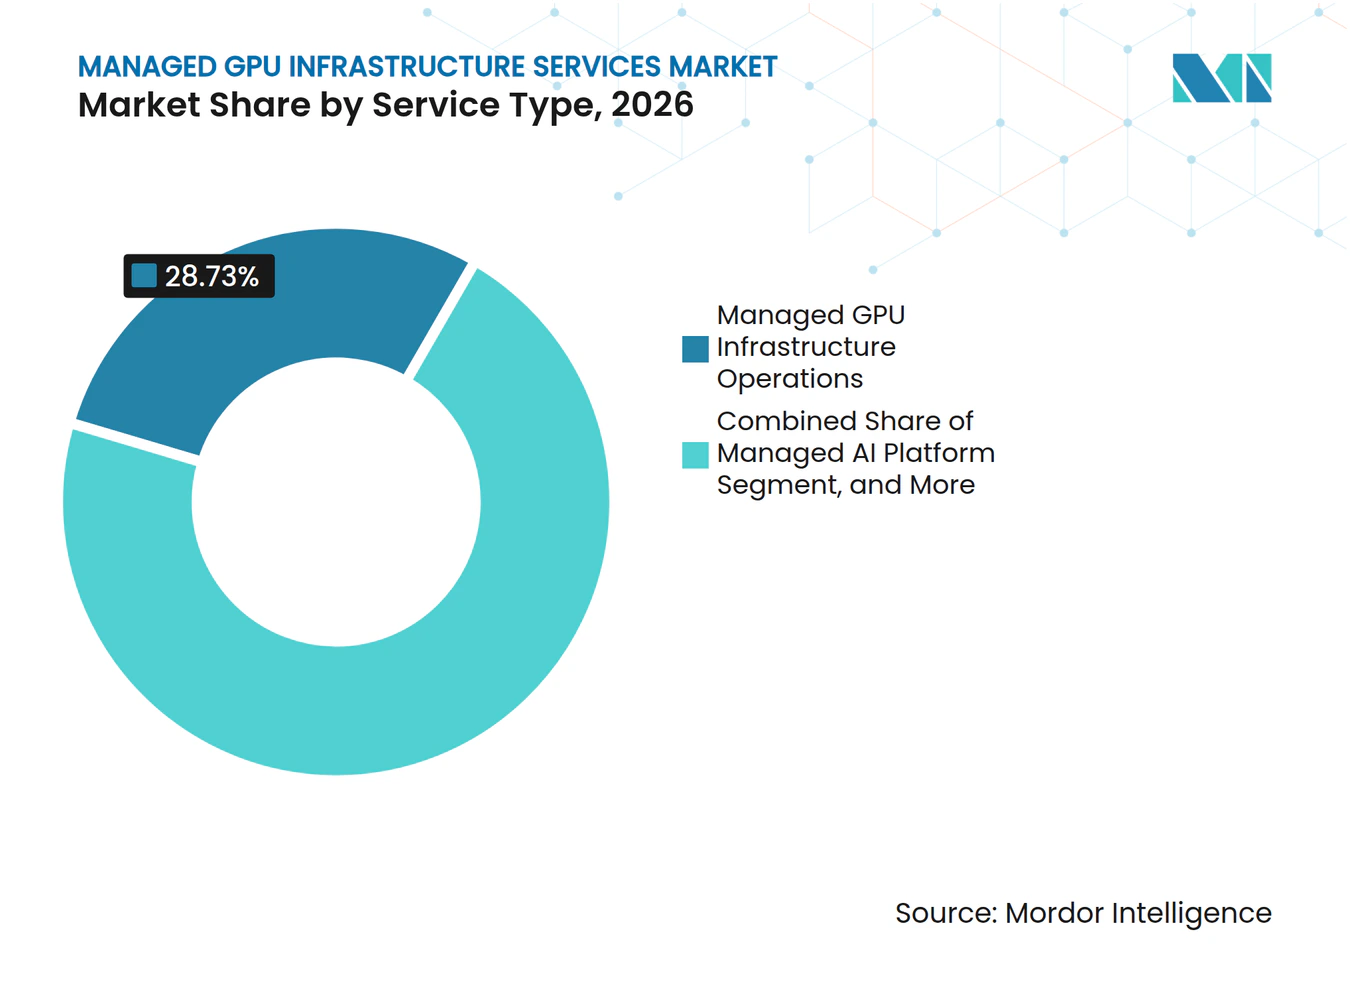
- Por tipo de servicio, las operaciones de infraestructura GPU gestionada representaron el 28,73% de la participación del mercado de servicios de infraestructura GPU gestionada en 2026, mientras que se proyecta que las operaciones de inferencia gestionada y servicio de modelos se expandan a una CAGR del 26,81% hasta 2032.
- Por carga de trabajo GPU, la inferencia de IA y el servicio de modelos representaron el 36,41% de la participación del mercado de servicios de infraestructura GPU gestionada en 2026, mientras que se proyecta que el ajuste fino y la RAG se expandan a una CAGR del 27,62% hasta 2032.
- Por modelo de implementación, la implementación basada en la nube representó el 68,58% de la participación del mercado de servicios de infraestructura GPU gestionada en 2026 y se proyecta que se expanda a una CAGR del 27,33% hasta 2032.
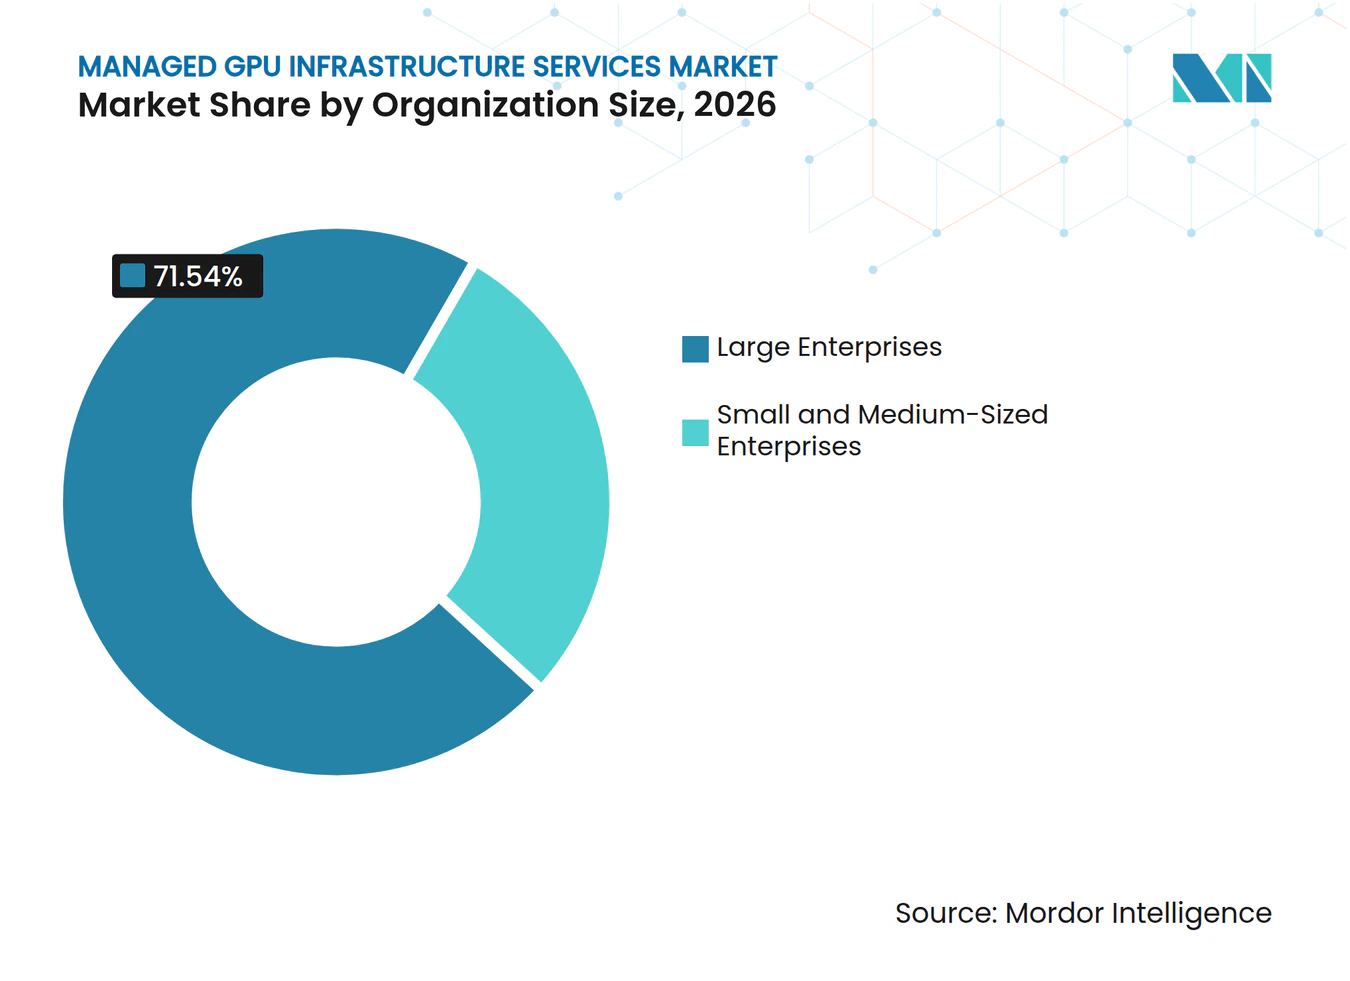
- Por tamaño de organización, las grandes empresas mantuvieron una participación del 71,54% en 2026, mientras que se proyecta que las PYMEs se expandan a una CAGR del 26,59% hasta 2032.
- Por usuario final, TI y telecomunicaciones mantuvieron una participación del 71,54% en 2026, mientras que se proyecta que la salud y las ciencias de la vida se expandan a una CAGR del 28,27% hasta 2032.
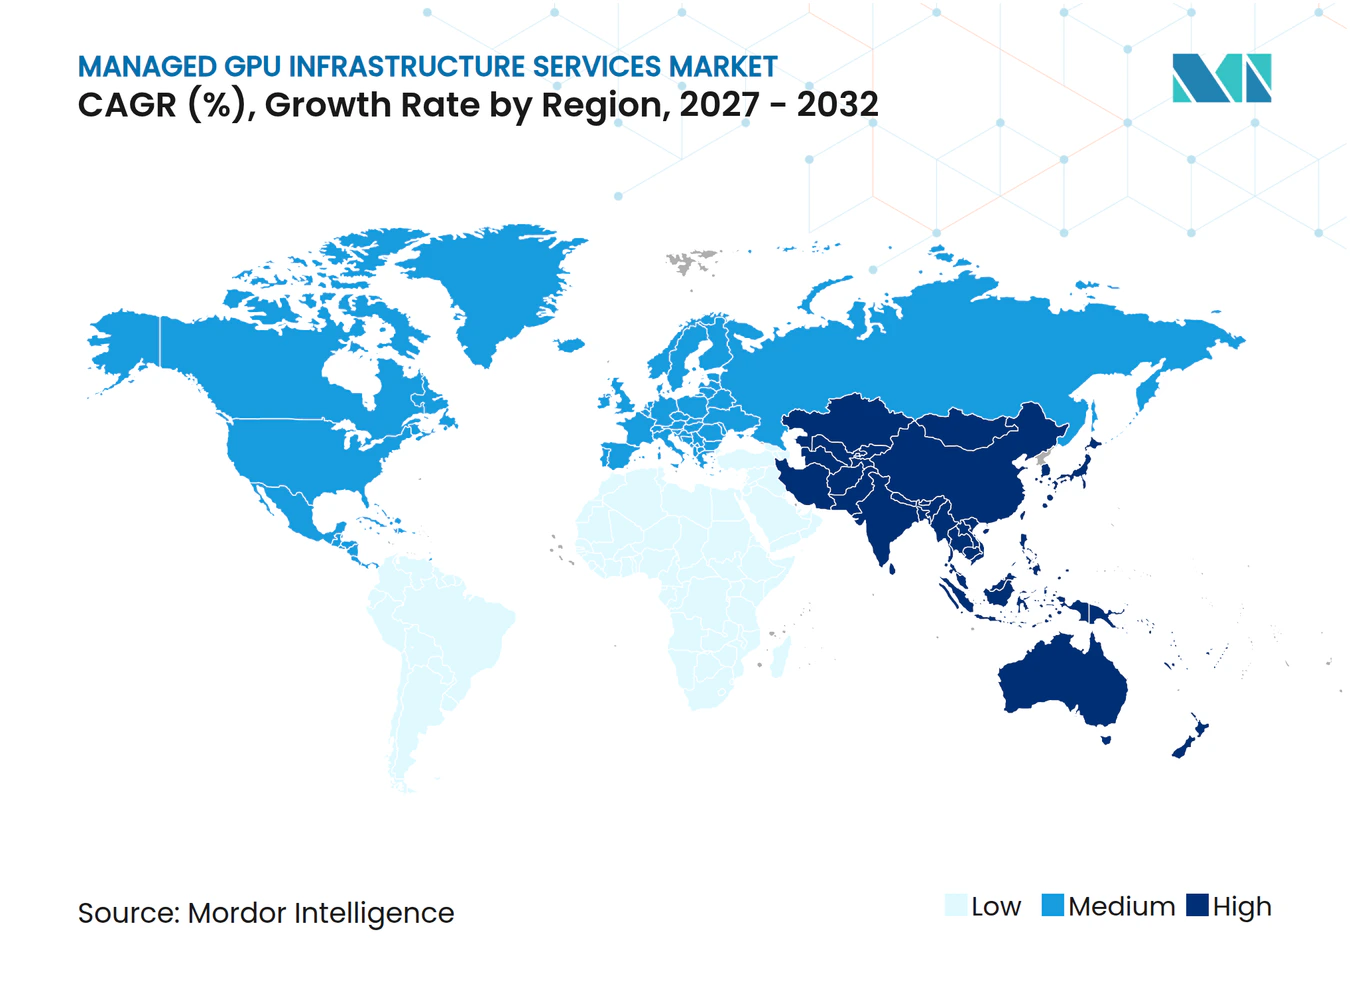
- Por geografía, América del Norte mantuvo el 38,64% de la participación del mercado de servicios de infraestructura GPU gestionada en 2026, mientras que se proyecta que Asia-Pacífico se expanda a una CAGR del 27,91% hasta 2032.
Nota: Las cifras de mercado de este informe se basan en el marco de estimación propietario de Mordor Intelligence, que combina nueve meses de datos reales con proyecciones del cuarto trimestre para el año base 2026.
Tendencias e Información del Mercado
Análisis del Impacto de los Impulsores*
| IMPULSOR | (~) % DE IMPACTO EN EL PRONÓSTICO DE CAGR | RELEVANCIA GEOGRÁFICA | PLAZO DE IMPACTO |
|---|---|---|---|
| Entrenamiento e Inferencia de IA Generativa a Escala de Producción | +8.5% | Global | Mediano plazo (2-4 años) |
| Aumento de la Densidad de Inferencia y Cargas de Trabajo de IA Agéntica | +7.2% | Global | Corto plazo (≤ 2 años) |
| Transición de la Propiedad de GPU hacia Capacidad Gestionada Elástica | +5.8% | América del Norte y Europa | Mediano plazo (2-4 años) |
| IA Soberana, Residencia de Datos y Demanda de Cargas de Trabajo Reguladas | +3.4% | Europa, Asia-Pacífico, Oriente Medio | Mediano plazo (2-4 años) |
| Optimización del Uso de GPU mediante Asignación Fraccionada y Programación | +2.1% | Global | Corto plazo (≤ 2 años) |
| Refrigeración, Energía y Operaciones de Clústeres Gestionadas para Bastidores de Alta Densidad | +1.3% | América del Norte, Núcleo de Asia-Pacífico | Largo plazo (≥ 4 años) |
| Fuente: Mordor Intelligence | |||
Entrenamiento e Inferencia de IA Generativa a Escala de Producción
El entrenamiento de modelos de lenguaje de frontera requiere clústeres con muchos miles de aceleradores que operen durante períodos prolongados. La inferencia de producción también requiere capacidad sostenida, ya que los servicios deben gestionar millones de solicitudes diarias con estrictos requisitos de latencia. Estos requisitos superan la capacidad de adquisición y operaciones de muchos equipos de TI empresariales. CoreWeave reportó 5,1 mil millones de USD en ingresos en el ejercicio fiscal 2025, frente a 1,9 mil millones de USD en el ejercicio fiscal 2024, lo que subraya la escala de los compromisos de capacidad gestionada contratada.[1] Eli Lilly implementó 1.016 GPU NVIDIA Blackwell Ultra en octubre de 2025 para apoyar el entrenamiento de modelos de fundación para el descubrimiento de fármacos a través de Lilly TuneLab. El mercado de servicios de infraestructura GPU gestionada se beneficia a medida que los sectores sensibles a los datos tratan el acceso a la capacidad de computación gestionada como un requisito operativo en lugar de una necesidad de proyecto temporal.
Aumento de la Densidad de Inferencia y Cargas de Trabajo de IA Agéntica
Una solicitud convencional de chatbot puede liberar una GPU en milisegundos tras producir una respuesta. Una sesión agéntica puede implicar llamadas repetidas al modelo, pasos de recuperación y acciones de herramientas, manteniendo los recursos de computación ocupados durante mucho más tiempo. Este comportamiento aumenta la densidad y la duración de la demanda de inferencia. Los proveedores necesitan configurar la infraestructura en torno al ancho de banda de memoria, la programación, el procesamiento por lotes y la gestión del tiempo de respuesta. Se proyecta que las operaciones de inferencia gestionada y servicio de modelos se expandan a una CAGR del 26,81% hasta 2032, lo que refleja este requisito de producción. Por lo tanto, el mercado de servicios de infraestructura GPU gestionada favorece a las plataformas que pueden operar flotas de inferencia persistentes sin requerir que cada cliente construya un equipo especializado de infraestructura.
Transición de la Propiedad de GPU hacia Capacidad Gestionada Elástica
La propiedad de GPU conlleva mayor riesgo cuando las generaciones de hardware avanzan rápidamente. Una empresa que adquiere un clúster puede enfrentar menor eficiencia cuando se disponga de arquitecturas más nuevas. Los servicios gestionados permiten a los clientes acceder a capacidad más reciente sin poseer equipos que puedan quedar obsoletos. CoreWeave reportó una cartera de pedidos de 55,6 mil millones de USD al tercer trimestre de 2025, lo que refleja grandes compromisos contratados para infraestructura de IA. Los compromisos reservados también pueden proporcionar a los proveedores de servicios la visibilidad de demanda necesaria para financiar nueva capacidad de centros de datos. Este cambio apoya el mercado de servicios de infraestructura GPU gestionada porque la capacidad contratada puede ser más adecuada que la infraestructura propia para los cambiantes requisitos de carga de trabajo de IA.
IA Soberana, Residencia de Datos y Demanda de Cargas de Trabajo Reguladas
Las políticas gubernamentales exigen cada vez mayor control sobre la ubicación y operación de los recursos de computación de IA. La Comisión Europea propuso una Ley de Desarrollo de la Nube y la IA que establece un marco de soberanía para los servicios de nube e IA.[2] Los requisitos de mayor garantía favorecen a los proveedores con operaciones, personal y cadenas de suministro controlados localmente. La Misión IndiaAI de India asignó infraestructura GPU a 14 proveedores nacionales en el marco de un programa de INR 10.372 crore (1,23 mil millones de USD), según se indica en el material fuente. Las medidas regionales de localización de datos crean un requisito de servicio diferenciado más allá del acceso básico a aceleradores. El mercado de servicios de infraestructura GPU gestionada puede beneficiarse cuando los proveedores demuestran cumplimiento auditable, alojamiento nacional y soporte operativo local.
Análisis del Impacto de las Restricciones*
| RESTRICCIÓN | (~) % DE IMPACTO EN EL PRONÓSTICO DE CAGR | RELEVANCIA GEOGRÁFICA | PLAZO DE IMPACTO |
|---|---|---|---|
| Volatilidad en el Suministro de GPU, HBM y Empaquetado Avanzado | -4.2% | Global | Corto plazo (≤ 2 años) |
| Restricciones en la Modernización de Energía y Refrigeración de Alta Densidad | -3.1% | América del Norte y Europa | Mediano plazo (2-4 años) |
| Rápida Obsolescencia de Aceleradores y Riesgo de Actualización | -1.8% | Global | Largo plazo (≥ 4 años) |
| Seguridad de Datos, Aislamiento Multi-Inquilino y Preocupaciones de Cumplimiento | -1.4% | Global, con Enfoque en Asia-Pacífico y Europa | Mediano plazo (2-4 años) |
| Fuente: Mordor Intelligence | |||
Volatilidad en el Suministro de GPU, HBM y Empaquetado Avanzado
La cadena de suministro de aceleradores de IA de frontera sigue siendo limitada por la memoria de alto ancho de banda y el empaquetado avanzado. Estos componentes pueden limitar la producción de aceleradores incluso cuando la capacidad de fabricación de chips lógicos está disponible. Un grupo reducido de proveedores controla una gran parte del suministro de empaquetado avanzado y memoria. Las nuevas líneas de fabricación requieren largos plazos de entrega, lo que restringe las adiciones rápidas de capacidad. Para los proveedores de servicios, las escaseces pueden retrasar la puesta en servicio de clústeres y alargar las listas de espera de los clientes. El mercado de servicios de infraestructura GPU gestionada puede enfrentar una expansión más lenta y presión de reajuste de precios cuando la demanda contratada supera el suministro de hardware implementable.
Restricciones en la Modernización de Energía y Refrigeración de Alta Densidad
Las implementaciones de entrenamiento de IA requieren densidades de bastidor mucho más altas que la infraestructura empresarial tradicional. Los clústeres basados en NVIDIA GB300 NVL72 pueden consumir hasta 142 kW por bastidor.[3] Muchas instalaciones heredadas fueron diseñadas para cargas de energía mucho menores y refrigeración por aire convencional. Los clústeres de mayor densidad requieren refrigeración líquida directa o sistemas de inmersión, junto con los cambios relacionados en la distribución de energía. Estas necesidades de modernización elevan los requisitos de capital y ejecución para los operadores de centros de datos. Por lo tanto, el mercado de servicios de infraestructura GPU gestionada puede favorecer a los proveedores con instalaciones más nuevas o los recursos para rediseñar los sitios existentes.
*Nuestras previsiones consideran los impactos de impulsores y restricciones como direccionales, no aditivos. Las previsiones de impacto reflejan el crecimiento base, los efectos de mezcla y las interacciones entre variables.
Análisis de Segmentos
Por Tipo de Servicio:
Las Operaciones y el Soporte de Inferencia Impulsan la Adopción GestionadaLas operaciones de infraestructura GPU gestionada representaron el 28,73% de los ingresos totales por servicios en 2026. El segmento abarca tareas del ciclo de vida del clúster, como actualizaciones de firmware, programación de capacidad, monitoreo de estado y corrección de fallos. Las organizaciones que operan clústeres con muchos miles de GPU a menudo carecen del personal interno necesario para mantener el tiempo de actividad a nivel de servicio. Las operaciones completamente gestionadas abordan esta brecha combinando la supervisión de la infraestructura con el soporte al cliente. La orquestación de Kubernetes gestionado y contenedores apoya la implementación de aplicaciones en entornos de computación compartidos. Las operaciones de plataforma de IA gestionada y MLOps pueden entonces ayudar a los clientes a monitorear modelos y gestionar flujos de trabajo de producción.
Se proyecta que las operaciones de inferencia gestionada y servicio de modelos se expandan a una CAGR del 26,81% hasta 2032. Su alcance incluye el enrutamiento de modelos, el escalado automático, el almacenamiento en caché de tokens y la gestión de latencia para servicios de producción. Estas funciones se vuelven más importantes a medida que las empresas pasan del entrenamiento ocasional de modelos a la inferencia continua. La infraestructura gestionada de entrenamiento y ajuste fino de modelos también apoya a las organizaciones que trabajan con datos propietarios sensibles. Lambda anunció en octubre de 2026 que integraría el NVIDIA Run:ai de código abierto con Lambda Kubernetes Service para el uso compartido de fracciones de GPU, la programación con reconocimiento de topología, las cuotas de uso compartido equitativo y la corrección automatizada de nodos.[4] Los clientes pueden usar estas funciones para gestionar la infraestructura compartida manteniendo el acceso a las cargas de trabajo y la asignación de recursos bajo reglas operativas definidas. El modelo de servicio también reduce la necesidad de ensamblar equipos separados para la administración de clústeres, la política de programación y la corrección diaria. Estas capacidades muestran por qué la diferenciación de servicios va más allá del acceso al hardware en la industria de servicios de infraestructura GPU gestionada.


Nota: Las participaciones de todos los segmentos individuales están disponibles con la compra del informe
Por Carga de Trabajo GPU:
La Demanda de Inferencia Remodela el Uso de los ClústeresLa inferencia de IA y el servicio de modelos representaron el 36,41% de los ingresos totales por servicios en 2026. Las empresas utilizan cada vez más sistemas de IA para atender aplicaciones en tiempo real en lugar de solo tareas de procesamiento por lotes. Las cargas de trabajo de inferencia ponen especial énfasis en el ancho de banda de memoria, el tiempo de respuesta y la asignación eficiente de recursos. Los proveedores necesitan configurar los clústeres para un servicio de producción estable en lugar de solo el rendimiento máximo de entrenamiento. El entrenamiento de modelos de fundación sigue siendo relevante para los laboratorios de IA de frontera con grandes requisitos de datos y computación. Los modelos de pesos abiertos reducen la necesidad de que muchas organizaciones entrenen modelos grandes desde el principio.
Se proyecta que el ajuste fino y la RAG se expandan a una CAGR del 27,62% hasta 2032. Muchas organizaciones adaptan los modelos de frontera o de pesos abiertos existentes a sus propios datos en lugar de construir modelos de fundación desde cero. Este enfoque crea demanda de entornos seguros que soporten el desarrollo y la evaluación iterativa de modelos. Eli Lilly, Roche y Bristol Myers Squibb anunciaron implementaciones dedicadas de GPU SuperPOD hasta mediados de 2026 para cargas de trabajo de IA relacionadas con la investigación. Estas implementaciones muestran que los usuarios científicos necesitan acceso repetible a la capacidad de computación durante los ciclos de investigación iterativa. Los proveedores pueden apoyar este trabajo a través de entornos gestionados que combinen el control de la infraestructura con la continuidad operativa. La computación de alto rendimiento y la simulación científica mantienen una demanda separada de los usuarios de investigación, ingeniería y computación técnica. Los gemelos digitales y el renderizado también utilizan capacidad GPU gestionada, aunque la inferencia y el ajuste fino acaparan una proporción creciente de los recursos disponibles.
Por Modelo de Implementación:
La Nube Lidera Mientras el Híbrido Apoya las Cargas de Trabajo ControladasLa implementación basada en la nube representó el 68,58% del tamaño del mercado de servicios de infraestructura GPU gestionada en 2026. También se proyecta que se expanda a una CAGR del 27,33% hasta 2032. Los servicios en la nube permiten a los clientes pasar de una pequeña ejecución de ajuste fino a un clúster de entrenamiento mucho más grande sin adquirir hardware físico. Esta flexibilidad es adecuada para organizaciones con demanda irregular entre ciclos de desarrollo y períodos de producción. También ofrece a los proveedores una forma de agrupar capacidad entre clientes. El modelo en la nube apoya el mercado más amplio de servicios de infraestructura GPU gestionada al hacer que la computación avanzada esté disponible a través de modelos de servicio basados en el consumo.
Las implementaciones de GPU gestionadas en instalaciones propias siguen siendo relevantes para las organizaciones que enfrentan restricciones de salida de datos o requieren latencia muy baja. Los usuarios gubernamentales y de defensa también pueden requerir aislamiento físico para cargas de trabajo seleccionadas. Los entornos híbridos y multi-nube permiten a las empresas separar la inferencia orientada al público del desarrollo de modelos propietarios. Red Hat identifica el hardware, la estructura, el programador y la virtualización como capas distintas que requieren controles alineados para el aislamiento de GPU multi-inquilino. Este diseño en capas refleja el trabajo operativo requerido cuando los clientes utilizan más de 1 entorno de infraestructura. También ayuda a explicar por qué los servicios gestionados son relevantes cuando las organizaciones necesitan políticas comunes en distintas ubicaciones. Las políticas de computación soberana pueden requerir que ciertas cargas de trabajo permanezcan en una jurisdicción definida. Estas condiciones crean demanda de proveedores que puedan operar entornos coordinados en infraestructura de nube, local y soberana.
Por Tamaño de Organización:
Las Empresas Lideran, las PYMEs Mejoran el AccesoLas grandes empresas mantuvieron una participación del 71,54% en 2026. Pueden comprometerse con contratos reservados plurianuales que apoyan las decisiones de inversión en centros de datos por parte de neoclouds e hiperescaladores. Los compromisos reservados pueden ofrecer precios más bajos que el uso bajo demanda, pero requieren una planificación clara de la carga de trabajo y capacidad financiera. Los grandes clientes a menudo adquieren soporte operativo de mayor valor, aislamiento de seguridad, configuraciones de red personalizadas e integración de MLOps. Estos servicios ayudan a mantener una capacidad predecible para los programas de IA empresarial. La concentración de grandes contratos también proporciona a los proveedores una base más sólida para financiar la expansión de la infraestructura.
Se proyecta que las PYMEs se expandan a una CAGR del 26,59% hasta 2032. Los servicios de GPU sin servidor y la facturación por segundo reducen el compromiso mínimo necesario para utilizar la computación de alto rendimiento. La asignación fraccionada permite a un cliente utilizar parte de una GPU en lugar de reservar un dispositivo completo. La programación de uso compartido equitativo y la preferencia de instancias puntuales pueden hacer que los grupos compartidos sean más prácticos para cargas de trabajo más pequeñas. El aprovisionamiento automatizado también puede limitar la carga administrativa en equipos que no cuentan con personal de infraestructura dedicado. Estos modelos de consumo permiten a los clientes más pequeños ajustar el uso de capacidad más estrechamente a la duración y el patrón de demanda de un proyecto. Estos modelos pueden aumentar el acceso para organizaciones sin un presupuesto de infraestructura de IA dedicado. La demanda de las PYMEs amplía la base de clientes del mercado de servicios de infraestructura GPU gestionada al tiempo que otorga mayor importancia al aprovisionamiento automatizado y los controles de utilización.

Por Usuario Final:
TI y Telecomunicaciones Lidera, la Salud se ExpandeTI y telecomunicaciones mantuvieron una participación del 71,54% en 2026. El sector es tanto un gran constructor como un gran usuario de infraestructura de computación de IA. Los proveedores de nube necesitan capacidad para las plataformas de clientes y los servicios internos. Los operadores de telecomunicaciones utilizan la IA para las operaciones de red y los servicios digitales relacionados. Los proveedores de SaaS también requieren capacidad GPU gestionada cuando añaden funciones de IA generativa a los productos existentes. Estos requisitos hacen del segmento una fuente estable de demanda a escala de producción.
Se proyecta que la industria de la salud y las ciencias de la vida se expanda a una CAGR del 28,27% hasta 2032. Las organizaciones farmacéuticas y de biotecnología utilizan sistemas intensivos en GPU para la predicción de estructuras de proteínas, el acoplamiento molecular, la genómica y el entrenamiento de modelos biomédicos. NVIDIA reportó que el 57% de los encuestados del sector farmacéutico y biotecnológico identificaron el descubrimiento de fármacos como su principal caso de uso de IA, mientras que el 44% citó aplicaciones de genómica.[5] Estas cargas de trabajo requieren entornos de computación protegidos porque los datos de investigación y los resultados de los modelos pueden ser sensibles. También se benefician de la fiabilidad operativa cuando los procesos computacionales necesitan acceso repetido a recursos de alto rendimiento. Los usuarios de BFSI aplican la computación gestionada al modelado de riesgos, la detección de fraudes y las cargas de trabajo de IA generativa. Las organizaciones gubernamentales, de manufactura industrial y de comercio minorista utilizan los servicios para aplicaciones soberanas, gemelos digitales, simulación de ingeniería, sistemas de recomendación y personalización. Estos usos diversos reducen la dependencia de una única categoría de usuario final en la industria de servicios de infraestructura GPU gestionada.
Análisis Geográfico
Mercado de Servicios de Infraestructura GPU Gestionada en América del Norte
América del Norte concentró el 38,64% de los ingresos totales en 2026. La región cuenta con una alta concentración de proveedores de nube a hiperescala, empresas nativas de inteligencia artificial y operadores de nube GPU de propósito específico. CoreWeave operó 43 centros de datos con más de 850 MW de potencia activa en 2025. La empresa proyectó un gasto de capital de entre 30.000 millones y 35.000 millones de USD en 2026 y apuntó a más de 8 GW de capacidad total para 2030. Canadá y México pueden beneficiarse del desbordamiento de infraestructura y de su proximidad a los Estados Unidos.
Mercado de Servicios de Infraestructura GPU Gestionada en Europa y Asia-Pacífico
Europa está ampliando su capacidad a través de regiones de hiperescaladores y programas de nube soberana. El marco propuesto por la UE crea requisitos de contratación más estructurados para la infraestructura de nube e inteligencia artificial conforme. Se proyecta que Asia-Pacífico se expanda a una CAGR del 27,91% hasta 2032, la tasa regional más alta en el mercado de servicios de infraestructura GPU gestionada. Indonesia se está convirtiendo en una ubicación de despliegue a través del compromiso de 800 millones de USD de Ooredoo Group con Zankore, que apunta a 1 GW de capacidad de la Fábrica de IA NVIDIA DSX. El plan prevé que 200 MW estén en línea en el primer semestre de 2027.
Mercado de Servicios de Infraestructura GPU Gestionada en Asia-Pacífico, Oriente Medio y África, y América del Sur
La Misión IndiaAI de India, la expansión de la nube doméstica en China y los programas de cómputo respaldados por el gobierno en Japón y Corea del Sur impulsan la demanda orientada por políticas en toda Asia-Pacífico. Oriente Medio cuenta con el respaldo de inversiones de fondos soberanos de riqueza y bajos costos energéticos en Arabia Saudita y los Emiratos Árabes Unidos. América del Sur tiene a Brasil como su principal centro, con demanda proveniente de la banca, el comercio minorista y la transformación digital gubernamental. La inversión en la región sigue siendo inferior a la escala del desarrollo en Asia-Pacífico. África sigue siendo el segmento regional más pequeño, aunque Sudáfrica, Nigeria y Kenia muestran actividad incipiente. Los hiperescaladores están comenzando a sembrar capacidad GPU para atender la economía digital en expansión del continente.
Panorama Competitivo
Concentración del Mercado
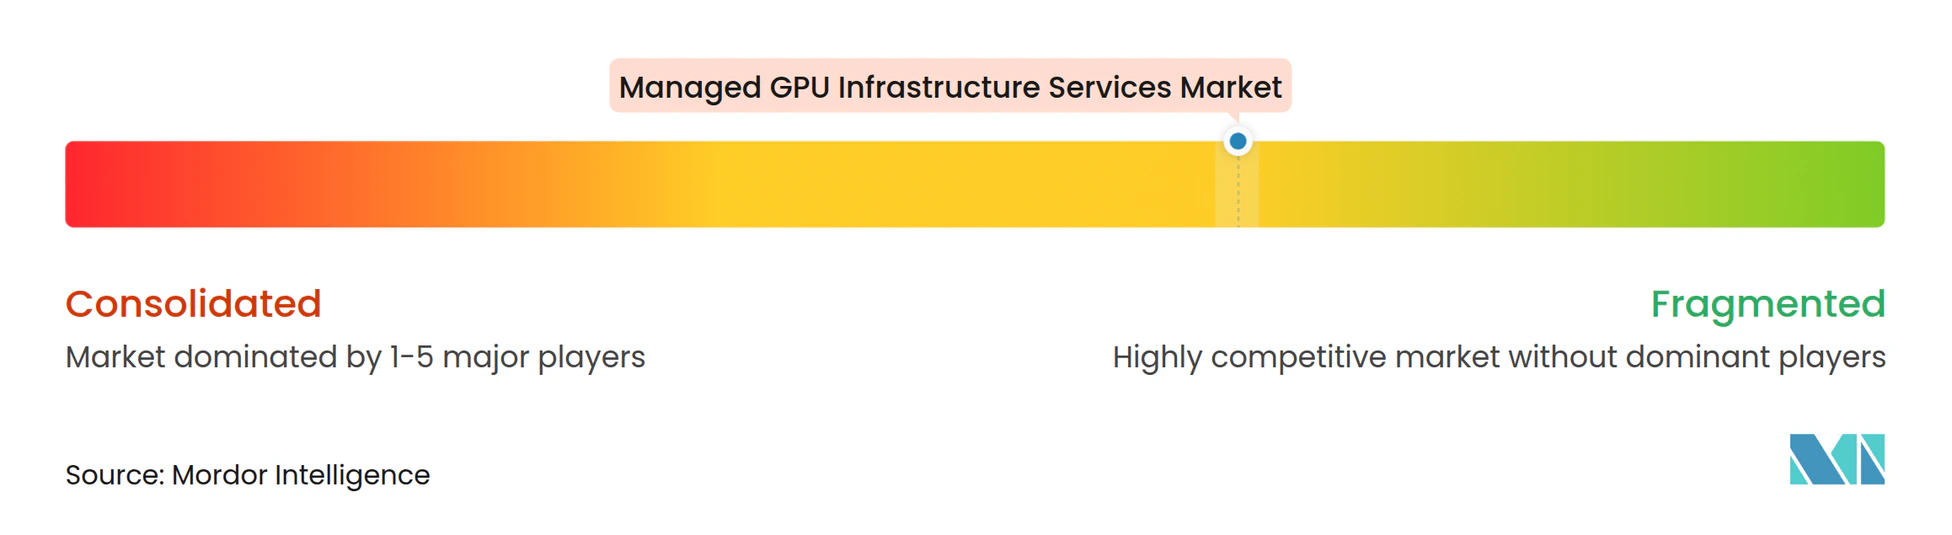
El mercado de servicios de infraestructura GPU gestionada está moderadamente fragmentado y tiene una estructura competitiva escalonada. AWS, Microsoft Azure, Google Cloud, Oracle Cloud Infrastructure e IBM Cloud compiten a través de un amplio alcance geográfico, software integrado y relaciones empresariales establecidas. CoreWeave, Lambda, Crusoe, Nebius, RunPod, Vast.ai y Voltage Park compiten centrándose en hardware más reciente, configuraciones de un solo inquilino y aprovisionamiento más rápido. Los proveedores que ofrecen solo alquiler de GPU indiferenciado enfrentan mayor presión de precios a medida que el acceso básico a H100 se vuelve más ampliamente disponible. La ventaja competitiva reside cada vez más en operar la infraestructura en lugar de simplemente suministrar el acelerador. Los proveedores también necesitan apoyar la seguridad, la observabilidad, la planificación de capacidad y el rendimiento a nivel de aplicación.
Los compromisos de capacidad a largo plazo pueden fortalecer las relaciones entre los principales proveedores y sus clientes más grandes. CoreWeave amplió su relación con OpenAI a través de un contrato de 6,5 mil millones de USD en septiembre de 2025, elevando el valor total declarado del acuerdo a 22,4 mil millones de USD en 3 expansiones. Crusoe lanzó Crusoe Spark Liquid en octubre de 2026, una fábrica de IA modular con refrigeración líquida diseñada para sistemas NVIDIA Vera Rubin NVL72. Lambda anunció su integración de NVIDIA Run:ai para su servicio Kubernetes en octubre de 2026. Estos movimientos abordan la densidad de clústeres, la programación y las operaciones gestionadas, que son áreas importantes de diferenciación de servicios.
Las oportunidades permanecen en la infraestructura soberana y regulada, la inferencia gestionada orientada a las PYMEs y la orquestación para cargas de trabajo agénticas. Los operadores de telecomunicaciones regionales pueden combinar conectividad local, relaciones empresariales e infraestructura local cuando ingresan al mercado de servicios GPU gestionados. Los proveedores que pueden validar la pila tecnológica completa, desde la configuración del hardware hasta la observabilidad de MLOps, tienen una posición más sólida con los clientes regulados. Las prácticas de saneamiento y aislamiento de datos también son importantes cuando los clientes comparten infraestructura. El mercado sigue siendo competitivo en los niveles de servicio hiperescalable, neocloud y regional. El material fuente disponible no proporciona participaciones de mercado combinadas para los principales actores, por lo que no se puede respaldar una puntuación de concentración numérica sin introducir una estimación no respaldada.
Líderes de la Industria de Servicios de Infraestructura GPU Gestionada
-
Amazon Web Services, Inc.
-
Microsoft Corporation
-
Google LLC
-
Oracle Corporation
-
International Business Machines Corporation
- *Nota aclaratoria: los principales jugadores no se ordenaron de un modo en especial
Mercado de Servicios de Infraestructura GPU Gestionada Empresas cubiertas en este informe
- Amazon Web Services, Inc.
- Microsoft Corporation
- Google LLC
- Oracle Corporation
- International Business Machines Corporation
- CoreWeave, Inc.
- Lambda, Inc.
- RunPod, Inc.
- Vast.ai, Inc.
- Nebius Group N.V.
- Crusoe Energy Systems LLC
- Fluidstack Limited
- Voltage Park, Inc.
- DigitalOcean, LLC
- OVH SAS
- Rackspace Technology, Inc.
- Equinix, Inc.
- Digital Realty Trust, Inc.
- Alibaba Cloud Computing Ltd.
- Tencent Cloud Computing (Beijing) Co., Ltd.
- NVIDIA Corporation
- Advanced Micro Devices, Inc.
- Hewlett Packard Enterprise Company
- Dell Technologies Inc.
Desarrollos recientes de la industria en Mercado de Servicios de Infraestructura GPU Gestionada
- Octubre de 2026: Crusoe lanzó Crusoe Spark Liquid en NVIDIA GTC Berlín, una fábrica de IA modular con refrigeración líquida que ofrece 5 veces la densidad de computación de su predecesora con refrigeración por aire, diseñada para sistemas NVIDIA Vera Rubin NVL72. Crusoe se unió simultáneamente al ecosistema de socios de diseño NVIDIA DSX POD y abrió vistas previas privadas de Managed RL y Managed MLflow.
- Octubre de 2026: Lambda anunció la integración del NVIDIA Run:ai de código abierto con Lambda Kubernetes Service, habilitando el uso compartido de fracciones de GPU, la programación con reconocimiento de topología, la aplicación de cuotas de uso compartido equitativo y la corrección automatizada de nodos para la infraestructura de IA compartida empresarial.
- Octubre de 2025: Eli Lilly implementó 1.016 GPU NVIDIA Blackwell Ultra en una configuración DGX SuperPOD para el entrenamiento de modelos de fundación para el descubrimiento de fármacos a través de Lilly TuneLab.
- Septiembre de 2025: CoreWeave amplió su asociación con OpenAI con un contrato de infraestructura GPU gestionada de 6,5 mil millones de USD, elevando el valor total del acuerdo a 22,4 mil millones de USD.
Alcance del Informe Global del Mercado de Servicios de Infraestructura GPU Gestionada
El mercado de servicios de infraestructura GPU gestionada proporciona a las empresas recursos de computación GPU junto con operaciones lideradas por el proveedor, como implementación, monitoreo, planificación de capacidad, mantenimiento de controladores y firmware, aplicación de parches de seguridad, optimización del rendimiento y respuesta a incidentes. Estos servicios apoyan el entrenamiento de IA, la inferencia, la computación de alto rendimiento, el renderizado y otras cargas de trabajo aceleradas, al tiempo que reducen la necesidad de experiencia interna en operaciones de GPU.
El Informe del Mercado de Servicios de Infraestructura GPU Gestionada está Segmentado por Tipo de Servicio (Diseño e Implementación de Clústeres GPU Gestionados, Operaciones de Infraestructura GPU Gestionada, Orquestación de Kubernetes y Contenedores Gestionados, Operaciones de Plataforma de IA Gestionada y MLOps, Infraestructura Gestionada de Entrenamiento y Ajuste Fino de Modelos, Operaciones de Inferencia Gestionada y Servicio de Modelos, y Otros Tipos de Servicio), Carga de Trabajo GPU (Entrenamiento de Modelos de Fundación, Ajuste Fino y Generación Aumentada por Recuperación, Inferencia de IA y Servicio de Modelos, Computación de Alto Rendimiento y Simulación Científica, Renderizado, Animación, VFX y Producción Virtual, Gemelos Digitales, Ingeniería y Simulación Industrial, y Otras Cargas de Trabajo GPU), Modo de Implementación (Basado en la Nube, En Instalaciones Propias, e Híbrido y Multi-Nube), Tamaño de Organización (Grandes Empresas y Pequeñas y Medianas Empresas), Industria de Usuario Final (Banca, Servicios Financieros y Seguros (BFSI), TI y Telecomunicaciones, Salud y Ciencias de la Vida, Gobierno y Administración Pública, Manufactura Industrial, Comercio Minorista y Comercio Electrónico, y Otras Industrias de Usuario Final) y Geografía (América del Norte, América del Sur, Europa, Asia-Pacífico, Oriente Medio y África). Los Pronósticos del Mercado se Proporcionan en Términos de Valor (USD).
Resumen de la segmentación
| Diseño e Implementación de Clústeres GPU Gestionados |
| Operaciones de Infraestructura GPU Gestionada |
| Orquestación de Kubernetes y Contenedores Gestionados |
| Operaciones de Plataforma de IA Gestionada y MLOps |
| Infraestructura Gestionada de Entrenamiento y Ajuste Fino de Modelos |
| Operaciones de Inferencia Gestionada y Servicio de Modelos |
| Otros Tipos de Servicio |
| Entrenamiento de Modelos de Fundación |
| Ajuste Fino y Generación Aumentada por Recuperación |
| Inferencia de IA y Servicio de Modelos |
| Computación de Alto Rendimiento y Simulación Científica |
| Renderizado, Animación, VFX y Producción Virtual |
| Gemelos Digitales, Ingeniería y Simulación Industrial |
| Otras Cargas de Trabajo GPU |
| Basado en la Nube |
| En Instalaciones Propias |
| Híbrido y Multi-Nube |
| Grandes Empresas |
| Pequeñas y Medianas Empresas |
| Banca, Servicios Financieros y Seguros (BFSI) |
| TI y Telecomunicaciones |
| Salud y Ciencias de la Vida |
| Gobierno y Administración Pública |
| Manufactura Industrial |
| Comercio Minorista y Comercio Electrónico |
| Otras Industrias de Usuario Final |
| América del Norte | Estados Unidos |
| Canadá | |
| México | |
| América del Sur | Brasil |
| Resto de América del Sur | |
| Europa | Alemania |
| Reino Unido | |
| Francia | |
| Resto de Europa | |
| Asia-Pacífico | China |
| Japón | |
| Corea del Sur | |
| India | |
| Resto de Asia-Pacífico | |
| Oriente Medio | Arabia Saudita |
| Emiratos Árabes Unidos | |
| Resto de Oriente Medio | |
| África | Sudáfrica |
| Nigeria | |
| Resto de África |
| Por Tipo de Servicio | Diseño e Implementación de Clústeres GPU Gestionados | |
| Operaciones de Infraestructura GPU Gestionada | ||
| Orquestación de Kubernetes y Contenedores Gestionados | ||
| Operaciones de Plataforma de IA Gestionada y MLOps | ||
| Infraestructura Gestionada de Entrenamiento y Ajuste Fino de Modelos | ||
| Operaciones de Inferencia Gestionada y Servicio de Modelos | ||
| Otros Tipos de Servicio | ||
| Por Carga de Trabajo GPU | Entrenamiento de Modelos de Fundación | |
| Ajuste Fino y Generación Aumentada por Recuperación | ||
| Inferencia de IA y Servicio de Modelos | ||
| Computación de Alto Rendimiento y Simulación Científica | ||
| Renderizado, Animación, VFX y Producción Virtual | ||
| Gemelos Digitales, Ingeniería y Simulación Industrial | ||
| Otras Cargas de Trabajo GPU | ||
| Por Modelo de Implementación | Basado en la Nube | |
| En Instalaciones Propias | ||
| Híbrido y Multi-Nube | ||
| Por Tamaño de Organización | Grandes Empresas | |
| Pequeñas y Medianas Empresas | ||
| Por Usuario Final | Banca, Servicios Financieros y Seguros (BFSI) | |
| TI y Telecomunicaciones | ||
| Salud y Ciencias de la Vida | ||
| Gobierno y Administración Pública | ||
| Manufactura Industrial | ||
| Comercio Minorista y Comercio Electrónico | ||
| Otras Industrias de Usuario Final | ||
| Por Geografía | América del Norte | Estados Unidos |
| Canadá | ||
| México | ||
| América del Sur | Brasil | |
| Resto de América del Sur | ||
| Europa | Alemania | |
| Reino Unido | ||
| Francia | ||
| Resto de Europa | ||
| Asia-Pacífico | China | |
| Japón | ||
| Corea del Sur | ||
| India | ||
| Resto de Asia-Pacífico | ||
| Oriente Medio | Arabia Saudita | |
| Emiratos Árabes Unidos | ||
| Resto de Oriente Medio | ||
| África | Sudáfrica | |
| Nigeria | ||
| Resto de África | ||
Preguntas Clave Respondidas en el Informe
¿Cuál es el tamaño del mercado de servicios de infraestructura GPU gestionada?
Se espera que el tamaño del mercado de servicios de infraestructura GPU gestionada crezca de 3,47 mil millones de USD en 2026 a 4,56 mil millones de USD en 2027 y se prevé que alcance los 14,21 mil millones de USD en 2032 a una CAGR del 25,52% durante 2027-2032.
¿Qué está impulsando la demanda de servicios de infraestructura GPU gestionada?
El entrenamiento de IA generativa a escala de producción, la inferencia persistente, las cargas de trabajo agénticas y el paso del hardware propio a la capacidad contratada son factores clave de demanda.
¿Qué servicio GPU gestionado se está expandiendo más rápidamente?
Se proyecta que las operaciones de inferencia gestionada y servicio de modelos se expandan a una CAGR del 26,81% hasta 2032 a medida que los clientes operan más sistemas de IA en producción.
¿Qué modelo de implementación lidera los servicios GPU gestionados?
La implementación basada en la nube mantuvo una participación del 68,58% en 2026 y se proyecta que se expanda a una CAGR del 27,33% hasta 2032.
¿Qué sector de usuario final tiene la mayor expansión proyectada?
Se proyecta que la salud y las ciencias de la vida se expandan a una CAGR del 28,27% hasta 2032, respaldadas por el descubrimiento de fármacos, la genómica y el desarrollo de modelos biomédicos.
¿Qué región tiene la expansión proyectada más rápida?
Se proyecta que Asia-Pacífico se expanda a una CAGR del 27,91% hasta 2032, respaldada por programas de computación soberana e inversión en capacidad regional.