
Marktgröße und Marktanteil für verwaltete GPU-Infrastrukturdienste
Marktübersicht
| Studienzeitraum | 2021 - 2032 |
|---|---|
| Marktgröße (2027) | 4.56 Milliarden US-Dollar |
| Marktgröße (2032) | 14.21 Milliarden US-Dollar |
| Wachstumsrate (2027 - 2032) | 25.52 % |
| Schnellstwachsender Markt | Asien-Pazifik |
| Größter Markt | Nordamerika |
| Marktkonzentration | Mittel |
Hauptakteure *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert Bild © Mordor Intelligence. Wiederverwendung erfordert Namensnennung gemäß CC BY 4.0. | |
Marktanalyse für verwaltete GPU-Infrastrukturdienste von Mordor Intelligence
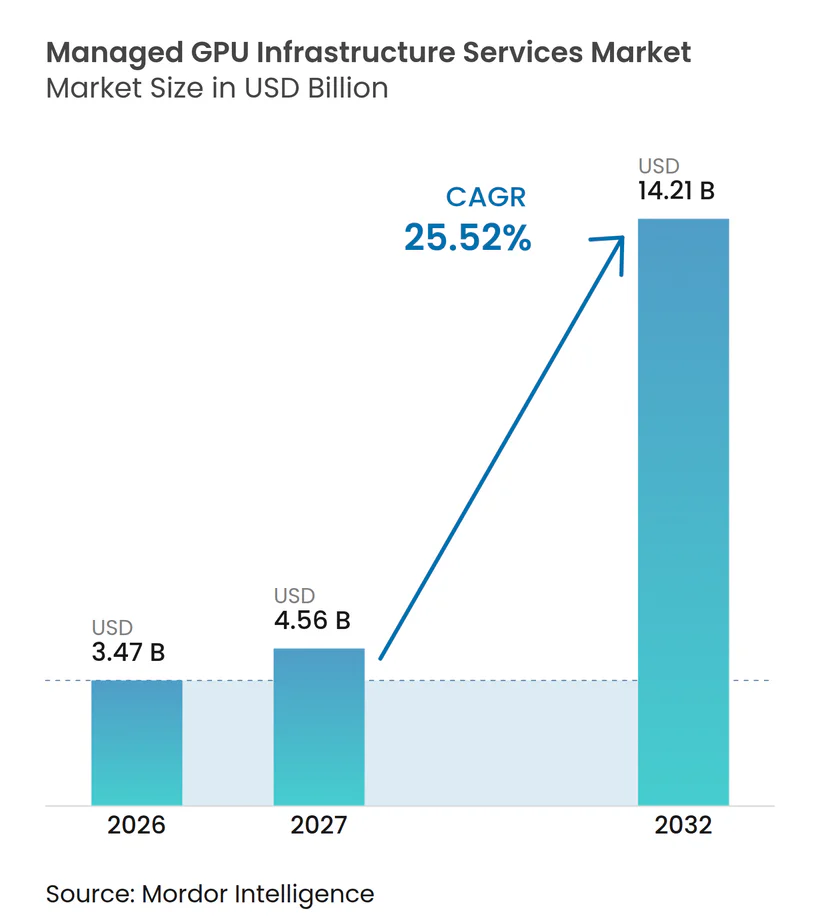
Die Marktgröße für verwaltete GPU-Infrastrukturdienste wird voraussichtlich von 3,47 Milliarden USD im Jahr 2026 auf 4,56 Milliarden USD im Jahr 2027 wachsen und soll bis 2032 bei einem CAGR von 25,52 % über 2027–2032 14,21 Milliarden USD erreichen. Der Markt für verwaltete GPU-Infrastrukturdienste entwickelt sich von periodischen Hardware-Käufen hin zu vertraglich vereinbarten Computing-Diensten im Produktionsmaßstab mit Service-Level-Verpflichtungen. Generatives KI-Training und Inferenz erhöhen den Bedarf an zuverlässiger Kapazität, operativem Support und vorhersehbarer Leistung. Anbieter, die Orchestrierung, Überwachung und verwaltete Betriebsabläufe kombinieren, können komplexere Arbeitslasten bedienen als Anbieter, die lediglich einfache GPU-Vermietung anbieten. Die Hardware-Verfügbarkeit, insbesondere Hochbandbreitenspeicher und fortschrittliche Packaging-Kapazität, begrenzt das Tempo, mit dem Anbieter neue Cluster in Betrieb nehmen können. Anforderungen an souveränes Computing und Datenlokalisierungsregeln schaffen zudem Chancen für regionale Anbieter, die regulierte Arbeitslasten innerhalb der erforderlichen Jurisdiktion unterstützen können.
Wichtigste Erkenntnisse des Berichts
- Nach Dienstleistungstyp hielt der Betrieb verwalteter GPU-Infrastrukturen im Jahr 2026 einen Marktanteil von 28,73 % am Markt für verwaltete GPU-Infrastrukturdienste, während verwaltete Inferenz- und Modell-Serving-Operationen bis 2032 voraussichtlich mit einem CAGR von 26,81 % wachsen werden.
- Nach GPU-Arbeitslast entfielen KI-Inferenz und Modell-Serving im Jahr 2026 auf 36,41 % des Marktanteils für verwaltete GPU-Infrastrukturdienste, während Feinabstimmung und RAG bis 2032 voraussichtlich mit einem CAGR von 27,62 % wachsen werden.
- Nach Bereitstellungsmodell entfiel cloudbasierte Bereitstellung im Jahr 2026 auf 68,58 % des Marktanteils für verwaltete GPU-Infrastrukturdienste und wird bis 2032 voraussichtlich mit einem CAGR von 27,33 % wachsen.
- Nach Unternehmensgröße hielten Großunternehmen im Jahr 2026 einen Anteil von 71,54 %, während KMU bis 2032 voraussichtlich mit einem CAGR von 26,59 % wachsen werden.
- Nach Endnutzer hielten IT und Telekommunikation im Jahr 2026 einen Anteil von 71,54 %, während das Gesundheitswesen und die Biowissenschaften bis 2032 voraussichtlich mit einem CAGR von 28,27 % wachsen werden.
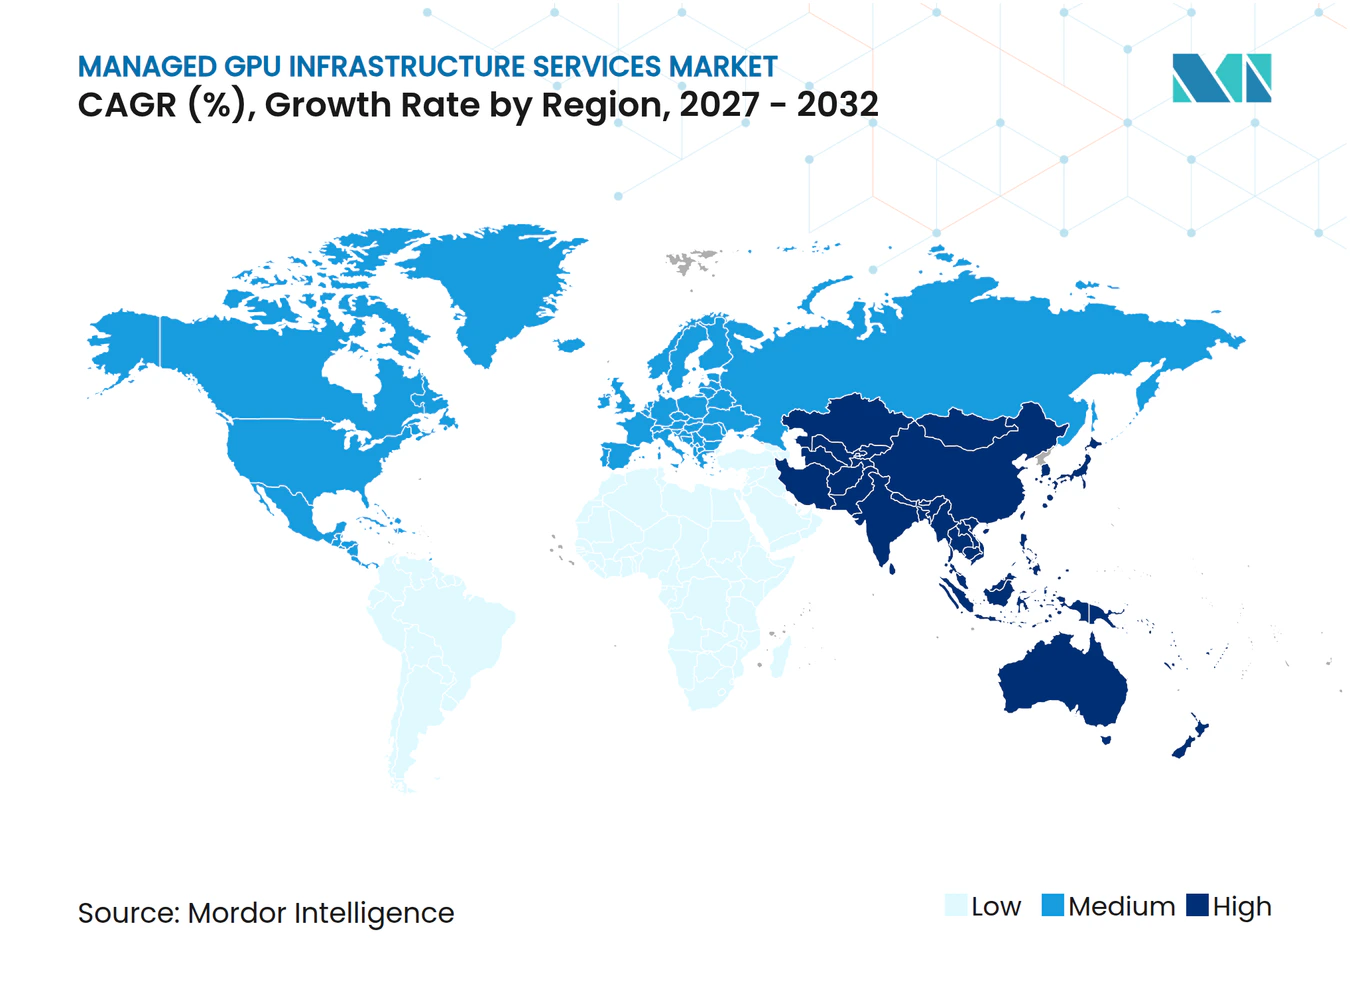
- Nach Geografie hielt Nordamerika im Jahr 2026 einen Anteil von 38,64 % am Markt für verwaltete GPU-Infrastrukturdienste, während der asiatisch-pazifische Raum bis 2032 voraussichtlich mit einem CAGR von 27,91 % wachsen wird.
Hinweis: Die in diesem Bericht angegebenen Marktzahlen basieren auf dem proprietären Schätzrahmen von Mordor Intelligence, der neun Monate an Ist-Daten mit den Prognosen für das vierte Quartal des Basisjahres 2026 kombiniert.
Markttrends und Einblicke
Analyse der Treiberwirkung*
| TREIBER | (~) % AUSWIRKUNG AUF DIE CAGR-PROGNOSE | GEOGRAFISCHE RELEVANZ | ZEITHORIZONT DER AUSWIRKUNG |
|---|---|---|---|
| Generatives KI-Training und Inferenz im Produktionsmaßstab | +8.5% | Global | Mittelfristig (2–4 Jahre) |
| Steigende Inferenzdichte und agentische KI-Arbeitslasten | +7.2% | Global | Kurzfristig (≤ 2 Jahre) |
| Wechsel vom GPU-Besitz zu elastischer verwalteter Kapazität | +5.8% | Nordamerika und Europa | Mittelfristig (2–4 Jahre) |
| Souveräne KI, Datenlokalisierung und Nachfrage nach regulierten Arbeitslasten | +3.4% | Europa, asiatisch-pazifischer Raum, Naher Osten | Mittelfristig (2–4 Jahre) |
| Optimierung der GPU-Auslastung durch fraktionale Zuweisung und Scheduling | +2.1% | Global | Kurzfristig (≤ 2 Jahre) |
| Verwaltete Kühlung, Stromversorgung und Cluster-Betrieb für hochdichte Racks | +1.3% | Nordamerika, asiatisch-pazifischer Kernraum | Langfristig (≥ 4 Jahre) |
| Quelle: Mordor Intelligence | |||
Generatives KI-Training und Inferenz im Produktionsmaßstab
Das Training von Frontier-Sprachmodellen erfordert Cluster mit vielen Tausenden von Beschleunigern, die über längere Zeiträume betrieben werden. Produktionsinferenz erfordert ebenfalls eine dauerhafte Kapazität, da Dienste Millionen von täglichen Anfragen mit strengen Latenzanforderungen bewältigen müssen. Diese Anforderungen übersteigen die Beschaffungs- und Betriebskapazität vieler Unternehmens-IT-Teams. CoreWeave meldete für das Geschäftsjahr 2025 einen Umsatz von 5,1 Milliarden USD, gegenüber 1,9 Milliarden USD im Geschäftsjahr 2024, was den Umfang der vertraglich vereinbarten verwalteten Kapazitätsverpflichtungen unterstreicht.[1] Eli Lilly setzte im Oktober 2025 1.016 NVIDIA Blackwell Ultra GPUs ein, um das Training von Basismodellen für die Wirkstoffforschung über Lilly TuneLab zu unterstützen. Der Markt für verwaltete GPU-Infrastrukturdienste profitiert davon, dass datensensible Branchen den Zugang zu verwalteter Rechenkapazität als operativen Bedarf und nicht als vorübergehenden Projektbedarf betrachten.
Steigende Inferenzdichte und agentische KI-Arbeitslasten
Eine herkömmliche Chatbot-Anfrage kann eine GPU nach der Erzeugung einer Antwort in Millisekunden freigeben. Eine agentische Sitzung kann wiederholte Modellaufrufe, Abrufschritte und Werkzeugaktionen umfassen, wodurch Rechenressourcen deutlich länger belegt werden. Dieses Verhalten erhöht die Dichte und Dauer der Inferenznachfrage. Anbieter müssen die Infrastruktur rund um Speicherbandbreite, Scheduling, Batching und Reaktionszeitmanagement konfigurieren. Verwaltete Inferenz- und Modell-Serving-Operationen werden bis 2032 voraussichtlich mit einem CAGR von 26,81 % wachsen, was diesen Produktionsbedarf widerspiegelt. Der Markt für verwaltete GPU-Infrastrukturdienste begünstigt daher Plattformen, die persistente Inferenz-Flotten betreiben können, ohne dass jeder Kunde ein spezialisiertes Infrastrukturteam aufbauen muss.
Wechsel vom GPU-Besitz zu elastischer verwalteter Kapazität
Der GPU-Besitz birgt ein höheres Risiko, wenn sich Hardware-Generationen schnell weiterentwickeln. Ein Unternehmen, das einen Cluster kauft, kann bei der Verfügbarkeit neuerer Architekturen mit geringerer Effizienz konfrontiert werden. Verwaltete Dienste ermöglichen es Kunden, auf neuere Kapazitäten zuzugreifen, ohne Geräte zu besitzen, die möglicherweise ungenutzt bleiben. CoreWeave meldete zum dritten Quartal 2025 einen Auftragsbestand von 55,6 Milliarden USD, was große vertraglich vereinbarte Verpflichtungen für KI-Infrastruktur widerspiegelt. Reservierte Verpflichtungen können Dienstleistern auch die Nachfragesichtbarkeit verschaffen, die zur Finanzierung neuer Rechenzentrumskapazitäten erforderlich ist. Dieser Wandel unterstützt den Markt für verwaltete GPU-Infrastrukturdienste, da vertraglich vereinbarte Kapazitäten für sich ändernde KI-Arbeitslasten geeigneter sein können als eigene Infrastruktur.
Souveräne KI, Datenlokalisierung und Nachfrage nach regulierten Arbeitslasten
Regierungsrichtlinien verlangen zunehmend eine stärkere Kontrolle über den Standort und den Betrieb von KI-Rechenressourcen. Die Europäische Kommission schlug einen Cloud- und KI-Entwicklungsakt vor, der einen Souveränitätsrahmen für Cloud- und KI-Dienste festlegt.[2] Die höchsten Sicherheitsanforderungen begünstigen Anbieter mit lokal kontrollierten Betriebsabläufen, Personal und Lieferketten. Indiens IndiaAI-Mission wies GPU-Infrastruktur an 14 inländische Anbieter im Rahmen eines Programms im Wert von INR 10.372 Crore (1,23 Milliarden USD) zu, wie im Quellmaterial angegeben. Regionale Datenlokalisierungsmaßnahmen schaffen eine eigenständige Dienstleistungsanforderung, die über den bloßen Zugang zu Beschleunigern hinausgeht. Der Markt für verwaltete GPU-Infrastrukturdienste kann davon profitieren, wenn Anbieter nachprüfbare Compliance, inländisches Hosting und lokalen Betriebssupport nachweisen.
Analyse der Hemmnisse*
| HEMMNIS | (~) % AUSWIRKUNG AUF DIE CAGR-PROGNOSE | GEOGRAFISCHE RELEVANZ | ZEITHORIZONT DER AUSWIRKUNG |
|---|---|---|---|
| Versorgungsvolatilität bei GPUs, HBM und fortschrittlichem Packaging | -4.2% | Global | Kurzfristig (≤ 2 Jahre) |
| Einschränkungen bei der Nachrüstung von Hochdichte-Strom- und Kühlsystemen | -3.1% | Nordamerika und Europa | Mittelfristig (2–4 Jahre) |
| Schnelle Obsoleszenz von Beschleunigern und Upgrade-Risiko | -1.8% | Global | Langfristig (≥ 4 Jahre) |
| Datensicherheit, Multi-Tenant-Isolation und Compliance-Bedenken | -1.4% | Global, Schwerpunkt asiatisch-pazifischer Raum und Europa | Mittelfristig (2–4 Jahre) |
| Quelle: Mordor Intelligence | |||
Versorgungsvolatilität bei GPUs, HBM und fortschrittlichem Packaging
Die Lieferkette für Frontier-KI-Beschleuniger bleibt durch Hochbandbreitenspeicher und fortschrittliches Packaging eingeschränkt. Diese Komponenten können die Beschleunigerproduktion begrenzen, selbst wenn Fertigungskapazitäten für Logikchips verfügbar sind. Eine begrenzte Gruppe von Anbietern kontrolliert einen großen Anteil des fortschrittlichen Packagings und der Speicherversorgung. Neue Fertigungslinien erfordern lange Vorlaufzeiten, was schnelle Kapazitätserweiterungen einschränkt. Für Dienstleister können Engpässe die Inbetriebnahme von Clustern verzögern und Wartelisten für Kunden verlängern. Der Markt für verwaltete GPU-Infrastrukturdienste kann bei einer langsameren Expansion und einem Preisdruck konfrontiert werden, wenn die vertraglich vereinbarte Nachfrage das einsetzbare Hardware-Angebot übersteigt.
Einschränkungen bei der Nachrüstung von Hochdichte-Strom- und Kühlsystemen
KI-Trainingsbereitstellungen erfordern deutlich höhere Rack-Dichten als herkömmliche Unternehmensinfrastruktur. NVIDIAs GB300 NVL72-basierte Cluster können bis zu 142 kW pro Rack verbrauchen.[3] Viele ältere Einrichtungen wurden für deutlich geringere Stromlasten und herkömmliche Luftkühlung ausgelegt. Hochdichte Cluster erfordern direkte Flüssigkühlung oder Immersionssysteme sowie damit verbundene Änderungen an der Stromverteilung. Diese Nachrüstungsanforderungen erhöhen den Kapital- und Ausführungsaufwand für Rechenzentrumsbetreiber. Der Markt für verwaltete GPU-Infrastrukturdienste könnte daher Anbieter mit neueren Einrichtungen oder den Ressourcen zur Umgestaltung bestehender Standorte begünstigen.
*Unsere Prognosen behandeln die Auswirkungen von Treibern und Einschränkungen als richtungsweisend und nicht additiv. Die Wirkungsprognosen berücksichtigen Basiswachstum, Mischungseffekte und Wechselwirkungen zwischen Variablen.
Segmentanalyse
Nach Dienstleistungstyp:
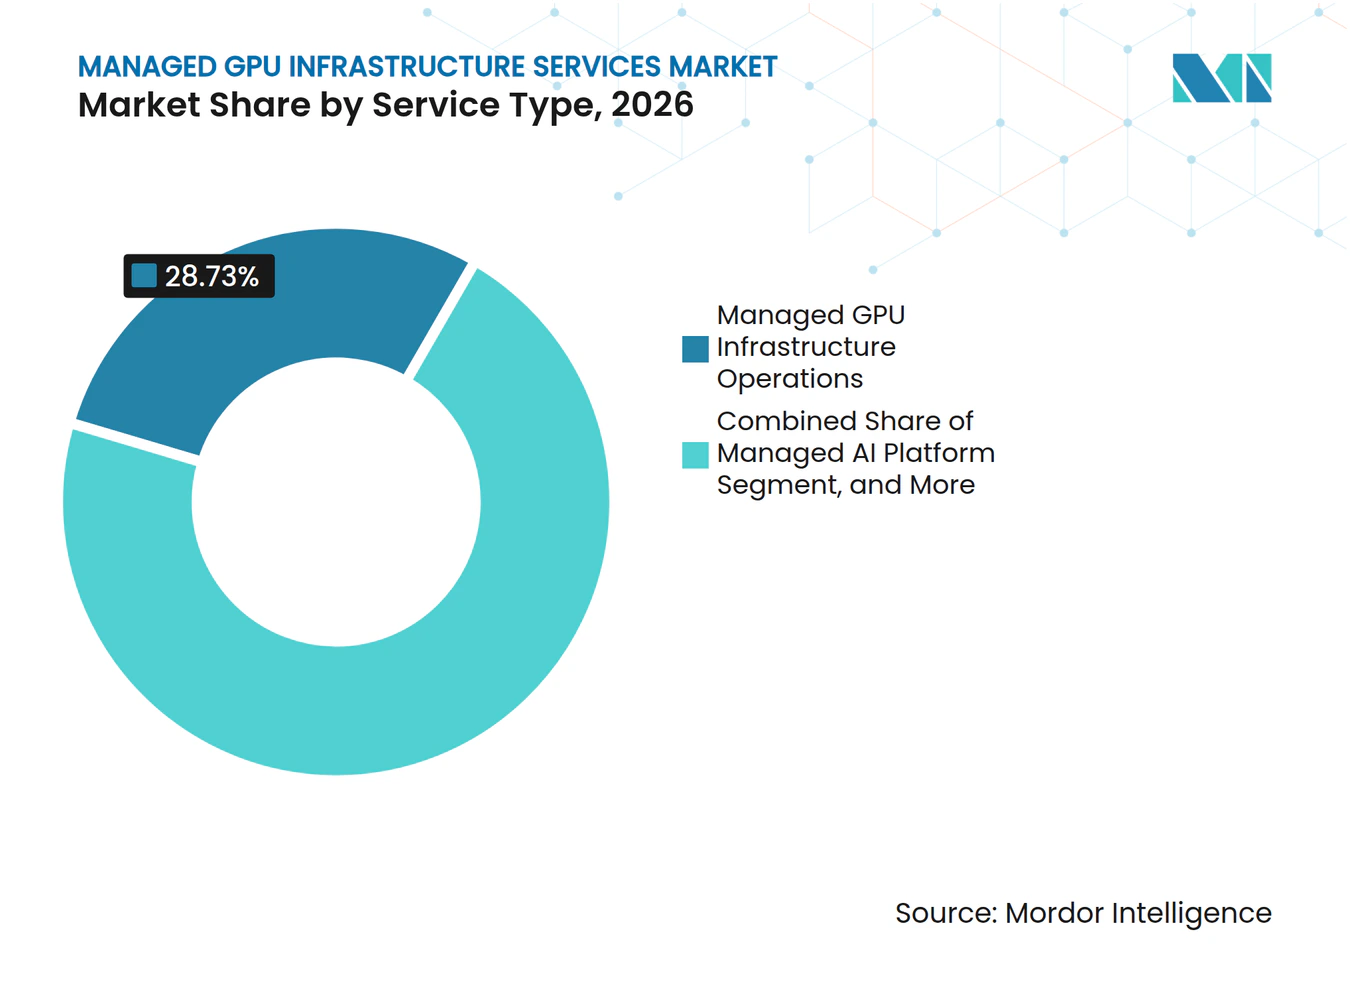
Betrieb und Inferenz-Support treiben die verwaltete Akzeptanz voranDer Betrieb verwalteter GPU-Infrastrukturen hielt im Jahr 2026 einen Anteil von 28,73 % am gesamten Dienstleistungsumsatz. Das Segment umfasst Cluster-Lebenszyklusaufgaben wie Firmware-Updates, Kapazitäts-Scheduling, Zustandsüberwachung und Fehlerbehebung. Organisationen, die Cluster mit vielen Tausenden von GPUs betreiben, verfügen häufig nicht über das interne Personal, das zur Aufrechterhaltung der Service-Level-Verfügbarkeit erforderlich ist. Vollständig verwaltete Betriebsabläufe schließen diese Lücke durch die Kombination von Infrastrukturüberwachung und Kundensupport. Verwaltetes Kubernetes und Container-Orchestrierung unterstützen die Bereitstellung von Anwendungen in gemeinsam genutzten Rechenumgebungen. Verwaltete KI-Plattform- und MLOps-Operationen können Kunden dann dabei helfen, Modelle zu überwachen und Produktions-Workflows zu verwalten.
Verwaltete Inferenz- und Modell-Serving-Operationen werden bis 2032 voraussichtlich mit einem CAGR von 26,81 % wachsen. Ihr Umfang umfasst Modell-Routing, automatische Skalierung, Token-Caching und Latenzmanagement für Produktionsdienste. Diese Funktionen werden wichtiger, wenn Unternehmen von gelegentlichem Modelltraining zu laufender Inferenz übergehen. Verwaltete Modelltrainings- und Feinabstimmungsinfrastruktur unterstützt auch Organisationen, die mit sensiblen proprietären Daten arbeiten. Lambda gab im Oktober 2026 bekannt, dass es Open-Source NVIDIA Run:ai mit dem Lambda Kubernetes Service für GPU-Fraktionsfreigabe, topologiebewusstes Scheduling, Fair-Share-Quoten und automatisierte Knotenbereinigung integrieren wird.[4] Kunden können diese Funktionen nutzen, um gemeinsam genutzte Infrastruktur zu verwalten und dabei den Arbeitslastzugang und die Ressourcenzuweisung unter definierten Betriebsregeln zu halten. Das Dienstleistungsmodell reduziert auch den Bedarf, separate Teams für Cluster-Administration, Scheduling-Richtlinien und die tägliche Fehlerbehebung zusammenzustellen. Diese Fähigkeiten zeigen, warum die Dienstleistungsdifferenzierung in der Branche für verwaltete GPU-Infrastrukturdienste über den bloßen Zugang zu Hardware hinausgeht.



Nach GPU-Arbeitslast:
Inferenznachfrage gestaltet die Cluster-Nutzung umKI-Inferenz und Modell-Serving entfielen im Jahr 2026 auf 36,41 % des gesamten Dienstleistungsumsatzes. Unternehmen nutzen KI-Systeme zunehmend für Echtzeit-Anwendungen und nicht nur für Batch-Verarbeitungsaufgaben. Inferenz-Arbeitslasten legen besonderen Wert auf Speicherbandbreite, Reaktionszeit und effiziente Ressourcenzuweisung. Anbieter müssen Cluster für einen stabilen Produktionsbetrieb konfigurieren und nicht nur für Spitzen-Trainingsleistung. Das Training von Basismodellen bleibt für Frontier-KI-Labore mit großen Daten- und Rechenanforderungen relevant. Open-Weight-Modelle reduzieren den Bedarf vieler Organisationen, große Modelle von Grund auf zu trainieren.
Feinabstimmung und RAG werden bis 2032 voraussichtlich mit einem CAGR von 27,62 % wachsen. Viele Organisationen passen bestehende Frontier- oder Open-Weight-Modelle an ihre eigenen Daten an, anstatt Basismodelle von Grund auf zu entwickeln. Dieser Ansatz schafft Nachfrage nach sicheren Umgebungen, die wiederholte Modellentwicklung und -evaluierung unterstützen. Eli Lilly, Roche und Bristol Myers Squibb kündigten bis Mitte 2026 dedizierte GPU SuperPOD-Bereitstellungen für forschungsbezogene KI-Arbeitslasten an. Diese Bereitstellungen zeigen, dass wissenschaftliche Nutzer wiederholbaren Zugang zu Rechenkapazität während iterativer Forschungszyklen benötigen. Anbieter können diese Arbeit durch verwaltete Umgebungen unterstützen, die Infrastrukturkontrolle mit operativer Kontinuität verbinden. HPC und wissenschaftliche Simulation behalten eine eigenständige Nachfrage von Forschungs-, Ingenieur- und technischen Computernutzern. Digitale Zwillinge und Rendering nutzen ebenfalls verwaltete GPU-Kapazität, obwohl Inferenz und Feinabstimmung einen wachsenden Anteil der verfügbaren Ressourcen beanspruchen.
Nach Bereitstellungsmodell:
Cloud führt, während Hybrid kontrollierte Arbeitslasten unterstütztCloudbasierte Bereitstellung entfiel im Jahr 2026 auf 68,58 % der Marktgröße für verwaltete GPU-Infrastrukturdienste. Sie wird bis 2032 auch voraussichtlich mit einem CAGR von 27,33 % wachsen. Cloud-Dienste ermöglichen es Kunden, von einem kleinen Feinabstimmungslauf zu einem deutlich größeren Trainingscluster zu wechseln, ohne physische Hardware kaufen zu müssen. Diese Flexibilität eignet sich für Organisationen mit ungleichmäßiger Nachfrage zwischen Entwicklungszyklen und Produktionsphasen. Sie gibt Anbietern auch die Möglichkeit, Kapazitäten über Kunden hinweg zu bündeln. Das Cloud-Modell unterstützt den breiteren Markt für verwaltete GPU-Infrastrukturdienste, indem es fortschrittliche Rechenleistung über verbrauchsbasierte Dienstleistungsmodelle zugänglich macht.
Vor-Ort-Bereitstellungen verwalteter GPUs bleiben für Organisationen relevant, die Datentransfer-Einschränkungen unterliegen oder sehr geringe Latenz benötigen. Regierungs- und Verteidigungsnutzer können auch physische Isolation für ausgewählte Arbeitslasten erfordern. Hybride und Multi-Cloud-Umgebungen ermöglichen es Unternehmen, öffentlich zugängliche Inferenz von proprietärer Modellentwicklung zu trennen. Red Hat identifiziert Hardware, Fabric, Scheduler und Virtualisierung als eigenständige Schichten, die aufeinander abgestimmte Kontrollen für die Multi-Tenant-GPU-Isolation erfordern. Dieses mehrschichtige Design spiegelt den operativen Aufwand wider, wenn Kunden mehr als eine Infrastrukturumgebung nutzen. Es hilft auch zu erklären, warum verwaltete Dienste relevant sind, wenn Organisationen gemeinsame Richtlinien über verschiedene Standorte hinweg benötigen. Souveräne Computing-Richtlinien können verlangen, dass bestimmte Arbeitslasten in einer definierten Jurisdiktion verbleiben. Diese Bedingungen schaffen Nachfrage nach Anbietern, die koordinierte Umgebungen über Cloud-, lokale und souveräne Infrastruktur hinweg betreiben können.
Nach Unternehmensgröße:
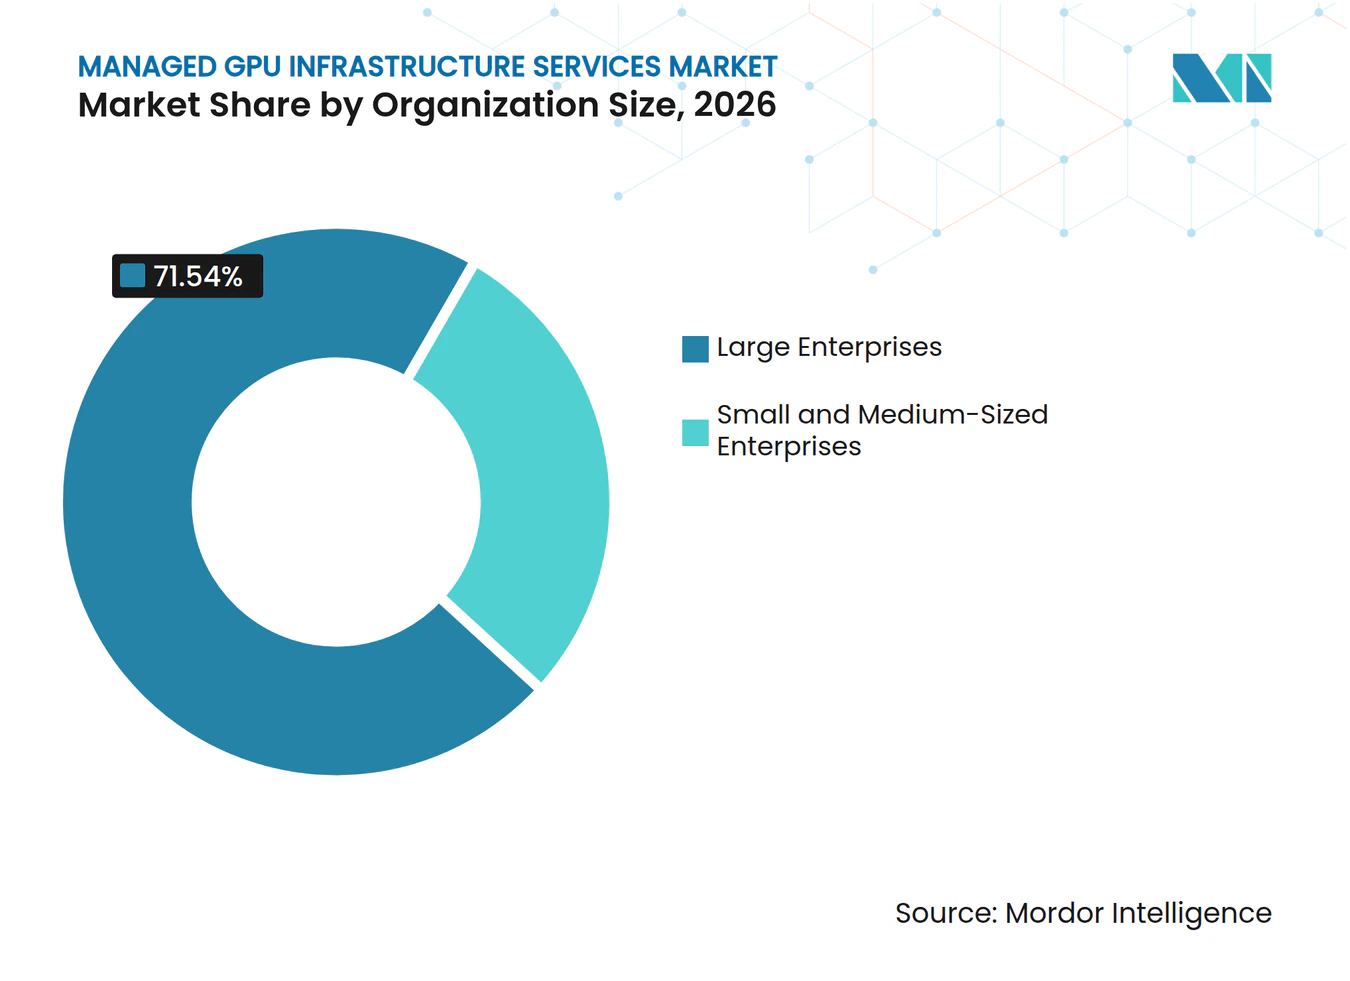
Großunternehmen führen, KMU verbessern den ZugangGroßunternehmen hielten im Jahr 2026 einen Anteil von 71,54 %. Sie können mehrjährige Reservierungsverträge abschließen, die Rechenzentrumsinvestitionsentscheidungen von Neoclouds und Hyperscalern unterstützen. Reservierte Verpflichtungen können niedrigere Preise als On-Demand-Nutzung bieten, erfordern jedoch eine klare Arbeitslastplanung und finanzielle Kapazität. Große Kunden kaufen häufig höherwertige Betriebsunterstützung, Sicherheitsisolation, benutzerdefinierte Netzwerkkonfigurationen und MLOps-Integration. Diese Dienste helfen dabei, vorhersehbare Kapazitäten für Unternehmens-KI-Programme aufrechtzuerhalten. Die Konzentration großer Verträge gibt Anbietern auch eine stärkere Grundlage für die Finanzierung der Infrastrukturerweiterung.
KMU werden bis 2032 voraussichtlich mit einem CAGR von 26,59 % wachsen. Serverlose GPU-Dienste und sekundenbasierte Abrechnung reduzieren die Mindestverpflichtung, die für die Nutzung von Hochleistungsrechnen erforderlich ist. Fraktionale Zuweisung ermöglicht es einem Kunden, einen Teil einer GPU zu nutzen, anstatt ein vollständiges Gerät zu reservieren. Fair-Share-Scheduling und Spot-Instanz-Preemption können gemeinsam genutzte Pools für kleinere Arbeitslasten praktischer machen. Automatisierte Bereitstellung kann auch den Verwaltungsaufwand für Teams reduzieren, die kein dediziertes Infrastrukturpersonal haben. Diese Verbrauchsmodelle ermöglichen es kleineren Kunden, die Kapazitätsnutzung enger an die Dauer und das Nachfragemuster eines Projekts anzupassen. Diese Modelle können den Zugang für Organisationen ohne ein dediziertes KI-Infrastrukturbudget verbessern. Die KMU-Nachfrage verbreitert die Kundenbasis des Marktes für verwaltete GPU-Infrastrukturdienste und legt gleichzeitig größeren Wert auf automatisierte Bereitstellung und Auslastungskontrollen.

Nach Endnutzer:
IT und Telekommunikation führen, Gesundheitswesen expandiertIT und Telekommunikation hielten im Jahr 2026 einen Anteil von 71,54 %. Der Sektor ist sowohl ein wichtiger Aufbauer als auch ein wichtiger Nutzer von KI-Recheninfrastruktur. Cloud-Anbieter benötigen Kapazitäten für Kundenplattformen und interne Dienste. Telekommunikationsunternehmen nutzen KI für den Netzwerkbetrieb und damit verbundene digitale Dienste. SaaS-Anbieter benötigen ebenfalls verwaltete GPU-Kapazität, wenn sie bestehenden Produkten generative KI-Funktionen hinzufügen. Diese Anforderungen machen das Segment zu einer stabilen Quelle für Nachfrage im Produktionsmaßstab.
Das Gesundheitswesen und die Biowissenschaften werden bis 2032 voraussichtlich mit einem CAGR von 28,27 % wachsen. Pharmazeutische und biotechnologische Organisationen nutzen GPU-intensive Systeme für die Vorhersage von Proteinstrukturen, molekulares Docking, Genomik und das Training biomedizinischer Modelle. NVIDIA berichtete, dass 57 % der befragten pharmazeutischen und biotechnologischen Teilnehmer die Wirkstoffforschung als ihren primären KI-Anwendungsfall identifizierten, während 44 % Genomik-Anwendungen nannten.[5] Diese Arbeitslasten erfordern geschützte Rechenumgebungen, da Forschungsdaten und Modellausgaben sensibel sein können. Sie profitieren auch von operativer Zuverlässigkeit, bei der Rechenprozesse wiederholten Zugang zu Hochleistungsressourcen benötigen. BFSI-Nutzer wenden verwaltetes Computing auf Risikomodellierung, Betrugserkennung und generative KI-Arbeitslasten an. Regierungs-, Industriefertigungs- und Einzelhandelsorganisationen nutzen Dienste für souveräne Anwendungen, digitale Zwillinge, Ingenieurssimulation, Empfehlungssysteme und Personalisierung. Diese vielfältigen Nutzungen reduzieren die Abhängigkeit von einer einzigen Endnutzerkategorie in der Branche für verwaltete GPU-Infrastrukturdienste.
Geografische Analyse
Markt für verwaltete GPU-Infrastrukturdienste in Nordamerika
Nordamerika hielt im Jahr 2026 einen Anteil von 38,64 % am Gesamtumsatz. Die Region weist eine hohe Konzentration an Hyperscale-Cloud-Anbietern, KI-nativen Unternehmen und zweckgebundenen GPU-Cloud-Betreibern auf. CoreWeave betrieb im Jahr 2025 43 Rechenzentren mit mehr als 850 MW aktiver Leistung. Das Unternehmen plante für 2026 Investitionsausgaben von 30 bis 35 Milliarden USD und strebte bis 2030 eine Gesamtkapazität von mehr als 8 GW an. Kanada und Mexiko können von Infrastruktur-Spillover-Effekten und ihrer Nähe zu den Vereinigten Staaten profitieren.
Markt für verwaltete GPU-Infrastrukturdienste in Europa und im asiatisch-pazifischen Raum
Europa baut seine Kapazitäten durch Hyperscaler-Regionen und souveräne Cloud-Programme aus. Der vorgeschlagene EU-Rahmen schafft strukturiertere Beschaffungsanforderungen für konforme Cloud- und KI-Infrastruktur. Der asiatisch-pazifische Raum wird voraussichtlich bis 2032 mit einer CAGR von 27,91 % wachsen – die höchste regionale Rate im Markt für verwaltete GPU-Infrastrukturdienste. Indonesien entwickelt sich durch das Engagement der Ooredoo Group in Höhe von 800 Millionen USD für Zankore zu einem Bereitstellungsstandort, der auf eine NVIDIA DSX AI Factory-Kapazität von 1 GW abzielt. Der Plan sieht vor, dass 200 MW in der ersten Hälfte des Jahres 2027 in Betrieb gehen.
Markt für verwaltete GPU-Infrastrukturdienste im asiatisch-pazifischen Raum, im Nahen Osten und Afrika sowie in Südamerika
Indiens IndiaAI-Mission, die inländische Cloud-Expansion in China sowie staatlich geförderte Rechenprogramme in Japan und Südkorea stützen die politisch getriebene Nachfrage im gesamten asiatisch-pazifischen Raum. Der Nahe Osten wird durch Investitionen aus Staatsfonds und niedrige Energiekosten in Saudi-Arabien und den Vereinigten Arabischen Emiraten unterstützt. Südamerika hat Brasilien als wichtigstes Zentrum, mit Nachfrage aus dem Bankwesen, dem Einzelhandel und der digitalen Transformation des öffentlichen Sektors. Die Investitionen in der Region bleiben hinter dem Ausmaß des Ausbaus im asiatisch-pazifischen Raum zurück. Afrika bleibt das kleinste regionale Segment, obwohl Südafrika, Nigeria und Kenia erste Aktivitäten zeigen. Hyperscaler beginnen damit, GPU-Kapazitäten bereitzustellen, um die wachsende digitale Wirtschaft des Kontinents zu bedienen.
Wettbewerbslandschaft
Marktkonzentration
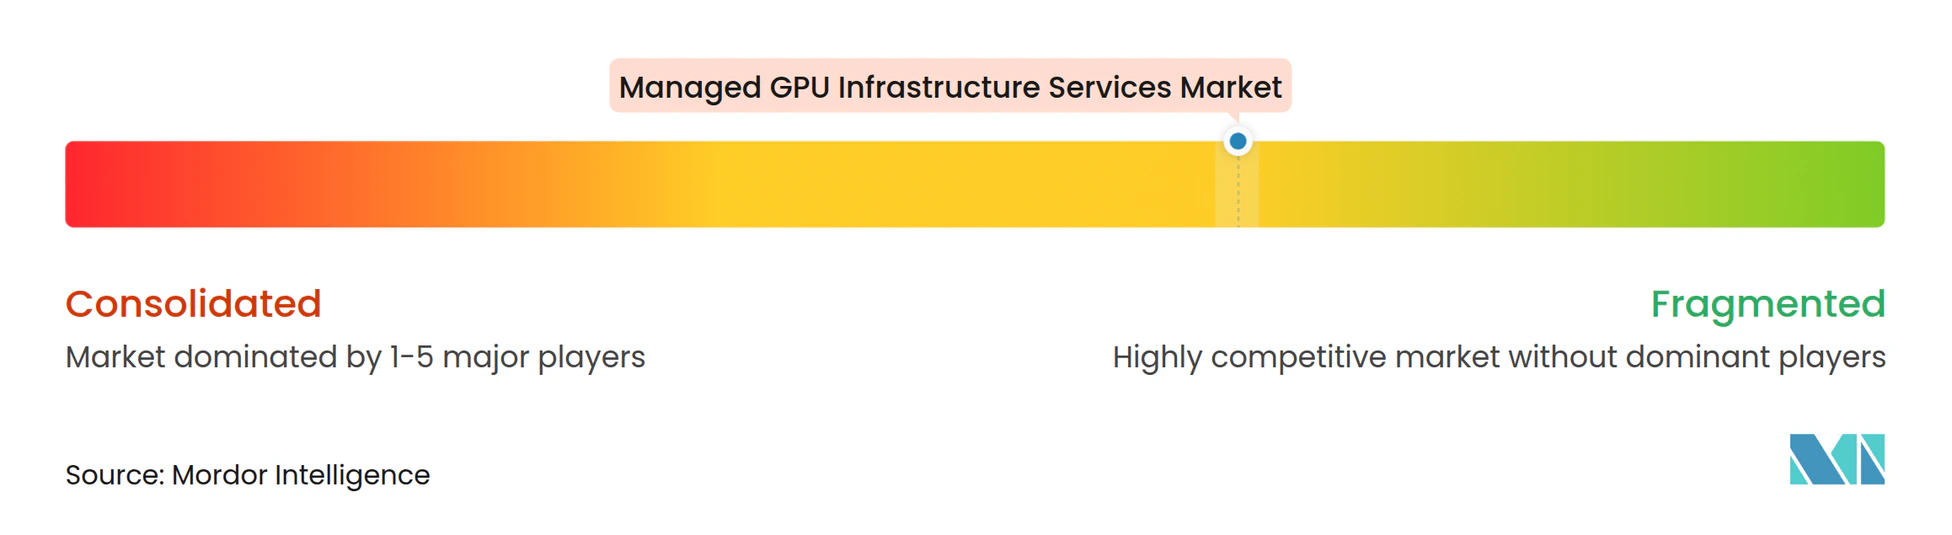
Der Markt für verwaltete GPU-Infrastrukturdienste ist mäßig fragmentiert und weist eine gestufte Wettbewerbsstruktur auf. AWS, Microsoft Azure, Google Cloud, Oracle Cloud Infrastructure und IBM Cloud konkurrieren durch breite geografische Reichweite, integrierte Software und etablierte Unternehmensbeziehungen. CoreWeave, Lambda, Crusoe, Nebius, RunPod, Vast.ai und Voltage Park konkurrieren durch den Fokus auf neuere Hardware, Single-Tenant-Konfigurationen und schnellere Bereitstellung. Anbieter, die nur undifferenzierte GPU-Vermietung anbieten, sehen sich einem stärkeren Preisdruck ausgesetzt, da der grundlegende H100-Zugang immer breiter verfügbar wird. Der Wettbewerbsvorteil liegt zunehmend im Betrieb der Infrastruktur und nicht nur in der Bereitstellung des Beschleunigers. Anbieter müssen auch Sicherheit, Beobachtbarkeit, Kapazitätsplanung und Leistung auf Anwendungsebene unterstützen.
Langfristige Kapazitätsverpflichtungen können die Beziehungen zwischen führenden Anbietern und ihren größten Kunden stärken. CoreWeave erweiterte seine Beziehung zu OpenAI durch einen Vertrag im Wert von 6,5 Milliarden USD im September 2025, wodurch der angegebene Gesamtvertragswert auf 22,4 Milliarden USD über 3 Erweiterungen stieg. Crusoe startete im Oktober 2026 Crusoe Spark Liquid, eine flüssiggekühlte modulare KI-Fabrik für NVIDIA Vera Rubin NVL72-Systeme. Lambda kündigte im Oktober 2026 seine NVIDIA Run:ai-Integration für seinen Kubernetes-Dienst an. Diese Schritte adressieren Cluster-Dichte, Scheduling und verwaltete Betriebsabläufe, die wichtige Bereiche der Dienstleistungsdifferenzierung sind.
Chancen bestehen in souveräner und regulierter Infrastruktur, auf KMU ausgerichteter verwalteter Inferenz und Orchestrierung für agentische Arbeitslasten. Regionale Telekommunikationsunternehmen können lokale Konnektivität, Unternehmensbeziehungen und lokale Infrastruktur kombinieren, wenn sie in den Markt für verwaltete GPU-Dienste eintreten. Anbieter, die den vollständigen Technologie-Stack von der Hardware-Konfiguration bis zur MLOps-Beobachtbarkeit validieren können, haben eine stärkere Position bei regulierten Kunden. Datensanitierungs- und Isolationspraktiken sind ebenfalls wichtig, wenn Kunden Infrastruktur gemeinsam nutzen. Der Markt bleibt wettbewerbsfähig über Hyperscale-, Neocloud- und regionale Dienstleistungsebenen hinweg. Das verfügbare Quellmaterial liefert keine kombinierten Marktanteile für die führenden Akteure, sodass ein numerischer Konzentrationsindex ohne eine nicht unterstützte Schätzung nicht angegeben werden kann.
Marktführer in der Branche für verwaltete GPU-Infrastrukturdienste
-
Amazon Web Services, Inc.
-
Microsoft Corporation
-
Google LLC
-
Oracle Corporation
-
International Business Machines Corporation
- *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert
Markt für verwaltete GPU-Infrastrukturdienste Unternehmen in diesem Bericht
- Amazon Web Services, Inc.
- Microsoft Corporation
- Google LLC
- Oracle Corporation
- International Business Machines Corporation
- CoreWeave, Inc.
- Lambda, Inc.
- RunPod, Inc.
- Vast.ai, Inc.
- Nebius Group N.V.
- Crusoe Energy Systems LLC
- Fluidstack Limited
- Voltage Park, Inc.
- DigitalOcean, LLC
- OVH SAS
- Rackspace Technology, Inc.
- Equinix, Inc.
- Digital Realty Trust, Inc.
- Alibaba Cloud Computing Ltd.
- Tencent Cloud Computing (Beijing) Co., Ltd.
- NVIDIA Corporation
- Advanced Micro Devices, Inc.
- Hewlett Packard Enterprise Company
- Dell Technologies Inc.
Neueste Industrielle Entwicklungen in Markt für verwaltete GPU-Infrastrukturdienste
- Oktober 2026: Crusoe stellte Crusoe Spark Liquid auf der NVIDIA GTC Berlin vor, eine flüssiggekühlte modulare KI-Fabrik, die die fünffache Rechendichte ihres luftgekühlten Vorgängers liefert und für NVIDIA Vera Rubin NVL72-Systeme entwickelt wurde. Crusoe trat gleichzeitig dem NVIDIA DSX POD-Designpartner-Ökosystem bei und eröffnete private Vorschauen von Managed RL und Managed MLflow.
- Oktober 2026: Lambda kündigte die Integration von Open-Source NVIDIA Run:ai mit dem Lambda Kubernetes Service an und ermöglichte damit GPU-Fraktionsfreigabe, topologiebewusstes Scheduling, Fair-Share-Quotendurchsetzung und automatisierte Knotenbereinigung für gemeinsam genutzte KI-Unternehmensinfrastruktur.
- Oktober 2025: Eli Lilly setzte 1.016 NVIDIA Blackwell Ultra GPUs in einer DGX SuperPOD-Konfiguration für das Training von Basismodellen für die Wirkstoffforschung über Lilly TuneLab ein.
- September 2025: CoreWeave erweiterte seine Partnerschaft mit OpenAI durch einen verwalteten GPU-Infrastrukturvertrag im Wert von 6,5 Milliarden USD und brachte den Gesamtvertragswert auf 22,4 Milliarden USD.
Globaler Berichtsumfang des Marktes für verwaltete GPU-Infrastrukturdienste
Der Markt für verwaltete GPU-Infrastrukturdienste stellt Unternehmen GPU-Rechenressourcen zusammen mit anbieterseitig geführten Betriebsabläufen wie Bereitstellung, Überwachung, Kapazitätsplanung, Treiber- und Firmware-Wartung, Sicherheits-Patching, Leistungsoptimierung und Incident-Response zur Verfügung. Diese Dienste unterstützen KI-Training, Inferenz, Hochleistungsrechnen, Rendering und andere beschleunigte Arbeitslasten und reduzieren gleichzeitig den Bedarf an internem Fachwissen im GPU-Betrieb.
Der Marktbericht für verwaltete GPU-Infrastrukturdienste ist segmentiert nach Dienstleistungstyp (verwaltetes GPU-Cluster-Design und -Bereitstellung, Betrieb verwalteter GPU-Infrastrukturen, verwaltetes Kubernetes und Container-Orchestrierung, verwaltete KI-Plattform- und MLOps-Operationen, verwaltete Modelltrainings- und Feinabstimmungsinfrastruktur, verwaltete Inferenz- und Modell-Serving-Operationen und andere Dienstleistungstypen), GPU-Arbeitslast (Training von Basismodellen, Feinabstimmung und Retrieval-Augmented Generation, KI-Inferenz und Modell-Serving, Hochleistungsrechnen und wissenschaftliche Simulation, Rendering, Animation, VFX und virtuelle Produktion, digitale Zwillinge, Ingenieurswesen und industrielle Simulation sowie andere GPU-Arbeitslasten), Bereitstellungsmodell (cloudbasiert, vor Ort sowie hybrid und Multi-Cloud), Unternehmensgröße (Großunternehmen sowie kleine und mittlere Unternehmen), Endnutzerbranche (Banken, Finanzdienstleistungen und Versicherungen (BFSI), IT und Telekommunikation, Gesundheitswesen und Biowissenschaften, Regierung und öffentliche Verwaltung, Industriefertigung, Einzelhandel und E-Commerce sowie andere Endnutzerbranchen) sowie Geografie (Nordamerika, Südamerika, Europa, asiatisch-pazifischer Raum, Naher Osten und Afrika). Die Marktprognosen werden in Wertangaben (USD) bereitgestellt.
Segmentierungsübersicht
| Verwaltetes GPU-Cluster-Design und -Bereitstellung |
| Betrieb verwalteter GPU-Infrastrukturen |
| Verwaltetes Kubernetes und Container-Orchestrierung |
| Verwaltete KI-Plattform- und MLOps-Operationen |
| Verwaltete Modelltrainings- und Feinabstimmungsinfrastruktur |
| Verwaltete Inferenz- und Modell-Serving-Operationen |
| Andere Dienstleistungstypen |
| Training von Basismodellen |
| Feinabstimmung und Retrieval-Augmented Generation |
| KI-Inferenz und Modell-Serving |
| Hochleistungsrechnen und wissenschaftliche Simulation |
| Rendering, Animation, VFX und virtuelle Produktion |
| Digitale Zwillinge, Ingenieurswesen und industrielle Simulation |
| Andere GPU-Arbeitslasten |
| Cloudbasiert |
| Vor Ort |
| Hybrid und Multi-Cloud |
| Großunternehmen |
| Kleine und mittlere Unternehmen |
| Banken, Finanzdienstleistungen und Versicherungen (BFSI) |
| IT und Telekommunikation |
| Gesundheitswesen und Biowissenschaften |
| Regierung und öffentliche Verwaltung |
| Industriefertigung |
| Einzelhandel und E-Commerce |
| Andere Endnutzerbranchen |
| Nordamerika | Vereinigte Staaten |
| Kanada | |
| Mexiko | |
| Südamerika | Brasilien |
| Übriges Südamerika | |
| Europa | Deutschland |
| Vereinigtes Königreich | |
| Frankreich | |
| Übriges Europa | |
| Asiatisch-pazifischer Raum | China |
| Japan | |
| Südkorea | |
| Indien | |
| Übriger asiatisch-pazifischer Raum | |
| Naher Osten | Saudi-Arabien |
| Vereinigte Arabische Emirate | |
| Übriger Naher Osten | |
| Afrika | Südafrika |
| Nigeria | |
| Übriges Afrika |
| Nach Dienstleistungstyp | Verwaltetes GPU-Cluster-Design und -Bereitstellung | |
| Betrieb verwalteter GPU-Infrastrukturen | ||
| Verwaltetes Kubernetes und Container-Orchestrierung | ||
| Verwaltete KI-Plattform- und MLOps-Operationen | ||
| Verwaltete Modelltrainings- und Feinabstimmungsinfrastruktur | ||
| Verwaltete Inferenz- und Modell-Serving-Operationen | ||
| Andere Dienstleistungstypen | ||
| Nach GPU-Arbeitslast | Training von Basismodellen | |
| Feinabstimmung und Retrieval-Augmented Generation | ||
| KI-Inferenz und Modell-Serving | ||
| Hochleistungsrechnen und wissenschaftliche Simulation | ||
| Rendering, Animation, VFX und virtuelle Produktion | ||
| Digitale Zwillinge, Ingenieurswesen und industrielle Simulation | ||
| Andere GPU-Arbeitslasten | ||
| Nach Bereitstellungsmodell | Cloudbasiert | |
| Vor Ort | ||
| Hybrid und Multi-Cloud | ||
| Nach Unternehmensgröße | Großunternehmen | |
| Kleine und mittlere Unternehmen | ||
| Nach Endnutzer | Banken, Finanzdienstleistungen und Versicherungen (BFSI) | |
| IT und Telekommunikation | ||
| Gesundheitswesen und Biowissenschaften | ||
| Regierung und öffentliche Verwaltung | ||
| Industriefertigung | ||
| Einzelhandel und E-Commerce | ||
| Andere Endnutzerbranchen | ||
| Nach Geografie | Nordamerika | Vereinigte Staaten |
| Kanada | ||
| Mexiko | ||
| Südamerika | Brasilien | |
| Übriges Südamerika | ||
| Europa | Deutschland | |
| Vereinigtes Königreich | ||
| Frankreich | ||
| Übriges Europa | ||
| Asiatisch-pazifischer Raum | China | |
| Japan | ||
| Südkorea | ||
| Indien | ||
| Übriger asiatisch-pazifischer Raum | ||
| Naher Osten | Saudi-Arabien | |
| Vereinigte Arabische Emirate | ||
| Übriger Naher Osten | ||
| Afrika | Südafrika | |
| Nigeria | ||
| Übriges Afrika | ||
Im Bericht beantwortete Schlüsselfragen
Wie groß ist der Markt für verwaltete GPU-Infrastrukturdienste?
Die Marktgröße für verwaltete GPU-Infrastrukturdienste wird voraussichtlich von 3,47 Milliarden USD im Jahr 2026 auf 4,56 Milliarden USD im Jahr 2027 wachsen und soll bis 2032 bei einem CAGR von 25,52 % über 2027–2032 14,21 Milliarden USD erreichen.
Was treibt die Nachfrage nach verwalteten GPU-Infrastrukturdiensten an?
Generatives KI-Training im Produktionsmaßstab, persistente Inferenz, agentische Arbeitslasten und der Wechsel von eigener Hardware zu vertraglich vereinbarter Kapazität sind wichtige Nachfragefaktoren.
Welcher verwaltete GPU-Dienst expandiert am schnellsten?
Verwaltete Inferenz- und Modell-Serving-Operationen werden bis 2032 voraussichtlich mit einem CAGR von 26,81 % wachsen, da Kunden mehr KI-Systeme im Produktionsbetrieb einsetzen.
Welches Bereitstellungsmodell führt bei verwalteten GPU-Diensten?
Cloudbasierte Bereitstellung hielt im Jahr 2026 einen Anteil von 68,58 % und wird bis 2032 voraussichtlich mit einem CAGR von 27,33 % wachsen.
Welcher Endnutzersektor weist die höchste prognostizierte Expansion auf?
Das Gesundheitswesen und die Biowissenschaften werden bis 2032 voraussichtlich mit einem CAGR von 28,27 % wachsen, unterstützt durch Wirkstoffforschung, Genomik und die Entwicklung biomedizinischer Modelle.
Welche Region weist die schnellste prognostizierte Expansion auf?
Der asiatisch-pazifische Raum wird bis 2032 voraussichtlich mit einem CAGR von 27,91 % wachsen, unterstützt durch souveräne Rechenprogramme und regionale Kapazitätsinvestitionen.