
Tamanho e Participação do Mercado de Automação de Classificação de Dados
Visão Geral do Mercado
| Período de Estudo | 2020 - 2031 |
|---|---|
| Tamanho do Mercado (2026) | 1.41 Bilhões de dólares |
| Tamanho do Mercado (2031) | 4.27 Bilhões de dólares |
| Taxa de crescimento (2026 - 2031) | 24.81 % |
| Mercado de Crescimento Mais Rápido | Ásia-Pacífico |
| Maior Mercado | América do Norte |
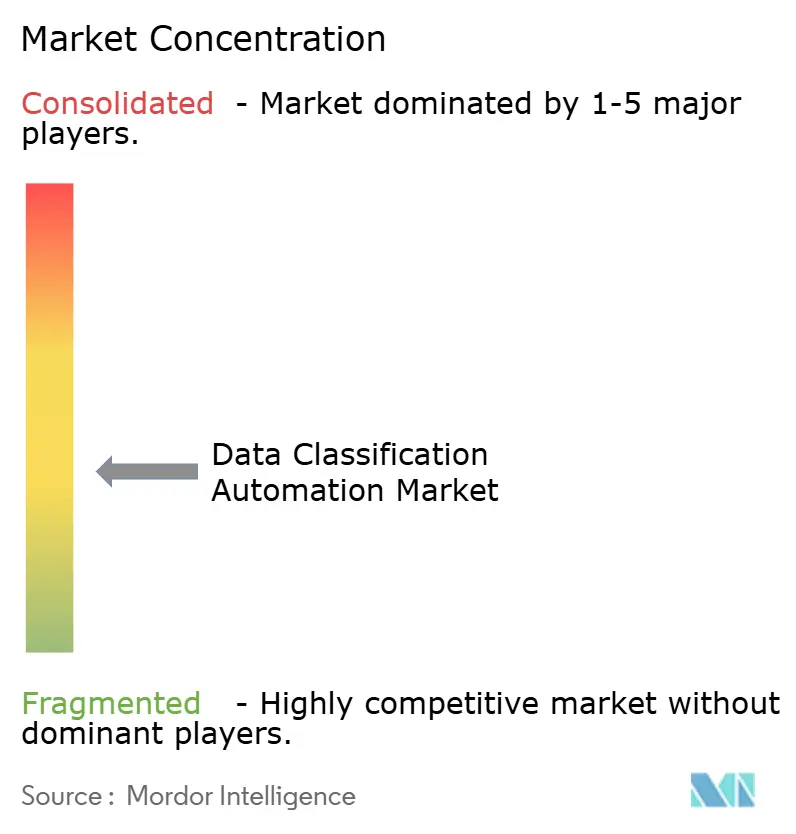
| Concentração do Mercado | Médio |
Principais jogadores *Isenção de responsabilidade: Principais participantes classificados em nenhuma ordem específica Imagem © Mordor Intelligence. O reuso requer atribuição conforme CC BY 4.0. | |
Análise do Mercado de Automação de Classificação de Dados por Mordor Intelligence
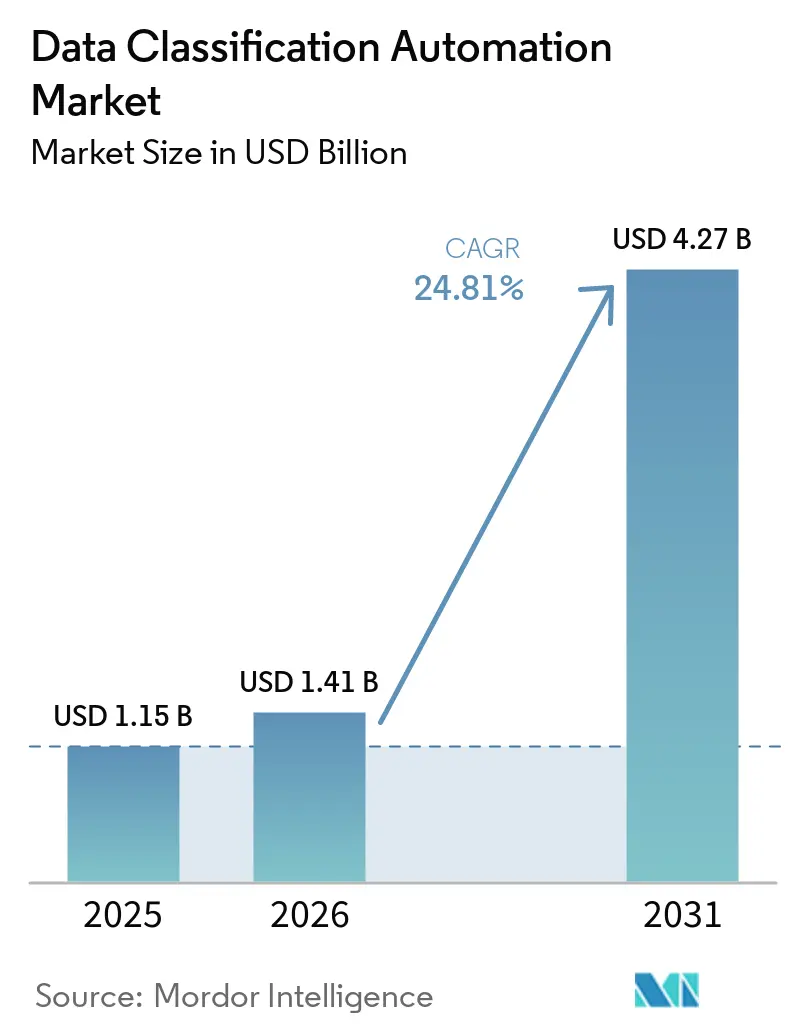
O tamanho do mercado de automação de classificação de dados está projetado para expandir de 1,15 bilhões de USD em 2025 e 1,41 bilhões de USD em 2026 para 4,27 bilhões de USD até 2031, registrando um CAGR de 24,81% entre 2026 e 2031. A aplicação integral dos requisitos do Regulamento de IA da UE para sistemas de alto risco, a partir de 2 de agosto de 2026, torna os dados de treinamento documentados um requisito para a implantação de IA em conformidade. Isso coloca a classificação de dados ao lado dos controles de privacidade como parte central da governança de IA empresarial. As empresas também estão lidando com volumes muito maiores de conteúdo não estruturado, o que torna a revisão manual de documentos, e-mails, imagens, arquivos de colaboração e vídeos difícil. A adoção de nuvem híbrida e as regras de nuvem soberana estão deslocando a classificação de repositórios isolados para pipelines de políticas que rastreiam dados em diferentes ambientes. Os fornecedores estão respondendo por meio de plataformas integradas que combinam classificação com prevenção de perda de dados, gestão de postura de segurança de dados, governança de IA e controles de acesso.
Principais Conclusões do Relatório
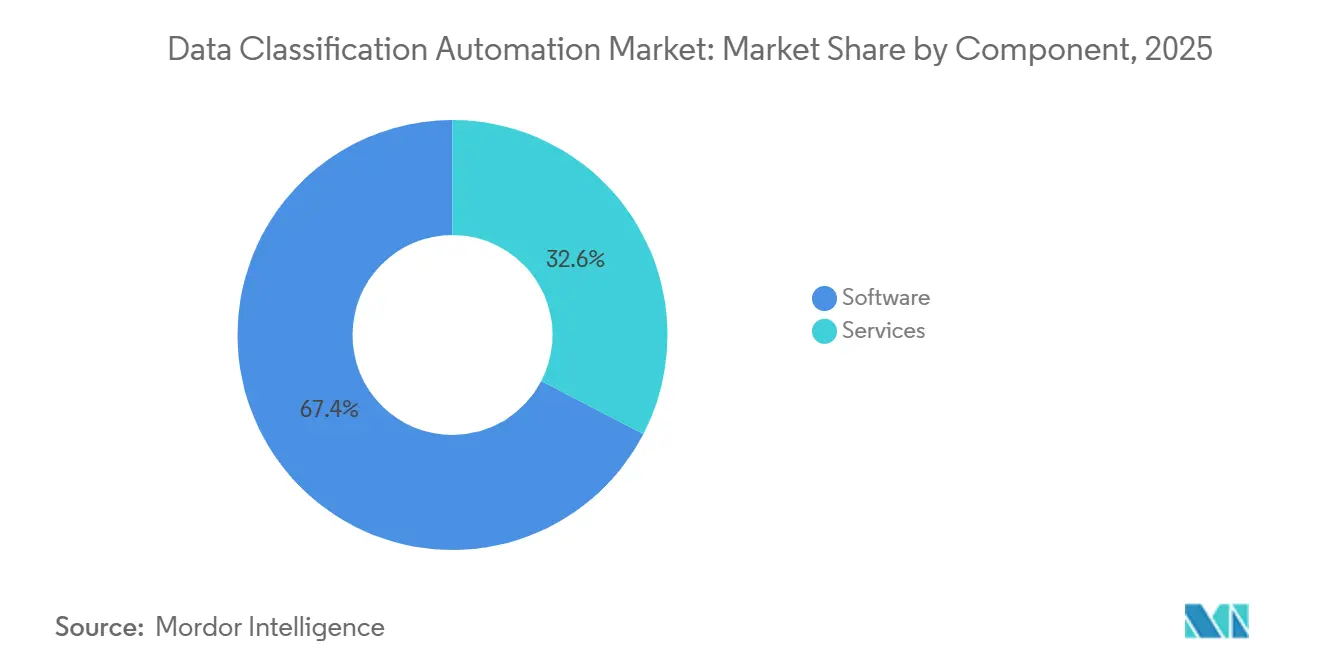
- Por componente, o software representou 67,39% da receita no mercado de automação de classificação de dados em 2025, enquanto os serviços estão projetados para expandir a um CAGR de 27,62% até 2031.
- Por modo de implantação, as implantações baseadas em nuvem representaram 57,83% da receita em 2025 e estão projetadas para crescer a um CAGR de 26,28% até 2031.
- Por tamanho de organização, as grandes empresas detinham 69,74% de participação de receita em 2025, enquanto as pequenas e médias empresas estão projetadas para expandir a um CAGR de 28,51% até 2031.
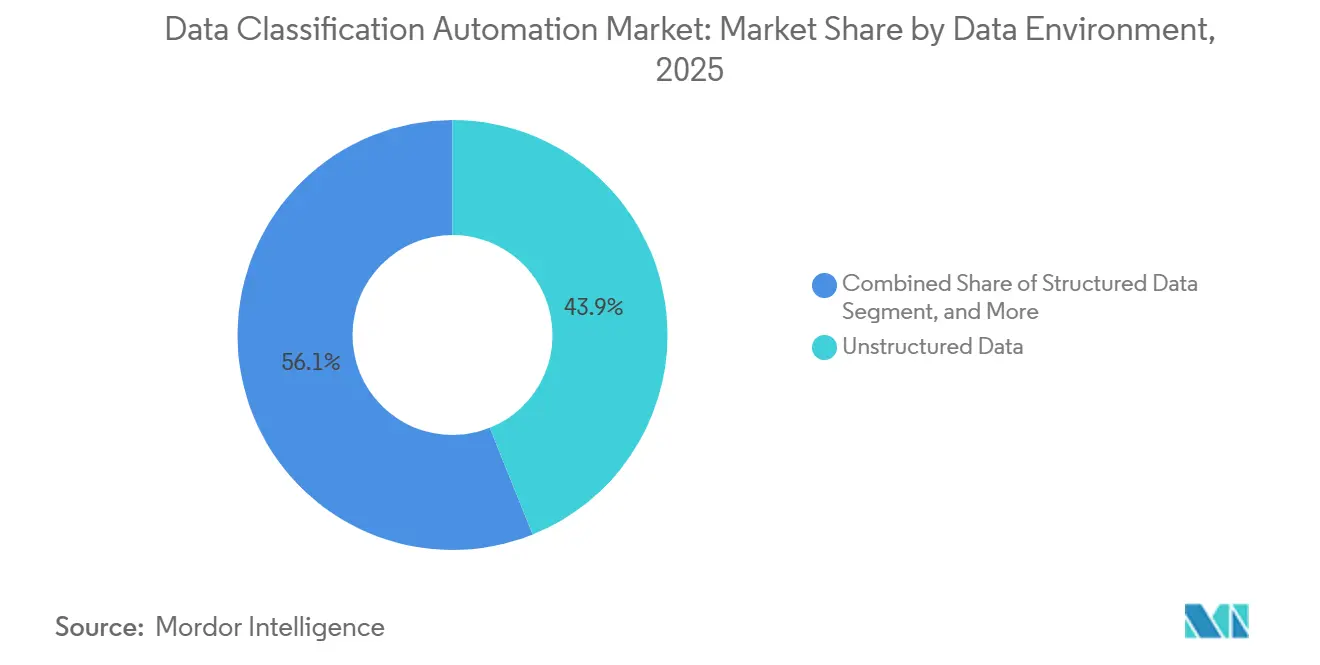
- Por ambiente de dados, os dados não estruturados detinham 43,91% da participação do mercado de automação de classificação de dados em 2025, enquanto os dados estruturados estão projetados para expandir a um CAGR de 26,32% até 2031.
- Por vertical do setor, serviços bancários, financeiros e de seguros detinham 27,68% de participação de receita em 2025, enquanto governo e administração pública estão projetados para expandir a um CAGR de 27,26% até 2031.
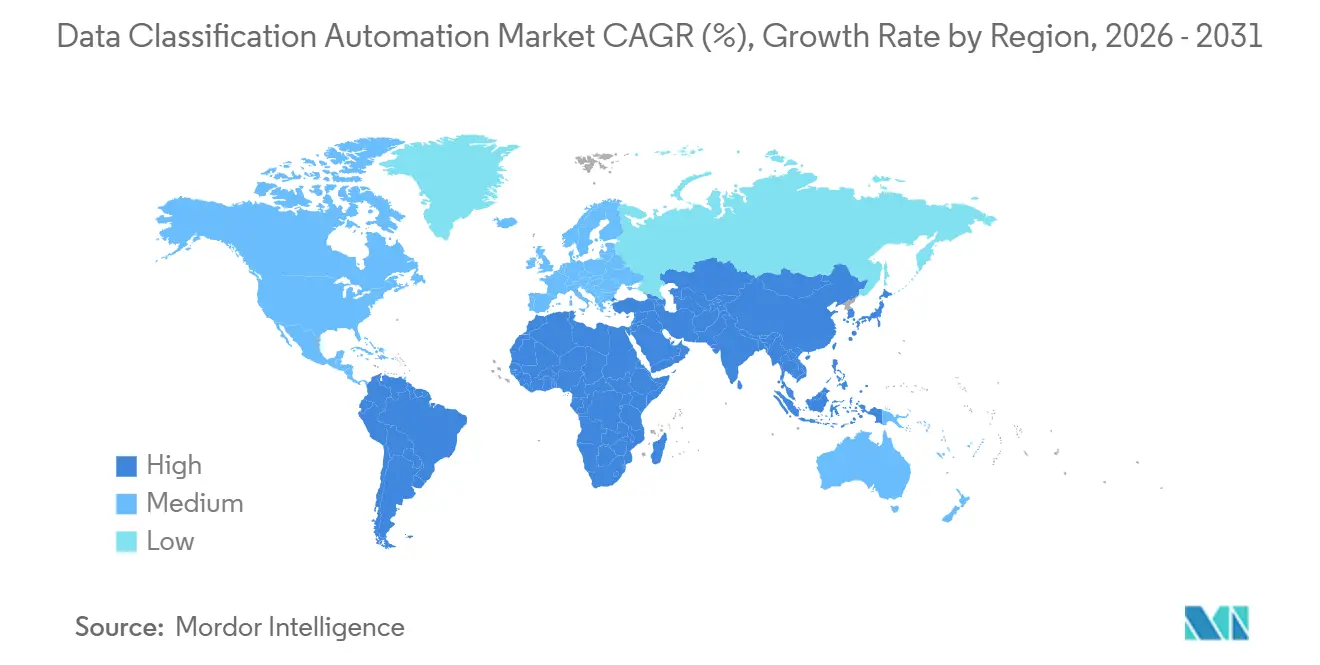
- Por geografia, a América do Norte detinha 42,39% de participação de receita no mercado de automação de classificação de dados em 2025, enquanto a Ásia-Pacífico está projetada para expandir a um CAGR de 28,66% até 2031.
Nota: O tamanho do mercado e os números de previsão neste relatório são gerados usando a estrutura de estimativa proprietária da Mordor Intelligence, atualizada com os dados e percepções mais recentes disponíveis em janeiro de 2026.
Tendências e Perspectivas do Mercado Global de Automação de Classificação de Dados
Análise de Impacto dos Impulsionadores*
| IMPULSIONADOR | (~) % DE IMPACTO NA PREVISÃO DE CAGR | RELEVÂNCIA GEOGRÁFICA | PRAZO DE IMPACTO |
|---|---|---|---|
| Requisitos de Governança de Dados para IA Generativa e Agentes de IA | +6.1% | Global, mais agudo na América do Norte e na UE | Curto prazo (≤ 2 anos) |
| Expansão das Regulamentações de Privacidade e Segurança de Dados | +5.4% | Global, com impacto inicial concentrado na UE, núcleo da Ásia-Pacífico, com extensão ao Oriente Médio e África | Médio prazo (2-4 anos) |
| Crescimento dos Volumes de Dados Não Estruturados e Sensíveis | +4.8% | Global | Longo prazo (≥ 4 anos) |
| Expansão de Ambientes Híbridos, Multinuvem e de Software como Serviço | +4.2% | Global, mais pronunciado na América do Norte e na Ásia-Pacífico | Médio prazo (2-4 anos) |
| Classificação Contínua para Dados de Streaming, IoT e Gerados por Máquinas | +1.8% | Núcleo da Ásia-Pacífico, com extensão à América do Norte | Longo prazo (≥ 4 anos) |
| Pipelines de Geração Aumentada por Recuperação com Reconhecimento de Classificação | +1.5% | América do Norte e UE | Curto prazo (≤ 2 anos) |
| Fonte: Mordor Intelligence | |||
Requisitos de Governança de Dados para IA Generativa e Agentes de IA
O Regulamento de IA da UE exige que os fornecedores de sistemas de alto risco documentem as origens dos dados, as etapas de preparação e o exame de viés para conjuntos de dados de treinamento, validação e teste a partir de 2 de agosto de 2026. Esse requisito cria um mandato de classificação de dados que se situa ao lado das obrigações estabelecidas de relatórios de privacidade. As empresas, portanto, precisam de uma estrutura de classificação para informações pessoais e sensíveis e outra para a documentação de modelos de IA. O Microsoft Purview e o Amazon SageMaker Catalog mostram como os fornecedores estão adicionando classificação automatizada aos fluxos de trabalho de gestão de dados de IA. O Amazon SageMaker Catalog pode analisar metadados de tabelas com modelos de linguagem do Amazon Bedrock e aplicar glossários de negócios e tags de informações de identificação pessoal. A IA agêntica aumenta a necessidade de classificação no ponto em que os dados são acessados ou alterados, e não apenas onde são armazenados.
Expansão das Regulamentações de Privacidade e Segurança de Dados
As regras de privacidade e segurança de dados agora afetam um conjunto mais amplo de jurisdições, trazendo a classificação automatizada para mercados que anteriormente investiam menos nessas ferramentas. A China emitiu uma estrutura de classificação de dados financeiros em quatro níveis em 24 de janeiro de 2026, abrangendo dados essenciais, dados importantes, dados gerais sensíveis e dados gerais. As instituições financeiras devem manter inventários auditáveis e enviar catálogos de dados importantes aos reguladores sob essa estrutura. O Banco de Reserva da Índia propôs uma estrutura de governança de dados em 2026 que inclui a classificação de dados nos sistemas de gestão de risco das entidades reguladas. A aplicação do DORA a partir de janeiro de 2025, o NIS2 e o GDPR exigem que as organizações europeias atendam a expectativas sobrepostas de governança de dados. Os controles de rotulagem de informações ISO 27001 e ISO 27701:2025 também ajudam a padronizar as taxonomias de classificação em operações multinacionais.
Crescimento dos Volumes de Dados Não Estruturados e Sensíveis
Os arquivos não estruturados incluem documentos, e-mail, conteúdo de colaboração, imagens digitalizadas e vídeo, criando uma grande carga de descoberta e rotulagem para as empresas. A Cloud Security Alliance relatou que o conteúdo não estruturado representava 33% do volume de dados empresariais e mais da metade do crescimento anual de dados para quase 1 em cada 3 empresas pesquisadas.[1] A mesma pesquisa constatou que mais de 56% das organizações tinham apenas visibilidade parcial sobre onde seus dados residiam. A Komprise relatou que 56% das empresas identificaram a classificação de dados como o principal desafio ao preparar dados para IA em 2026, acima dos 41% em 2024. O NIST SP 1800-39, publicado em fevereiro de 2026, fornece métodos para descobrir, identificar e rotular dados não estruturados para suportar a Arquitetura de Confiança Zero e a prontidão para criptografia quântica segura. As saídas internas de IA também podem reproduzir informações proprietárias ou regulamentadas, portanto, as organizações precisam classificar as saídas dos modelos, bem como as entradas.
Expansão de Ambientes Híbridos, Multinuvem e de Software como Serviço
Os ambientes híbridos e multinuvem enfraquecem o valor dos controles que dependem apenas de um perímetro de rede tradicional. A classificação permite que as políticas sejam aplicadas aos dados em diferentes plataformas de nuvem e serviços de software. A AvePoint afirmou que a classificação transforma políticas gerais de acesso em controles aplicáveis para casos de uso de IA.[2] As regras de nuvem soberana podem acelerar as implantações de classificação em nuvem, ao mesmo tempo que exigem que os mesmos controles operem de forma independente em múltiplos ambientes nacionais. Um estudo publicado em periódico em 2024 descreveu a gestão automatizada de metadados e o monitoramento em tempo real em um banco de investimento global que suportava obrigações de GDPR e CCPA em um ambiente de nuvem híbrida. Os requisitos ISO 27001, CMMC 2.0 e SOC 2 também apoiam o investimento em controles de classificação documentados durante os ciclos de certificação e renovação.
Análise de Impacto das Restrições*
| RESTRIÇÃO | (~) % DE IMPACTO NA PREVISÃO DE CAGR | RELEVÂNCIA GEOGRÁFICA | PRAZO DE IMPACTO |
|---|---|---|---|
| Altos Custos de Integração e Implementação | -3.2% | Global, mais agudo entre empresas de médio porte na América do Norte e na UE | Médio prazo (2-4 anos) |
| Escassez de Especialistas em Governança de Dados e Classificação | -2.6% | Global, mais grave na UE, América do Norte e Ásia-Pacífico emergente | Longo prazo (≥ 4 anos) |
| Desvio de Taxonomia em Unidades de Negócios Federadas | -1.4% | Global, concentrado em grandes empresas com estruturas descentralizadas | Médio prazo (2-4 anos) |
| Riscos de Explicabilidade e Falsos Positivos na Classificação Baseada em Modelos de Linguagem de Grande Escala | -1.1% | Global | Curto prazo (≤ 2 anos) |
| Fonte: Mordor Intelligence | |||
Altos Custos de Integração e Implementação
As implantações de automação de classificação de dados exigem trabalho além do licenciamento de software, pois devem se conectar com fluxos de trabalho de prevenção de perda de dados, gestão de identidade e acesso, criptografia e gestão de informações e eventos de segurança. As implementações em grandes empresas normalmente levaram de 18 a 24 meses de trabalho de engenharia sustentado. Esse ônus é mais agudo para empresas de médio porte, onde a equipe de governança de dados frequentemente também gerencia operações de segurança. A pesquisa da Trilha Industrial da ACL de 2026 constatou que os sistemas de classificação empresarial requerem calibração contínua à medida que as taxonomias institucionais evoluem.[3] O mesmo trabalho identificou a estabilidade das explicações como um critério importante de implantação, pois os modelos devem justificar consistentemente rótulos semelhantes sob pequenas alterações de entrada. As plataformas de Software como Serviço com conectores pré-construídos podem reduzir o trabalho de integração, mas o design da taxonomia e o ajuste de políticas ainda exigirão atenção contínua.
Escassez de Especialistas em Governança de Dados e Classificação
A escassez de especialistas em classificação limita a rapidez com que as organizações podem implementar e manter programas de governança. O LinkedIn relatou um crescimento de 150% ano a ano na demanda por habilidades de governança de IA em 2026. A Axipro identificou 3.004 funções de desenvolvedor de IA para cada 446 funções de governança em sua pesquisa de contratação europeia, o que mostra o desequilíbrio entre o desenvolvimento de modelos e a capacidade de governança. O ManpowerGroup pesquisou 39.000 empregadores e constatou que as funções de governança de IA eram as mais difíceis de preencher globalmente em 2026. Essa escassez também pode fortalecer a demanda por automação, pois as organizações usam ferramentas para suprir lacunas de pessoal. Os fornecedores que oferecem assistentes de taxonomia, modelos regulatórios e editores de políticas de baixo código podem reduzir a dependência de recursos especializados escassos.
*Nossas previsões tratam os impactos dos impulsionadores e restrições como direcionais, e não aditivos. As previsões de impacto refletem o crescimento de base, os efeitos de composição e as interações entre variáveis.
Análise de Segmentos
Por Componente: O Software Ancora a Pilha de Governança
O software detinha 67,39% da participação do Mercado de Automação de Classificação de Dados em 2025, pois os mecanismos de varredura, as regras e os rótulos de sensibilidade formam a camada operacional para decisões automatizadas. Essas capacidades devem estar em vigor antes que a criptografia, a prevenção de perda de dados ou a revogação de acesso possam operar com base em uma classificação consistente. Varonis, Cyera e Sentra combinam correspondência de padrões determinística com modelos de IA específicos de domínio para melhorar a qualidade da classificação. A Varonis recebeu a Patente Americana 12664203 em junho de 2026 por um método de aprendizado de máquina por incorporação que classifica itens de dados e aplica políticas de gestão. A camada de software permanece central porque processa os sinais de dados que os controles de aplicação downstream utilizam.
Os serviços estão projetados para expandir a um CAGR de 27,62% até 2031, tornando-os o componente de crescimento mais rápido. As organizações precisam de suporte para reconciliar rótulos entre unidades de negócios, mapear regulamentações para elementos de dados e validar a precisão por meio de ciclos de auditoria. Os serviços gerenciados de classificação podem monitorar e corrigir lacunas de classificação para clientes sem equipes de governança dedicadas. O Mercado de Automação de Classificação de Dados, portanto, provavelmente continuará a ter uma necessidade significativa de serviços, mesmo à medida que o software se torna mais fácil de implantar. Commvault e Forcepoint mostram como as ofertas gerenciadas estão combinando gestão de postura de segurança de dados, prevenção de perda de dados e classificação pós-implantação.


Por Modo de Implantação: Implantações Baseadas em Nuvem Impulsionam a Governança Escalável
As implantações baseadas em nuvem detinham 57,83% de participação de receita em 2025, refletindo o crescente volume de dados sensíveis criados, processados e armazenados em ambientes nativos de nuvem. A varredura contínua pode identificar e classificar dados à medida que mudam, em vez de depender de revisões periódicas em lote. A Komprise constatou que os volumes de dados estão crescendo mais rapidamente do que os processos de revisão manual e semiautomatizada conseguem acompanhar. Microsoft Purview, AWS Macie, SageMaker Catalog e Google Cloud DLP API conectam a classificação aos seus respectivos ambientes de nuvem. Isso torna a implantação em nuvem uma opção prática para patrimônios de dados distribuídos.
O tamanho do Mercado de Automação de Classificação de Dados baseado em nuvem está projetado para crescer a um CAGR de 26,28% até 2031. Os requisitos de nuvem soberana na França, Alemanha, Índia e Austrália estão direcionando as implantações em nuvem para infraestrutura nacional, em vez de regiões de nuvem pública global. OpenText e S3NS anunciaram uma parceria em abril de 2026 para gestão de conteúdo e classificação de dados em conformidade com SecNumCloud na França e na Europa. Os sistemas locais mantêm um papel relevante para contratantes de defesa, concessionárias e prestadores de serviços de saúde com requisitos de isolamento de rede. A implantação híbrida permanece necessária em organizações regulamentadas que não podem mover todos os dados para serviços de nuvem pública, mas ainda precisam de políticas consistentes em todos os locais.
Por Tamanho de Organização: Grandes Empresas Ancoram a Demanda, PMEs Aceleram
As grandes empresas detinham 69,74% de participação de receita em 2025, pois operam patrimônios multinuvem e enfrentam regulamentação em várias jurisdições. Seus conjuntos de dados podem abranger bancos de dados estruturados, repositórios não estruturados, plataformas de Software como Serviço e ferramentas de colaboração. Essa escala torna a classificação manual e semiautomatizada comercialmente impraticável. Um estudo de 2024 sobre um banco de investimento global constatou que a governança habilitada por IA e o monitoramento em tempo real poderiam suportar processos de conformidade com GDPR e CCPA.[4] Os requisitos ISO 27001 e PCI DSS 4.0 também apoiam a demanda por programas de classificação documentados e auditáveis entre grandes organizações.
As pequenas e médias empresas estão projetadas para crescer a um CAGR de 28,51% até 2031. As ferramentas entregues como Software como Serviço com modelos pré-construídos para GDPR, CCPA, HIPAA e requisitos específicos do setor reduziram as barreiras de adoção para esse grupo. O Regulamento de IA da UE e a Lei de Proteção de Dados Pessoais Digitais da Índia estendem as expectativas de classificação a organizações menores que desenvolvem ou implantam sistemas de IA. A integração de baixo código e os classificadores prontos são importantes onde as empresas não têm equipes de governança dedicadas. A Sentra introduziu um Classificador de IA para Dados Não Estruturados em novembro de 2025, usando modelos de linguagem pequenos específicos de domínio com suporte para mais de 70 idiomas.
Por Ambiente de Dados: Dados Não Estruturados Dominam, IA Remodela Prioridades
Os dados não estruturados detinham 43,91% da participação do Mercado de Automação de Classificação de Dados em 2025, pois texto, imagens e conteúdo baseado em arquivos são amplamente difundidos nos repositórios empresariais. A Cloud Security Alliance constatou que 56% das empresas tinham apenas visibilidade parcial sobre onde seus dados não estruturados residiam. Quase 30% dessas empresas identificaram os dados não estruturados como a fonte da maior parte do crescimento anual de dados. O NIST SP 1800-39 descreve a classificação de dados não estruturados como uma base para a Arquitetura de Confiança Zero e a prontidão para dados de treinamento de IA. A Forcepoint expandiu sua tecnologia de Classificação de Dados AI Mesh em outubro de 2025 para tratar dados estruturados e não estruturados por meio de uma única plataforma.
Os dados estruturados estão projetados para crescer a um CAGR de 26,32% até 2031, a maior taxa entre os ambientes de dados. As organizações que constroem pipelines de modelos de linguagem de grande escala e de geração aumentada por recuperação precisam identificar quais tabelas de banco de dados são permitidas para treinamento e inferência de modelos. O padrão GB/T 43697-2024 da China, em vigor desde outubro de 2024, estabelece regras de classificação e graduação para conjuntos de dados financeiros e operacionais estruturados.[5] Logs semiestruturados, arquivos XML e saídas JSON também precisam de rótulos automatizados à medida que as arquiteturas orientadas por API geram mais metadados relevantes para auditoria. Esses requisitos mantêm todos os 3 ambientes de dados relevantes para o Mercado de Automação de Classificação de Dados.

Por Vertical do Setor: BFSI Lidera Enquanto o Governo Ganha Ritmo
Os serviços bancários, financeiros e de seguros representaram 27,68% da receita em 2025, tornando-o o maior vertical no Mercado de Automação de Classificação de Dados. As instituições financeiras devem gerenciar DORA, GDPR, PCI DSS 4.0, SOX, GLBA e as regras de classificação de dados financeiros da China. A combinação requer registros auditáveis para atividades de processamento de dados em muitos sistemas. Um estudo da AAAI de 2025 constatou que os modelos de classificação específicos de domínio superaram as alternativas comerciais de uso geral nas medidas de recall para informações financeiras de identificação pessoal e dados de transações. Saúde e ciências da vida, tecnologia da informação e telecomunicações, e energia e serviços públicos formam um grupo secundário com seus próprios requisitos de conformidade e operacionais.
O setor de governo e administração pública está projetado para expandir a um CAGR de 27,26% até 2031. Os requisitos do Pilar de Dados de Confiança Zero do Departamento de Defesa dos Estados Unidos e as diretrizes de Informações Não Classificadas Controladas estabelecem a classificação de dados como uma linha de base de segurança federal. O NIST SP 1800-39 fornece uma referência de implementação que suporta esses requisitos. A estrutura proposta de governança de dados bancários da Índia também cria obrigações de classificação para bancos e empresas financeiras não bancárias. Educação e pesquisa, varejo e comércio eletrônico, transporte e logística, e petróleo e gás são verticais menores nos quais o uso de IA e a migração para a nuvem estão criando novas necessidades de classificação.
Análise Geográfica
A América do Norte detinha 42,39% da participação do Mercado de Automação de Classificação de Dados em 2025. A região tem adoção precoce de nuvem empresarial, requisitos maduros de segurança de dados e uma base instalada de sistemas de prevenção de perda de dados e identidade com os quais o software de classificação pode se integrar. Os Estados Unidos são o principal contribuinte, pois mandatos federais, leis estaduais de privacidade em 13 estados e regras financeiras criam necessidades de classificação sobrepostas. Canadá e México adicionam demanda por meio de suas estruturas de privacidade e maior adoção de nuvem em serviços financeiros e saúde. O NIST SP 1800-39, publicado em fevereiro de 2026, fornece uma arquitetura de referência governamental para agências federais e suas cadeias de suprimentos.
A Europa é o segundo maior bloco geográfico e tem alta densidade regulatória. O GDPR, o DORA, o NIS2 e o Regulamento de IA da UE exigem que as organizações em ambientes híbridos demonstrem cobertura de classificação de dados em múltiplas estruturas. Alemanha, França, Reino Unido e os países do BENELUX lideram a adoção por meio de seus setores de serviços financeiros, manufatura e saúde. Os requisitos SecNumCloud da França adicionam demanda por ferramentas em conformidade com a soberania. OpenText e S3NS anunciaram uma parceria em abril de 2026 para suportar gestão de conteúdo e classificação de dados em conformidade com SecNumCloud para implantações de nuvem soberana francesa e europeia. As expectativas de certificação ISO 27001 e BSI C5 também apoiam o investimento em classificação em toda a região.
A Ásia-Pacífico está projetada para crescer a um CAGR de 28,66% até 2031, a maior taxa regional. Índia, Japão, Coreia do Sul, Austrália e Singapura têm requisitos de localização de dados que tornam a classificação necessária antes que informações sensíveis possam ser movidas para infraestrutura de nuvem soberana. A China aplica PIPL, GB/T 43697-2024 e requisitos de classificação de dados financeiros que apoiam a demanda de classificação entre empresas domésticas. As regras operacionais de 2025 da Índia sob a Lei de Proteção de Dados Pessoais Digitais criaram um ciclo de aquisição entre entidades financeiras regulamentadas, exportadores de serviços de TI e organizações de saúde. A América do Sul está emergindo por meio da aplicação da LGPD do Brasil e da estrutura atualizada de proteção de dados da Argentina, com empresas financeiras de São Paulo formando uma área-chave de demanda. O Oriente Médio e a África permanecem a menor região por receita, mas as regras de privacidade da Arábia Saudita e dos Emirados Árabes Unidos estão criando requisitos especializados em centros financeiros, incluindo ADGM e DIFC.

Cenário Competitivo
O mercado de automação de classificação de dados é moderadamente fragmentado, com a concorrência transitando de uma estrutura liderada por especialistas para dois grupos distintos. Fornecedores amplos de cibersegurança e hiperescaladores oferecem classificação dentro de plataformas de segurança mais amplas, enquanto fornecedores especializados competem em precisão, transparência e velocidade de implementação. O grupo de plataformas amplas inclui Microsoft, IBM, Informatica e Commvault. O grupo especializado inclui Cyera, Varonis, BigID e Sentra. Esses grupos competem pelos mesmos orçamentos de governança de dados empresariais, embora utilizem modelos de entrega diferentes.
A Microsoft integra o Purview ao Microsoft 365 e ao Azure, enquanto a Salesforce incorporou as capacidades de catálogo de dados, governança, qualidade e privacidade da Informatica após sua aquisição em novembro de 2025. A Commvault expandiu suas capacidades de segurança de dados e IA em março de 2026 após adquirir a Satori, estendendo a descoberta automatizada, a classificação e a avaliação de riscos a dados estruturados e bancos de dados vetoriais. A Palo Alto Networks anunciou sua intenção de adquirir a Portkey em abril de 2026 para adicionar controle centralizado e governança de classificação para comunicações de agentes de IA autônomos ao Prisma AIRS. Forcepoint e F5 formaram uma aliança em março de 2026 que combina gestão de postura de segurança de dados nativa de IA e classificação com testes de segurança de IA e proteções. Esses movimentos mostram que os fornecedores estão conectando a classificação com segurança de IA, resiliência e governança de acesso.
Oportunidades permanecem em ofertas de Software como Serviço projetadas para pequenas e médias empresas, onde modelos regulatórios prontos podem reduzir o trabalho de implementação. A IA agêntica cria uma necessidade distinta de governança sobre dados que são acessados e transformados sem revisão humana. As ofertas compatíveis com nuvem soberana também são importantes na Alemanha, França, Índia e Austrália, onde as organizações devem usar infraestrutura nacional para dados sensíveis. Concentric AI, Seclore e Ground Labs atendem a requisitos mais específicos, incluindo gestão de direitos e classificação de dados financeiros na Ásia-Pacífico.
Líderes do Setor de Automação de Classificação de Dados
-
Microsoft Corporation
-
International Business Machines Corporation
-
Varonis Systems, Inc.
-
BigID, Inc.
-
Informatica Inc.
- *Isenção de responsabilidade: Principais participantes classificados em nenhuma ordem específica

Desenvolvimentos Recentes do Setor
- Setembro de 2026: A Palo Alto Networks concluiu a aquisição da Console, uma plataforma de segurança agêntica nativa de IA, integrando-a ao seu portfólio Cortex para habilitar investigação de alertas orientada por linguagem natural e fluxos de trabalho de remediação automatizada em ambientes de gestão de postura de segurança de dados.
- Junho de 2026: A Cyera captou 600 milhões de USD em uma rodada Série G com avaliação de 12 bilhões de USD, elevando o financiamento total para 2,3 bilhões de USD; a rodada foi liderada pela Evolution Equity Partners, com Cyberstarts e Temasek entre os novos investidores, e está destinada a escalar o mecanismo de classificação da empresa para segurança de IA empresarial em escala de exabytes.
- Abril de 2026: OpenText e S3NS (uma aliança Thales-Google Cloud) anunciaram uma parceria estratégica para fornecer gestão de conteúdo e classificação de dados em conformidade com SecNumCloud para ambientes de nuvem soberana francesa e europeia, suportando conformidade com GDPR e SecNum 3.2.
- Abril de 2026: A Palo Alto Networks anunciou sua intenção de adquirir a Portkey, uma plataforma de gateway de IA que processa trilhões de tokens por mês, para integrar controle centralizado e governança de classificação sobre comunicações de agentes de IA autônomos à sua plataforma Prisma AIRS.


Escopo do Relatório Global do Mercado de Automação de Classificação de Dados
O mercado de automação de classificação de dados abrange soluções baseadas em IA e aprendizado de máquina que descobrem, varrem e categorizam automaticamente dados sensíveis em fontes de dados estruturadas e não estruturadas sem intervenção manual. Este mercado concentra-se na identificação e rotulagem de tipos de dados como informações de identificação pessoal, dados de cartão de pagamento, informações de saúde protegidas, registros financeiros e propriedade intelectual, analisando padrões de conteúdo, contexto e metadados em escala em ambientes locais, de nuvem e híbridos. A automação elimina os gargalos de classificação manual ao monitorar continuamente os repositórios de dados, aplicar esquemas de classificação regulatórios e organizacionais, detectar a sensibilidade dos dados em tempo real e habilitar controles de segurança downstream como criptografia, restrições de acesso e políticas de prevenção de perda de dados com base em tags de classificação automatizadas para suportar os requisitos de conformidade com GDPR, CCPA, HIPAA e PCI-DSS.
O Relatório do Mercado de Automação de Classificação de Dados é Segmentado por Componente (Software e Serviços), Modo de Implantação (Baseado em Nuvem, Local e Híbrido), Tamanho da Organização (Grandes Empresas e Pequenas e Médias Empresas), Ambiente de Dados (Dados Estruturados, Dados Não Estruturados e Dados Semiestruturados), Vertical do Setor (Governo e Administração Pública, Manufatura Industrial, Varejo e Comércio Eletrônico, Transporte e Logística, Energia e Serviços Públicos, Petróleo e Gás, Tecnologia da Informação e Telecomunicações, Mídia e Entretenimento, Instituições de Educação e Pesquisa, Saúde e Ciências da Vida, Serviços Bancários, Financeiros e de Seguros (BFSI) e Outros Verticais do Setor) e Geografia (América do Norte, América do Sul, Europa, Ásia-Pacífico e Oriente Médio e África). As Previsões de Mercado são Fornecidas em Termos de Valor (USD).
| Software |
| Serviços |
| Baseado em Nuvem |
| Local |
| Híbrido |
| Grandes Empresas |
| Pequenas e Médias Empresas |
| Dados Estruturados |
| Dados Não Estruturados |
| Dados Semiestruturados |
| Governo e Administração Pública |
| Manufatura Industrial |
| Varejo e Comércio Eletrônico |
| Transporte e Logística |
| Energia e Serviços Públicos |
| Petróleo e Gás |
| Tecnologia da Informação e Telecomunicações |
| Mídia e Entretenimento |
| Instituições de Educação e Pesquisa |
| Saúde e Ciências da Vida |
| Serviços Bancários, Financeiros e de Seguros (BFSI) |
| Outros Verticais do Setor |
| América do Norte | Estados Unidos | |
| Canadá | ||
| América do Sul | Brasil | |
| Argentina | ||
| México | ||
| Restante da América do Sul | ||
| Europa | Alemanha | |
| Reino Unido | ||
| França | ||
| Itália | ||
| BENELUX | ||
| Restante da Europa | ||
| Ásia-Pacífico | China | |
| Japão | ||
| Índia | ||
| Coreia do Sul | ||
| Austrália | ||
| Restante da Ásia-Pacífico | ||
| Oriente Médio e África | Oriente Médio | Emirados Árabes Unidos |
| Arábia Saudita | ||
| Restante do Oriente Médio | ||
| África | África do Sul | |
| Nigéria | ||
| Egito | ||
| Restante da África | ||
| Por Componente | Software | ||
| Serviços | |||
| Por Modo de Implantação | Baseado em Nuvem | ||
| Local | |||
| Híbrido | |||
| Por Tamanho de Organização | Grandes Empresas | ||
| Pequenas e Médias Empresas | |||
| Por Ambiente de Dados | Dados Estruturados | ||
| Dados Não Estruturados | |||
| Dados Semiestruturados | |||
| Por Vertical do Setor | Governo e Administração Pública | ||
| Manufatura Industrial | |||
| Varejo e Comércio Eletrônico | |||
| Transporte e Logística | |||
| Energia e Serviços Públicos | |||
| Petróleo e Gás | |||
| Tecnologia da Informação e Telecomunicações | |||
| Mídia e Entretenimento | |||
| Instituições de Educação e Pesquisa | |||
| Saúde e Ciências da Vida | |||
| Serviços Bancários, Financeiros e de Seguros (BFSI) | |||
| Outros Verticais do Setor | |||
| Por Geografia | América do Norte | Estados Unidos | |
| Canadá | |||
| América do Sul | Brasil | ||
| Argentina | |||
| México | |||
| Restante da América do Sul | |||
| Europa | Alemanha | ||
| Reino Unido | |||
| França | |||
| Itália | |||
| BENELUX | |||
| Restante da Europa | |||
| Ásia-Pacífico | China | ||
| Japão | |||
| Índia | |||
| Coreia do Sul | |||
| Austrália | |||
| Restante da Ásia-Pacífico | |||
| Oriente Médio e África | Oriente Médio | Emirados Árabes Unidos | |
| Arábia Saudita | |||
| Restante do Oriente Médio | |||
| África | África do Sul | ||
| Nigéria | |||
| Egito | |||
| Restante da África | |||


Principais Perguntas Respondidas no Relatório
Qual é o tamanho do mercado de automação de classificação de dados?
O Mercado de Automação de Classificação de Dados foi avaliado em 1,15 bilhões de USD em 2025, está estimado em 1,41 bilhões de USD em 2026 e está projetado para atingir 4,27 bilhões de USD até 2031. Está projetado para registrar um CAGR de 24,81% durante 2026-2031. O crescimento reflete a necessidade das empresas de documentar os dados usados em sistemas de IA, fortalecer os controles de privacidade e aplicar políticas em ambientes de nuvem e Software como Serviço em expansão. A previsão também reflete mais dados sendo criados em repositórios não estruturados, bancos de dados estruturados e arquivos operacionais semiestruturados. A classificação está se tornando um controle operacional para governança de dados e implantação de IA, em vez de uma atividade de conformidade independente, particularmente onde as empresas devem demonstrar que os dados que suportam as decisões de IA foram identificados, rotulados e gerenciados sob políticas documentadas.
O que está impulsionando a demanda por classificação automatizada de dados?
As obrigações de governança de IA, a expansão das regras de privacidade, o crescimento de dados não estruturados e a adoção de nuvem híbrida estão apoiando a demanda. As empresas precisam identificar e rotular informações em documentos, bancos de dados, plataformas de colaboração, serviços de nuvem e fluxos de trabalho internos de IA. Os requisitos de registros auditáveis também tornam a classificação relevante para programas de conformidade, gestão de acesso, prevenção de perda de dados, criptografia e o uso seguro de modelos de IA. O conteúdo interno gerado por IA também pode conter informações regulamentadas ou proprietárias, o que estende a necessidade de classificação das entradas dos modelos para as saídas dos modelos. As necessidades regulatórias e operacionais estão, portanto, convergindo em torno dos mesmos controles de dados, o que torna importante usar rótulos consistentes em unidades de negócios, repositórios e os sistemas que aplicam políticas de acesso, proteção e retenção.
Qual componente lidera os gastos com automação de classificação de dados?
O software liderou com 67,39% de participação de receita em 2025, pois os mecanismos de varredura, as regras de classificação e os rótulos de sensibilidade suportam os controles downstream. Essas ferramentas fornecem a camada de classificação que permite a aplicação consistente de políticas por meio de criptografia, prevenção de perda de dados e revogação de acesso. Os serviços também estão crescendo à medida que as organizações precisam de ajuda com design de taxonomia, integrações, mapeamento regulatório, validação de classificação e preparação contínua de auditoria em patrimônios de dados federados. Os serviços gerenciados também podem ajudar as organizações a monitorar lacunas de classificação quando não conseguem contratar especialistas dedicados em governança. Esse trabalho permanece importante quando os rótulos de negócios locais devem se alinhar com os requisitos de política em toda a empresa, especialmente em organizações onde os dados são criados e gerenciados em vários departamentos, serviços de nuvem e jurisdições com diferentes obrigações de conformidade.
Qual modelo de implantação está se expandindo mais rapidamente?
As implantações baseadas em nuvem estão projetadas para crescer a um CAGR de 26,28% até 2031, pois suportam varredura contínua em ambientes distribuídos. Essa abordagem ajuda as equipes a classificar as informações à medida que são criadas e alteradas, em vez de apenas durante revisões programadas. Os requisitos de nuvem soberana também criam a necessidade de ferramentas que possam operar em infraestrutura nacional, enquanto os ambientes híbridos requerem políticas que abranjam tanto os serviços de nuvem pública quanto os repositórios locais. Os sistemas locais mantêm um papel em ambientes de defesa, serviços públicos e saúde onde as operações com isolamento de rede permanecem necessárias. O ambiente resultante requer cobertura de classificação consistente em vários modelos de implantação, para que as equipes de segurança e governança possam aplicar as mesmas regras de sensibilidade mesmo quando as informações permanecem em um repositório local ou se movem entre serviços de nuvem.
Qual tipo de organização está crescendo mais rapidamente?
As pequenas e médias empresas estão projetadas para crescer a um CAGR de 28,51% até 2031, à medida que as ferramentas de Software como Serviço reduzem as barreiras de adoção. Modelos pré-construídos, integração de baixo código e classificadores prontos ajudam as empresas a implantar controles sem grandes equipes técnicas. Esses recursos são importantes onde o pessoal de governança também gerencia operações de segurança, enquanto o Regulamento de IA da UE e as obrigações de proteção de dados criam requisitos de classificação para organizações que desenvolvem ou implantam sistemas de IA. As grandes empresas permanecem o maior grupo de clientes, pois seus patrimônios de dados multinuvem e requisitos multijurisdicionais tornam as abordagens manuais impraticáveis. Ambos os grupos precisam de controles que possam ser adaptados a tipos de dados e obrigações regulatórias em mudança, pois programas eficazes exigem que as políticas de classificação permaneçam alinhadas com taxonomias de negócios, arquiteturas de nuvem e casos de uso de IA em evolução.
Qual região está projetada para crescer mais rapidamente?
A Ásia-Pacífico está projetada para crescer a um CAGR de 28,66% até 2031, apoiada por regras de localização de dados e volumes crescentes de dados empresariais. Os padrões de classificação da China e as regras de classificação de dados financeiros, juntamente com mudanças regulatórias na Índia e em outras economias, apoiam a adoção. As organizações também precisam de classificação antes de mover informações sensíveis para plataformas de nuvem soberana, o que vincula conformidade regulatória, migração para a nuvem, uso de IA e infraestrutura de dados doméstica em toda a região. A América do Norte permaneceu o maior contribuinte regional em 2025, com 42,39% de participação de receita, apoiada pela adoção madura de nuvem e requisitos sobrepostos de segurança de dados. A Europa também tem demanda sustentada, pois as organizações devem atender aos requisitos de GDPR, DORA, NIS2 e Regulamento de IA da UE em conjunto, o que aumenta o valor das ferramentas que podem documentar a cobertura de classificação e suportar auditorias em requisitos regulatórios sobrepostos.


 Seus dados estão seguros e nunca são vendidos ou compartilhados.

