
Marktgröße und Marktanteil für Automatisierung der Datenklassifizierung
Marktübersicht
| Studienzeitraum | 2020 - 2031 |
|---|---|
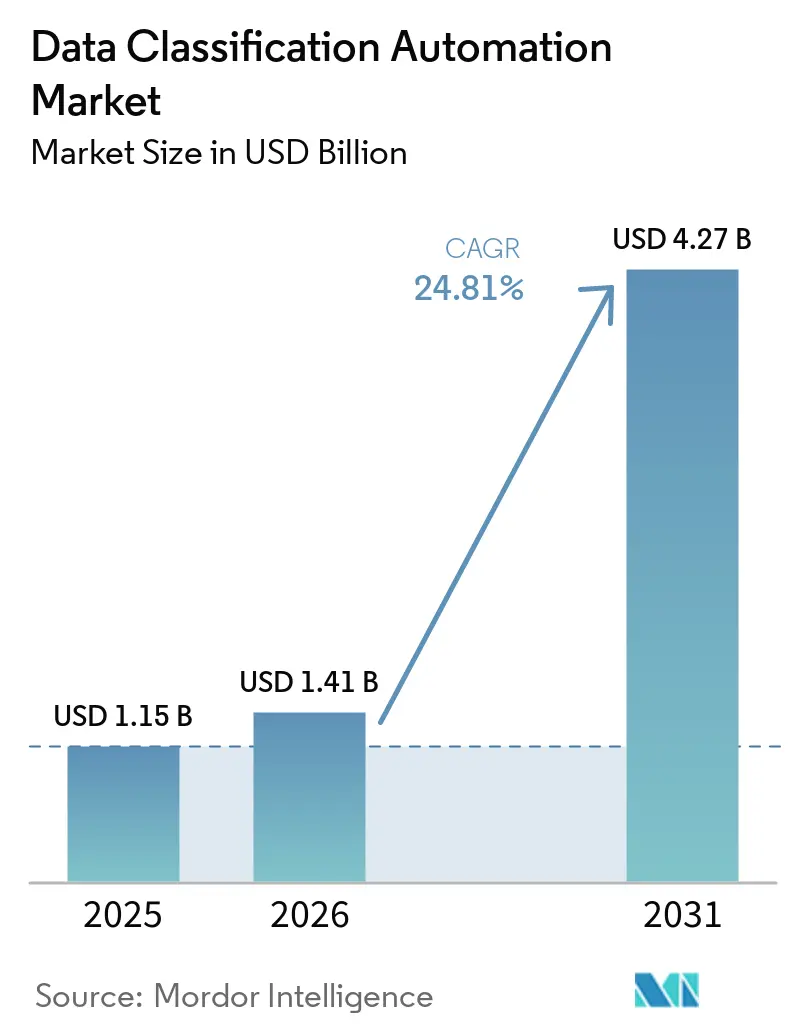
| Marktgröße (2026) | 1.41 Milliarden US-Dollar |
| Marktgröße (2031) | 4.27 Milliarden US-Dollar |
| Wachstumsrate (2026 - 2031) | 24.81 % |
| Schnellstwachsender Markt | Asien-Pazifik |
| Größter Markt | Nordamerika |
| Marktkonzentration | Mittel |
Hauptakteure *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert Bild © Mordor Intelligence. Wiederverwendung erfordert Namensnennung gemäß CC BY 4.0. | |
Marktanalyse für Automatisierung der Datenklassifizierung von Mordor Intelligence
Die Marktgröße für Automatisierung der Datenklassifizierung wird voraussichtlich von 1,15 Milliarden USD im Jahr 2025 und 1,41 Milliarden USD im Jahr 2026 auf 4,27 Milliarden USD bis 2031 anwachsen, mit einer CAGR von 24,81 % zwischen 2026 und 2031. Die vollständige Anwendung der Anforderungen des EU-KI-Gesetzes für Hochrisikosysteme ab dem 2. August 2026 macht dokumentierte Trainingsdaten zu einer Voraussetzung für eine konforme KI-Bereitstellung. Dies stellt die Datenklassifizierung neben Datenschutzkontrollen als zentralen Bestandteil der unternehmensweiten KI-Governance. Unternehmen verarbeiten zudem deutlich größere Mengen unstrukturierter Inhalte, was die manuelle Überprüfung von Dokumenten, E-Mails, Bildern, Kollaborationsdateien und Videos erschwert. Die Einführung hybrider Cloud-Lösungen und Regelungen zur Datensouveränität verlagern die Klassifizierung von isolierten Repositorys hin zu Richtlinien-Pipelines, die Daten umgebungsübergreifend verfolgen. Anbieter reagieren darauf mit integrierten Plattformen, die Klassifizierung mit Datenverlustprävention, Verwaltung der Datensicherheitslage, KI-Governance und Zugriffskontrollen kombinieren.
Wichtigste Erkenntnisse des Berichts
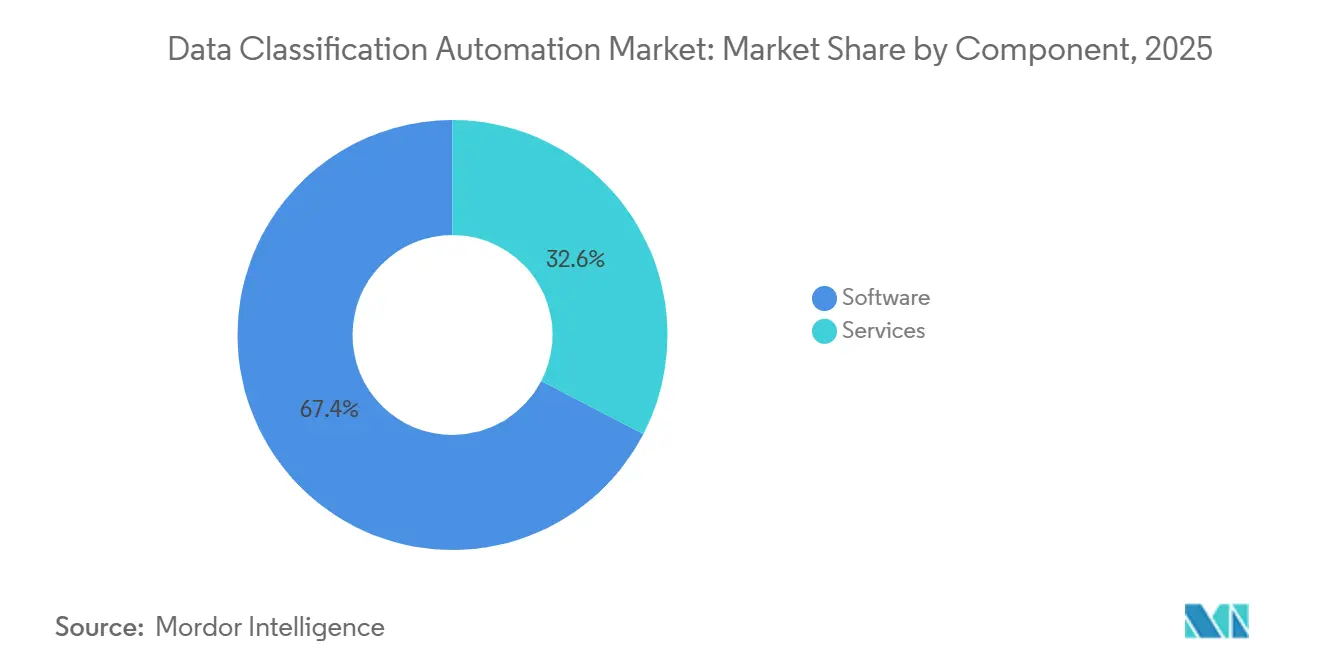
- Nach Komponente entfiel im Jahr 2025 ein Anteil von 67,39 % des Umsatzes im Markt für Automatisierung der Datenklassifizierung auf Software, während Dienstleistungen bis 2031 voraussichtlich mit einer CAGR von 27,62 % wachsen werden.
- Nach Bereitstellungsmodus entfielen im Jahr 2025 57,83 % des Umsatzes auf Cloud-basierte Bereitstellungen, die bis 2031 voraussichtlich mit einer CAGR von 26,28 % wachsen werden.
- Nach Unternehmensgröße hielten Großunternehmen im Jahr 2025 einen Umsatzanteil von 69,74 %, während kleine und mittlere Unternehmen bis 2031 voraussichtlich mit einer CAGR von 28,51 % wachsen werden.
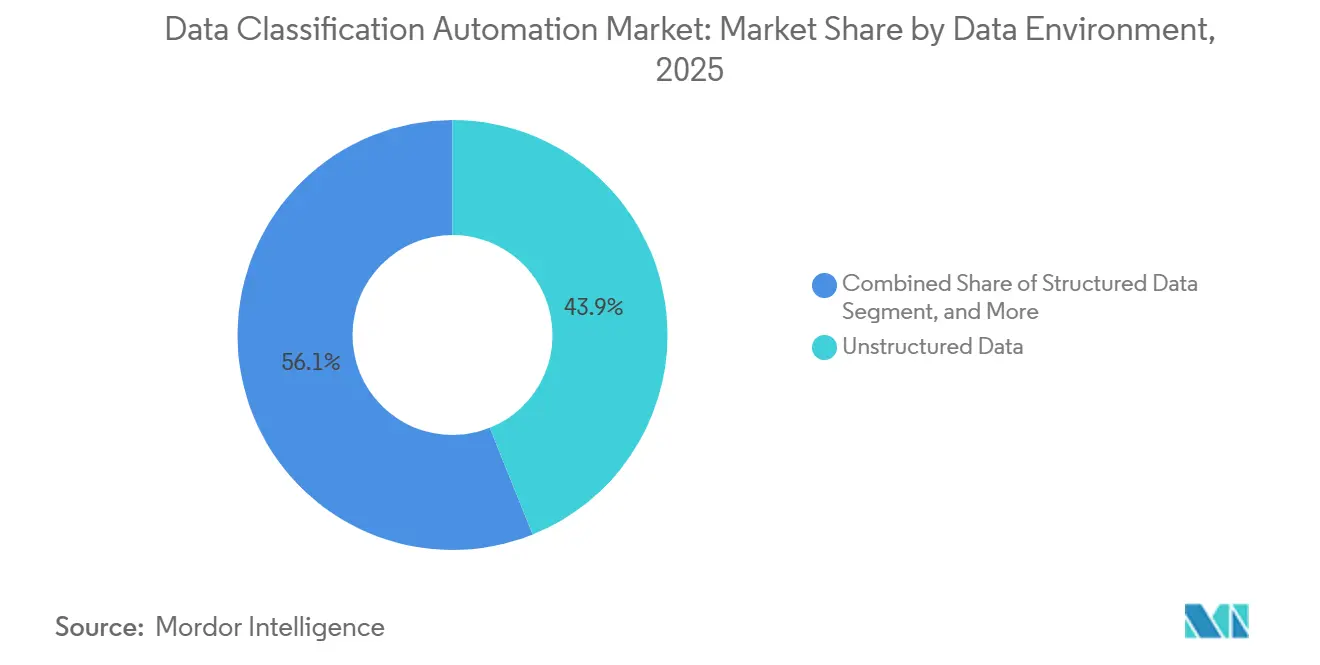
- Nach Datenumgebung hielten unstrukturierte Daten im Jahr 2025 einen Anteil von 43,91 % am Markt für Automatisierung der Datenklassifizierung, während strukturierte Daten bis 2031 voraussichtlich mit einer CAGR von 26,32 % wachsen werden.
- Nach Branchenvertikale hielten Banken, Finanzdienstleistungen und Versicherungen im Jahr 2025 einen Umsatzanteil von 27,68 %, während Regierung und öffentliche Verwaltung bis 2031 voraussichtlich mit einer CAGR von 27,26 % wachsen werden.
- Nach Geografie hielt Nordamerika im Jahr 2025 einen Umsatzanteil von 42,39 % im Markt für Automatisierung der Datenklassifizierung, während der asiatisch-pazifische Raum bis 2031 voraussichtlich mit einer CAGR von 28,66 % wachsen wird.
Hinweis: Die Marktgröße und Prognosezahlen in diesem Bericht werden mithilfe des proprietären Schätzungsrahmens von Mordor Intelligence erstellt und mit den neuesten verfügbaren Daten und Erkenntnissen vom Januar 2026 aktualisiert.
Globale Trends und Erkenntnisse im Markt für Automatisierung der Datenklassifizierung
Analyse der Treiberwirkung*
| TREIBER | (~) % AUSWIRKUNG AUF DIE CAGR-PROGNOSE | GEOGRAFISCHE RELEVANZ | ZEITHORIZONT DER AUSWIRKUNG |
|---|---|---|---|
| Anforderungen an die Datenverwaltung für generative KI und KI-Agenten | +6.1% | Global, am stärksten in Nordamerika und der EU | Kurzfristig (≤ 2 Jahre) |
| Ausweitung von Datenschutz- und Datensicherheitsvorschriften | +5.4% | Global, mit konzentrierter Frühwirkung in der EU, dem asiatisch-pazifischen Kernraum und Ausstrahlungseffekten auf den Nahen Osten und Afrika | Mittelfristig (2–4 Jahre) |
| Wachstum unstrukturierter und sensibler Datenvolumina | +4.8% | Global | Langfristig (≥ 4 Jahre) |
| Ausbreitung hybrider, Multi-Cloud- und SaaS-Umgebungen | +4.2% | Global, am stärksten in Nordamerika und dem asiatisch-pazifischen Raum | Mittelfristig (2–4 Jahre) |
| Kontinuierliche Klassifizierung für Streaming-, IoT- und maschinell generierte Daten | +1.8% | Asiatisch-pazifischer Kernraum mit Ausstrahlungseffekten auf Nordamerika | Langfristig (≥ 4 Jahre) |
| Klassifizierungsbewusste Pipelines für die retrieval-augmentierte Generierung | +1.5% | Nordamerika und EU | Kurzfristig (≤ 2 Jahre) |
| Quelle: Mordor Intelligence | |||
Anforderungen an die Datenverwaltung für generative KI und KI-Agenten
Das EU-KI-Gesetz verpflichtet Anbieter von Hochrisikosystemen ab dem 2. August 2026 zur Dokumentation von Datenherkunft, Aufbereitungsschritten und Bias-Prüfung für Trainings-, Validierungs- und Testdatensätze. Diese Anforderung schafft ein Datenklassifizierungsmandat, das neben bestehenden Datenschutz-Meldepflichten besteht. Unternehmen benötigen daher eine Klassifizierungsstruktur für personenbezogene und sensible Informationen sowie eine weitere für die Dokumentation von KI-Modellen. Microsoft Purview und Amazon SageMaker Catalog zeigen, wie Anbieter automatisierte Klassifizierung in KI-Datenverwaltungs-Workflows integrieren. Amazon SageMaker Catalog kann Tabellenmetadaten mit Amazon Bedrock-Sprachmodellen analysieren und Geschäftsglossar- sowie Tags für personenbezogene Informationen anwenden. Agentische KI erhöht den Bedarf an Klassifizierung an dem Punkt, an dem auf Daten zugegriffen oder diese verändert werden, und nicht nur dort, wo sie gespeichert sind.
Ausweitung von Datenschutz- und Datensicherheitsvorschriften
Datenschutz- und Datensicherheitsvorschriften betreffen nun eine breitere Gruppe von Rechtsordnungen und bringen die automatisierte Klassifizierung in Märkte, die bisher weniger in diese Werkzeuge investiert hatten. China veröffentlichte am 24. Januar 2026 einen vierstufigen Rahmen zur Einstufung von Finanzdaten, der Kerndaten, wichtige Daten, sensible allgemeine Daten und allgemeine Daten umfasst. Finanzinstitute müssen prüfbare Inventare führen und Kataloge wichtiger Daten im Rahmen dieses Regelwerks an die Aufsichtsbehörden übermitteln. Die Reserve Bank of India schlug 2026 einen Datenverwaltungsrahmen vor, der die Datenklassifizierung in die Risikomanagementsysteme regulierter Unternehmen einbezieht. Die DORA-Durchsetzung ab Januar 2025, NIS2 und die DSGVO verpflichten europäische Organisationen zur Erfüllung überlappender Datenverwaltungsanforderungen. Die Informationskennzeichnungskontrollen nach ISO 27001 und ISO 27701:2025 tragen ebenfalls zur Standardisierung von Klassifizierungstaxonomien in multinationalen Betrieben bei.
Wachstum unstrukturierter und sensibler Datenvolumina
Unstrukturierte Dateien umfassen Dokumente, E-Mails, Kollaborationsinhalte, gescannte Bilder und Videos und erzeugen eine erhebliche Erkennungs- und Kennzeichnungslast für Unternehmen. Die Cloud Security Alliance berichtete, dass unstrukturierte Inhalte 33 % des Unternehmensdatenvolumens ausmachten und bei fast 1 von 3 befragten Unternehmen mehr als die Hälfte des jährlichen Datenwachstums darstellten.[1] Dieselbe Studie ergab, dass mehr als 56 % der Organisationen nur eine teilweise Transparenz darüber hatten, wo ihre Daten gespeichert waren. Komprise berichtete, dass 56 % der Unternehmen die Datenklassifizierung im Jahr 2026 als größte Herausforderung bei der Vorbereitung von Daten für KI identifizierten, gegenüber 41 % im Jahr 2024. NIST SP 1800-39, veröffentlicht im Februar 2026, bietet Methoden zur Erkennung, Identifizierung und Kennzeichnung unstrukturierter Daten zur Unterstützung der Zero-Trust-Architektur und der Vorbereitung auf quantensichere Kryptografie. Interne KI-Ausgaben können auch proprietäre oder regulierte Informationen reproduzieren, sodass Organisationen sowohl Modelleingaben als auch -ausgaben klassifizieren müssen.
Ausbreitung hybrider, Multi-Cloud- und SaaS-Umgebungen
Hybride und Multi-Cloud-Umgebungen schwächen den Wert von Kontrollen, die ausschließlich auf einem traditionellen Netzwerkperimeter basieren. Die Klassifizierung ermöglicht es, Richtlinien auf Daten über verschiedene Cloud-Plattformen und Softwaredienste hinweg anzuwenden. AvePoint erklärte, dass die Klassifizierung allgemeine Zugriffsrichtlinien in durchsetzbare Kontrollen für KI-Anwendungsfälle umwandelt.[2] Regelungen zur Datensouveränität können Cloud-Klassifizierungsbereitstellungen beschleunigen und gleichzeitig erfordern, dass dieselben Kontrollen unabhängig in mehreren nationalen Umgebungen betrieben werden. Eine Journalstudie aus dem Jahr 2024 beschrieb automatisiertes Metadatenmanagement und Echtzeit-Monitoring bei einer globalen Investmentbank, das DSGVO- und CCPA-Verpflichtungen in einer hybriden Cloud-Umgebung unterstützte. ISO 27001-, CMMC 2.0- und SOC-2-Anforderungen unterstützen ebenfalls Investitionen in dokumentierte Klassifizierungskontrollen während Zertifizierungs- und Erneuerungszyklen.
Analyse der Hemmnisse*
| HEMMNIS | (~) % AUSWIRKUNG AUF DIE CAGR-PROGNOSE | GEOGRAFISCHE RELEVANZ | ZEITHORIZONT DER AUSWIRKUNG |
|---|---|---|---|
| Hohe Integrations- und Implementierungskosten | -3.2% | Global, am stärksten bei mittelständischen Unternehmen in Nordamerika und der EU | Mittelfristig (2–4 Jahre) |
| Mangel an Spezialisten für Datenverwaltung und Datenklassifizierung | -2.6% | Global, am stärksten in der EU, Nordamerika und dem aufstrebenden asiatisch-pazifischen Raum | Langfristig (≥ 4 Jahre) |
| Taxonomiedrift in föderativen Geschäftsbereichen | -1.4% | Global, konzentriert in Großunternehmen mit dezentralen Strukturen | Mittelfristig (2–4 Jahre) |
| Erklärbarkeits- und Falsch-Positiv-Risiken bei der LLM-basierten Klassifizierung | -1.1% | Global | Kurzfristig (≤ 2 Jahre) |
| Quelle: Mordor Intelligence | |||
Hohe Integrations- und Implementierungskosten
Bereitstellungen zur Automatisierung der Datenklassifizierung erfordern mehr als nur Softwarelizenzen, da sie mit Datenverlustprävention, Identitäts- und Zugriffsmanagement, Verschlüsselung sowie Workflows für Sicherheitsinformations- und Ereignismanagement verbunden werden müssen. Große Unternehmensimplementierungen erforderten typischerweise 18 bis 24 Monate kontinuierlicher Ingenieursarbeit. Diese Belastung ist für mittelständische Unternehmen besonders ausgeprägt, wo das Datenverwaltungspersonal häufig auch den Sicherheitsbetrieb verwaltet. Forschungsergebnisse aus dem ACL Industry Track 2026 ergaben, dass Unternehmensklassifizierungssysteme eine kontinuierliche Kalibrierung erfordern, da sich institutionelle Taxonomien weiterentwickeln.[3] Dieselbe Arbeit identifizierte die Stabilität von Erklärungen als wichtiges Bereitstellungskriterium, da Modelle ähnliche Kennzeichnungen bei geringfügigen Eingabeänderungen konsistent begründen sollten. SaaS-Plattformen mit vorgefertigten Konnektoren können den Integrationsaufwand reduzieren, aber Taxonomiedesign und Richtlinienoptimierung erfordern weiterhin kontinuierliche Aufmerksamkeit.
Mangel an Spezialisten für Datenverwaltung und Datenklassifizierung
Der Mangel an Klassifizierungsspezialisten begrenzt die Geschwindigkeit, mit der Organisationen Governance-Programme implementieren und aufrechterhalten können. LinkedIn berichtete im Jahr 2026 von einem Wachstum der Nachfrage nach KI-Governance-Fähigkeiten von 150 % im Jahresvergleich. Axipro identifizierte in seiner europäischen Einstellungsforschung 3.004 KI-Entwicklerrollen für je 446 Governance-Rollen, was das Ungleichgewicht zwischen Modellentwicklung und Governance-Kapazität verdeutlicht. ManpowerGroup befragte 39.000 Arbeitgeber und stellte fest, dass KI-Governance-Rollen im Jahr 2026 weltweit am schwierigsten zu besetzen waren. Dieser Mangel kann auch die Nachfrage nach Automatisierung stärken, da Organisationen Werkzeuge einsetzen, um Personalengpässe zu beheben. Anbieter, die Taxonomie-Assistenten, regulatorische Vorlagen und Low-Code-Richtlinieneditoren bereitstellen, können die Abhängigkeit von knappen Spezialistenressourcen verringern.
*Unsere Prognosen behandeln die Auswirkungen von Treibern und Einschränkungen als richtungsweisend und nicht additiv. Die Wirkungsprognosen berücksichtigen Basiswachstum, Mischungseffekte und Wechselwirkungen zwischen Variablen.
Segmentanalyse
Nach Komponente: Software verankert den Governance-Stack
Software hielt im Jahr 2025 einen Anteil von 67,39 % am Markt für Automatisierung der Datenklassifizierung, da Scan-Engines, Regeln und Sensitivitätskennzeichnungen die Betriebsschicht für automatisierte Entscheidungen bilden. Diese Fähigkeiten müssen vorhanden sein, bevor Verschlüsselung, Datenverlustprävention oder Zugangsentzug auf Basis einer konsistenten Klassifizierung betrieben werden können. Varonis, Cyera und Sentra kombinieren deterministischen Musterabgleich mit domänenspezifischen KI-Modellen, um die Klassifizierungsqualität zu verbessern. Varonis erhielt im Juni 2026 das US-Patent 12664203 für eine Einbettungs-Maschinenlernmethode, die Datenpunkte klassifiziert und Verwaltungsrichtlinien anwendet. Die Softwareschicht bleibt zentral, da sie die Datensignale verarbeitet, die nachgelagerte Durchsetzungskontrollen verwenden.
Dienstleistungen werden bis 2031 voraussichtlich mit einer CAGR von 27,62 % wachsen und sind damit die am schnellsten wachsende Komponente. Organisationen benötigen Unterstützung bei der Abstimmung von Kennzeichnungen über Geschäftsbereiche hinweg, der Zuordnung von Vorschriften zu Datenelementen und der Validierung der Genauigkeit durch Prüfzyklen. Verwaltete Klassifizierungsdienste können Klassifizierungslücken für Kunden ohne dedizierte Governance-Teams überwachen und beheben. Der Markt für Automatisierung der Datenklassifizierung wird daher voraussichtlich auch weiterhin einen erheblichen Bedarf an Dienstleistungen haben, selbst wenn Software einfacher bereitzustellen wird. Commvault und Forcepoint zeigen, wie verwaltete Angebote Verwaltung der Datensicherheitslage, Datenverlustprävention und Klassifizierung nach der Bereitstellung kombinieren.


Nach Bereitstellungsmodus: Cloud-basierte Bereitstellungen treiben skalierbare Governance voran
Cloud-basierte Bereitstellungen hielten im Jahr 2025 einen Umsatzanteil von 57,83 %, was das wachsende Volumen sensibler Daten widerspiegelt, die in Cloud-nativen Umgebungen erstellt, verarbeitet und gespeichert werden. Kontinuierliches Scannen kann Daten bei ihrer Änderung identifizieren und klassifizieren, anstatt sich auf periodische Stapelüberprüfungen zu verlassen. Komprise stellte fest, dass Datenvolumina schneller wachsen, als manuelle und halbautomatisierte Überprüfungsprozesse bewältigen können. Microsoft Purview, AWS Macie, SageMaker Catalog und die Google Cloud DLP API verbinden die Klassifizierung mit ihren jeweiligen Cloud-Umgebungen. Dies macht die Cloud-Bereitstellung zu einer praktischen Option für verteilte Datenbestände.
Die Marktgröße für Cloud-basierte Automatisierung der Datenklassifizierung wird bis 2031 voraussichtlich mit einer CAGR von 26,28 % wachsen. Anforderungen an souveräne Clouds in Frankreich, Deutschland, Indien und Australien lenken Cloud-Bereitstellungen auf nationale Infrastrukturen statt auf globale öffentliche Cloud-Regionen. OpenText und S3NS kündigten im April 2026 eine Partnerschaft für SecNumCloud-konformes Content-Management und Datenklassifizierung in Frankreich und Europa an. On-Premises-Systeme behalten eine relevante Rolle für Verteidigungsunternehmen, Versorgungsunternehmen und Gesundheitsdienstleister mit Air-Gap-Anforderungen. Hybride Bereitstellungen bleiben in regulierten Organisationen notwendig, die nicht alle Daten in öffentliche Cloud-Dienste verlagern können, aber dennoch konsistente Richtlinien über alle Standorte hinweg benötigen.
Nach Unternehmensgröße: Großunternehmen verankern die Nachfrage, KMU beschleunigen
Großunternehmen hielten im Jahr 2025 einen Umsatzanteil von 69,74 %, da sie Multi-Cloud-Bestände betreiben und in mehreren Rechtsordnungen reguliert werden. Ihre Datensätze können strukturierte Datenbanken, unstrukturierte Repositorys, SaaS-Plattformen und Kollaborationswerkzeuge umfassen. Dieser Umfang macht manuelle und halbautomatisierte Klassifizierung wirtschaftlich unpraktikabel. Eine Studie aus dem Jahr 2024 über eine globale Investmentbank ergab, dass KI-gestützte Governance und Echtzeit-Monitoring Compliance-Prozesse im Rahmen der DSGVO und des CCPA unterstützen können.[4] ISO-27001- und PCI-DSS-4.0-Anforderungen unterstützen ebenfalls die Nachfrage nach dokumentierten und prüfbaren Klassifizierungsprogrammen bei Großunternehmen.
Kleine und mittlere Unternehmen werden bis 2031 voraussichtlich mit einer CAGR von 28,51 % wachsen. SaaS-basierte Werkzeuge mit vorgefertigten Vorlagen für DSGVO, CCPA, HIPAA und branchenspezifische Anforderungen haben die Adoptionshürden für diese Gruppe gesenkt. Das EU-KI-Gesetz und Indiens Gesetz zum Schutz digitaler personenbezogener Daten erweitern die Klassifizierungserwartungen auf kleinere Organisationen, die KI-Systeme entwickeln oder einsetzen. Low-Code-Onboarding und vorgefertigte Klassifikatoren sind wichtig, wenn Unternehmen keine dedizierten Governance-Teams haben. Sentra führte im November 2025 einen KI-Klassifikator für unstrukturierte Daten ein, der domänenspezifische kleine Sprachmodelle mit Unterstützung für mehr als 70 Sprachen verwendet.
Nach Datenumgebung: Unstrukturierte Daten dominieren, KI gestaltet Prioritäten neu
Unstrukturierte Daten hielten im Jahr 2025 einen Anteil von 43,91 % am Markt für Automatisierung der Datenklassifizierung, da Text, Bilder und dateibasierte Inhalte in Unternehmensrepositorys weit verbreitet sind. Die Cloud Security Alliance stellte fest, dass 56 % der Unternehmen nur eine teilweise Transparenz darüber hatten, wo ihre unstrukturierten Daten gespeichert waren. Fast 30 % dieser Unternehmen identifizierten unstrukturierte Daten als Quelle des größten jährlichen Datenwachstums. NIST SP 1800-39 beschreibt die Klassifizierung unstrukturierter Daten als Grundlage für die Zero-Trust-Architektur und die Bereitschaft für KI-Trainingsdaten. Forcepoint erweiterte seine KI-Mesh-Datenklassifizierungstechnologie im Oktober 2025, um strukturierte und unstrukturierte Daten über eine Plattform zu adressieren.
Strukturierte Daten werden bis 2031 voraussichtlich mit einer CAGR von 26,32 % wachsen, der höchsten Rate unter den Datenumgebungen. Organisationen, die Pipelines für große Sprachmodelle und retrieval-augmentierte Generierung aufbauen, müssen identifizieren, welche Datenbanktabellen für Modelltraining und Inferenz zugelassen sind. Chinas Standard GB/T 43697-2024, der im Oktober 2024 in Kraft trat, legt Klassifizierungs- und Einstufungsregeln für strukturierte Finanz- und Betriebsdatensätze fest.[5] Halbstrukturierte Protokolle, XML-Dateien und JSON-Ausgaben benötigen ebenfalls automatisierte Kennzeichnungen, da API-gesteuerte Architekturen mehr prüfungsrelevante Metadaten erzeugen. Diese Anforderungen halten alle drei Datenumgebungen für den Markt für Automatisierung der Datenklassifizierung relevant.

Nach Branchenvertikale: BFSI führt, während der öffentliche Sektor aufholt
Banken, Finanzdienstleistungen und Versicherungen machten im Jahr 2025 27,68 % des Umsatzes aus und sind damit die größte Vertikale im Markt für Automatisierung der Datenklassifizierung. Finanzinstitute müssen DORA, DSGVO, PCI DSS 4.0, SOX, GLBA und Chinas Regeln zur Einstufung von Finanzdaten einhalten. Die Kombination erfordert prüfbare Aufzeichnungen für Datenverarbeitungsaktivitäten über viele Systeme hinweg. Eine AAAI-Studie aus dem Jahr 2025 ergab, dass domänenspezifische Klassifizierungsmodelle allgemeine kommerzielle Alternativen bei Recall-Maßen für personenbezogene Finanzinformationen und Transaktionsdaten übertrafen. Gesundheitswesen und Biowissenschaften, IT und Telekommunikation sowie Energie und Versorgung bilden eine sekundäre Gruppe mit eigenen Compliance- und Betriebsanforderungen.
Die Branchenvertikale Regierung und öffentliche Verwaltung wird bis 2031 voraussichtlich mit einer CAGR von 27,26 % wachsen. Die Anforderungen der Zero-Trust-Datensäule des US-Verteidigungsministeriums und die Leitlinien zu kontrollierten nicht klassifizierten Informationen etablieren die Datenklassifizierung als föderalen Sicherheitsstandard. NIST SP 1800-39 bietet eine Implementierungsreferenz, die diese Anforderungen unterstützt. Indiens vorgeschlagener Rahmen für die Datenverwaltung im Bankensektor schafft ebenfalls Klassifizierungspflichten für Banken und Nichtbanken-Finanzunternehmen. Bildung und Forschung, Einzel- und E-Commerce, Transport und Logistik sowie Öl und Gas sind kleinere Vertikalen, in denen KI-Nutzung und Cloud-Migration neue Klassifizierungsanforderungen schaffen.
Geografische Analyse
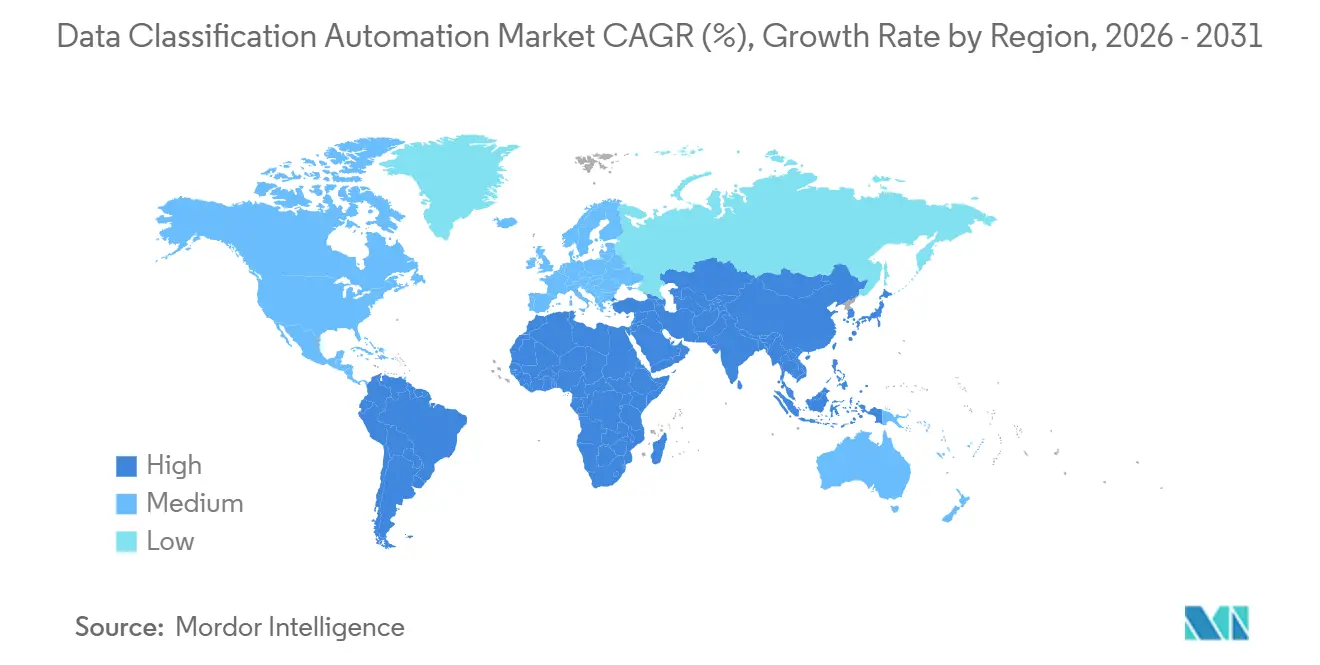
Nordamerika hielt im Jahr 2025 einen Anteil von 42,39 % am Markt für Automatisierung der Datenklassifizierung. Die Region verfügt über eine frühe Unternehmens-Cloud-Adoption, ausgereifte Datensicherheitsanforderungen und eine installierte Basis von Datenverlustpräventions- und Identitätssystemen, mit denen Klassifizierungssoftware integriert werden kann. Die Vereinigten Staaten sind der Hauptbeitragszahler, da föderale Mandate, staatliche Datenschutzgesetze in 13 Bundesstaaten und Finanzvorschriften überlappende Klassifizierungsanforderungen schaffen. Kanada und Mexiko tragen durch ihre Datenschutzrahmen und die zunehmende Cloud-Adoption in Finanzdienstleistungen und Gesundheitswesen zur Nachfrage bei. NIST SP 1800-39, veröffentlicht im Februar 2026, bietet eine staatliche Referenzarchitektur für Bundesbehörden und ihre Lieferketten.
Europa ist der zweitgrößte geografische Block und weist eine hohe regulatorische Dichte auf. DSGVO, DORA, NIS2 und das EU-KI-Gesetz verpflichten Organisationen in hybriden Umgebungen, die Abdeckung der Datenklassifizierung über mehrere Rahmenwerke hinweg nachzuweisen. Deutschland, Frankreich, das Vereinigte Königreich und die BENELUX-Länder führen die Adoption durch ihre Finanzdienstleistungs-, Fertigungs- und Gesundheitssektoren an. Frankreichs SecNumCloud-Anforderungen schaffen zusätzliche Nachfrage nach souveränitätskonformen Werkzeugen. OpenText und S3NS kündigten im April 2026 eine Partnerschaft an, um SecNumCloud-konformes Content-Management und Datenklassifizierung für französische und europäische souveräne Cloud-Bereitstellungen zu unterstützen. ISO-27001- und BSI-C5-Zertifizierungserwartungen unterstützen ebenfalls Klassifizierungsinvestitionen in der gesamten Region.
Der asiatisch-pazifische Raum wird bis 2031 voraussichtlich mit einer CAGR von 28,66 % wachsen, der höchsten regionalen Rate. Indien, Japan, Südkorea, Australien und Singapur haben Datenlokalisierungsanforderungen, die eine Klassifizierung notwendig machen, bevor sensible Informationen auf souveräne Cloud-Infrastrukturen übertragen werden können. China wendet PIPL, GB/T 43697-2024 und Anforderungen zur Einstufung von Finanzdaten an, die die Klassifizierungsnachfrage bei inländischen Unternehmen unterstützen. Indiens Betriebsregeln aus dem Jahr 2025 im Rahmen des Gesetzes zum Schutz digitaler personenbezogener Daten haben einen Beschaffungszyklus bei regulierten Finanzunternehmen, IT-Dienstleistungsexporteuren und Gesundheitsorganisationen ausgelöst. Südamerika entwickelt sich durch die Durchsetzung von Brasiliens LGPD und Argentiniens aktualisiertem Datenschutzrahmen, wobei Finanzunternehmen in São Paulo ein wichtiges Nachfragegebiet bilden. Der Nahe Osten und Afrika bleibt die kleinste Region nach Umsatz, aber die Datenschutzvorschriften Saudi-Arabiens und der Vereinigten Arabischen Emirate schaffen spezialisierte Anforderungen in Finanzzentren wie ADGM und DIFC.

Wettbewerbslandschaft
Der Markt für Automatisierung der Datenklassifizierung ist mäßig fragmentiert, wobei der Wettbewerb von einer spezialisierten Struktur zu zwei unterschiedlichen Gruppen übergeht. Breite Cybersicherheitsanbieter und Hyperscaler bieten Klassifizierung innerhalb umfassenderer Sicherheitsplattformen an, während spezialisierte Anbieter bei Genauigkeit, Transparenz und Implementierungsgeschwindigkeit konkurrieren. Die breite Plattformgruppe umfasst Microsoft, IBM, Informatica und Commvault. Die spezialisierte Gruppe umfasst Cyera, Varonis, BigID und Sentra. Diese Gruppen konkurrieren um dieselben Unternehmens-Datenverwaltungsbudgets, obwohl sie unterschiedliche Bereitstellungsmodelle verwenden.
Microsoft integriert Purview in Microsoft 365 und Azure, während Salesforce nach der Übernahme von Informatica im November 2025 deren Datenkatalog-, Governance-, Qualitäts- und Datenschutzfähigkeiten einbezog. Commvault erweiterte seine Daten- und KI-Sicherheitsfähigkeiten im März 2026 nach der Übernahme von Satori und erweiterte die automatisierte Erkennung, Klassifizierung und Risikobewertung auf strukturierte Daten und Vektordatenbanken. Palo Alto Networks kündigte im April 2026 die Absicht an, Portkey zu übernehmen, um zentralisierte Kontrolle und Klassifizierungs-Governance für autonome KI-Agentenkommunikation zu Prisma AIRS hinzuzufügen. Forcepoint und F5 schlossen im März 2026 eine Allianz, die KI-native Verwaltung der Datensicherheitslage und Klassifizierung mit KI-Red-Teaming und Leitplanken kombiniert. Diese Schritte zeigen, dass Anbieter die Klassifizierung mit KI-Sicherheit, Resilienz und Zugriffs-Governance verbinden.
Chancen bestehen bei SaaS-Angeboten für kleine und mittlere Unternehmen, bei denen vorgefertigte regulatorische Vorlagen den Implementierungsaufwand reduzieren können. Agentische KI schafft einen spezifischen Bedarf an Governance über Daten, auf die ohne menschliche Überprüfung zugegriffen und die transformiert werden. Souveräne Cloud-kompatible Angebote sind auch in Deutschland, Frankreich, Indien und Australien wichtig, wo Organisationen nationale Infrastrukturen für sensible Daten nutzen müssen. Concentric AI, Seclore und Ground Labs adressieren engere Anforderungen, einschließlich Rechteverwaltung und Finanzdatenklassifizierung im asiatisch-pazifischen Raum.
Marktführer in der Branche für Automatisierung der Datenklassifizierung
-
Microsoft Corporation
-
International Business Machines Corporation
-
Varonis Systems, Inc.
-
BigID, Inc.
-
Informatica Inc.
- *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert

Aktuelle Branchenentwicklungen
- September 2026: Palo Alto Networks schloss die Übernahme von Console ab, einer KI-nativen agentischen Sicherheitsplattform, und integrierte sie in sein Cortex-Portfolio, um natürlichsprachgesteuerte Alarmuntersuchungen und automatisierte Behebungs-Workflows in Umgebungen zur Verwaltung der Datensicherheitslage zu ermöglichen.
- Juni 2026: Cyera sammelte 600 Millionen USD in einer Series-G-Runde bei einer Bewertung von 12 Milliarden USD ein, womit die Gesamtfinanzierung auf 2,3 Milliarden USD stieg; die Runde wurde von Evolution Equity Partners angeführt, mit Cyberstarts und Temasek unter den neuen Investoren, und ist für die Skalierung der Klassifizierungs-Engine des Unternehmens für unternehmensweite KI-Sicherheit im Exabyte-Maßstab vorgesehen.
- April 2026: OpenText und S3NS (eine Allianz von Thales und Google Cloud) kündigten eine strategische Partnerschaft an, um SecNumCloud-konformes Content-Management und Datenklassifizierung für französische und europäische souveräne Cloud-Umgebungen bereitzustellen und die Einhaltung von DSGVO und SecNum 3.2 zu unterstützen.
- April 2026: Palo Alto Networks kündigte die Absicht an, Portkey zu übernehmen, eine KI-Gateway-Plattform, die Billionen von Token pro Monat verarbeitet, um zentralisierte Kontrolle und Klassifizierungs-Governance über autonome KI-Agentenkommunikation in seine Prisma-AIRS-Plattform zu integrieren.


Globaler Berichtsumfang des Marktes für Automatisierung der Datenklassifizierung
Der Markt für Automatisierung der Datenklassifizierung umfasst KI- und ML-gestützte Lösungen, die sensible Daten über strukturierte und unstrukturierte Datenquellen hinweg automatisch erkennen, scannen und kategorisieren, ohne manuelle Eingriffe. Dieser Markt konzentriert sich auf die Identifizierung und Kennzeichnung von Datentypen wie personenbezogene Informationen, Zahlungskarteninformationen, geschützte Gesundheitsinformationen, Finanzdaten und geistiges Eigentum durch die Analyse von Inhaltsmustern, Kontext und Metadaten in großem Maßstab über On-Premises-, Cloud- und hybride Umgebungen hinweg. Die Automatisierung beseitigt manuelle Klassifizierungsengpässe durch kontinuierliche Überwachung von Datenrepositorys, Anwendung regulatorischer und organisatorischer Klassifizierungsschemata, Erkennung von Datensensitivität in Echtzeit und Aktivierung nachgelagerter Sicherheitskontrollen wie Verschlüsselung, Zugriffsbeschränkungen und Richtlinien zur Datenverlustprävention auf Basis automatisierter Klassifizierungstags zur Unterstützung der Compliance-Anforderungen von DSGVO, CCPA, HIPAA und PCI-DSS.
Der Bericht zum Markt für Automatisierung der Datenklassifizierung ist segmentiert nach Komponente (Software und Dienstleistungen), Bereitstellungsmodus (Cloud-basiert, On-Premises und Hybrid), Unternehmensgröße (Großunternehmen sowie kleine und mittlere Unternehmen), Datenumgebung (Strukturierte Daten, Unstrukturierte Daten und Halbstrukturierte Daten), Branchenvertikale (Regierung und öffentliche Verwaltung, Industrielle Fertigung, Einzel- und E-Commerce, Transport und Logistik, Energie und Versorgung, Öl und Gas, IT und Telekommunikation, Medien und Unterhaltung, Bildungs- und Forschungseinrichtungen, Gesundheitswesen und Biowissenschaften, Banken, Finanzdienstleistungen und Versicherungen (BFSI) sowie sonstige Branchenvertikalen) und Geografie (Nordamerika, Südamerika, Europa, asiatisch-pazifischer Raum sowie Naher Osten und Afrika). Die Marktprognosen werden in Wertangaben (USD) bereitgestellt.
| Software |
| Dienstleistungen |
| Cloud-basiert |
| On-Premises |
| Hybrid |
| Großunternehmen |
| Kleine und mittlere Unternehmen |
| Strukturierte Daten |
| Unstrukturierte Daten |
| Halbstrukturierte Daten |
| Regierung und öffentliche Verwaltung |
| Industrielle Fertigung |
| Einzel- und E-Commerce |
| Transport und Logistik |
| Energie und Versorgung |
| Öl und Gas |
| IT und Telekommunikation |
| Medien und Unterhaltung |
| Bildungs- und Forschungseinrichtungen |
| Gesundheitswesen und Biowissenschaften |
| Banken, Finanzdienstleistungen und Versicherungen (BFSI) |
| Sonstige Branchenvertikalen |
| Nordamerika | Vereinigte Staaten | |
| Kanada | ||
| Südamerika | Brasilien | |
| Argentinien | ||
| Mexiko | ||
| Übriges Südamerika | ||
| Europa | Deutschland | |
| Vereinigtes Königreich | ||
| Frankreich | ||
| Italien | ||
| BENELUX | ||
| Übriges Europa | ||
| Asiatisch-pazifischer Raum | China | |
| Japan | ||
| Indien | ||
| Südkorea | ||
| Australien | ||
| Übriger asiatisch-pazifischer Raum | ||
| Naher Osten und Afrika | Naher Osten | Vereinigte Arabische Emirate |
| Saudi-Arabien | ||
| Übriger Naher Osten | ||
| Afrika | Südafrika | |
| Nigeria | ||
| Ägypten | ||
| Übriges Afrika | ||
| Nach Komponente | Software | ||
| Dienstleistungen | |||
| Nach Bereitstellungsmodus | Cloud-basiert | ||
| On-Premises | |||
| Hybrid | |||
| Nach Unternehmensgröße | Großunternehmen | ||
| Kleine und mittlere Unternehmen | |||
| Nach Datenumgebung | Strukturierte Daten | ||
| Unstrukturierte Daten | |||
| Halbstrukturierte Daten | |||
| Nach Branchenvertikale | Regierung und öffentliche Verwaltung | ||
| Industrielle Fertigung | |||
| Einzel- und E-Commerce | |||
| Transport und Logistik | |||
| Energie und Versorgung | |||
| Öl und Gas | |||
| IT und Telekommunikation | |||
| Medien und Unterhaltung | |||
| Bildungs- und Forschungseinrichtungen | |||
| Gesundheitswesen und Biowissenschaften | |||
| Banken, Finanzdienstleistungen und Versicherungen (BFSI) | |||
| Sonstige Branchenvertikalen | |||
| Nach Geografie | Nordamerika | Vereinigte Staaten | |
| Kanada | |||
| Südamerika | Brasilien | ||
| Argentinien | |||
| Mexiko | |||
| Übriges Südamerika | |||
| Europa | Deutschland | ||
| Vereinigtes Königreich | |||
| Frankreich | |||
| Italien | |||
| BENELUX | |||
| Übriges Europa | |||
| Asiatisch-pazifischer Raum | China | ||
| Japan | |||
| Indien | |||
| Südkorea | |||
| Australien | |||
| Übriger asiatisch-pazifischer Raum | |||
| Naher Osten und Afrika | Naher Osten | Vereinigte Arabische Emirate | |
| Saudi-Arabien | |||
| Übriger Naher Osten | |||
| Afrika | Südafrika | ||
| Nigeria | |||
| Ägypten | |||
| Übriges Afrika | |||


Im Bericht beantwortete Schlüsselfragen
Wie groß ist der Markt für Automatisierung der Datenklassifizierung?
Der Markt für Automatisierung der Datenklassifizierung wurde im Jahr 2025 auf 1,15 Milliarden USD geschätzt, wird für 2026 auf 1,41 Milliarden USD geschätzt und soll bis 2031 einen Wert von 4,27 Milliarden USD erreichen. Es wird erwartet, dass er im Zeitraum 2026–2031 eine CAGR von 24,81 % verzeichnet. Das Wachstum spiegelt den Bedarf von Unternehmen wider, in KI-Systemen verwendete Daten zu dokumentieren, Datenschutzkontrollen zu stärken und Richtlinien über expandierende Cloud- und SaaS-Umgebungen hinweg anzuwenden. Die Prognose spiegelt auch wider, dass mehr Daten über unstrukturierte Repositorys, strukturierte Datenbanken und halbstrukturierte Betriebsdateien erstellt werden. Die Klassifizierung wird zu einer Betriebskontrolle für Datenverwaltung und KI-Bereitstellung statt einer eigenständigen Compliance-Aktivität, insbesondere dort, wo Unternehmen nachweisen müssen, dass die KI-Entscheidungen unterstützenden Daten unter dokumentierten Richtlinien identifiziert, gekennzeichnet und verwaltet wurden.
Was treibt die Nachfrage nach automatisierter Datenklassifizierung an?
KI-Governance-Verpflichtungen, ausgeweitete Datenschutzvorschriften, Wachstum unstrukturierter Daten und die Einführung hybrider Cloud-Lösungen unterstützen die Nachfrage. Unternehmen müssen Informationen über Dokumente, Datenbanken, Kollaborationsplattformen, Cloud-Dienste und interne KI-Workflows hinweg identifizieren und kennzeichnen. Anforderungen an prüfbare Aufzeichnungen machen die Klassifizierung auch für Compliance-Programme, Zugriffsmanagement, Datenverlustprävention, Verschlüsselung und die sichere Nutzung von KI-Modellen relevant. KI-generierte interne Inhalte können auch regulierte oder proprietäre Informationen enthalten, was den Bedarf an Klassifizierung von Modelleingaben auf Modellausgaben ausweitet. Regulatorische und betriebliche Anforderungen konvergieren daher um dieselben Datenkontrollen, was es wichtig macht, konsistente Kennzeichnungen über Geschäftsbereiche, Repositorys und die Systeme hinweg zu verwenden, die Zugriffs-, Schutz- und Aufbewahrungsrichtlinien durchsetzen.
Welche Komponente führt bei den Ausgaben für Automatisierung der Datenklassifizierung?
Software führte im Jahr 2025 mit einem Umsatzanteil von 67,39 %, da Scan-Engines, Klassifizierungsregeln und Sensitivitätskennzeichnungen nachgelagerte Kontrollen unterstützen. Diese Werkzeuge stellen die Klassifizierungsschicht bereit, die eine konsistente Richtliniendurchsetzung durch Verschlüsselung, Datenverlustprävention und Zugangsentzug ermöglicht. Dienstleistungen wachsen ebenfalls, da Organisationen Unterstützung bei Taxonomiedesign, Integrationen, regulatorischem Mapping, Klassifizierungsvalidierung und kontinuierlicher Prüfungsvorbereitung über föderative Datenbestände hinweg benötigen. Verwaltete Dienste können Organisationen auch dabei helfen, Klassifizierungslücken zu überwachen, wenn sie keine dedizierten Governance-Spezialisten einstellen können. Diese Arbeit bleibt wichtig, wenn lokale Geschäftskennzeichnungen mit unternehmensweiten Richtlinienanforderungen abgestimmt werden müssen, insbesondere in Organisationen, in denen Daten über mehrere Abteilungen, Cloud-Dienste und Rechtsordnungen mit unterschiedlichen Compliance-Verpflichtungen hinweg erstellt und verwaltet werden.
Welches Bereitstellungsmodell wächst am schnellsten?
Cloud-basierte Bereitstellungen werden bis 2031 voraussichtlich mit einer CAGR von 26,28 % wachsen, da sie kontinuierliches Scanning über verteilte Umgebungen hinweg unterstützen. Dieser Ansatz hilft Teams, Informationen bei ihrer Erstellung und Änderung zu klassifizieren, anstatt nur bei geplanten Überprüfungen. Anforderungen an souveräne Clouds schaffen auch einen Bedarf an Werkzeugen, die auf nationaler Infrastruktur betrieben werden können, während hybride Umgebungen Richtlinien erfordern, die sowohl öffentliche Cloud-Dienste als auch On-Premises-Repositorys umfassen. On-Premises-Systeme behalten eine Rolle in Verteidigungs-, Versorgungs- und Gesundheitsumgebungen, in denen Air-Gap-Betrieb notwendig bleibt. Das resultierende Umfeld erfordert eine konsistente Klassifizierungsabdeckung über mehrere Bereitstellungsmodelle hinweg, damit Sicherheits- und Governance-Teams dieselben Sensitivitätsregeln anwenden können, auch wenn Informationen in einem lokalen Repository verbleiben oder zwischen Cloud-Diensten verschoben werden.
Welcher Organisationstyp wächst am schnellsten?
Kleine und mittlere Unternehmen werden bis 2031 voraussichtlich mit einer CAGR von 28,51 % wachsen, da SaaS-Werkzeuge die Adoptionshürden senken. Vorgefertigte Vorlagen, Low-Code-Onboarding und vorgefertigte Klassifikatoren helfen Unternehmen, Kontrollen ohne große technische Teams einzusetzen. Diese Funktionen sind wichtig, wenn Governance-Personal auch den Sicherheitsbetrieb verwaltet, während das EU-KI-Gesetz und Datenschutzverpflichtungen Klassifizierungsanforderungen für Organisationen schaffen, die KI-Systeme entwickeln oder einsetzen. Großunternehmen bleiben die größte Kundengruppe, da ihre Multi-Cloud-Datenbestände und grenzüberschreitenden Anforderungen manuelle Ansätze unpraktikabel machen. Beide Gruppen benötigen Kontrollen, die an sich ändernde Datentypen und regulatorische Verpflichtungen angepasst werden können, da effektive Programme erfordern, dass Klassifizierungsrichtlinien mit sich entwickelnden Geschäftstaxonomien, Cloud-Architekturen und KI-Anwendungsfällen abgestimmt bleiben.
Welche Region wird voraussichtlich am schnellsten wachsen?
Der asiatisch-pazifische Raum wird bis 2031 voraussichtlich mit einer CAGR von 28,66 % wachsen, unterstützt durch Datenlokalisierungsvorschriften und wachsende Unternehmensdatenvolumina. Chinas Klassifizierungsstandards und Regeln zur Einstufung von Finanzdaten sowie regulatorische Änderungen in Indien und anderen Volkswirtschaften unterstützen die Adoption. Organisationen benötigen auch eine Klassifizierung, bevor sensible Informationen auf souveräne Cloud-Plattformen übertragen werden können, was regulatorische Compliance, Cloud-Migration, KI-Nutzung und inländische Dateninfrastruktur in der gesamten Region miteinander verbindet. Nordamerika blieb im Jahr 2025 der größte regionale Beitragszahler mit einem Umsatzanteil von 42,39 %, unterstützt durch ausgereifte Cloud-Adoption und überlappende Datensicherheitsanforderungen. Europa verzeichnet ebenfalls eine anhaltende Nachfrage, da Organisationen DSGVO-, DORA-, NIS2- und EU-KI-Gesetz-Anforderungen gemeinsam erfüllen müssen, was den Wert von Werkzeugen erhöht, die die Klassifizierungsabdeckung dokumentieren und Prüfungen über überlappende regulatorische Anforderungen hinweg unterstützen können.


 Ihre Daten sind sicher und werden niemals verkauft oder weitergegeben.

