
Taille et part du marché de l'automatisation de la classification des données
VUE D’ENSEMBLE DU MARCHÉ
| Période d'étude | 2020 - 2031 |
|---|---|
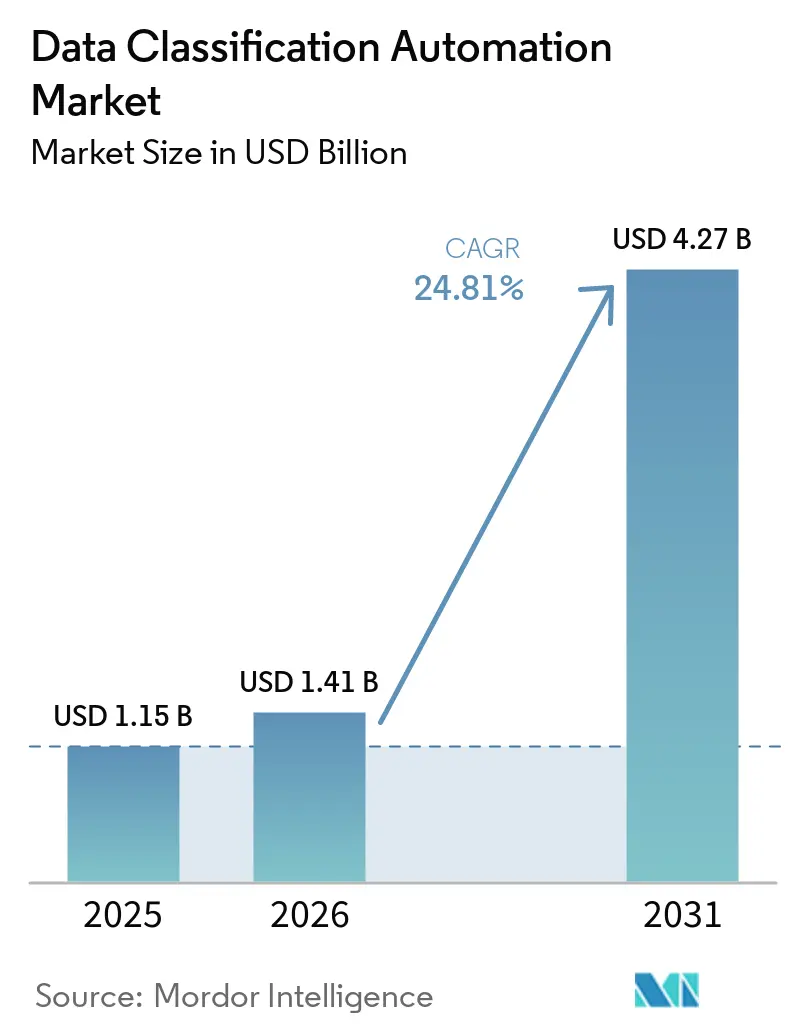
| Taille du Marché (2026) | 1.41 Milliards de dollars |
| Taille du Marché (2031) | 4.27 Milliards de dollars |
| Taux de croissance (2026 - 2031) | 24.81 % |
| Marché à la Croissance la Plus Rapide | Asie-Pacifique |
| Plus Grand Marché | Amérique du Nord |
| Concentration du Marché | Moyen |
Acteurs majeurs *Avis de non-responsabilité : les principaux acteurs sont triés sans ordre particulier Image © Mordor Intelligence. La réutilisation nécessite une attribution sous CC BY 4.0. | |
Analyse du marché de l'automatisation de la classification des données par Mordor Intelligence
La taille du marché de l'automatisation de la classification des données devrait s'étendre de 1,15 milliard USD en 2025 et 1,41 milliard USD en 2026 à 4,27 milliards USD d'ici 2031, enregistrant un CAGR de 24,81 % entre 2026 et 2031. L'application complète des exigences de l'acte européen sur l'IA pour les systèmes à haut risque, à compter du 2 août 2026, fait de la documentation des données d'entraînement une obligation pour le déploiement d'une IA conforme. Cela place la classification des données aux côtés des contrôles de confidentialité en tant qu'élément central de la gouvernance de l'IA en entreprise. Les entreprises gèrent également des volumes beaucoup plus importants de contenu non structuré, ce qui rend difficile la révision manuelle des documents, courriels, images, fichiers de collaboration et vidéos. L'adoption du cloud hybride et les règles relatives aux clouds souverains font évoluer la classification, passant de référentiels isolés à des pipelines de politiques qui suivent les données dans tous les environnements. Les fournisseurs répondent par des plateformes intégrées combinant classification, prévention des pertes de données, gestion de la posture de sécurité des données, gouvernance de l'IA et contrôles d'accès.
Points clés du rapport
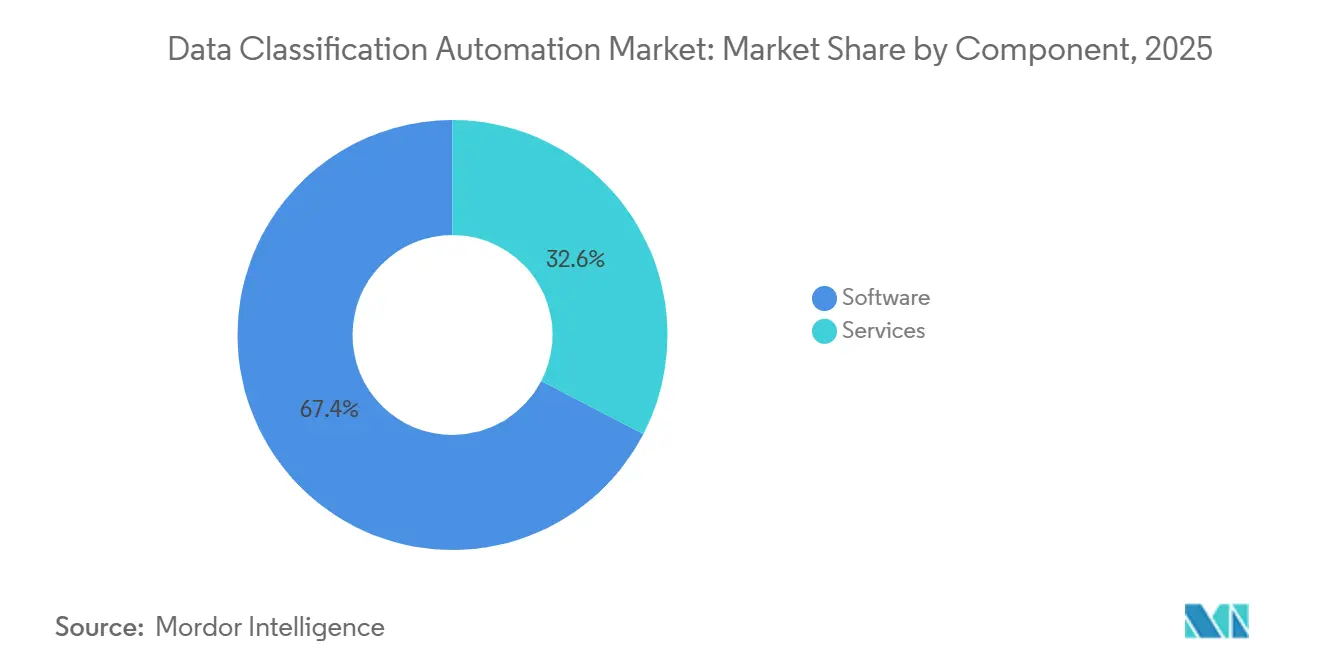
- Par composant, les logiciels représentaient 67,39 % des revenus du marché de l'automatisation de la classification des données en 2025, tandis que les services devraient se développer à un CAGR de 27,62 % jusqu'en 2031.
- Par mode de déploiement, les déploiements basés sur le cloud représentaient 57,83 % des revenus en 2025 et devraient croître à un CAGR de 26,28 % jusqu'en 2031.
- Par taille d'organisation, les grandes entreprises détenaient une part de revenus de 69,74 % en 2025, tandis que les petites et moyennes entreprises devraient se développer à un CAGR de 28,51 % jusqu'en 2031.
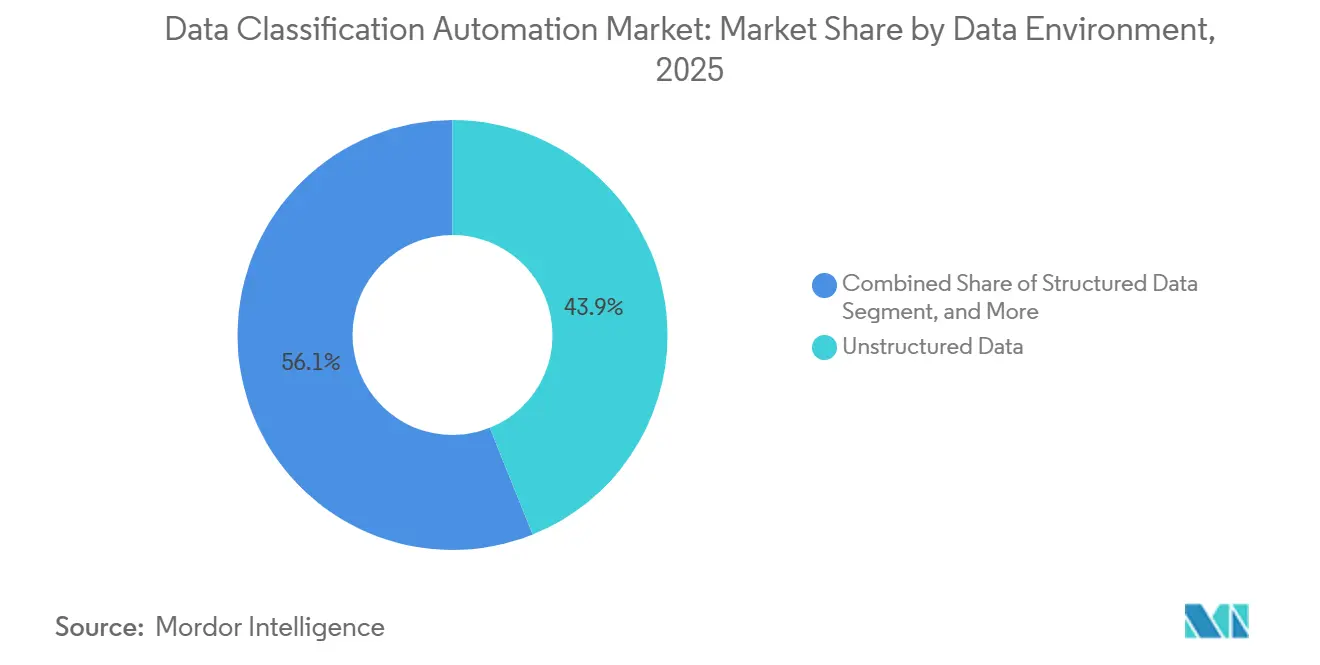
- Par environnement de données, les données non structurées détenaient 43,91 % de la part du marché de l'automatisation de la classification des données en 2025, tandis que les données structurées devraient se développer à un CAGR de 26,32 % jusqu'en 2031.
- Par secteur d'activité, les services bancaires, financiers et d'assurance détenaient une part de revenus de 27,68 % en 2025, tandis que le gouvernement et l'administration publique devraient se développer à un CAGR de 27,26 % jusqu'en 2031.
- Par géographie, l'Amérique du Nord détenait une part de revenus de 42,39 % sur le marché de l'automatisation de la classification des données en 2025, tandis que l'Asie-Pacifique devrait se développer à un CAGR de 28,66 % jusqu'en 2031.
Note : La taille du marché et les prévisions figurant dans ce rapport sont générées à l'aide du cadre d'estimation exclusif de Mordor Intelligence, mis à jour avec les dernières données et informations disponibles en janvier 2026.
Tendances et perspectives mondiales du marché de l'automatisation de la classification des données
Analyse de l'impact des moteurs*
| MOTEUR | (~) % D'IMPACT SUR LES PRÉVISIONS DE CAGR | PERTINENCE GÉOGRAPHIQUE | HORIZON TEMPOREL DE L'IMPACT |
|---|---|---|---|
| Exigences de gouvernance des données pour l'IA générative et les agents IA | +6.1% | Mondial, plus aigu en Amérique du Nord et dans l'UE | Court terme (≤ 2 ans) |
| Expansion des réglementations sur la confidentialité et la sécurité des données | +5.4% | Mondial, avec un impact précoce concentré dans l'UE, le cœur de l'Asie-Pacifique, et des retombées vers le Moyen-Orient et l'Afrique | Moyen terme (2-4 ans) |
| Croissance des volumes de données non structurées et sensibles | +4.8% | Mondial | Long terme (≥ 4 ans) |
| Expansion des environnements hybrides, multi-cloud et SaaS | +4.2% | Mondial, plus prononcé en Amérique du Nord et en Asie-Pacifique | Moyen terme (2-4 ans) |
| Classification continue pour les données en flux, l'IoT et les données générées par les machines | +1.8% | Cœur de l'Asie-Pacifique, avec des retombées vers l'Amérique du Nord | Long terme (≥ 4 ans) |
| Pipelines de génération augmentée par récupération avec prise en compte de la classification | +1.5% | Amérique du Nord et UE | Court terme (≤ 2 ans) |
| Source: Mordor Intelligence | |||
Exigences de gouvernance des données pour l'IA générative et les agents IA
L'acte européen sur l'IA exige des fournisseurs de systèmes à haut risque qu'ils documentent les origines des données, les étapes de préparation et l'examen des biais pour les ensembles de données d'entraînement, de validation et de test à compter du 2 août 2026. Cette exigence crée un mandat de classification des données qui s'ajoute aux obligations établies en matière de rapports sur la confidentialité. Les entreprises ont donc besoin d'une structure de classification pour les informations personnelles et sensibles, et d'une autre pour la documentation des modèles d'IA. Microsoft Purview et Amazon SageMaker Catalog montrent comment les fournisseurs ajoutent une classification automatisée aux flux de gestion des données d'IA. Amazon SageMaker Catalog peut analyser les métadonnées de tables avec les modèles de langage Amazon Bedrock et appliquer des balises de glossaire métier et d'informations personnellement identifiables. L'IA agentique renforce le besoin de classification au point où les données sont consultées ou modifiées, plutôt qu'uniquement là où elles sont stockées.
Expansion des réglementations sur la confidentialité et la sécurité des données
Les règles de confidentialité et de sécurité des données affectent désormais un plus grand nombre de juridictions, amenant la classification automatisée sur des marchés qui avaient précédemment moins investi dans ces outils. La Chine a publié un cadre de classification des données financières à quatre niveaux le 24 janvier 2026, couvrant les données essentielles, les données importantes, les données générales sensibles et les données générales. Les institutions financières doivent maintenir des inventaires auditables et soumettre des catalogues de données importantes aux régulateurs dans le cadre de ce dispositif. La Banque de réserve de l'Inde a proposé en 2026 un cadre de gouvernance des données incluant la classification des données dans les systèmes de gestion des risques des entités réglementées. L'application du règlement DORA à partir de janvier 2025, NIS2 et le RGPD imposent aux organisations européennes de satisfaire à des exigences de gouvernance des données qui se recoupent. Les contrôles d'étiquetage des informations ISO 27001 et ISO 27701:2025 contribuent également à standardiser les taxonomies de classification dans les opérations multinationales.
Croissance des volumes de données non structurées et sensibles
Les fichiers non structurés comprennent des documents, des courriels, du contenu collaboratif, des images numérisées et des vidéos, créant une lourde charge de découverte et d'étiquetage pour les entreprises. La Cloud Security Alliance a rapporté que le contenu non structuré représentait 33 % du volume des données d'entreprise et plus de la moitié de la croissance annuelle des données pour près d'1 entreprise sur 3 interrogées.[1] La même étude a révélé que plus de 56 % des organisations n'avaient qu'une visibilité partielle sur l'emplacement de leurs données. Komprise a rapporté que 56 % des entreprises identifiaient la classification des données comme le principal défi lors de la préparation des données pour l'IA en 2026, contre 41 % en 2024. Le NIST SP 1800-39, publié en février 2026, fournit des méthodes pour découvrir, identifier et étiqueter les données non structurées afin de soutenir l'architecture Zero Trust et la préparation à la cryptographie post-quantique. Les sorties internes de l'IA peuvent également reproduire des informations propriétaires ou réglementées, de sorte que les organisations doivent classifier les sorties des modèles ainsi que les entrées.
Expansion des environnements hybrides, multi-cloud et SaaS
Les environnements hybrides et multi-cloud affaiblissent la valeur des contrôles qui reposent uniquement sur un périmètre réseau traditionnel. La classification permet d'appliquer des politiques aux données sur différentes plateformes cloud et services logiciels. AvePoint a déclaré que la classification transforme les politiques d'accès générales en contrôles applicables pour les cas d'usage de l'IA.[2] Les règles relatives aux clouds souverains peuvent accélérer les déploiements de classification dans le cloud tout en exigeant que les mêmes contrôles fonctionnent indépendamment dans plusieurs environnements nationaux. Une étude publiée dans une revue en 2024 a décrit la gestion automatisée des métadonnées et la surveillance en temps réel dans une banque d'investissement mondiale, soutenant les obligations RGPD et CCPA dans un environnement cloud hybride. Les exigences ISO 27001, CMMC 2.0 et SOC 2 soutiennent également l'investissement dans des contrôles de classification documentés lors des cycles de certification et de renouvellement.
Analyse de l'impact des freins*
| FREIN | (~) % D'IMPACT SUR LES PRÉVISIONS DE CAGR | PERTINENCE GÉOGRAPHIQUE | HORIZON TEMPOREL DE L'IMPACT |
|---|---|---|---|
| Coûts élevés d'intégration et de mise en œuvre | -3.2% | Mondial, plus aigu parmi les entreprises du marché intermédiaire en Amérique du Nord et dans l'UE | Moyen terme (2-4 ans) |
| Pénurie de spécialistes en gouvernance des données et en classification | -2.6% | Mondial, plus sévère dans l'UE, en Amérique du Nord et en Asie-Pacifique émergente | Long terme (≥ 4 ans) |
| Dérive taxonomique entre les unités commerciales fédérées | -1.4% | Mondial, concentré dans les grandes entreprises à structures décentralisées | Moyen terme (2-4 ans) |
| Risques liés à l'explicabilité et aux faux positifs dans la classification basée sur les LLM | -1.1% | Mondial | Court terme (≤ 2 ans) |
| Source: Mordor Intelligence | |||
Coûts élevés d'intégration et de mise en œuvre
Les déploiements d'automatisation de la classification des données nécessitent un travail au-delà de la simple licence logicielle, car ils doivent s'intégrer aux flux de prévention des pertes de données, de gestion des identités et des accès, de chiffrement et de gestion des informations et des événements de sécurité. Les implémentations dans les grandes entreprises nécessitaient généralement 18 à 24 mois de travail d'ingénierie soutenu. Cette charge est plus aiguë pour les entreprises du marché intermédiaire, où le personnel de gouvernance des données gère souvent également les opérations de sécurité. Des recherches issues de l'ACL Industry Track 2026 ont révélé que les systèmes de classification en entreprise nécessitent un calibrage continu à mesure que les taxonomies institutionnelles évoluent.[3] Le même travail a identifié la stabilité des explications comme un critère de déploiement important, les modèles devant justifier de manière cohérente des étiquettes similaires sous des modifications mineures des entrées. Les plateformes SaaS avec des connecteurs préconstruits peuvent réduire le travail d'intégration, mais la conception de la taxonomie et l'ajustement des politiques nécessiteront toujours une attention continue.
Pénurie de spécialistes en gouvernance des données et en classification
La pénurie de spécialistes en classification limite la rapidité à laquelle les organisations peuvent mettre en œuvre et maintenir des programmes de gouvernance. LinkedIn a rapporté une croissance de 150 % d'une année sur l'autre de la demande de compétences en gouvernance de l'IA en 2026. Axipro a identifié 3 004 rôles de développeurs d'IA pour 446 rôles de gouvernance dans ses recherches sur le recrutement européen, ce qui illustre le déséquilibre entre le développement de modèles et la capacité de gouvernance. ManpowerGroup a interrogé 39 000 employeurs et a constaté que les rôles de gouvernance de l'IA étaient les plus difficiles à pourvoir à l'échelle mondiale en 2026. Cette pénurie peut également renforcer la demande d'automatisation, car les organisations utilisent des outils pour combler les lacunes en matière de personnel. Les fournisseurs qui proposent des assistants de taxonomie, des modèles réglementaires et des éditeurs de politiques à faible code peuvent réduire la dépendance à l'égard de ressources spécialisées rares.
*Nos prévisions considèrent les impacts des moteurs et des contraintes comme directionnels et non additifs. Les prévisions d'impact reflètent la croissance de référence, les effets de composition et les interactions entre variables.
Analyse des segments
Par composant : les logiciels ancrent la pile de gouvernance
Les logiciels détenaient 67,39 % de la part du marché de l'automatisation de la classification des données en 2025, car les moteurs d'analyse, les règles et les étiquettes de sensibilité constituent la couche opérationnelle des décisions automatisées. Ces capacités doivent être en place avant que le chiffrement, la prévention des pertes de données ou la révocation des accès puissent fonctionner sur la base d'une classification cohérente. Varonis, Cyera et Sentra combinent la correspondance de motifs déterministe avec des modèles d'IA spécifiques au domaine pour améliorer la qualité de la classification. Varonis a reçu le brevet américain 12664203 en juin 2026 pour une méthode d'apprentissage automatique par incorporation qui classe les éléments de données et applique des politiques de gestion. La couche logicielle reste centrale car elle traite les signaux de données utilisés par les contrôles d'application en aval.
Les services devraient se développer à un CAGR de 27,62 % jusqu'en 2031, ce qui en fait le composant à la croissance la plus rapide. Les organisations ont besoin d'aide pour réconcilier les étiquettes entre les unités commerciales, mapper les réglementations aux éléments de données et valider l'exactitude lors des cycles d'audit. Les services de classification gérés peuvent surveiller et corriger les lacunes de classification pour les clients sans équipes de gouvernance dédiées. Le marché de l'automatisation de la classification des données devrait donc continuer à avoir un besoin significatif de services, même si les logiciels deviennent plus faciles à déployer. Commvault et Forcepoint montrent comment les offres gérées combinent la gestion de la posture de sécurité des données, la prévention des pertes de données et la classification post-déploiement.


Par mode de déploiement : les déploiements basés sur le cloud favorisent une gouvernance évolutive
Les déploiements basés sur le cloud détenaient une part de revenus de 57,83 % en 2025, reflétant le volume croissant de données sensibles créées, traitées et stockées dans des environnements natifs du cloud. L'analyse continue peut identifier et classifier les données au fur et à mesure de leur modification, plutôt que de s'appuyer sur des révisions périodiques par lots. Komprise a constaté que les volumes de données augmentent plus vite que les processus de révision manuels et semi-automatisés ne peuvent les traiter. Microsoft Purview, AWS Macie, SageMaker Catalog et l'API Google Cloud DLP connectent la classification à leurs environnements cloud respectifs. Cela fait du déploiement dans le cloud une option pratique pour les parcs de données distribués.
La taille du marché de l'automatisation de la classification des données basé sur le cloud devrait croître à un CAGR de 26,28 % jusqu'en 2031. Les exigences relatives aux clouds souverains en France, en Allemagne, en Inde et en Australie orientent les déploiements cloud vers des infrastructures nationales plutôt que vers des régions de cloud public mondial. OpenText et S3NS ont annoncé un partenariat en avril 2026 pour la gestion de contenu et la classification des données conformes à SecNumCloud en France et en Europe. Les systèmes sur site conservent un rôle pertinent pour les sous-traitants de la défense, les services publics et les prestataires de soins de santé ayant des exigences d'isolation physique. Le déploiement hybride reste nécessaire dans les organisations réglementées qui ne peuvent pas déplacer toutes leurs données vers des services de cloud public tout en ayant besoin de politiques cohérentes sur tous les sites.
Par taille d'organisation : les grandes entreprises ancrent la demande, les PME accélèrent
Les grandes entreprises détenaient une part de revenus de 69,74 % en 2025, car elles exploitent des parcs multi-cloud et font face à des réglementations dans plusieurs juridictions. Leurs ensembles de données peuvent couvrir des bases de données structurées, des référentiels non structurés, des plateformes SaaS et des outils de collaboration. Cette échelle rend la classification manuelle et semi-automatisée commercialement impraticable. Une étude de 2024 portant sur une banque d'investissement mondiale a révélé que la gouvernance assistée par l'IA et la surveillance en temps réel pouvaient soutenir les processus de conformité au RGPD et au CCPA.[4] Les exigences ISO 27001 et PCI DSS 4.0 soutiennent également la demande de programmes de classification documentés et auditables parmi les grandes organisations.
Les petites et moyennes entreprises devraient croître à un CAGR de 28,51 % jusqu'en 2031. Les outils fournis en mode SaaS avec des modèles préconstruits pour le RGPD, le CCPA, l'HIPAA et les exigences sectorielles spécifiques ont abaissé les barrières à l'adoption pour ce groupe. L'acte européen sur l'IA et la loi indienne sur la protection des données personnelles numériques étendent les attentes en matière de classification aux organisations plus petites qui développent ou déploient des systèmes d'IA. L'intégration à faible code et les classificateurs prêts à l'emploi sont importants là où les entreprises ne disposent pas d'équipes de gouvernance dédiées. Sentra a introduit un classificateur IA pour les données non structurées en novembre 2025, utilisant des petits modèles de langage spécifiques au domaine avec prise en charge de plus de 70 langues.
Par environnement de données : les données non structurées dominent, l'IA redéfinit les priorités
Les données non structurées détenaient 43,91 % de la part du marché de l'automatisation de la classification des données en 2025, car les textes, images et contenus basés sur des fichiers sont omniprésents dans les référentiels d'entreprise. La Cloud Security Alliance a constaté que 56 % des entreprises n'avaient qu'une visibilité partielle sur l'emplacement de leurs données non structurées. Près de 30 % de ces entreprises ont identifié les données non structurées comme la source de la majeure partie de la croissance annuelle des données. Le NIST SP 1800-39 décrit la classification des données non structurées comme un fondement de l'architecture Zero Trust et de la préparation des données d'entraînement pour l'IA. Forcepoint a étendu sa technologie de classification des données AI Mesh en octobre 2025 pour traiter les données structurées et non structurées via une seule plateforme.
Les données structurées devraient croître à un CAGR de 26,32 % jusqu'en 2031, le taux le plus élevé parmi les environnements de données. Les organisations qui construisent des pipelines de grands modèles de langage et de génération augmentée par récupération doivent identifier quelles tables de base de données sont autorisées pour l'entraînement et l'inférence des modèles. La norme chinoise GB/T 43697-2024, en vigueur depuis octobre 2024, établit des règles de classification et de gradation pour les ensembles de données financières et opérationnelles structurées.[5] Les journaux semi-structurés, les fichiers XML et les sorties JSON nécessitent également des étiquettes automatisées, car les architectures pilotées par API génèrent davantage de métadonnées pertinentes pour les audits. Ces exigences maintiennent les 3 environnements de données pertinents pour le marché de l'automatisation de la classification des données.

Par secteur d'activité : le BFSI en tête tandis que le gouvernement accélère
Les services bancaires, financiers et d'assurance représentaient 27,68 % des revenus en 2025, ce qui en fait le plus grand secteur vertical du marché de l'automatisation de la classification des données. Les institutions financières doivent gérer DORA, le RGPD, PCI DSS 4.0, SOX, GLBA et les règles chinoises de gradation des données financières. La combinaison exige des enregistrements auditables pour les activités de traitement des données sur de nombreux systèmes. Une étude AAAI de 2025 a révélé que les modèles de classification spécifiques au domaine surpassaient les alternatives commerciales à usage général sur les mesures de rappel pour les informations financières personnellement identifiables et les données de transaction. La santé et les sciences de la vie, les technologies de l'information et les télécommunications, ainsi que l'énergie et les services publics forment un groupe secondaire avec leurs propres exigences de conformité et opérationnelles.
Le secteur du gouvernement et de l'administration publique devrait se développer à un CAGR de 27,26 % jusqu'en 2031. Les exigences du pilier de données Zero Trust du département américain de la Défense et les directives sur les informations non classifiées contrôlées établissent la classification des données comme une base de sécurité fédérale. Le NIST SP 1800-39 fournit une référence de mise en œuvre qui soutient ces exigences. Le cadre proposé par l'Inde pour la gouvernance des données bancaires crée également des obligations de classification pour les banques et les sociétés financières non bancaires. L'éducation et la recherche, le commerce de détail et le commerce électronique, le transport et la logistique, ainsi que le pétrole et le gaz sont des secteurs verticaux plus petits dans lesquels l'utilisation de l'IA et la migration vers le cloud créent de nouveaux besoins de classification.
Analyse géographique
L'Amérique du Nord détenait 42,39 % de la part du marché de l'automatisation de la classification des données en 2025. La région bénéficie d'une adoption précoce du cloud en entreprise, d'exigences matures en matière de sécurité des données et d'une base installée de systèmes de prévention des pertes de données et d'identité avec lesquels les logiciels de classification peuvent s'intégrer. Les États-Unis sont le principal contributeur, car les mandats fédéraux, les lois sur la confidentialité dans 13 États et les règles financières créent des besoins de classification qui se recoupent. Le Canada et le Mexique ajoutent de la demande grâce à leurs cadres de confidentialité et à l'adoption plus large du cloud dans les services financiers et la santé. Le NIST SP 1800-39, publié en février 2026, fournit une architecture de référence gouvernementale pour les agences fédérales et leurs chaînes d'approvisionnement.
L'Europe est le deuxième bloc géographique en importance et présente une forte densité réglementaire. Le RGPD, DORA, NIS2 et l'acte européen sur l'IA exigent des organisations dans des environnements hybrides qu'elles démontrent une couverture de classification des données dans plusieurs cadres. L'Allemagne, la France, le Royaume-Uni et les pays du BENELUX mènent l'adoption grâce à leurs secteurs des services financiers, de la fabrication et de la santé. Les exigences SecNumCloud de la France ajoutent de la demande pour des outils conformes à la souveraineté. OpenText et S3NS ont annoncé un partenariat en avril 2026 pour soutenir la gestion de contenu et la classification des données conformes à SecNumCloud pour les déploiements de cloud souverain français et européen. Les attentes en matière de certification ISO 27001 et BSI C5 soutiennent également l'investissement dans la classification dans toute la région.
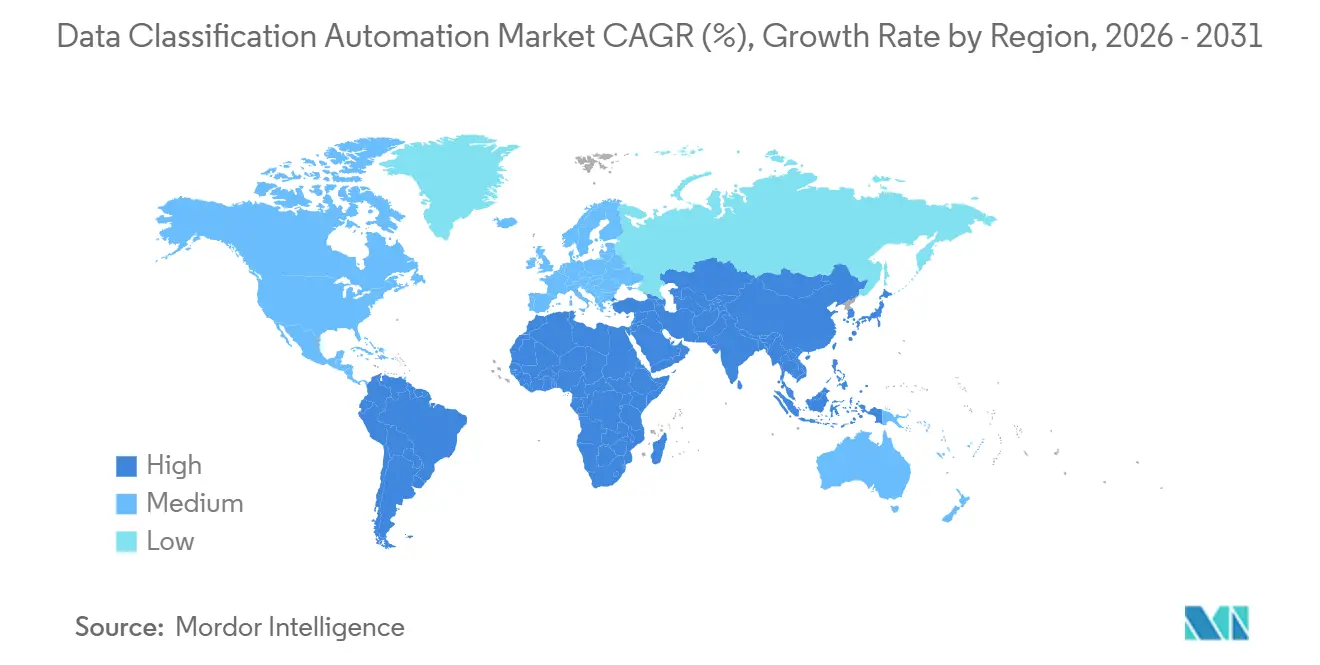
L'Asie-Pacifique devrait croître à un CAGR de 28,66 % jusqu'en 2031, le taux régional le plus élevé. L'Inde, le Japon, la Corée du Sud, l'Australie et Singapour ont des exigences de localisation des données qui rendent la classification nécessaire avant que les informations sensibles puissent être transférées vers une infrastructure de cloud souverain. La Chine applique la PIPL, la norme GB/T 43697-2024 et les exigences de gradation des données financières qui soutiennent la demande de classification parmi les entreprises nationales. Les règles opérationnelles de l'Inde de 2025 en vertu de la loi sur la protection des données personnelles numériques ont créé un cycle d'approvisionnement parmi les entités financières réglementées, les exportateurs de services informatiques et les organisations de santé. L'Amérique du Sud émerge grâce à l'application de la LGPD au Brésil et au cadre de protection des données mis à jour en Argentine, les entreprises financières de São Paulo formant un domaine de demande clé. Le Moyen-Orient et l'Afrique restent la plus petite région par revenus, mais les règles de confidentialité de l'Arabie saoudite et des Émirats arabes unis créent des exigences spécialisées dans les centres financiers, notamment l'ADGM et le DIFC.

Paysage concurrentiel
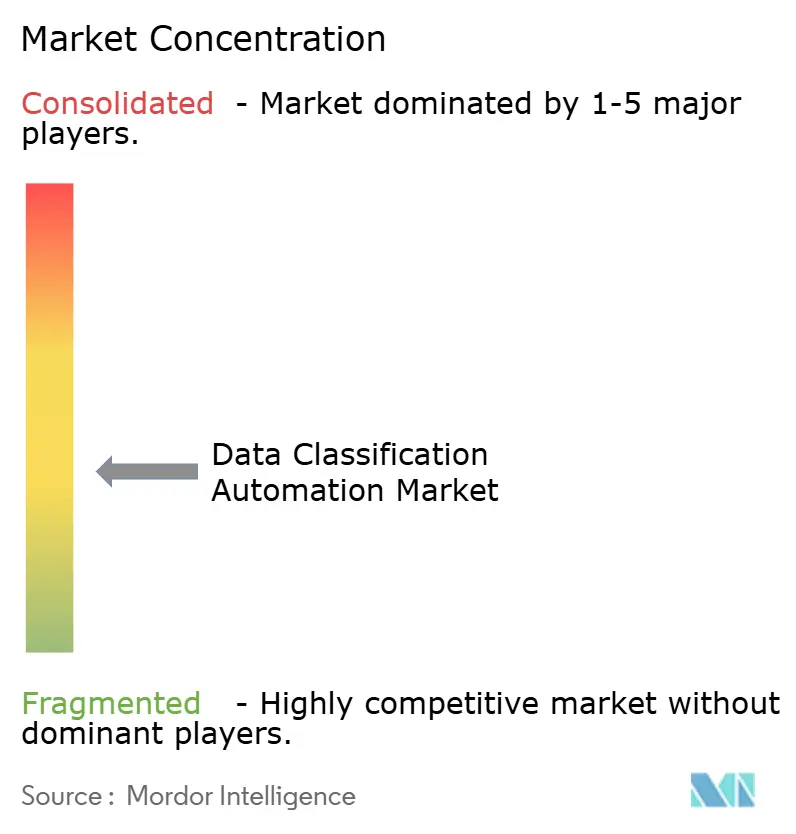
Le marché de l'automatisation de la classification des données est modérément fragmenté, avec une concurrence passant d'une structure dominée par des spécialistes à deux groupes distincts. Les grands fournisseurs de cybersécurité et les hyperscalers proposent la classification dans le cadre de plateformes de sécurité plus larges, tandis que les fournisseurs spécialisés se distinguent par leur précision, leur transparence et leur rapidité de mise en œuvre. Le groupe des plateformes larges comprend Microsoft, IBM, Informatica et Commvault. Le groupe spécialisé comprend Cyera, Varonis, BigID et Sentra. Ces groupes se disputent les mêmes budgets de gouvernance des données d'entreprise, bien qu'ils utilisent des modèles de livraison différents.
Microsoft intègre Purview dans Microsoft 365 et Azure, tandis que Salesforce a intégré les capacités de catalogue de données, de gouvernance, de qualité et de confidentialité d'Informatica après son acquisition en novembre 2025. Commvault a étendu ses capacités de sécurité des données et de l'IA en mars 2026 après l'acquisition de Satori, étendant la découverte automatisée, la classification et l'évaluation des risques aux données structurées et aux bases de données vectorielles. Palo Alto Networks a annoncé son intention d'acquérir Portkey en avril 2026 pour ajouter un contrôle centralisé et une gouvernance de classification pour les communications des agents IA autonomes à Prisma AIRS. Forcepoint et F5 ont formé une alliance en mars 2026 combinant la gestion de la posture de sécurité des données native à l'IA et la classification avec le test d'intrusion de l'IA et les garde-fous. Ces mouvements montrent que les fournisseurs connectent la classification à la sécurité de l'IA, à la résilience et à la gouvernance des accès.
Des opportunités subsistent dans les offres SaaS conçues pour les petites et moyennes entreprises, où des modèles réglementaires prêts à l'emploi peuvent réduire le travail de mise en œuvre. L'IA agentique crée un besoin distinct de gouvernance sur les données consultées et transformées sans révision humaine. Les offres compatibles avec les clouds souverains sont également importantes en Allemagne, en France, en Inde et en Australie, où les organisations doivent utiliser des infrastructures nationales pour les données sensibles. Concentric AI, Seclore et Ground Labs répondent à des exigences plus étroites, notamment la gestion des droits et la classification des données financières en Asie-Pacifique.
Leaders du secteur de l'automatisation de la classification des données
-
Microsoft Corporation
-
International Business Machines Corporation
-
Varonis Systems, Inc.
-
BigID, Inc.
-
Informatica Inc.
- *Avis de non-responsabilité : les principaux acteurs sont triés sans ordre particulier

Développements récents du secteur
- Septembre 2026 : Palo Alto Networks a finalisé l'acquisition de Console, une plateforme de sécurité agentique native à l'IA, en l'intégrant à son portefeuille Cortex pour permettre des flux d'investigation d'alertes pilotés par le langage naturel et des flux de remédiation automatisés dans les environnements de gestion de la posture de sécurité des données.
- Juin 2026 : Cyera a levé 600 millions USD lors d'un tour de table de série G à une valorisation de 12 milliards USD, portant le financement total à 2,3 milliards USD ; le tour a été mené par Evolution Equity Partners, avec Cyberstarts et Temasek parmi les nouveaux investisseurs, et est destiné à faire évoluer le moteur de classification de l'entreprise pour la sécurité de l'IA en entreprise à l'échelle de l'exaoctet.
- Avril 2026 : OpenText et S3NS (une alliance Thales-Google Cloud) ont annoncé un partenariat stratégique pour fournir une gestion de contenu et une classification des données conformes à SecNumCloud pour les environnements de cloud souverain français et européen, soutenant la conformité au RGPD et à SecNum 3.2.
- Avril 2026 : Palo Alto Networks a annoncé son intention d'acquérir Portkey, une plateforme de passerelle IA traitant des billions de jetons par mois, afin d'intégrer un contrôle centralisé et une gouvernance de classification sur les communications des agents IA autonomes dans sa plateforme Prisma AIRS.


Périmètre du rapport mondial sur le marché de l'automatisation de la classification des données
Le marché de l'automatisation de la classification des données englobe les solutions alimentées par l'IA et l'apprentissage automatique qui découvrent, analysent et catégorisent automatiquement les données sensibles dans des sources de données structurées et non structurées sans intervention manuelle. Ce marché se concentre sur l'identification et l'étiquetage des types de données tels que les informations personnellement identifiables, les données de carte de paiement, les informations de santé protégées, les dossiers financiers et la propriété intellectuelle en analysant les modèles de contenu, le contexte et les métadonnées à grande échelle dans des environnements sur site, cloud et hybrides. L'automatisation élimine les goulots d'étranglement de la classification manuelle en surveillant en continu les référentiels de données, en appliquant des schémas de classification réglementaires et organisationnels, en détectant la sensibilité des données en temps réel et en permettant des contrôles de sécurité en aval tels que le chiffrement, les restrictions d'accès et les politiques de prévention des pertes de données basées sur des balises de classification automatisées pour soutenir les exigences de conformité au RGPD, au CCPA, à l'HIPAA et à la norme PCI-DSS.
Le rapport sur le marché de l'automatisation de la classification des données est segmenté par composant (logiciels et services), mode de déploiement (basé sur le cloud, sur site et hybride), taille d'organisation (grandes entreprises et petites et moyennes entreprises), environnement de données (données structurées, données non structurées et données semi-structurées), secteur d'activité (gouvernement et administration publique, fabrication industrielle, commerce de détail et commerce électronique, transport et logistique, énergie et services publics, pétrole et gaz, technologies de l'information et télécommunications, médias et divertissement, établissements d'enseignement et de recherche, santé et sciences de la vie, services bancaires, financiers et d'assurance (BFSI), et autres secteurs verticaux), et géographie (Amérique du Nord, Amérique du Sud, Europe, Asie-Pacifique, et Moyen-Orient et Afrique). Les prévisions du marché sont fournies en termes de valeur (USD).
| Logiciels |
| Services |
| Basé sur le cloud |
| Sur site |
| Hybride |
| Grandes entreprises |
| Petites et moyennes entreprises |
| Données structurées |
| Données non structurées |
| Données semi-structurées |
| Gouvernement et administration publique |
| Fabrication industrielle |
| Commerce de détail et commerce électronique |
| Transport et logistique |
| Énergie et services publics |
| Pétrole et gaz |
| Technologies de l'information et télécommunications |
| Médias et divertissement |
| Établissements d'enseignement et de recherche |
| Santé et sciences de la vie |
| Services bancaires, financiers et d'assurance (BFSI) |
| Autres secteurs verticaux |
| Amérique du Nord | États-Unis | |
| Canada | ||
| Amérique du Sud | Brésil | |
| Argentine | ||
| Mexique | ||
| Reste de l'Amérique du Sud | ||
| Europe | Allemagne | |
| Royaume-Uni | ||
| France | ||
| Italie | ||
| BENELUX | ||
| Reste de l'Europe | ||
| Asie-Pacifique | Chine | |
| Japon | ||
| Inde | ||
| Corée du Sud | ||
| Australie | ||
| Reste de l'Asie-Pacifique | ||
| Moyen-Orient et Afrique | Moyen-Orient | Émirats arabes unis |
| Arabie saoudite | ||
| Reste du Moyen-Orient | ||
| Afrique | Afrique du Sud | |
| Nigéria | ||
| Égypte | ||
| Reste de l'Afrique | ||
| Par composant | Logiciels | ||
| Services | |||
| Par mode de déploiement | Basé sur le cloud | ||
| Sur site | |||
| Hybride | |||
| Par taille d'organisation | Grandes entreprises | ||
| Petites et moyennes entreprises | |||
| Par environnement de données | Données structurées | ||
| Données non structurées | |||
| Données semi-structurées | |||
| Par secteur d'activité | Gouvernement et administration publique | ||
| Fabrication industrielle | |||
| Commerce de détail et commerce électronique | |||
| Transport et logistique | |||
| Énergie et services publics | |||
| Pétrole et gaz | |||
| Technologies de l'information et télécommunications | |||
| Médias et divertissement | |||
| Établissements d'enseignement et de recherche | |||
| Santé et sciences de la vie | |||
| Services bancaires, financiers et d'assurance (BFSI) | |||
| Autres secteurs verticaux | |||
| Par géographie | Amérique du Nord | États-Unis | |
| Canada | |||
| Amérique du Sud | Brésil | ||
| Argentine | |||
| Mexique | |||
| Reste de l'Amérique du Sud | |||
| Europe | Allemagne | ||
| Royaume-Uni | |||
| France | |||
| Italie | |||
| BENELUX | |||
| Reste de l'Europe | |||
| Asie-Pacifique | Chine | ||
| Japon | |||
| Inde | |||
| Corée du Sud | |||
| Australie | |||
| Reste de l'Asie-Pacifique | |||
| Moyen-Orient et Afrique | Moyen-Orient | Émirats arabes unis | |
| Arabie saoudite | |||
| Reste du Moyen-Orient | |||
| Afrique | Afrique du Sud | ||
| Nigéria | |||
| Égypte | |||
| Reste de l'Afrique | |||


Questions clés auxquelles le rapport répond
Quelle est la taille du marché de l'automatisation de la classification des données ?
Le marché de l'automatisation de la classification des données était évalué à 1,15 milliard USD en 2025, est estimé à 1,41 milliard USD en 2026 et devrait atteindre 4,27 milliards USD d'ici 2031. Il devrait enregistrer un CAGR de 24,81 % durant la période 2026-2031. La croissance reflète le besoin des entreprises de documenter les données utilisées dans les systèmes d'IA, de renforcer les contrôles de confidentialité et d'appliquer des politiques dans des environnements cloud et SaaS en expansion. Les prévisions reflètent également la création de davantage de données dans des référentiels non structurés, des bases de données structurées et des fichiers opérationnels semi-structurés. La classification devient un contrôle opérationnel pour la gouvernance des données et le déploiement de l'IA plutôt qu'une activité de conformité autonome, en particulier là où les entreprises doivent démontrer que les données soutenant les décisions d'IA ont été identifiées, étiquetées et gérées selon des politiques documentées.
Qu'est-ce qui stimule la demande de classification automatisée des données ?
Les obligations de gouvernance de l'IA, l'expansion des règles de confidentialité, la croissance des données non structurées et l'adoption du cloud hybride soutiennent la demande. Les entreprises doivent identifier et étiqueter les informations dans les documents, les bases de données, les plateformes de collaboration, les services cloud et les flux de travail d'IA internes. Les exigences en matière d'enregistrements auditables rendent également la classification pertinente pour les programmes de conformité, la gestion des accès, la prévention des pertes de données, le chiffrement et l'utilisation sécurisée des modèles d'IA. Le contenu interne généré par l'IA peut également contenir des informations réglementées ou propriétaires, ce qui étend le besoin de classification des entrées des modèles aux sorties des modèles. Les besoins réglementaires et opérationnels convergent donc autour des mêmes contrôles de données, ce qui rend important l'utilisation d'étiquettes cohérentes entre les unités commerciales, les référentiels et les systèmes qui appliquent les politiques d'accès, de protection et de rétention.
Quel composant domine les dépenses en automatisation de la classification des données ?
Les logiciels étaient en tête avec une part de revenus de 67,39 % en 2025, car les moteurs d'analyse, les règles de classification et les étiquettes de sensibilité soutiennent les contrôles en aval. Ces outils fournissent la couche de classification qui permet une application cohérente des politiques via le chiffrement, la prévention des pertes de données et la révocation des accès. Les services connaissent également une croissance, car les organisations ont besoin d'aide pour la conception de taxonomies, les intégrations, la cartographie réglementaire, la validation de la classification et la préparation continue des audits dans des parcs de données fédérés. Les services gérés peuvent également aider les organisations à surveiller les lacunes de classification lorsqu'elles ne peuvent pas recruter de spécialistes de gouvernance dédiés. Ce travail reste important lorsque les étiquettes commerciales locales doivent s'aligner sur les exigences de politique à l'échelle de l'entreprise, en particulier dans les organisations où les données sont créées et gérées dans plusieurs départements, services cloud et juridictions avec des obligations de conformité différentes.
Quel modèle de déploiement se développe le plus rapidement ?
Les déploiements basés sur le cloud devraient croître à un CAGR de 26,28 % jusqu'en 2031, car ils permettent une analyse continue dans des environnements distribués. Cette approche aide les équipes à classifier les informations au fur et à mesure de leur création et de leur modification, plutôt que seulement lors de révisions planifiées. Les exigences relatives aux clouds souverains créent également un besoin d'outils pouvant fonctionner sur des infrastructures nationales, tandis que les environnements hybrides nécessitent des politiques couvrant à la fois les services de cloud public et les référentiels sur site. Les systèmes sur site conservent un rôle dans les environnements de défense, de services publics et de santé où les opérations isolées physiquement restent nécessaires. L'environnement qui en résulte nécessite une couverture de classification cohérente sur plusieurs modèles de déploiement, afin que les équipes de sécurité et de gouvernance puissent appliquer les mêmes règles de sensibilité même lorsque les informations restent dans un référentiel local ou se déplacent entre des services cloud.
Quel type d'organisation connaît la croissance la plus rapide ?
Les petites et moyennes entreprises devraient croître à un CAGR de 28,51 % jusqu'en 2031, les outils SaaS réduisant les barrières à l'adoption. Les modèles préconstruits, l'intégration à faible code et les classificateurs prêts à l'emploi aident les entreprises à déployer des contrôles sans grandes équipes techniques. Ces fonctionnalités sont importantes là où le personnel de gouvernance gère également les opérations de sécurité, tandis que l'acte européen sur l'IA et les obligations de protection des données créent des exigences de classification pour les organisations qui développent ou déploient des systèmes d'IA. Les grandes entreprises restent le plus grand groupe de clients, car leurs parcs de données multi-cloud et leurs exigences transjuridictionnelles rendent les approches manuelles impraticables. Les deux groupes ont besoin de contrôles pouvant être adaptés à l'évolution des types de données et des obligations réglementaires, car des programmes efficaces exigent que les politiques de classification restent alignées sur les taxonomies métier, les architectures cloud et les cas d'usage de l'IA en constante évolution.
Quelle région devrait connaître la croissance la plus rapide ?
L'Asie-Pacifique devrait croître à un CAGR de 28,66 % jusqu'en 2031, soutenue par les règles de localisation des données et l'expansion des volumes de données d'entreprise. Les normes de classification chinoises et les règles de gradation des données financières, ainsi que les changements réglementaires en Inde et dans d'autres économies, soutiennent l'adoption. Les organisations ont également besoin de classification avant de déplacer des informations sensibles vers des plateformes de cloud souverain, ce qui relie la conformité réglementaire, la migration vers le cloud, l'utilisation de l'IA et les infrastructures de données nationales dans toute la région. L'Amérique du Nord est restée le plus grand contributeur régional en 2025, avec une part de revenus de 42,39 % soutenue par une adoption mature du cloud et des exigences de sécurité des données qui se recoupent. L'Europe présente également une demande soutenue, car les organisations doivent répondre conjointement aux exigences du RGPD, de DORA, de NIS2 et de l'acte européen sur l'IA, ce qui augmente la valeur des outils pouvant documenter la couverture de classification et soutenir les audits dans le cadre d'exigences réglementaires qui se recoupent.


 Vos données sont sécurisées et ne sont jamais vendues ni partagées.

