
Tamaño y Participación del Mercado de Automatización de Clasificación de Datos
Visión General del Mercado
| Período de Estudio | 2020 - 2031 |
|---|---|
| Tamaño del Mercado (2026) | 1.41 Mil millones de dólares |
| Tamaño del Mercado (2031) | 4.27 Mil millones de dólares |
| Tasa de crecimiento (2026 - 2031) | 24.81 % |
| Mercado de Crecimiento Más Rápido | Asia-Pacífico |
| Mercado Más Grande | América del Norte |
| Concentración del Mercado | Medio |
Jugadores principales *Nota aclaratoria: los principales jugadores no se ordenaron de un modo en especial Imagen © Mordor Intelligence. El uso requiere atribución según CC BY 4.0. | |
Análisis del Mercado de Automatización de Clasificación de Datos por Mordor Intelligence
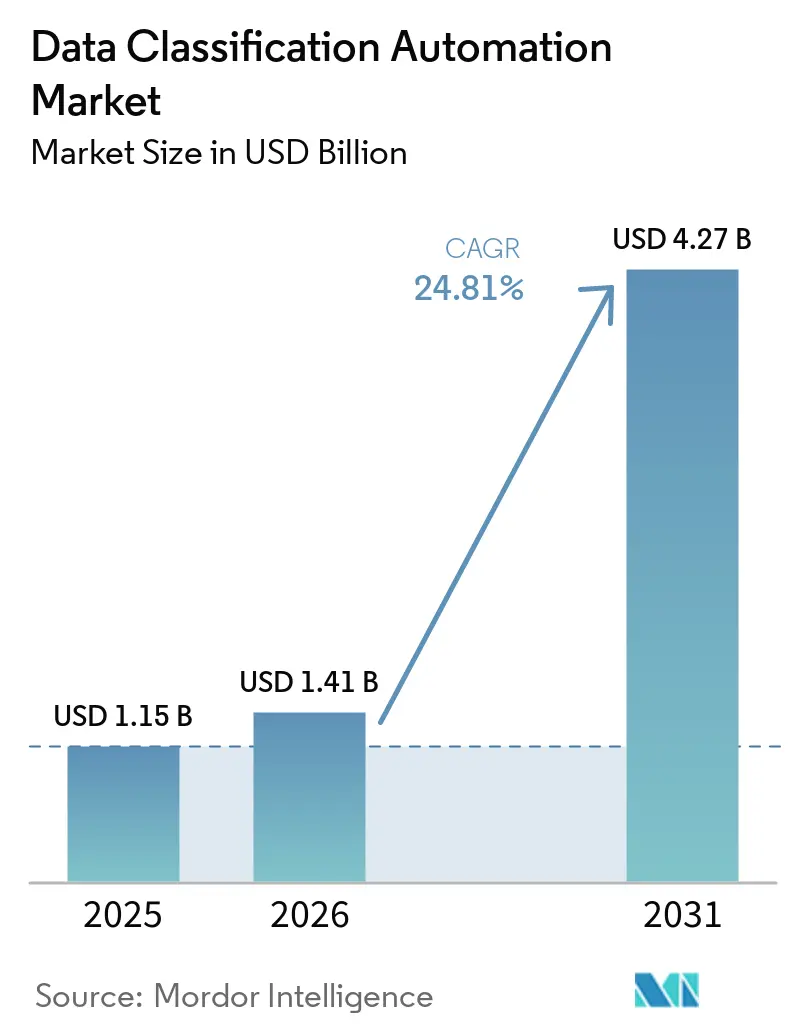
Se proyecta que el tamaño del mercado de automatización de clasificación de datos se expanda desde 1,15 mil millones de USD en 2025 y 1,41 mil millones de USD en 2026 hasta 4,27 mil millones de USD en 2031, registrando una CAGR del 24,81% entre 2026 y 2031. La plena aplicación de los requisitos de la Ley de IA de la UE para sistemas de alto riesgo, a partir del 2 de agosto de 2026, convierte los datos de entrenamiento documentados en un requisito para la implementación de IA conforme. Esto sitúa la clasificación de datos junto a los controles de privacidad como parte central de la gobernanza de IA empresarial. Las empresas también gestionan volúmenes mucho mayores de contenido no estructurado, lo que dificulta la revisión manual de documentos, correos electrónicos, imágenes, archivos de colaboración y vídeos. La adopción de la nube híbrida y las normas de nube soberana están desplazando la clasificación desde repositorios aislados hacia canales de políticas que rastrean los datos en todos los entornos. Los proveedores están respondiendo con plataformas integradas que combinan la clasificación con la prevención de pérdida de datos, la gestión de la postura de seguridad de datos, la gobernanza de IA y los controles de acceso.
Conclusiones Clave del Informe
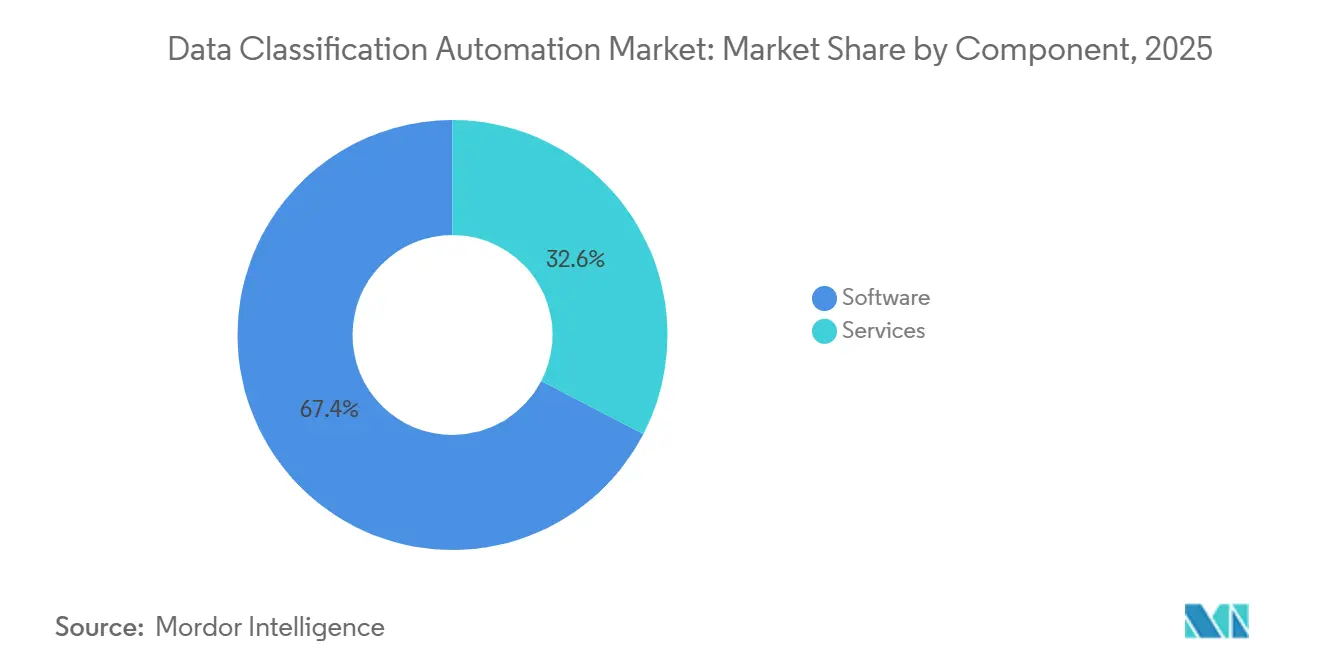
- Por componente, el software representó el 67,39% de los ingresos en el mercado de automatización de clasificación de datos en 2025, mientras que se proyecta que los servicios se expandan a una CAGR del 27,62% hasta 2031.
- Por modo de implementación, las implementaciones basadas en la nube representaron el 57,83% de los ingresos en 2025 y se proyecta que crezcan a una CAGR del 26,28% hasta 2031.
- Por tamaño de organización, las grandes empresas mantuvieron una participación de ingresos del 69,74% en 2025, mientras que se proyecta que las pequeñas y medianas empresas se expandan a una CAGR del 28,51% hasta 2031.
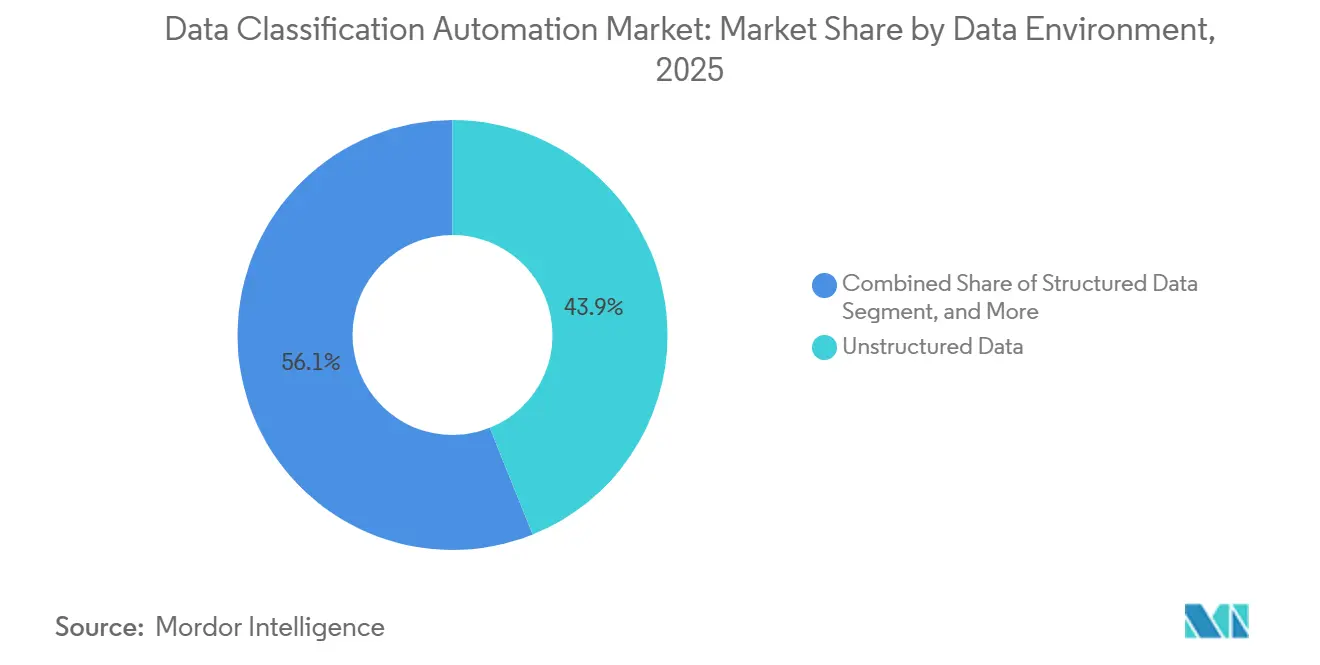
- Por entorno de datos, los datos no estructurados mantuvieron el 43,91% de la participación del mercado de automatización de clasificación de datos en 2025, mientras que se proyecta que los datos estructurados se expandan a una CAGR del 26,32% hasta 2031.
- Por vertical industrial, la banca, los servicios financieros y los seguros mantuvieron una participación de ingresos del 27,68% en 2025, mientras que se proyecta que el gobierno y la administración pública se expandan a una CAGR del 27,26% hasta 2031.
- Por geografía, América del Norte mantuvo una participación de ingresos del 42,39% en el mercado de automatización de clasificación de datos en 2025, mientras que se proyecta que Asia-Pacífico se expanda a una CAGR del 28,66% hasta 2031.
Nota: Las cifras del tamaño del mercado y los pronósticos de este informe se generan utilizando el marco de estimación patentado de Mordor Intelligence, actualizado con los datos y conocimientos más recientes disponibles a partir de enero de 2026.
Tendencias e Información del Mercado Global de Automatización de Clasificación de Datos
Análisis del Impacto de los Impulsores*
| IMPULSOR | (~) % DE IMPACTO EN EL PRONÓSTICO DE CAGR | RELEVANCIA GEOGRÁFICA | HORIZONTE TEMPORAL DE IMPACTO |
|---|---|---|---|
| Requisitos de Gobernanza de Datos para IA Generativa y Agentes de IA | +6.1% | Global, más agudo en América del Norte y la UE | Corto plazo (≤ 2 años) |
| Expansión de las Regulaciones de Privacidad y Seguridad de Datos | +5.4% | Global, con impacto temprano concentrado en la UE, núcleo de Asia-Pacífico, con extensión a Oriente Medio y África | Mediano plazo (2-4 años) |
| Crecimiento de los Volúmenes de Datos No Estructurados y Sensibles | +4.8% | Global | Largo plazo (≥ 4 años) |
| Expansión de Entornos Híbridos, Multi-Nube y SaaS | +4.2% | Global, más pronunciado en América del Norte y Asia-Pacífico | Mediano plazo (2-4 años) |
| Clasificación Continua para Datos en Streaming, IoT y Generados por Máquinas | +1.8% | Núcleo de Asia-Pacífico, con extensión a América del Norte | Largo plazo (≥ 4 años) |
| Canales de Generación Aumentada por Recuperación con Conciencia de Clasificación | +1.5% | América del Norte y la UE | Corto plazo (≤ 2 años) |
| Fuente: Mordor Intelligence | |||
Requisitos de Gobernanza de Datos para IA Generativa y Agentes de IA
La Ley de IA de la UE exige que los proveedores de sistemas de alto riesgo documenten los orígenes de los datos, los pasos de preparación y el examen de sesgos para los conjuntos de datos de entrenamiento, validación y prueba a partir del 2 de agosto de 2026. Este requisito crea un mandato de clasificación de datos que se sitúa junto a las obligaciones de reporte de privacidad ya establecidas. Las empresas necesitan, por tanto, una estructura de clasificación para la información personal y sensible y otra para la documentación de modelos de IA. Microsoft Purview y Amazon SageMaker Catalog muestran cómo los proveedores están añadiendo clasificación automatizada a los flujos de trabajo de gestión de datos de IA. Amazon SageMaker Catalog puede analizar metadatos de tablas con modelos de lenguaje de Amazon Bedrock y aplicar etiquetas de glosario empresarial e información de identificación personal. La IA agéntica aumenta la necesidad de clasificación en el punto donde se accede o modifica a los datos, en lugar de solo donde se almacenan.
Expansión de las Regulaciones de Privacidad y Seguridad de Datos
Las normas de privacidad y seguridad de datos afectan ahora a un conjunto más amplio de jurisdicciones, llevando la clasificación automatizada a mercados que anteriormente habían invertido menos en estas herramientas. China emitió un marco de clasificación de datos financieros en cuatro niveles el 24 de enero de 2026, que abarca datos básicos, datos importantes, datos generales sensibles y datos generales. Las instituciones financieras deben mantener inventarios auditables y presentar catálogos de datos importantes a los reguladores bajo este marco. El Banco de la Reserva de India propuso un marco de gobernanza de datos en 2026 que incluye la clasificación de datos en los sistemas de gestión de riesgos de las entidades reguladas. La aplicación de DORA desde enero de 2025, NIS2 y el RGPD exigen que las organizaciones europeas cumplan expectativas superpuestas de gobernanza de datos. Los controles de etiquetado de información de las normas ISO 27001 e ISO 27701:2025 también ayudan a estandarizar las taxonomías de clasificación en operaciones multinacionales.
Crecimiento de los Volúmenes de Datos No Estructurados y Sensibles
Los archivos no estructurados incluyen documentos, correo electrónico, contenido de colaboración, imágenes escaneadas y vídeo, lo que genera una gran carga de descubrimiento y etiquetado para las empresas. La Cloud Security Alliance informó que el contenido no estructurado representaba el 33% del volumen de datos empresariales y más de la mitad del crecimiento anual de datos para casi 1 de cada 3 empresas encuestadas.[1] La misma investigación encontró que más del 56% de las organizaciones tenían solo visibilidad parcial sobre dónde residían sus datos. Komprise informó que el 56% de las empresas identificó la clasificación de datos como el principal desafío al preparar datos para IA en 2026, frente al 41% en 2024. El NIST SP 1800-39, publicado en febrero de 2026, proporciona métodos para descubrir, identificar y etiquetar datos no estructurados para respaldar la Arquitectura de Confianza Cero y la preparación para la criptografía cuántica segura. Los resultados internos de IA también pueden reproducir información propietaria o regulada, por lo que las organizaciones necesitan clasificar tanto las salidas como las entradas de los modelos.
Expansión de Entornos Híbridos, Multi-Nube y SaaS
Los entornos híbridos y multi-nube debilitan el valor de los controles que dependen únicamente de un perímetro de red tradicional. La clasificación permite aplicar políticas a los datos en diferentes plataformas en la nube y servicios de software. AvePoint declaró que la clasificación convierte las políticas de acceso generales en controles aplicables para casos de uso de IA.[2] Las normas de nube soberana pueden acelerar las implementaciones de clasificación en la nube al tiempo que exigen que los mismos controles operen de forma independiente en múltiples entornos nacionales. Un estudio de revista de 2024 describió la gestión automatizada de metadatos y la supervisión en tiempo real en un banco de inversión global que respaldaba las obligaciones del RGPD y la CCPA en un entorno de nube híbrida. Los requisitos de ISO 27001, CMMC 2.0 y SOC 2 también respaldan la inversión en controles de clasificación documentados durante los ciclos de certificación y renovación.
Análisis del Impacto de las Restricciones*
| RESTRICCIÓN | (~) % DE IMPACTO EN EL PRONÓSTICO DE CAGR | RELEVANCIA GEOGRÁFICA | HORIZONTE TEMPORAL DE IMPACTO |
|---|---|---|---|
| Altos Costos de Integración e Implementación | -3.2% | Global, más agudo entre las empresas del mercado medio en América del Norte y la UE | Mediano plazo (2-4 años) |
| Escasez de Especialistas en Gobernanza de Datos y Clasificación | -2.6% | Global, más grave en la UE, América del Norte y el emergente Asia-Pacífico | Largo plazo (≥ 4 años) |
| Deriva Taxonómica en Unidades de Negocio Federadas | -1.4% | Global, concentrado en grandes empresas con estructuras descentralizadas | Mediano plazo (2-4 años) |
| Riesgos de Explicabilidad y Falsos Positivos en la Clasificación Basada en Modelos de Lenguaje de Gran Escala | -1.1% | Global | Corto plazo (≤ 2 años) |
| Fuente: Mordor Intelligence | |||
Altos Costos de Integración e Implementación
Las implementaciones de automatización de clasificación de datos requieren trabajo más allá de la licencia de software, ya que deben conectarse con flujos de trabajo de prevención de pérdida de datos, gestión de identidades y accesos, cifrado, y gestión de información y eventos de seguridad. Las implementaciones en grandes empresas típicamente requirieron entre 18 y 24 meses de trabajo de ingeniería sostenido. Esta carga es más aguda para las empresas del mercado medio, donde el personal de gobernanza de datos a menudo también gestiona las operaciones de seguridad. La investigación del ACL Industry Track de 2026 encontró que los sistemas de clasificación empresarial requieren calibración continua a medida que evolucionan las taxonomías institucionales.[3] El mismo trabajo identificó la estabilidad de las explicaciones como un criterio de implementación importante, ya que los modelos deben justificar de forma consistente etiquetas similares ante cambios menores en la entrada. Las plataformas SaaS con conectores prediseñados pueden reducir el trabajo de integración, pero el diseño de taxonomías y el ajuste de políticas seguirán requiriendo atención continua.
Escasez de Especialistas en Gobernanza de Datos y Clasificación
La escasez de especialistas en clasificación limita la rapidez con que las organizaciones pueden implementar y mantener programas de gobernanza. LinkedIn informó un crecimiento interanual del 150% en la demanda de habilidades de gobernanza de IA en 2026. Axipro identificó 3.004 roles de constructor de IA por cada 446 roles de gobernanza en su investigación de contratación europea, lo que muestra el desequilibrio entre el desarrollo de modelos y la capacidad de gobernanza. ManpowerGroup encuestó a 39.000 empleadores y encontró que los roles de gobernanza de IA eran los más difíciles de cubrir a nivel global en 2026. Esta escasez también puede fortalecer la demanda de automatización, ya que las organizaciones utilizan herramientas para abordar las brechas de personal. Los proveedores que ofrecen asistentes de taxonomía, plantillas regulatorias y editores de políticas de bajo código pueden reducir la dependencia de recursos especializados escasos.
*Nuestras previsiones consideran los impactos de impulsores y restricciones como direccionales, no aditivos. Las previsiones de impacto reflejan el crecimiento base, los efectos de mezcla y las interacciones entre variables.
Análisis de Segmentos
Por Componente: El Software Ancla la Pila de Gobernanza
El software mantuvo el 67,39% de la participación del Mercado de Automatización de Clasificación de Datos en 2025, porque los motores de escaneo, las reglas y las etiquetas de sensibilidad forman la capa operativa para las decisiones automatizadas. Estas capacidades deben estar en su lugar antes de que el cifrado, la prevención de pérdida de datos o la revocación de acceso puedan operar sobre una clasificación consistente. Varonis, Cyera y Sentra combinan la coincidencia de patrones determinista con modelos de IA específicos de dominio para mejorar la calidad de la clasificación. Varonis recibió la Patente de EE. UU. 12664203 en junio de 2026 por un método de aprendizaje automático de incrustación que clasifica elementos de datos y aplica políticas de gestión. La capa de software sigue siendo central porque procesa las señales de datos que utilizan los controles de aplicación posteriores.
Se proyecta que los servicios se expandan a una CAGR del 27,62% hasta 2031, convirtiéndolos en el componente de más rápido crecimiento. Las organizaciones necesitan apoyo para reconciliar etiquetas entre unidades de negocio, mapear regulaciones a elementos de datos y validar la precisión a través de ciclos de auditoría. Los servicios de clasificación gestionados pueden supervisar y corregir las brechas de clasificación para clientes sin equipos de gobernanza dedicados. Por lo tanto, es probable que el Mercado de Automatización de Clasificación de Datos continúe teniendo una necesidad significativa de servicios incluso a medida que el software se vuelve más fácil de implementar. Commvault y Forcepoint muestran cómo las ofertas gestionadas están combinando la gestión de la postura de seguridad de datos, la prevención de pérdida de datos y la clasificación posterior a la implementación.


Por Modo de Implementación: Las Implementaciones Basadas en la Nube Impulsan la Gobernanza Escalable
Las implementaciones basadas en la nube mantuvieron una participación de ingresos del 57,83% en 2025, lo que refleja el creciente volumen de datos sensibles creados, procesados y almacenados en entornos nativos de la nube. El escaneo continuo puede identificar y clasificar los datos a medida que cambian, en lugar de depender de revisiones periódicas por lotes. Komprise encontró que los volúmenes de datos crecen más rápido de lo que los procesos de revisión manual y semiautomática pueden gestionar. Microsoft Purview, AWS Macie, SageMaker Catalog y la API de Google Cloud DLP conectan la clasificación con sus respectivos entornos en la nube. Esto convierte la implementación en la nube en una opción práctica para los patrimonios de datos distribuidos.
Se proyecta que el tamaño del Mercado de Automatización de Clasificación de Datos basado en la nube crezca a una CAGR del 26,28% hasta 2031. Los requisitos de nube soberana en Francia, Alemania, India y Australia están dirigiendo las implementaciones en la nube hacia infraestructura nacional en lugar de regiones de nube pública global. OpenText y S3NS anunciaron una asociación en abril de 2026 para la gestión de contenido y la clasificación de datos conformes con SecNumCloud en Francia y Europa. Los sistemas locales mantienen un papel relevante para los contratistas de defensa, las empresas de servicios públicos y los proveedores de atención médica con requisitos de redes aisladas. La implementación híbrida sigue siendo necesaria en organizaciones reguladas que no pueden mover todos los datos a servicios de nube pública y al mismo tiempo necesitan políticas consistentes en todas las ubicaciones.
Por Tamaño de Organización: Las Grandes Empresas Anclan la Demanda, las Pymes Aceleran
Las grandes empresas mantuvieron una participación de ingresos del 69,74% en 2025 porque operan patrimonios multi-nube y enfrentan regulaciones en varias jurisdicciones. Sus conjuntos de datos pueden abarcar bases de datos estructuradas, repositorios no estructurados, plataformas SaaS y herramientas de colaboración. Esta escala hace que la clasificación manual y semiautomática sea comercialmente impráctica. Un estudio de 2024 sobre un banco de inversión global encontró que la gobernanza habilitada por IA y la supervisión en tiempo real podían respaldar los procesos de cumplimiento del RGPD y la CCPA.[4] Los requisitos de ISO 27001 y PCI DSS 4.0 también respaldan la demanda de programas de clasificación documentados y auditables entre las grandes organizaciones.
Se proyecta que las pequeñas y medianas empresas crezcan a una CAGR del 28,51% hasta 2031. Las herramientas entregadas como SaaS con plantillas prediseñadas para el RGPD, la CCPA, la HIPAA y los requisitos específicos del sector han reducido las barreras de adopción para este grupo. La Ley de IA de la UE y la Ley de Protección de Datos Personales Digitales de India extienden las expectativas de clasificación a organizaciones más pequeñas que desarrollan o implementan sistemas de IA. La incorporación de bajo código y los clasificadores prediseñados son importantes donde las empresas no tienen equipos de gobernanza dedicados. Sentra introdujo un Clasificador de IA para Datos No Estructurados en noviembre de 2025 utilizando modelos de lenguaje pequeños específicos de dominio con soporte para más de 70 idiomas.
Por Entorno de Datos: Los Datos No Estructurados Dominan, la IA Remodela las Prioridades
Los datos no estructurados mantuvieron el 43,91% de la participación del Mercado de Automatización de Clasificación de Datos en 2025, porque el texto, las imágenes y el contenido basado en archivos están ampliamente distribuidos en los repositorios empresariales. La Cloud Security Alliance encontró que el 56% de las empresas tenía solo visibilidad parcial sobre dónde residían sus datos no estructurados. Casi el 30% de esas empresas identificó los datos no estructurados como la fuente de la mayor parte del crecimiento anual de datos. El NIST SP 1800-39 describe la clasificación de datos no estructurados como una base para la Arquitectura de Confianza Cero y la preparación de datos de entrenamiento de IA. Forcepoint amplió su tecnología de Clasificación de Datos AI Mesh en octubre de 2025 para abordar datos estructurados y no estructurados a través de una sola plataforma.
Se proyecta que los datos estructurados crezcan a una CAGR del 26,32% hasta 2031, la tasa más alta entre los entornos de datos. Las organizaciones que construyen canales de modelos de lenguaje de gran escala y de generación aumentada por recuperación necesitan identificar qué tablas de bases de datos están permitidas para el entrenamiento e inferencia de modelos. La norma GB/T 43697-2024 de China, vigente desde octubre de 2024, establece reglas de clasificación y graduación para conjuntos de datos financieros y operativos estructurados.[5] Los registros semiestructurados, los archivos XML y las salidas JSON también necesitan etiquetas automatizadas a medida que las arquitecturas basadas en API generan más metadatos relevantes para auditorías. Estos requisitos mantienen los 3 entornos de datos relevantes para el Mercado de Automatización de Clasificación de Datos.
Nota: Las participaciones de todos los segmentos individuales están disponibles con la compra del informe
Por Vertical Industrial: El Sector BFSI Lidera mientras el Gobierno Gana Ritmo
La banca, los servicios financieros y los seguros representaron el 27,68% de los ingresos en 2025, convirtiéndolo en el vertical más grande del Mercado de Automatización de Clasificación de Datos. Las instituciones financieras deben gestionar DORA, RGPD, PCI DSS 4.0, SOX, GLBA y las normas de clasificación de datos financieros de China. La combinación requiere registros auditables para las actividades de procesamiento de datos en muchos sistemas. Un estudio de la AAAI de 2025 encontró que los modelos de clasificación específicos de dominio superaron a las alternativas comerciales de propósito general en las medidas de recuperación para información financiera de identificación personal y datos de transacciones. La atención médica y las ciencias de la vida, las tecnologías de la información y las telecomunicaciones, y la energía y los servicios públicos forman un grupo secundario con sus propios requisitos de cumplimiento y operativos.
Se proyecta que la industria del gobierno y la administración pública se expanda a una CAGR del 27,26% hasta 2031. Los requisitos del Pilar de Datos de Confianza Cero del Departamento de Defensa de los Estados Unidos y la guía de Información No Clasificada Controlada establecen la clasificación de datos como una línea de base de seguridad federal. El NIST SP 1800-39 proporciona una referencia de implementación que respalda estos requisitos. El marco propuesto de gobernanza de datos bancarios de India también crea obligaciones de clasificación para bancos y compañías financieras no bancarias. La educación e investigación, el comercio minorista y el comercio electrónico, el transporte y la logística, y el petróleo y el gas son verticales más pequeños en los que el uso de IA y la migración a la nube están creando nuevas necesidades de clasificación.
Análisis Geográfico
América del Norte mantuvo el 42,39% de la participación del Mercado de Automatización de Clasificación de Datos en 2025. La región cuenta con una adopción temprana de la nube empresarial, requisitos maduros de seguridad de datos y una base instalada de sistemas de prevención de pérdida de datos e identidad con los que el software de clasificación puede integrarse. Estados Unidos es el principal contribuyente porque los mandatos federales, las leyes de privacidad estatales en 13 estados y las normas financieras crean necesidades de clasificación superpuestas. Canadá y México añaden demanda a través de sus marcos de privacidad y una mayor adopción de la nube en servicios financieros y atención médica. El NIST SP 1800-39, publicado en febrero de 2026, proporciona una arquitectura de referencia gubernamental para las agencias federales y sus cadenas de suministro.
Europa es el segundo bloque geográfico más grande y tiene una alta densidad regulatoria. El RGPD, DORA, NIS2 y la Ley de IA de la UE exigen que las organizaciones en entornos híbridos demuestren cobertura de clasificación de datos en múltiples marcos. Alemania, Francia, el Reino Unido y los países del BENELUX lideran la adopción a través de sus sectores de servicios financieros, manufactura y atención médica. Los requisitos de SecNumCloud de Francia añaden demanda de herramientas conformes con la soberanía. OpenText y S3NS anunciaron una asociación en abril de 2026 para respaldar la gestión de contenido y la clasificación de datos conformes con SecNumCloud para implementaciones de nube soberana francesa y europea. Las expectativas de certificación ISO 27001 y BSI C5 respaldan aún más la inversión en clasificación en toda la región.
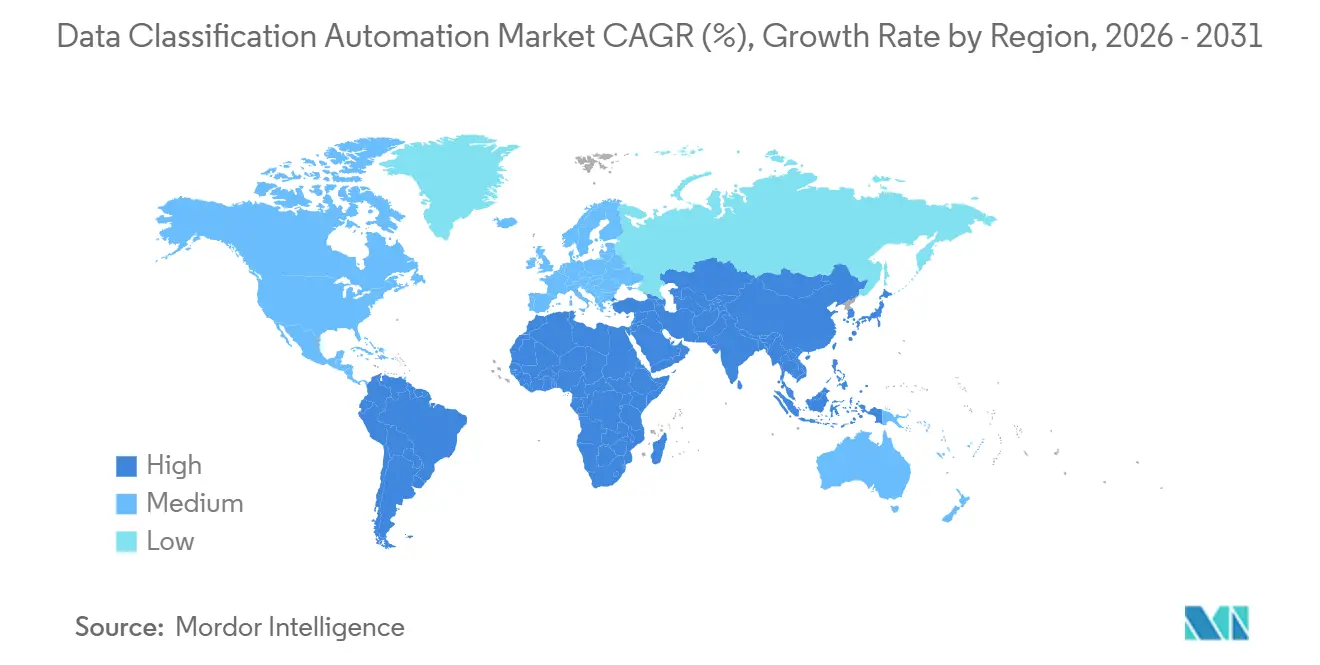
Se proyecta que Asia-Pacífico crezca a una CAGR del 28,66% hasta 2031, la tasa regional más alta. India, Japón, Corea del Sur, Australia y Singapur tienen requisitos de localización de datos que hacen que la clasificación sea necesaria antes de que la información sensible pueda trasladarse a infraestructura de nube soberana. China aplica la PIPL, GB/T 43697-2024 y los requisitos de clasificación de datos financieros que respaldan la demanda de clasificación entre las empresas nacionales. Las normas operativas de 2025 de India bajo la Ley de Protección de Datos Personales Digitales han creado un ciclo de adquisición entre entidades financieras reguladas, exportadores de servicios de TI y organizaciones de atención médica. América del Sur está emergiendo a través de la aplicación de la LGPD de Brasil y el marco actualizado de protección de datos de Argentina, con las empresas financieras de São Paulo formando un área clave de demanda. Oriente Medio y África sigue siendo la región más pequeña por ingresos, pero las normas de privacidad de Arabia Saudita y los Emiratos Árabes Unidos están creando requisitos especializados en centros financieros como ADGM y DIFC.

Panorama Competitivo
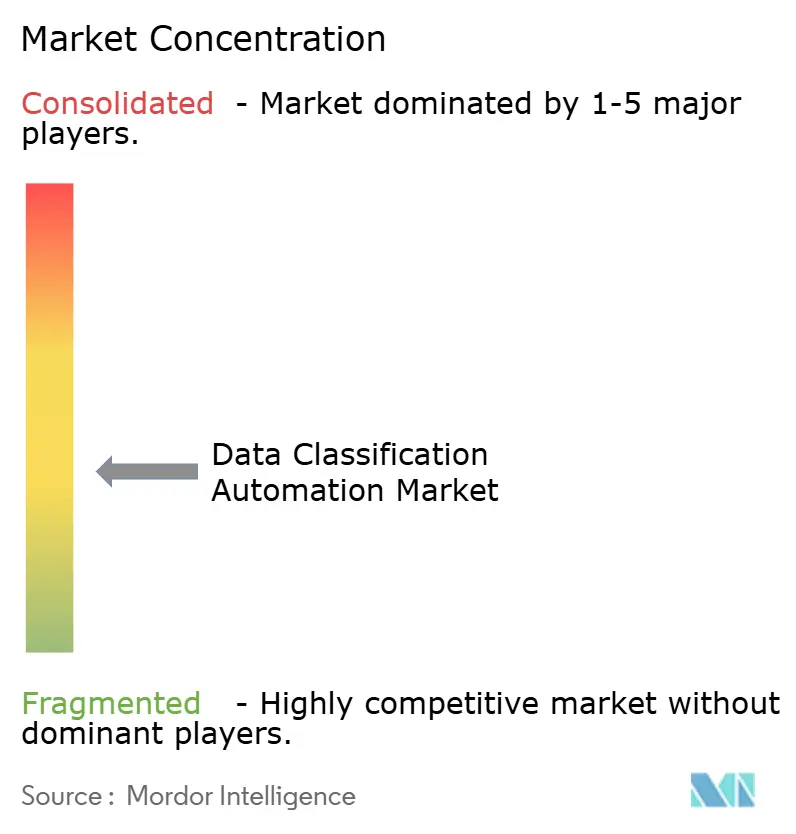
El mercado de automatización de clasificación de datos está moderadamente fragmentado, con una competencia que transita desde una estructura liderada por especialistas hacia dos grupos distintos. Los proveedores amplios de ciberseguridad y los hiperescaladores ofrecen clasificación dentro de plataformas de seguridad más amplias, mientras que los proveedores especializados compiten en precisión, transparencia y velocidad de implementación. El grupo de plataformas amplias incluye a Microsoft, IBM, Informatica y Commvault. El grupo especializado incluye a Cyera, Varonis, BigID y Sentra. Estos grupos compiten por los mismos presupuestos de gobernanza de datos empresariales, aunque utilizan modelos de entrega diferentes.
Microsoft integra Purview en Microsoft 365 y Azure, mientras que Salesforce incorporó las capacidades de catálogo de datos, gobernanza, calidad y privacidad de Informatica tras su adquisición en noviembre de 2025. Commvault amplió sus capacidades de seguridad de datos e IA en marzo de 2026 tras adquirir Satori, extendiendo el descubrimiento automatizado, la clasificación y la evaluación de riesgos a datos estructurados y bases de datos vectoriales. Palo Alto Networks anunció su intención de adquirir Portkey en abril de 2026 para añadir control centralizado y gobernanza de clasificación para las comunicaciones de agentes de IA autónomos a Prisma AIRS. Forcepoint y F5 formaron una alianza en marzo de 2026 que combina la gestión de la postura de seguridad de datos nativa de IA y la clasificación con pruebas de penetración de IA y salvaguardas. Estos movimientos muestran que los proveedores están conectando la clasificación con la seguridad de IA, la resiliencia y la gobernanza de acceso.
Persisten oportunidades en las ofertas SaaS diseñadas para pequeñas y medianas empresas, donde las plantillas regulatorias prediseñadas pueden reducir el trabajo de implementación. La IA agéntica crea una necesidad distinta de gobernanza sobre los datos a los que se accede y transforma sin revisión humana. Las ofertas compatibles con la nube soberana también son importantes en Alemania, Francia, India y Australia, donde las organizaciones deben utilizar infraestructura nacional para datos sensibles. Concentric AI, Seclore y Ground Labs abordan requisitos más específicos, incluida la gestión de derechos y la clasificación de datos financieros en Asia-Pacífico.
Líderes de la Industria de Automatización de Clasificación de Datos
-
Microsoft Corporation
-
International Business Machines Corporation
-
Varonis Systems, Inc.
-
BigID, Inc.
-
Informatica Inc.
- *Nota aclaratoria: los principales jugadores no se ordenaron de un modo en especial

Desarrollos Recientes de la Industria
- Septiembre de 2026: Palo Alto Networks completó la adquisición de Console, una plataforma de seguridad agéntica nativa de IA, integrándola en su cartera Cortex para habilitar la investigación de alertas impulsada por lenguaje natural y flujos de trabajo de remediación automatizada en entornos de gestión de la postura de seguridad de datos.
- Junio de 2026: Cyera recaudó 600 millones de USD en una ronda Serie G con una valoración de 12 mil millones de USD, elevando la financiación total a 2,3 mil millones de USD; la ronda fue liderada por Evolution Equity Partners, con Cyberstarts y Temasek entre los nuevos inversores, y está destinada a escalar el motor de clasificación de la empresa para la seguridad de IA empresarial a escala de exabytes.
- Abril de 2026: OpenText y S3NS (una alianza de Thales y Google Cloud) anunciaron una asociación estratégica para ofrecer gestión de contenido y clasificación de datos conformes con SecNumCloud para entornos de nube soberana francesa y europea, respaldando el cumplimiento del RGPD y SecNum 3.2.
- Abril de 2026: Palo Alto Networks anunció su intención de adquirir Portkey, una plataforma de puerta de enlace de IA que procesa billones de tokens por mes, para integrar el control centralizado y la gobernanza de clasificación sobre las comunicaciones de agentes de IA autónomos en su plataforma Prisma AIRS.


Alcance del Informe Global del Mercado de Automatización de Clasificación de Datos
El mercado de automatización de clasificación de datos abarca soluciones impulsadas por IA y aprendizaje automático que descubren, escanean y categorizan automáticamente datos sensibles en fuentes de datos estructuradas y no estructuradas sin intervención manual. Este mercado se centra en identificar y etiquetar tipos de datos como información de identificación personal, información de tarjetas de pago, información de salud protegida, registros financieros y propiedad intelectual, analizando patrones de contenido, contexto y metadatos a escala en entornos locales, en la nube e híbridos. La automatización elimina los cuellos de botella de la clasificación manual mediante la supervisión continua de los repositorios de datos, la aplicación de esquemas de clasificación regulatorios y organizacionales, la detección de la sensibilidad de los datos en tiempo real y la habilitación de controles de seguridad posteriores como cifrado, restricciones de acceso y políticas de prevención de pérdida de datos basadas en etiquetas de clasificación automatizadas para respaldar los requisitos de cumplimiento del RGPD, la CCPA, la HIPAA y PCI-DSS.
El Informe del Mercado de Automatización de Clasificación de Datos está Segmentado por Componente (Software y Servicios), Modo de Implementación (Basado en la Nube, Local e Híbrido), Tamaño de Organización (Grandes Empresas y Pequeñas y Medianas Empresas), Entorno de Datos (Datos Estructurados, Datos No Estructurados y Datos Semiestructurados), Vertical Industrial (Gobierno y Administración Pública, Manufactura Industrial, Comercio Minorista y Comercio Electrónico, Transporte y Logística, Energía y Servicios Públicos, Petróleo y Gas, Tecnologías de la Información y Telecomunicaciones, Medios de Comunicación y Entretenimiento, Educación e Instituciones de Investigación, Atención Médica y Ciencias de la Vida, Banca, Servicios Financieros y Seguros (BFSI), y Otros Verticales Industriales), y Geografía (América del Norte, América del Sur, Europa, Asia-Pacífico, y Oriente Medio y África). Los Pronósticos del Mercado se Proporcionan en Términos de Valor (USD).
| Software |
| Servicios |
| Basado en la Nube |
| Local |
| Híbrido |
| Grandes Empresas |
| Pequeñas y Medianas Empresas |
| Datos Estructurados |
| Datos No Estructurados |
| Datos Semiestructurados |
| Gobierno y Administración Pública |
| Manufactura Industrial |
| Comercio Minorista y Comercio Electrónico |
| Transporte y Logística |
| Energía y Servicios Públicos |
| Petróleo y Gas |
| Tecnologías de la Información y Telecomunicaciones |
| Medios de Comunicación y Entretenimiento |
| Educación e Instituciones de Investigación |
| Atención Médica y Ciencias de la Vida |
| Banca, Servicios Financieros y Seguros (BFSI) |
| Otros Verticales Industriales |
| América del Norte | Estados Unidos | |
| Canadá | ||
| América del Sur | Brasil | |
| Argentina | ||
| México | ||
| Resto de América del Sur | ||
| Europa | Alemania | |
| Reino Unido | ||
| Francia | ||
| Italia | ||
| BENELUX | ||
| Resto de Europa | ||
| Asia-Pacífico | China | |
| Japón | ||
| India | ||
| Corea del Sur | ||
| Australia | ||
| Resto de Asia-Pacífico | ||
| Oriente Medio y África | Oriente Medio | Emiratos Árabes Unidos |
| Arabia Saudita | ||
| Resto de Oriente Medio | ||
| África | Sudáfrica | |
| Nigeria | ||
| Egipto | ||
| Resto de África | ||
| Por Componente | Software | ||
| Servicios | |||
| Por Modo de Implementación | Basado en la Nube | ||
| Local | |||
| Híbrido | |||
| Por Tamaño de Organización | Grandes Empresas | ||
| Pequeñas y Medianas Empresas | |||
| Por Entorno de Datos | Datos Estructurados | ||
| Datos No Estructurados | |||
| Datos Semiestructurados | |||
| Por Vertical Industrial | Gobierno y Administración Pública | ||
| Manufactura Industrial | |||
| Comercio Minorista y Comercio Electrónico | |||
| Transporte y Logística | |||
| Energía y Servicios Públicos | |||
| Petróleo y Gas | |||
| Tecnologías de la Información y Telecomunicaciones | |||
| Medios de Comunicación y Entretenimiento | |||
| Educación e Instituciones de Investigación | |||
| Atención Médica y Ciencias de la Vida | |||
| Banca, Servicios Financieros y Seguros (BFSI) | |||
| Otros Verticales Industriales | |||
| Por Geografía | América del Norte | Estados Unidos | |
| Canadá | |||
| América del Sur | Brasil | ||
| Argentina | |||
| México | |||
| Resto de América del Sur | |||
| Europa | Alemania | ||
| Reino Unido | |||
| Francia | |||
| Italia | |||
| BENELUX | |||
| Resto de Europa | |||
| Asia-Pacífico | China | ||
| Japón | |||
| India | |||
| Corea del Sur | |||
| Australia | |||
| Resto de Asia-Pacífico | |||
| Oriente Medio y África | Oriente Medio | Emiratos Árabes Unidos | |
| Arabia Saudita | |||
| Resto de Oriente Medio | |||
| África | Sudáfrica | ||
| Nigeria | |||
| Egipto | |||
| Resto de África | |||


Preguntas Clave Respondidas en el Informe
¿Cuál es el tamaño del mercado de automatización de clasificación de datos?
El Mercado de Automatización de Clasificación de Datos fue valorado en 1,15 mil millones de USD en 2025, se estima en 1,41 mil millones de USD en 2026 y se proyecta que alcance los 4,27 mil millones de USD en 2031. Se proyecta que registre una CAGR del 24,81% durante 2026-2031. El crecimiento refleja la necesidad de las empresas de documentar los datos utilizados en sistemas de IA, fortalecer los controles de privacidad y aplicar políticas en entornos de nube y SaaS en expansión. El pronóstico también refleja la creación de más datos en repositorios no estructurados, bases de datos estructuradas y archivos operativos semiestructurados. La clasificación se está convirtiendo en un control operativo para la gobernanza de datos y la implementación de IA, en lugar de una actividad de cumplimiento independiente, particularmente donde las empresas deben demostrar que los datos que respaldan las decisiones de IA fueron identificados, etiquetados y gestionados bajo políticas documentadas.
¿Qué impulsa la demanda de clasificación automatizada de datos?
Las obligaciones de gobernanza de IA, la expansión de las normas de privacidad, el crecimiento de los datos no estructurados y la adopción de la nube híbrida respaldan la demanda. Las empresas necesitan identificar y etiquetar información en documentos, bases de datos, plataformas de colaboración, servicios en la nube y flujos de trabajo internos de IA. Los requisitos de registros auditables también hacen que la clasificación sea relevante para los programas de cumplimiento, la gestión de accesos, la prevención de pérdida de datos, el cifrado y el uso seguro de modelos de IA. El contenido interno generado por IA también puede contener información regulada o propietaria, lo que extiende la necesidad de clasificación desde las entradas hasta las salidas de los modelos. Las necesidades regulatorias y operativas están convergiendo, por tanto, en torno a los mismos controles de datos, lo que hace importante utilizar etiquetas consistentes en todas las unidades de negocio, repositorios y los sistemas que aplican políticas de acceso, protección y retención.
¿Qué componente lidera el gasto en automatización de clasificación de datos?
El software lideró con una participación de ingresos del 67,39% en 2025, porque los motores de escaneo, las reglas de clasificación y las etiquetas de sensibilidad respaldan los controles posteriores. Estas herramientas proporcionan la capa de clasificación que permite la aplicación consistente de políticas mediante cifrado, prevención de pérdida de datos y revocación de acceso. Los servicios también están creciendo a medida que las organizaciones necesitan ayuda con el diseño de taxonomías, las integraciones, el mapeo regulatorio, la validación de la clasificación y la preparación continua de auditorías en patrimonios de datos federados. Los servicios gestionados también pueden ayudar a las organizaciones a supervisar las brechas de clasificación cuando no pueden contratar especialistas de gobernanza dedicados. Este trabajo sigue siendo importante cuando las etiquetas empresariales locales deben alinearse con los requisitos de políticas de toda la empresa, especialmente en organizaciones donde los datos se crean y gestionan en varios departamentos, servicios en la nube y jurisdicciones con diferentes obligaciones de cumplimiento.
¿Qué modelo de implementación se expande más rápido?
Se proyecta que las implementaciones basadas en la nube crezcan a una CAGR del 26,28% hasta 2031, porque respaldan el escaneo continuo en entornos distribuidos. Este enfoque ayuda a los equipos a clasificar la información a medida que se crea y cambia, en lugar de solo durante las revisiones programadas. Los requisitos de nube soberana también crean la necesidad de herramientas que puedan operar en infraestructura nacional, mientras que los entornos híbridos requieren políticas que abarquen tanto los servicios de nube pública como los repositorios locales. Los sistemas locales mantienen un papel en entornos de defensa, servicios públicos y atención médica donde las operaciones con redes aisladas siguen siendo necesarias. El entorno resultante requiere una cobertura de clasificación consistente en varios modelos de implementación, para que los equipos de seguridad y gobernanza puedan aplicar las mismas reglas de sensibilidad incluso cuando la información permanece en un repositorio local o se mueve entre servicios en la nube.
¿Qué tipo de organización crece más rápido?
Se proyecta que las pequeñas y medianas empresas crezcan a una CAGR del 28,51% hasta 2031, a medida que las herramientas SaaS reducen las barreras de adopción. Las plantillas prediseñadas, la incorporación de bajo código y los clasificadores prediseñados ayudan a las empresas a implementar controles sin grandes equipos técnicos. Estas características son importantes donde el personal de gobernanza también gestiona las operaciones de seguridad, mientras que la Ley de IA de la UE y las obligaciones de protección de datos crean requisitos de clasificación para las organizaciones que desarrollan o implementan sistemas de IA. Las grandes empresas siguen siendo el grupo de clientes más grande porque sus patrimonios de datos multi-nube y los requisitos entre jurisdicciones hacen que los enfoques manuales sean impracticables. Ambos grupos necesitan controles que puedan adaptarse a los tipos de datos cambiantes y las obligaciones regulatorias, porque los programas efectivos requieren que las políticas de clasificación permanezcan alineadas con las taxonomías empresariales en evolución, las arquitecturas en la nube y los casos de uso de IA.
¿Qué región se proyecta que crezca más rápido?
Se proyecta que Asia-Pacífico crezca a una CAGR del 28,66% hasta 2031, respaldada por las normas de localización de datos y la expansión de los volúmenes de datos empresariales. Los estándares de clasificación de China y las normas de clasificación de datos financieros, junto con los cambios regulatorios en India y otras economías, respaldan la adopción. Las organizaciones también necesitan clasificación antes de trasladar información sensible a plataformas de nube soberana, lo que vincula el cumplimiento regulatorio, la migración a la nube, el uso de IA y la infraestructura de datos doméstica en toda la región. América del Norte siguió siendo el mayor contribuyente regional en 2025, con una participación de ingresos del 42,39% respaldada por la adopción madura de la nube y los requisitos superpuestos de seguridad de datos. Europa también tiene una demanda sostenida porque las organizaciones deben abordar conjuntamente los requisitos del RGPD, DORA, NIS2 y la Ley de IA de la UE, lo que aumenta el valor de las herramientas que pueden documentar la cobertura de clasificación y respaldar las auditorías en requisitos regulatorios superpuestos.


 Sus datos están seguros y nunca se venden ni se comparten.

