
Taille et part du marché de la découverte de données sensibles
VUE D’ENSEMBLE DU MARCHÉ
| Période d'étude | 2020 - 2031 |
|---|---|
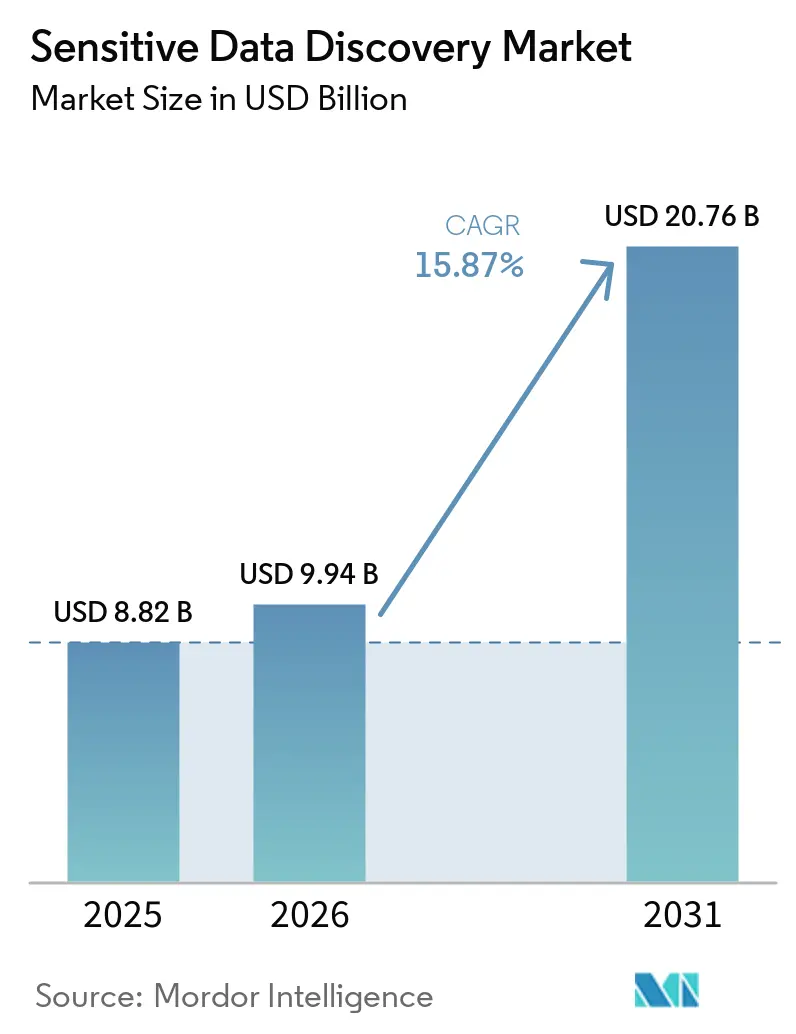
| Taille du Marché (2026) | 9.94 Milliards de dollars |
| Taille du Marché (2031) | 20.76 Milliards de dollars |
| Taux de croissance (2026 - 2031) | 15.87 % |
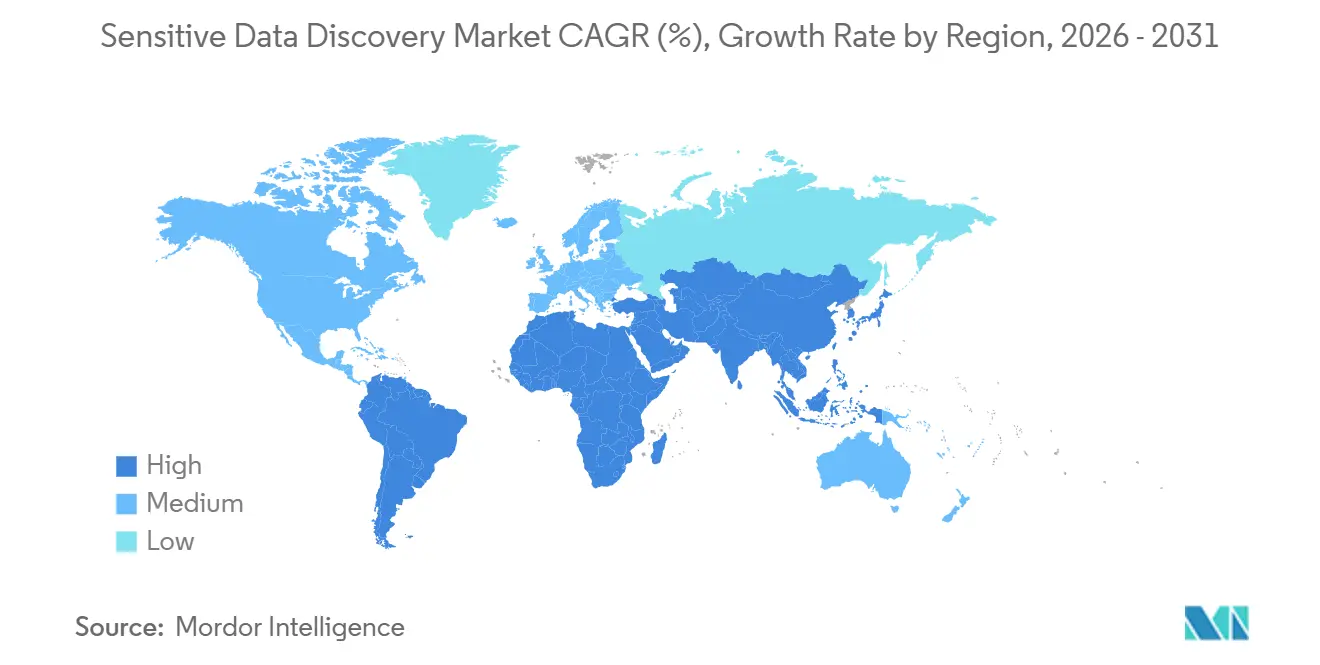
| Marché à la Croissance la Plus Rapide | Asie-Pacifique |
| Plus Grand Marché | Amérique du Nord |
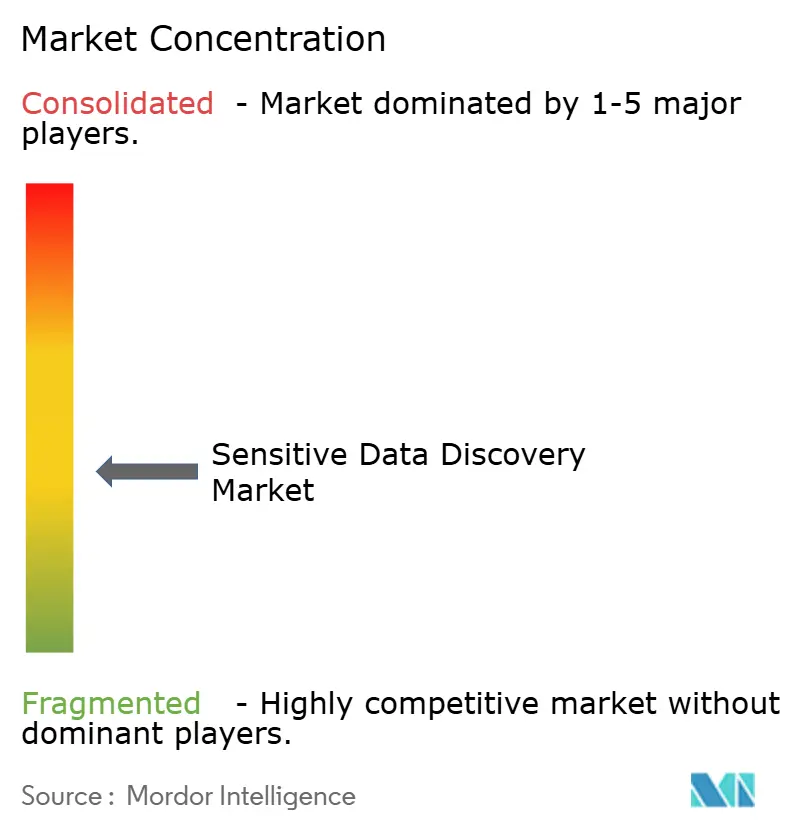
| Concentration du Marché | Moyen |
Acteurs majeurs *Avis de non-responsabilité : les principaux acteurs sont triés sans ordre particulier Image © Mordor Intelligence. La réutilisation nécessite une attribution sous CC BY 4.0. | |
Analyse du marché de la découverte de données sensibles par Mordor Intelligence
La taille du marché de la découverte de données sensibles était de 8,82 milliards USD en 2025 et devrait atteindre 20,76 milliards USD d'ici 2031, à un CAGR de 15,87 % durant la période 2026-2031. Le marché de la découverte de données sensibles est en expansion à mesure que les organisations déploient l'IA générative et des agents autonomes sur des patrimoines de données qui n'étaient pas entièrement catalogués, notamment les plateformes cloud, les applications SaaS, les anciens systèmes internes et les environnements de collaboration, ce qui modifie le périmètre de la gouvernance des données, car les outils automatisés peuvent créer, récupérer, résumer et transférer des informations sans étape de révision conventionnelle. Les réglementations en matière de confidentialité et un renforcement de leur application font également de la visibilité des données une préoccupation de la direction générale, car les organisations doivent localiser les informations personnelles ou réglementées avant de répondre à des exigences juridiques, sécuritaires ou opérationnelles. Les équipes chargées de la confidentialité, de la sécurité, des données et des activités métier ont souvent besoin du même registre indiquant où résident les informations sensibles. Les acheteurs recherchent des outils qui identifient les informations sensibles, appliquent des classifications cohérentes et soutiennent les opérations de sécurité et de conformité sur un nombre croissant de référentiels, tout en offrant une voie pratique allant de la classification aux contrôles d'accès, aux décisions de conservation et aux activités de remédiation. La concurrence s'intensifie à mesure que les fournisseurs spécialisés et les grands éditeurs de plateformes ajoutent des contrôles connexes en matière de sécurité des données, de gouvernance, de résilience et d'IA, modifiant les décisions d'achat, certaines organisations préférant une plateforme intégrée tandis que d'autres ont besoin de capacités spécialisées pour des référentiels complexes, une classification précise ou des intégrations complexes. Cette combinaison d'activité IA automatisée, d'environnements de données en mutation et d'obligations réglementaires fait de la découverte un processus opérationnel continu plutôt qu'un déploiement technologique limité.
Principaux enseignements du rapport
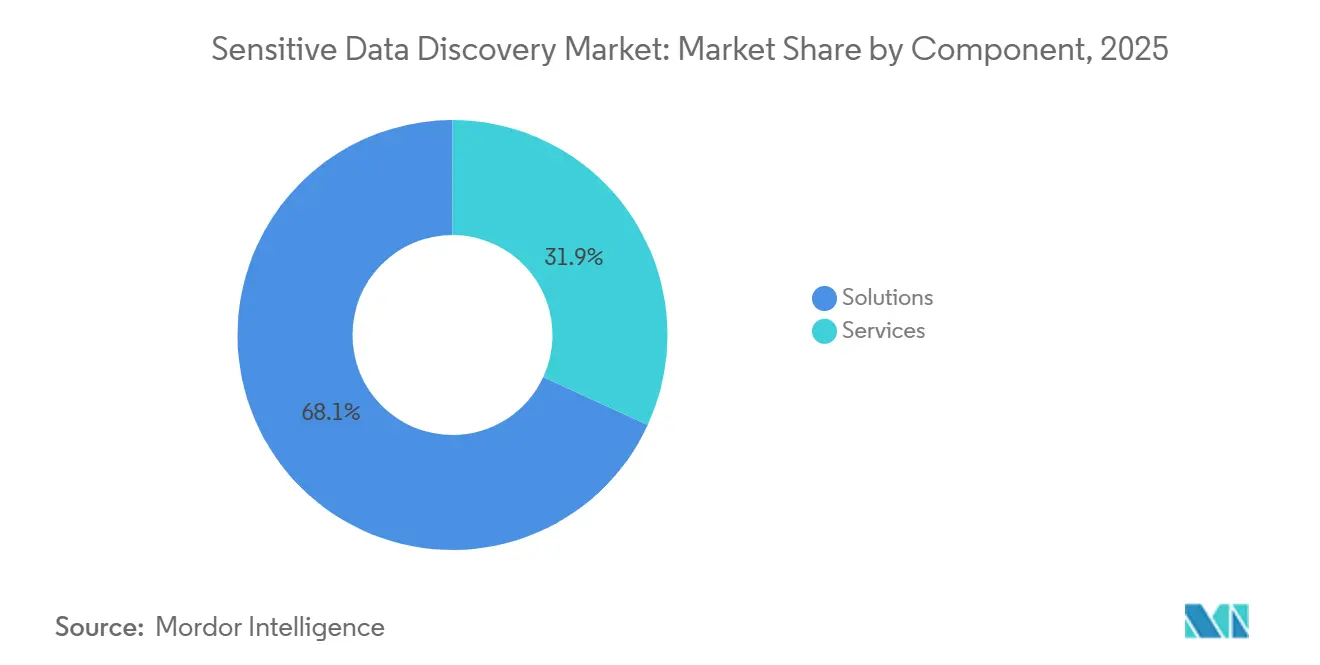
- Par composant, les solutions ont représenté 68,12 % de la part des revenus du marché de la découverte de données sensibles en 2025, tandis que les services devraient se développer à un CAGR de 18,02 % jusqu'en 2031.
- Par type de données, les données non structurées ont représenté 60,29 % de la part des revenus du marché de la découverte de données sensibles en 2025, tandis que les données semi-structurées devraient se développer à un CAGR de 17,05 % jusqu'en 2031.
- Par mode de déploiement, le déploiement cloud a représenté 62,44 % de la part des revenus du marché de la découverte de données sensibles en 2025, tandis que le déploiement hybride devrait se développer à un CAGR de 17,45 % jusqu'en 2031.
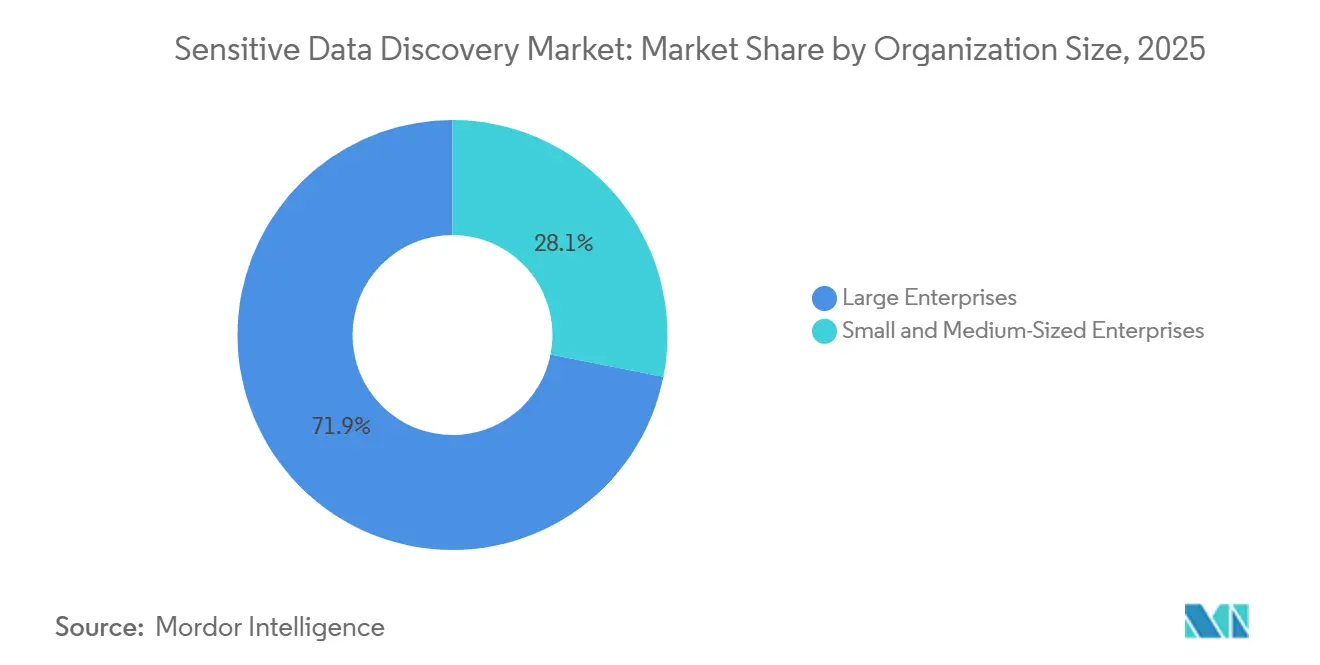
- Par taille d'organisation, les grandes entreprises ont représenté 71,89 % de la part des revenus du marché de la découverte de données sensibles en 2025, tandis que les PME devraient se développer à un CAGR de 17,71 % jusqu'en 2031.
- Par secteur d'activité, le BFSI a représenté 24,51 % de la part des revenus du marché de la découverte de données sensibles en 2025, tandis que la santé et les sciences de la vie devraient se développer à un CAGR de 16,49 % jusqu'en 2031.
- Par géographie, l'Amérique du Nord a représenté 35,74 % de la part des revenus du marché de la découverte de données sensibles en 2025, tandis que l'Asie-Pacifique devrait se développer à un CAGR de 16,78 % jusqu'en 2031.
Note : La taille du marché et les prévisions figurant dans ce rapport sont générées à l'aide du cadre d'estimation exclusif de Mordor Intelligence, mis à jour avec les dernières données et informations disponibles en janvier 2026.
Tendances et perspectives mondiales du marché de la découverte de données sensibles
Analyse de l'impact des moteurs*
| Moteur | (~) % d'impact sur les prévisions de CAGR | Pertinence géographique | Horizon temporel de l'impact |
|---|---|---|---|
| Déploiement de l'IA en entreprise sur des données non cataloguées | +3.5% | Mondial, concentré en Amérique du Nord et en Europe occidentale | Court terme (≤ 2 ans) |
| Exigences légales en matière de visibilité des données sensibles | +3.0% | Mondial, plus fort en Europe, en Amérique du Nord et dans les juridictions réglementaires d'Asie-Pacifique | Moyen terme (2-4 ans) |
| Adoption de la sécurité zéro confiance et de la conformité automatisée | +2.5% | Amérique du Nord et Europe, avec des répercussions sur les segments d'entreprises d'Asie-Pacifique et du Moyen-Orient et Afrique | Moyen terme (2-4 ans) |
| Prolifération des données cloud, SaaS et multicloud | +2.0% | Mondial, plus élevé dans les marchés matures en matière de cloud | Court terme (≤ 2 ans) |
| Exigences en matière de gouvernance des données prêtes pour l'IA et de traçabilité des données | +1.5% | Mondial, concentré dans les secteurs réglementés | Moyen terme (2-4 ans) |
| Extension de la découverte de données vers des plateformes de sécurité plus larges | +1.2% | Amérique du Nord et Europe, avec une adoption émergente en Asie-Pacifique et au Moyen-Orient et Afrique | Long terme (≥ 4 ans) |
| Source: Mordor Intelligence | |||
Déploiement de l'IA en entreprise sur des données non cataloguées
L'utilisation de l'IA générative et des agents autonomes en entreprise fait de la découverte de données une exigence de gouvernance continue, car les systèmes peuvent ingérer des partages de fichiers, des archives de courriers électroniques et des pipelines de génération augmentée par récupération à la vitesse des machines. Cyera a rapporté en juin 2026 que 68 % des organisations ne pouvaient pas distinguer l'activité humaine de l'activité des agents IA dans leurs systèmes de données, soulevant des préoccupations concernant des entrepôts de données dépourvus de classification fiable. Le projet de publication spéciale 1800-39 du NIST de février 2026 a identifié la classification automatisée comme une exigence pour la gouvernance zéro confiance et la gouvernance de l'entraînement des modèles d'IA, plaçant la classification avant les décisions de politique qui reposent sur la sensibilité des données. Les orientations établissent également un lien entre cette tâche et une planification de sécurité plus large, notamment la cryptographie résistante aux ordinateurs quantiques et la prise en charge d'analyses récurrentes plutôt que d'un inventaire ponctuel. BigID a introduit le contrôle d'accès agentique et la surveillance des activités basée sur les intentions en août 2026 pour comparer le comportement des agents IA aux objectifs déclarés. Le marché de la découverte de données sensibles gagne en pertinence, les organisations ayant besoin de comprendre à quoi les systèmes automatisés peuvent accéder et ce qu'ils peuvent déduire des informations existantes.[1]L'adoption croissante de l'IA, de l'analytique et des initiatives de gouvernance des données devrait accroître davantage la demande de solutions de découverte de données sensibles.
Exigences légales en matière de visibilité des données sensibles
L'application des réglementations sur la confidentialité rend les lacunes en matière de cartographie des données plus lourdes de conséquences, car les organisations ne peuvent pas appliquer de manière cohérente les règles de suppression, d'accès, de conservation ou de transfert si elles ne savent pas où les informations pertinentes sont stockées. Le procureur général de Californie a annoncé un règlement CCPA de 2,75 millions USD avec Disney en février 2026 et l'a décrit comme le plus grand règlement CCPA de l'histoire de la Californie. Ce règlement a montré que les défaillances en matière de gouvernance des données peuvent avoir des conséquences financières directes et nécessitent une vue auditable des informations personnelles dans l'ensemble des systèmes. Les cadres de confidentialité en Asie-Pacifique augmentent également la nécessité pour les organisations de comprendre où les informations personnelles sont stockées et qui est responsable de chaque référentiel. Cela nécessite des inventaires de données capables de soutenir la documentation, la sécurité et les décisions de traitement dans l'ensemble des unités opérationnelles et des environnements technologiques. Le marché de la découverte de données sensibles peut bénéficier lorsque les entreprises préparent des processus de découverte reproductibles avant que les obligations de conformité n'entrent en vigueur.
Adoption de la sécurité zéro confiance et de la conformité automatisée
La sécurité zéro confiance exige que les décisions d'accès reflètent la sensibilité des données, l'identité du demandeur et l'objectif, et repose donc sur un inventaire actualisé des données sensibles. Le marché de la découverte de données sensibles comble le fossé entre les contrôles d'accès basés sur l'identité et la pleine conscience des données en fournissant des informations que les moteurs de politique et les équipes de sécurité peuvent utiliser. Le rapport HPE Zero Trust Security 2026 a interrogé 851 professionnels de l'informatique et de la scurité, constatant que 56 % utilisaient l'IA ou l'apprentissage automatique pour la détection des menaces et 42 % pour l'automatisation des politiques en temps réel. Ces résultats montrent que l'automatisation de la sécurité s'intègre dans les opérations quotidiennes et que les décisions de politique automatisées nécessitent des étiquettes de données fiables. Les orientations provisoires du NIST traitent la classification comme un fondement de la conformité à la confidentialité, de l'accès zéro confiance, de la gouvernance de l'IA et de la planification cryptographique, élargissant les groupes susceptibles de soutenir un investissement. Les acheteurs évalueront probablement si une plateforme peut maintenir les classifications à jour à mesure que les référentiels et les politiques évoluent.
Prolifération des données cloud, SaaS et multicloud
Les services cloud, les applications SaaS et les déploiements multicloud ont multiplié le nombre d'emplacements où des données sensibles peuvent être stockées, notamment les entrepôts temporaires, les zones de transit analytiques et les bases de données vectorielles d'IA. Netskope a rapporté en 2026 que 87 % des organisations géraient des données sur 5 outils ou plateformes ou plus, tandis que 58 % utilisaient 11 outils de sécurité des données distincts ou plus. Ces conditions peuvent créer des angles morts lors des transferts entre applications, comptes cloud et produits de sécurité. Les copies de données de production peuvent avoir des autorisations différentes de celles des systèmes sources et peuvent ne pas figurer dans les anciens inventaires de données. Les organisations doivent identifier ces copies avant d'appliquer les exigences de conservation, d'accès ou de suppression sur des patrimoines technologiques distribués. Le marché de la découverte de données sensibles répond au besoin d'une vue plus large et plus cohérente des données cloud, SaaS et opérationnelles connectées.
Analyse de l'impact des contraintes*
| Contrainte | (~) % d'impact sur les prévisions de CAGR | Pertinence géographique | Horizon temporel de l'impact |
|---|---|---|---|
| Faux positifs dans la classification basée sur des modèles | -1.5% | Mondial, plus aigu dans les grandes entreprises des secteurs réglementés | Court terme (≤ 2 ans) |
| Connecteurs fragmentés entre systèmes hérités et systèmes sur mesure | -1.0% | Mondial, plus sévère en Asie-Pacifique et au Moyen-Orient et Afrique où les concentrations d'infrastructures héritées sont plus élevées | Moyen terme (2-4 ans) |
| Pénurie de compétences en remédiation et d'autorité des responsables métier | -0.8% | Mondial, plus aigu parmi les PME et les organisations sans fonctions de gouvernance dédiées | Moyen terme (2-4 ans) |
| Coûts de calcul, d'énergie et d'analyse complète du patrimoine | -0.6% | Mondial, avec l'impact le plus élevé dans les organisations disposant de patrimoines de données non structurées à l'échelle du pétaoctet | Long terme (≥ 4 ans) |
| Source: Mordor Intelligence | |||
Faux positifs dans la classification basée sur des modèles
Les outils de correspondance de modèles restent courants dans la classification des données sensibles et peuvent générer des faux positifs lorsqu'un modèle ressemble à des informations sensibles mais manque du contexte requis. Lorsque les alertes sont répétitivement inexactes, les analystes peuvent leur accorder moins de confiance, réduire les activités de suivi et affaiblir l'application même lorsque l'outil reste déployé. Des recherches présentées au symposium ACM 2026 sur l'ingénierie documentaire ont montré que les architectures à plusieurs étapes nécessitaient un réglage minutieux pour maintenir les taux de faux positifs en dessous de 1 % sur des types de documents hétérogènes à l'échelle de l'entreprise. Une classification de haute qualité est importante lorsque les contrôles en aval s'appuient sur les résultats sans révision humaine, car des étiquettes incorrectes peuvent déclencher des investigations inutiles ou entraver un processus légitime. Les organisations doivent tester les modèles sur des documents, des référentiels et des langues qui reflètent leurs propres environnements, ce qui rend le travail de mise en œuvre important même avec des fonctionnalités avancées d'apprentissage automatique. Le marché de la découverte de données sensibles favorise les fournisseurs qui démontrent leur précision et fournissent un processus clair pour améliorer les classifications.
Connecteurs fragmentés entre systèmes hérités et systèmes sur mesure
Une plateforme ne peut analyser que les systèmes que ses connecteurs peuvent atteindre, tandis que de nombreuses entreprises utilisent encore des systèmes de l'ère des mainframes, des applications sur mesure et des bases de données personnalisées sans interfaces standard. Ces systèmes peuvent contenir d'anciens enregistrements clients, des archives de propriété intellectuelle et des dossiers réglementaires conservés depuis de nombreuses années. Les organisations peuvent combler les lacunes grâce à des connecteurs personnalisés développés par les fournisseurs ou à des couches middleware, mais les deux ajoutent des coûts, du temps de mise en œuvre et des travaux de maintenance. Cela peut retarder un programme de découverte étendu même lorsqu'un acheteur a approuvé la technologie, en particulier dans la fabrication industrielle, le pétrole et le gaz, et l'administration gouvernementale. Le problème peut persister, la modernisation des infrastructures se poursuivant jusqu'aux années 2030, notamment dans certaines parties de l'Asie-Pacifique, de l'Amérique du Sud, du Moyen-Orient et de l'Afrique. Le marché de la découverte de données sensibles est contraint lorsque les organisations ne peuvent pas obtenir une couverture sur les sources de données les plus importantes, faisant de l'étendue des connecteurs un critère de sélection important.
*Nos prévisions considèrent les impacts des moteurs et des contraintes comme directionnels et non additifs. Les prévisions d'impact reflètent la croissance de référence, les effets de composition et les interactions entre variables.
Analyse des segments
Par composant : les services croissent plus rapidement à mesure que la complexité de mise en œuvre augmente
Les solutions ont représenté 68,12 % des revenus en 2025. Elles fournissent le logiciel permettant de localiser, classer et surveiller les informations sensibles dans les référentiels d'entreprise. Leur position dominante reflète le rôle central des capacités de la plateforme dans un programme de découverte. Les organisations ont besoin d'outils qui analysent les sources de données et présentent les résultats de classification. La part de marché des solutions de découverte de données sensibles reflète la demande de visibilité des données dans les environnements cloud, SaaS et sur site.
Les services devraient se développer à un CAGR de 18,02 % durant la période 2026-2031. Ils comprennent le conseil et l'évaluation, la mise en œuvre et l'intégration, la découverte gérée, la formation, le support et la maintenance. Le travail de mise en œuvre augmente à mesure que les organisations étendent leur couverture des environnements cloud aux référentiels sur site et aux applications SaaS héritées. La découverte gérée gagne en importance parmi les acheteurs du marché intermédiaire sans ressources internes en ingénierie des données. Le secteur de la découverte de données sensibles évolue vers un modèle de livraison soutenu par les services, avec une configuration et une remédiation se poursuivant après le déploiement.


Par type de données : les données non structurées sont en tête tandis que les données semi-structurées s'accélèrent
Les données non structurées ont représenté 60,29 % des revenus en 2025. Les documents, les courriers électroniques, les présentations et le contenu collaboratif sont difficiles à gouverner avec des contrôles axés sur les bases de données, car les informations sensibles sont intégrées dans du texte libre et des formats mixtes. Ces sources sont réparties dans des dossiers partagés et des applications métier. La position dominante reflète la nécessité de trouver des informations personnelles, financières et autres informations sensibles en dehors des champs de base de données prédéfinis. La classification contextuelle aide à distinguer le contenu sensible du texte ordinaire.
Les données semi-structurées devraient se développer à un CAGR de 17,05 % durant la période 2026-2031. La catégorie comprend les journaux JSON, les flux XML, les charges utiles d'API et les flux d'événements provenant des pipelines d'IA. Les applications natives du cloud génèrent ces enregistrements lorsqu'elles échangent des informations et capturent l'activité du système. Des identifiants sensibles peuvent apparaître dans les données opérationnelles même lorsque l'enregistrement existe à des fins de surveillance technique. Le marché de la découverte de données sensibles répond à un environnement caractérisé par une télémétrie applicative accrue et des enregistrements liés à l'IA.[2]À mesure que les organisations élargissent l'adoption de l'IA et la collecte de données générées par les machines, la demande devrait croître pour des solutions capables d'identifier, de classer et de gouverner en continu les informations sensibles intégrées dans des écosystèmes de données de plus en plus complexes.
Par mode de déploiement : les déploiements hybrides progressent à mesure que les exigences de résidence des données s'étendent
Le déploiement cloud a représenté 62,44 % des revenus en 2025. Les applications SaaS et les entrepôts de données natifs du cloud sont des emplacements importants pour les informations métier. L'analyse sans agent peut permettre la découverte sans nécessiter de modifications d'infrastructure sur chaque système cible. Cela peut simplifier la couverture initiale pour les organisations disposant d'environnements cloud distribués. Le déploiement cloud prend également en charge la mise à l'échelle à mesure que de nouveaux référentiels sont ajoutés.
Le déploiement hybride devrait se développer à un CAGR de 17,45 % jusqu'en 2031. Les exigences de résidence et de souveraineté des données peuvent limiter le passage à une conception purement cloud. De nombreuses organisations ne peuvent pas retirer leur infrastructure sur site durant la période de prévision. Le déploiement sur site reste pertinent pour les environnements de défense à isolation physique, les gouvernements classifiés et les services financiers réglementés. Les fournisseurs disposant d'une gestion unifiée des politiques dans les environnements cloud, sur site et SaaS peuvent répondre à la taille du marché de la découverte de données sensibles associée à ces patrimoines mixtes.
Par taille d'organisation : les PME accélèrent leur adoption à mesure que l'économie des plateformes évolue
Les grandes entreprises ont représenté 71,89 % des revenus en 2025. Elles gèrent des patrimoines de données plus importants, opèrent dans plusieurs juridictions et peuvent financer des plateformes, des intégrations et des équipes de gouvernance dédiées. Ces conditions ont fait des grandes organisations les premiers acheteurs de capacités de découverte étendues. Leurs environnements comprennent souvent des services cloud, des systèmes hérités et de nombreuses unités opérationnelles. La part du marché de la découverte de données sensibles détenue par les grandes entreprises reflète cette combinaison de complexité des données et de coûts de conformité.
Les PME devraient se développer à un CAGR de 17,71 % durant la période 2026-2031. La tarification SaaS basée sur la consommation peut réduire l'investissement initial qui limitait l'accès aux capacités de découverte. Les organisations plus petites font également face à des pénalités légales et à des exigences de conformité de la chaîne d'approvisionnement. IBM a rapporté un coût moyen mondial de violation de données de 4,99 millions USD en 2026, basé sur 602 organisations victimes de violations entre mars 2025 et février 2026. Les fournisseurs natifs du cloud tels que Nightfall AI et Sentra offrent une couverture de classification sans la charge de services professionnels courante dans les grands déploiements.
Par secteur d'activité : le BFSI est en tête tandis que la santé et les sciences de la vie s'accélèrent
Le BFSI a représenté 24,51 % des revenus en 2025. Les institutions financières gèrent des données de paiement, des enregistrements clients, des informations sur les transactions et d'autres classes de données à haute valeur. Elles font face à des exigences simultanées, notamment PCI DSS 4.0.1, DORA, NYDFS Part 500 et la règle de protection GLBA. PCI DSS 4.0.1 est entré pleinement en vigueur en mars 2025, et le matériel fourni identifie NYDFS Part 500 comme pleinement appliqué en 2026. IBM a classé les services financiers comme le deuxième secteur le plus coûteux en matière de violations de données, avec 6,29 millions USD par incident dans son rapport 2026.
La santé et les sciences de la vie devraient se développer à un CAGR de 16,49 % durant la période 2026-2031. Le secteur détient des informations de santé protégées, des dossiers cliniques et des données liées à la recherche sur de nombreux systèmes. Le bureau des droits civils du HHS a réglé 4 enquêtes sur les rançongiciels liées à la règle de sécurité HIPAA pour 1,165 million USD en avril 2026 et a cité chaque entité pour des manquements à la réalisation des analyses de risques requises. Le gouvernement et l'administration publique, les technologies de l'information et les télécommunications, ainsi que le commerce de détail et le commerce électronique constituent le prochain niveau de demande, le commerce de détail étant soutenu par les enregistrements de paiement et comportementaux issus de la collecte omnicanale. La croissance plus rapide de la santé reflète un écart de maturité en matière de découverte par rapport aux institutions financières.
Analyse géographique
L'Amérique du Nord a représenté 35,74 % des revenus en 2025. La région combine une forte concentration d'entreprises natives du cloud avec des exigences fédérales et étatiques qui se chevauchent. Elle dispose également d'un écosystème de fournisseurs mature, avec BigID, Varonis, Cyera, Nightfall AI et Sentra dont le siège social est aux États-Unis. Le procureur général de Californie a annoncé un règlement CCPA de 2,75 millions USD avec Disney en février 2026. Le bureau l'a décrit comme le plus grand règlement CCPA de l'histoire de la Californie.[3]L'intensification de l'application réglementaire et la hausse des pénalités financières pour les défaillances en matière de gouvernance des données devraient accélérer les investissements dans les solutions de découverte de données sensibles.
L'Asie-Pacifique devrait se développer à un CAGR de 16,78 % durant la période 2026-2031. La taille du marché de la découverte de données sensibles dans la région est soutenue par des cadres de confidentialité nouveaux et renforcés. Les exigences en matière de confidentialité accroissent la nécessité de processus de découverte, de classification et de documentation dans les environnements cloud, SaaS et sur site. La transformation numérique et l'activation réglementaire soutiennent le profil de croissance plus rapide de la région. Ces conditions renforcent la nécessité de pratiques cohérentes de traitement des données.
L'Europe a détenu la deuxième part de revenus la plus importante en 2025. La préférence de l'Allemagne pour les déploiements souverains européens et sur site soutient les architectures hybrides. La France a publié le décret n° 2026-272 en avril 2026, exigeant la qualification SecNumCloud pour les services cloud traitant des données d'État sensibles. L'Amérique du Sud est une opportunité en phase initiale soutenue par l'application de la LGPD brésilienne, tandis que le Moyen-Orient et l'Afrique se développent à travers des cadres nationaux de gouvernance des données.

Paysage concurrentiel
Le marché de la découverte de données sensibles est modérément fragmenté. Les fournisseurs spécialisés comprennent BigID, Cyera, Sentra, Netwrix, Spirion, Ground Labs et Nightfall AI, tandis que les grands éditeurs de plateformes comprennent Microsoft via Purview, Palo Alto Networks via Cortex Cloud, IBM via Guardium et Informatica. Ces fournisseurs se font concurrence sur la couverture de découverte, la qualité de la classification, l'intégration et le lien entre la découverte et des contrôles plus larges. Les acheteurs peuvent choisir entre la profondeur spécialisée et une relation de plateforme plus large. Le marché de la découverte de données sensibles comprend à la fois des produits ponctuels et des plateformes intégrées de gouvernance et de sécurité.
Cyera a levé 600 millions USD à une valorisation de 12 milliards USD en juin 2026 et a déclaré que le capital total levé dépassait 2,3 milliards USD. Elle a également déclaré que le chiffre d'affaires annuel récurrent avait triplé pendant 3 années consécutives et qu'elle avait réalisé 5 acquisitions au cours des 18 mois précédents, notamment Ryft et Genie pour la gouvernance de l'IA agentique. Veeam a finalisé son acquisition de Securiti AI pour 1,725 milliard USD en décembre 2025, combinant la résilience des données avec la gestion de la posture de sécurité des données, la confidentialité, la gouvernance et la confiance dans l'IA. La documentation Purview de Microsoft confirme des intégrations avec Varonis, Cyera et BigID. Ces mouvements montrent à la fois des opportunités de consolidation et de partenariat pour les fournisseurs spécialisés.[4]Le marché devrait connaître de nouvelles opportunités de croissance à mesure que les entreprises recherchent des plateformes intégrées combinant la découverte de données, la gouvernance, la confidentialité, la confiance dans l'IA et les capacités de cyber-résilience au sein d'un cadre unifié de sécurité des données.
BigID a annoncé le contrôle d'accès agentique et la surveillance des activités basée sur les intentions en août 2026, tandis que Netwrix a annoncé des capacités de gouvernance de l'IA pour les environnements Microsoft hybrides en juin 2026. Proofpoint a mis à disposition des capacités améliorées de gestion de la posture de sécurité des données européennes en août 2026, notamment la découverte et la classification assistées par l'IA dans les principales langues d'affaires européennes depuis un centre de données à Francfort. Des opportunités subsistent dans les profils sectoriels spécifiques pour les données génomiques et d'essais cliniques, la gouvernance des données d'entraînement de l'IA et la découverte en tant que service pour les PME. Le marché de la découverte de données sensibles pourrait récompenser les fournisseurs qui combinent les exigences locales avec des résultats d'intégration et de classification fiables.
Leaders du secteur de la découverte de données sensibles
-
OpenText Corporation
-
IBM Corporation
-
Microsoft Corporation
-
Palo Alto Networks, Inc.
-
Varonis Systems, Inc.
- *Avis de non-responsabilité : les principaux acteurs sont triés sans ordre particulier

Développements récents du secteur
- Août 2026 : BigID a annoncé le contrôle d'accès agentique et la surveillance des activités basée sur les intentions lors de Black Hat, étendant sa plateforme pour gouverner l'accès aux données des agents IA en fonction de l'objectif déclaré et du comportement observé. Cette capacité a comblé les lacunes de gouvernance créées lorsque les autorisations statiques ne pouvaient pas s'adapter à l'activité des agents chaînés à la vitesse des machines sur des entrepôts de données réglementés.
- Août 2026 : Proofpoint a mis à disposition des capacités améliorées de gestion de la posture de sécurité des données européennes, notamment la découverte et la classification assistées par l'IA dans les principales langues d'affaires européennes, hébergées depuis son centre de données de Francfort, en Allemagne. La version, annoncée en février 2026, ciblait directement les entreprises ayant des exigences de résidence des données et de conformité à la loi européenne sur l'IA.
- Juin 2026 : Cyera a levé 600 millions USD lors d'un tour de table de série D à une valorisation de 12 milliards USD, dirigé par Evolution Equity Partners, avec la participation de Cyberstarts et Temasek, portant le financement total à plus de 2,3 milliards USD. Cyera a révélé que le chiffre d'affaires annuel récurrent avait triplé sur 3 années consécutives et que 5 acquisitions avaient été réalisées au cours des 18 mois précédents, notamment Ryft et Genie pour la gouvernance de l'IA agentique.
- Juin 2026 : Netwrix a dévoilé de nouvelles capacités de gouvernance de l'IA pour les environnements Microsoft hybrides via sa plateforme SaaS 1Secure, ajoutant une visibilité et un contrôle sur l'accès aux données sensibles par les agents IA et Microsoft Copilot dans les configurations sur site et cloud.


Périmètre du rapport mondial sur le marché de la découverte de données sensibles
Le marché de la découverte de données sensibles comprend des solutions et des services qui permettent aux organisations d'identifier, de classer, d'inventorier, de surveiller et de gérer les données sensibles dans des référentiels de données structurées, semi-structurées et non structurées. Ces solutions aident les organisations à découvrir les informations personnellement identifiables (PII), les informations de santé protégées (PHI), les données de cartes de paiement, la propriété intellectuelle, les informations commerciales confidentielles et d'autres actifs de données réglementés ou sensibles dans des environnements sur site, cloud et hybrides. Les plateformes de découverte de données sensibles soutiennent les initiatives de protection des données, de conformité à la confidentialité, de cybersécurité, de gouvernance, de gestion des risques, de minimisation des données et de reporting réglementaire en offrant une visibilité sur l'emplacement, le mouvement et l'exposition des informations sensibles.
Le rapport sur le marché de la découverte de données sensibles est segmenté par composant (solutions et services [services de conseil et d'évaluation, services de mise en œuvre et d'intégration, services gérés de découverte de données sensibles, et services de formation, de support et de maintenance]), type de données (données structurées, données non structurées et données semi-structurées), mode de déploiement (cloud, sur site et hybride), taille d'organisation (grandes entreprises et petites et moyennes entreprises), secteur d'activité (gouvernement et administration publique, fabrication industrielle, technologies de l'information et télécommunications, santé et sciences de la vie, banque, services financiers et assurance [BFSI] et autres secteurs d'activité) et géographie (Amérique du Nord, Amérique du Sud, Europe, Asie-Pacifique et Moyen-Orient et Afrique). Les prévisions du marché sont fournies en termes de valeur (USD).
| Solutions | |
| Services | Services de conseil et d'évaluation |
| Services de mise en œuvre et d'intégration | |
| Services gérés de découverte de données sensibles | |
| Services de formation, de support et de maintenance |
| Données structurées |
| Données non structurées |
| Données semi-structurées |
| Cloud |
| Sur site |
| Hybride |
| Grandes entreprises |
| Petites et moyennes entreprises |
| Gouvernement et administration publique |
| Fabrication industrielle |
| Technologies de l'information et télécommunications |
| Santé et sciences de la vie |
| Banque, services financiers et assurance (BFSI) |
| Autres secteurs d'activité |
| Amérique du Nord | États-Unis | |
| Canada | ||
| Amérique du Sud | Brésil | |
| Mexique | ||
| Reste de l'Amérique du Sud | ||
| Europe | Allemagne | |
| Royaume-Uni | ||
| France | ||
| Italie | ||
| Reste de l'Europe | ||
| Asie-Pacifique | Chine | |
| Japon | ||
| Inde | ||
| Corée du Sud | ||
| Reste de l'Asie-Pacifique | ||
| Moyen-Orient et Afrique | Moyen-Orient | Émirats arabes unis |
| Arabie saoudite | ||
| Reste du Moyen-Orient | ||
| Afrique | Afrique du Sud | |
| Reste de l'Afrique | ||
| Par composant | Solutions | ||
| Services | Services de conseil et d'évaluation | ||
| Services de mise en œuvre et d'intégration | |||
| Services gérés de découverte de données sensibles | |||
| Services de formation, de support et de maintenance | |||
| Par type de données | Données structurées | ||
| Données non structurées | |||
| Données semi-structurées | |||
| Par mode de déploiement | Cloud | ||
| Sur site | |||
| Hybride | |||
| Par taille d'organisation | Grandes entreprises | ||
| Petites et moyennes entreprises | |||
| Par secteur d'activité | Gouvernement et administration publique | ||
| Fabrication industrielle | |||
| Technologies de l'information et télécommunications | |||
| Santé et sciences de la vie | |||
| Banque, services financiers et assurance (BFSI) | |||
| Autres secteurs d'activité | |||
| Par géographie | Amérique du Nord | États-Unis | |
| Canada | |||
| Amérique du Sud | Brésil | ||
| Mexique | |||
| Reste de l'Amérique du Sud | |||
| Europe | Allemagne | ||
| Royaume-Uni | |||
| France | |||
| Italie | |||
| Reste de l'Europe | |||
| Asie-Pacifique | Chine | ||
| Japon | |||
| Inde | |||
| Corée du Sud | |||
| Reste de l'Asie-Pacifique | |||
| Moyen-Orient et Afrique | Moyen-Orient | Émirats arabes unis | |
| Arabie saoudite | |||
| Reste du Moyen-Orient | |||
| Afrique | Afrique du Sud | ||
| Reste de l'Afrique | |||


Questions clés auxquelles le rapport répond
Quelle est la taille du marché de la découverte de données sensibles ?
Le marché de la découverte de données sensibles était de 8,82 milliards USD en 2025 et devrait atteindre 20,76 milliards USD d'ici 2031, à un CAGR de 15,87 % durant la période 2026-2031.
Qu'est-ce qui stimule la demande de plateformes de découverte de données sensibles ?
L'adoption de l'IA générative, l'application des réglementations sur la confidentialité, les programmes zéro confiance et la prolifération des données dans les environnements cloud et SaaS augmentent la demande, en particulier lorsque les entreprises ont besoin d'une visibilité continue sur les référentiels hérités et nouveaux, de classer les informations de manière cohérente et de connecter les résultats aux actions d'accès, de conservation et de remédiation.
Quel composant devrait connaître la croissance la plus rapide jusqu'en 2031 ?
Les services devraient se développer à un CAGR de 18,02 % car les acheteurs ont besoin de mise en œuvre, d'intégration, de découverte gérée, de formation, de support et d'assistance pour la configuration et la remédiation continues.
Quel modèle de déploiement connaît la croissance la plus rapide ?
Le déploiement hybride devrait se développer à un CAGR de 17,45 % jusqu'en 2031, car de nombreuses organisations ont besoin de prendre en charge des données cloud et sur site tout en répondant aux exigences de résidence des données.
Quelle région devrait connaître la croissance la plus rapide ?
L'Asie-Pacifique devrait se développer à un CAGR de 16,78 % durant la période 2026-2031, les cadres de confidentialité et la transformation numérique augmentant les investissements en matière de conformité.
Quel secteur offre l'opportunité de croissance la plus rapide ?
La santé et les sciences de la vie devraient se développer à un CAGR de 16,49 % jusqu'en 2031, soutenues par la nécessité d'améliorer la visibilité sur les informations de santé protégées dans des systèmes cliniques complexes.


 Vos données sont sécurisées et ne sont jamais vendues ni partagées.

