
Marktgröße und Marktanteil im Bereich Sensitive Data Discovery
Marktübersicht
| Studienzeitraum | 2020 - 2031 |
|---|---|
| Marktgröße (2026) | 9.94 Milliarden US-Dollar |
| Marktgröße (2031) | 20.76 Milliarden US-Dollar |
| Wachstumsrate (2026 - 2031) | 15.87 % |
| Schnellstwachsender Markt | Asien-Pazifik |
| Größter Markt | Nordamerika |
| Marktkonzentration | Mittel |
Hauptakteure *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert Bild © Mordor Intelligence. Wiederverwendung erfordert Namensnennung gemäß CC BY 4.0. | |
Marktanalyse für Sensitive Data Discovery von Mordor Intelligence
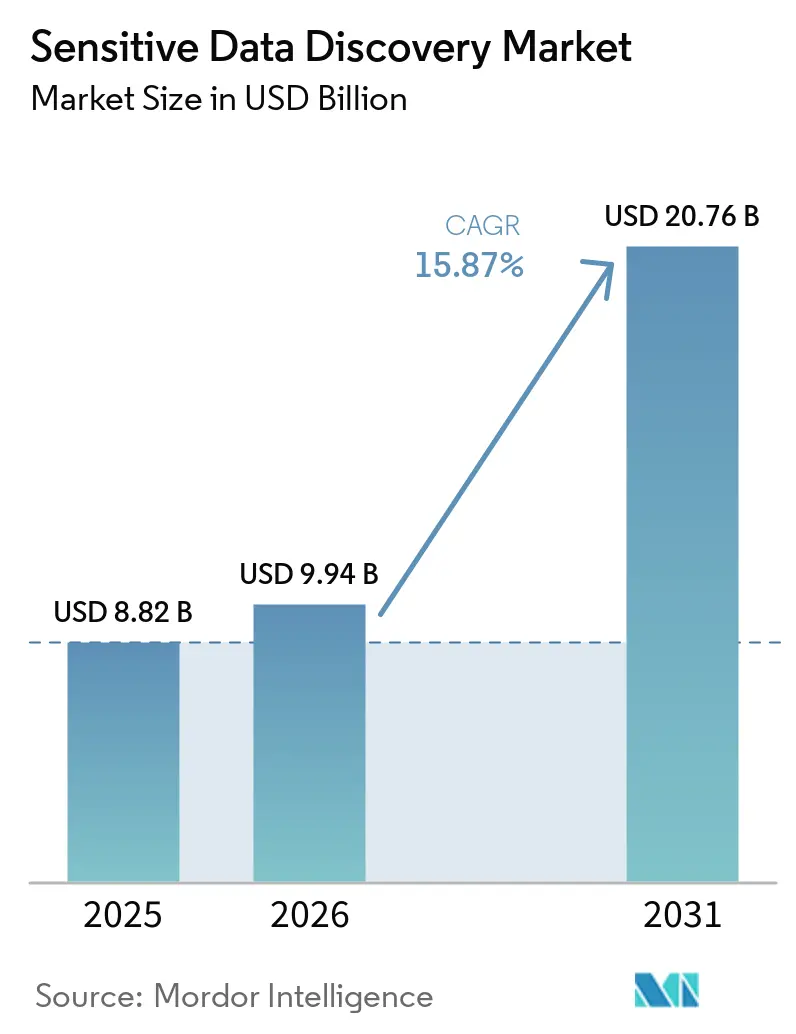
Die Marktgröße für Sensitive Data Discovery betrug 2025 8,82 Milliarden USD und wird voraussichtlich bis 2031 auf 20,76 Milliarden USD anwachsen, bei einer CAGR von 15,87 % im Zeitraum 2026–2031. Der Markt für Sensitive Data Discovery expandiert, da Unternehmen generative KI und autonome Agenten in Datenbeständen einsetzen, die nicht vollständig katalogisiert wurden – darunter Cloud-Plattformen, SaaS-Anwendungen, ältere interne Systeme und Kollaborationsumgebungen –, was den Umfang der Datenverwaltung verändert, weil automatisierte Tools Informationen ohne einen herkömmlichen Prüfschritt erstellen, abrufen, zusammenfassen und übertragen können. Datenschutzvorschriften und eine aktivere Durchsetzung machen Datentransparenz auch zu einem Anliegen des Senior Managements, da Unternehmen persönliche oder regulierte Informationen lokalisieren müssen, bevor sie auf rechtliche, sicherheitsbezogene oder betriebliche Anforderungen reagieren können. Datenschutz-, Sicherheits-, Daten- und Geschäftsteams benötigen häufig denselben Überblick darüber, wo sich sensible Informationen befinden. Käufer suchen nach Tools, die sensible Informationen identifizieren, konsistente Klassifizierungen anwenden und Sicherheits- sowie Compliance-Vorgänge über eine wachsende Anzahl von Repositories hinweg unterstützen und dabei auch einen praktischen Weg von der Klassifizierung zu Zugriffskontrollen, Aufbewahrungsentscheidungen und Abhilfemaßnahmen bieten. Der Wettbewerb nimmt zu, da Spezialanbieter und größere Plattformanbieter verwandte Datensicherheits-, Governance-, Resilienz- und KI-Kontrollen hinzufügen, was Kaufentscheidungen verändert, da einige Unternehmen eine integrierte Plattform bevorzugen, während andere spezialisierte Fähigkeiten für schwierige Repositories, präzise Klassifizierung oder komplexe Integrationen benötigen. Diese Kombination aus automatisierter KI-Aktivität, sich verändernden Datenumgebungen und regulatorischen Verpflichtungen macht die Erkennung zu einem kontinuierlichen operativen Prozess und nicht zu einem begrenzten Technologieeinsatz.
Wichtigste Erkenntnisse des Berichts
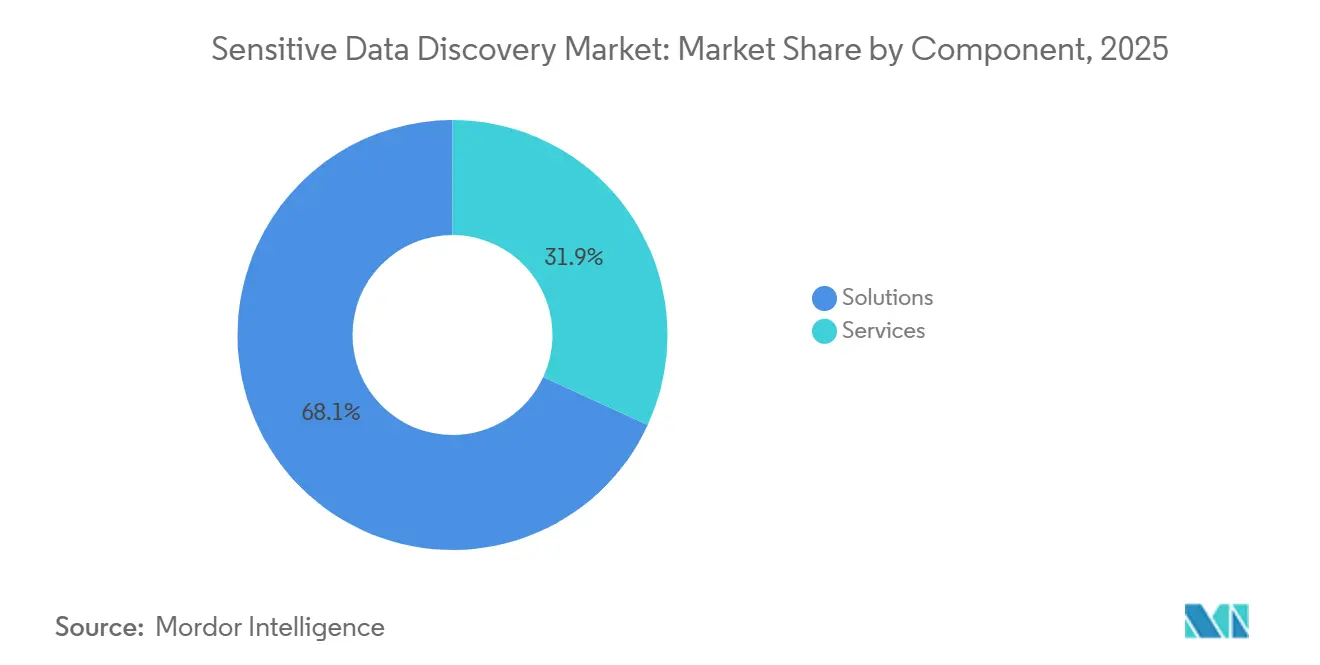
- Nach Komponente hielten Lösungen 2025 einen Umsatzanteil von 68,12 % am Markt für Sensitive Data Discovery, während Dienstleistungen bis 2031 voraussichtlich mit einer CAGR von 18,02 % wachsen werden.
- Nach Datentyp hielt unstrukturierte Daten 2025 einen Umsatzanteil von 60,29 % am Markt für Sensitive Data Discovery, während semi-strukturierte Daten bis 2031 voraussichtlich mit einer CAGR von 17,05 % wachsen werden.
- Nach Bereitstellungsmodus hielt die Cloud-Bereitstellung 2025 einen Umsatzanteil von 62,44 % am Markt für Sensitive Data Discovery, während die Hybrid-Bereitstellung bis 2031 voraussichtlich mit einer CAGR von 17,45 % wachsen wird.
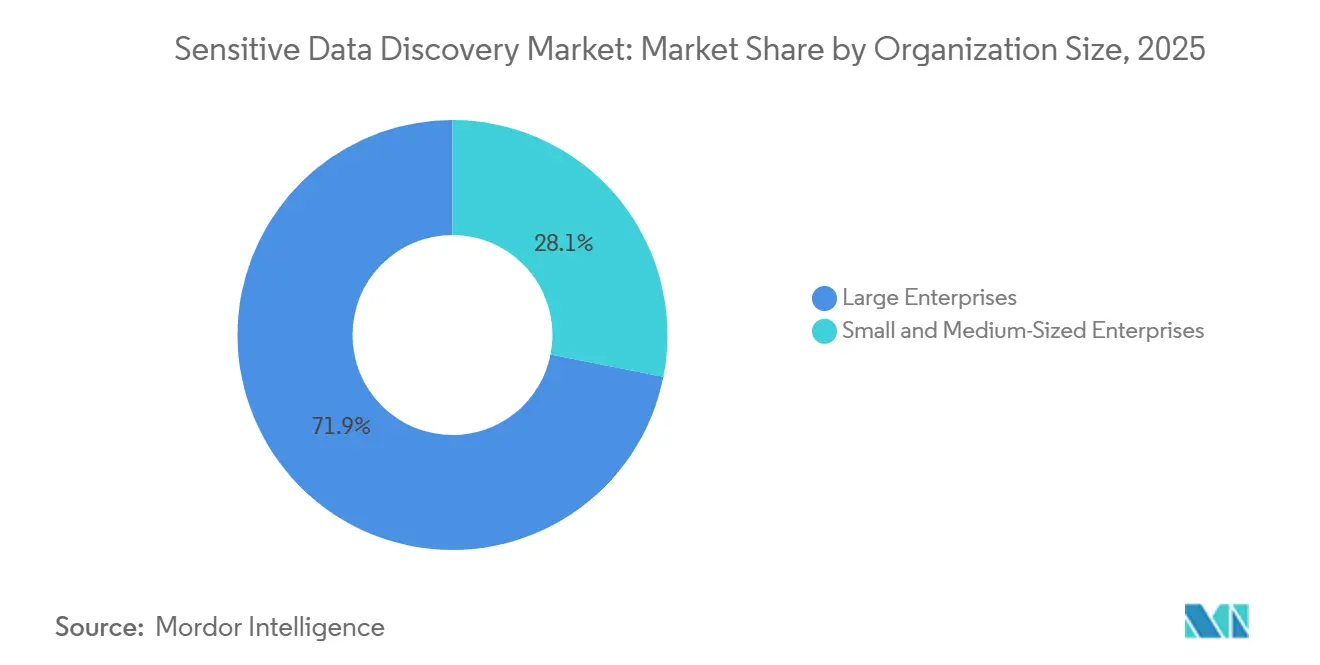
- Nach Unternehmensgröße hielten Großunternehmen 2025 einen Umsatzanteil von 71,89 % am Markt für Sensitive Data Discovery, während KMU bis 2031 voraussichtlich mit einer CAGR von 17,71 % wachsen werden.
- Nach Branchenvertikale hielt BFSI 2025 einen Umsatzanteil von 24,51 % am Markt für Sensitive Data Discovery, während das Gesundheitswesen und die Biowissenschaften bis 2031 voraussichtlich mit einer CAGR von 16,49 % wachsen werden.
- Nach Geografie hielt Nordamerika 2025 einen Umsatzanteil von 35,74 % am Markt für Sensitive Data Discovery, während der asiatisch-pazifische Raum bis 2031 voraussichtlich mit einer CAGR von 16,78 % wachsen wird.
Hinweis: Die Marktgröße und Prognosezahlen in diesem Bericht werden mithilfe des proprietären Schätzungsrahmens von Mordor Intelligence erstellt und mit den neuesten verfügbaren Daten und Erkenntnissen vom Januar 2026 aktualisiert.
Globale Trends und Erkenntnisse im Markt für Sensitive Data Discovery
Analyse der Treiberwirkung*
| Treiber | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Einsatz von Unternehmens-KI in nicht katalogisierten Datenbeständen | +3.5% | Global, konzentriert in Nordamerika und Westeuropa | Kurzfristig (≤ 2 Jahre) |
| Gesetzliche Anforderungen an die Sichtbarkeit sensibler Daten | +3.0% | Global, am stärksten in Europa, Nordamerika und regulatorischen Jurisdiktionen im asiatisch-pazifischen Raum | Mittelfristig (2–4 Jahre) |
| Zero-Trust-Sicherheit und automatisierte Compliance-Einführung | +2.5% | Nordamerika und Europa, mit Ausstrahlungseffekten auf Unternehmenssegmente im asiatisch-pazifischen Raum sowie im Nahen Osten und Afrika | Mittelfristig (2–4 Jahre) |
| Cloud-, SaaS- und Multi-Cloud-Datenwucherung | +2.0% | Global, am höchsten in cloud-reifen Märkten | Kurzfristig (≤ 2 Jahre) |
| KI-fähige Datenverwaltung und Anforderungen an die Datenherkunft | +1.5% | Global, konzentriert in regulierten Sektoren | Mittelfristig (2–4 Jahre) |
| Ausweitung der Datenerkennung auf breitere Sicherheitsplattformen | +1.2% | Nordamerika und Europa, mit aufkommender Einführung im asiatisch-pazifischen Raum sowie im Nahen Osten und Afrika | Langfristig (≥ 4 Jahre) |
| Quelle: Mordor Intelligence | |||
Einsatz von Unternehmens-KI in nicht katalogisierten Datenbeständen
Der Einsatz von generativer KI und autonomen Agenten in Unternehmen macht die Datenerkennung zu einer kontinuierlichen Governance-Anforderung, da Systeme Dateifreigaben, E-Mail-Archive und Retrieval-Augmented-Generation-Pipelines mit Maschinengeschwindigkeit verarbeiten können. Cyera berichtete im Juni 2026, dass 68 % der Unternehmen menschliche Aktivitäten nicht von KI-Agentenaktivitäten in ihren Datensystemen unterscheiden konnten, was Bedenken hinsichtlich Datenspeichern ohne zuverlässige Klassifizierung aufwirft. Der NIST-Entwurf der Sonderpublikation 1800-39 vom Februar 2026 identifizierte die automatisierte Klassifizierung als Anforderung für Zero-Trust- und KI-Modelltraining-Governance und stellte die Klassifizierung vor Richtlinienentscheidungen, die auf Datensensitivität beruhen. Die Leitlinien verknüpfen die Aufgabe auch mit einer umfassenderen Sicherheitsplanung, einschließlich quantensicherer Kryptografie und der Unterstützung wiederkehrender Scans anstelle einer einmaligen Bestandsaufnahme. BigID führte im August 2026 Agentic Access Control und Intent-Based Activity Monitoring ein, um das Verhalten von KI-Agenten mit erklärten Zwecken zu vergleichen. Der Markt für Sensitive Data Discovery gewinnt an Relevanz, da Unternehmen verstehen müssen, auf welche Informationen automatisierte Systeme zugreifen und was sie aus vorhandenen Informationen ableiten können.[1]Die wachsende Einführung von KI, Analysen und Datenverwaltungsinitiativen wird voraussichtlich die Nachfrage nach Lösungen für Sensitive Data Discovery weiter steigern.
Gesetzliche Anforderungen an die Sichtbarkeit sensibler Daten
Die Durchsetzung von Datenschutzvorschriften macht Lücken in der Datenkartierung folgenreicher, da Unternehmen Löschungs-, Zugriffs-, Aufbewahrungs- oder Übertragungsregeln nicht konsistent anwenden können, wenn sie nicht wissen, wo relevante Informationen gespeichert sind. Der Generalstaatsanwalt Kaliforniens gab im Februar 2026 einen CCPA-Vergleich in Höhe von 2,75 Millionen USD mit Disney bekannt und bezeichnete ihn als den größten CCPA-Vergleich in der Geschichte Kaliforniens. Der Vergleich zeigte, dass Datenverwaltungsfehler direkte finanzielle Konsequenzen haben können und eine prüfbare Übersicht über personenbezogene Informationen in allen Systemen erfordern. Datenschutzrahmen im asiatisch-pazifischen Raum erhöhen ebenfalls den Bedarf für Unternehmen, zu verstehen, wo personenbezogene Informationen gespeichert sind und wer für jedes Repository verantwortlich ist. Dies erfordert Dateninventare, die Dokumentations-, Sicherheits- und Handhabungsentscheidungen über Geschäftsbereiche und Technologieumgebungen hinweg unterstützen können. Der Markt für Sensitive Data Discovery kann davon profitieren, wenn Unternehmen wiederholbare Erkennungsprozesse einrichten, bevor Compliance-Verpflichtungen in Kraft treten.
Zero-Trust-Sicherheit und automatisierte Compliance-Einführung
Zero-Trust-Sicherheit erfordert, dass Zugriffsentscheidungen die Datensensitivität, die Identität des Anforderers und den Zweck widerspiegeln, und ist daher auf ein aktuelles Inventar sensibler Daten angewiesen. Der Markt für Sensitive Data Discovery schließt die Lücke zwischen identitätsbasierten Zugriffskontrollen und vollständiger Datentransparenz, indem er Informationen bereitstellt, die Richtlinien-Engines und Sicherheitsteams nutzen können. Der HPE Zero Trust Security Report 2026 befragte 851 IT- und Sicherheitsfachleute und stellte fest, dass 56 % KI oder maschinelles Lernen zur Bedrohungserkennung und 42 % zur Echtzeit-Richtlinienautomatisierung einsetzten. Diese Ergebnisse zeigen, dass Sicherheitsautomatisierung in den täglichen Betrieb einzieht und dass automatisierte Richtlinienentscheidungen zuverlässige Datenetiketten erfordern. Die NIST-Entwurfsleitlinien behandeln die Klassifizierung als Grundlage für Datenschutz-Compliance, Zero-Trust-Zugriff, KI-Governance und kryptografische Planung und erweitern damit die Gruppen, die eine Investition unterstützen können. Käufer werden wahrscheinlich beurteilen, ob eine Plattform Klassifizierungen aktuell halten kann, wenn sich Repositories und Richtlinien ändern.
Cloud-, SaaS- und Multi-Cloud-Datenwucherung
Cloud-Dienste, SaaS-Anwendungen und Multi-Cloud-Bereitstellungen haben die Anzahl der Speicherorte für sensible Daten erweitert, darunter temporäre Speicher, Analyse-Staging-Bereiche und KI-Vektordatenbanken. Netskope berichtete 2026, dass 87 % der Unternehmen Daten über 5 oder mehr Tools oder Plattformen verwalteten, während 58 % 11 oder mehr separate Datensicherheitstools nutzten. Diese Bedingungen können blinde Flecken an den Übergabepunkten zwischen Anwendungen, Cloud-Konten und Sicherheitsprodukten erzeugen. Produktionsdatenkopien können Berechtigungen aufweisen, die von Quellsystemen abweichen, und erscheinen möglicherweise nicht in älteren Dateninventaren. Unternehmen müssen diese Kopien identifizieren, bevor sie Aufbewahrungs-, Zugriffs- oder Löschanforderungen über verteilte Technologiebestände hinweg anwenden. Der Markt für Sensitive Data Discovery reagiert auf den Bedarf nach einem umfassenderen und konsistenteren Überblick über Cloud-, SaaS- und verbundene operative Daten.
Analyse der Hemmnisse*
| Hemmnis | (~) % Auswirkung auf die CAGR-Prognose | Geografische Relevanz | Zeithorizont der Auswirkung |
|---|---|---|---|
| Falsch-Positive bei musterbasierter Klassifizierung | -1.5% | Global, am ausgeprägtesten in Großunternehmen mit umfangreichen Datenbeständen in regulierten Branchen | Kurzfristig (≤ 2 Jahre) |
| Fragmentierte Konnektoren über Legacy- und maßgeschneiderte Systeme hinweg | -1.0% | Global, am schwerwiegendsten im asiatisch-pazifischen Raum sowie im Nahen Osten und Afrika, wo Legacy-Infrastrukturkonzentrationen höher sind | Mittelfristig (2–4 Jahre) |
| Mangel an Abhilfefähigkeiten und Entscheidungsbefugnis der Geschäftsverantwortlichen | -0.8% | Global, am ausgeprägtesten bei KMU und Unternehmen ohne dedizierte Governance-Funktionen | Mittelfristig (2–4 Jahre) |
| Rechen-, Energie- und Vollbestandsscanning-Kosten | -0.6% | Global, mit dem höchsten Einfluss in Unternehmen mit unstrukturierten Datenbeständen im Petabyte-Maßstab | Langfristig (≥ 4 Jahre) |
| Quelle: Mordor Intelligence | |||
Falsch-Positive bei musterbasierter Klassifizierung
Musterabgleich-Tools sind bei der Klassifizierung sensibler Daten nach wie vor weit verbreitet und können Falsch-Positive erzeugen, wenn ein Muster sensiblen Informationen ähnelt, aber den erforderlichen Kontext vermissen lässt. Wenn Warnmeldungen wiederholt ungenau sind, können Analysten ihnen weniger vertrauen, Folgemaßnahmen reduzieren und die Durchsetzung abschwächen, selbst wenn das Tool weiterhin eingesetzt wird. Auf dem ACM-Symposium für Dokumententechnik 2026 vorgestellte Forschungsergebnisse zeigten, dass mehrstufige Architekturen einer sorgfältigen Abstimmung bedurften, um Falsch-Positiv-Raten bei heterogenen Dokumenttypen im Unternehmensmaßstab unter 1 % zu halten. Eine hochwertige Klassifizierung ist wichtig, wenn nachgelagerte Kontrollen auf Ergebnissen ohne menschliche Überprüfung beruhen, da falsche Etiketten unnötige Untersuchungen auslösen oder einen legitimen Prozess behindern können. Unternehmen müssen Modelle über Dokumente, Repositories und Sprachen hinweg testen, die ihre eigenen Umgebungen widerspiegeln, was die Implementierungsarbeit auch bei fortschrittlichen Funktionen des maschinellen Lernens wichtig macht. Der Markt für Sensitive Data Discovery bevorzugt Anbieter, die Präzision nachweisen und einen klaren Prozess zur Verbesserung von Klassifizierungen bereitstellen.
Fragmentierte Konnektoren über Legacy- und maßgeschneiderte Systeme hinweg
Eine Plattform kann nur die Systeme scannen, die ihre Konnektoren erreichen können, während viele Unternehmen noch immer Systeme aus der Mainframe-Ära, maßgeschneiderte Anwendungen und benutzerdefinierte Datenbanken ohne Standardschnittstellen verwenden. Diese Systeme können ältere Kundendatensätze, Archive geistigen Eigentums und regulatorische Einreichungen enthalten, die über viele Jahre aufbewahrt wurden. Unternehmen können Lücken durch vom Anbieter entwickelte benutzerdefinierte Konnektoren oder Middleware-Schichten schließen, aber beides erhöht Kosten, Implementierungszeit und Wartungsaufwand. Dies kann ein umfassendes Erkennungsprogramm verzögern, selbst wenn ein Käufer die Technologie genehmigt hat, insbesondere in der Industriefertigung, im Öl- und Gassektor und in der öffentlichen Verwaltung. Das Problem kann fortbestehen, da die Infrastrukturmodernisierung bis in die 2030er Jahre andauert, einschließlich Teilen des asiatisch-pazifischen Raums, Südamerikas, des Nahen Ostens und Afrikas. Der Markt für Sensitive Data Discovery ist eingeschränkt, wenn Unternehmen keine vollständige Abdeckung der wichtigsten Datenquellen erreichen können, was die Breite der Konnektoren zu einem wichtigen Auswahlkriterium macht.
*Unsere Prognosen behandeln die Auswirkungen von Treibern und Einschränkungen als richtungsweisend und nicht additiv. Die Wirkungsprognosen berücksichtigen Basiswachstum, Mischungseffekte und Wechselwirkungen zwischen Variablen.
Segmentanalyse
Nach Komponente: Dienstleistungen wachsen schneller, da die Implementierungskomplexität zunimmt
Lösungen hielten 2025 einen Umsatzanteil von 68,12 %. Sie stellen die Software zur Lokalisierung, Klassifizierung und Überwachung sensibler Informationen in Unternehmens-Repositories bereit. Ihre führende Position spiegelt die zentrale Rolle von Plattformfähigkeiten in einem Erkennungsprogramm wider. Unternehmen benötigen Tools, die Datenquellen scannen und Klassifizierungsergebnisse präsentieren. Der Marktanteil von Lösungen für Sensitive Data Discovery spiegelt die Nachfrage nach Datentransparenz in Cloud-, SaaS- und On-Premises-Umgebungen wider.
Dienstleistungen werden voraussichtlich mit einer CAGR von 18,02 % im Zeitraum 2026–2031 wachsen. Sie umfassen Beratung und Bewertung, Implementierung und Integration, verwaltete Erkennung, Schulung, Support und Wartung. Der Implementierungsaufwand wächst, da Unternehmen die Abdeckung von Cloud-Umgebungen auf On-Premises-Repositories und ältere SaaS-Anwendungen ausweiten. Verwaltete Erkennung gewinnt bei mittelständischen Käufern ohne interne Datentechnik-Ressourcen an Bedeutung. Die Sensitive Data Discovery Branche entwickelt sich hin zu einem dienstleistungsgestützten Bereitstellungsmodell, bei dem Konfiguration und Abhilfe nach der Bereitstellung fortgesetzt werden.


Nach Datentyp: Unstrukturierte Daten führen, während semi-strukturierte Daten beschleunigen
Unstrukturierte Daten hielten 2025 einen Umsatzanteil von 60,29 %. Dokumente, E-Mails, Präsentationen und Kollaborationsinhalte sind mit datenbankorientierten Kontrollen schwer zu verwalten, da sensible Informationen in Freitext und gemischten Formaten eingebettet sind. Diese Quellen sind über gemeinsame Ordner und Geschäftsanwendungen verteilt. Die führende Position spiegelt den Bedarf wider, persönliche, finanzielle und andere sensible Informationen außerhalb vordefinierter Datenbankfelder zu finden. Kontextbewusste Klassifizierung hilft dabei, sensible Inhalte von gewöhnlichem Text zu unterscheiden.
Semi-strukturierte Daten werden voraussichtlich mit einer CAGR von 17,05 % im Zeitraum 2026–2031 wachsen. Die Kategorie umfasst JSON-Protokolle, XML-Feeds, API-Payloads und Ereignisströme aus KI-Pipelines. Cloud-native Anwendungen erzeugen diese Datensätze beim Informationsaustausch und bei der Erfassung von Systemaktivitäten. Sensible Identifikatoren können in operativen Daten erscheinen, selbst wenn der Datensatz für technisches Monitoring existiert. Der Markt für Sensitive Data Discovery reagiert auf eine Umgebung, die durch erhöhte Anwendungstelemetrie und KI-bezogene Datensätze gekennzeichnet ist.[2]Da Unternehmen die KI-Einführung und die Erfassung maschinell generierter Daten ausweiten, wird erwartet, dass die Nachfrage nach Lösungen wächst, die sensible Informationen in zunehmend komplexen Datenökosystemen kontinuierlich identifizieren, klassifizieren und verwalten können.
Nach Bereitstellungsmodus: Hybrid-Bereitstellungen gewinnen an Bedeutung, da Anforderungen an den Datenstandort zunehmen
Die Cloud-Bereitstellung hielt 2025 einen Umsatzanteil von 62,44 %. SaaS-Anwendungen und cloud-native Datenspeicher sind wichtige Speicherorte für Geschäftsinformationen. Agentenlose Scans können die Erkennung ermöglichen, ohne dass Infrastrukturänderungen an jedem Zielsystem erforderlich sind. Dies kann die frühe Abdeckung für Unternehmen mit verteilten Cloud-Umgebungen vereinfachen. Die Cloud-Bereitstellung unterstützt auch die Skalierung, wenn neue Repositories hinzugefügt werden.
Die Hybrid-Bereitstellung wird voraussichtlich bis 2031 mit einer CAGR von 17,45 % wachsen. Anforderungen an den Datenstandort und die Datensouveränität können einen Wechsel zu einem reinen Cloud-Design einschränken. Viele Unternehmen können On-Premises-Infrastruktur während des Prognosezeitraums nicht abbauen. Die On-Premises-Bereitstellung bleibt für luftdicht abgeschirmte Verteidigungsumgebungen, klassifizierte Regierungsumgebungen und regulierte Finanzdienstleistungsumgebungen relevant. Anbieter mit einheitlichem Richtlinienmanagement über Cloud-, On-Premises- und SaaS-Umgebungen hinweg können die Größe des Marktes für Sensitive Data Discovery ansprechen, der mit diesen gemischten Datenbeständen verbunden ist.
Nach Unternehmensgröße: KMU beschleunigen die Einführung, da sich die Plattformökonomie verändert
Großunternehmen hielten 2025 einen Umsatzanteil von 71,89 %. Sie verwalten größere Datenbestände, sind in mehr Jurisdiktionen tätig und können Plattformen, Integrationen und dedizierte Governance-Teams finanzieren. Diese Bedingungen machten Großunternehmen zu frühen Käufern umfassender Erkennungsfähigkeiten. Ihre Umgebungen umfassen häufig Cloud-Dienste, Legacy-Systeme und viele Geschäftsbereiche. Der Anteil des Marktes für Sensitive Data Discovery, den Großunternehmen halten, spiegelt diese Kombination aus Datenkomplexität und Compliance-Kosten wider.
KMU werden voraussichtlich mit einer CAGR von 17,71 % im Zeitraum 2026–2031 wachsen. Verbrauchsbasierte SaaS-Preisgestaltung kann die Vorabinvestition reduzieren, die den Zugang zu Erkennungsfähigkeiten bisher eingeschränkt hat. Kleinere Unternehmen sehen sich auch gesetzlichen Strafen und Compliance-Anforderungen in der Lieferkette gegenüber. IBM berichtete 2026 von durchschnittlichen globalen Datenschutzverletzungskosten von 4,99 Millionen USD, basierend auf 602 Unternehmen, die zwischen März 2025 und Februar 2026 von Datenschutzverletzungen betroffen waren. Cloud-native Anbieter wie Nightfall AI und Sentra bieten Klassifizierungsabdeckung ohne den professionellen Dienstleistungsaufwand, der bei großen Bereitstellungen üblich ist.
Nach Branchenvertikale: BFSI führt, während Gesundheitswesen und Biowissenschaften beschleunigen
BFSI hielt 2025 einen Umsatzanteil von 24,51 %. Finanzinstitute verwalten Zahlungsdaten, Kundendatensätze, Transaktionsinformationen und andere hochwertige Datenkategorien. Sie unterliegen gleichzeitigen Anforderungen, darunter PCI DSS 4.0.1, DORA, NYDFS Part 500 und die GLBA Safeguards Rule. PCI DSS 4.0.1 trat im März 2025 vollständig in Kraft, und das bereitgestellte Material identifiziert NYDFS Part 500 als ab 2026 vollständig durchgesetzt. IBM stufte Finanzdienstleistungen als den zweitteuersten Sektor für Datenschutzverletzungen ein, mit 6,29 Millionen USD pro Vorfall in seinem Bericht von 2026.
Das Gesundheitswesen und die Biowissenschaften werden voraussichtlich mit einer CAGR von 16,49 % im Zeitraum 2026–2031 wachsen. Der Sektor hält geschützte Gesundheitsinformationen, klinische Aufzeichnungen und forschungsbezogene Daten in vielen Systemen. Das HHS OCR schloss im April 2026 4 HIPAA-Sicherheitsregel-Ransomware-Untersuchungen für 1,165 Millionen USD ab und zitierte jede Einrichtung wegen Versäumnissen bei der Durchführung erforderlicher Risikoanalysen. Regierung und öffentliche Verwaltung, IT und Telekommunikation sowie Einzelhandel und E-Commerce bilden die nächste Nachfragestufe, wobei der Einzelhandel durch Zahlungs- und Verhaltensdaten aus der Omnichannel-Erfassung unterstützt wird. Das schnellere Wachstum des Gesundheitswesens spiegelt eine Lücke in der Erkennungsreife im Vergleich zu Finanzinstituten wider.
Geografische Analyse
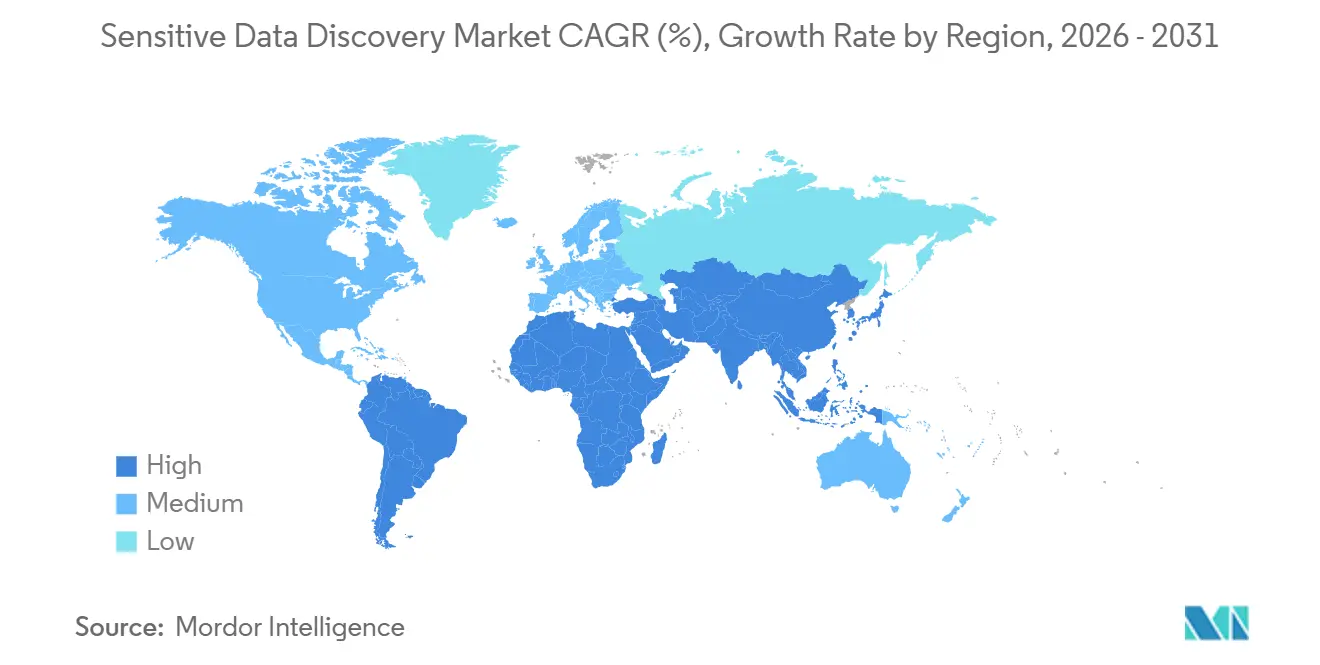
Nordamerika hielt 2025 einen Umsatzanteil von 35,74 %. Die Region kombiniert eine hohe Konzentration cloud-nativer Unternehmen mit überlappenden Bundes- und Staatsanforderungen. Sie verfügt auch über ein reifes Anbieter-Ökosystem, mit BigID, Varonis, Cyera, Nightfall AI und Sentra mit Hauptsitz in den Vereinigten Staaten. Der Generalstaatsanwalt Kaliforniens gab im Februar 2026 einen CCPA-Vergleich in Höhe von 2,75 Millionen USD mit Disney bekannt. Das Büro bezeichnete ihn als den größten CCPA-Vergleich in der Geschichte Kaliforniens.[3]Die zunehmende Intensität der regulatorischen Durchsetzung und steigende finanzielle Strafen für Datenverwaltungsfehler werden voraussichtlich Investitionen in Lösungen für Sensitive Data Discovery beschleunigen.
Der asiatisch-pazifische Raum wird voraussichtlich mit einer CAGR von 16,78 % im Zeitraum 2026–2031 wachsen. Die Marktgröße für Sensitive Data Discovery in der Region wird durch neue und sich stärkende Datenschutzrahmen unterstützt. Datenschutzanforderungen erhöhen den Bedarf an Erkennungs-, Klassifizierungs- und Dokumentationsprozessen in Cloud-, SaaS- und On-Premises-Umgebungen. Digitale Transformation und regulatorische Aktivierung unterstützen das schnellere Wachstumsprofil der Region. Diese Bedingungen stärken den Bedarf an konsistenten Datenhandhabungspraktiken.
Europa hielt 2025 den zweitgrößten Umsatzanteil. Deutschlands Präferenz für europäische souveräne und On-Premises-Bereitstellungen unterstützt Hybrid-Architekturen. Frankreich erließ im April 2026 das Dekret Nr. 2026-272, das die SecNumCloud-Qualifikation für Cloud-Dienste vorschreibt, die sensible Staatsdaten verarbeiten. Südamerika ist eine Frühphasen-Chance, die durch die Durchsetzung des brasilianischen LGPD unterstützt wird, während der Nahe Osten und Afrika sich durch nationale Datenverwaltungsrahmen entwickeln.

Wettbewerbslandschaft
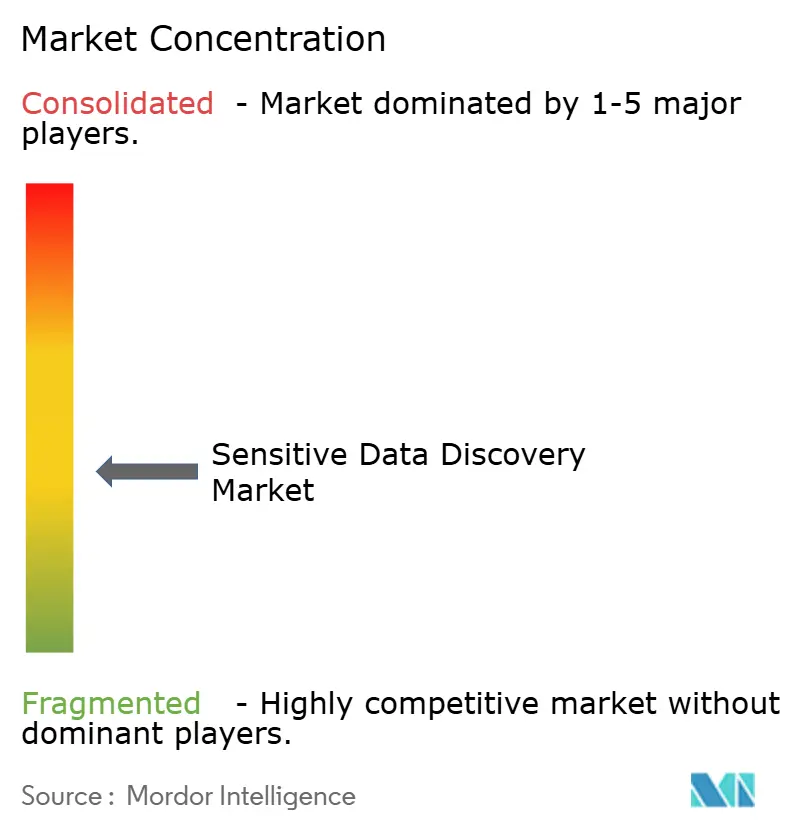
Der Markt für Sensitive Data Discovery ist mäßig fragmentiert. Zu den Spezialanbietern gehören BigID, Cyera, Sentra, Netwrix, Spirion, Ground Labs und Nightfall AI, während zu den größeren Plattformanbietern Microsoft über Purview, Palo Alto Networks über Cortex Cloud, IBM über Guardium und Informatica gehören. Diese Anbieter konkurrieren in den Bereichen Erkennungsabdeckung, Klassifizierungsqualität, Integration und die Verbindung zwischen Erkennung und umfassenderen Kontrollen. Käufer können zwischen spezialisierter Tiefe und einer breiteren Plattformbeziehung wählen. Der Markt für Sensitive Data Discovery umfasst sowohl Einzelprodukte als auch integrierte Governance- und Sicherheitsplattformen.
Cyera sammelte im Juni 2026 600 Millionen USD bei einer Bewertung von 12 Milliarden USD ein und erklärte, dass das insgesamt aufgebrachte Kapital 2,3 Milliarden USD überstieg. Es wurde auch angegeben, dass der jährlich wiederkehrende Umsatz drei aufeinanderfolgende Jahre lang verdreifacht wurde und dass in den vorangegangenen 18 Monaten 5 Akquisitionen abgeschlossen wurden, darunter Ryft und Genie für agentische KI-Governance. Veeam schloss im Dezember 2025 die Akquisition von Securiti AI für 1,725 Milliarden USD ab und kombinierte dabei Datenresilienz mit Datensicherheits-Positionsmanagement, Datenschutz, Governance und KI-Vertrauen. Microsofts Purview-Dokumentation bestätigt Integrationen mit Varonis, Cyera und BigID. Diese Schritte zeigen sowohl Konsolidierungs- als auch Partnerschaftsmöglichkeiten für Spezialanbieter.[4]Es wird erwartet, dass der Markt weitere Wachstumschancen verzeichnen wird, da Unternehmen integrierte Plattformen suchen, die Datenerkennung, Governance, Datenschutz, KI-Vertrauen und Cyber-Resilienz in einem einheitlichen Datensicherheitsrahmen kombinieren.
BigID kündigte im August 2026 Agentic Access Control und Intent-Based Activity Monitoring an, während Netwrix im Juni 2026 KI-Governance-Fähigkeiten für hybride Microsoft-Umgebungen ankündigte. Proofpoint stellte im August 2026 erweiterte europäische Datensicherheits-Positionsmanagement-Fähigkeiten zur Verfügung, einschließlich KI-gestützter Erkennung und Klassifizierung in den wichtigsten europäischen Geschäftssprachen aus einem Rechenzentrum in Frankfurt. Chancen bestehen weiterhin in sektorspezifischen Profilen für genomische und klinische Studiendaten, KI-Trainingsdaten-Governance und Erkennung als Dienstleistung für KMU. Der Markt für Sensitive Data Discovery kann Anbieter belohnen, die lokale Anforderungen mit zuverlässiger Integration und Klassifizierungsergebnissen kombinieren.
Marktführer im Bereich Sensitive Data Discovery
-
OpenText Corporation
-
IBM Corporation
-
Microsoft Corporation
-
Palo Alto Networks, Inc.
-
Varonis Systems, Inc.
- *Haftungsausschluss: Hauptakteure in keiner bestimmten Reihenfolge sortiert

Aktuelle Branchenentwicklungen
- August 2026: BigID kündigte auf der Black Hat Agentic Access Control und Intent-Based Activity Monitoring an und erweiterte damit seine Plattform zur Steuerung des Datenzugriffs von KI-Agenten auf Basis des erklärten Zwecks und des beobachteten Verhaltens. Die Fähigkeit adressierte Governance-Lücken, die entstehen, wenn statische Berechtigungen sich nicht an maschinengeschnelle, verkettete Agentenaktivitäten über regulierte Datenspeicher hinweg anpassen können.
- August 2026: Proofpoint stellte erweiterte europäische DSPM-Fähigkeiten zur Verfügung, einschließlich KI-gestützter Erkennung und Klassifizierung in den wichtigsten europäischen Geschäftssprachen, gehostet aus seinem Rechenzentrum in Frankfurt, Deutschland. Die im Februar 2026 angekündigte Version richtete sich direkt an Unternehmen mit Anforderungen an den Datenstandort und die Einhaltung des EU AI Act.
- Juni 2026: Cyera sammelte 600 Millionen USD in einer Series-D-Runde bei einer Bewertung von 12 Milliarden USD ein, angeführt von Evolution Equity Partners, mit Beteiligung von Cyberstarts und Temasek, wodurch die Gesamtfinanzierung auf über 2,3 Milliarden USD stieg. Cyera gab bekannt, dass der jährlich wiederkehrende Umsatz drei aufeinanderfolgende Jahre lang verdreifacht wurde und dass in den vorangegangenen 18 Monaten 5 Akquisitionen abgeschlossen wurden, darunter Ryft und Genie für agentische KI-Governance.
- Juni 2026: Netwrix stellte über seine 1Secure SaaS-Plattform neue KI-Governance-Fähigkeiten für hybride Microsoft-Umgebungen vor und fügte Transparenz und Kontrolle über den Zugriff auf sensible Daten durch KI-Agenten und Microsoft Copilot in On-Premises- und Cloud-Konfigurationen hinzu.


Berichtsumfang des globalen Marktes für Sensitive Data Discovery
Der Markt für Sensitive Data Discovery umfasst Lösungen und Dienstleistungen, die es Unternehmen ermöglichen, sensible Daten in strukturierten, semi-strukturierten und unstrukturierten Daten-Repositories zu identifizieren, zu klassifizieren, zu inventarisieren, zu überwachen und zu verwalten. Diese Lösungen helfen Unternehmen dabei, personenbezogene Daten (PII), geschützte Gesundheitsinformationen (PHI), Zahlungskartendaten, geistiges Eigentum, vertrauliche Geschäftsinformationen und andere regulierte oder sensible Datenbestände in On-Premises-, Cloud- und Hybrid-Umgebungen zu entdecken. Plattformen für Sensitive Data Discovery unterstützen Datenschutz-, Datenschutz-Compliance-, Cybersicherheits-, Governance-, Risikomanagement-, Datenminimierungs- und regulatorische Berichterstattungsinitiativen, indem sie Transparenz über den Standort, die Bewegung und die Exposition sensibler Informationen bieten.
Der Bericht zum Markt für Sensitive Data Discovery ist segmentiert nach Komponente (Lösungen und Dienstleistungen [Beratungs- und Bewertungsdienstleistungen, Implementierungs- und Integrationsdienstleistungen, Verwaltete Sensitive Data Discovery Dienstleistungen sowie Schulungs-, Support- und Wartungsdienstleistungen]), Datentyp (Strukturierte Daten, Unstrukturierte Daten und Semi-Strukturierte Daten), Bereitstellungsmodus (Cloud, On-Premises und Hybrid), Unternehmensgröße (Großunternehmen sowie Kleine und Mittlere Unternehmen), Branchenvertikale (Regierung und öffentliche Verwaltung, Industriefertigung, IT und Telekommunikation, Gesundheitswesen und Biowissenschaften, Banken, Finanzdienstleistungen und Versicherungen [BFSI] sowie sonstige Branchenvertikalen) und Geografie (Nordamerika, Südamerika, Europa, asiatisch-pazifischer Raum sowie Naher Osten und Afrika). Die Marktprognosen werden in Wertangaben (USD) bereitgestellt.
| Lösungen | |
| Dienstleistungen | Beratungs- und Bewertungsdienstleistungen |
| Implementierungs- und Integrationsdienstleistungen | |
| Verwaltete Sensitive Data Discovery Dienstleistungen | |
| Schulungs-, Support- und Wartungsdienstleistungen |
| Strukturierte Daten |
| Unstrukturierte Daten |
| Semi-Strukturierte Daten |
| Cloud |
| On-Premises |
| Hybrid |
| Großunternehmen |
| Kleine und Mittlere Unternehmen |
| Regierung und öffentliche Verwaltung |
| Industriefertigung |
| IT und Telekommunikation |
| Gesundheitswesen und Biowissenschaften |
| Banken, Finanzdienstleistungen und Versicherungen (BFSI) |
| Sonstige Branchenvertikalen |
| Nordamerika | Vereinigte Staaten | |
| Kanada | ||
| Südamerika | Brasilien | |
| Mexiko | ||
| Übriges Südamerika | ||
| Europa | Deutschland | |
| Vereinigtes Königreich | ||
| Frankreich | ||
| Italien | ||
| Übriges Europa | ||
| Asiatisch-Pazifischer Raum | China | |
| Japan | ||
| Indien | ||
| Südkorea | ||
| Übriger asiatisch-pazifischer Raum | ||
| Naher Osten und Afrika | Naher Osten | Vereinigte Arabische Emirate |
| Saudi-Arabien | ||
| Übriger Naher Osten | ||
| Afrika | Südafrika | |
| Übriges Afrika | ||
| Nach Komponente | Lösungen | ||
| Dienstleistungen | Beratungs- und Bewertungsdienstleistungen | ||
| Implementierungs- und Integrationsdienstleistungen | |||
| Verwaltete Sensitive Data Discovery Dienstleistungen | |||
| Schulungs-, Support- und Wartungsdienstleistungen | |||
| Nach Datentyp | Strukturierte Daten | ||
| Unstrukturierte Daten | |||
| Semi-Strukturierte Daten | |||
| Nach Bereitstellungsmodus | Cloud | ||
| On-Premises | |||
| Hybrid | |||
| Nach Unternehmensgröße | Großunternehmen | ||
| Kleine und Mittlere Unternehmen | |||
| Nach Branchenvertikale | Regierung und öffentliche Verwaltung | ||
| Industriefertigung | |||
| IT und Telekommunikation | |||
| Gesundheitswesen und Biowissenschaften | |||
| Banken, Finanzdienstleistungen und Versicherungen (BFSI) | |||
| Sonstige Branchenvertikalen | |||
| Nach Geografie | Nordamerika | Vereinigte Staaten | |
| Kanada | |||
| Südamerika | Brasilien | ||
| Mexiko | |||
| Übriges Südamerika | |||
| Europa | Deutschland | ||
| Vereinigtes Königreich | |||
| Frankreich | |||
| Italien | |||
| Übriges Europa | |||
| Asiatisch-Pazifischer Raum | China | ||
| Japan | |||
| Indien | |||
| Südkorea | |||
| Übriger asiatisch-pazifischer Raum | |||
| Naher Osten und Afrika | Naher Osten | Vereinigte Arabische Emirate | |
| Saudi-Arabien | |||
| Übriger Naher Osten | |||
| Afrika | Südafrika | ||
| Übriges Afrika | |||


Im Bericht beantwortete Schlüsselfragen
Wie groß ist der Markt für Sensitive Data Discovery?
Der Markt für Sensitive Data Discovery hatte 2025 einen Wert von 8,82 Milliarden USD und wird voraussichtlich bis 2031 auf 20,76 Milliarden USD anwachsen, bei einer CAGR von 15,87 % im Zeitraum 2026–2031.
Was treibt die Nachfrage nach Plattformen für Sensitive Data Discovery an?
Die Einführung generativer KI, die Durchsetzung von Datenschutzvorschriften, Zero-Trust-Programme und die Datenwucherung in Cloud- und SaaS-Umgebungen steigern die Nachfrage, insbesondere wenn Unternehmen kontinuierliche Transparenz über Legacy- und neue Repositories benötigen, Informationen konsistent klassifizieren und Ergebnisse mit Zugriffs-, Aufbewahrungs- und Abhilfemaßnahmen verknüpfen müssen.
Welche Komponente wird bis 2031 voraussichtlich am schnellsten wachsen?
Dienstleistungen werden voraussichtlich mit einer CAGR von 18,02 % wachsen, da Käufer Implementierung, Integration, verwaltete Erkennung, Schulung, Support und Unterstützung bei der laufenden Konfiguration und Abhilfe benötigen.
Welches Bereitstellungsmodell wächst am schnellsten?
Die Hybrid-Bereitstellung wird voraussichtlich bis 2031 mit einer CAGR von 17,45 % wachsen, da viele Unternehmen Cloud- und On-Premises-Daten unterstützen müssen und gleichzeitig Anforderungen an den Datenstandort erfüllen müssen.
Welche Region wird voraussichtlich am schnellsten wachsen?
Der asiatisch-pazifische Raum wird voraussichtlich mit einer CAGR von 16,78 % im Zeitraum 2026–2031 wachsen, da Datenschutzrahmen und digitale Transformation Compliance-Investitionen steigern.
Welche Branchenvertikale bietet die schnellste Wachstumschance?
Das Gesundheitswesen und die Biowissenschaften werden voraussichtlich bis 2031 mit einer CAGR von 16,49 % wachsen, unterstützt durch den Bedarf, die Transparenz über geschützte Gesundheitsinformationen in komplexen klinischen Systemen zu verbessern.


 Ihre Daten sind sicher und werden niemals verkauft oder weitergegeben.

